
Corso
Machine Learning per dati di serie temporali in Python
4 ore
54.1K
Il tempo è una dimensione fondamentale nell’analisi dei dati. Nel tempo, i valori possono fluttuare, mostrare trend o restare stabili. Quando analizziamo come i dati evolvono nel tempo, stiamo lavorando con serie temporali.
Un’operazione comune nell’analisi di serie temporali è l’adattamento della frequenza di date e orari nei nostri dati, una tecnica nota come riprelevamento (resampling). In questo tutorial useremo Pandas, una libreria con strumenti robusti per una manipolazione intuitiva ed efficiente delle serie temporali.
Partiremo dalle basi per arrivare gradualmente a tecniche di riprelevamento più avanzate. Forniremo esempi pratici e condivideremo buone pratiche per rendere l’analisi delle serie temporali efficace e performante.
Se vuoi approfondire le serie temporali, dai un’occhiata a questo corso su manipolare i dati di serie temporali in Python.
Come possiamo raggruppare i dati per categoria, il riprelevamento ci permette di raggrupparli in diversi intervalli temporali. Questo è utile sia per la pulizia dei dati sia per un’analisi approfondita delle serie temporali. Ad esempio, potremmo dover allineare due serie temporali a una frequenza comune prima di confrontarle.
Esistono due tipi principali di riprelevamento:
Possiamo eseguire il riprelevamento in pandas con due metodi principali: .asfreq() e .resample().
Per iniziare a usarli, dobbiamo prima importare la libreria pandas con il consueto alias pd. Importeremo anche matplotlib per visualizzare i risultati.
import pandas as pd
import matplotlib.pyplot as plt
Cominciamo con il metodo .asfreq(). Questo metodo converte una serie temporale a una frequenza specificata, restituendo i dati originali allineati a un nuovo indice con tale frequenza.
Lavoreremo con un dataset che contiene le letture giornaliere della temperatura a Madrid dal 1997 al 2015. Partiamo da alcuni passaggi di preprocessing prima di entrare nel vivo del riprelevamento.
url = 'https://raw.githubusercontent.com/jcanalesluna/courses_materials/master/datasets/Madrid%20Daily%20Weather%201997-2015.csv'
df = pd.read_csv(url, usecols=['CET', 'Max TemperatureC', 'Mean TemperatureC', 'Min TemperatureC'])

# Change column names
df.columns = ['time', 'max_temp', 'mean_temp', 'min_temp']

# Convert string column to datetime
df['time'] = pd.to_datetime(df['time'])

# Set time column as index
df = df.set_index('time')

df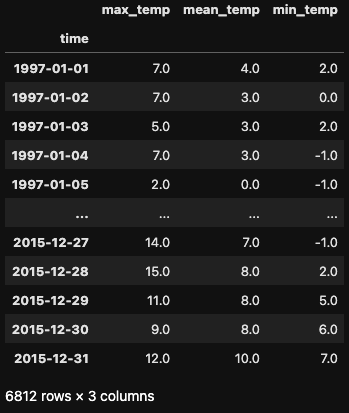
Per illustrare l’upsampling, immaginiamo di voler convertire le nostre letture giornaliere della temperatura in letture orarie. Possiamo farlo con il metodo .asfreq() e il parametro freq='H'.
df_hour = df.asfreq('H')
df_hour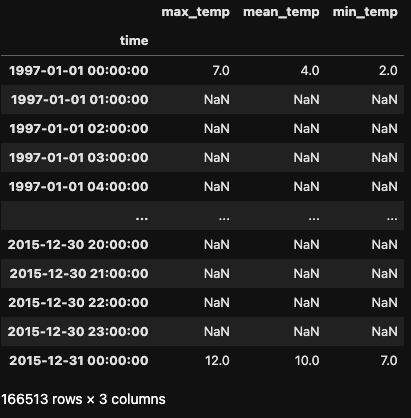
Il dataset risultante è notevolmente più grande, perché sono state create nuove righe con dati orari invece che giornalieri. Per impostazione predefinita, .asfreq() prende la prima voce nell’indice originale e popola le ore rimanenti con valori nulli.
Il dataset risultante è considerevolmente più grande, perché sono state create nuove righe con dati orari invece che giornalieri. Per impostazione predefinita, .asfreq() prende la prima voce nell’indice originale e crea valori nulli per le ore restanti.
Pandas offre tre strategie per riempire questi valori nulli:
ffill): propaga in avanti l’ultima osservazione valida.bfill): usa la successiva osservazione valida per colmare il vuoto.Le prime due strategie si impostano con il parametro method del metodo .asfreq(), mentre il valore di riempimento si specifica con il parametro fill_value.
df_mean_temp = df[['mean_temp']]
df_mean_temp_hour= df_mean_temp.asfreq('H')

df_mean_temp_hour['ffill'] = df_mean_temp.asfreq('H', method='ffill')
df_mean_temp_hour['bfill'] = df_mean_temp.asfreq('H', method='bfill')
df_mean_temp_hour['value'] = df_mean_temp.asfreq('H', fill_value=0)
df_mean_temp_hour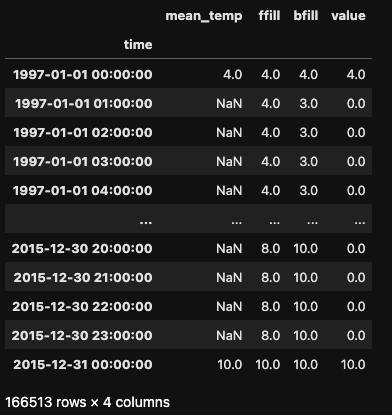
Passiamo ora al downsampling. Supponiamo di voler cambiare la frequenza giornaliera in mensile. Possiamo farlo con .asfreq() e il parametro freq='M'.
In questo caso stiamo riducendo la frequenza dei dati, passando da giornaliera a mensile. Il DataFrame risultante ha solo 228 righe, rispetto alle 6.812 del DataFrame originale.
df_month = df.asfreq(freq='M')
df_month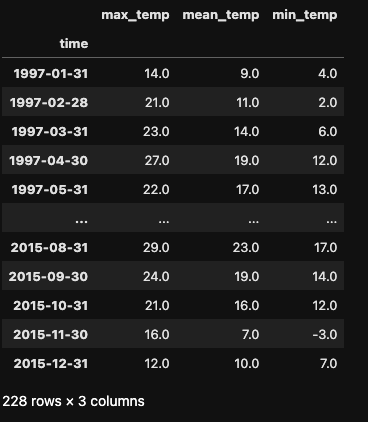
Nota che .asfreq() seleziona semplicemente l’ultimo giorno di ciascun mese e usa il suo valore per rappresentare l’intero mese. Non viene eseguita alcuna aggregazione (ad es., calcolare la temperatura media mensile). Per eseguire queste aggregazioni, passeremo al metodo .resample() nella sezione successiva.
Sebbene .asfreq() sia comodo per visualizzare i dati di una serie temporale con una frequenza diversa, il metodo .resample() è lo strumento ideale quando vogliamo effettuare aggregazioni insieme al riprelevamento.
Il metodo .resample() funziona in modo simile a .groupby(): raggruppa i dati all’interno di un intervallo temporale specificato e poi applica una o più funzioni a ciascun gruppo. Il risultato di queste funzioni viene assegnato a una nuova data all’interno di quell’intervallo.
Usiamo .resample() sia per l’upsampling (riempimento o interpolazione dei dati mancanti) sia per il downsampling (aggregazione dei dati).
Riprendiamo la conversione a frequenza oraria per vedere come funziona l’upsampling con .resample(). Applicando .resample() otteniamo un oggetto Resampler, al quale possiamo poi applicare un altro metodo per ottenere un DataFrame.
print(df.resample('H'))DatetimeIndexResampler [freq=<Hour>, axis=0, closed=left, label=left, convention=start, origin=start_day]Per quanto riguarda l’upsampling, il metodo .resample() può svolgere gli stessi compiti di .asfreq().
df.mean_temp.resample('H').asfreq()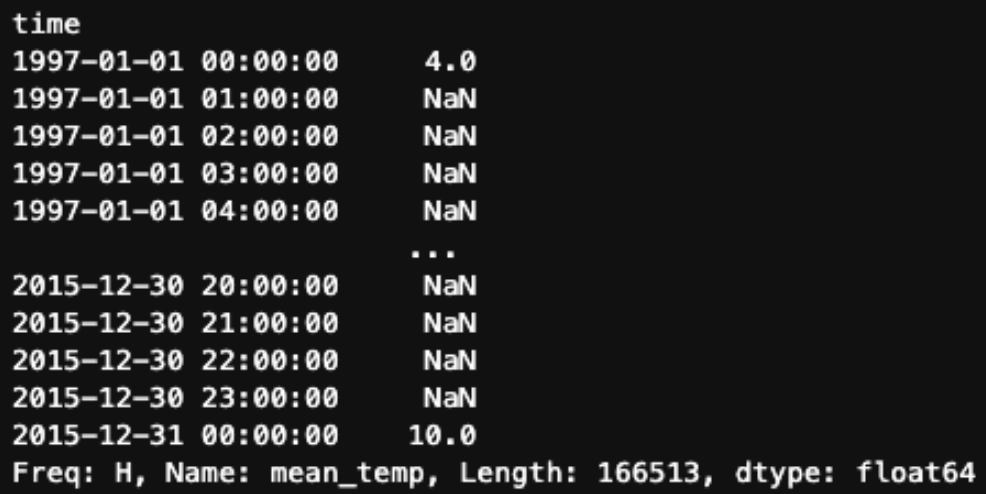
Possiamo anche applicare le stesse strategie di riempimento e interpolazione usate con .asfreq(). Ad esempio, per usare il forward fill:
df.mean_temp.resample('H').ffill()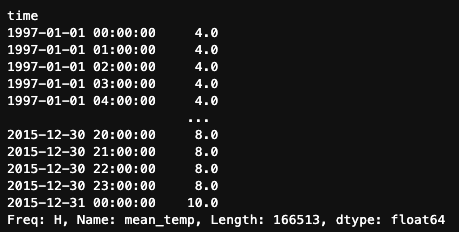
Ma .resample() offre anche metodi aggiuntivi non disponibili con .asfreq(). Ad esempio, possiamo usare il metodo .interpolate(), che stima i valori nei nuovi punti temporali trovando punti lungo una linea retta tra i dati esistenti.
df.mean_temp.resample('H').interpolate()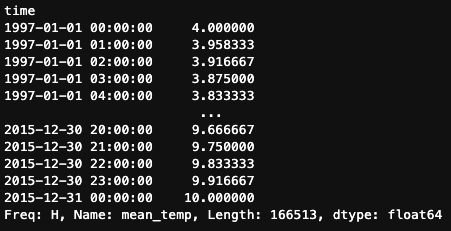
Il metodo .resample() dà il meglio nel downsampling, perché permette di applicare vari metodi di aggregazione per riassumere i dati. Per esempio, calcoliamo sia la media mensile sia la mediana trimestrale delle temperature per Madrid usando .resample().
df.mean_temp.resample('M').mean()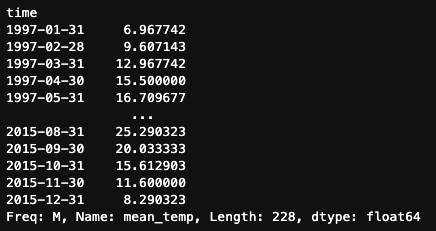
df.mean_temp.resample('Q').median()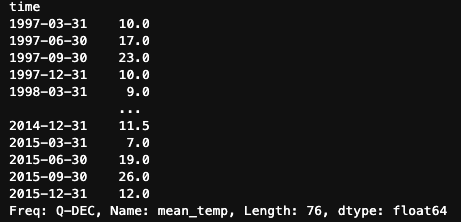
Oltre alle operazioni di base, i metodi di riprelevamento di Pandas gestiscono anche scenari più avanzati. Vediamo i più comuni.
Il riprelevamento ci consente di creare una nuova serie temporale con una frequenza su misura per le nostre esigenze. Alcune frequenze usate spesso includono:
W: frequenza settimanale (termina di domenica)M: fine meseQ: fine trimestreH: frequenza orariaTuttavia, Pandas offre molte altre opzioni in base alle necessità. Possiamo definire frequenze basate su inizio o fine periodo, usare giorni lavorativi invece dei giorni di calendario o persino creare frequenze completamente personalizzate.
df.mean_temp.resample('M').mean() # calendar month end
df.mean_temp.resample('MS').mean() # calendar month start
df.mean_temp.resample('BM').mean() # business calendar end
df.mean_temp.resample('BMS').mean() # business calendar startCome il metodo groupby(), .resample() consente di applicare più aggregazioni contemporaneamente. Possiamo usare il metodo .agg() e passare un elenco di funzioni di aggregazione, come mean, median e standard deviation.
df.mean_temp.resample('M').agg(['mean','median','std'])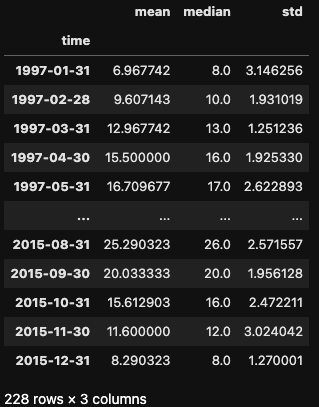
Pandas è altamente ottimizzato per la gestione di dataset di grandi dimensioni, ma all’aumentare della dimensione dei DataFrame l’elaborazione può diventare onerosa. Questo è particolarmente vero durante l’upsampling. Immagina di riprelevare una serie oraria a secondi: il DataFrame risultante potrebbe essere enorme!
Se riscontri problemi di performance con dataset grandi, puoi adottare queste strategie:
Per fortuna, le versioni di pandas dalla 2.0 in poi includono tecniche avanzate per un’elaborazione più efficiente. Puoi saperne di più in questo articolo su Pandas 2.0.
Il riprelevamento è una tecnica fondamentale nell’analisi delle serie temporali: ci permette di adattare la frequenza dei dati aggregando (downsampling) o interpolando (upsampling) i valori. Abbiamo visto come pandas offra strumenti potenti come .asfreq() e .resample() per rendere questo processo intuitivo ed efficiente.
Per approfondire il riprelevamento e la manipolazione delle serie temporali in Python, dai un’occhiata a queste risorse:
Approfondisci le serie temporali con questi corsi!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



