
{count, plural, one {Kursus} other {Kursus}}
Machine Learning untuk Data Deret Waktu di Python
{hours} jam
54.2K
Waktu adalah dimensi fundamental dalam analisis data. Seiring waktu, nilai dapat berfluktuasi, membentuk tren, atau tetap stabil. Saat kita menganalisis bagaimana data berubah dari waktu ke waktu, kita bekerja dengan deret waktu.
Tugas umum dalam analisis deret waktu adalah menyesuaikan frekuensi tanggal dan waktu di dalam data kita, teknik yang dikenal sebagai resampling. Dalam tutorial ini, kita akan memanfaatkan Pandas, pustaka dengan alat andal untuk manipulasi deret waktu yang intuitif dan efisien.
Kita akan mulai dari dasar dan secara bertahap berlanjut ke teknik resampling yang lebih lanjut. Kami akan memberikan contoh praktis dan berbagi praktik terbaik agar analisis deret waktu kita efektif dan berkinerja baik.
Jika Anda ingin mempelajari lebih lanjut tentang deret waktu, lihat kursus ini tentang memanipulasi data deret waktu di Python.
Mirip dengan cara kita dapat mengelompokkan data menurut kategori, resampling memungkinkan kita mengelompokkan data ke dalam interval waktu yang berbeda. Ini bermanfaat baik untuk pembersihan data maupun analisis deret waktu yang mendalam. Misalnya, kita mungkin perlu menyelaraskan dua deret waktu ke frekuensi yang sama sebelum membandingkannya.
Ada dua jenis resampling utama:
Kita dapat melakukan resampling dengan pandas menggunakan dua metode utama: .asfreq() dan .resample().
Untuk mulai menggunakan metode ini, pertama kita harus mengimpor pustaka pandas dengan alias konvensional pd. Kita juga akan mengimpor matplotlib untuk memvisualisasikan hasilnya.
import pandas as pd
import matplotlib.pyplot as plt
Mari mulai dengan metode .asfreq(). Metode ini mengonversi deret waktu ke frekuensi tertentu, mengembalikan data asli yang disejajarkan dengan indeks baru pada frekuensi tersebut.
Kita akan bekerja dengan dataset yang berisi pembacaan suhu harian di Madrid dari 1997 hingga 2015. Mari mulai dengan beberapa langkah pra-pemrosesan sebelum masuk ke resampling.
url = 'https://raw.githubusercontent.com/jcanalesluna/courses_materials/master/datasets/Madrid%20Daily%20Weather%201997-2015.csv'
df = pd.read_csv(url, usecols=['CET', 'Max TemperatureC', 'Mean TemperatureC', 'Min TemperatureC'])

# Change column names
df.columns = ['time', 'max_temp', 'mean_temp', 'min_temp']

# Convert string column to datetime
df['time'] = pd.to_datetime(df['time'])

# Set time column as index
df = df.set_index('time')

df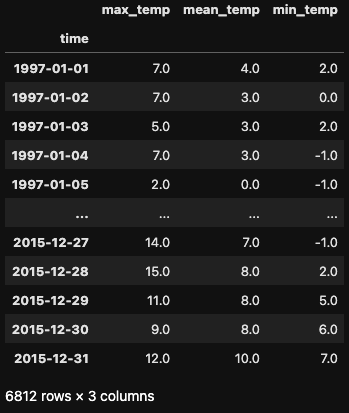
Untuk mengilustrasikan upsampling, bayangkan kita ingin mengonversi pembacaan suhu harian menjadi per jam. Kita dapat melakukannya menggunakan metode .asfreq() dengan parameter freq='H'.
df_hour = df.asfreq('H')
df_hour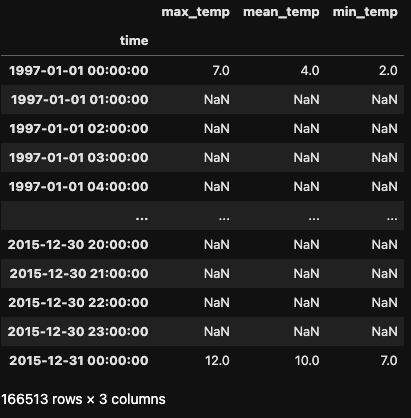
Dataset yang dihasilkan menjadi jauh lebih besar, karena baris-baris baru dibuat dengan data per jam alih-alih harian. Secara bawaan, .asfreq() mengambil entri pertama pada indeks asli dan mengisi jam-jam berikutnya dengan nilai null.
Dataset yang dihasilkan menjadi jauh lebih besar, karena baris-baris baru dibuat dengan data per jam alih-alih data harian. Secara bawaan, .asfreq() mengambil entri pertama pada indeks asli dan membuat nilai null untuk jam-jam sisanya.
Pandas menawarkan tiga strategi untuk mengisi nilai null ini:
ffill): Meneruskan observasi valid terakhir ke depan.bfill): Menggunakan observasi valid berikutnya untuk menutup celah.Dua strategi pertama diimplementasikan menggunakan parameter method pada metode .asfreq(), sedangkan nilai isian ditentukan dengan parameter fill_value.
df_mean_temp = df[['mean_temp']]
df_mean_temp_hour= df_mean_temp.asfreq('H')

df_mean_temp_hour['ffill'] = df_mean_temp.asfreq('H', method='ffill')
df_mean_temp_hour['bfill'] = df_mean_temp.asfreq('H', method='bfill')
df_mean_temp_hour['value'] = df_mean_temp.asfreq('H', fill_value=0)
df_mean_temp_hour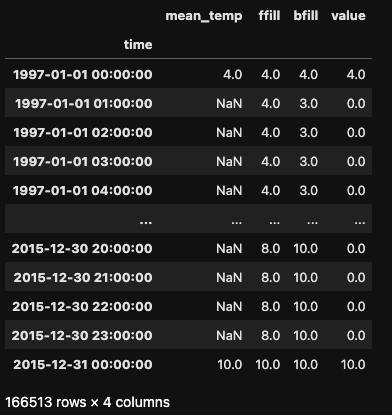
Sekarang mari kita jelajahi downsampling. Misalkan kita ingin mengubah frekuensi harian menjadi bulanan. Kita dapat melakukannya menggunakan .asfreq() dengan parameter freq='M'.
Dalam hal ini, kita mengurangi frekuensi data, beralih dari harian ke bulanan. DataFrame yang dihasilkan hanya memiliki 228 baris, dibandingkan dengan 6.812 pada DataFrame asli.
df_month = df.asfreq(freq='M')
df_month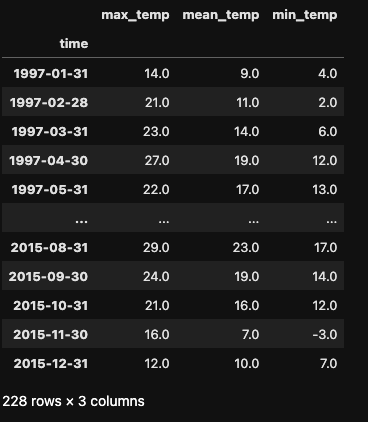
Perhatikan bahwa .asfreq() hanya memilih hari terakhir setiap bulan dan menggunakan nilainya untuk mewakili keseluruhan bulan. Tidak ada agregasi yang dilakukan (mis., menghitung suhu rata-rata bulanan). Untuk melakukan agregasi seperti itu, kita akan beralih ke metode .resample() pada bagian berikutnya.
Meskipun .asfreq() berguna untuk menampilkan data deret waktu pada frekuensi berbeda, metode .resample() adalah alat pilihan saat melakukan agregasi bersamaan dengan resampling.
Metode .resample() beroperasi mirip dengan .groupby(): metode ini mengelompokkan data dalam interval waktu tertentu lalu menerapkan satu atau beberapa fungsi ke setiap grup. Hasil fungsi-fungsi tersebut ditetapkan ke tanggal baru dalam interval itu.
Kita menggunakan .resample() baik untuk upsampling (mengisi atau menginterpolasi data yang hilang) maupun downsampling (mengagregasikan data).
Mari kita tinjau kembali konversi per jam untuk melihat bagaimana upsampling bekerja dengan .resample(). Menerapkan .resample() mengembalikan objek Resampler, yang kemudian dapat kita terapkan metode lain untuk memperoleh DataFrame.
print(df.resample('H'))DatetimeIndexResampler [freq=<Hour>, axis=0, closed=left, label=left, convention=start, origin=start_day]Terkait upsampling, metode .resample() dapat melakukan tugas yang sama seperti .asfreq().
df.mean_temp.resample('H').asfreq()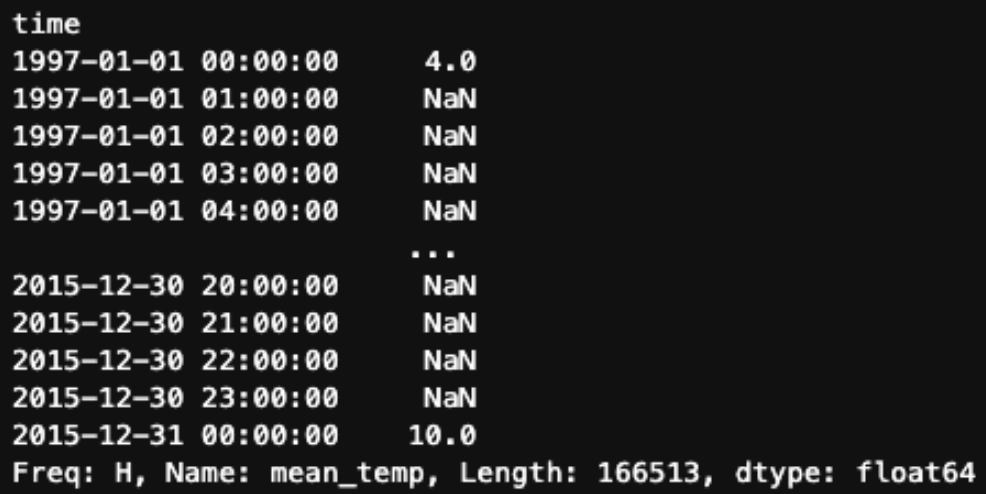
Kita juga dapat menerapkan strategi pengisian dan interpolasi yang sama seperti yang kita gunakan dengan .asfreq(). Misalnya, untuk menggunakan forward fill:
df.mean_temp.resample('H').ffill()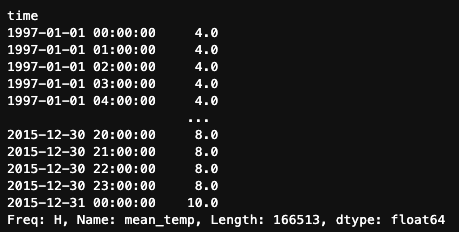
Namun .resample() juga menawarkan metode tambahan yang tidak tersedia pada .asfreq(). Misalnya, kita bisa menggunakan metode .interpolate(), yang memperkirakan nilai pada titik waktu baru dengan mencari titik di sepanjang garis lurus di antara titik data yang ada.
df.mean_temp.resample('H').interpolate()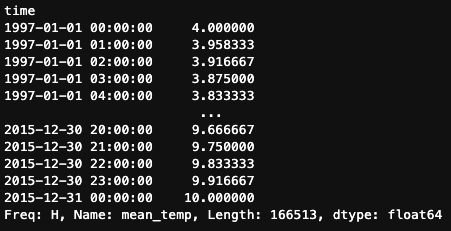
Metode .resample() benar-benar unggul saat melakukan downsampling, karena memungkinkan kita menerapkan berbagai metode agregasi untuk meringkas data. Sebagai contoh, mari hitung suhu rata-rata bulanan dan median triwulanan untuk Madrid menggunakan .resample().
df.mean_temp.resample('M').mean()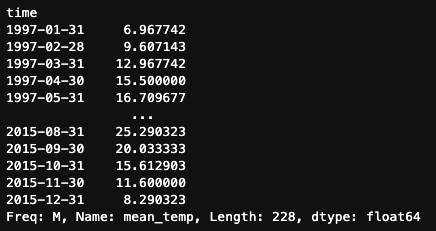
df.mean_temp.resample('Q').median()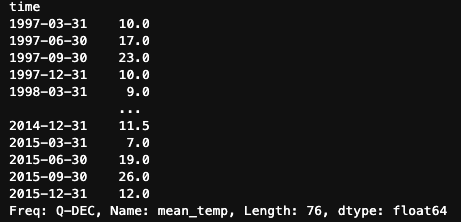
Di luar operasi dasar yang telah kita bahas, metode resampling Pandas juga dapat menangani skenario yang lebih maju. Mari jelajahi beberapa yang paling umum.
Resampling memungkinkan kita membuat deret waktu baru dengan frekuensi yang disesuaikan dengan kebutuhan spesifik kita. Beberapa frekuensi yang umum digunakan meliputi:
W: Frekuensi mingguan (berakhir pada Minggu)M: Frekuensi akhir bulanQ: Frekuensi akhir kuartalH: Frekuensi per jamNamun, Pandas menawarkan jauh lebih banyak opsi tergantung kebutuhan kita. Kita dapat menentukan frekuensi berdasarkan tanggal mulai atau akhir, menggunakan hari kerja alih-alih hari kalender, atau bahkan membuat frekuensi yang sepenuhnya kustom.
df.mean_temp.resample('M').mean() # calendar month end
df.mean_temp.resample('MS').mean() # calendar month start
df.mean_temp.resample('BM').mean() # business calendar end
df.mean_temp.resample('BMS').mean() # business calendar startSeperti metode groupby(), .resample() memungkinkan kita menerapkan beberapa agregasi secara bersamaan. Kita dapat menggunakan metode .agg() dan melewatkan daftar fungsi agregasi, seperti mean, median, dan standar deviasi.
df.mean_temp.resample('M').agg(['mean','median','std'])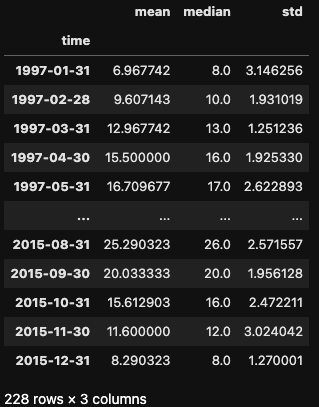
Pandas sangat dioptimalkan untuk menangani dataset besar, tetapi seiring bertambahnya ukuran DataFrame, pemrosesan dan manipulasi dapat menjadi menuntut secara komputasi. Ini terutama berlaku saat upsampling. Bayangkan meresampling deret waktu per jam menjadi per detik – DataFrame yang dihasilkan bisa sangat besar!
Jika kita menghadapi masalah kinerja dengan dataset besar, kita dapat menggunakan strategi berikut:
Untungnya, pandas versi 2.0 dan lebih baru memasukkan teknik canggih untuk pemrosesan yang lebih efisien. Anda dapat mempelajarinya lebih lanjut dalam artikel tentang Pandas 2.0.
Resampling adalah teknik mendasar dalam analisis deret waktu, memungkinkan kita menyesuaikan frekuensi data dengan mengagregasi (downsampling) atau menginterpolasi (upsampling) nilai. Kita telah melihat bagaimana pandas menyediakan alat yang andal seperti .asfreq() dan .resample() untuk membuat proses ini intuitif dan efisien.
Untuk memperdalam pemahaman Anda tentang resampling dan manipulasi deret waktu di Python, lihat sumber daya berikut:
Pelajari lebih lanjut tentang deret waktu melalui kursus-kursus ini!
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



