
Cursus
Machine Learning voor tijdreeksgegevens in Python
4 uur
54.1K
Tijd is een fundamentele dimensie in data-analyse. In de loop der tijd kunnen waarden schommelen, een trend volgen of stabiel blijven. Als we analyseren hoe data in de tijd verandert, werken we met tijdreeksen.
Een veelvoorkomende taak in tijdreeksanalyse is het aanpassen van de frequentie van datums en tijdstippen in onze data, een techniek die bekendstaat als resampling. In deze tutorial maken we gebruik van Pandas, een bibliotheek met krachtige tools voor intuïtieve en efficiënte bewerking van tijdreeksen.
We beginnen met de basis en bouwen geleidelijk op naar meer geavanceerde resamplingtechnieken. We geven praktische voorbeelden en delen best practices om ervoor te zorgen dat onze tijdreeksanalyse effectief en performant is.
Wil je meer leren over tijdreeksen? Bekijk dan deze cursus over het manipuleren van seriedata in Python.
Net zoals we data op categorie kunnen groeperen, laat resampling ons data groeperen in verschillende tijdsintervallen. Dit is waardevol voor zowel datacleaning als diepgaande tijdreeksanalyse. Zo kan het nodig zijn om twee tijdreeksen op een gemeenschappelijke frequentie uit te lijnen voordat we ze vergelijken.
Er zijn twee primaire typen resampling:
We kunnen resampling in pandas uitvoeren met twee hoofdmethodes: .asfreq() en .resample().
Om deze methodes te gebruiken, importeren we eerst de pandas-bibliotheek met de conventionele alias pd. We importeren ook matplotlib om de resultaten te visualiseren.
import pandas as pd
import matplotlib.pyplot as plt
Laten we beginnen met de .asfreq()-methode. Deze methode zet een tijdreeks om naar een opgegeven frequentie en geeft de oorspronkelijke data terug, uitgelijnd met een nieuwe index op die frequentie.
We werken met een dataset met dagelijkse temperatuurmetingen in Madrid van 1997 tot 2015. Laten we starten met wat preprocessing-stappen voordat we in resampling duiken.
url = 'https://raw.githubusercontent.com/jcanalesluna/courses_materials/master/datasets/Madrid%20Daily%20Weather%201997-2015.csv'
df = pd.read_csv(url, usecols=['CET', 'Max TemperatureC', 'Mean TemperatureC', 'Min TemperatureC'])

# Change column names
df.columns = ['time', 'max_temp', 'mean_temp', 'min_temp']

# Convert string column to datetime
df['time'] = pd.to_datetime(df['time'])

# Set time column as index
df = df.set_index('time')

df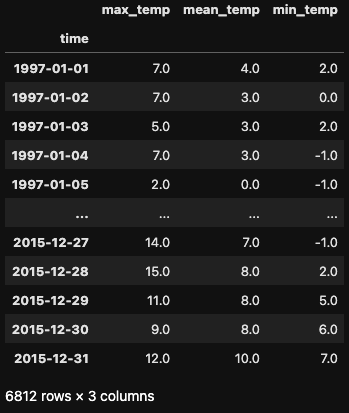
Om upsampling te illustreren: stel dat we onze dagelijkse temperatuurmetingen willen omzetten naar uurlijkse metingen. Dat kan met de methode .asfreq() en de parameter freq='H'.
df_hour = df.asfreq('H')
df_hour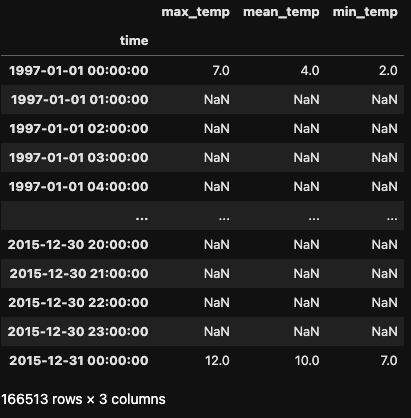
De resulterende dataset is aanzienlijk groter, omdat er nieuwe rijen zijn aangemaakt met uurlijkse in plaats van dagelijkse data. Standaard neemt .asfreq() de eerste vermelding in de oorspronkelijke index en vult de resterende uren met null-waarden.
De resulterende dataset is aanzienlijk groter, want er zijn nieuwe rijen aangemaakt met uurlijkse data in plaats van dagelijkse data. Standaard neemt .asfreq() de eerste vermelding in de oorspronkelijke index en maakt null-waarden voor de resterende uren.
Pandas biedt drie strategieën om deze null-waarden te vullen:
ffill): Zet de laatste geldige observatie door naar voren.bfill): Gebruikt de eerstvolgende geldige observatie om het gat te vullen.De eerste twee strategieën gebruik je via de parameter method in de .asfreq()-methode, terwijl je voor de vaste waarde de parameter fill_value gebruikt.
df_mean_temp = df[['mean_temp']]
df_mean_temp_hour= df_mean_temp.asfreq('H')

df_mean_temp_hour['ffill'] = df_mean_temp.asfreq('H', method='ffill')
df_mean_temp_hour['bfill'] = df_mean_temp.asfreq('H', method='bfill')
df_mean_temp_hour['value'] = df_mean_temp.asfreq('H', fill_value=0)
df_mean_temp_hour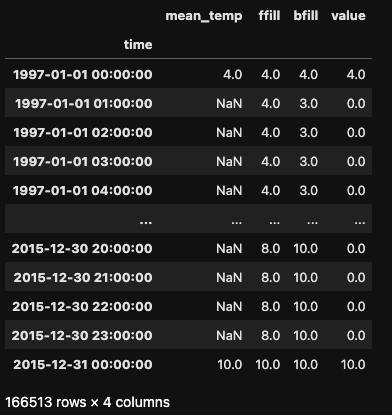
Laten we nu downsampling verkennen. Stel dat we de dagelijkse frequentie willen omzetten naar een maandelijkse. Dat kan met .asfreq() en de parameter freq='M'.
In dit geval verlagen we de frequentie van onze data, van dagelijks naar maandelijks. De resulterende DataFrame heeft slechts 228 rijen, vergeleken met de 6.812 in de oorspronkelijke DataFrame.
df_month = df.asfreq(freq='M')
df_month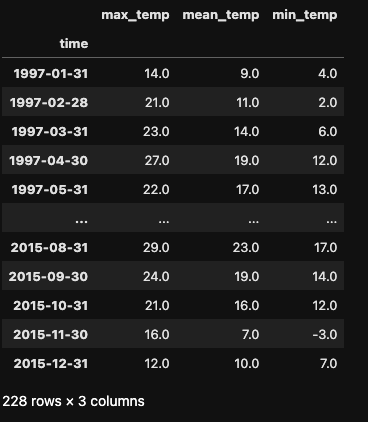
Merk op dat .asfreq() simpelweg de laatste dag van elke maand pakt en die waarde gebruikt om de hele maand te representeren. Er wordt geen aggregatie uitgevoerd (zoals het berekenen van de gemiddelde maandtemperatuur). Voor zulke aggregaties schakelen we in de volgende sectie over op de methode .resample().
Hoewel .asfreq() handig is om tijdreeksdata in een andere frequentie weer te geven, is de methode .resample() de aangewezen tool wanneer je tijdens het resamplen ook wilt aggregeren.
De methode .resample() werkt vergelijkbaar met .groupby(): ze groepeert data binnen een opgegeven tijdsinterval en past vervolgens één of meer functies toe op elke groep. Het resultaat van die functies wordt toegewezen aan een nieuwe datum binnen dat interval.
We gebruiken .resample() zowel voor upsampling (missende data vullen of interpoleren) als voor downsampling (data aggregeren).
Laten we onze uurlijkse conversie opnieuw bekijken om te zien hoe upsampling met .resample() werkt. Het toepassen van .resample() geeft een Resampler-object terug, waarop we vervolgens een andere methode kunnen toepassen om een DataFrame te verkrijgen.
print(df.resample('H'))DatetimeIndexResampler [freq=<Hour>, axis=0, closed=left, label=left, convention=start, origin=start_day]Wat upsampling betreft, kan de methode .resample() dezelfde taken uitvoeren als .asfreq().
df.mean_temp.resample('H').asfreq()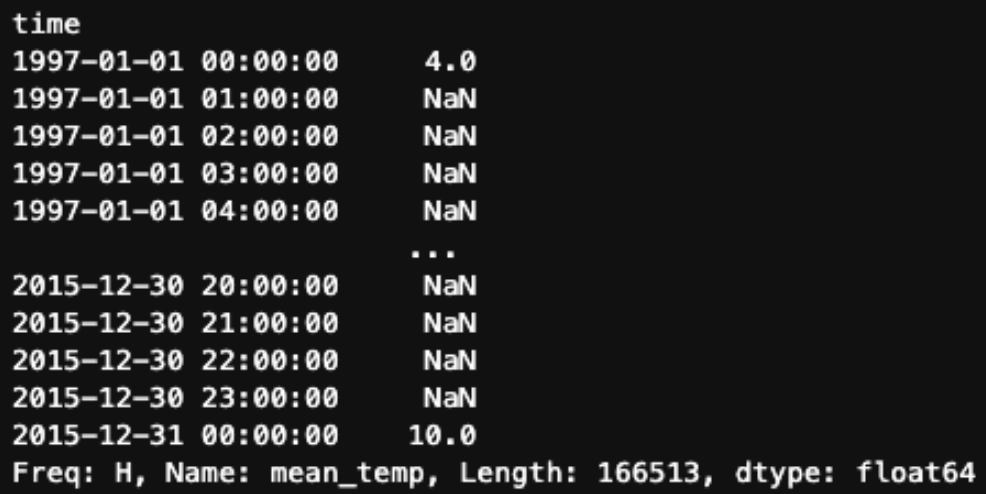
We kunnen ook dezelfde vul- en interpolatiestrategieën toepassen die we met .asfreq() gebruikten. Bijvoorbeeld, om forward fill te gebruiken:
df.mean_temp.resample('H').ffill()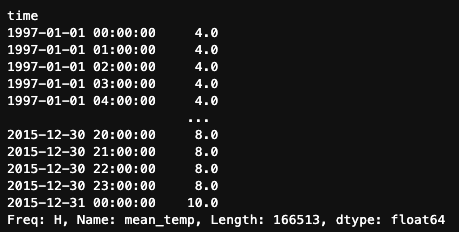
Maar .resample() biedt ook extra methodes die niet beschikbaar zijn met .asfreq(). Zo kunnen we de methode .interpolate() gebruiken, die waarden schat op nieuwe tijdspunten door punten op een rechte lijn tussen bestaande datapunten te vinden.
df.mean_temp.resample('H').interpolate()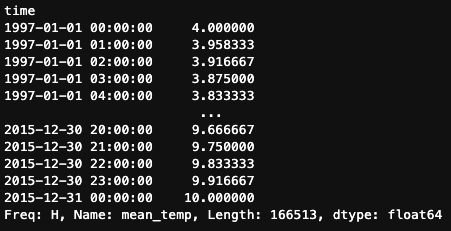
De methode .resample() komt vooral tot zijn recht bij downsampling, omdat we verschillende aggregatiemethodes kunnen toepassen om onze data samen te vatten. Laten we bijvoorbeeld zowel de maandelijkse gemiddelde als de kwartaal-medianetemperaturen voor Madrid berekenen met .resample().
df.mean_temp.resample('M').mean()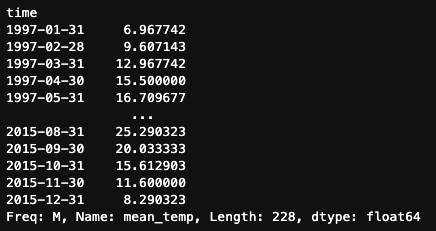
df.mean_temp.resample('Q').median()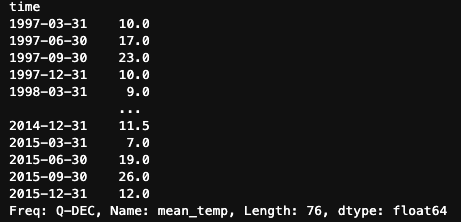
Naast de basisbewerkingen die we hebben behandeld, kunnen de resamplingmethodes van Pandas ook meer geavanceerde scenario’s aan. Laten we enkele van de meest voorkomende bekijken.
Met resampling kunnen we een nieuwe tijdreeks maken met een frequentie die is afgestemd op onze specifieke behoeften. Enkele veelgebruikte frequenties zijn:
W: Wekelijkse frequentie (eindigend op zondag)M: Maandeinde-frequentieQ: Kwarteinde-frequentieH: Uurlijkse frequentiePandas biedt echter nog veel meer opties, afhankelijk van onze vereisten. We kunnen frequenties definiëren op basis van begin- of einddatums, werkdagen gebruiken in plaats van kalenderdagen, of zelfs volledig aangepaste frequenties maken.
df.mean_temp.resample('M').mean() # calendar month end
df.mean_temp.resample('MS').mean() # calendar month start
df.mean_temp.resample('BM').mean() # business calendar end
df.mean_temp.resample('BMS').mean() # business calendar startNet als de groupby()-methode laat .resample() ons meerdere aggregaties tegelijkertijd toepassen. We kunnen de methode .agg() gebruiken en een lijst met aggregatiefuncties doorgeven, zoals mean, median en standard deviation.
df.mean_temp.resample('M').agg(['mean','median','std'])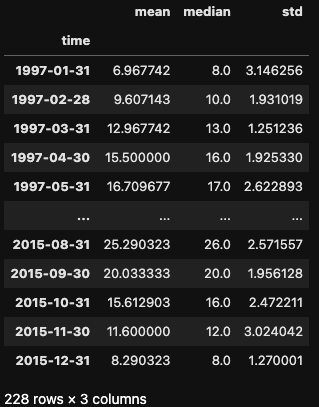
Pandas is sterk geoptimaliseerd voor grote datasets, maar naarmate onze DataFrames groeien, kan verwerking en manipulatie rekenintensief worden. Dit geldt vooral bij upsampling. Stel je voor dat je een uurlijke tijdreeks naar seconden resampled – de resulterende DataFrame kan enorm worden!
Als we prestatieproblemen tegenkomen bij grote datasets, kunnen we deze strategieën gebruiken:
Gelukkig bevatten pandas-versies 2.0 en later geavanceerde technieken voor efficiëntere verwerking. Je kunt hier meer over lezen in dit artikel over Pandas 2.0.
Resampling is een fundamentele techniek in tijdreeksanalyse waarmee we de frequentie van onze data kunnen aanpassen door waarden te aggregeren (downsampling) of te interpoleren (upsampling). We hebben gezien hoe pandas krachtige tools biedt, zoals .asfreq() en .resample(), om dit proces intuïtief en efficiënt te maken.
Wil je je begrip van resampling en het manipuleren van tijdreeksen in Python verdiepen? Bekijk dan deze resources:
Leer meer over tijdreeksen met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

