
Kurs
Python ile Zaman Serisi Verileri için Machine Learning
4 sa
54.1K
Zaman, veri analizinde temel bir boyuttur. Zamanla değerler dalgalanabilir, eğilim gösterebilir veya sabit kalabilir. Verilerin zaman içinde nasıl değiştiğini analiz ettiğimizde, zaman serileriyle çalışıyoruz.
Zaman serisi analizinde yaygın bir görev, verilerimizdeki tarih ve saatlerin sıklığını ayarlamaktır; buna yeniden örnekleme denir. Bu eğitimde, sezgisel ve verimli zaman serisi işlemleri için güçlü araçlar sunan Pandas kütüphanesinden yararlanacağız.
Temelden başlayıp kademeli olarak daha gelişmiş yeniden örnekleme tekniklerine ilerleyeceğiz. Uygulamalı örnekler sağlayacak ve zaman serisi analizimizin etkili ve performanslı olmasını sağlamak için en iyi uygulamaları paylaşacağız.
Zaman serileri hakkında daha fazla bilgi edinmek isterseniz, Python'da seri verileri işleme kursuna göz atın.
Verileri kategoriye göre gruplayabildiğimiz gibi, yeniden örnekleme de verileri farklı zaman aralıklarına göre gruplamamıza olanak tanır. Bu hem veri temizliği hem de derinlemesine zaman serisi analizi için değerlidir. Örneğin, iki zaman serisini karşılaştırmadan önce ortak bir sıklığa hizalamamız gerekebilir.
İki temel yeniden örnekleme türü vardır:
Pandas ile yeniden örneklemeyi iki ana yöntemle gerçekleştirebiliriz: .asfreq() ve .resample().
Bu yöntemleri kullanmaya başlamak için önce pandas kütüphanesini geleneksel pd kısaltmasıyla içe aktarmalıyız. Sonuçları görselleştirmek için matplotlib'i de içe aktaracağız.
import pandas as pd
import matplotlib.pyplot as plt
Önce .asfreq() yöntemiyle başlayalım. Bu yöntem, bir zaman serisini belirtilen bir sıklığa dönüştürerek orijinal verileri o sıklıktaki yeni bir indeksle hizalar ve geri döndürür.
1997'den 2015'e kadar Madrid'deki günlük sıcaklık ölçümlerini içeren bir veri kümesiyle çalışacağız. Yeniden örneklemeye geçmeden önce bazı ön işleme adımlarıyla başlayalım.
url = 'https://raw.githubusercontent.com/jcanalesluna/courses_materials/master/datasets/Madrid%20Daily%20Weather%201997-2015.csv'
df = pd.read_csv(url, usecols=['CET', 'Max TemperatureC', 'Mean TemperatureC', 'Min TemperatureC'])

# Change column names
df.columns = ['time', 'max_temp', 'mean_temp', 'min_temp']

# Convert string column to datetime
df['time'] = pd.to_datetime(df['time'])

# Set time column as index
df = df.set_index('time')

df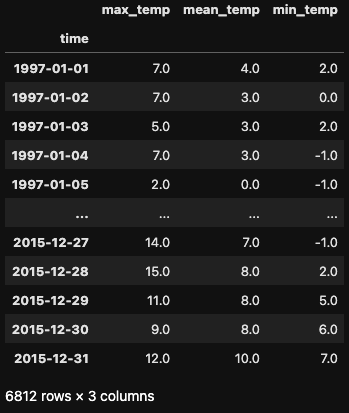
Üst örneklemeyi göstermek için, günlük sıcaklık ölçümlerimizi saatlik ölçümlere dönüştürmek istediğimizi hayal edin. Bunu freq='H' parametresiyle .asfreq() yöntemini kullanarak gerçekleştirebiliriz.
df_hour = df.asfreq('H')
df_hour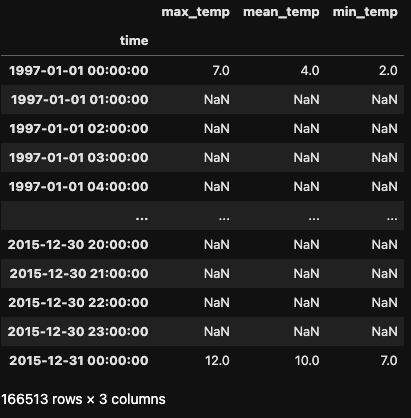
Ortaya çıkan veri kümesi belirgin şekilde daha büyüktür; çünkü günlük yerine saatlik verilerle yeni satırlar oluşturulmuştur. Varsayılan olarak .asfreq(), orijinal indeksin ilk girişini alır ve kalan saatleri boş (null) değerlerle doldurur.
Ortaya çıkan veri kümesi hayli büyüktür; zira günlük veri yerine saatlik verilerle yeni satırlar oluşturulmuştur. Varsayılan olarak .asfreq(), orijinal indeksin ilk girişini alır ve kalan saatler için boş değerler oluşturur.
Pandas bu boş değerleri doldurmak için üç strateji sunar:
ffill): Son geçerli gözlemi ileriye taşır.bfill): Boşluğu doldurmak için bir sonraki geçerli gözlemi kullanır.İlk iki strateji .asfreq() yöntemindeki method parametresiyle, sabit değerle doldurma ise fill_value parametresiyle uygulanır.
df_mean_temp = df[['mean_temp']]
df_mean_temp_hour= df_mean_temp.asfreq('H')

df_mean_temp_hour['ffill'] = df_mean_temp.asfreq('H', method='ffill')
df_mean_temp_hour['bfill'] = df_mean_temp.asfreq('H', method='bfill')
df_mean_temp_hour['value'] = df_mean_temp.asfreq('H', fill_value=0)
df_mean_temp_hour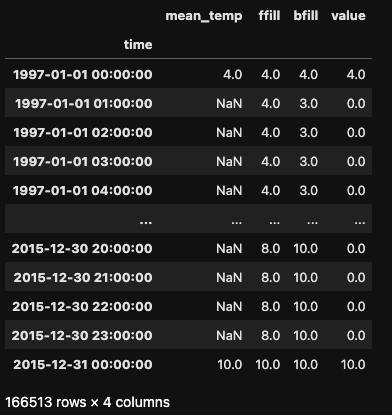
Şimdi alt örneklemeyi inceleyelim. Diyelim ki günlük sıklığı aylığa çevirmek istiyoruz. Bunu freq='M' paramresiyle .asfreq() kullanarak yapabiliriz.
Bu durumda verimizin sıklığını azaltıyoruz; günlükten aylığa geçiyoruz. Ortaya çıkan DataFrame, orijinalindeki 6.812 satıra kıyasla yalnızca 228 satıra sahiptir.
df_month = df.asfreq(freq='M')
df_month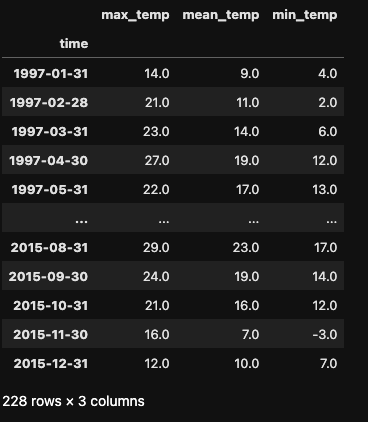
.asfreq()'in her ayın son gününü seçip tüm ayı temsil etmesi için o günün değerini kullandığına dikkat edin. Herhangi bir toplama (ör. aylık ortalama sıcaklığın hesaplanması) yapılmaz. Bu tür toplamalari gerçekleştirmek için bir sonraki bölümde .resample() yöntemine geçeceğiz.
.asfreq() zaman serilerini farklı bir sıklıkta görüntülemek için kullanışlı olsa da, yeniden örnekleme ile birlikte toplama işlemleri yapacağımız zaman tercih edilen araç .resample() yöntemidir.
.resample() yöntemi, .groupby() ile oldukça benzer şekilde çalışır: verileri belirtilen bir zaman aralığı içinde gruplar ve her gruba bir veya daha fazla fonksiyon uygular. Bu fonksiyonların sonucu, o aralık içindeki yeni bir tarihe atanır.
.resample()'ı hem üst örnekleme (eksik verileri doldurma veya enterpolasyon) hem de alt örnekleme (verileri toplama) için kullanırız.
Üst örneklemenin .resample() ile nasıl çalıştığını görmek için saatlik dönüştürme örneğimize geri dönelim. .resample() uygulamak bir Resampler nesnesi döndürür; ardından bir DataFrame elde etmek için bu nesneye başka bir yöntem uygulayabiliriz.
print(df.resample('H'))DatetimeIndexResampler [freq=<Hour>, axis=0, closed=left, label=left, convention=start, origin=start_day]Üst örnekleme açısından, .resample() yöntemi .asfreq() ile aynı görevleri yerine getirebilir.
df.mean_temp.resample('H').asfreq()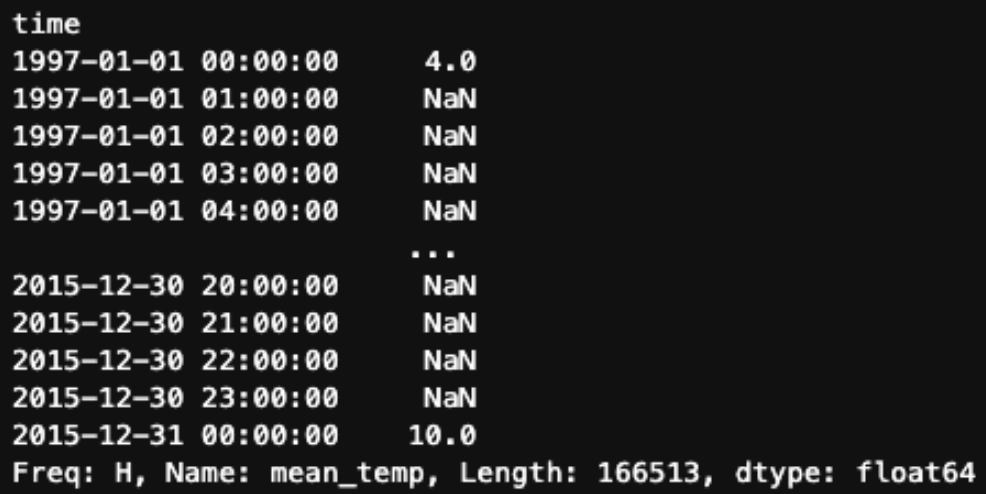
Ayrıca .asfreq() ile kullandığımız aynı doldurma ve enterpolasyon stratejilerini de uygulayabiliriz. Örneğin, ileri doldurma kullanmak için:
df.mean_temp.resample('H').ffill()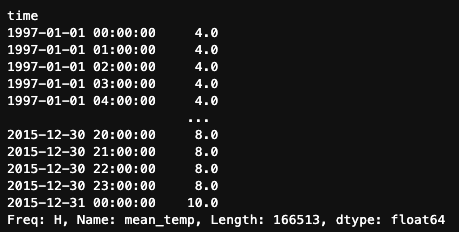
Ancak .resample(), .asfreq()'de bulunmayan ek yöntemler de sunar. Örneğin, mevcut veri noktaları arasındaki doğrusal çizgi boyunca noktalar bularak yeni zaman noktalarındaki değerleri tahmin eden .interpolate() yöntemini kullanabiliriz.
df.mean_temp.resample('H').interpolate()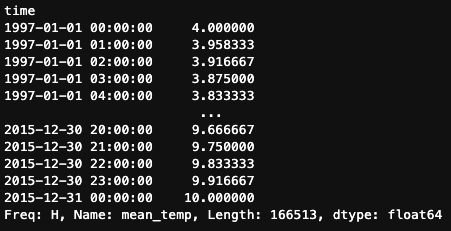
.resample() yöntemi özellikle alt örneklemede öne çıkar; çünkü verilerimizi özetlemek için çeşitli toplama yöntemleri uygulamamıza olanak tanır. Örneğin, .resample() kullanarak Madrid için hem aylık ortalama hem de üç aylık medyan sıcaklıkları hesaplayalım.
df.mean_temp.resample('M').mean()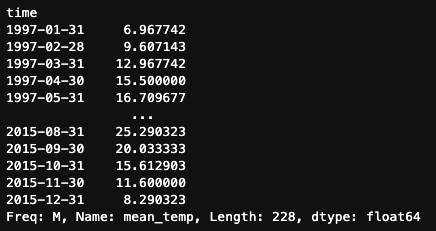
df.mean_temp.resample('Q').median()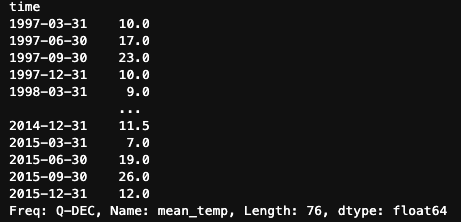
Ele aldığımız temel işlemlerin ötesinde, Pandas yeniden örnekleme yöntemleri daha gelişmiş senaryoları da yönetebilir. En yaygın olanlardan bazılarını inceleyelim.
Yeniden örnekleme, ihtiyaçlarımıza göre uyarlanmış bir sıklığa sahip yeni bir zaman serisi oluşturmamıza olanak tanır. Yaygın kullanılan bazı sıklıklar şunlardır:
W: Haftalık sıklık (Pazar günü biter)M: Ay sonu sıklığıQ: Çeyrek sonu sıklığıH: Saatlik sıklıkBununla birlikte, gereksinimlerimize bağlı olarak Pandas çok daha fazla seçenek sunar. Başlangıç veya bitiş tarihlerine göre sıklık tanımlayabilir, takvim günleri yerine iş günleri kullanabilir veya tamamen özel sıklıklar oluşturabiliriz.
df.mean_temp.resample('M').mean() # calendar month end
df.mean_temp.resample('MS').mean() # calendar month start
df.mean_temp.resample('BM').mean() # business calendar end
df.mean_temp.resample('BMS').mean() # business calendar startgroupby() yöntemi gibi, .resample() da aynı anda birden çok toplama uygulamamıza olanak tanır. .agg() yöntemini kullanıp mean, median ve standart sapma gibi toplama fonksiyonlarının bir listesini geçebiliriz.
df.mean_temp.resample('M').agg(['mean','median','std'])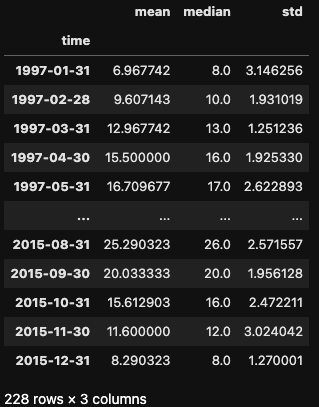
Pandas büyük veri kümelerini işlemek için oldukça optimize edilmiştir; ancak DataFrame boyutlarımız büyüdükçe, işleme ve manipülasyon hesaplama açısından zorlayıcı hale gelebilir. Bu, özellikle üst örnekleme sırasında geçerlidir. Saatlik bir zaman serisini saniyeye yeniden örneklediğinizi düşünün – ortaya çıkan DataFrame devasa olabilir!
Büyük veri kümelerinde performans sorunlarıyla karşılaşırsak şu stratejileri kullanabiliriz:
Neyse ki pandas 2.0 ve sonraki sürümler, daha verimli işleme için gelişmiş teknikler içerir. Pandas 2.0 hakkındaki bu makalede daha fazlasını öğrenebilirsiniz.
Yeniden örnekleme, zaman serisi analizinde temel bir tekniktir ve verilerimizin sıklığını, değerleri toplayarak (alt örnekleme) veya enterpole ederek (üst örnekleme) ayarlamamızı sağlar. Bu süreci sezgisel ve verimli hale getiren .asfreq() ve .resample() gibi güçlü araçlar sunduğunu gördük.
Python'da yeniden örnekleme ve zaman serisi manipülasyonu konusundaki bilginizi derinleştirmek için şu kaynaklara göz atın:
Bu kurslarla zaman serileri hakkında daha fazla bilgi edinin!
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




