Kurs
Maschinelles Lernen für Zeitreihendaten in Python
4 Std.
54.3K
Zeit ist eine zentrale Dimension in der Datenanalyse. Im Zeitverlauf können Werte schwanken, Trends zeigen oder stabil bleiben. Analysieren wir, wie sich Daten über die Zeit verändern, arbeiten wir mit Zeitreihen.
Eine häufige Aufgabe in der Zeitreihenanalyse ist das Anpassen der Datums- und Zeitfrequenz in unseren Daten – das sogenannte Resampling. In diesem Tutorial nutzen wir Pandas, eine Bibliothek mit leistungsfähigen Tools für eine intuitive und effiziente Arbeit mit Zeitreihen.
Wir starten mit den Grundlagen und steigern uns Schritt für Schritt zu fortgeschrittenen Resampling-Techniken. Dazu gibt es praxisnahe Beispiele und Best Practices, damit deine Zeitreihenanalyse wirksam und performant ist.
Wenn du tiefer in Zeitreihen einsteigen willst, schau dir diesen Kurs zum Arbeiten mit Zeitreihendaten in Python an.
Ähnlich wie wir Daten nach Kategorien gruppieren können, erlaubt uns Resampling, Daten in unterschiedliche Zeitintervalle zu gruppieren. Das ist sowohl für Datenbereinigung als auch für die tiefergehende Zeitreihenanalyse wertvoll. Beispielsweise müssen wir zwei Zeitreihen oft vor einem Vergleich auf eine gemeinsame Frequenz bringen.
Es gibt zwei grundlegende Arten des Resamplings:
In pandas stehen uns zwei Hauptmethoden für Resampling zur Verfügung: .asfreq() und .resample().
Bevor wir loslegen, importieren wir zunächst die Bibliothek pandas unter dem üblichen Alias pd. Außerdem laden wir matplotlib, um Ergebnisse zu visualisieren.
import pandas as pd
import matplotlib.pyplot as plt
Beginnen wir mit der Methode .asfreq(). Sie konvertiert eine Zeitreihe in eine angegebene Frequenz und gibt die Originaldaten mit einem neuen Index in dieser Frequenz zurück.
Wir arbeiten mit einem Datensatz täglicher Temperaturmessungen in Madrid von 1997 bis 2015. Vor dem Resampling führen wir ein paar Vorverarbeitungsschritte aus.
url = 'https://raw.githubusercontent.com/jcanalesluna/courses_materials/master/datasets/Madrid%20Daily%20Weather%201997-2015.csv'
df = pd.read_csv(url, usecols=['CET', 'Max TemperatureC', 'Mean TemperatureC', 'Min TemperatureC'])

# Change column names
df.columns = ['time', 'max_temp', 'mean_temp', 'min_temp']

# Convert string column to datetime
df['time'] = pd.to_datetime(df['time'])

# Set time column as index
df = df.set_index('time')

df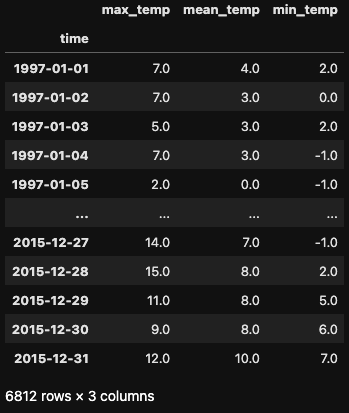
Zum Veranschaulichen des Upsamplings stellen wir uns vor, wir wollen die täglichen Temperaturwerte in stündliche umwandeln. Das erreichen wir mit .asfreq() und dem Parameter freq='H'.
df_hour = df.asfreq('H')
df_hour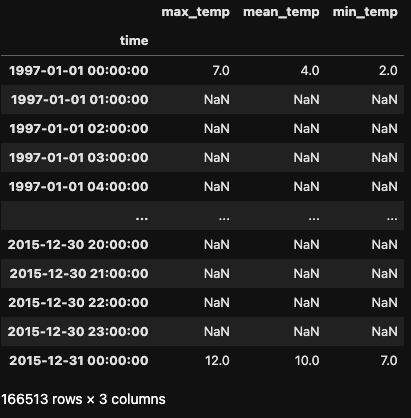
Der resultierende Datensatz ist deutlich größer, da neue Zeilen mit stündlichen statt täglichen Daten entstanden sind. Standardmäßig nimmt .asfreq() den ersten Eintrag im ursprünglichen Index und füllt die übrigen Stunden mit Nullwerten auf.
Der resultierende Datensatz ist somit deutlich umfangreicher, denn statt täglicher liegen nun stündliche Werte vor. Standardmäßig wählt .asfreq() den ersten Indexeintrag und erzeugt für die restlichen Stunden fehlende Werte.
Pandas bietet drei Strategien, um diese fehlenden Werte zu füllen:
ffill): Führt die letzte gültige Beobachtung nach vorne fort.bfill): Nutzt die nächste gültige Beobachtung, um die Lücke zu füllen.Die ersten beiden Strategien setzt du über den Parameter method in .asfreq() um, während der feste Wert mit dem Parameter fill_value angegeben wird.
df_mean_temp = df[['mean_temp']]
df_mean_temp_hour= df_mean_temp.asfreq('H')

df_mean_temp_hour['ffill'] = df_mean_temp.asfreq('H', method='ffill')
df_mean_temp_hour['bfill'] = df_mean_temp.asfreq('H', method='bfill')
df_mean_temp_hour['value'] = df_mean_temp.asfreq('H', fill_value=0)
df_mean_temp_hour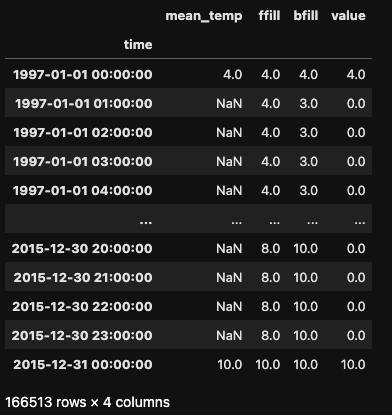
Als nächstes schauen wir uns Downsampling an. Angenommen, wir wollen die tägliche Frequenz in eine monatliche ändern. Das geht mit .asfreq() und dem Parameter freq='M'.
In diesem Fall reduzieren wir die Frequenz der Daten, also von täglich auf monatlich. Der resultierende DataFrame hat nur noch 228 Zeilen gegenüber 6.812 Zeilen im Original.
df_month = df.asfreq(freq='M')
df_month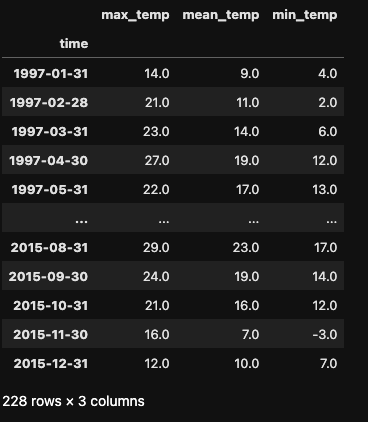
Beachte, dass .asfreq() lediglich den letzten Tag eines Monats auswählt und dessen Wert für den gesamten Monat nutzt. Es findet keine Aggregation statt (z. B. die Berechnung der durchschnittlichen Monatstemperatur). Solche Aggregationen erledigen wir im nächsten Abschnitt mit der Methode .resample().
Während .asfreq() praktisch ist, um Zeitreihen in einer anderen Frequenz anzuzeigen, ist .resample() die erste Wahl, wenn beim Resampling zugleich aggregiert werden soll.
Die Methode .resample() arbeitet ähnlich wie .groupby(): Sie gruppiert Daten innerhalb eines angegebenen Zeitintervalls und wendet dann eine oder mehrere Funktionen auf jede Gruppe an. Das Ergebnis wird einem neuen Datum innerhalb dieses Intervalls zugewiesen.
Wir setzen .resample() sowohl für Upsampling (Füllen oder Interpolieren fehlender Werte) als auch für Downsampling (Aggregieren von Daten) ein.
Werfen wir noch einmal einen Blick auf die stündliche Umwandlung, um zu sehen, wie Upsampling mit .resample() funktioniert. .resample() liefert zunächst ein Resampler-Objekt, auf das wir eine weitere Methode anwenden, um einen DataFrame zu erhalten.
print(df.resample('H'))DatetimeIndexResampler [freq=<Hour>, axis=0, closed=left, label=left, convention=start, origin=start_day]Beim Upsampling kann .resample() im Grunde dasselbe leisten wie .asfreq().
df.mean_temp.resample('H').asfreq()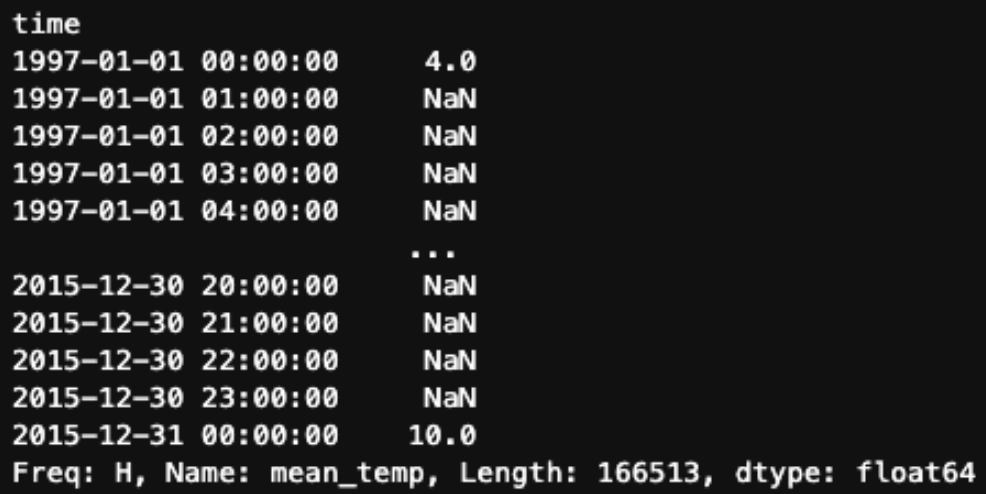
Wir können auch dieselben Füll- und Interpolationsstrategien anwenden wie mit .asfreq(). Beispiel für Forward Fill:
df.mean_temp.resample('H').ffill()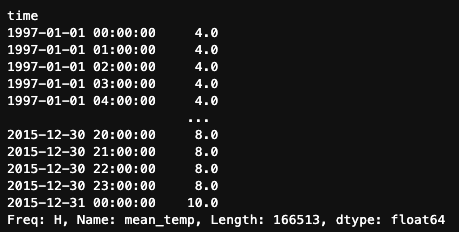
Darüber hinaus bietet .resample() Methoden, die .asfreq() nicht hat. So können wir etwa .interpolate() nutzen, um Werte an neuen Zeitpunkten zu schätzen, indem Zwischenpunkte auf einer Geraden zwischen vorhandenen Datenpunkten bestimmt werden.
df.mean_temp.resample('H').interpolate()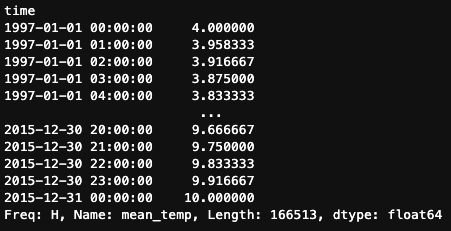
Seine Stärken spielt .resample() vor allem beim Downsampling aus, denn hier lassen sich unterschiedliche Aggregationsmethoden anwenden, um Daten zusammenzufassen. Berechnen wir zum Beispiel die monatlichen Durchschnitts- und die vierteljährlichen Median-Temperaturen für Madrid mit .resample().
df.mean_temp.resample('M').mean()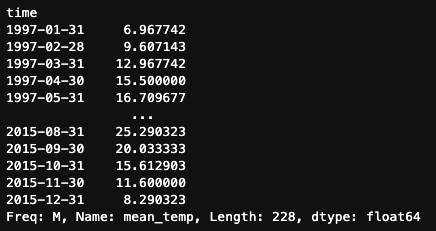
df.mean_temp.resample('Q').median()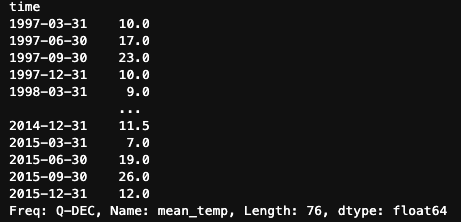
Über die Grundlagen hinaus können die Resampling-Methoden von Pandas auch komplexere Fälle abdecken. Schauen wir uns einige häufige Szenarien an.
Mit Resampling erstellen wir neue Zeitreihen mit genau der Frequenz, die wir brauchen. Gängige Frequenzen sind etwa:
W: Wöchentliche Frequenz (endet am Sonntag)M: MonatsendeQ: QuartalsendeH: StündlichPandas bietet jedoch viele weitere Optionen, je nach Bedarf. Wir können Frequenzen nach Start- oder Endtermin definieren, statt Kalendertagen nur Arbeitstage nutzen oder sogar vollständig eigene Frequenzen erstellen.
df.mean_temp.resample('M').mean() # calendar month end
df.mean_temp.resample('MS').mean() # calendar month start
df.mean_temp.resample('BM').mean() # business calendar end
df.mean_temp.resample('BMS').mean() # business calendar startWie bei groupby() erlaubt .resample() mehrere Aggregationen in einem Schritt. Mit .agg() übergeben wir eine Liste von Funktionen wie mean, median und std.
df.mean_temp.resample('M').agg(['mean','median','std'])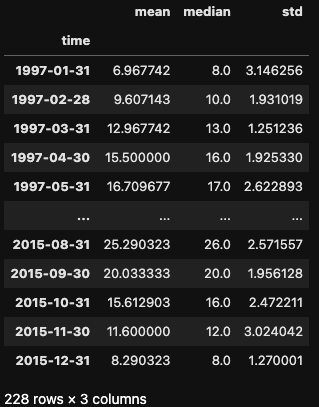
Pandas ist für große Datensätze stark optimiert, doch mit wachsender DataFrame-Größe können Verarbeitung und Manipulation rechenintensiv werden – besonders beim Upsampling. Stell dir vor, du wandelst eine stündliche Zeitreihe in Sekunden um – der resultierende DataFrame kann riesig werden!
Wenn bei großen Datensätzen Performance-Probleme auftreten, helfen diese Strategien:
Ab pandas 2.0 sind außerdem erweiterte Techniken für effizientere Verarbeitung integriert. Mehr dazu in diesem Artikel zu Pandas 2.0.
Resampling ist eine grundlegende Technik der Zeitreihenanalyse. Sie erlaubt es uns, die Datenfrequenz anzupassen, indem wir Werte aggregieren (Downsampling) oder interpolieren (Upsampling). Wir haben gesehen, wie pandas mit .asfreq() und .resample() leistungsstarke Werkzeuge für einen intuitiven und effizienten Workflow bereitstellt.
Wenn du dein Verständnis für Resampling und Zeitreihenmanipulation in Python vertiefen willst, schau dir diese Ressourcen an:
Lerne mehr über Zeitreihen mit diesen Kursen!
Kurs
Kurs
Kurs
Tutorial
Aditya Sharma
5 Min.
Tutorial
Abid Ali Awan
7 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Allan Ouko
11 Min.
Tutorial
Aditya Sharma
7 Min.
Tutorial
DataCamp Team
2 Min.