
Last chance! 50% off DataCamp Premium
Sale ends in
डेटा विश्लेषण में समय एक बुनियादी आयाम है। समय के साथ मान बदल सकते हैं, ट्रेंड कर सकते हैं, या स्थिर रह सकते हैं। जब हम देखते हैं कि समय के साथ डेटा कैसे बदलता है, तो हम टाइम सीरीज़ के साथ काम कर रहे होते हैं।
टाइम सीरीज़ विश्लेषण में एक सामान्य कार्य हमारे डेटा में तिथियों और समयों की फ्रीक्वेंसी को समायोजित करना है, जिसे रिसैम्पलिंग कहा जाता है। इस ट्यूटोरियल में, हम Pandas का उपयोग करेंगे, जो सहज और कुशल टाइम सीरीज़ मैनिपुलेशन के लिए सशक्त टूल प्रदान करता है।
हम मूल बातें से शुरू करेंगे और धीरे-धीरे उन्नत रिसैम्पलिंग तकनीकों की ओर बढ़ेंगे। हम व्यावहारिक उदाहरण देंगे और सर्वोत्तम प्रथाएँ साझा करेंगे ताकि हमारा टाइम सीरीज़ विश्लेषण प्रभावी और प्रदर्शनक्षम रहे।
यदि आप टाइम सीरीज़ के बारे में और सीखना चाहते हैं, तो इस Python में सीरीज़ डेटा मैनिपुलेट करने वाले कोर्स को देखें।
जैसे हम डेटा को श्रेणी के आधार पर समूहित कर सकते हैं, वैसे ही रिसैम्पलिंग हमें डेटा को अलग-अलग समयांतरालों में समूहित करने देती है। यह डेटा क्लीनिंग और गहन टाइम सीरीज़ विश्लेषण दोनों के लिए उपयोगी है। उदाहरण के लिए, तुलना से पहले हमें दो टाइम सीरीज़ को एक समान फ्रीक्वेंसी पर संरेखित करने की आवश्यकता हो सकती है।
रिसैम्पलिंग के दो मुख्य प्रकार हैं:
pandas में हम मुख्यतः दो विधियों से रिसैम्पलिंग कर सकते हैं: .asfreq() और .resample()।
इन विधियों का उपयोग शुरू करने के लिए, पहले हमें प्रचलित pd उपनाम के साथ pandas लाइब्रेरी इम्पोर्ट करनी होगी। हम परिणामों को विज़ुअलाइज़ करने के लिए matplotlib भी इम्पोर्ट करेंगे।
import pandas as pd
import matplotlib.pyplot as plt
आइए .asfreq() मेथड से शुरू करें। यह मेथड किसी टाइम सीरीज़ को निर्दिष्ट फ्रीक्वेंसी में बदलता है और मूल डेटा को उस फ्रीक्वेंसी पर नए इंडेक्स के साथ संरेखित करके लौटाता है।
हम 1997 से 2015 तक मैड्रिड में दैनिक तापमान रिकॉर्ड वाले डेटासेट पर काम करेंगे। रिसैम्पलिंग में जाने से पहले कुछ प्रीप्रोसेसिंग स्टेप्स से शुरुआत करते हैं।
url = 'https://raw.githubusercontent.com/jcanalesluna/courses_materials/master/datasets/Madrid%20Daily%20Weather%201997-2015.csv'
df = pd.read_csv(url, usecols=['CET', 'Max TemperatureC', 'Mean TemperatureC', 'Min TemperatureC'])

# Change column names
df.columns = ['time', 'max_temp', 'mean_temp', 'min_temp']

# Convert string column to datetime
df['time'] = pd.to_datetime(df['time'])

# Set time column as index
df = df.set_index('time')

df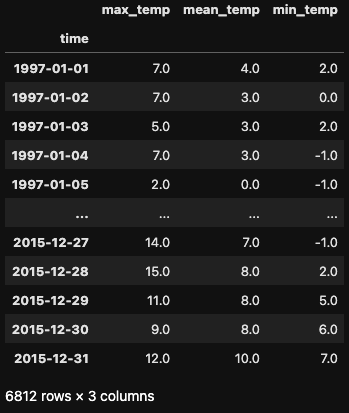
Upsampling को समझाने के लिए मान लें कि हम अपनी दैनिक तापमान रीडिंग्स को प्रति घंटा में बदलना चाहते हैं। यह हम .asfreq() मेथड के साथ पैरामीटर freq='H' देकर कर सकते हैं।
df_hour = df.asfreq('H')
df_hour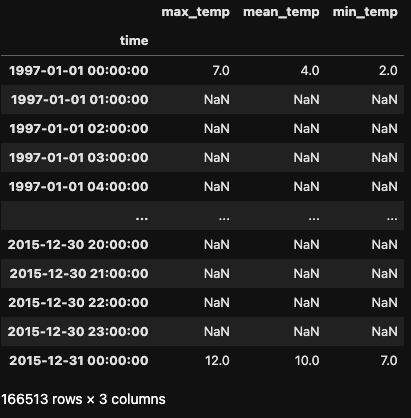
प्राप्त डेटासेट स्पष्ट रूप से बड़ा है, क्योंकि दैनिक के बजाय प्रति घंटा डेटा के साथ नई पंक्तियाँ बनाई गई हैं। डिफ़ॉल्ट रूप से, .asfreq() मूल इंडेक्स की पहली एंट्री लेता है और शेष घंटों को null मानों से भर देता है।
प्राप्त डेटासेट काफ़ी बड़ा हो जाता है, क्योंकि दैनिक डेटा की जगह प्रति घंटा डेटा के लिए नई पंक्तियाँ बनती हैं। डिफ़ॉल्ट रूप से, .asfreq() मूल इंडेक्स की पहली एंट्री लेता है और शेष घंटों के लिए null मान बनाता है।
Pandas इन null मानों को भरने के लिए तीन रणनीतियाँ प्रदान करता है:
ffill): अंतिम वैध ऑब्ज़र्वेशन को आगे की ओर बढ़ाता है।bfill): गैप भरने के लिए अगले वैध ऑब्ज़र्वेशन का उपयोग करता है।पहली दो रणनीतियाँ .asfreq() में method पैरामीटर से लागू होती हैं, जबकि fill value को fill_value पैरामीटर से निर्दिष्ट किया जाता है।
df_mean_temp = df[['mean_temp']]
df_mean_temp_hour= df_mean_temp.asfreq('H')

df_mean_temp_hour['ffill'] = df_mean_temp.asfreq('H', method='ffill')
df_mean_temp_hour['bfill'] = df_mean_temp.asfreq('H', method='bfill')
df_mean_temp_hour['value'] = df_mean_temp.asfreq('H', fill_value=0)
df_mean_temp_hour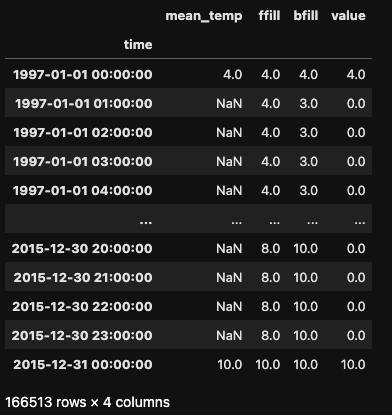
अब डाउनसैम्पलिंग देखते हैं। मान लें कि हम दैनिक फ्रीक्वेंसी को मासिक में बदलना चाहते हैं। यह .asfreq() के साथ पैरामीटर freq='M' देकर किया जा सकता है।
इस स्थिति में, हम अपने डेटा की फ्रीक्वेंसी घटा रहे हैं, यानी दैनिक से मासिक में जा रहे हैं। मूल DataFrame की 6,812 पंक्तियों की तुलना में प्राप्त DataFrame में केवल 228 पंक्तियाँ हैं।
df_month = df.asfreq(freq='M')
df_month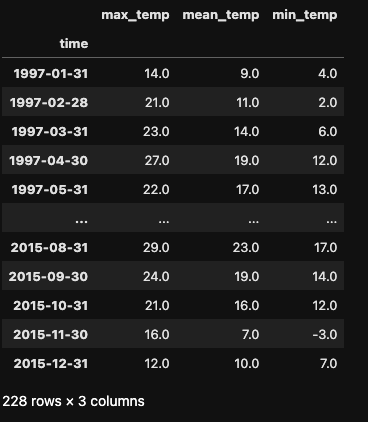
ध्यान दें कि .asfreq() केवल प्रत्येक महीने के अंतिम दिन का चयन करता है और उसके मान को पूरे महीने का प्रतिनिधित्व करने के लिए उपयोग करता है। कोई एग्रीगेशन नहीं होता (जैसे, मासिक औसत तापमान निकालना)। ऐसे एग्रीगेशन करने के लिए हम अगला सेक्शन में .resample() मेथड का उपयोग करेंगे।
जहाँ .asfreq() अलग फ्रीक्वेंसी पर टाइम सीरीज़ दिखाने में उपयोगी है, वहीं रिसैम्पलिंग के साथ एग्रीगेशन करने के लिए .resample() बेहतर टूल है।
.resample() मेथड .groupby() की तरह काम करता है: यह दिए गए समयांतराल के भीतर डेटा को समूहित करता है और फिर प्रत्येक समूह पर एक या अधिक फ़ंक्शन लागू करता है। इन फ़ंक्शनों का परिणाम उस अंतराल के भीतर नई तिथि को सौंपा जाता है।
हम .resample() का उपयोग upsampling (अनुपस्थित डेटा को भरना या इंटरपोलेट करना) और downsampling (डेटा का एग्रीगेशन) दोनों के लिए करते हैं।
आइए अपनी प्रति घंटा कन्वर्ज़न पर लौटें और देखें कि .resample() के साथ upsampling कैसे काम करता है। .resample() लागू करने पर एक Resampler ऑब्जेक्ट मिलता है, जिस पर कोई और मेथड लगाकर हम DataFrame प्राप्त कर सकते हैं।
print(df.resample('H'))DatetimeIndexResampler [freq=<Hour>, axis=0, closed=left, label=left, convention=start, origin=start_day]Upsampling के संदर्भ में, .resample() मेथड .asfreq() के समान कार्य कर सकता है।
df.mean_temp.resample('H').asfreq()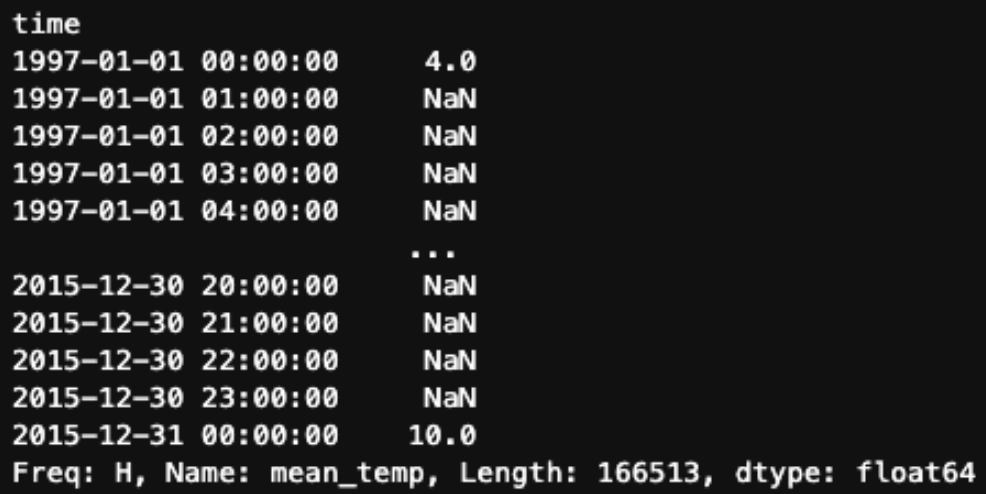
हम वही फ़िलिंग और इंटरपोलेशन रणनीतियाँ भी लागू कर सकते हैं जो हमने .asfreq() के साथ की थीं। उदाहरण के लिए, फॉरवर्ड फ़िल के लिए:
df.mean_temp.resample('H').ffill()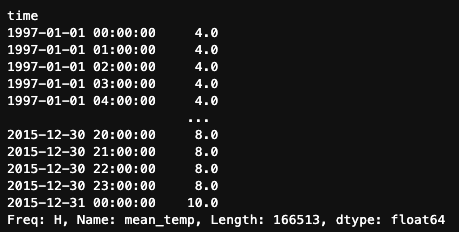
लेकिन .resample() ऐसी अतिरिक्त विधियाँ भी देता है जो .asfreq() में उपलब्ध नहीं हैं। उदाहरण के लिए, हम .interpolate() मेथड का उपयोग कर सकते हैं, जो मौजूदा डेटा पॉइंट्स के बीच सीधी रेखा के साथ नए टाइम पॉइंट्स पर मानों का अनुमान लगाता है।
df.mean_temp.resample('H').interpolate()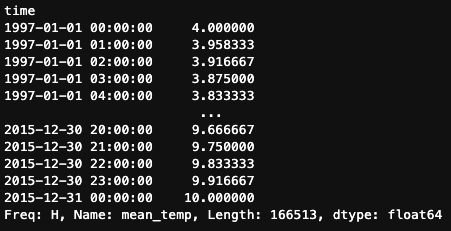
.resample() मेथड डाउनसैम्पलिंग में सच में चमकता है, क्योंकि यह हमारे डेटा का सार प्रस्तुत करने के लिए विभिन्न एग्रीगेशन मेथड्स लगाने देता है। उदाहरण के लिए, आइए .resample() का उपयोग करके मैड्रिड के मासिक औसत और तिमाही माध्यिका तापमान की गणना करें।
df.mean_temp.resample('M').mean()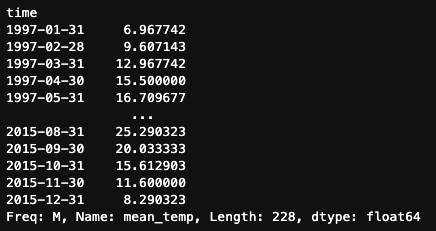
df.mean_temp.resample('Q').median()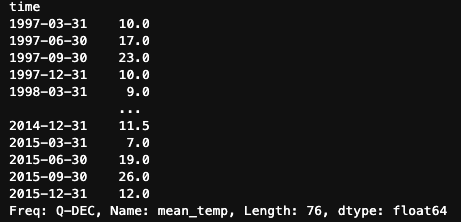
हमने जिन बुनियादी कार्यों को कवर किया है, उनके अलावा Pandas की रिसैम्पलिंग विधियाँ और भी उन्नत परिदृश्यों को संभाल सकती हैं। आइए कुछ सामान्य मामलों को देखें।
रिसैम्पलिंग हमें अपनी आवश्यकता के अनुसार फ्रीक्वेंसी वाली नई टाइम सीरीज़ बनाने देती है। कुछ सामान्य फ्रीक्वेंसियाँ हैं:
W: साप्ताहिक फ्रीक्वेंसी (रविवार पर समाप्त)M: माह-अंत फ्रीक्वेंसीQ: तिमाही-अंत फ्रीक्वेंसीH: प्रति घंटा फ्रीक्वेंसीहालाँकि, हमारी ज़रूरतों के अनुसार Pandas और भी कई विकल्प देता है। हम शुरू या अंत तिथियों के आधार पर फ्रीक्वेंसी परिभाषित कर सकते हैं, कैलेंडर दिनों की जगह बिज़नेस डेज़ का उपयोग कर सकते हैं, या पूरी तरह कस्टम फ्रीक्वेंसी बना सकते हैं।
df.mean_temp.resample('M').mean() # calendar month end
df.mean_temp.resample('MS').mean() # calendar month start
df.mean_temp.resample('BM').mean() # business calendar end
df.mean_temp.resample('BMS').mean() # business calendar startgroupby() मेथड की तरह, .resample() हमें एक साथ कई एग्रीगेशन लागू करने देता है। हम .agg() मेथड का उपयोग करके mean, median और standard deviation जैसी फ़ंक्शनों की सूची दे सकते हैं।
df.mean_temp.resample('M').agg(['mean','median','std'])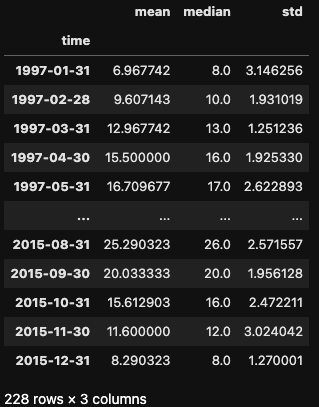
Pandas बड़े डेटासेट्स को संभालने के लिए अत्यधिक अनुकूलित है, लेकिन जैसे-जैसे हमारे DataFrames का आकार बढ़ता है, प्रोसेसिंग और मैनिपुलेशन कंप्यूटेशनल रूप से माँग वाले हो सकते हैं। यह विशेष रूप से upsampling के दौरान सही है। कल्पना करें कि प्रति घंटा टाइम सीरीज़ को सेकंड में रिसैम्पल करना – प्राप्त DataFrame बहुत बड़ा हो सकता है!
यदि बड़े डेटासेट्स के साथ प्रदर्शन संबंधी समस्याएँ आएँ, तो हम ये रणनीतियाँ अपना सकते हैं:
सौभाग्य से, pandas 2.0 और उसके बाद के संस्करण अधिक कुशल प्रोसेसिंग के लिए उन्नत तकनीकों को शामिल करते हैं। आप Pandas 2.0 पर इस लेख में और जान सकते हैं।
रिसैम्पलिंग टाइम सीरीज़ विश्लेषण में एक बुनियादी तकनीक है, जो हमें मानों को एग्रीगेट (डाउनसैम्पलिंग) या इंटरपोलेट (अपसैम्पलिंग) करके डेटा की फ्रीक्वेंसी समायोजित करने देती है। हमने देखा कि pandas .asfreq() और .resample() जैसे सशक्त टूल देता है, जो इस प्रक्रिया को सहज और कुशल बनाते हैं।
Python में रिसैम्पलिंग और टाइम सीरीज़ मैनिपुलेशन की समझ को गहरा करने के लिए, ये संसाधन देखें:
इन कोर्सेज़ के साथ टाइम सीरीज़ के बारे में और जानें!
कोर्स
कोर्स
कोर्स
