Cours
Machine Learning for Time Series Data in Python
4 h
54.3K
Le temps est une dimension fondamentale en analyse de données. Au fil du temps, les valeurs peuvent fluctuer, suivre une tendance ou rester stables. Lorsque nous analysons l’évolution des données dans le temps, nous travaillons sur des séries temporelles.
Une tâche courante en analyse de séries temporelles consiste à ajuster la fréquence des dates et heures dans nos données : c’est le rééchantillonnage. Dans ce tutoriel, nous allons utiliser Pandas, une bibliothèque qui offre des outils puissants pour manipuler les séries temporelles de manière intuitive et efficace.
Nous commencerons par les bases avant de passer progressivement à des techniques de rééchantillonnage plus avancées. Nous proposerons des exemples concrets et des bonnes pratiques pour rendre votre analyse de séries temporelles fiable et performante.
Pour aller plus loin sur les séries temporelles, consultez ce cours sur la manipulation des séries temporelles en Python.
Comme on peut regrouper des données par catégorie, le rééchantillonnage permet de regrouper des données par intervalles de temps. C’est utile aussi bien pour le nettoyage que pour une analyse approfondie des séries temporelles. Par exemple, il peut être nécessaire d’aligner deux séries sur une même fréquence avant de les comparer.
On distingue deux grands types de rééchantillonnage :
On peut rééchantillonner avec pandas à l’aide de deux méthodes principales : .asfreq() et .resample().
Pour commencer, importons la bibliothèque pandas sous l’alias usuel pd. Nous importerons aussi matplotlib pour visualiser les résultats.
import pandas as pd
import matplotlib.pyplot as plt
Commençons par la méthode .asfreq(). Elle convertit une série temporelle vers une fréquence donnée et renvoie les données originales alignées sur un nouvel index à cette fréquence.
Nous allons travailler avec un jeu de données contenant les relevés quotidiens de température à Madrid de 1997 à 2015. Réalisons d’abord quelques étapes de prétraitement avant de passer au rééchantillonnage.
url = 'https://raw.githubusercontent.com/jcanalesluna/courses_materials/master/datasets/Madrid%20Daily%20Weather%201997-2015.csv'
df = pd.read_csv(url, usecols=['CET', 'Max TemperatureC', 'Mean TemperatureC', 'Min TemperatureC'])

# Change column names
df.columns = ['time', 'max_temp', 'mean_temp', 'min_temp']

# Convert string column to datetime
df['time'] = pd.to_datetime(df['time'])

# Set time column as index
df = df.set_index('time')

df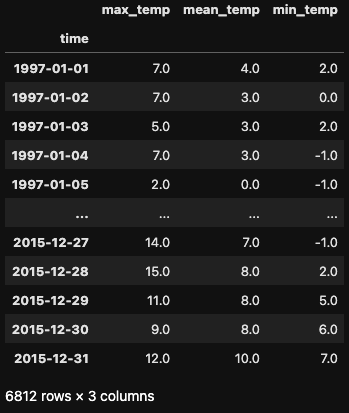
Pour illustrer l’upsampling, imaginons que nous voulions convertir nos relevés quotidiens en relevés horaires. Nous pouvons le faire avec .asfreq() et le paramètre freq='H'.
df_hour = df.asfreq('H')
df_hour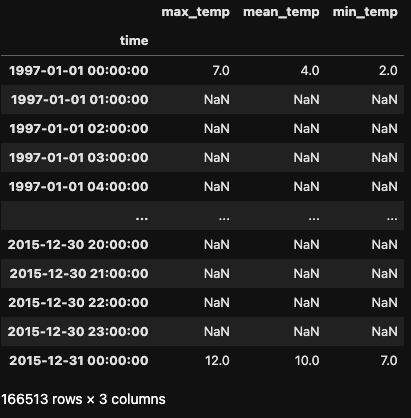
Le jeu de données obtenu est nettement plus volumineux, car de nouvelles lignes horaires ont été créées à la place des lignes quotidiennes. Par défaut, .asfreq() prend la première entrée de l’index d’origine et renseigne les heures restantes avec des valeurs nulles.
Le jeu de données résultant est donc considérablement plus grand : des lignes horaires ont été ajoutées à la place des données quotidiennes. Par défaut, .asfreq() prend la première entrée de l’index d’origine et crée des valeurs nulles pour les heures restantes.
Pandas propose trois stratégies pour renseigner ces valeurs manquantes :
ffill) : propage la dernière observation valide.bfill) : utilise la prochaine observation valide pour combler le manque.Les deux premières stratégies s’appliquent via le paramètre method de .asfreq(), tandis que la valeur de remplacement se définit avec le paramètre fill_value.
df_mean_temp = df[['mean_temp']]
df_mean_temp_hour= df_mean_temp.asfreq('H')

df_mean_temp_hour['ffill'] = df_mean_temp.asfreq('H', method='ffill')
df_mean_temp_hour['bfill'] = df_mean_temp.asfreq('H', method='bfill')
df_mean_temp_hour['value'] = df_mean_temp.asfreq('H', fill_value=0)
df_mean_temp_hour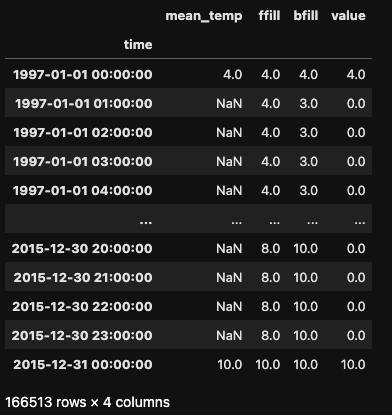
Passons maintenant au downsampling. Supposons que nous voulions passer d’une fréquence quotidienne à une fréquence mensuelle. Nous pouvons y parvenir avec .asfreq() et le paramètre freq='M'.
Dans ce cas, nous réduisons la fréquence des données, en passant du quotidien au mensuel. Le DataFrame obtenu ne compte plus que 228 lignes, contre 6 812 dans le DataFrame d’origine.
df_month = df.asfreq(freq='M')
df_month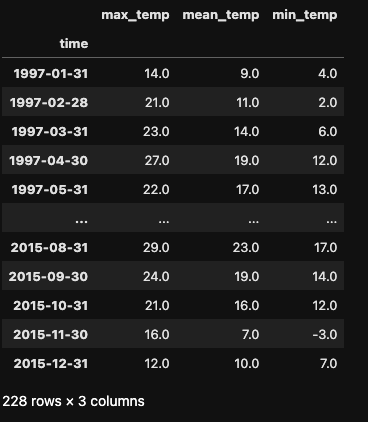
Remarquez que .asfreq() se contente de sélectionner le dernier jour de chaque mois et d’utiliser sa valeur pour représenter l’ensemble du mois. Aucune agrégation n’est effectuée (par ex. calculer la température moyenne mensuelle). Pour réaliser ces agrégations, nous allons utiliser la méthode .resample() dans la section suivante.
Si .asfreq() est pratique pour afficher des données à une autre fréquence, .resample() est l’outil de référence lorsqu’il s’agit d’agréger en même temps que l’on rééchantillonne.
La méthode .resample() fonctionne de manière similaire à .groupby() : elle regroupe les données dans un intervalle temporel donné, puis applique une ou plusieurs fonctions à chaque groupe. Le résultat de ces fonctions est affecté à une nouvelle date à l’intérieur de cet intervalle.
On utilise .resample() aussi bien pour l’upsampling (remplissage ou interpolation des données manquantes) que pour le downsampling (agrégation des données).
Revenons à notre conversion horaire pour voir comment fonctionne l’upsampling avec .resample(). L’application de .resample() renvoie un objet Resampler, sur lequel on applique ensuite une autre méthode pour obtenir un DataFrame.
print(df.resample('H'))DatetimeIndexResampler [freq=<Hour>, axis=0, closed=left, label=left, convention=start, origin=start_day]Pour l’upsampling, .resample() peut accomplir les mêmes opérations que .asfreq().
df.mean_temp.resample('H').asfreq()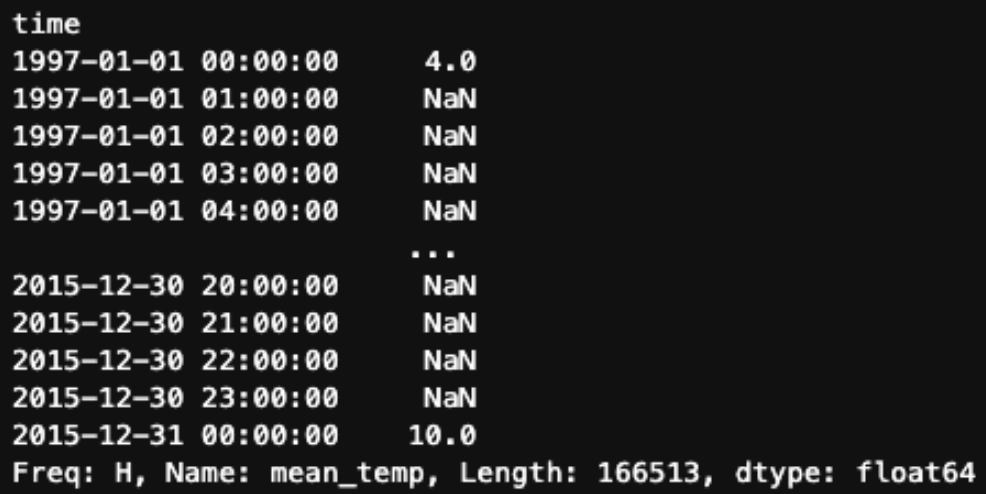
On peut également appliquer les mêmes stratégies de remplissage et d’interpolation qu’avec .asfreq(). Par exemple, pour une propagation vers l’avant :
df.mean_temp.resample('H').ffill()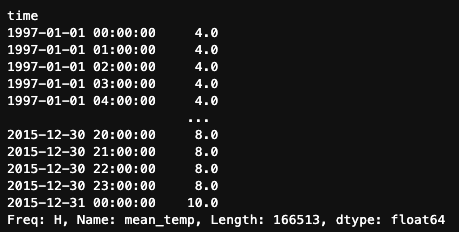
Mais .resample() propose aussi des méthodes supplémentaires non disponibles avec .asfreq(). Par exemple, on peut utiliser .interpolate(), qui estime les valeurs aux nouveaux points temporels en traçant une ligne droite entre les points existants.
df.mean_temp.resample('H').interpolate()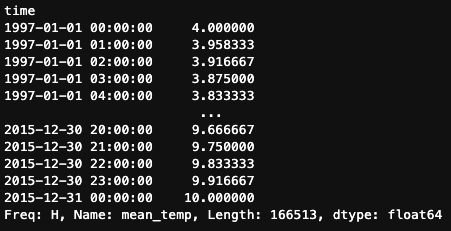
La méthode .resample() révèle tout son intérêt pour le downsampling, car elle permet d’appliquer diverses fonctions d’agrégation afin de synthétiser les données. Par exemple, calculons la moyenne mensuelle et la médiane trimestrielle des températures à Madrid avec .resample().
df.mean_temp.resample('M').mean()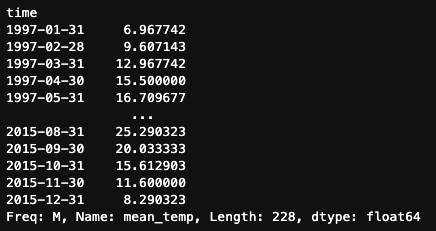
df.mean_temp.resample('Q').median()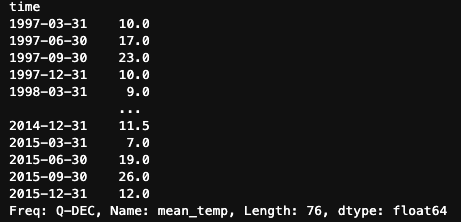
Au-delà des opérations de base, les méthodes de rééchantillonnage de pandas couvrent des scénarios plus avancés. Voyons quelques cas courants.
Le rééchantillonnage permet de créer une nouvelle série temporelle avec une fréquence adaptée à vos besoins. Parmi les fréquences courantes :
W : hebdomadaire (fin le dimanche)M : fin de mois calendaireQ : fin de trimestreH : horaireCependant, pandas offre de nombreuses autres options selon vos contraintes. Vous pouvez définir des fréquences basées sur le début ou la fin des périodes, utiliser les jours ouvrés plutôt que les jours calendaires, ou même créer des fréquences entièrement personnalisées.
df.mean_temp.resample('M').mean() # calendar month end
df.mean_temp.resample('MS').mean() # calendar month start
df.mean_temp.resample('BM').mean() # business calendar end
df.mean_temp.resample('BMS').mean() # business calendar startÀ l’instar de groupby(), .resample() permet d’appliquer plusieurs agrégations simultanément. Utilisez .agg() en lui passant une liste de fonctions d’agrégation, comme mean, median et std.
df.mean_temp.resample('M').agg(['mean','median','std'])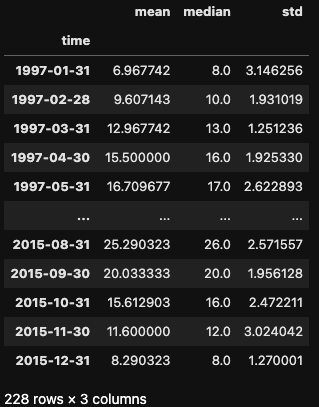
Pandas est fortement optimisé pour les grands jeux de données, mais plus les DataFrames grossissent, plus le traitement peut devenir coûteux en calcul, en particulier lors de l’upsampling. Imaginez rééchantillonner une série horaire à la seconde : le DataFrame final pourrait être gigantesque !
En cas de problèmes de performances sur de gros volumes, adoptez ces stratégies :
Bonne nouvelle : depuis la version 2.0, pandas intègre des optimisations avancées pour un traitement plus efficace. Pour en savoir plus, consultez cet article sur Pandas 2.0.
Le rééchantillonnage est une technique clé en analyse de séries temporelles : il permet d’ajuster la fréquence de vos données en agrégeant (downsampling) ou en interpolant (upsampling) les valeurs. Nous avons vu comment pandas propose des outils puissants comme .asfreq() et .resample() pour rendre ce processus intuitif et efficace.
Pour approfondir le rééchantillonnage et la manipulation des séries temporelles en Python, consultez :
Approfondissez les séries temporelles avec ces cours !
Cours
Cours
Cours
Tutoriel
Aditya Sharma
5 min
Tutoriel
DataCamp Team
3 min
Tutoriel
Aditya Sharma
7 min
Tutoriel
DataCamp Team
2 min
Tutoriel
Abid Ali Awan
7 min
Tutoriel
Satyabrata Pal
15 min


