

课程
数据沟通概念
3 小时
85.9K
实践并学习路径你的进步。
使用 Google 继续想象一下,您在查看一些公司数据时注意到:随着广告支出增加,营收似乎也在增加。在做出任何决策之前,您会希望能够量化这种关系的强度。
皮尔逊相关系数是量化此类关系的首选方法。它广泛用于数据科学、经济学、心理学、生物学等众多学科。分析师甚至会在探索性数据分析阶段计算相关性,以便在采用其他技术前先发现模式。
在查看公式或计算之前,先建立对相关性的直观理解很有帮助。最基本地,相关性衡量的是两个变量如何共同变化。它回答的问题是:“当一个变量增加时,另一个变量会怎样?”
相关性关注的是共变动的模式,而非单个取值。当两个变量倾向于同时增加或同时减少时,它们呈正相关。当两个变量倾向于朝相反方向变化(一个增加、另一个减少)时,它们呈负相关。而当两个变量的取值看起来没有一致的模式时,可能不存在关系。
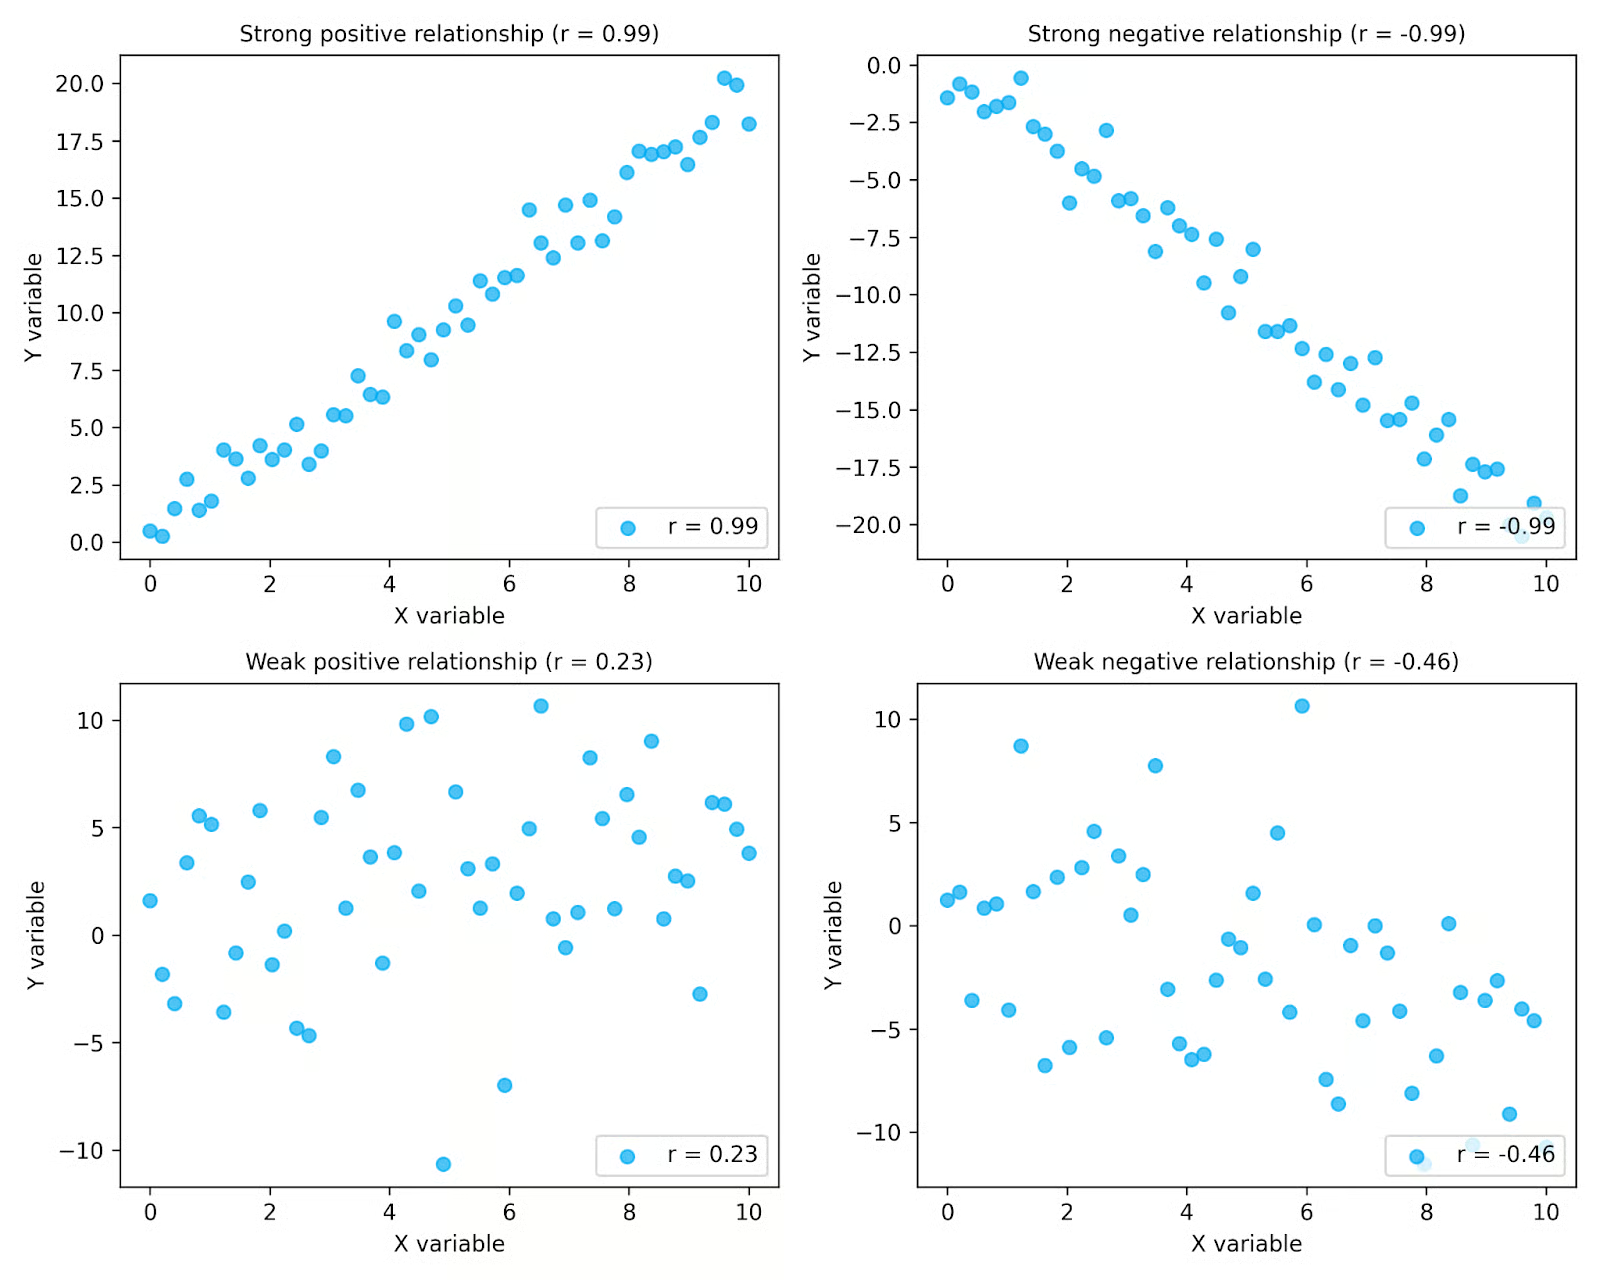
在上面的图中,您可以看到相关性如何同时体现方向与强度。上排显示强相关,数据点呈现清晰的直线趋势;下排显示较弱相关,点更分散。左侧图为正相关,数值一起上升;右侧图为负相关,一个上升另一个下降。每个图中的 r 值对这些模式进行了总结。
在探索性数据分析中,相关性尤其有用,分析师会检查变量之间的关系。绘制数据可以更容易地观察模式,并判断皮尔逊相关等度量是否适用。
还要牢记,相关性描述的是数据中观察到的关系,而不是产生这些关系的机制。即使两个变量高度相关,也不代表一个变量导致另一个变量发生变化。相关性仅仅是对现有模式的概括。请记住那句老话:“相关不代表因果”。
皮尔逊相关系数提供了一种正式方法来衡量两个连续变量之间线性关系的强度与方向。它概括了散点图中的数据点与一条直线模式的贴合程度。
皮尔逊相关系数的取值始终介于 −1 和 +1 之间。
|
r 的取值 |
解释 |
|
+1 |
完全正线性关系 |
|
0 |
无线性关系 |
|
−1 |
完全负线性关系 |
这些取值量化了上一节讨论的模式。越接近 +1 或 −1,线性关系越强;越接近 0,关系越弱。符号表示关系是正向还是负向。
关键一点是,皮尔逊相关只衡量线性关系。如果两个变量遵循非线性模式,即使它们显然有关联,相关系数也可能接近于零。换句话说,r = 0 并不一定意味着不存在关系;它意味着两个变量之间不存在线性关系。
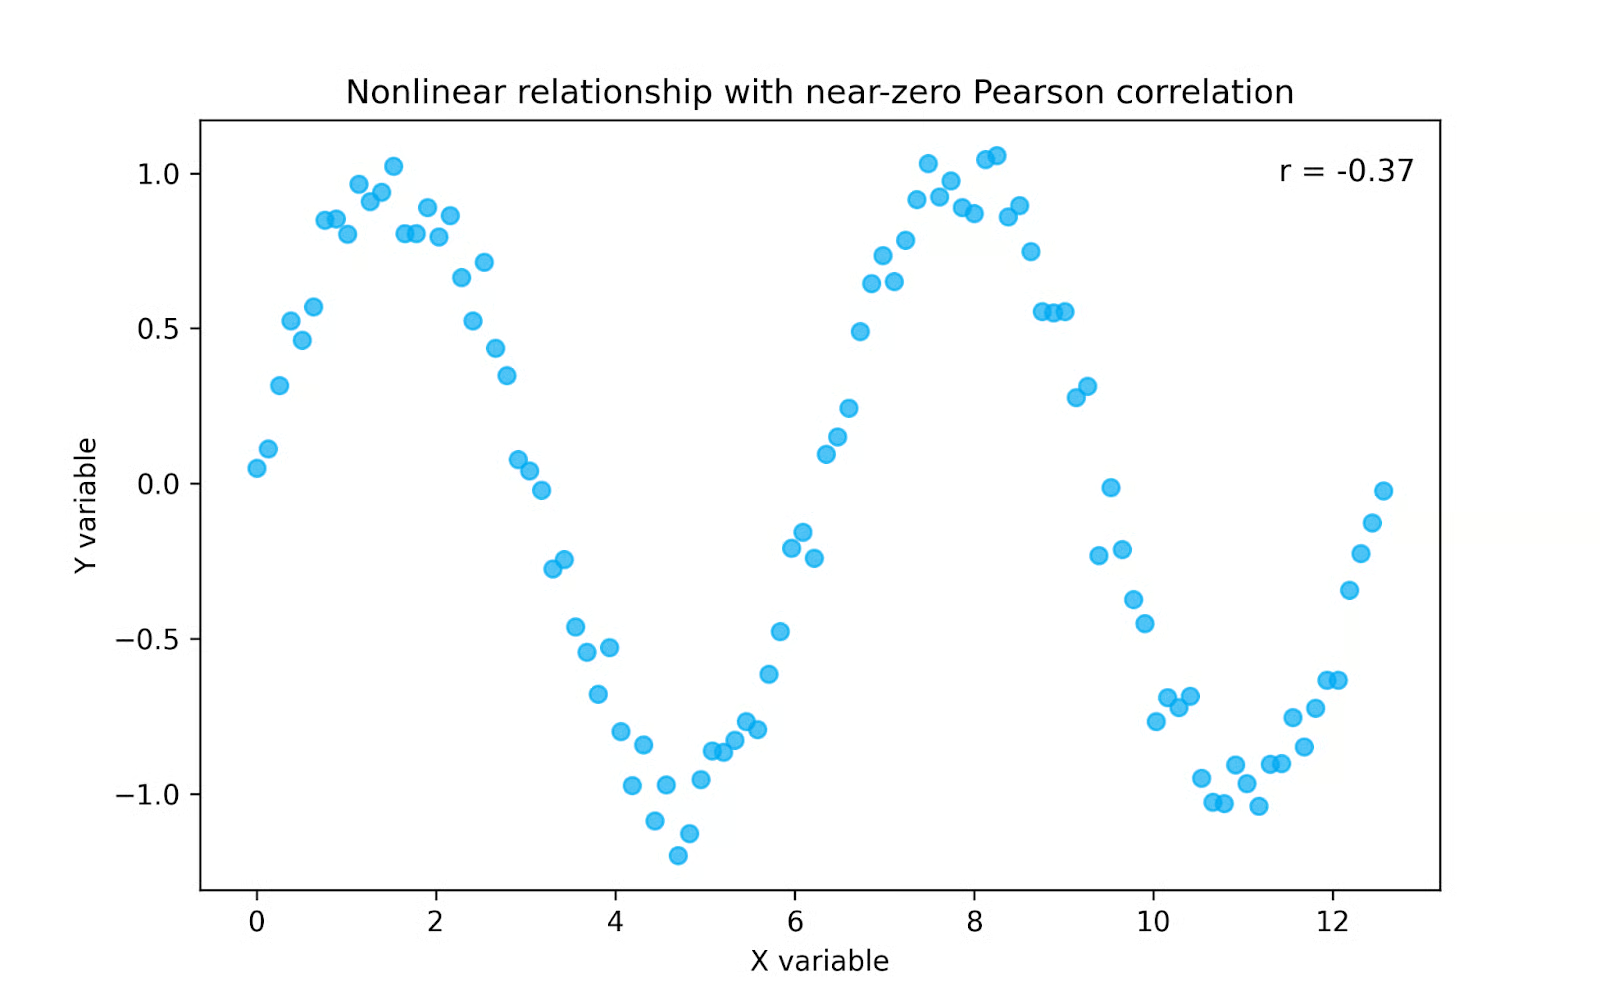
在上图中,变量显然遵循某种模式,但并非直线。由于皮尔逊相关只度量线性关系,即使变量之间关系很强,r 的取值也接近于零。在这种情况下,基于秩的度量(例如斯皮尔曼相关)可能更为合适,因为它能捕捉非线性的单调模式。
皮尔逊相关系数通过一个公式计算:该公式比较两个变量共同变化的程度与它们各自变化程度的关系。最常见的写法是:
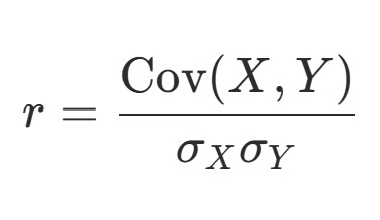
在该式中,Cov(X, Y) 表示两个变量之间的协方差,而 σX 和 σY 分别表示各自变量的标准差。协方差衡量两个变量是否倾向于同时上升或同时下降,但其大小受变量单位影响。用标准差进行归一化可以标准化结果,并确保皮尔逊相关系数始终介于 −1 和 +1 之间。若想更全面地了解相关性与协方差,请查阅我们的教程。
从本质上说,皮尔逊相关就是标准化的协方差。协方差告诉我们变量是同向还是反向变化;相关性则对这一信息进行缩放,使不同数据集之间的关系强度能够被一致地解读。
如果您曾经手工做过这个计算(感谢统计课!),您可能会认出下面这个公式,它更明确地展示了计算步骤:
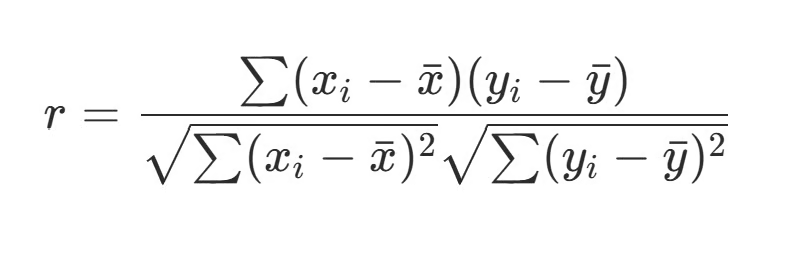
在这里,每个观测值都与其变量的均值比较。项 (Xi − X̄) 和 (Yi − Ȳ) 计算每个值偏离平均值的程度。将这些偏差相乘,衡量在每个观测点变量是否同向移动。当两个偏差同为正或同为负时,其乘积为正,促成正相关;当一个为正另一个为负时,乘积为负,促成负相关。
计算背后的逻辑很简单:
这种结构使皮尔逊相关系数能够在不受原始单位或量纲影响的情况下,为两个变量之间线性关系的强度提供标准化的度量。
让我们一起通过一个简短示例。假设我们想研究一组学生的学习时长与考试成绩之间的关系。下方是 5 位学生的小型数据集。
|
学生 |
学习时长(X) |
考试成绩(Y) |
|
Luther |
5 |
72 |
|
Alexandra |
2 |
70 |
|
Javier |
3 |
63 |
|
Jamie |
1 |
58 |
|
Auburn |
4 |
73 |
第一步总是要把数据画出来。下面我们来绘图。
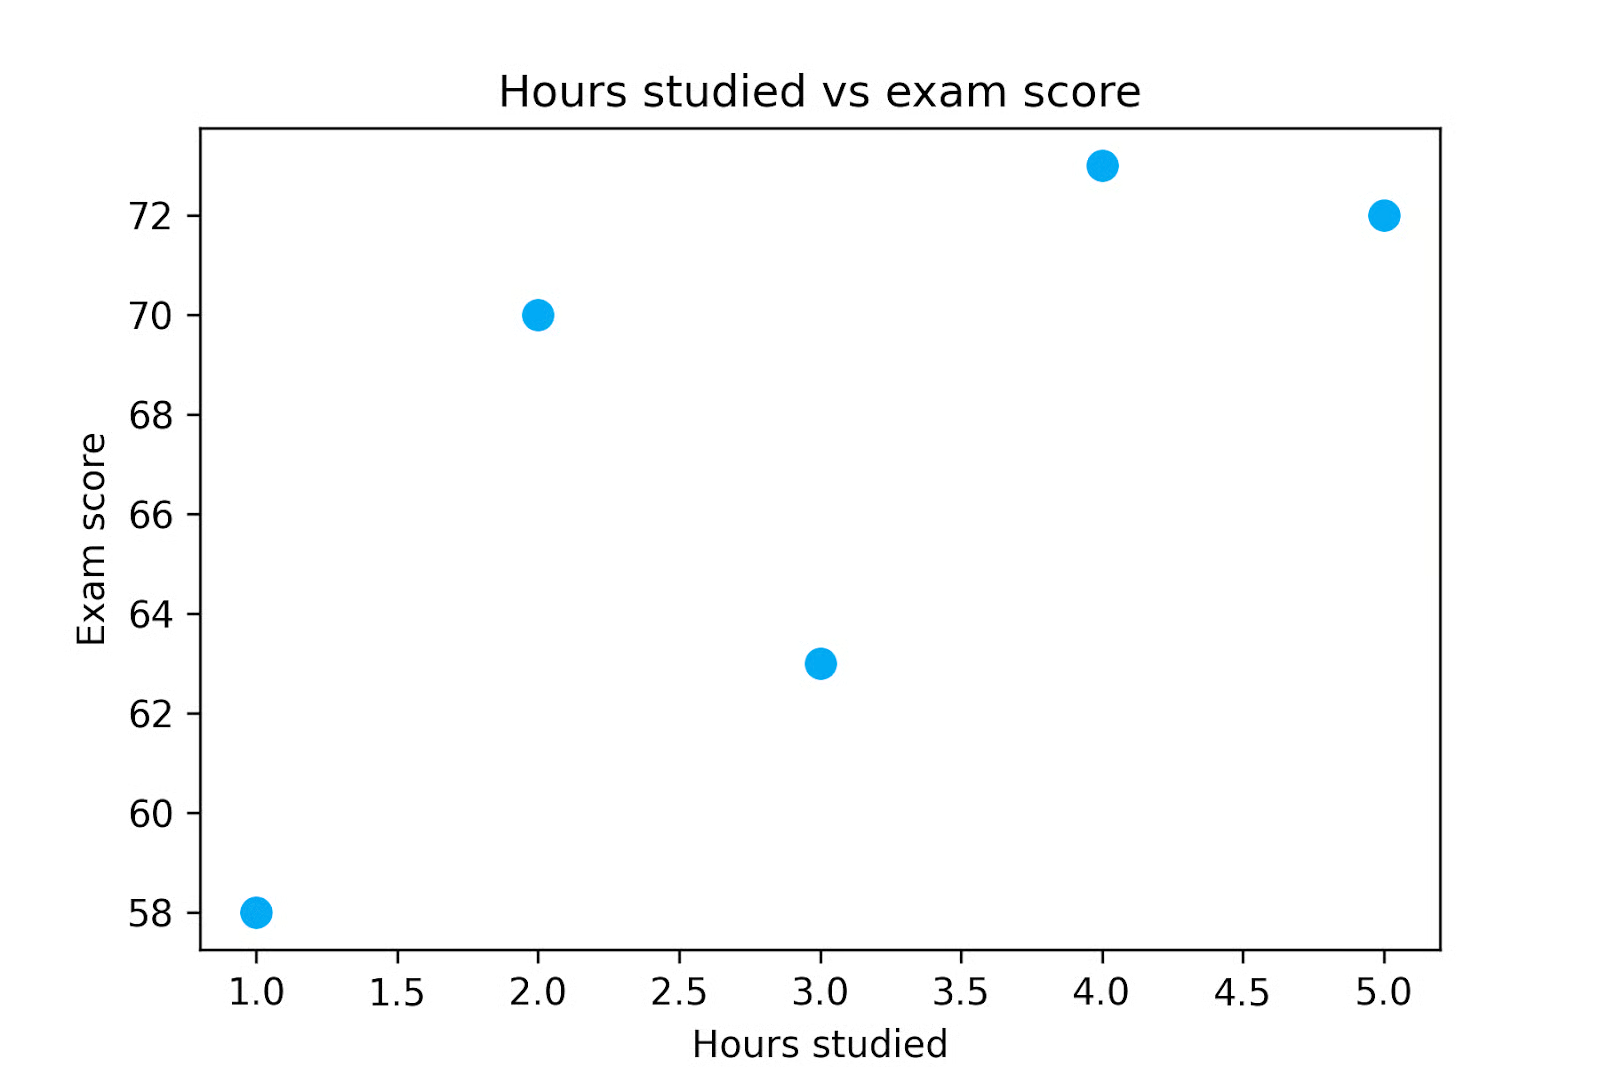
从图中可以看出,随着学习时间增加,考试成绩也倾向于上升,但我们希望将这种关系量化。因此,我们来计算该数据集的皮尔逊相关系数。
首先,计算每个变量的均值。本例中,平均学习时长为 3,平均考试成绩为 67.2。
接着,计算每个观测值与其均值的差,这些值称为“偏差”。
然后,将这些偏差相乘,以显示两个变量在每个观测点上的共同变化。当两个偏差同号时,乘积为正,有助于形成正相关;当偏差异号时,乘积为负,有助于形成负相关。
|
X |
Y |
X − X̄ |
Y − Ȳ |
(X − X̄)(Y − Ȳ) |
|
1 |
58 |
-2 |
-9.2 |
18.4 |
|
2 |
70 |
-1 |
2.8 |
-2.8 |
|
3 |
63 |
0 |
-4.2 |
0 |
|
4 |
73 |
1 |
5.8 |
5.8 |
|
5 |
72 |
2 |
4.8 |
9.6 |
将最后一列的乘积求和得到 31,这就是皮尔逊相关计算中的分子。
接下来,用标准差来计算每个变量的变异性。为此,我们先将上表第 3、4 列的偏差平方后再求和。
对于 X:
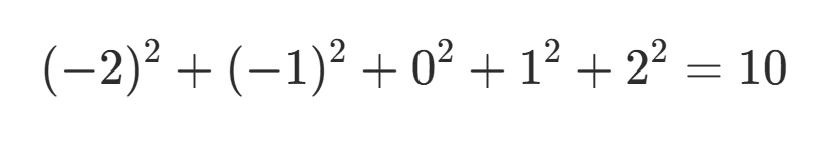
对于 Y:
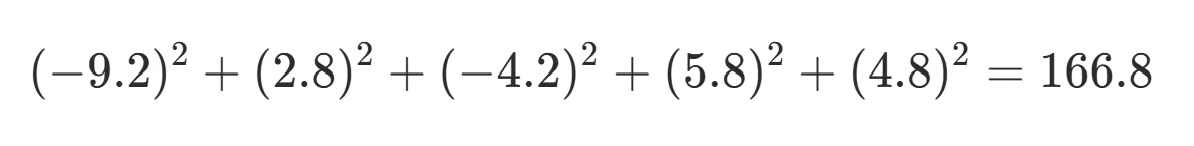
然后对每个和开平方:
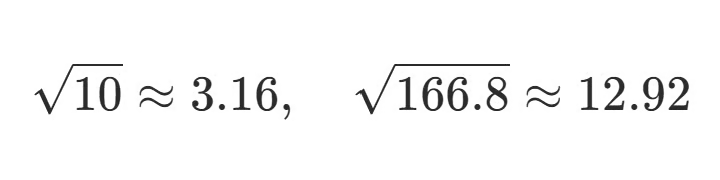
最后,将分子除以两个标准差的乘积:
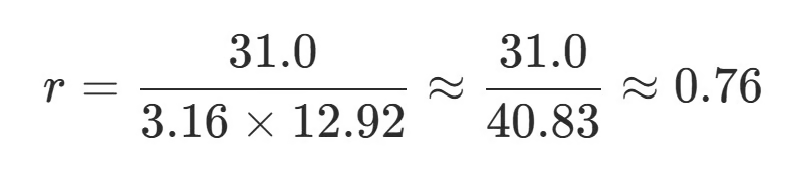
这一步得到皮尔逊相关系数,本例约为 0.76,表示较强的正线性关系。我们可以据此得出结论:学生的学习时长与其考试成绩之间存在较强、正向的相关性。
但我们不能据此认定学习时长导致了考试成绩的变化。要得出因果结论,还需要进一步的分析或实验研究。
从上面的简单示例可以看出,手工计算皮尔逊相关系数并不现实。
幸运的是,大多数统计软件都内置了相关函数。理解计算机制有助于直观把握,但在实际工作流中,系数通常由软件自动计算。下面简要介绍如何用三种常见工具计算皮尔逊相关系数:Excel、Python 和 R。
在 Excel 中,可使用 CORREL() 函数轻松计算皮尔逊相关系数。该函数接收两个代表感兴趣变量的数值区间,并返回它们的相关系数。
=CORREL(A1:A10, B1:B10)该函数直接从选择的区域计算皮尔逊 r,是在表格中快速探索变量关系的简便方法。
在 Python 中,常用 pandas 或 SciPy 来计算皮尔逊相关系数。pandas 的 corr()方法可计算 DataFrame 各列之间的相关性:
import pandas as pd

pearson_df['hours_studied'].corr(pearson_df['exam_score'])
或者,SciPy 统计模块中的 pearsonr()函数会同时返回相关系数以及用于假设检验的 p 值:
from scipy.stats import pearsonr

pearsonr(pearson_df['hours_studied'], pearson_df['exam_score'])
如果您刚接触基于 Python 的数据分析,可通过我们的pandas 教程了解如何处理表格数据。
在 R 中,可使用 cor()函数来计算皮尔逊相关系数:
cor(x, y)默认情况下,该函数计算皮尔逊相关系数,当然您也可以指定其他相关性方法。
上述三种工具都能快速计算皮尔逊相关系数。实际上,也正因为如此,分析师常常会生成一张相关矩阵,一次性展示多变量两两之间的相关性。这有助于识别值得在后续分析阶段进一步研究的模式和关系。
计算出皮尔逊相关系数是一回事,如何解读又是另一回事。请记住,系数 r 同时描述两个变量之间线性关系的方向与强度。
r 的符号表示关系方向。正值意味着变量倾向于一起增加;负值则表示当一个变量增加时另一个倾向于减少。
r 的绝对值表示线性关联强度,越接近 1 的值比接近 0 的值更强。不同领域对“强相关”的传统阈值不同。在高度可控的实验环境(如物理或工程的一些领域),强相关可能接近 1;而在涉及复杂生物或社会系统的领域(如医学、公共卫生、经济学或心理学),0.1 到 0.4 区间的相关性在变量难以测量或效应在群体层面累积时,仍可能具有意义。由于各学科标准不同,解读 r 需要结合领域知识与情境判断。
还要注意,皮尔逊相关对极端值敏感。单个离群值就可能明显增大或减小 r 的值。这也是为什么绘制数据如此重要。将散点图与相关系数结合考察,有助于识别可能产生过度影响的离群点。
统计软件通常会在皮尔逊相关系数旁提供一个 p 值。该 p 值用于检验:在变量间实际上不存在关系的前提下,观察到至少与当前一样强的相关性出现的可能性有多大。如果这种情况仅凭偶然性难以发生,我们就说这种关系在统计上显著。
该 p 值通过将皮尔逊相关系数转换为 t 统计量并与 t 分布比较而得到。这与学生 t 检验类似,但此处的目标是检验真实相关是否为零。
在大型数据集中,即使 r 值相对较小,也可能在统计上显著,但在个体层面仍可能是弱关系。这在公共卫生等领域尤为重要,因为较弱的关系在群体层面仍可能产生显著影响。因此,区分相关性的大小(r)与其统计显著性(p 值)通常很有必要。
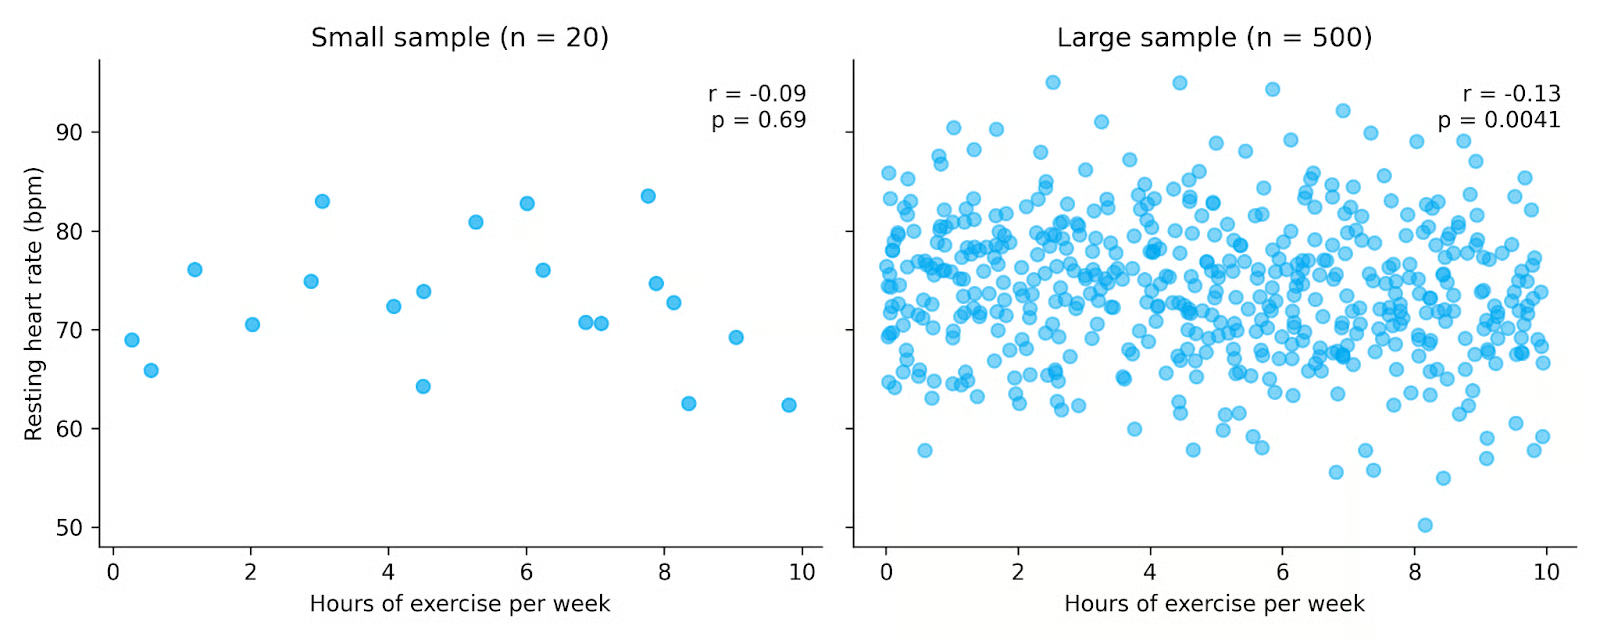
在上图中,两个数据集都表现出锻炼与静息心率之间较弱的负相关。但右侧数据集的样本量更大,即使相关系数很小,该关系在统计上仍显著。这凸显了更大的样本量能提升我们发现关系的能力,也说明在解读结果时同时考虑 r 的取值与 p 值的重要性。
皮尔逊相关系数因其计算与解读简明而被广泛使用。但与许多统计工具一样,当数据较好地满足某些假设时,它的效果最佳。
首先,皮尔逊相关假设两个变量之间是线性关系。如果真实关系呈弯曲或非线性模式,相关系数可能低估关联强度,甚至暗示不存在关系。
另一个假设是被分析的变量为连续型。皮尔逊相关适用于在连续数值尺度上测量的变量,如身高、收入、温度或考试成绩。如果您的数据是有序型或离散型,可能更适合使用斯皮尔曼相关或 Kendall’s tau。
通常还希望数据近似正态分布。这在进行假设检验或计算相关系数的置信区间时尤为重要。如果分布明显偏离正态,估计的相关性仍可描述样本关系,但得到的 p 值往往不太可靠。
皮尔逊相关还假设同方差性,即一个变量的变异性在另一个变量的取值范围内相对一致。实际来看,即散点图中点的离散程度应在数值增减时大致保持相似。当离散程度在数据范围内显著变化时,相关系数可能无法充分反映关系结构。与正态性类似,即使违背该假设仍可计算 r,但后续的推断检验会不够可靠。
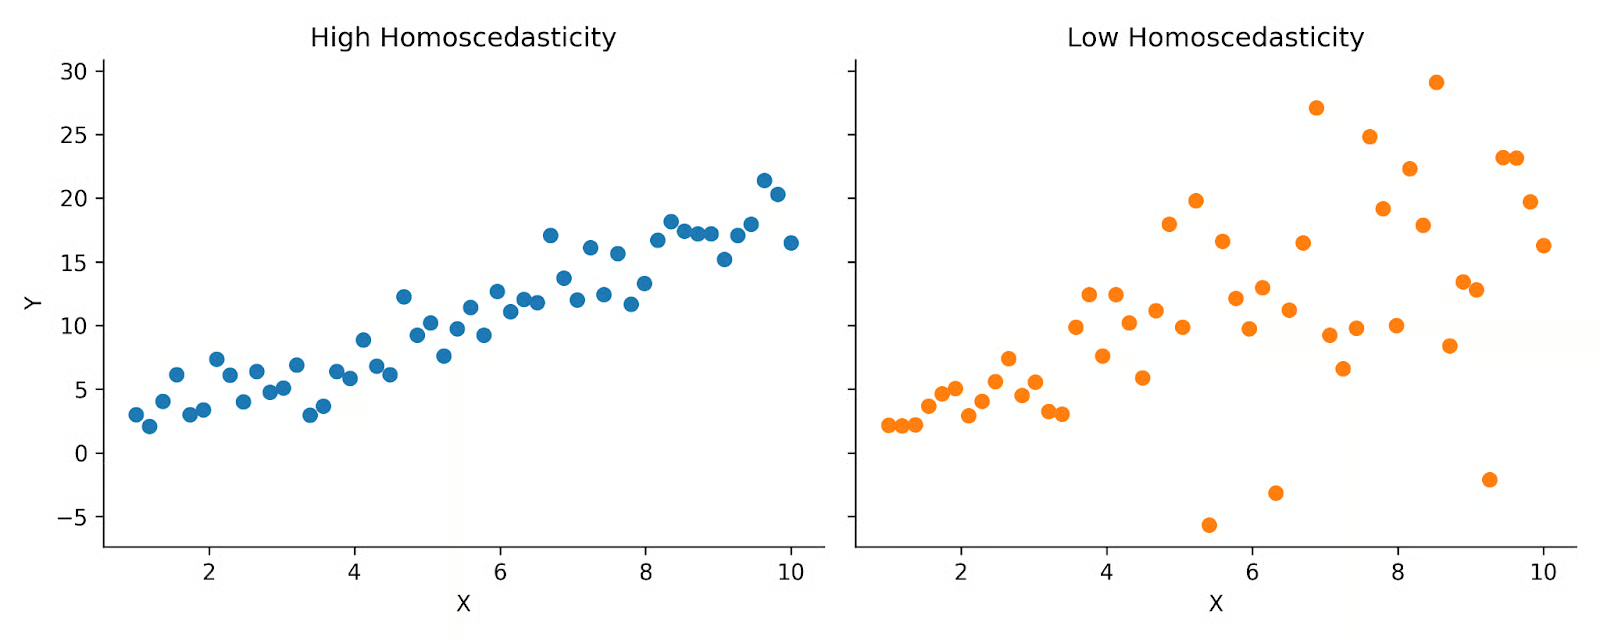
上图展示了高与低同方差性的两个示例。左图中,数据在分布范围内较为均匀;右图中,您会看到更明显的“锥形”。皮尔逊相关假设您的数据更接近左图的样子。
最后,如前所述,皮尔逊相关对离群值敏感。由于该系数基于均值和标准差,极端值可能对计算产生不成比例的影响。单个异常点就可能大幅改变相关系数。
皮尔逊相关与斯皮尔曼相关名称相似,容易混淆。二者都衡量两个变量之间的关系,但捕捉的关系类型和依赖的假设不同。
皮尔逊相关系数衡量两个连续变量之间线性关系的强度;而斯皮尔曼相关系数衡量单调关系的强度,即变量朝同一方向变化,但不一定以恒定速率。只要始终递增或递减,单调关系可以是线性的,也可以是非线性的。
斯皮尔曼相关用数据的秩而非原始值计算。通过将数据转换为秩,斯皮尔曼相关降低了离群值的影响,并且不要求线性假设。
皮尔逊相关被视为参数方法,因为它依赖于数据分布的假设;而斯皮尔曼相关被视为非参数方法,因为它不需要相同的分布假设,对正态性的依赖更小。
当皮尔逊相关的前提假设满足时,它能比斯皮尔曼相关更精确地估计实际的线性关联。然而,当数据不满足这些条件时,斯皮尔曼相关仍能捕捉到两个变量之间的关系。
|
相关系数 |
适用情形 |
|
皮尔逊相关 |
线性关系;连续变量;数据行为良好 |
|
斯皮尔曼相关 |
单调关系;存在离群值;有序或秩次数据 |
协方差与相关性密切相关,但在尺度与解读方式上有所不同。
协方差衡量两个变量是否倾向于同向或反向变化。若变量一起增加,协方差为正;若一个增加、另一个减少,协方差为负。
然而,协方差的大小依赖于变量的计量单位。例如,以厘米计的身高与以千克计的体重之间的协方差,与以英寸和磅计量时的协方差在数值上会不同。这使得跨数据集比较协方差变得困难。
皮尔逊相关通过用两个变量标准差的乘积去除协方差的量纲限制。由于这种归一化,皮尔逊相关是无量纲的,且始终介于 −1 与 +1 之间。这一区间的有界性使其更易解读。
简单来说:
尽管皮尔逊相关系数使用广泛、易于解读,但它也有若干重要局限。
皮尔逊相关最好与更广泛的探索与分析流程结合使用。可视化您的数据、检查各项假设是否满足,并在使用与解读皮尔逊相关系数时结合问题情境。
皮尔逊相关系数是广泛应用于多种学科的基础统计度量。若您想了解相关性如何融入现实工作流,请探索我们的Python 探索性数据分析教程。如果您想在实践中探索相关性,欢迎查看我们的pandas 教程,了解相关性如何应用于真实数据集。