Curso
Conceitos de comunicação de dados
3 h
85.2K
Imagine que você está analisando dados da sua empresa e percebe que, conforme o investimento em publicidade aumenta, a receita também cresce. Antes de tomar qualquer decisão, vale a pena quantificar a força dessa relação.
O coeficiente de correlação de Pearson é a forma mais utilizada para quantificar esse tipo de relação. Ele é aplicado em diversas áreas, como ciência de dados, economia, psicologia e biologia. Analistas costumam calcular correlações na análise exploratória de dados para encontrar padrões antes de avançar para outras técnicas.
Antes de olhar para fórmulas ou cálculos, ajuda desenvolver uma compreensão intuitiva do que a correlação descreve. Em linhas gerais, a correlação mede como duas variáveis se movimentam juntas. Responde à pergunta: “Quando uma variável aumenta, o que acontece com a outra?”
A correlação foca nos padrões de comovimentação, e não em valores individuais. Quando duas variáveis tendem a aumentar ou diminuir ao mesmo tempo, há uma relação positiva. Quando tendem a se mover em direções opostas (uma aumenta enquanto a outra diminui), há uma relação negativa. E quando os valores de ambas não parecem seguir um padrão consistente, pode não haver relação.
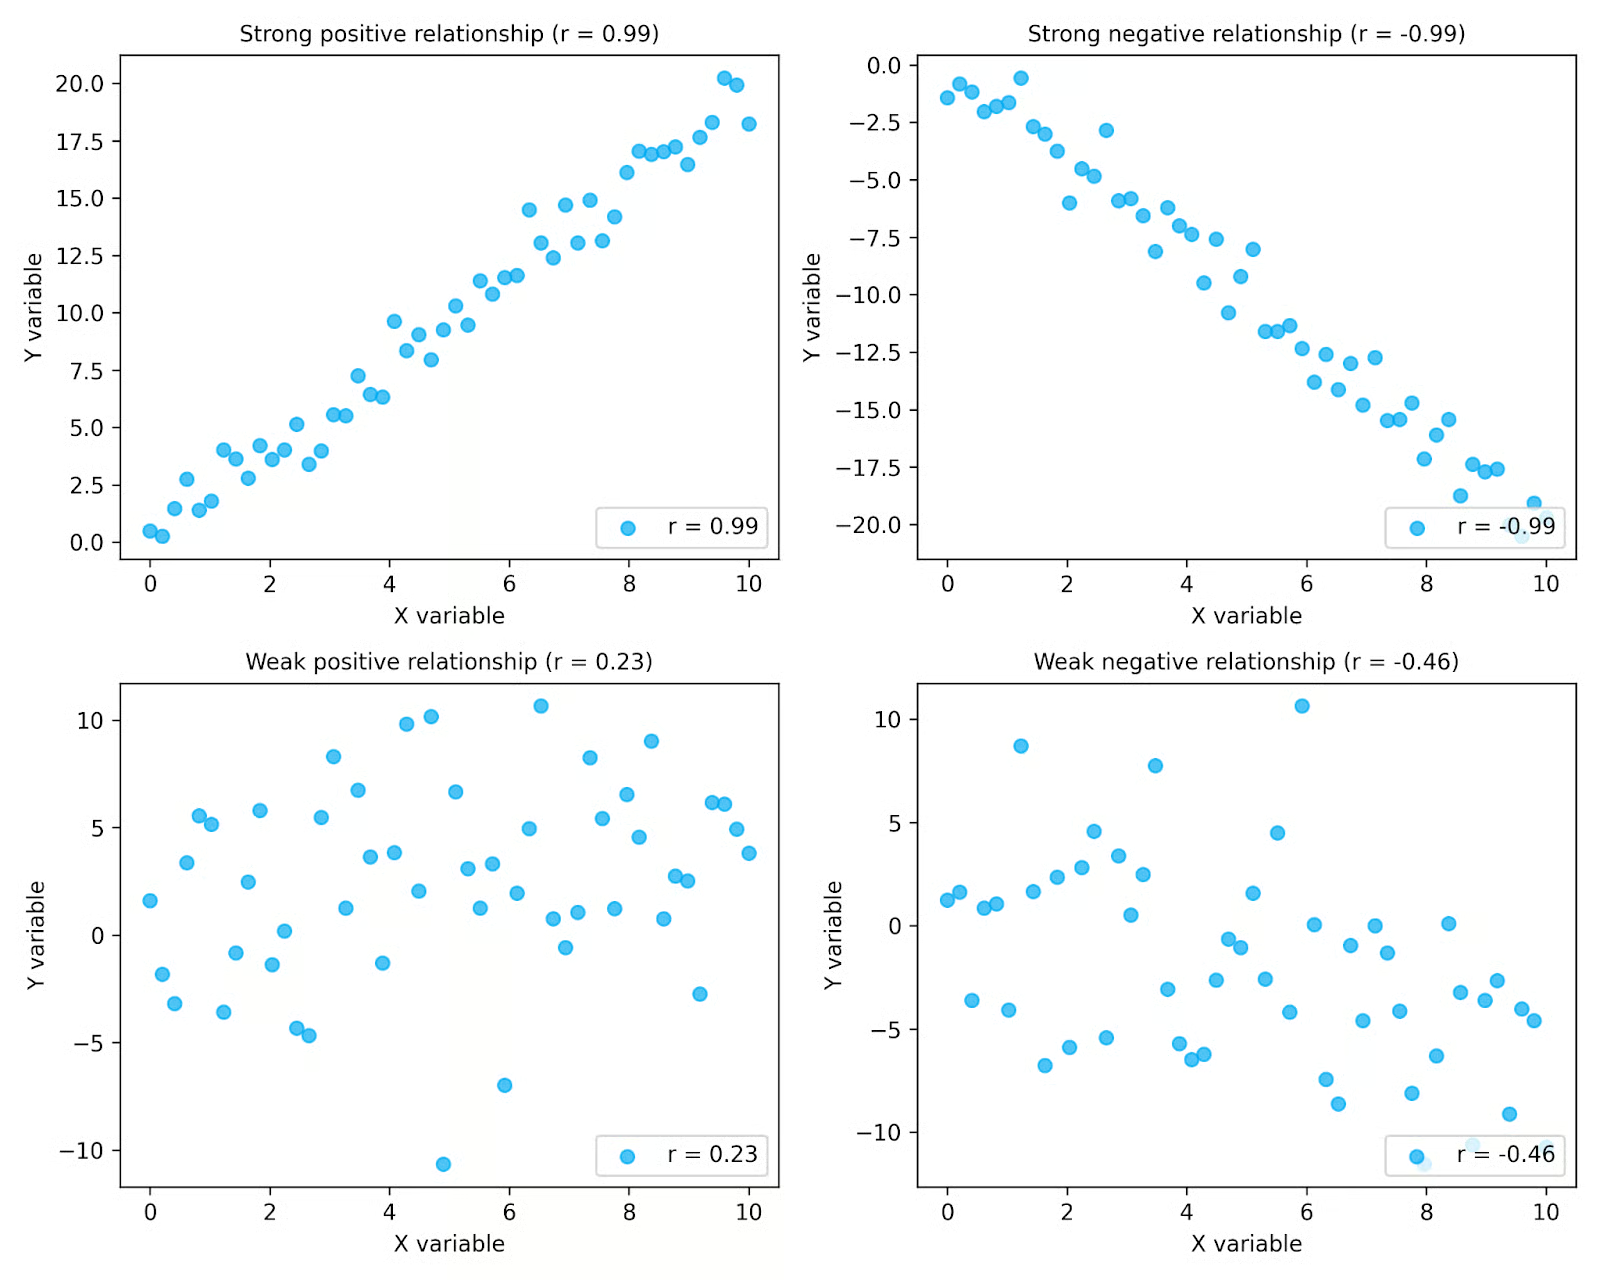
Nos gráficos acima, dá para ver como a correlação captura tanto a direção quanto a força. A linha de cima mostra relações fortes, nas quais os pontos seguem um padrão claro; já a linha de baixo mostra relações mais fracas, com mais dispersão. Os gráficos à esquerda mostram relações positivas, em que os valores aumentam juntos; os da direita mostram relações negativas, em que uma variável diminui conforme a outra aumenta. Os valores de r em cada gráfico resumem esses padrões.
A correlação é especialmente útil na análise exploratória, quando o analista examina relações entre variáveis. Visualizar os dados facilita enxergar padrões e decidir se uma medida de correlação, como a de Pearson, é apropriada para o seu conjunto de dados.
Também é importante lembrar que correlação descreve relações observadas nos dados, não os mecanismos que as produzem. Mesmo quando duas variáveis são fortemente correlacionadas, isso não significa que uma causou a mudança da outra. A correlação apenas resume os padrões existentes. Lembre-se do ditado clássico: “correlação não implica causalidade”.
O coeficiente de correlação de Pearson oferece uma forma formal de medir a força e a direção de uma relação linear entre duas variáveis contínuas. Ele resume o quão de perto os pontos em um gráfico de dispersão seguem um padrão de linha reta.
O valor do coeficiente de correlação de Pearson está sempre entre −1 e +1.
|
Valor de r |
Interpretação |
|
+1 |
Relação linear positiva perfeita |
|
0 |
Sem relação linear |
|
−1 |
Relação linear negativa perfeita |
Esses valores quantificam os padrões discutidos na seção anterior. Valores mais próximos de +1 ou −1 indicam uma relação linear mais forte, enquanto valores mais próximos de 0 indicam uma relação mais fraca. O sinal indica se a relação é positiva ou negativa.
Um ponto-chave é que a correlação de Pearson mede apenas relações lineares. Se duas variáveis seguem um padrão não linear, o coeficiente pode ficar próximo de zero mesmo quando elas estão claramente relacionadas. Em outras palavras, r = 0 não significa necessariamente que não há relação; significa que não há relação linear entre as variáveis.
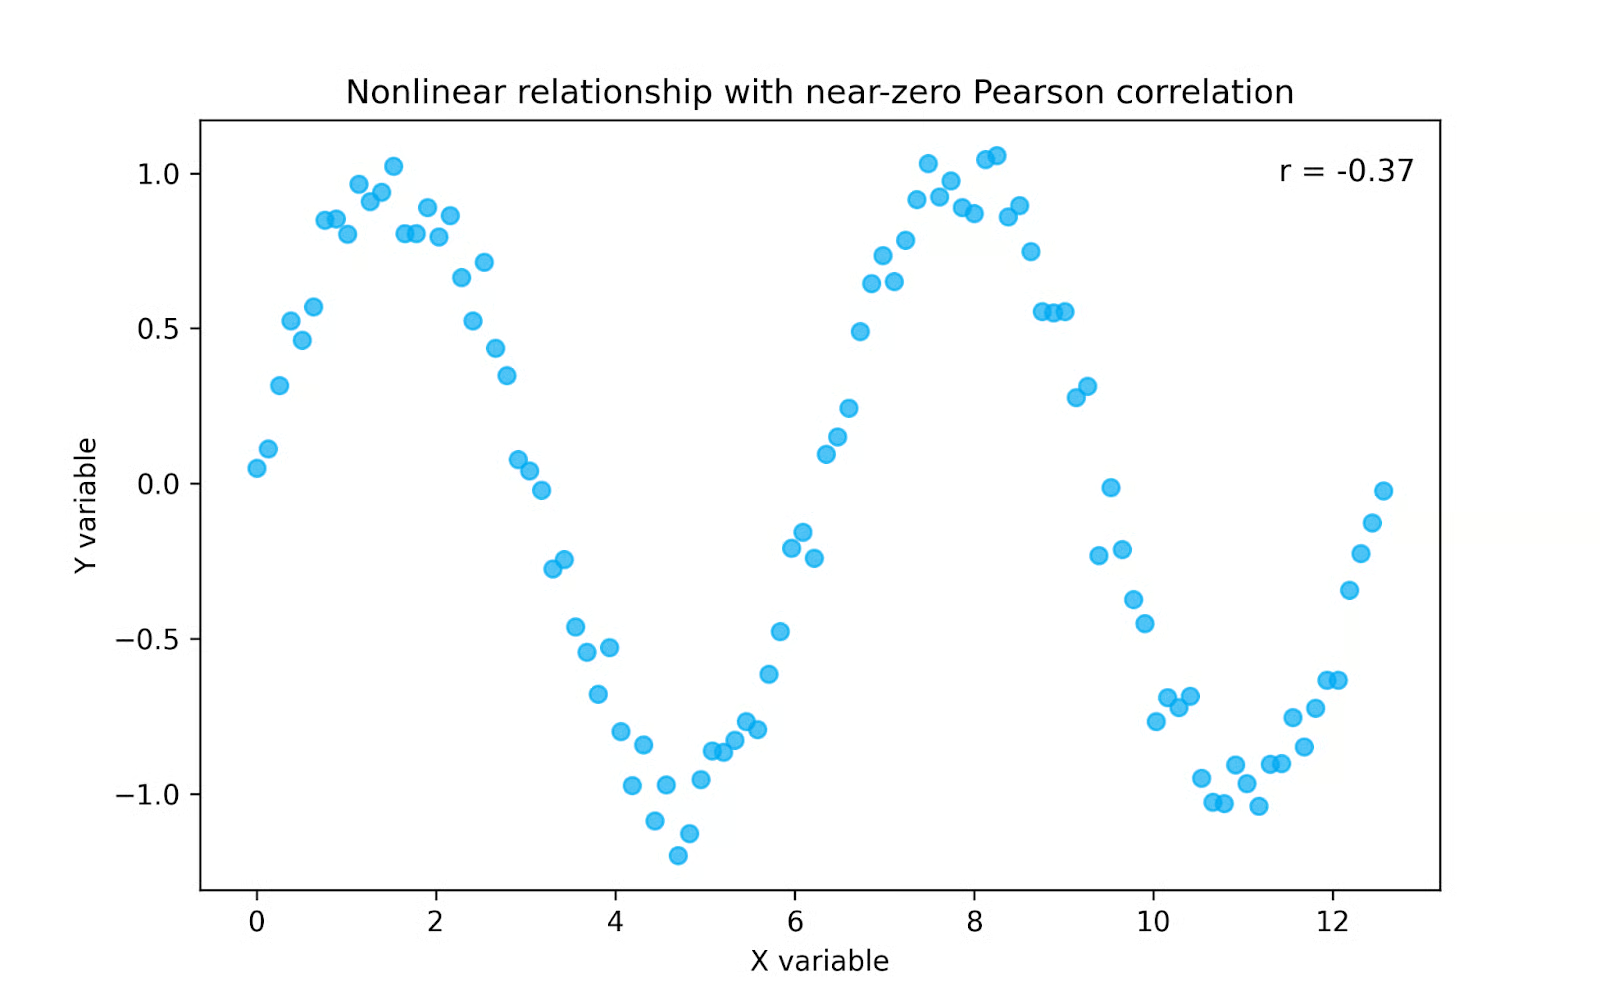
No gráfico acima, as variáveis seguem um padrão claro, mas não linear. Como a correlação de Pearson mede apenas relações lineares, o valor de r fica próximo de zero, mesmo com uma relação forte. Nesses casos, uma medida baseada em postos, como a correlação de Spearman pode ser mais adequada, pois captura padrões monotônicos que não são lineares.
O coeficiente de correlação de Pearson é calculado por uma fórmula que compara como duas variáveis variam juntas em relação a quanto variam individualmente. A forma mais comum de escrevê-la é:
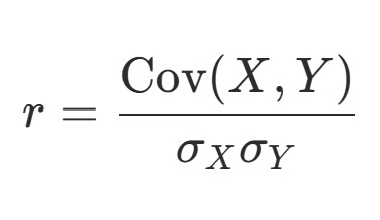
Nessa expressão, Cov(X, Y) representa a covariância entre as duas variáveis, enquanto σX e σY representam os desvios-padrão de cada variável. A covariância mede se duas variáveis tendem a aumentar ou diminuir juntas, mas sua magnitude depende das unidades das variáveis. Dividir pelos desvios-padrão padroniza o resultado e garante que o coeficiente de correlação de Pearson fique sempre entre −1 e +1. Para uma discussão mais ampla sobre correlação e covariância, confira nosso tutorial sobre o tema.
Em essência, a correlação de Pearson é a covariância padronizada. Enquanto a covariância indica se as variáveis se movem na mesma direção ou em direções opostas, a correlação escala essa informação para que a força da relação possa ser interpretada de forma consistente em diferentes conjuntos de dados.
Se você já precisou fazer esse cálculo na mão (obrigado, aula de estatística!), vai reconhecer esta versão da fórmula, que deixa as etapas mais explícitas:
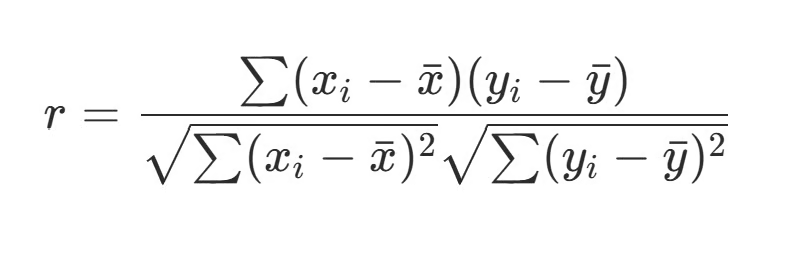
Aqui, cada observação é comparada com a média de sua variável. Os termos (Xi − X̄) e (Yi − Ȳ) calculam o quanto cada valor se distancia da média. Multiplicar esses desvios mede se as variáveis se movem na mesma direção em cada observação. Quando ambos os desvios são positivos ou ambos negativos, o produto é positivo, contribuindo para uma correlação positiva. Quando um desvio é positivo e o outro negativo, o produto é negativo, contribuindo para uma correlação negativa.
A lógica por trás do cálculo é simples:
Essa estrutura permite que o coeficiente de correlação de Pearson forneça uma medida padronizada de quão fortemente duas variáveis se relacionam linearmente, independentemente das unidades ou escalas originais.
Vamos passar por um exemplo rápido juntos. Suponha que queremos analisar a relação entre horas de estudo e notas de prova para um grupo de alunos. Abaixo, temos um pequeno conjunto de dados com cinco alunos.
|
Aluno |
Horas de estudo (X) |
Nota da prova (Y) |
|
Luther |
5 |
72 |
|
Alexandra |
2 |
70 |
|
Javier |
3 |
63 |
|
Jamie |
1 |
58 |
|
Auburn |
4 |
73 |
O primeiro passo é sempre visualizar os dados. Então, vamos fazer isso abaixo.
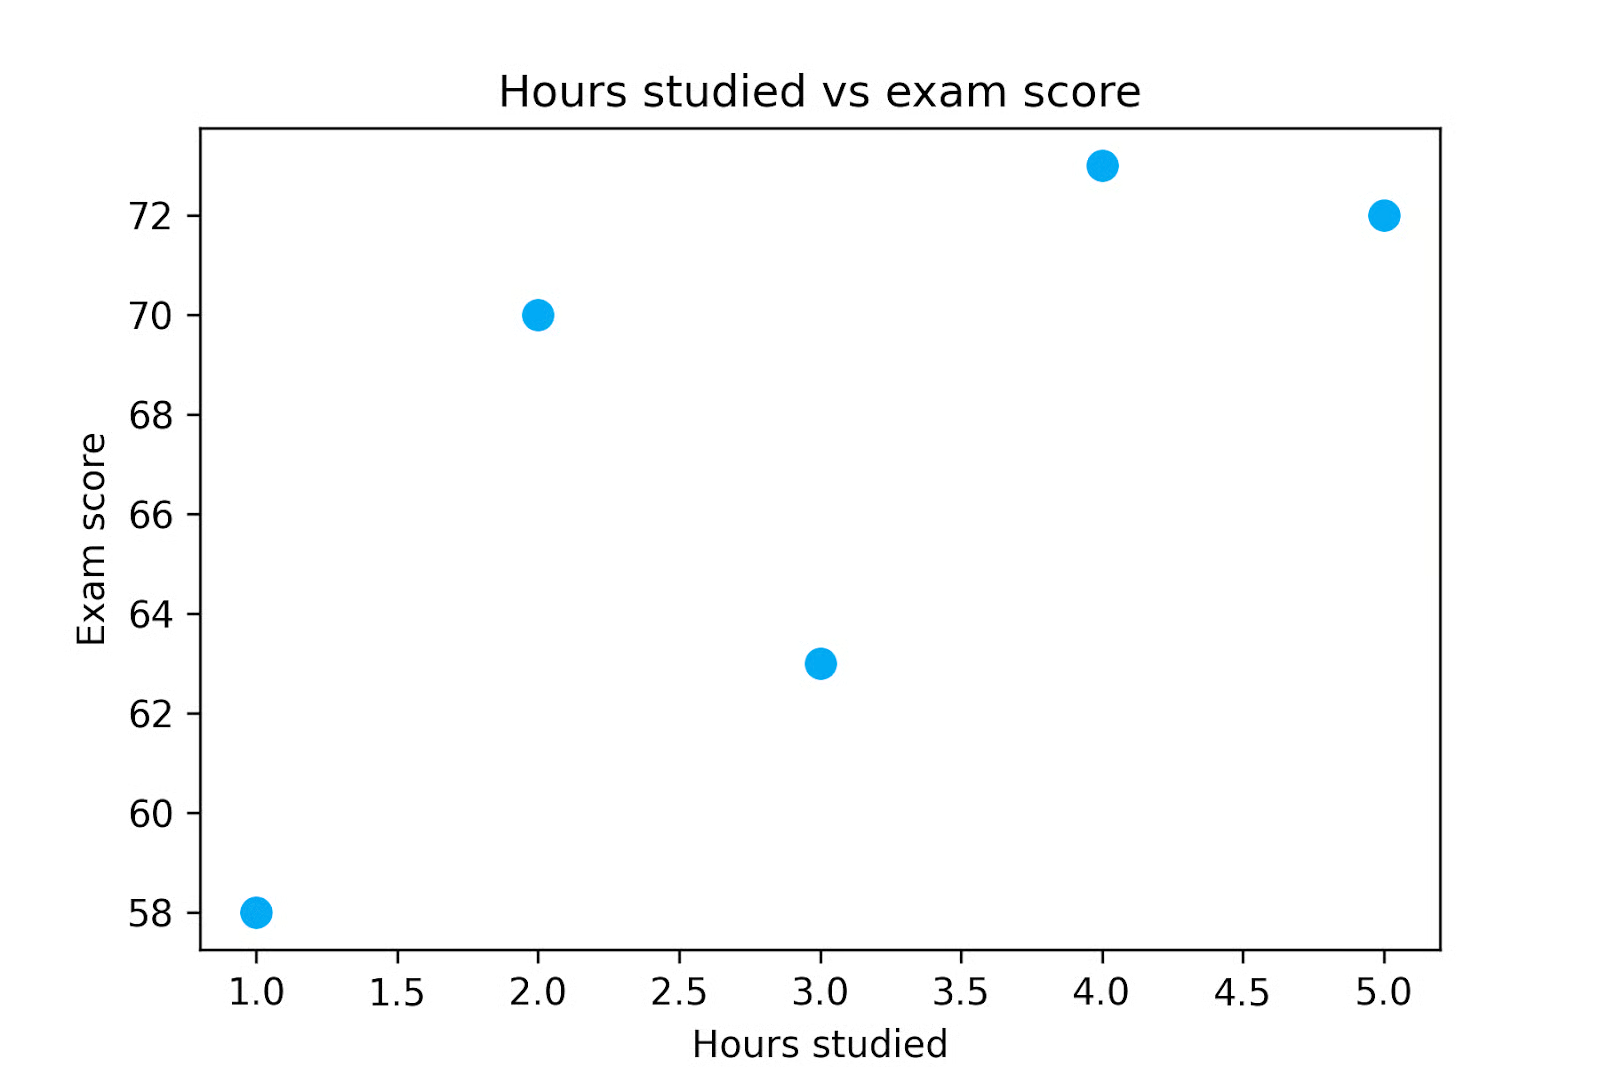
Ao plotar os dados, vemos que as notas tendem a aumentar conforme o tempo de estudo cresce, mas queremos quantificar essa relação. Então, vamos calcular o coeficiente de correlação de Pearson para este conjunto de dados.
Primeiro, precisamos calcular a média de cada variável. Neste exemplo, a média de horas de estudo é 3 e a média das notas é 67,2.
Depois, calculamos o quanto cada observação se afasta de sua média. Esses valores são chamados de desvios em relação à média.
Em seguida, multiplicamos os desvios para mostrar como as variáveis se movem juntas em cada observação. Quando ambos os desvios têm o mesmo sinal, o produto é positivo, contribuindo para uma correlação positiva. Quando os desviam em sentidos opostos, o produto é negativo e contribui para uma correlação negativa.
|
X |
Y |
X − X̄ |
Y − Ȳ |
(X − X̄)(Y − Ȳ) |
|
1 |
58 |
-2 |
-9,2 |
18,4 |
|
2 |
70 |
-1 |
2,8 |
-2,8 |
|
3 |
63 |
0 |
-4,2 |
0 |
|
4 |
73 |
1 |
5,8 |
5,8 |
|
5 |
72 |
2 |
4,8 |
9,6 |
Ao somar os produtos na última coluna, obtemos 31, que é o numerador do nosso cálculo da correlação de Pearson.
Em seguida, calculamos a variabilidade de cada variável usando seus desvios-padrão. Para isso, elevamos ao quadrado os desvios nas colunas 3 e 4 antes de somá-los.
Para X:
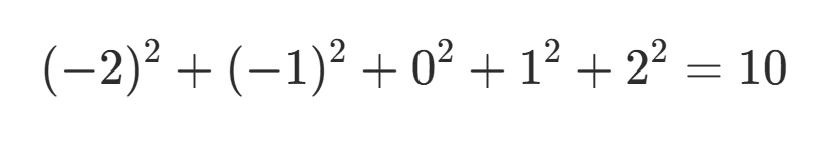
Para Y:
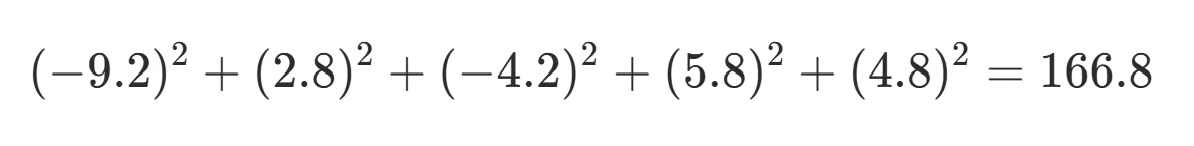
Depois, tiramos a raiz quadrada de cada soma:
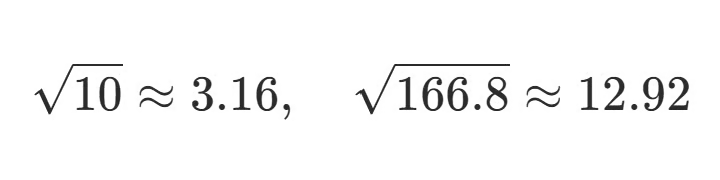
Por fim, dividimos o numerador pelo produto dos desvios-padrão:
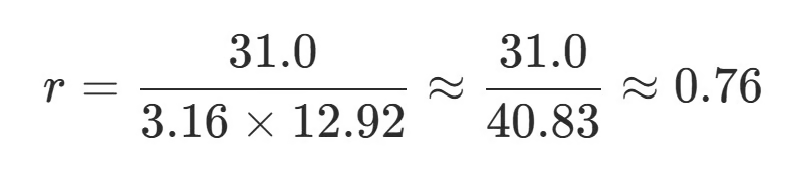
Esse passo final nos dá o coeficiente de correlação de Pearson, que neste caso é aproximadamente 0,76, indicando uma forte relação linear positiva. Podemos concluir que o número de horas estudadas está fortemente e positivamente correlacionado com as notas.
No entanto, não podemos concluir que as horas de estudo causaram as notas. Para isso, seriam necessárias análises adicionais ou um estudo experimental.
Como deu para ver no exemplo acima, calcular a correlação de Pearson na mão não é nada prático.
Felizmente, a maior parte dos softwares estatísticos tem funções prontas para isso. Entender a mecânica do cálculo ajuda na intuição, mas, no dia a dia, o coeficiente é calculado automaticamente. Vamos ver rapidamente como calcular a correlação de Pearson em três ferramentas comuns: Excel, Python e R.
No Excel, o coeficiente de correlação de Pearson é fácil de calcular usando a função CORREL(). Essa função recebe dois intervalos de valores que representam as variáveis de interesse e retorna o coeficiente de correlação entre elas.
=CORREL(A1:A10, B1:B10)A função calcula diretamente o r de Pearson a partir dos intervalos selecionados, sendo uma forma rápida de explorar relações entre variáveis em planilhas.
Em Python, o coeficiente de correlação de Pearson é comumente calculado usando as bibliotecas pandas ou SciPy. O método corr() no pandas computa correlações entre colunas de um DataFrame:
import pandas as pd

pearson_df['hours_studied'].corr(pearson_df['exam_score'])
Alternativamente, a função pearsonr() do módulo de estatística do SciPy retorna o coeficiente de correlação e o p-valor para teste de hipótese:
from scipy.stats import pearsonr

pearsonr(pearson_df['hours_studied'], pearson_df['exam_score'])
Se você está começando com análise de dados em Python, saiba mais sobre como trabalhar com dados tabulares no nosso tutorial de pandas.
No R, o coeficiente de correlação de Pearson pode ser calculado com a função cor():
cor(x, y)Por padrão, essa função calcula a correlação de Pearson, mas você pode especificar outros métodos se preferir.
Cada uma dessas três ferramentas facilita o cálculo rápido do coeficiente de Pearson. Na verdade, por ser tão simples, é comum analistas gerarem uma matriz de correlação, que mostra correlações pareadas entre várias variáveis de uma vez. Isso ajuda a identificar padrões e relações que podem merecer investigação mais profunda nas etapas seguintes da análise.
Uma coisa é calcular o coeficiente de correlação de Pearson; outra é interpretá-lo. Lembre-se de que o coeficiente r descreve a direção e a força de uma relação linear entre duas variáveis.
O sinal de r indica a direção da relação. Um valor positivo significa que as variáveis tendem a aumentar juntas, enquanto um valor negativo indica que uma tende a diminuir quando a outra aumenta.
A magnitude de r descreve a força da associação linear: valores próximos de 1 são mais fortes do que valores próximos de 0. Diferentes áreas têm tradições distintas sobre o que é considerado “forte”. Em contextos experimentais altamente controlados, como em algumas áreas da física ou engenharia, correlações fortes podem se aproximar de 1. Em campos com sistemas biológicos ou sociais complexos, como medicina, saúde pública, economia ou psicologia, correlações entre 0,1 e 0,4 podem ser relevantes, especialmente quando as variáveis são difíceis de medir ou os efeitos se acumulam em escala. Como os padrões variam entre disciplinas, interpretar r exige conhecimento de domínio e julgamento contextual.
Também é importante notar que a correlação de Pearson é sensível a valores extremos. Um único outlier pode aumentar ou diminuir substancialmente o valor de r. Por isso, é tão importante visualizar os dados. Examinar gráficos de dispersão junto com os coeficientes de correlação ajuda a identificar outliers que podem estar exercendo influência indevida.
Softwares estatísticos costumam fornecer um p-valor junto com o coeficiente de correlação de Pearson. Esse p-valor testa a probabilidade de observar uma correlação ao menos tão forte quanto a dos seus dados caso não exista relação real entre as variáveis. Se for improvável ocorrer por acaso, dizemos que a relação é estatisticamente significativa.
Esse p-valor é calculado convertendo o coeficiente de Pearson em uma estatística t e comparando-a com a distribuição t. É semelhante ao teste t de Student, mas aqui o objetivo é testar se a correlação verdadeira é zero.
Com conjuntos de dados grandes, mesmo um r relativamente pequeno pode ser estatisticamente significativo, embora a relação individual seja fraca. Isso é importante em saúde pública, por exemplo, onde uma relação fraca ainda pode gerar impactos relevantes em nível populacional. Por isso, é útil diferenciar entre a magnitude da correlação (r) e sua significância estatística (p-valor).
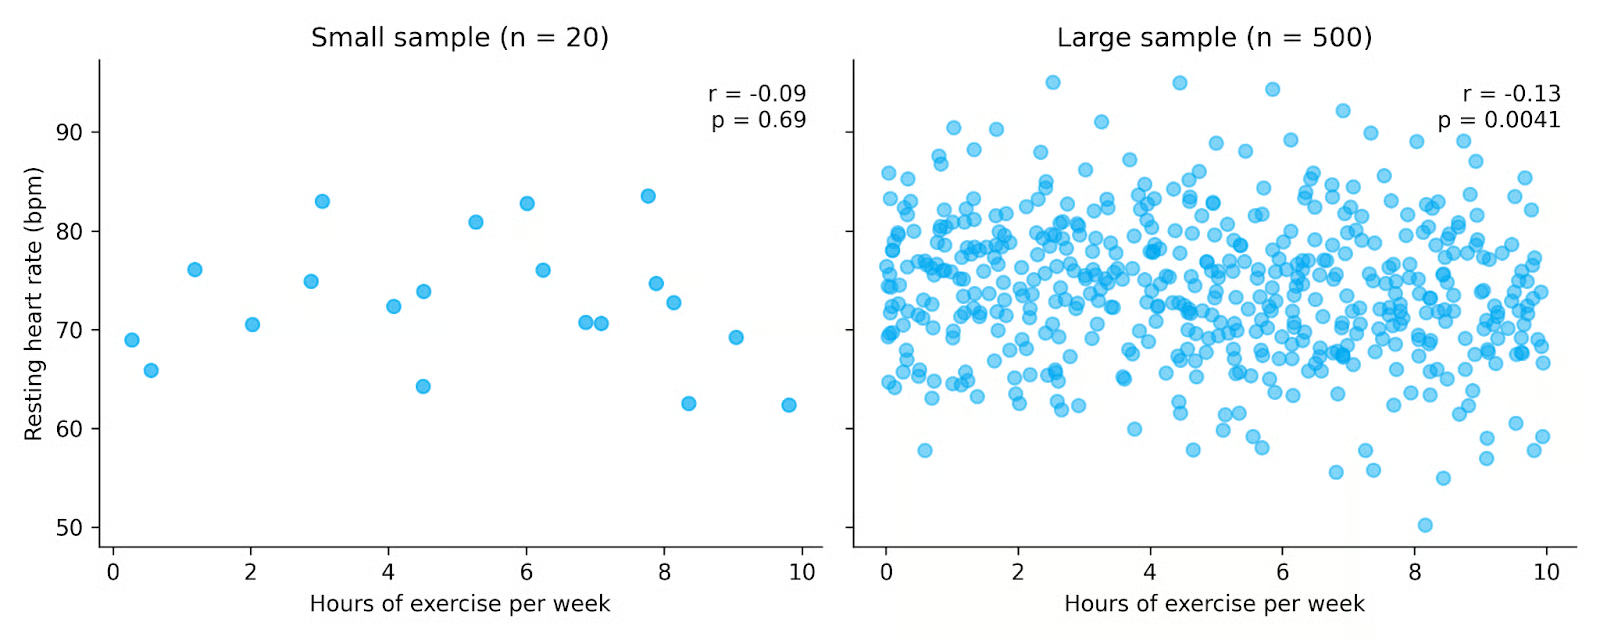
Nos gráficos acima, ambos os conjuntos mostram uma relação negativa fraca entre exercício e frequência cardíaca de repouso. Porém, o conjunto da direita inclui muito mais observações, tornando a relação estatisticamente significativa mesmo com correlação pequena. Isso destaca como amostras maiores aumentam nossa capacidade de detectar relações e por que é importante considerar tanto o valor de r quanto o p-valor ao interpretar resultados.
O coeficiente de correlação de Pearson é amplamente usado por ser simples de calcular e interpretar. Mas, como muitas ferramentas estatísticas, ele funciona melhor quando certos pressupostos sobre os dados são razoavelmente atendidos.
Primeiro, a correlação de Pearson pressupõe uma relação linear entre duas variáveis. Se a relação verdadeira for curvilínea ou não linear, o coeficiente pode subestimar a força da associação ou até sugerir que não há relação.
Outro pressuposto é que as variáveis analisadas sejam contínuas. A correlação de Pearson foi projetada para variáveis medidas em escalas numéricas contínuas, como altura, renda, temperatura ou notas. Se você tem dados ordinais ou discretos, pode ser melhor usar correlação de Spearman ou tau de Kendall.
Também é desejável que os dados sigam distribuição normal. Isso é especialmente importante se você for realizar testes de hipótese ou calcular intervalos de confiança para o coeficiente. Se as distribuições forem fortemente não normais, a correlação estimada pode até descrever a relação na amostra, mas o p-valor tende a ser menos confiável.
A correlação de Pearson também assume homocedasticidade, ou seja, que a variabilidade de uma variável é relativamente consistente ao longo da faixa da outra. Na prática, isso significa que a dispersão dos pontos em um gráfico de dispersão deve permanecer mais ou menos semelhante conforme os valores aumentam ou diminuem. Quando a dispersão muda bastante ao longo dos dados, o coeficiente pode não capturar plenamente a estrutura da relação. Assim como na normalidade, você ainda pode calcular r se esse pressuposto for violado, mas os testes de inferência subsequentes serão menos confiáveis.
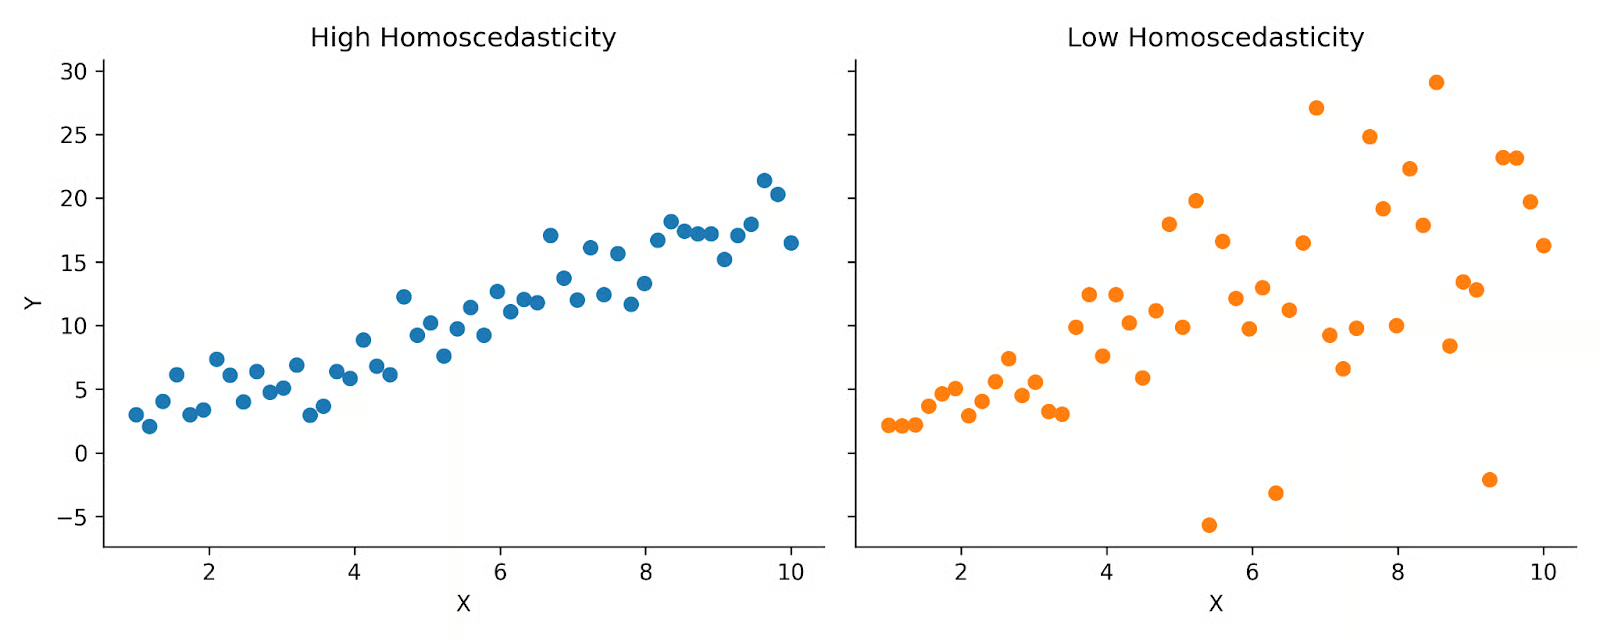
Acima você vê dois gráficos que demonstram alta e baixa homocedasticidade. À esquerda, a dispersão é relativamente uniforme. À direita, há um formato de cone. A correlação de Pearson pressupõe que seus dados se pareçam mais com o gráfico da esquerda.
Por fim, como já discutimos, a correlação de Pearson é sensível a outliers. Valores extremos podem influenciar desproporcionalmente o cálculo, pois o coeficiente se baseia em médias e desvios-padrão. Um único ponto incomum pode aumentar ou reduzir substancialmente a correlação.
Correlação de Pearson e correlação de Spearman soam parecidas e podem ser facilmente confundidas. Ambas medem a relação entre duas variáveis, mas diferem no tipo de relação que capturam e nos pressupostos em que se baseiam.
O coeficiente de Pearson mede a força de uma relação linear entre duas variáveis contínuas. Já o coeficiente de Spearman mede a força de uma relação monotônica, isto é, as variáveis se movem na mesma direção, mas não necessariamente a uma taxa constante. Uma relação monotônica pode ser linear ou não linear, desde que aumente ou diminua de forma consistente.
A correlação de Spearman é calculada usando os postos (ranks) dos dados, e não os valores brutos. Ao converter dados em postos, a correlação de Spearman reduz o impacto de outliers e não exige o pressuposto de linearidade.
A correlação de Pearson é considerada uma medida paramétrica porque depende de pressupostos sobre a distribuição dos dados. Já a correlação de Spearman é considerada não paramétrica, pois não requer os mesmos pressupostos e é menos dependente da normalidade.
Quando os pressupostos da correlação de Pearson são atendidos, ela pode fornecer uma estimativa mais precisa da associação linear do que a de Spearman. Porém, quando os dados não atendem a esses critérios, a correlação de Spearman ainda consegue captar a relação entre as variáveis.
|
Coeficiente de correlação |
Quando usar |
|
Correlação de Pearson |
Relação linear; variáveis contínuas; dados bem comportados |
|
Correlação de Spearman |
Relação monotônica; presença de outliers; dados ordinais ou ranqueados |
Covariância é um conceito intimamente relacionado, mas difere na forma de escala e interpretação.
A covariância mede se duas variáveis tendem a se mover na mesma direção ou em direções opostas. Se aumentam juntas, a covariância é positiva. Se uma aumenta enquanto a outra diminui, a covariância é negativa.
No entanto, a magnitude da covariância depende das unidades das variáveis. Por exemplo, a covariância entre altura em centímetros e peso em quilogramas será numericamente diferente da covariância entre altura em polegadas e peso em libras. Isso dificulta a comparação entre conjuntos de dados.
O coeficiente de correlação de Pearson resolve essa limitação dividindo a covariância pelo produto dos desvios-padrão das duas variáveis. Com essa normalização, a correlação de Pearson é adimensional e sempre fica entre −1 e +1. Esse intervalo limitado facilita muito a interpretação.
Em termos simples:
Embora o coeficiente de correlação de Pearson seja amplamente usado e fácil de interpretar, ele tem algumas limitações importantes.
A correlação de Pearson funciona melhor como parte de um fluxo mais amplo de exploração e análise. Visualize seus dados, verifique se os pressupostos são atendidos e considere o contexto do seu problema ao usar e interpretar o coeficiente de Pearson.
O coeficiente de correlação de Pearson é uma medida estatística fundamental usada em diversas disciplinas. Se você quer entender como a correlação entra nos fluxos de trabalho do mundo real, explore nosso tutorial de análise exploratória de dados em Python. Se quiser ver a correlação na prática, confira nosso tutorial de pandas para ver como as correlações são usadas em dados reais.
Aprenda com a DataCamp
Curso
Curso
Curso
blog
Summer Worsley
15 min
blog
Vinita Silaparasetty
14 min
Tutorial
Avinash Navlani
10 min
Tutorial
DataCamp Team
10 min
Tutorial
Abid Ali Awan
6 min
Tutorial
Abid Ali Awan
13 min