
Last chance! 50% off DataCamp Premium
Sale ends in
Bayangkan Anda melihat beberapa data perusahaan dan menyadari bahwa saat pengeluaran iklan meningkat, pendapatan Anda juga tampaknya meningkat. Sebelum mengambil keputusan, Anda perlu mengkuantifikasi seberapa kuat hubungan tersebut.
Koefisien korelasi Pearson adalah cara andalan untuk mengkuantifikasi hubungan seperti itu. Metode ini digunakan di berbagai disiplin, termasuk data science, ekonomi, psikologi, dan biologi. Analis bahkan menghitung korelasi selama analisis data eksploratori untuk menemukan pola sebelum beralih ke teknik lainnya.
Sebelum melihat rumus atau perhitungan, ada baiknya mengembangkan pemahaman intuitif tentang apa yang dijelaskan oleh korelasi. Secara sangat mendasar, korelasi mengukur bagaimana dua variabel bergerak bersama, seperti yang telah disebutkan. Ini menjawab pertanyaan, “Saat satu variabel meningkat, apa yang terjadi pada variabel lainnya?”
Korelasi berfokus khusus pada pola pergerakan bersama, bukan pada nilai-nilai individual. Ketika dua variabel cenderung meningkat atau menurun pada saat yang sama, keduanya memiliki hubungan positif. Ketika dua variabel cenderung bergerak ke arah yang berlawanan (satu meningkat sementara yang lain menurun), keduanya memiliki hubungan negatif. Dan ketika nilai kedua variabel tampaknya tidak memiliki pola yang konsisten, mungkin tidak ada hubungan.
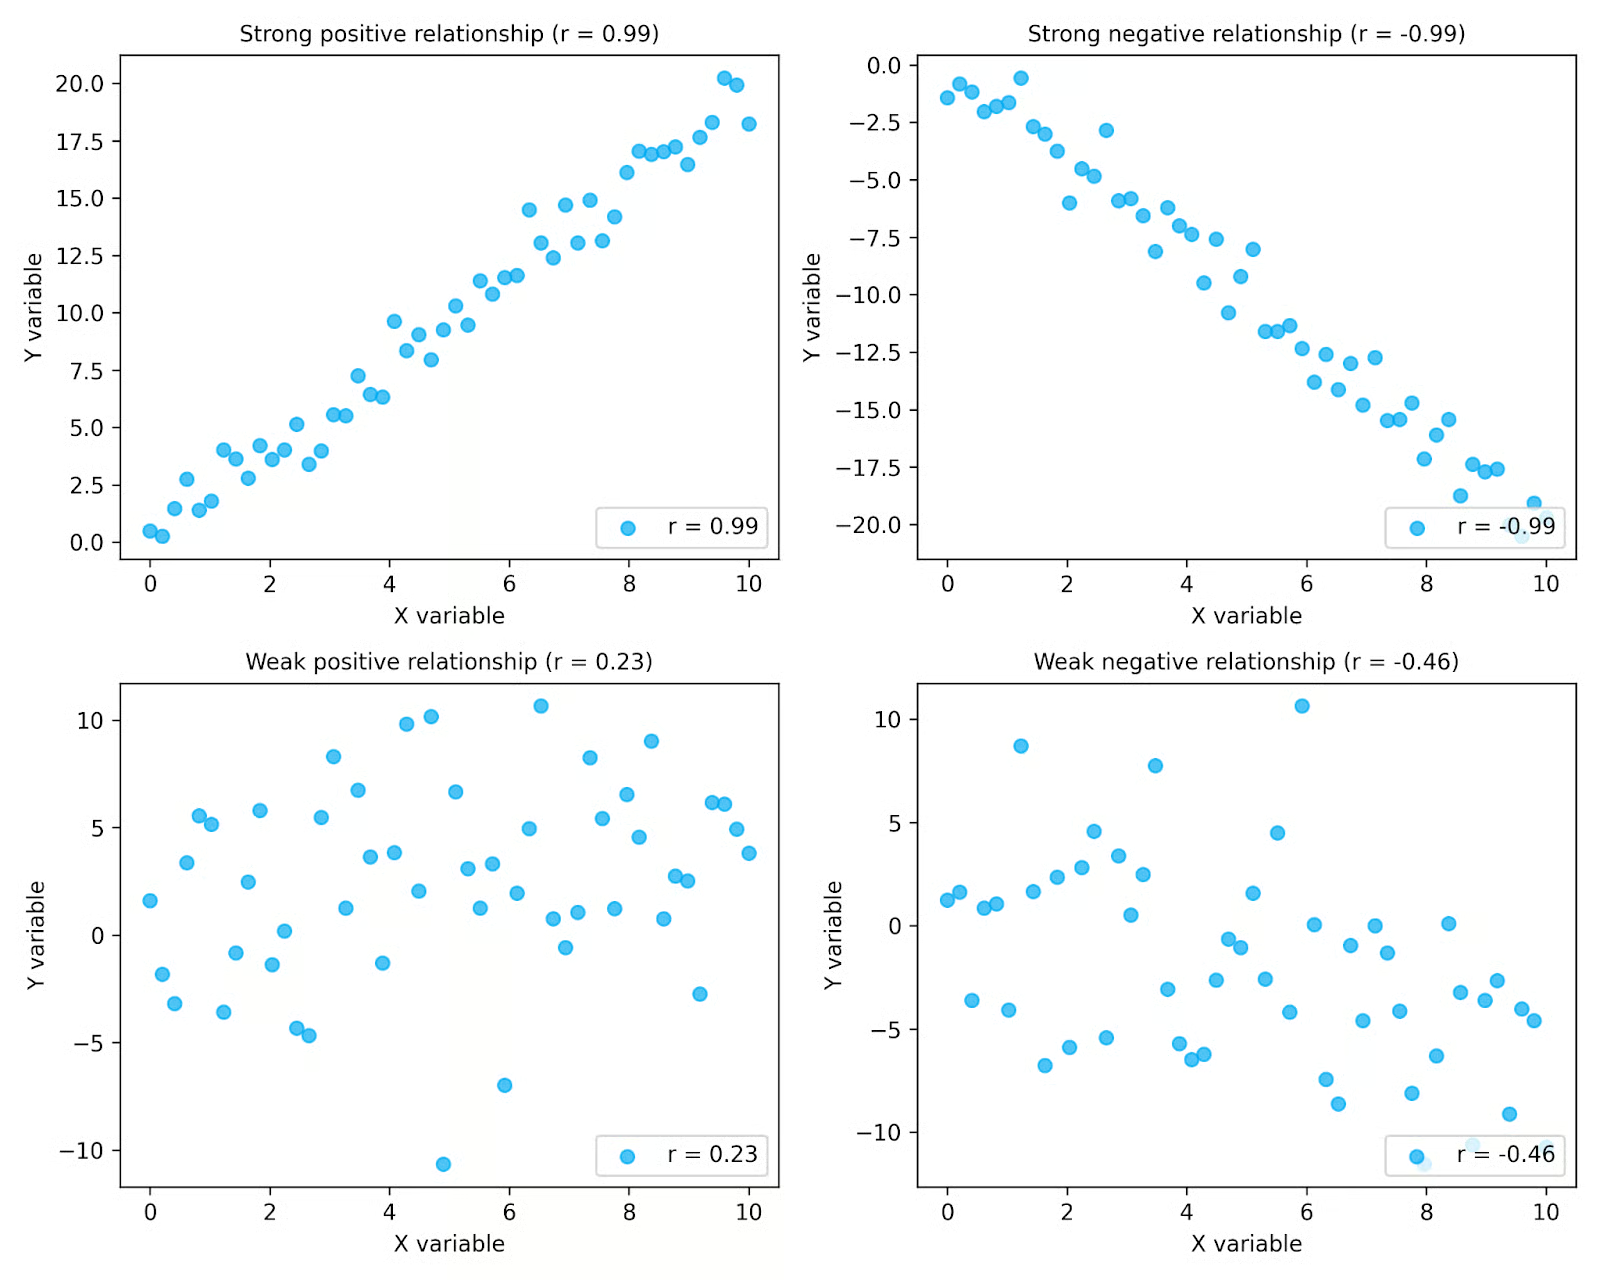
Pada plot di atas, Anda dapat melihat bagaimana korelasi menangkap baik arah maupun kekuatan. Baris atas menunjukkan hubungan yang kuat, di mana titik-titik mengikuti pola yang jelas, sementara baris bawah menunjukkan hubungan yang lebih lemah dengan sebaran yang lebih besar. Plot di sebelah kiri menunjukkan hubungan positif, di mana nilai meningkat bersama, dan plot di sebelah kanan menunjukkan hubungan negatif, di mana satu variabel menurun saat variabel lainnya meningkat. Nilai r yang ditampilkan di setiap plot merangkum pola-pola ini.
Korelasi sangat berguna selama analisis data eksploratori, ketika analis menelaah hubungan antarvariabel. Membuat plot data Anda memudahkan untuk melihat pola dan menentukan apakah ukuran korelasi seperti Pearson tepat untuk data Anda.
Penting juga untuk diingat bahwa korelasi menggambarkan hubungan yang diamati dalam data, bukan mekanisme yang menyebabkannya. Bahkan ketika dua variabel berkorelasi kuat, itu tidak berarti bahwa satu variabel menyebabkan variabel lain berubah. Korelasi sekadar merangkum pola yang ada. Ingatlah pepatah lama, “korelasi tidak menyiratkan kausalitas”.
Koefisien korelasi Pearson memberikan cara formal untuk mengukur kekuatan dan arah hubungan linear antara dua variabel kontinu. Ini merangkum seberapa dekat titik-titik data dalam scatter plot mengikuti pola garis lurus.
Nilai koefisien korelasi Pearson selalu berada antara −1 dan +1.
|
Nilai r |
Interpretasi |
|
+1 |
Hubungan linear positif sempurna |
|
0 |
Tidak ada hubungan linear |
|
−1 |
Hubungan linear negatif sempurna |
Nilai-nilai ini mengkuantifikasi pola yang kita bahas pada bagian sebelumnya. Nilai yang lebih dekat ke +1 atau −1 menunjukkan hubungan linear yang lebih kuat, sementara nilai yang lebih dekat ke 0 menunjukkan hubungan yang lebih lemah. Tanda menunjukkan apakah hubungannya positif atau negatif.
Poin pentingnya adalah bahwa korelasi Pearson hanya mengukur hubungan linear. Jika dua variabel mengikuti pola nonlinier, koefisien korelasi bisa mendekati nol meskipun variabel-variabel tersebut jelas saling terkait. Dengan kata lain, r = 0 tidak serta merta berarti tidak ada hubungan; itu berarti tidak ada hubungan linear antara variabel-variabel tersebut.
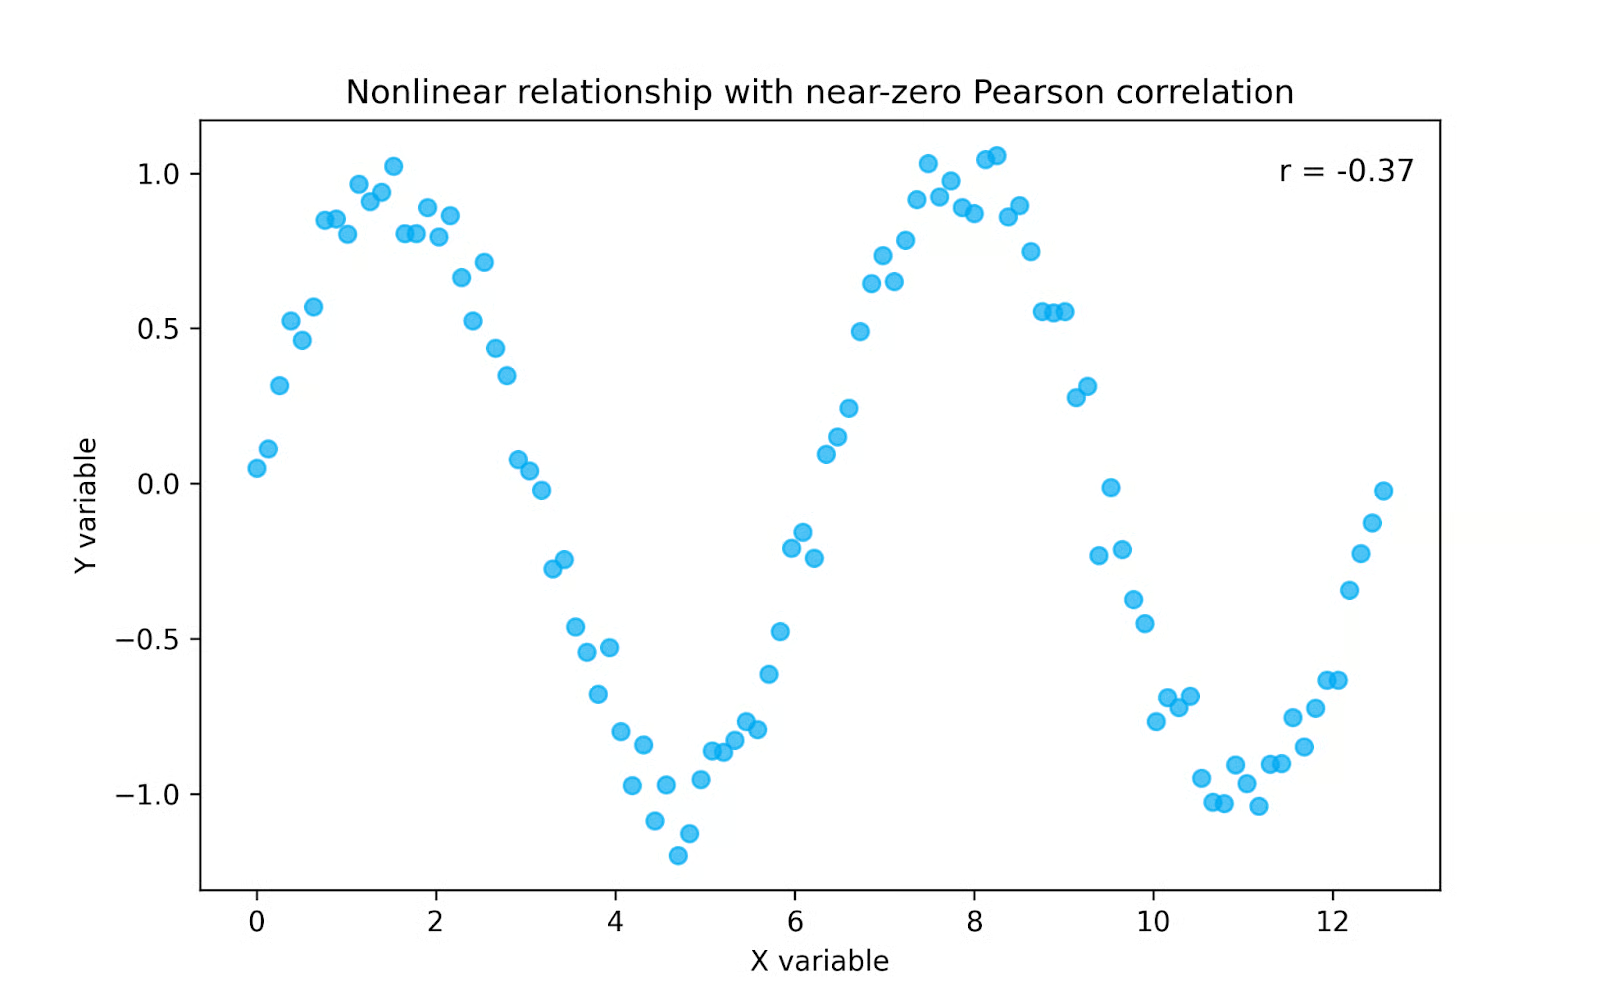
Pada plot di atas, variabel-variabel jelas mengikuti pola, tetapi bukan garis lurus. Karena korelasi Pearson hanya mengukur hubungan linear, nilai r mendekati nol meskipun variabel-variabel tersebut sangat terkait. Dalam kasus seperti ini, ukuran berbasis peringkat seperti korelasi Spearman mungkin lebih tepat, karena dapat menangkap pola monoton yang tidak linear.
Koefisien korelasi Pearson dihitung menggunakan rumus yang membandingkan bagaimana dua variabel berubah bersama relatif terhadap seberapa besar perubahan masing-masing variabel secara individual. Rumus ini paling umum ditulis sebagai:
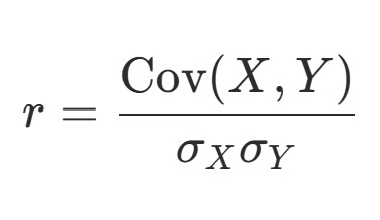
Dalam ekspresi ini, Cov(X, Y) merepresentasikan kovarians antara dua variabel, sedangkan σX dan σY merepresentasikan simpangan baku masing-masing variabel. Kovarians mengukur apakah dua variabel cenderung meningkat atau menurun bersama, tetapi magnitudonya bergantung pada satuan variabel. Membagi dengan simpangan baku menstandarkan hasil dan memastikan bahwa koefisien korelasi Pearson selalu berada antara −1 dan +1. Untuk pembahasan lebih luas tentang korelasi dan kovarians, lihat tutorial kami mengenai topik tersebut.
Korelasi Pearson pada dasarnya adalah kovarians yang telah distandarkan. Sementara kovarians memberi tahu kita apakah variabel bergerak ke arah yang sama atau berlawanan, korelasi men-skala informasi ini sehingga kekuatan hubungan dapat ditafsirkan secara konsisten antar dataset.
Jika Anda pernah harus melakukan perhitungan ini secara manual (terima kasih kelas statistik!) Anda mungkin mengenali versi rumus ini, yang membuat langkah-langkahnya lebih eksplisit:
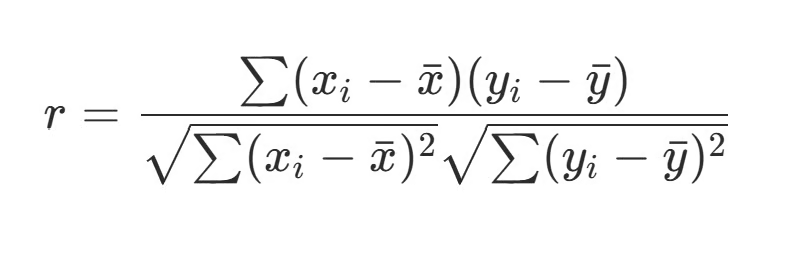
Di sini, setiap observasi dibandingkan dengan mean variabelnya. Istilah (Xi − X̄) dan (Yi − Ȳ) menghitung seberapa jauh setiap nilai dari rata-ratanya. Mengalikan deviasi ini mengukur apakah variabel bergerak ke arah yang sama pada setiap observasi. Ketika kedua deviasi positif atau keduanya negatif, hasil kalinya positif, berkontribusi pada korelasi positif. Ketika satu deviasi positif dan yang lain negatif, hasil kalinya negatif, berkontribusi pada korelasi negatif.
Logika dasar perhitungannya sederhana:
Struktur ini memungkinkan koefisien korelasi Pearson memberikan ukuran baku tentang seberapa kuat dua variabel berhubungan secara linear, terlepas dari satuan atau skala asalnya.
Mari kita melalui sebuah contoh singkat bersama. Misalkan kita ingin menelaah hubungan antara jam belajar dan nilai ujian untuk sekelompok siswa. Di bawah ini, kita memiliki dataset kecil untuk lima siswa.
|
Siswa |
Jam Belajar (X) |
Nilai Ujian (Y) |
|
Luther |
5 |
72 |
|
Alexandra |
2 |
70 |
|
Javier |
3 |
63 |
|
Jamie |
1 |
58 |
|
Auburn |
4 |
73 |
Langkah pertama selalu adalah memplot data Anda. Jadi mari kita lakukan di bawah ini.
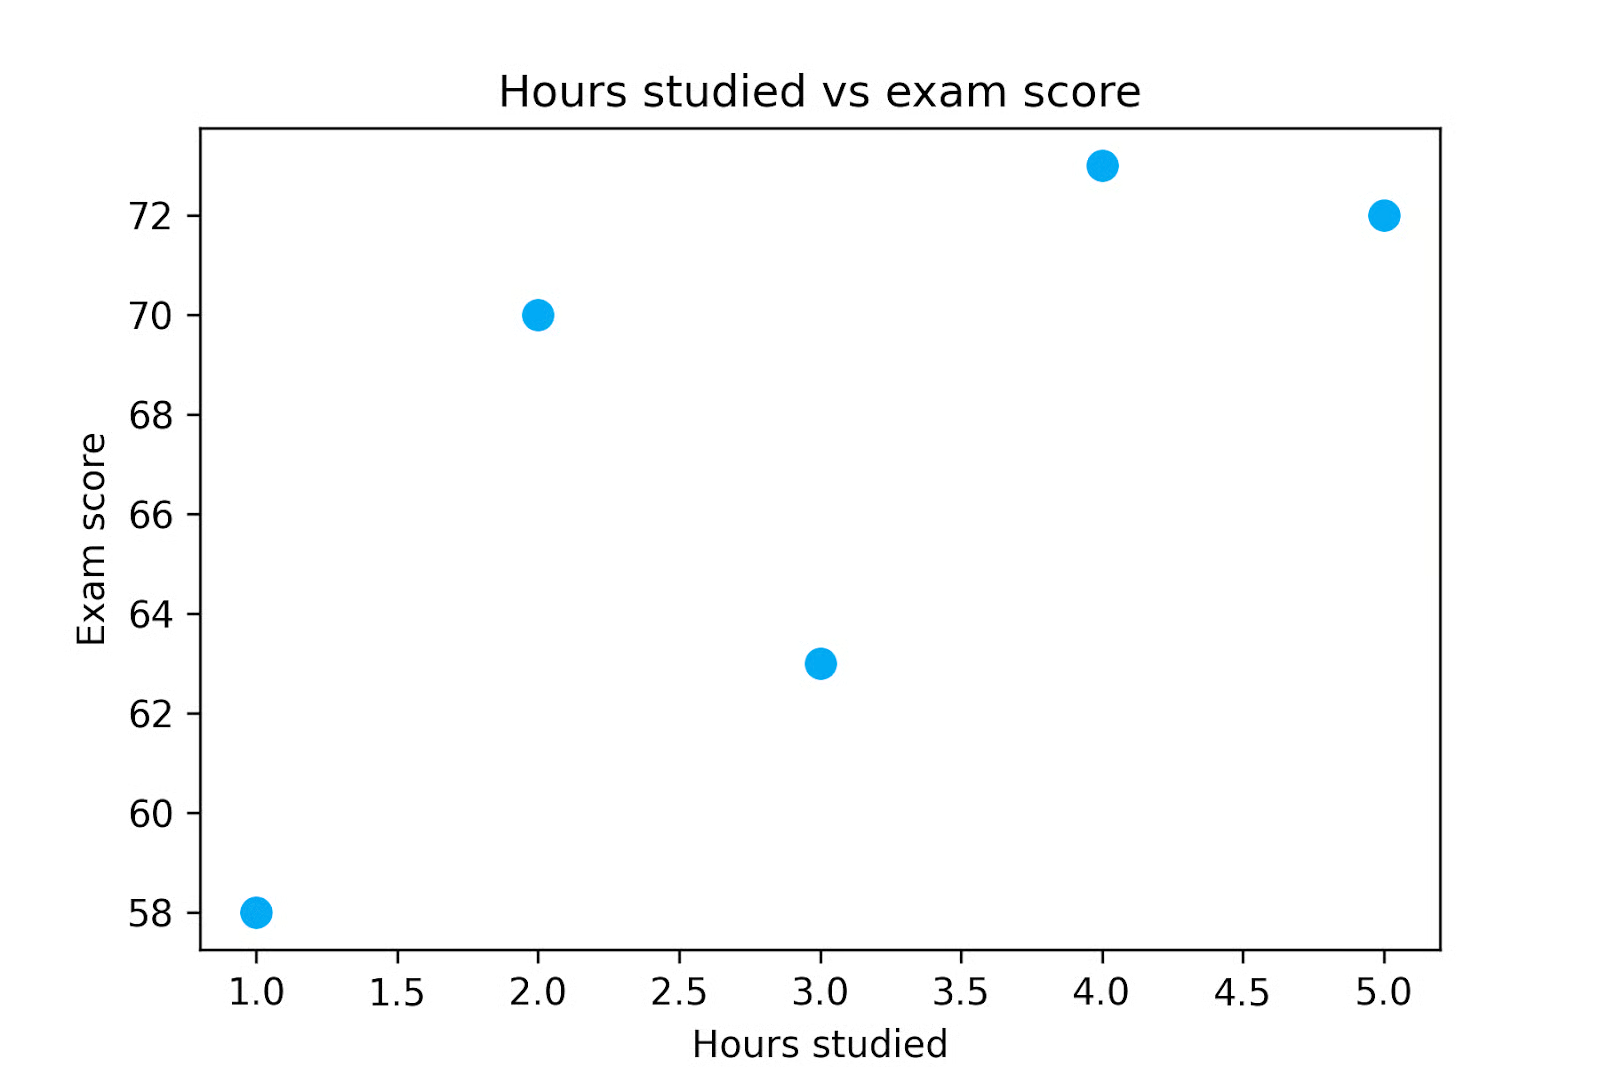
Saat kita memplot data, kita dapat melihat bahwa nilai ujian cenderung meningkat seiring bertambahnya waktu belajar, tetapi kita ingin mengkuantifikasi hubungan ini. Jadi mari kita hitung koefisien korelasi Pearson untuk dataset ini.
Pertama, kita perlu menghitung mean masing-masing variabel. Dalam contoh ini, rata-rata jam belajar adalah 3, dan rata-rata nilai ujian adalah 67,2.
Selanjutnya, kita menghitung seberapa jauh setiap observasi dari mean-nya. Nilai-nilai ini disebut deviasi dari mean.
Lalu, kita mengalikan deviasi untuk menunjukkan bagaimana variabel bergerak bersama pada setiap observasi. Ketika kedua deviasi memiliki tanda yang sama, hasil kalinya positif, yang berkontribusi pada korelasi positif. Ketika deviasinya bertanda berlawanan, hasil kalinya negatif dan berkontribusi pada korelasi negatif.
|
X |
Y |
X − X̄ |
Y − Ȳ |
(X − X̄)(Y − Ȳ) |
|
1 |
58 |
-2 |
-9.2 |
18.4 |
|
2 |
70 |
-1 |
2.8 |
-2.8 |
|
3 |
63 |
0 |
-4.2 |
0 |
|
4 |
73 |
1 |
5.8 |
5.8 |
|
5 |
72 |
2 |
4.8 |
9.6 |
Saat kita jumlahkan hasil kali pada kolom terakhir, kita mendapatkan 31, yang merupakan pembilang dari perhitungan korelasi Pearson kita.
Selanjutnya, kita menghitung variabilitas masing-masing variabel menggunakan simpangan bakunya. Untuk melakukan ini, kita kuadratkan deviasi pada kolom 3 dan 4 sebelum menjumlahkannya.
Untuk X:
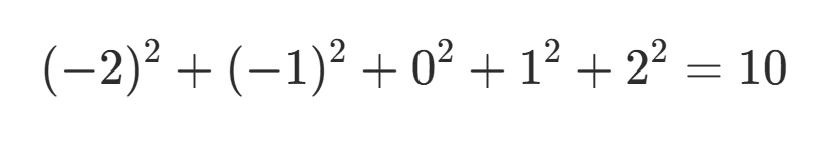
Untuk Y:
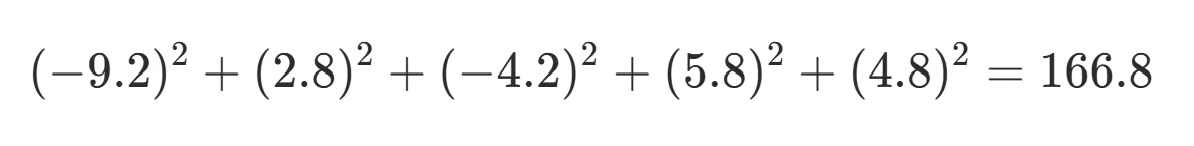
Kemudian kita ambil akar kuadrat dari masing-masing jumlah:
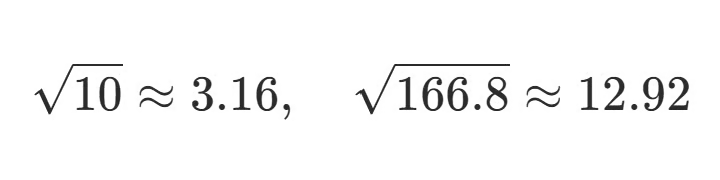
Terakhir, kita bagi pembilang dengan hasil kali simpangan baku:
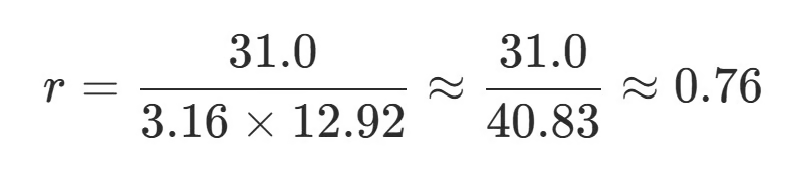
Langkah terakhir ini memberikan koefisien korelasi Pearson kita, yang dalam kasus ini kira-kira 0,76, menunjukkan hubungan linear positif yang kuat. Kita dapat menyimpulkan dari sini bahwa jumlah jam belajar seorang siswa berkorelasi kuat dan positif dengan nilai ujiannya.
Namun, kita tidak dapat menyimpulkan bahwa jam belajar menyebabkan nilai ujian mereka. Untuk menyimpulkan hal itu, kita memerlukan analisis tambahan atau studi eksperimental.
Dari contoh sederhana di atas, terlihat bahwa menghitung koefisien korelasi Pearson secara manual kurang praktis.
Untungnya, sebagian besar perangkat lunak statistik memiliki fungsi bawaan untuk menghitungnya. Memahami mekanisme di balik perhitungan berguna untuk intuisi, tetapi dalam alur kerja nyata, koefisien biasanya dihitung secara otomatis. Mari kita lihat secara singkat cara menghitung koefisien korelasi Pearson menggunakan tiga alat umum: Excel, Python, dan R.
Di Excel, koefisien korelasi Pearson mudah dihitung menggunakan fungsi CORREL(). Fungsi ini menerima dua rentang nilai yang merepresentasikan variabel yang diminati dan mengembalikan koefisien korelasinya.
=CORREL(A1:A10, B1:B10)Fungsi tersebut menghitung r Pearson secara langsung dari rentang yang dipilih, sehingga menjadi cara cepat untuk mengeksplorasi hubungan antarvariabel dalam spreadsheet.
Di Python, koefisien korelasi Pearson umumnya dihitung menggunakan pustaka pandas atau SciPy. Metode corr() di pandas menghitung korelasi antar kolom dalam sebuah DataFrame:
import pandas as pd

pearson_df['hours_studied'].corr(pearson_df['exam_score'])
Sebagai alternatif, fungsi pearsonr() dari modul statistik SciPy mengembalikan baik koefisien korelasi maupun nilai p untuk pengujian hipotesis:
from scipy.stats import pearsonr

pearsonr(pearson_df['hours_studied'], pearson_df['exam_score'])
Jika Anda baru dalam analisis data berbasis Python, Anda dapat mempelajari lebih lanjut cara bekerja dengan dataset tabular dalam tutorial pandas kami.
Di R, koefisien korelasi Pearson dapat dihitung menggunakan fungsi cor():
cor(x, y)Secara default, fungsi ini menghitung koefisien korelasi Pearson, meskipun Anda dapat menentukan metode korelasi lain jika diinginkan.
Ketiga alat ini memudahkan penghitungan koefisien korelasi Pearson dengan cepat. Faktanya, karena begitu mudah, analis sering membuat matriks korelasi, yang menampilkan korelasi berpasangan antara banyak variabel sekaligus. Ini membantu mengidentifikasi pola dan hubungan yang mungkin perlu ditelaah lebih lanjut pada tahap analisis berikutnya.
Menghitung koefisien korelasi Pearson adalah satu hal, tetapi bagaimana cara menafsirkannya? Ingat bahwa koefisien r menggambarkan arah dan kekuatan hubungan linear antara dua variabel.
Tanda dari r menunjukkan arah hubungan. Nilai positif berarti variabel cenderung meningkat bersama, sedangkan nilai negatif menunjukkan bahwa satu variabel cenderung menurun saat yang lain meningkat.
Magnitudo r menggambarkan kekuatan keterkaitan linear, dengan nilai yang lebih dekat ke 1 lebih kuat daripada yang lebih dekat ke 0. Bidang yang berbeda mungkin memiliki tradisi berbeda tentang apa yang dianggap sebagai hubungan kuat. Dalam pengaturan eksperimental yang sangat terkontrol, seperti beberapa area fisika atau teknik, korelasi kuat dapat mendekati 1. Di bidang yang melibatkan sistem biologis atau sosial yang kompleks, seperti kedokteran, kesehatan masyarakat, ekonomi, atau psikologi, korelasi dalam rentang 0,1 hingga 0,4 tetap bisa bermakna, terutama ketika variabel sulit diukur atau efeknya terakumulasi dalam skala besar. Karena standar bervariasi antar disiplin, menafsirkan r memerlukan pengetahuan domain dan penilaian kontekstual.
Penting juga untuk dicatat bahwa korelasi Pearson sensitif terhadap nilai ekstrem. Satu outlier saja dapat secara substansial meningkatkan atau menurunkan nilai r. Inilah salah satu alasan mengapa memplot data Anda sangat penting. Menelaah scatter plot bersamaan dengan koefisien korelasi membantu mengidentifikasi outlier yang mungkin memberikan pengaruh berlebihan.
Perangkat lunak statistik sering kali dapat menyediakan nilai p bersamaan dengan koefisien korelasi Pearson Anda. Nilai p ini menguji seberapa mungkin mengamati korelasi setidaknya sekuat yang ada dalam data Anda jika sebenarnya tidak ada hubungan antara variabel. Jika kecil kemungkinannya terjadi hanya karena kebetulan, kita mengatakan bahwa hubungan tersebut signifikan secara statistik.
Nilai p ini dihitung dengan mengonversi koefisien korelasi Pearson menjadi statistik t dan membandingkannya dengan distribusi t. Ini mirip dengan uji t Student, tetapi di sini tujuannya adalah menguji apakah korelasi sebenarnya sama dengan nol.
Dengan dataset besar, bahkan nilai r yang relatif kecil mungkin tetap signifikan secara statistik, meskipun mungkin tetap merupakan hubungan yang lemah pada tingkat individu. Ini penting bagi kesehatan masyarakat, misalnya, di mana hubungan yang lemah tetap dapat menyebabkan dampak kesehatan yang signifikan pada tingkat populasi. Karena itu, sering kali berguna untuk membedakan antara magnitudo korelasi (r) dan signifikansi statistiknya (nilai p).
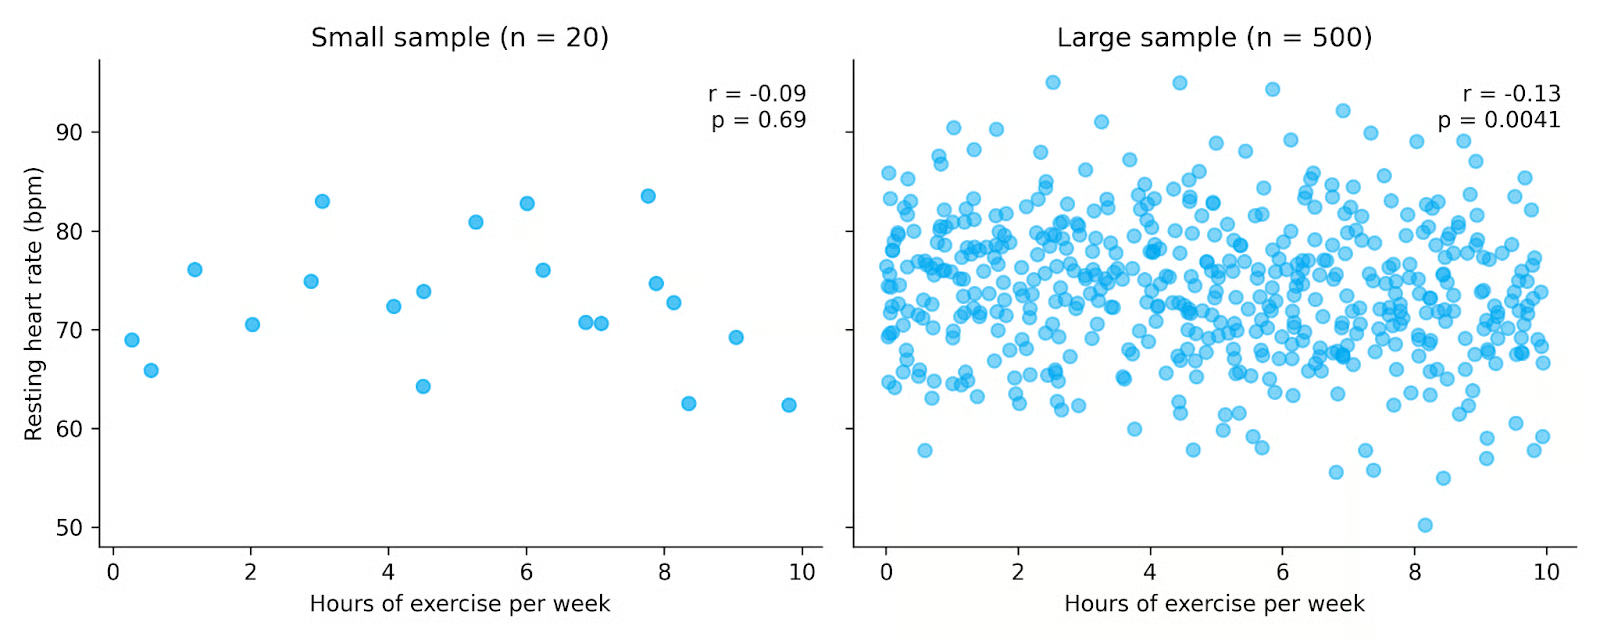
Pada plot di atas, kedua dataset menunjukkan hubungan negatif yang lemah antara olahraga dan detak jantung saat istirahat. Namun, dataset di sebelah kanan mencakup jauh lebih banyak observasi, membuat hubungan tersebut signifikan secara statistik meskipun korelasinya tetap kecil. Ini menyoroti bagaimana ukuran sampel yang lebih besar meningkatkan kemampuan kita untuk mendeteksi hubungan, dan mengapa penting mempertimbangkan baik nilai r maupun nilai p saat menafsirkan hasil.
Koefisien korelasi Pearson banyak digunakan karena mudah dihitung dan ditafsirkan. Namun, seperti banyak alat statistik lainnya, ini bekerja paling baik ketika asumsi tertentu tentang data terpenuhi secara wajar.
Pertama, korelasi Pearson mengasumsikan hubungan linear antara dua variabel. Jika hubungan sebenarnya mengikuti pola melengkung atau nonlinier, koefisien dapat meremehkan kekuatan keterkaitan atau bahkan menyiratkan bahwa tidak ada hubungan.
Asumsi lain adalah bahwa variabel yang dianalisis bersifat kontinu. Korelasi Pearson dirancang untuk variabel yang diukur pada skala numerik kontinu, seperti tinggi badan, pendapatan, suhu, atau nilai ujian. Jika Anda memiliki data ordinal atau diskret, Anda mungkin lebih cocok menggunakan korelasi Spearman atau Kendall’s tau.
Anda umumnya juga menginginkan data yang berdistribusi normal. Ini sangat penting jika Anda melakukan uji hipotesis atau menghitung interval kepercayaan untuk koefisien korelasi. Jika distribusi sangat tidak normal, korelasi yang diestimasi mungkin masih menggambarkan hubungan sampel, tetapi nilai p yang Anda dapatkan kemungkinan kurang andal.
Korelasi Pearson juga mengasumsikan homoskedastisitas, yang berarti variabilitas satu variabel relatif konsisten di seluruh rentang variabel lainnya. Secara praktis, ini berarti sebaran titik dalam scatter plot harus tetap kurang lebih serupa saat nilai meningkat atau menurun. Ketika sebaran berubah secara substansial di seluruh rentang data, koefisien korelasi mungkin tidak sepenuhnya menangkap struktur hubungan. Seperti halnya normalitas, Anda masih dapat menghitung r jika melanggar asumsi ini, tetapi uji inferensial selanjutnya akan kurang andal.
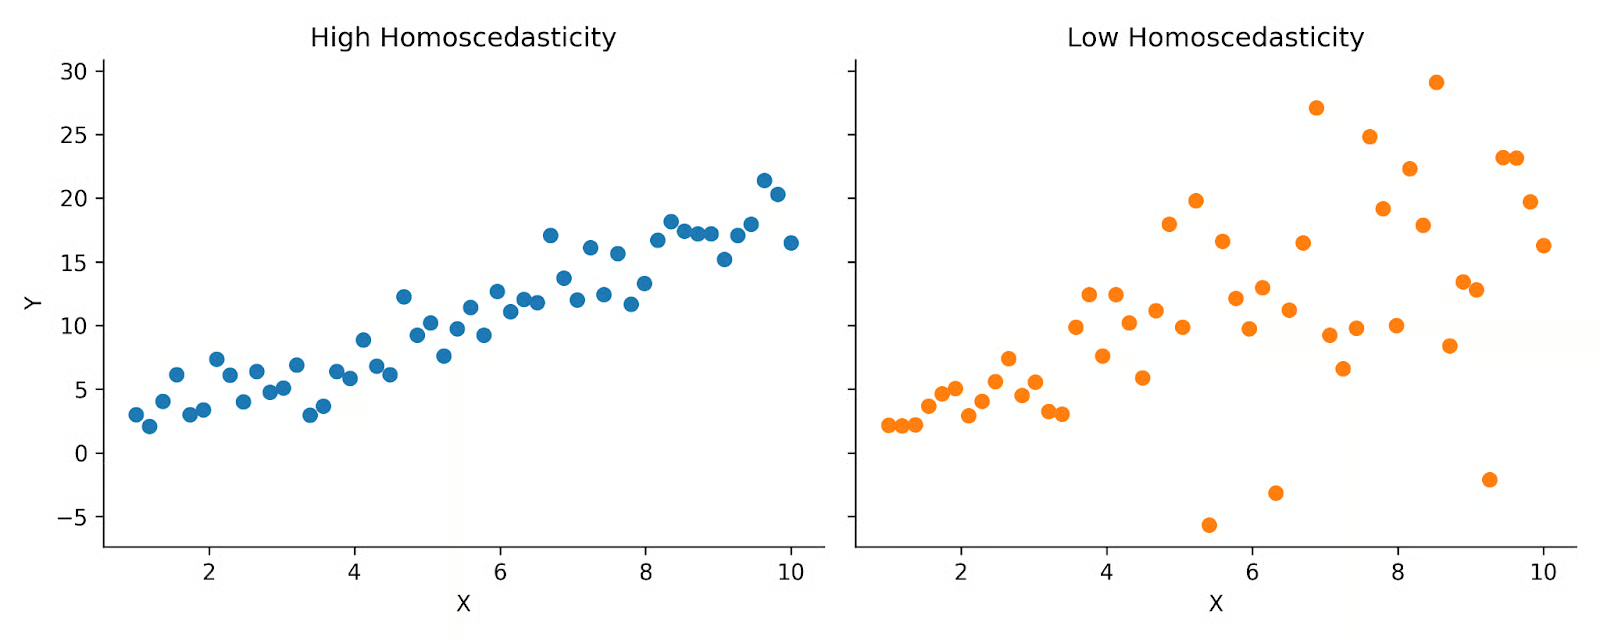
Di atas Anda dapat melihat dua plot yang menunjukkan homoskedastisitas tinggi versus rendah. Di sebelah kiri, data tersebar cukup merata di seluruh distribusi. Tetapi di sebelah kanan, Anda melihat bentuk seperti kerucut. Korelasi Pearson mengasumsikan bahwa data Anda terlihat lebih seperti plot di sebelah kiri.
Terakhir, seperti yang telah kita bahas sebelumnya, korelasi Pearson sensitif terhadap outlier. Nilai ekstrem dapat secara tidak proporsional memengaruhi perhitungan karena koefisien ini didasarkan pada mean dan simpangan baku. Satu titik data yang tidak biasa saja dapat secara substansial meningkatkan atau menurunkan korelasi.
Korelasi Pearson dan korelasi Spearman terdengar sangat mirip dan mudah membingungkan. Keduanya merupakan ukuran hubungan antara dua variabel, tetapi berbeda dalam jenis hubungan yang ditangkap dan asumsi yang digunakan.
Koefisien korelasi Pearson mengukur kekuatan hubungan linear antara dua variabel kontinu. Sebaliknya, koefisien korelasi Spearman mengukur kekuatan hubungan monoton, yang berarti variabel bergerak ke arah yang sama tetapi tidak harus pada laju yang konstan. Hubungan monoton bisa linear atau nonlinier, selama terus meningkat atau menurun secara konsisten.
Korelasi Spearman dihitung menggunakan nilai peringkat dari data, bukan nilai mentah. Dengan mengonversi data menjadi peringkat, korelasi Spearman mengurangi dampak outlier dan tidak memerlukan asumsi linearitas.
Korelasi Pearson dianggap sebagai ukuran parametrik karena mengandalkan asumsi tentang distribusi data. Namun, korelasi Spearman dianggap nonparametrik, karena tidak memerlukan asumsi distribusi yang sama dan kurang bergantung pada normalitas.
Ketika asumsi untuk korelasi Pearson terpenuhi, ukuran ini dapat memberikan estimasi yang lebih presisi tentang keterkaitan linear aktual dibandingkan korelasi Spearman. Namun, ketika data kita tidak memenuhi standar tersebut, korelasi Spearman masih bisa menangkap adanya hubungan antara dua variabel.
|
Koefisien Korelasi |
Kapan Digunakan |
|
Korelasi Pearson |
Hubungan linear; variabel kontinu; data yang “baik”/tertib |
|
Korelasi Spearman |
Hubungan monoton; keberadaan outlier; data ordinal atau berperingkat |
Kovarians adalah konsep yang sangat terkait, tetapi berbeda dalam cara penskalaan dan penafsirannya.
Kovarians mengukur apakah dua variabel cenderung bergerak ke arah yang sama atau ke arah yang berlawanan. Jika variabel meningkat bersama, kovariansnya positif. Jika satu meningkat sementara yang lain menurun, kovariansnya negatif.
Namun, magnitudo kovarians bergantung pada satuan variabel. Misalnya, kovarians antara tinggi yang diukur dalam sentimeter dan berat dalam kilogram akan berbeda secara numerik dari kovarians antara tinggi dalam inci dan berat dalam pon. Hal ini membuat kovarians sulit dibandingkan antar dataset.
Koefisien korelasi Pearson mengatasi keterbatasan ini dengan membagi kovarians dengan hasil kali simpangan baku dari kedua variabel. Karena normalisasi ini, korelasi Pearson tidak memiliki satuan dan selalu berada antara −1 dan +1. Rentang terbatas ini membuatnya jauh lebih mudah untuk ditafsirkan.
Secara sederhana:
Meskipun koefisien korelasi Pearson banyak digunakan dan mudah ditafsirkan, ada beberapa keterbatasan penting.
Korelasi Pearson paling baik digunakan sebagai bagian dari alur kerja eksplorasi dan analisis yang lebih luas. Visualisasikan data Anda, periksa apakah semua asumsi terpenuhi, dan pertimbangkan konteks masalah Anda saat menggunakan dan menafsirkan koefisien korelasi Pearson.
Koefisien korelasi Pearson adalah ukuran statistik fundamental yang digunakan di berbagai disiplin. Jika Anda tertarik bagaimana korelasi masuk ke alur kerja dunia nyata, jelajahi tutorial analisis data eksploratori di Python kami. Jika Anda ingin mengeksplorasi korelasi dalam praktik, lihat tutorial pandas kami untuk melihat bagaimana korelasi digunakan dalam dataset nyata.
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt




