Cours
Concepts de communication des données
3 h
85.9K
S'entraîner et cursus vos progrès.
Continuer Avec GoogleImaginez que vous examiniez des données d’entreprise et que vous remarquiez qu’à mesure que vos dépenses publicitaires augmentent, votre chiffre d’affaires semble progresser aussi. Avant de prendre une décision, vous voudrez quantifier la solidité de cette relation.
Le coefficient de corrélation de Pearson est la méthode de référence pour quantifier ce type de relation. Il est utilisé dans une grande variété de disciplines, notamment la data science, l’économie, la psychologie et la biologie. Les analystes calculent même des corrélations lors de l’analyse exploratoire des données afin de détecter des schémas avant de passer à d’autres techniques.
Avant de plonger dans les formules ou les calculs, il est utile de comprendre intuitivement ce que décrit la corrélation. Très simplement, la corrélation mesure la façon dont deux variables évoluent ensemble, comme évoqué plus haut. Elle répond à la question : « Quand une variable augmente, que fait l’autre ? »
La corrélation s’intéresse aux schémas de co‑variation plutôt qu’aux valeurs individuelles. Lorsque deux variables ont tendance à augmenter ou diminuer simultanément, la relation est positive. Lorsqu’elles évoluent en sens opposé (l’une augmente pendant que l’autre diminue), la relation est négative. Et lorsque les valeurs des deux variables ne semblent suivre aucun schéma cohérent, il se peut qu’il n’y ait pas de relation.
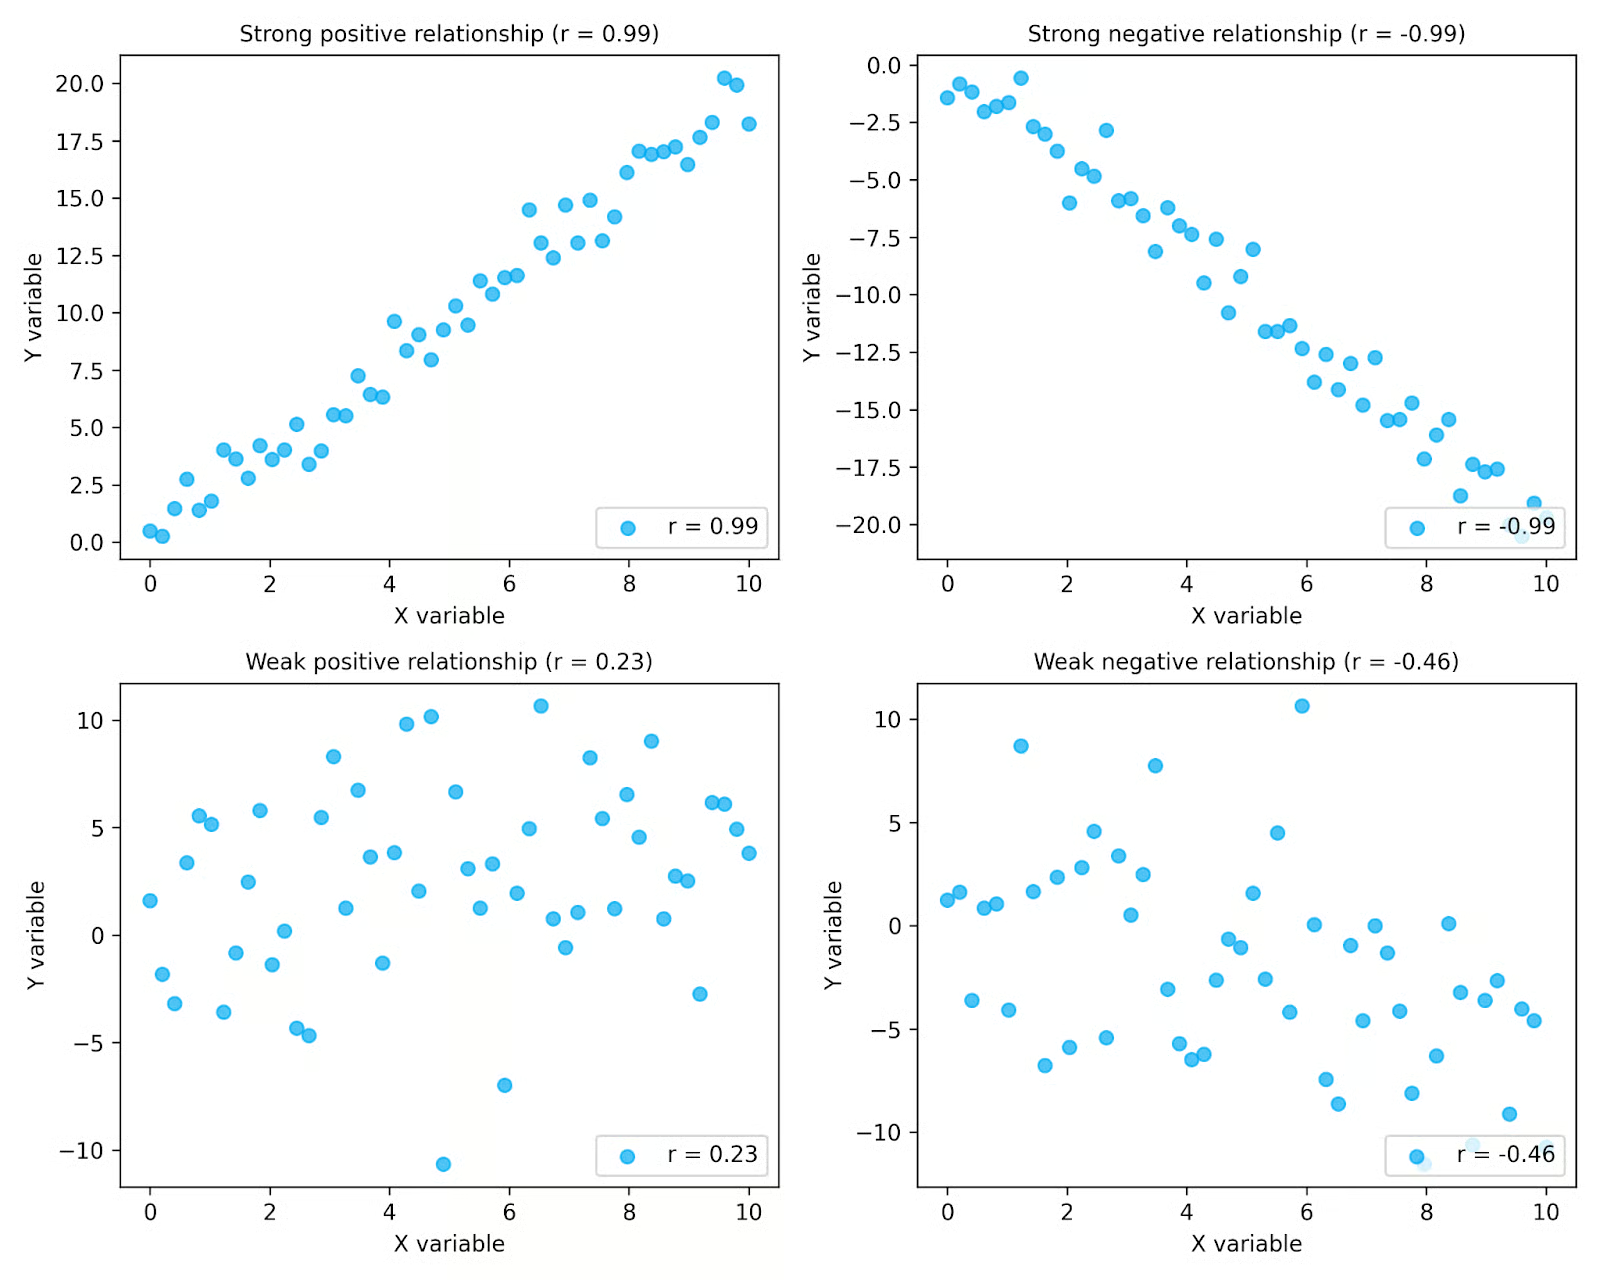
Sur les graphiques ci‑dessus, vous pouvez voir que la corrélation saisit à la fois le sens et l’intensité. La rangée du haut montre des relations fortes, où les points suivent un schéma clair, tandis que la rangée du bas montre des relations plus faibles avec davantage de dispersion. Les graphiques de gauche montrent des relations positives, où les valeurs augmentent ensemble, et ceux de droite des relations négatives, où une variable diminue quand l’autre augmente. Les valeurs r affichées sur chaque graphique résument ces schémas.
La corrélation est particulièrement utile lors de l’analyse exploratoire des données, quand on examine les relations entre variables. Représenter vos données facilite l’identification de schémas et permet de déterminer si une mesure de corrélation comme celle de Pearson est adaptée.
Il est également essentiel de se souvenir que la corrélation décrit des relations observées dans les données, pas les mécanismes qui les produisent. Même lorsque deux variables sont fortement corrélées, cela ne signifie pas que l’une a causé la variation de l’autre. La corrélation se contente de résumer les schémas existants. Rappelez-vous l’adage bien connu : « corrélation n’implique pas causalité ».
Le coefficient de corrélation de Pearson fournit un moyen formel de mesurer l’intensité et le sens d’une relation linéaire entre deux variables continues. Il résume dans quelle mesure les points d’un nuage de points suivent un schéma en ligne droite.
La valeur du coefficient de corrélation de Pearson est toujours comprise entre −1 et +1.
|
Valeur de r |
Interprétation |
|
+1 |
Relation linéaire positive parfaite |
|
0 |
Aucune relation linéaire |
|
−1 |
Relation linéaire négative parfaite |
Ces valeurs quantifient les schémas évoqués dans la section précédente. Plus elles sont proches de +1 ou de −1, plus la relation linéaire est forte ; plus elles sont proches de 0, plus elle est faible. Le signe indique si la relation est positive ou négative.
Point clé : la corrélation de Pearson mesure uniquement les relations linéaires. Si deux variables suivent un schéma non linéaire, le coefficient peut être proche de zéro alors même que les variables sont clairement liées. Autrement dit, r = 0 ne signifie pas nécessairement qu’il n’existe aucune relation ; cela veut dire qu’il n’y a pas de relation linéaire entre les variables.
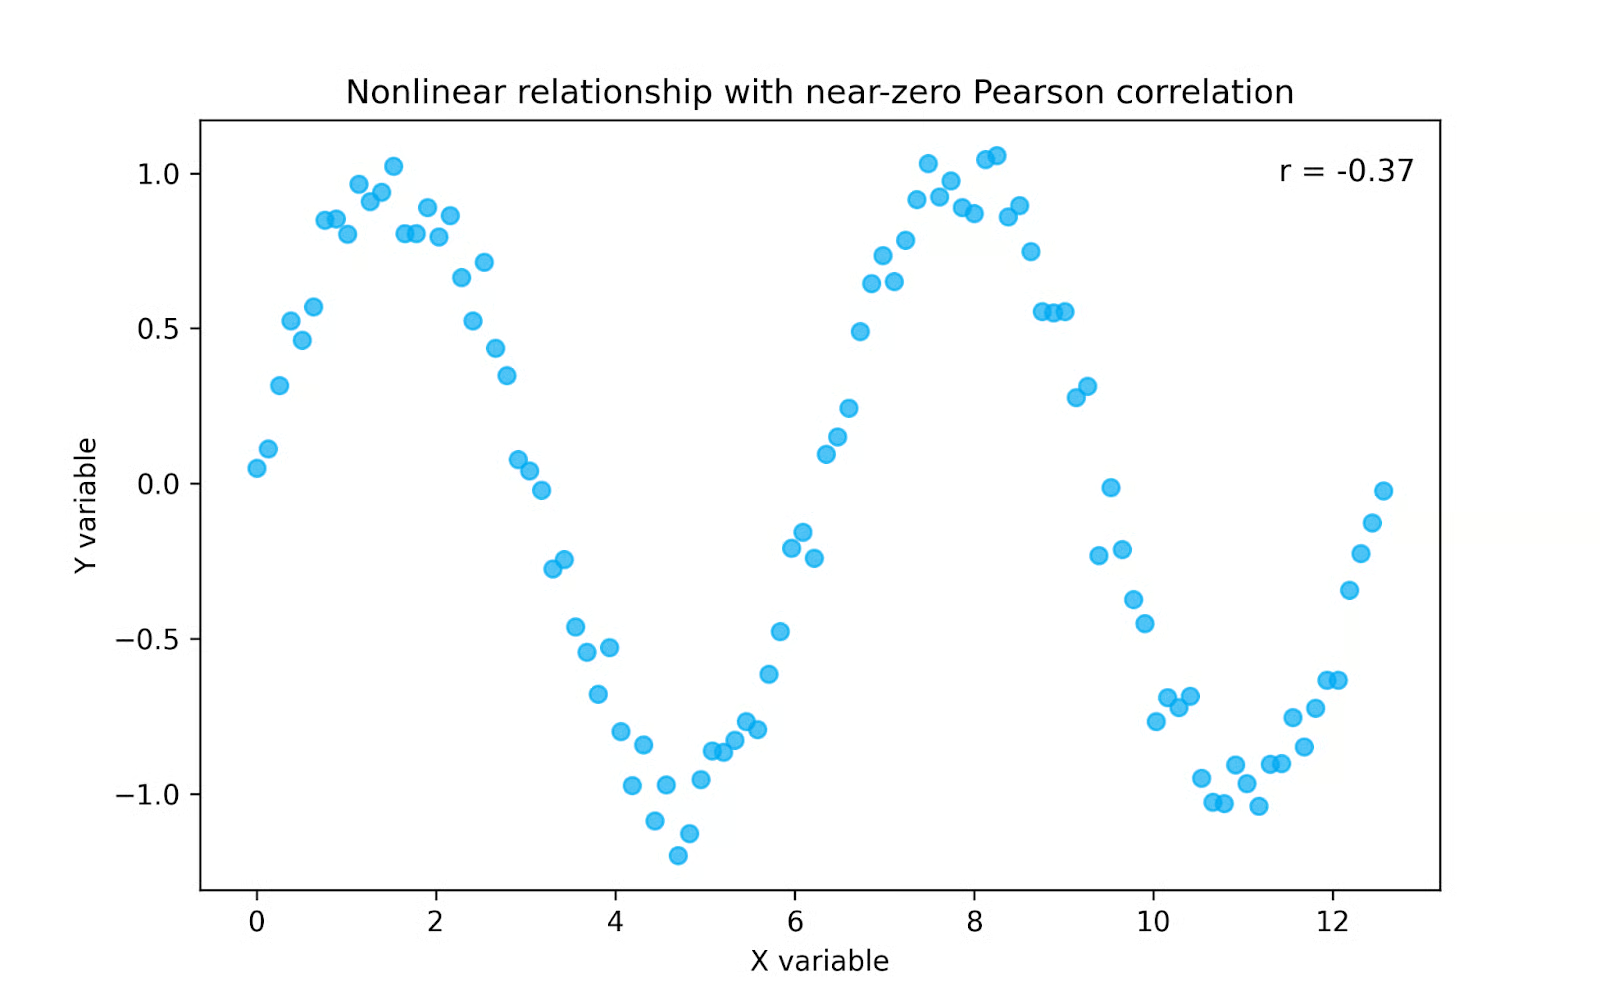
Sur le graphique ci‑dessus, les variables suivent clairement un schéma, mais pas une ligne droite. Parce que la corrélation de Pearson ne mesure que les relations linéaires, la valeur de r est proche de zéro, même si les variables sont fortement liées. Dans ce type de cas, une mesure basée sur les rangs comme la corrélation de Spearman peut être plus appropriée, car elle capture des schémas monotones non linéaires.
Le coefficient de corrélation de Pearson se calcule à l’aide d’une formule qui compare la co‑variation de deux variables à la variation propre de chacune. On l’écrit le plus souvent :
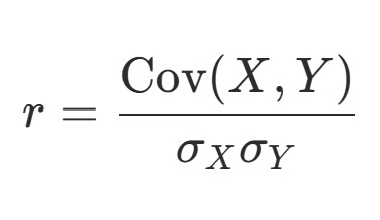
Dans cette expression, Cov(X, Y) représente la covariance entre les deux variables, tandis que σX et σY représentent les écarts types de chaque variable. La covariance mesure si deux variables ont tendance à augmenter ou diminuer ensemble, mais son amplitude dépend des unités de mesure. La division par les écarts types standardise le résultat et garantit que le coefficient de corrélation de Pearson est toujours compris entre −1 et +1. Pour une discussion plus large sur corrélation et covariance, consultez notre tutoriel sur le sujet.
La corrélation de Pearson est en substance une covariance standardisée. Alors que la covariance indique si les variables évoluent dans le même sens ou en sens opposé, la corrélation met cette information à l’échelle pour que l’intensité de la relation soit interprétable de manière cohérente entre différents jeux de données.
Si vous avez déjà dû faire ce calcul à la main (merci les cours de statistiques !), vous reconnaîtrez sans doute cette version de la formule, qui explicite davantage les étapes :
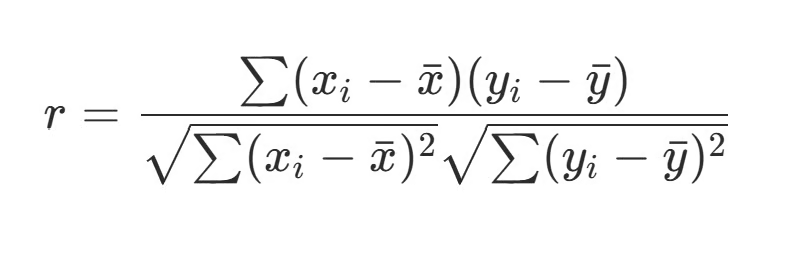
Ici, chaque observation est comparée à la moyenne de sa variable. Les termes (Xi − X̄) et (Yi − Ȳ) calculent l’écart de chaque valeur à la moyenne. Multiplier ces écarts mesure si les variables évoluent dans le même sens à chaque observation. Quand les deux écarts sont positifs ou négatifs, leur produit est positif et contribue à une corrélation positive. Quand l’un est positif et l’autre négatif, le produit est négatif et contribue à une corrélation négative.
La logique sous‑jacente est simple :
Cette structure permet au coefficient de corrélation de Pearson de fournir une mesure standardisée de l’intensité de la relation linéaire entre deux variables, quelles que soient leurs unités ou échelles d’origine.
Parcourons ensemble un court exemple. Supposons que nous voulions examiner la relation entre le nombre d’heures d’étude et les notes à un examen pour un groupe d’étudiants. Ci‑dessous, un petit jeu de données pour cinq étudiants.
|
Étudiant |
Heures d’étude (X) |
Note à l’examen (Y) |
|
Luther |
5 |
72 |
|
Alexandra |
2 |
70 |
|
Javier |
3 |
63 |
|
Jamie |
1 |
58 |
|
Auburn |
4 |
73 |
La première étape consiste toujours à tracer vos données. Faisons‑le ci‑dessous.
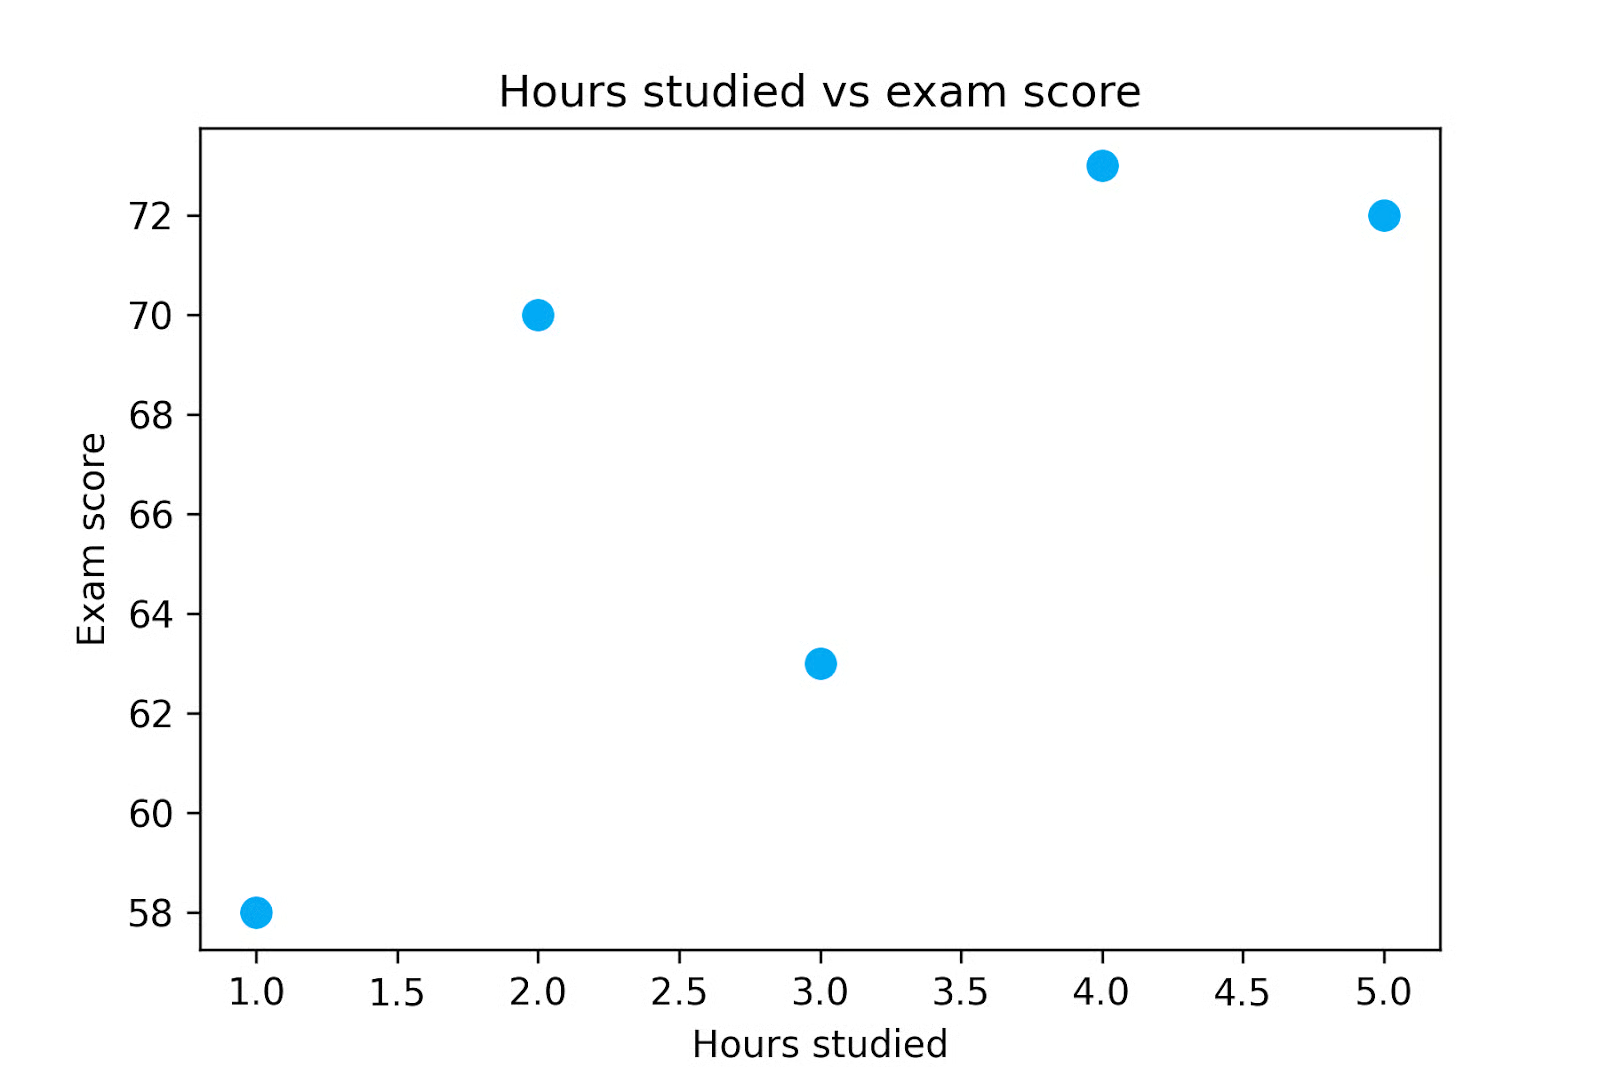
En traçant les données, on voit que les notes ont tendance à augmenter avec le temps d’étude, mais nous souhaitons quantifier cette relation. Calculons donc le coefficient de corrélation de Pearson pour ce jeu de données.
D’abord, calculons la moyenne de chaque variable. Ici, le nombre moyen d’heures d’étude est 3, et la note moyenne à l’examen est 67,2.
Ensuite, calculons l’écart de chaque observation par rapport à sa moyenne. Ces valeurs sont appelées écarts à la moyenne.
Puis, multiplions ces écarts pour montrer comment les variables évoluent ensemble à chaque observation. Lorsque les deux écarts ont le même signe, leur produit est positif, ce qui contribue à une corrélation positive. Quand les décarts ont des signes opposés, le produit est négatif et contribue à une corrélation négative.
|
X |
Y |
X − X̄ |
Y − Ȳ |
(X − X̄)(Y − Ȳ) |
|
1 |
58 |
-2 |
-9.2 |
18.4 |
|
2 |
70 |
-1 |
2.8 |
-2.8 |
|
3 |
63 |
0 |
-4.2 |
0 |
|
4 |
73 |
1 |
5.8 |
5.8 |
|
5 |
72 |
2 |
4.8 |
9.6 |
En faisant la somme des produits dans la dernière colonne, on obtient 31, qui est le numérateur du calcul de la corrélation de Pearson.
Calculons ensuite la variabilité de chaque variable via leur écart type. Pour ce faire, on élève au carré les écarts des colonnes 3 et 4 avant de les additionner.
Pour X :
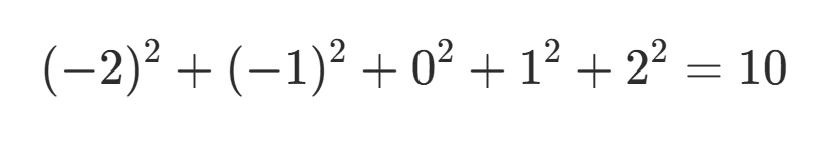
Pour Y :
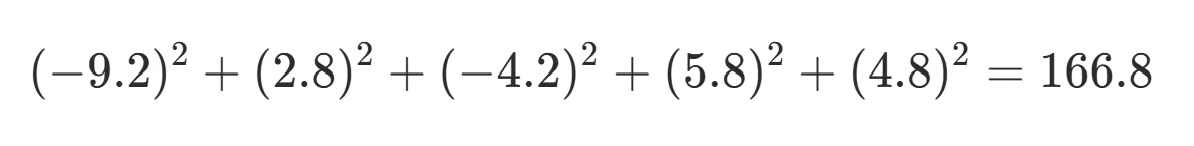
Puis on prend la racine carrée de chaque somme :
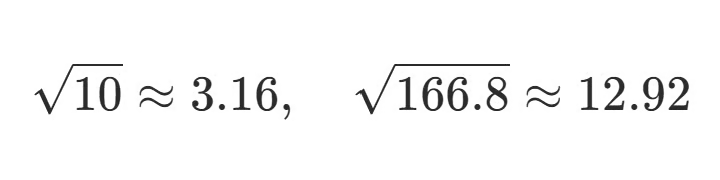
Enfin, on divise le numérateur par le produit des écarts types :
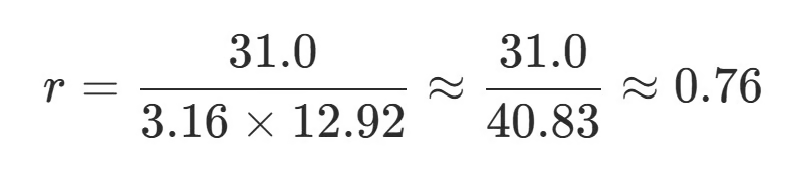
Cette dernière étape nous donne le coefficient de corrélation de Pearson, qui est ici d’environ 0,76, indiquant une forte relation linéaire positive. On peut en conclure que le nombre d’heures d’étude d’un étudiant est fortement et positivement corrélé à sa note.
Cependant, nous ne pouvons pas conclure que les heures d’étude ont causé la note obtenue. Pour le démontrer, il faudrait des analyses supplémentaires ou une étude expérimentale.
Comme vous l’avez vu avec l’exemple, calculer à la main le coefficient de corrélation de Pearson n’est guère pratique.
Heureusement, la plupart des logiciels statistiques proposent des fonctions intégrées pour le calculer. Comprendre la mécanique du calcul aide à développer l’intuition, mais dans les flux de travail réels, le coefficient est généralement calculé automatiquement. Voyons brièvement comment calculer le coefficient de Pearson avec trois outils courants : Excel, Python et R.
Dans Excel, le coefficient de corrélation de Pearson se calcule facilement avec la fonction CORREL(). Cette fonction prend deux plages de valeurs correspondant aux variables d’intérêt et renvoie leur coefficient de corrélation.
=CORREL(A1:A10, B1:B10)La fonction calcule directement r de Pearson à partir des plages sélectionnées, ce qui en fait un moyen rapide d’explorer les relations entre variables dans un tableur.
En Python, on calcule couramment le coefficient de Pearson avec les bibliothèques pandas ou SciPy. La méthode corr() de pandas calcule les corrélations entre colonnes d’un DataFrame :
import pandas as pd

pearson_df['hours_studied'].corr(pearson_df['exam_score'])
Autre option : la fonction pearsonr() du module statistics de SciPy, qui renvoie à la fois le coefficient de corrélation et une p‑valeur pour le test d’hypothèse :
from scipy.stats import pearsonr

pearsonr(pearson_df['hours_studied'], pearson_df['exam_score'])
Si vous débutez l’analyse de données en Python, découvrez comment travailler avec des jeux de données tabulaires dans notre tutoriel pandas.
En R, le coefficient de corrélation de Pearson se calcule avec la fonction cor() :
cor(x, y)Par défaut, cette fonction calcule le coefficient de Pearson, mais vous pouvez préciser d’autres méthodes si vous le souhaitez.
Ces trois outils permettent de calculer rapidement la corrélation de Pearson. C’est d’ailleurs si simple qu’il est courant de générer une matrice de corrélation, qui affiche les corrélations par paires entre plusieurs variables à la fois. Cela aide à repérer des schémas et des relations à approfondir lors des étapes ultérieures de l’analyse.
Calculer le coefficient de Pearson est une chose, mais comment l’interpréter ? Rappelez‑vous que le coefficient r décrit à la fois le sens et l’intensité d’une relation linéaire entre deux variables.
Le signe de r indique le sens de la relation. Une valeur positive signifie que les variables ont tendance à augmenter ensemble, tandis qu’une valeur négative indique que l’une diminue quand l’autre augmente.
L’amplitude de r décrit l’intensité de l’association linéaire : plus on est proche de 1, plus la relation est forte, par rapport à des valeurs proches de 0. Les seuils varient selon les domaines. Dans des contextes expérimentaux très contrôlés, comme certaines branches de la physique ou de l’ingénierie, des corrélations fortes peuvent frôler 1. Dans des domaines impliquant des systèmes biologiques ou sociaux complexes (médecine, santé publique, économie, psychologie), des corrélations de 0,1 à 0,4 peuvent rester parlantes, surtout quand les variables sont difficiles à mesurer ou que les effets s’additionnent à grande échelle. L’interprétation de r exige donc une connaissance métier et du contexte.
Notez aussi que la corrélation de Pearson est sensible aux valeurs extrêmes. Un seul point aberrant peut augmenter ou diminuer fortement la valeur de r. C’est l’une des raisons pour lesquelles il est si important de visualiser vos données. Examiner des nuages de points en parallèle des coefficients de corrélation aide à repérer d’éventuels outliers trop influents.
Les logiciels statistiques fournissent souvent une p‑valeur en plus du coefficient de corrélation de Pearson. Cette p‑valeur teste la probabilité d’observer une corrélation au moins aussi forte que celle de vos données s’il n’existait réellement aucune relation entre les variables. Si cet évènement est peu probable par le seul hasard, on considère que la relation est statistiquement significative.
Cette p‑valeur est calculée en convertissant le coefficient de Pearson en statistique t et en la comparant à la loi de Student. C’est similaire à un test t de Student, mais l’objectif ici est de tester si la corrélation vraie est nulle.
Avec de grands échantillons, même une valeur de r relativement faible peut être statistiquement significative, tout en restant une relation faible au niveau individuel. C’est important par exemple en santé publique, où une relation faible peut avoir des effets substantiels à l’échelle de la population. D’où l’intérêt de distinguer l’amplitude de la corrélation (r) et sa significativité statistique (p‑valeur).
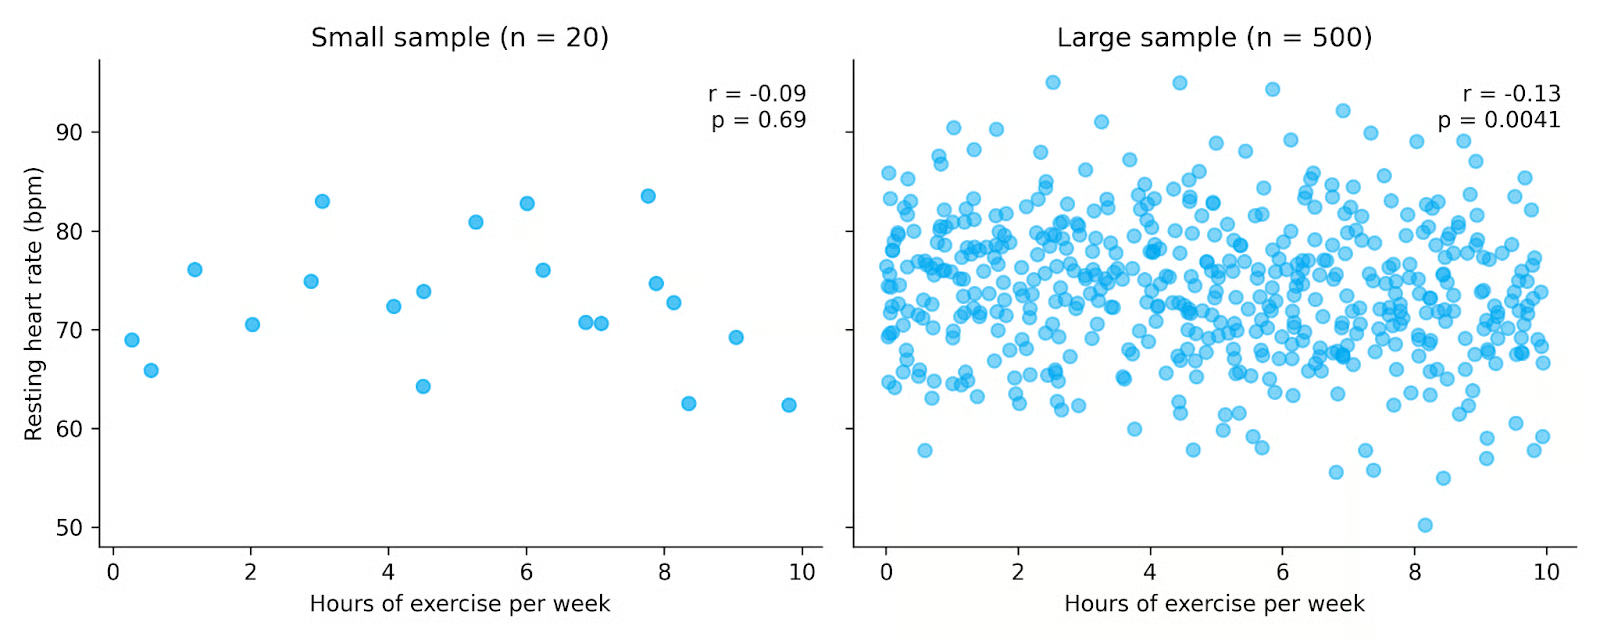
Sur les graphiques ci‑dessus, les deux jeux de données montrent une faible relation négative entre l’exercice et la fréquence cardiaque au repos. Cependant, celui de droite comprend beaucoup plus d’observations, rendant la relation statistiquement significative même si la corrélation demeure faible. Cela illustre comment des échantillons plus grands renforcent notre capacité à détecter des relations, et pourquoi il est important de considérer à la fois la valeur de r et la p‑valeur lors de l’interprétation.
Le coefficient de corrélation de Pearson est largement utilisé car il est simple à calculer et à interpréter. Toutefois, comme beaucoup d’outils statistiques, il fonctionne au mieux lorsque certaines hypothèses sur les données sont raisonnablement satisfaites.
Premièrement, la corrélation de Pearson suppose une relation linéaire entre deux variables. Si la relation réelle suit une courbe ou un schéma non linéaire, le coefficient peut sous‑estimer l’intensité de l’association, voire suggérer qu’il n’y a pas de relation.
Autre hypothèse : les variables analysées doivent être continues. La corrélation de Pearson est conçue pour des variables mesurées sur des échelles numériques continues, comme la taille, le revenu, la température ou des notes d’examen. Si vous avez des données ordinales ou discrètes, il vaut mieux recourir à la corrélation de Spearman ou au tau de Kendall.
On souhaite également, en général, que les données soient distribuées normalement. C’est particulièrement important si vous réalisez des tests d’hypothèse ou calculez des intervalles de confiance pour le coefficient de corrélation. Si les distributions sont fortement non normales, la corrélation estimée peut encore décrire la relation dans l’échantillon, mais la p‑valeur obtenue sera probablement moins fiable.
La corrélation de Pearson suppose également l’homoscedasticité, c’est‑à‑dire que la variabilité d’une variable reste relativement constante sur l’ensemble de l’autre variable. Concrètement, l’étalement des points d’un nuage doit rester globalement similaire quand les valeurs augmentent ou diminuent. Lorsque l’étalement varie fortement selon la plage de données, le coefficient peut ne pas bien refléter la structure de la relation. Comme pour la normalité, vous pouvez calculer r en violant cette hypothèse, mais les inférences statistiques ultérieures seront moins fiables.
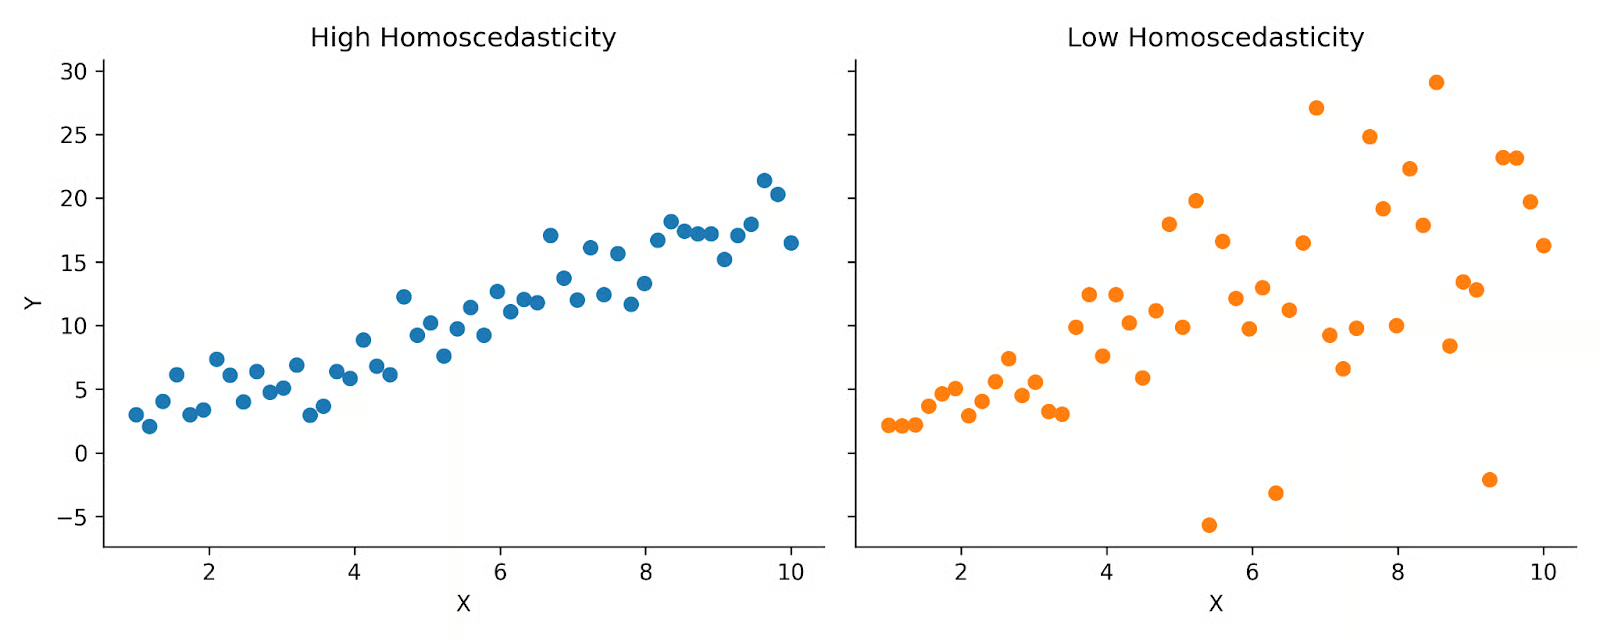
Ci‑dessus, deux graphiques illustrent une homoscedasticité élevée (à gauche) et faible (à droite). À gauche, les données sont assez uniformément réparties. À droite, on observe une forme en cône. La corrélation de Pearson suppose des données ressemblant plutôt au graphique de gauche.
Enfin, comme déjà évoqué, la corrélation de Pearson est sensible aux valeurs aberrantes. Des valeurs extrêmes peuvent influencer de façon disproportionnée le calcul, car le coefficient repose sur des moyennes et des écarts types. Un seul point inhabituel peut modifier sensiblement la corrélation.
La corrélation de Pearson et celle de Spearman paraissent proches et l’on peut facilement les confondre. Toutes deux mesurent la relation entre deux variables, mais elles diffèrent par le type de relation capté et les hypothèses sous‑jacentes.
Le coefficient de Pearson mesure l’intensité d’une relation linéaire entre deux variables continues. À l’inverse, le coefficient de Spearman mesure l’intensité d’une relation monotone, c’est‑à‑dire que les variables évoluent dans le même sens mais pas forcément à un rythme constant. Une relation monotone peut être linéaire ou non, du moment qu’elle est croissante ou décroissante de façon régulière.
La corrélation de Spearman se calcule à partir des rangs des données plutôt que des valeurs brutes. En convertissant les données en rangs, elle réduit l’impact des valeurs aberrantes et ne requiert pas l’hypothèse de linéarité.
La corrélation de Pearson est dite paramétrique car elle repose sur des hypothèses de distribution des données. Celle de Spearman est non paramétrique : elle ne nécessite pas les mêmes hypothèses et dépend moins de la normalité.
Lorsque les hypothèses de Pearson sont respectées, elle fournit une estimation plus précise de l’association linéaire réelle que Spearman. En revanche, lorsque nos données ne satisfont pas ces conditions, la corrélation de Spearman peut malgré tout détecter une relation entre deux variables.
|
Coefficient de corrélation |
Quand l’utiliser |
|
Corrélation de Pearson |
Relation linéaire ; variables continues ; données « propres » |
|
Corrélation de Spearman |
Relation monotone ; présence de valeurs aberrantes ; données ordinales ou classées |
La covariance est une notion proche, mais elle diffère par l’échelle et l’interprétation.
La covariance mesure si deux variables ont tendance à évoluer dans le même sens ou en sens inverse. Si elles augmentent ensemble, la covariance est positive. Si l’une augmente pendant que l’autre diminue, elle est négative.
Cependant, l’amplitude de la covariance dépend des unités des variables. Par exemple, la covariance entre une taille en centimètres et un poids en kilogrammes différera numériquement de celle entre une taille en pouces et un poids en livres. Cela rend la covariance difficile à comparer entre jeux de données.
Le coefficient de corrélation de Pearson contourne cette limite en divisant la covariance par le produit des écarts types des deux variables. Grâce à cette normalisation, la corrélation de Pearson est sans unité et toujours comprise entre −1 et +1. Cette borne facilite grandement l’interprétation.
En termes simples :
Bien que le coefficient de corrélation de Pearson soit largement utilisé et simple à interpréter, il présente plusieurs limites importantes.
La corrélation de Pearson s’emploie idéalement dans un cadre exploratoire et analytique plus large. Visualisez vos données, vérifiez les hypothèses et tenez compte du contexte de votre problème lors de l’utilisation et de l’interprétation du coefficient de Pearson.
Le coefficient de corrélation de Pearson est une mesure statistique fondamentale, utilisée dans de nombreuses disciplines. Si vous souhaitez voir comment la corrélation s’inscrit dans des workflows concrets, explorez notre tutoriel sur l’analyse exploratoire des données en Python. Pour pratiquer la corrélation, consultez notre tutoriel pandas pour voir comment les corrélations sont utilisées sur des données réelles.
Apprenez avec DataCamp
Cours
Cours
S'entraîner et cursus vos progrès.
Continuer Avec GoogleTutoriel
Josef Waples
8 min
Tutoriel
Laiba Siddiqui
6 min
Tutoriel
Allan Ouko
11 min
Tutoriel
Laiba Siddiqui
14 min
Tutoriel
DataCamp Team
3 min
Tutoriel
Josef Waples
3 min