
{count, plural, one {Cursus} other {Cursussen}}
Concepten voor datacommunicatie
{hours} uur
85.6K
Stel, je bekijkt bedrijfsdata en merkt dat naarmate je advertentie-uitgaven toenemen, je omzet ook lijkt te stijgen. Voordat je beslissingen neemt, wil je de sterkte van die relatie kunnen kwantificeren.
De Pearson-correlatiecoëfficiënt is dé manier om zo’n relatie te kwantificeren. Hij wordt gebruikt in talloze disciplines, waaronder datawetenschap, economie, psychologie en biologie. Analisten berekenen zelfs correlaties tijdens verkennende data-analyse om patronen te vinden voordat ze doorgaan met andere technieken.
Voordat je naar formules of berekeningen kijkt, helpt het om intuïtief te begrijpen wat correlatie beschrijft. Heel basic meet correlatie hoe twee variabelen samen bewegen, zoals ik al noemde. Het beantwoordt de vraag: “Als de ene variabele toeneemt, wat doet de andere dan?”
Correlatie richt zich specifiek op patronen van samen-beweging in plaats van op individuele waarden. Wanneer twee variabelen de neiging hebben om tegelijk toe te nemen of af te nemen, hebben ze een positieve relatie. Wanneer twee variabelen in tegengestelde richting bewegen (de ene neemt toe terwijl de andere afneemt), hebben ze een negatieve relatie. En wanneer de waarden van beide variabelen geen consistent patroon lijken te hebben, is er mogelijk geen relatie.
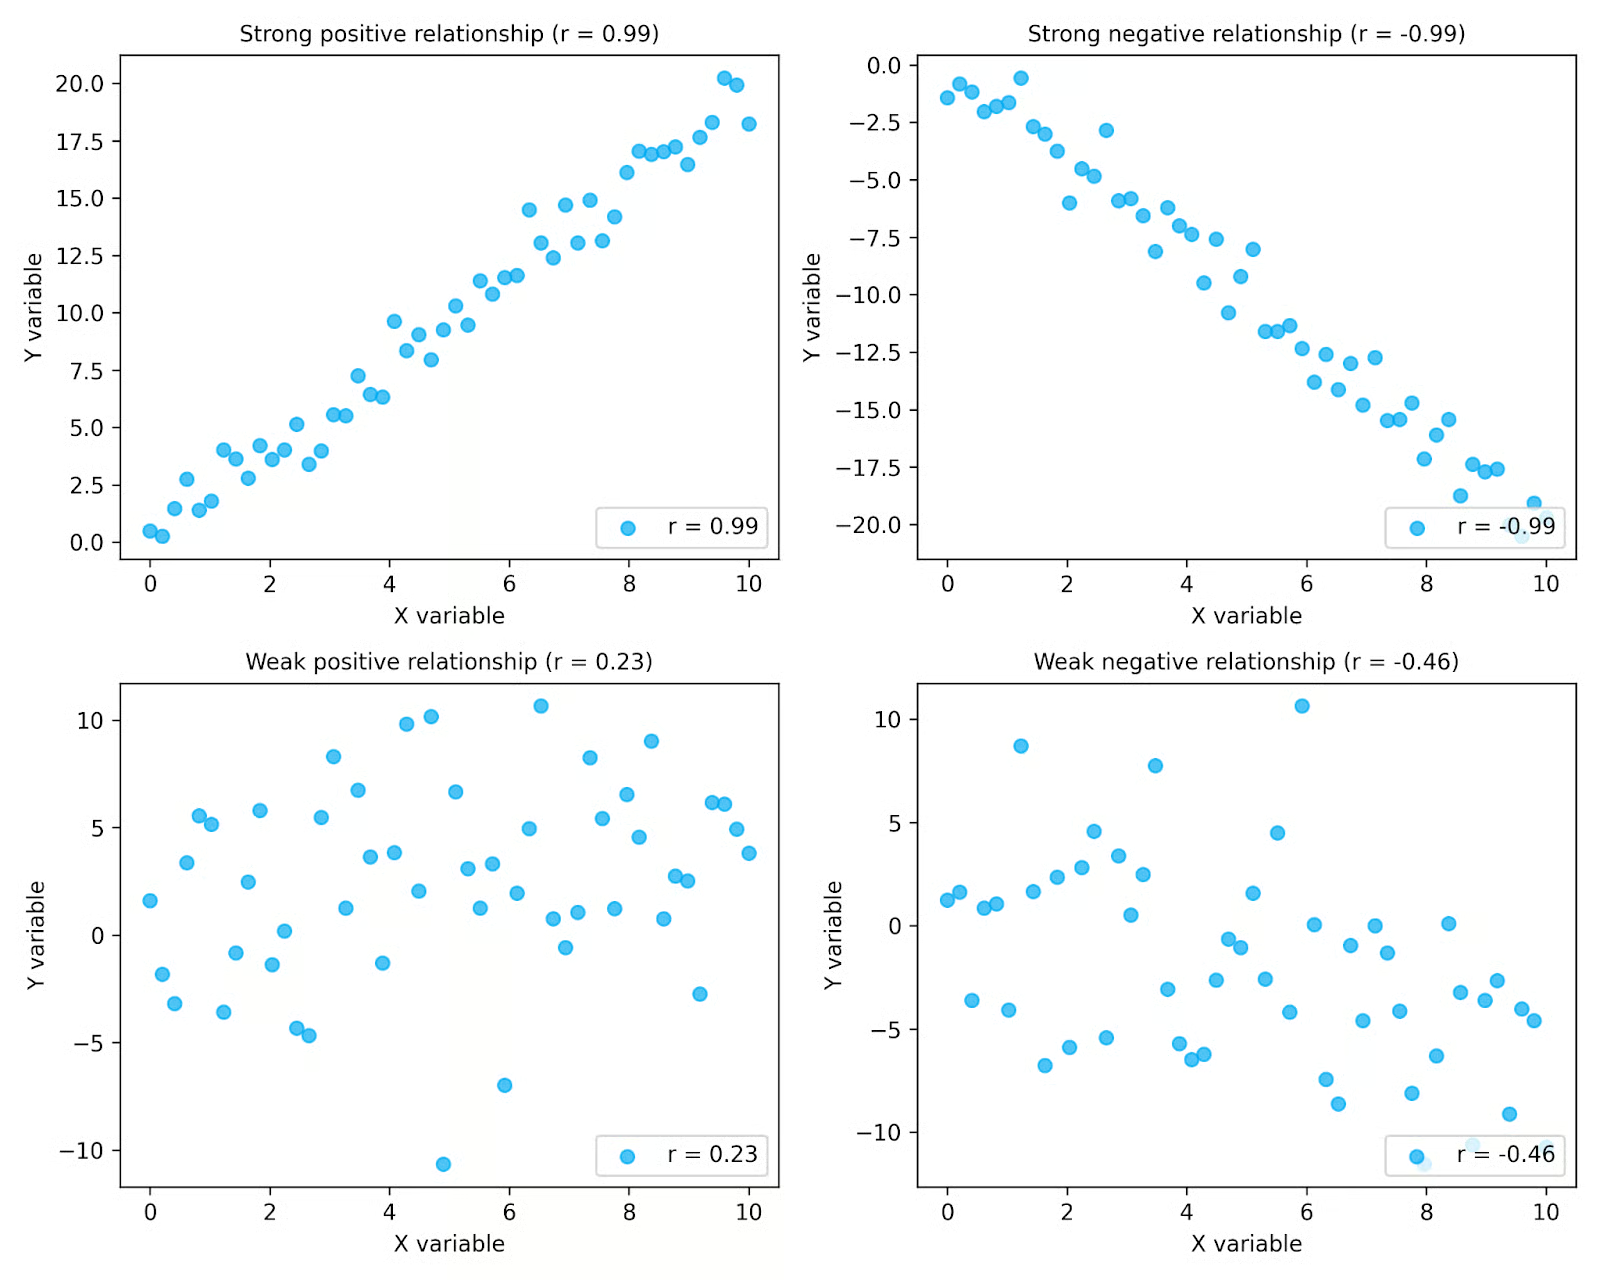
In de plots hierboven zie je hoe correlatie zowel richting als sterkte vastlegt. De bovenste rij toont sterke relaties, waar de punten een duidelijk patroon volgen, terwijl de onderste rij zwakkere relaties met meer spreiding laat zien. De plots links tonen positieve relaties, waarbij waarden samen toenemen, en de plots rechts tonen negatieve relaties, waarbij de ene variabele afneemt terwijl de andere toeneemt. De r-waarden in elke plot vatten deze patronen samen.
Correlatie is vooral nuttig tijdens verkennende data-analyse, waarbij analisten de relaties tussen variabelen onderzoeken. Je data plotten maakt het makkelijker om patronen te zien en te bepalen of een correlatiemaat zoals die van Pearson geschikt is voor je data.
Het is ook belangrijk te onthouden dat correlatie relaties beschrijft die in data worden waargenomen, niet de mechanismen die ze veroorzaken. Zelfs wanneer twee variabelen sterk correleren, betekent dat niet dat de ene variabele de andere verandering veroorzaakt. Correlatie vat simpelweg de bestaande patronen samen. Onthoud het oude adagium: “correlatie impliceert geen causaliteit”.
De Pearson-correlatiecoëfficiënt biedt een formele manier om de sterkte en richting van een lineaire relatie tussen twee continue variabelen te meten. Hij vat samen hoe dicht de punten in een spreidingsdiagram een rechte lijn volgen.
De waarde van de Pearson-correlatiecoëfficiënt ligt altijd tussen −1 en +1.
|
Waarde van r |
Interpretatie |
|
+1 |
Perfecte positieve lineaire relatie |
|
0 |
Geen lineaire relatie |
|
−1 |
Perfecte negatieve lineaire relatie |
Deze waarden kwantificeren de patronen die we in de vorige sectie bespraken. Waarden dichter bij +1 of −1 duiden op een sterkere lineaire relatie, terwijl waarden dichter bij 0 op een zwakkere relatie wijzen. Het teken geeft aan of de relatie positief of negatief is.
Een belangrijk punt is dat de correlatie van Pearson alleen lineaire relaties meet. Als twee variabelen een niet-lineair patroon volgen, kan de correlatiecoëfficiënt dicht bij nul liggen, zelfs wanneer de variabelen duidelijk gerelateerd zijn. Met andere woorden, r = 0 betekent niet per se dat er geen relatie bestaat; het betekent dat er geen lineaire relatie is tussen de variabelen.
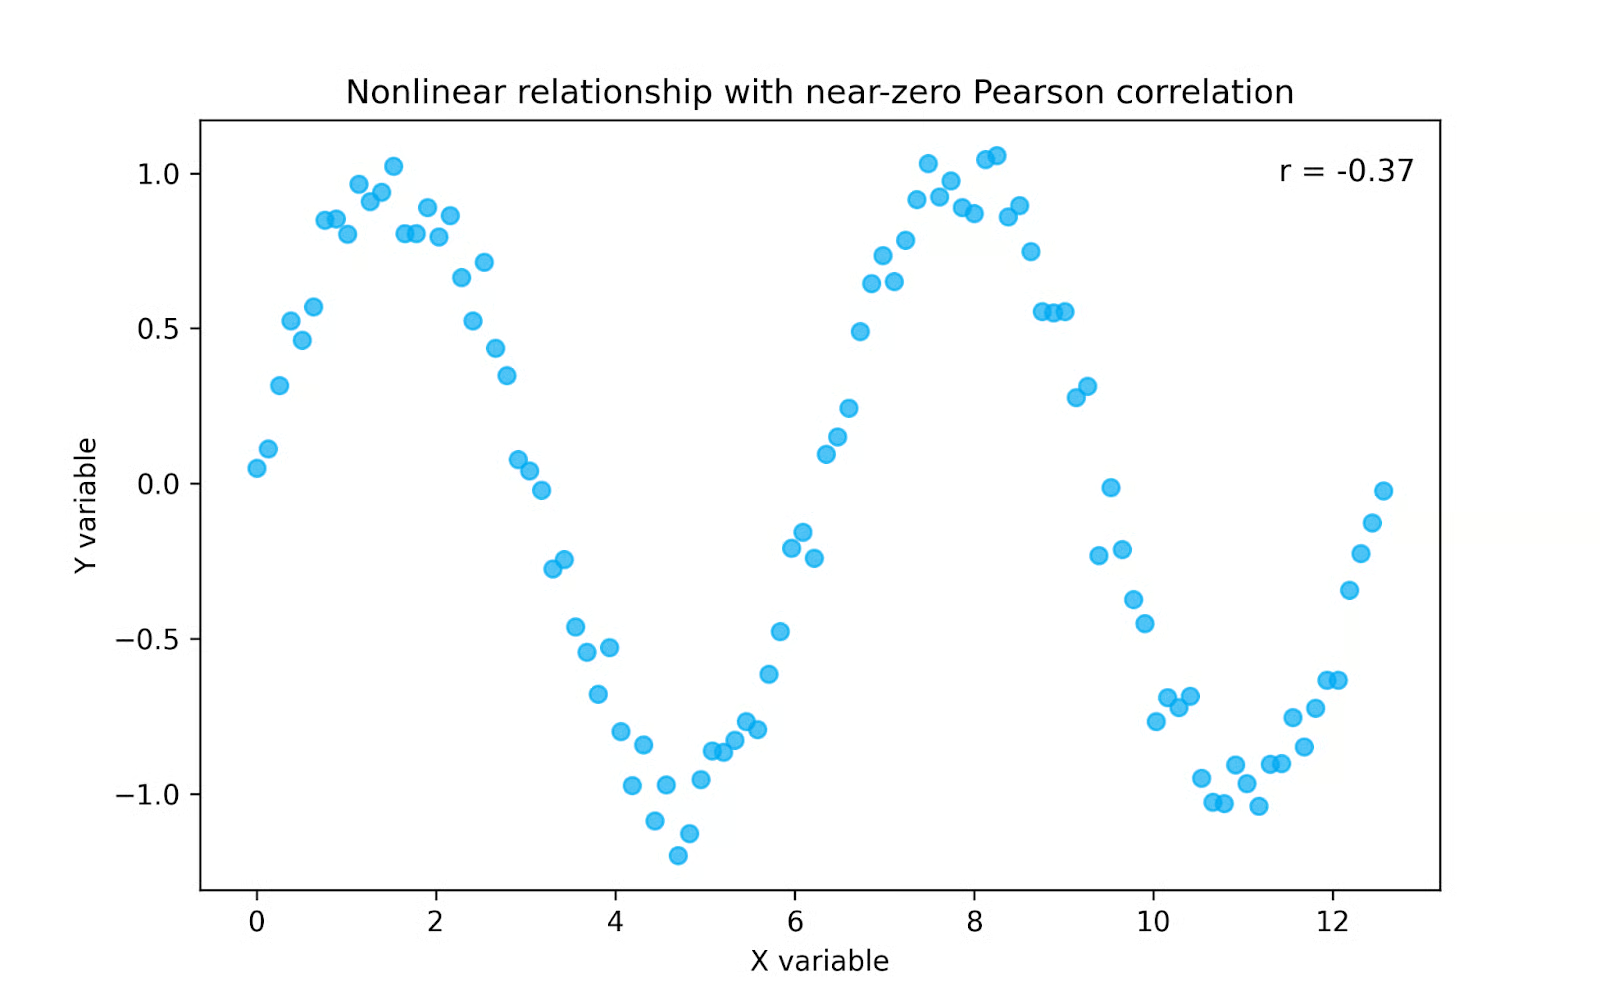
In de plot hierboven volgen de variabelen duidelijk een patroon, maar het is geen rechte lijn. Omdat de Pearson-correlatie alleen lineaire relaties meet, ligt de waarde van r dicht bij nul, ook al zijn de variabelen sterk gerelateerd. In dit soort gevallen kan een ranggebaseerde maat zoals Spearman-correlatie geschikter zijn, omdat die monotone patronen kan vastleggen die niet lineair zijn.
De correlatiecoëfficiënt van Pearson wordt berekend met een formule die vergelijkt hoe twee variabelen samen veranderen ten opzichte van hoeveel ze individueel veranderen. Hij wordt meestal zo geschreven:
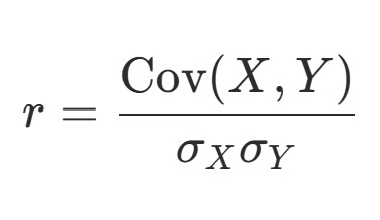
In deze uitdrukking staat Cov(X, Y) voor de covariantie tussen de twee variabelen, terwijl σX en σY de standaardafwijkingen van elke variabele voorstellen. Covariantie meet of twee variabelen de neiging hebben om samen toe te nemen of af te nemen, maar de omvang hangt af van de meeteenheden. Delen door de standaardafwijkingen standaardiseert het resultaat en zorgt ervoor dat de Pearson-correlatiecoëfficiënt altijd tussen −1 en +1 valt. Voor een bredere bespreking van correlatie en covariantie, bekijk onze tutorial over dit onderwerp.
De correlatie van Pearson is in wezen gestandaardiseerde covariantie. Terwijl covariantie ons vertelt of variabelen in dezelfde of in tegengestelde richting bewegen, schaalt correlatie deze informatie zodat de sterkte van de relatie consistent kan worden geïnterpreteerd over verschillende datasets.
Als je dit ooit met de hand hebt moeten uitrekenen (dank je, statistiekcollege!) herken je waarschijnlijk deze versie van de formule, die de stappen explicieter maakt:
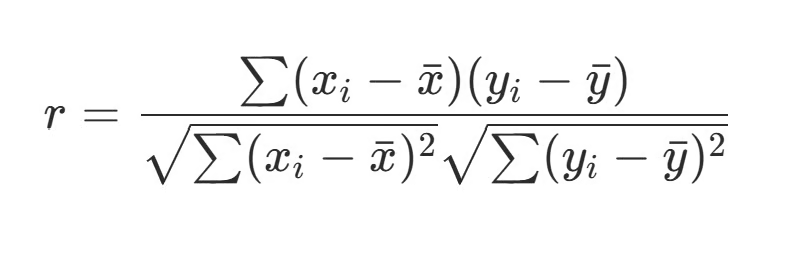
Hier wordt elke observatie vergeleken met het gemiddelde van zijn variabele. De termen (Xi − X̄) en (Yi − Ȳ) berekenen hoe ver elke waarde van het gemiddelde afligt. Door deze afwijkingen met elkaar te vermenigvuldigen, meten we of de variabelen bij elke observatie in dezelfde richting bewegen. Wanneer beide afwijkingen positief zijn of beide negatief, is hun product positief en draagt dat bij aan een positieve correlatie. Wanneer de ene afwijking positief is en de andere negatief, is hun product negatief en draagt dat bij aan een negatieve correlatie.
De onderliggende logica van de berekening is eenvoudig:
Deze structuur zorgt ervoor dat de Pearson-correlatiecoëfficiënt een gestandaardiseerde maat biedt voor hoe sterk twee variabelen lineair samenhangen, ongeacht hun oorspronkelijke eenheden of schalen.
Laten we samen een kort voorbeeld doorlopen. Stel dat we de relatie tussen studieuze uren en examenscores voor een groep studenten willen onderzoeken. Hieronder staat een kleine dataset voor vijf studenten.
|
Student |
Uren gestudeerd (X) |
Examenscore (Y) |
|
Luther |
5 |
72 |
|
Alexandra |
2 |
70 |
|
Javier |
3 |
63 |
|
Jamie |
1 |
58 |
|
Auburn |
4 |
73 |
De eerste stap is altijd: plot je data. Dus laten we dat hieronder doen.
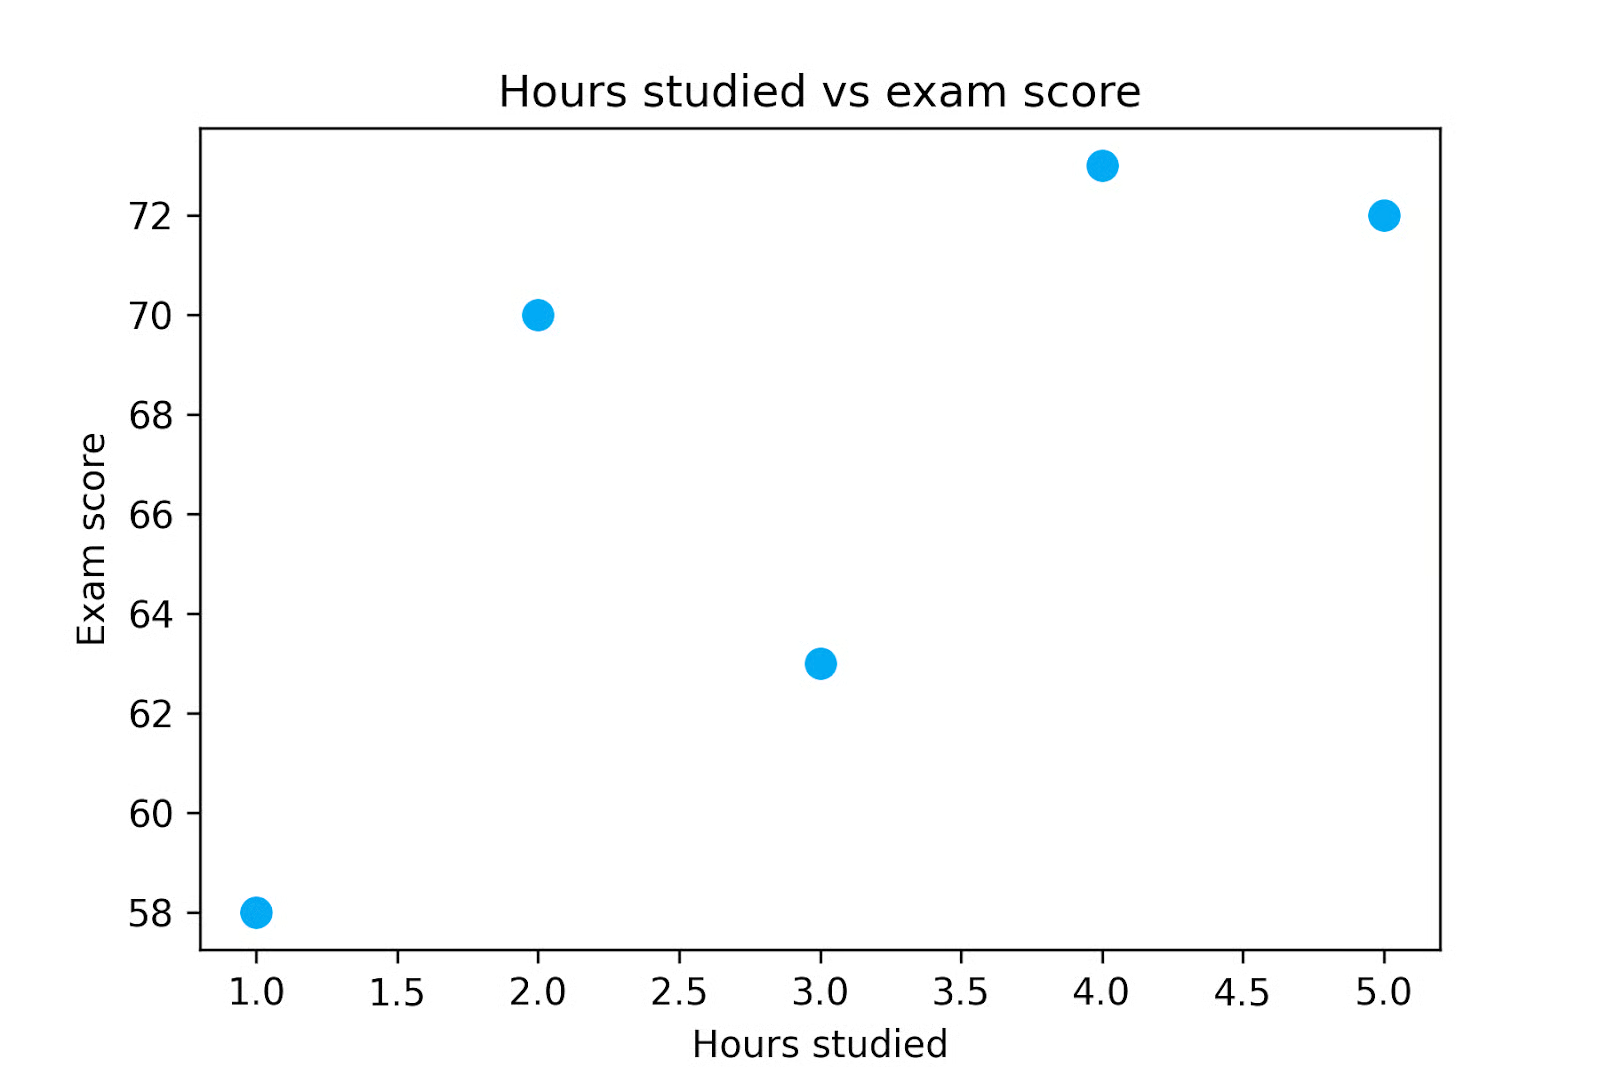
Wanneer we de data plotten, zien we dat examenscores de neiging hebben toe te nemen naarmate de studietijd toeneemt, maar we willen deze relatie kwantificeren. Laten we dus de Pearson-correlatiecoëfficiënt voor deze dataset berekenen.
Eerst moeten we het gemiddelde van elke variabele berekenen. In dit voorbeeld is het gemiddelde aantal studie-uren 3 en de gemiddelde examenscore 67,2.
Vervolgens berekenen we hoe ver elke observatie van zijn gemiddelde ligt. Deze waarden noemen we afwijkingen van het gemiddelde.
Daarna vermenigvuldigen we de afwijkingen om te laten zien hoe de variabelen bij elke observatie samen bewegen. Wanneer beide afwijkingen hetzelfde teken hebben, is hun product positief, wat bijdraagt aan een positieve correlatie. Wanneer de afwijkingen tegengestelde tekens hebben, is het product negatief en draagt dat bij aan een negatieve correlatie.
|
X |
Y |
X − X̄ |
Y − Ȳ |
(X − X̄)(Y − Ȳ) |
|
1 |
58 |
-2 |
-9,2 |
18,4 |
|
2 |
70 |
-1 |
2,8 |
-2,8 |
|
3 |
63 |
0 |
-4,2 |
0 |
|
4 |
73 |
1 |
5,8 |
5,8 |
|
5 |
72 |
2 |
4,8 |
9,6 |
Als we de producten in de laatste kolom optellen, krijgen we 31, wat de teller is van onze Pearson-correlatieberekening.
Vervolgens berekenen we de variabiliteit van elke variabele met hun standaardafwijkingen. Hiervoor kwadrateren we de afwijkingen in kolommen 3 en 4 voordat we ze optellen.
Voor X:
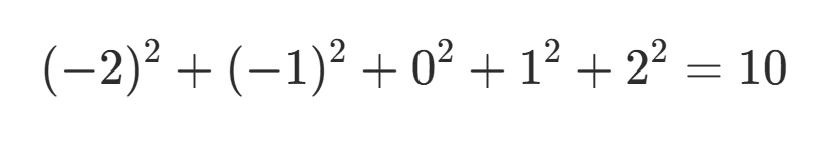
Voor Y:
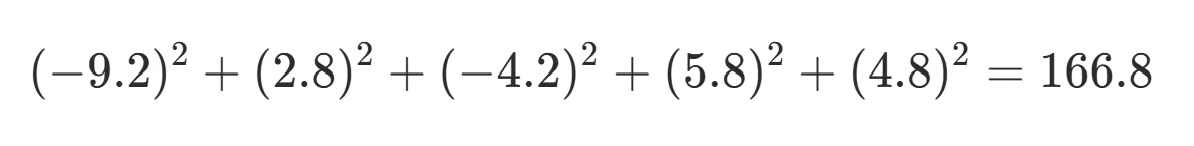
Daarna nemen we de vierkantswortel van elke som:
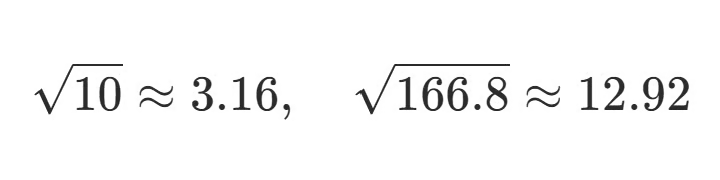
Tot slot delen we de teller door het product van de standaardafwijkingen:
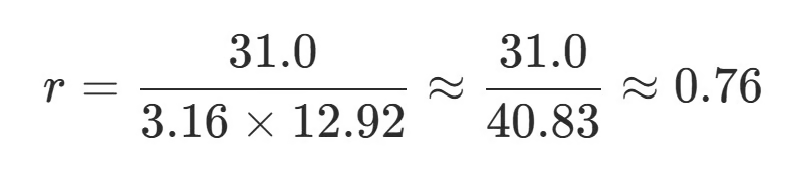
Deze laatste stap levert onze Pearson-correlatiecoëfficiënt op, die in dit geval ongeveer 0,76 is, wat wijst op een sterke positieve lineaire relatie. Hieruit kunnen we concluderen dat het aantal uren dat een student studeert sterk en positief correleert met zijn of haar testscores.
We kunnen echter niet concluderen dat de gestudeerde uren hun testscores hebben veroorzaakt. Om die conclusie te trekken, hebben we aanvullende analyses of een experimentele studie nodig.
Uit het simpele voorbeeld hierboven zie je dat het met de hand berekenen van de correlatiecoëfficiënt van Pearson niet bepaald praktisch is.
Gelukkig hebben de meeste statistische softwarepakketten ingebouwde functies om dit te doen. Het begrijpen van de mechaniek achter de berekening helpt voor je intuïtie, maar in echte workflows wordt de coëfficiënt meestal automatisch berekend. Laten we kort kijken hoe je de correlatiecoëfficiënt van Pearson berekent met drie veelgebruikte tools: Excel, Python en R.
In Excel is de Pearson-correlatiecoëfficiënt eenvoudig te berekenen met de CORREL()-functie. Deze functie neemt twee bereiken met waarden die de variabelen van interesse vertegenwoordigen en retourneert hun correlatiecoëfficiënt.
=CORREL(A1:A10, B1:B10)De functie berekent Pearson’s r rechtstreeks uit de geselecteerde bereiken, waardoor het een snelle manier is om relaties tussen variabelen in spreadsheets te verkennen.
In Python wordt de Pearson-correlatiecoëfficiënt vaak berekend met de libraries pandas of SciPy. De corr()-methode in pandas berekent correlaties tussen kolommen in een DataFrame:
import pandas as pd

pearson_df['hours_studied'].corr(pearson_df['exam_score'])
Als alternatief retourneert de functie pearsonr() uit het statistiekmodule van SciPy zowel de correlatiecoëfficiënt als een p-waarde voor hypothesetoetsing:
from scipy.stats import pearsonr

pearsonr(pearson_df['hours_studied'], pearson_df['exam_score'])
Als je nieuw bent met Python-gebaseerde data-analyse, kun je meer leren over het werken met tabeldata in onze pandas-tutorial.
In R kan de Pearson-correlatiecoëfficiënt worden berekend met de cor()-functie:
cor(x, y)Standaard berekent deze functie de Pearson-correlatiecoëfficiënt, al kun je desgewenst ook andere correlatiemethoden opgeven.
Elk van deze drie tools maakt het eenvoudig om snel de correlatiecoëfficiënt van Pearson te berekenen. Omdat het zo makkelijk is, maken analisten vaak een correlatiematrix, die paarsgewijze correlaties tussen meerdere variabelen tegelijk laat zien. Dit helpt patronen en relaties te identificeren die nader onderzoek waard zijn in latere analysetrajecten.
Het is één ding om de Pearson-correlatiecoëfficiënt te berekenen, maar hoe interpreteer je die? Onthoud dat coëfficiënt r zowel de richting als de sterkte van een lineaire relatie tussen twee variabelen beschrijft.
Het teken van r geeft de richting van de relatie aan. Een positieve waarde betekent dat de variabelen samen de neiging hebben toe te nemen, terwijl een negatieve waarde aangeeft dat de ene variabele de neiging heeft af te nemen wanneer de andere toeneemt.
De grootte van r beschrijft de sterkte van de lineaire samenhang, waarbij waarden dichter bij 1 sterker zijn dan waarden dichter bij 0. Verschillende vakgebieden hanteren verschillende tradities voor wat als een sterke relatie geldt. In sterk gecontroleerde experimentele omgevingen, zoals sommige gebieden van de natuurkunde of werktuigbouwkunde, kunnen sterke correlaties richting 1 gaan. In velden met complexe biologische of sociale systemen, zoals geneeskunde, publieke gezondheid, economie of psychologie, kunnen correlaties in de orde van 0,1 tot 0,4 nog steeds betekenisvol zijn, vooral wanneer variabelen lastig te meten zijn of effecten zich op schaal opstapelen. Omdat standaarden per discipline variëren, vereist de interpretatie van r domeinkennis en contextuele afweging.
Het is ook belangrijk te beseffen dat Pearson-correlatie gevoelig is voor extreme waarden. Een enkele uitschieter kan de waarde van r aanzienlijk verhogen of verlagen. Dit is een van de redenen waarom het zo belangrijk is om je data te plotten. Het bekijken van spreidingsdiagrammen naast correlatiecoëfficiënten helpt om eventuele uitschieters te herkennen die onevenredige invloed uitoefenen.
Statistische software kan vaak een p-waarde geven naast je Pearson-correlatiecoëfficiënt. Deze p-waarde toetst hoe waarschijnlijk het is om een correlatie ten minste zo sterk als die in jouw data te observeren als er werkelijk geen relatie tussen de variabelen bestaat. Als het onwaarschijnlijk is dat dit puur door toeval optreedt, zeggen we dat de relatie statistisch significant is.
Deze p-waarde wordt berekend door de Pearson-correlatiecoëfficiënt om te zetten in een t-statistiek en die te vergelijken met de t-verdeling. Dit lijkt op een Student’s t-toets, maar hier is het doel te testen of de echte correlatie nul is.
Bij grote datasets kan zelfs een relatief kleine r-waarde nog steeds statistisch significant zijn, al kan het op individueel niveau een zwakke relatie blijven. Dit is belangrijk in de publieke gezondheid, waar een zwakke relatie toch aanzienlijke effecten op bevolkingsniveau kan hebben. Daarom is het vaak nuttig onderscheid te maken tussen de grootte van de correlatie (r) en de statistische significantie (p-waarde).
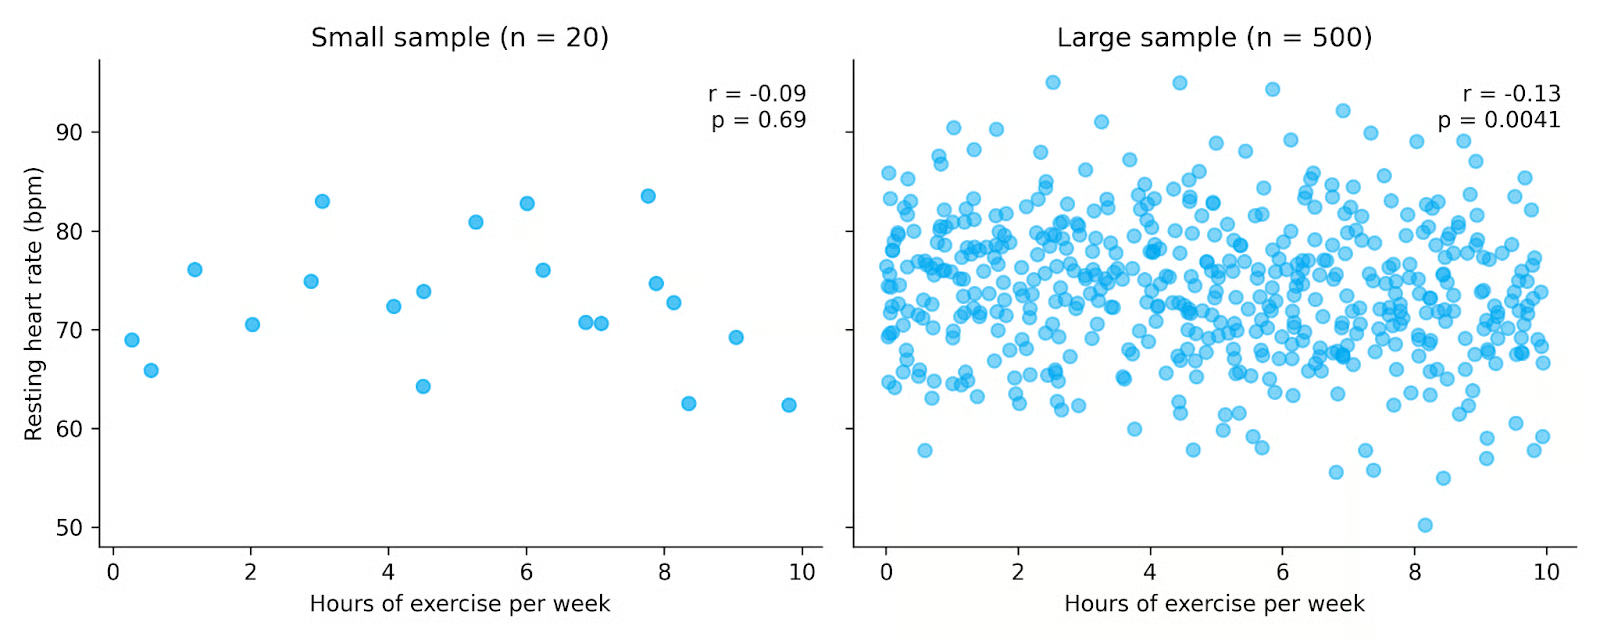
In de plots hierboven laten beide datasets een zwakke negatieve relatie zien tussen beweging en rusthartslag. De dataset rechts bevat echter veel meer observaties, waardoor de relatie statistisch significant wordt, ook al blijft de correlatie klein. Dit laat zien hoe grotere steekproeven ons vermogen om relaties te detecteren vergroten, en waarom het belangrijk is om zowel de waarde van r als de p-waarde in je interpretatie mee te nemen.
De Pearson-correlatiecoëfficiënt wordt veel gebruikt omdat hij eenvoudig te berekenen en te interpreteren is. Maar, zoals veel statistische tools, werkt hij het best wanneer bepaalde aannames over de data redelijkerwijs worden vervuld.
Ten eerste gaat de Pearson-correlatie uit van een lineaire relatie tussen twee variabelen. Als de werkelijke relatie een krom of niet-lineair patroon volgt, kan de coëfficiënt de sterkte van de samenhang onderschatten of zelfs suggereren dat er geen relatie bestaat.
Een andere aanname is dat de geanalyseerde variabelen continu zijn. Pearson-correlatie is ontworpen voor variabelen die zijn gemeten op continue numerieke schalen, zoals lengte, inkomen, temperatuur of examenscores. Als je ordinale of discrete data hebt, kun je beter gebruikmaken van Spearman-correlatie of Kendall’s tau.
Daarnaast wil je over het algemeen dat je data normaal verdeeld zijn. Dit is vooral belangrijk als je hypothesetoetsen uitvoert of betrouwbaarheidsintervallen voor de correlatiecoëfficiënt berekent. Als de verdelingen sterk niet-normaal zijn, kan de geschatte correlatie de relatie in de steekproef nog wel beschrijven, maar is de p-waarde die je krijgt waarschijnlijk minder betrouwbaar.
Pearson-correlatie gaat ook uit van homoscedasticiteit, wat betekent dat de variabiliteit van de ene variabele relatief consistent blijft over het bereik van de andere variabele. In de praktijk betekent dit dat de spreiding van punten in een spreidingsdiagram ongeveer gelijk moet blijven naarmate waarden toenemen of afnemen. Wanneer de spreiding aanzienlijk verandert over het bereik van de data, kan de correlatiecoëfficiënt de structuur van de relatie niet volledig vastleggen. Net als bij normaliteit kun je r nog steeds berekenen als je deze aanname schendt, maar daaropvolgende inferentietoetsen worden minder betrouwbaar.
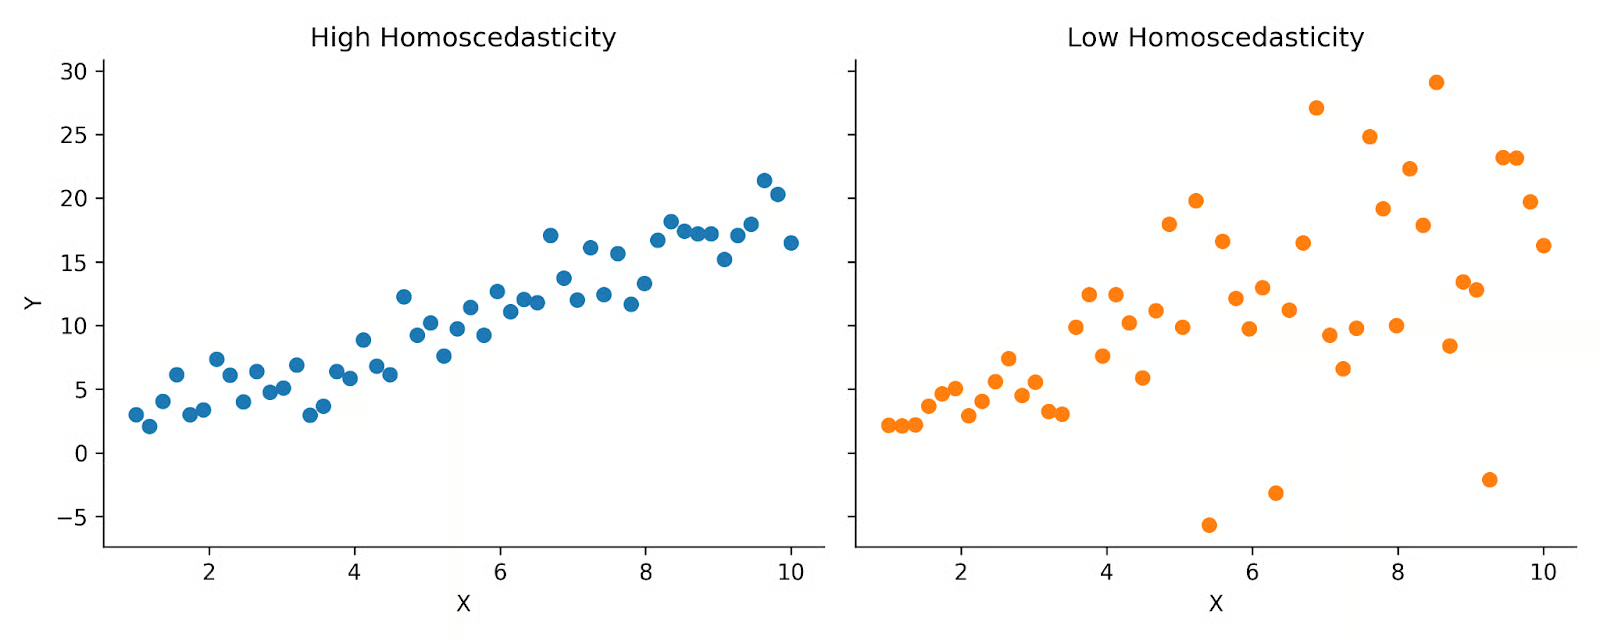
Hierboven zie je twee plots die hoge versus lage homoscedasticiteit laten zien. Links zie je dat de data vrij gelijkmatig over de verdeling is verspreid. Rechts zie je meer een kegelvorm. Pearson-correlatie gaat ervan uit dat je data meer lijkt op de plot links.
Tot slot, zoals eerder besproken, is Pearson-correlatie gevoelig voor uitschieters. Extreme waarden kunnen de berekening onevenredig beïnvloeden, omdat de coëfficiënt is gebaseerd op gemiddelden en standaardafwijkingen. Een enkel ongebruikelijk datapunt kan de correlatie aanzienlijk verhogen of verlagen.
Pearson-correlatie en Spearman-correlatie klinken erg vergelijkbaar en worden makkelijk verward. Het zijn allebei maten voor de relatie tussen twee variabelen, maar ze verschillen in het type relatie dat ze vastleggen en in de aannames waarop ze steunen.
De Pearson-correlatiecoëfficiënt meet de sterkte van een lineaire relatie tussen twee continue variabelen. Daarentegen meet de Spearman-correlatiecoëfficiënt de sterkte van een monotone relatie, wat betekent dat de variabelen in dezelfde richting bewegen maar niet noodzakelijk in een constant tempo. Een monotone relatie kan lineair of niet-lineair zijn, zolang deze maar consequent toeneemt of afneemt.
Spearman-correlatie wordt berekend met de gerangschikte waarden van de data in plaats van de ruwe waarden. Door data naar rangen om te zetten, verkleint Spearman de impact van uitschieters en is er geen aanname van lineariteit nodig.
Pearson-correlatie wordt beschouwd als een parametrische maat omdat die afhankelijk is van aannames over de verdeling van de data. Spearman-correlatie daarentegen is niet-parametrisch, omdat die niet dezelfde verdelingsaannames vereist en minder afhankelijk is van normaliteit.
Wanneer aan de aannames voor Pearson-correlatie is voldaan, kan die een nauwkeurigere schatting geven van de werkelijke lineaire samenhang dan Spearman. Maar wanneer onze data niet aan deze standaarden voldoet, kan Spearman-correlatie nog steeds een relatie tussen twee variabelen oppikken.
|
Correlatiecoëfficiënt |
Wanneer te gebruiken |
|
Pearson-correlatie |
Lineaire relatie; continue variabelen; goed gedragen data |
|
Spearman-correlatie |
Monotone relatie; aanwezigheid van uitschieters; ordinale of gerangschikte data |
Covariantie is een nauw verwant concept, maar verschilt in schaal en interpretatie.
Covariantie meet of twee variabelen de neiging hebben om in dezelfde richting of in tegengestelde richtingen te bewegen. Als de variabelen samen toenemen, is de covariantie positief. Als de ene toeneemt terwijl de andere afneemt, is de covariantie negatief.
De omvang van de covariantie hangt echter af van de eenheden van de variabelen. Zo verschilt de covariantie tussen lengte in centimeters en gewicht in kilogrammen numeriek van de covariantie tussen lengte in inches en gewicht in ponden. Dit maakt covariantie lastig te vergelijken tussen datasets.
De Pearson-correlatiecoëfficiënt ondervangt deze beperking door de covariantie te delen door het product van de standaardafwijkingen van de twee variabelen. Dankzij deze normalisatie is Pearson-correlatie eenheidsloos en ligt deze altijd tussen −1 en +1. Dit begrensde bereik maakt de interpretatie veel eenvoudiger.
Kort gezegd:
Hoewel de Pearson-correlatiecoëfficiënt veel wordt gebruikt en makkelijk te interpreteren is, zijn er enkele belangrijke beperkingen.
Pearson-correlatie gebruik je het beste als onderdeel van een bredere verkennende en analytische workflow. Visualiseer je data, controleer of alle aannames gelden en houd rekening met de context van je vraagstuk wanneer je de correlatiecoëfficiënt van Pearson gebruikt en interpreteert.
De Pearson-correlatiecoëfficiënt is een fundamentele statistische maat die in uiteenlopende disciplines wordt gebruikt. Ben je benieuwd hoe correlatie past in real-life workflows, bekijk dan onze tutorial over verkennende data-analyse in Python. Wil je correlatie in de praktijk verkennen, bekijk dan onze pandas-tutorial om te zien hoe correlaties in echte datasets worden gebruikt.
Leer met DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

