
Corso
Concetti di comunicazione dei dati
3 ore
85.4K
Immagina di esaminare alcuni dati aziendali e notare che, man mano che aumenti la spesa pubblicitaria, anche i ricavi sembrano aumentare. Prima di prendere decisioni, vorrai quantificare la forza di questa relazione.
Il coefficiente di correlazione di Pearson è il metodo di riferimento per quantificare una relazione di questo tipo. È utilizzato in una grande varietà di discipline, tra cui data science, economia, psicologia e biologia. Gli analisti calcolano le correlazioni già durante l’analisi esplorativa dei dati per individuare schemi prima di passare ad altre tecniche.
Prima di guardare formule o calcoli, è utile sviluppare un’intuizione su cosa descrive la correlazione. In termini molto semplici, la correlazione misura come due variabili si muovono insieme, come accennato. Risponde alla domanda: “Quando una variabile aumenta, cosa fa l’altra?”
La correlazione si concentra in modo specifico sugli schemi di co-movimento, piuttosto che sui valori individuali. Quando due variabili tendono ad aumentare o diminuire contemporaneamente, hanno una relazione positiva. Quando due variabili tendono a muoversi in direzioni opposte (una aumenta mentre l’altra diminuisce), hanno una relazione negativa. E quando i valori di entrambe le variabili non sembrano seguire alcuno schema coerente, potrebbe non esserci alcuna relazione.
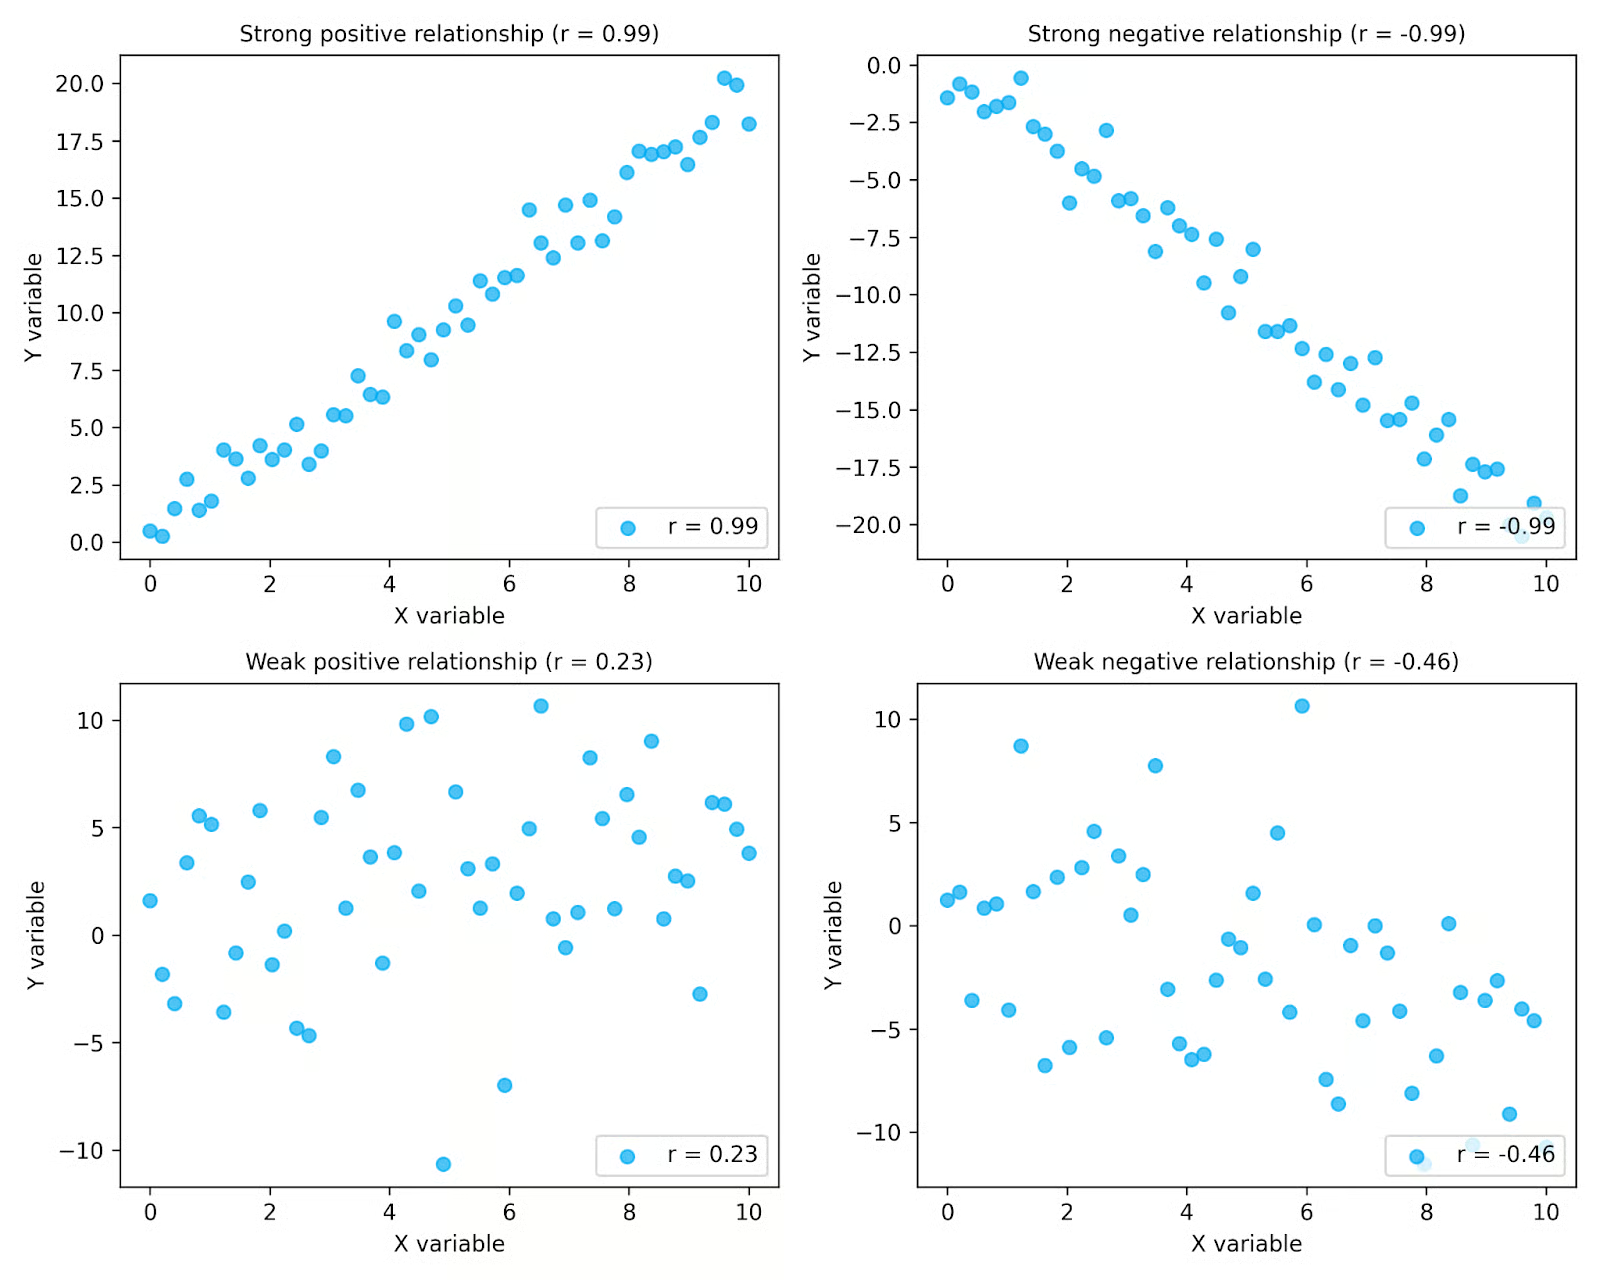
Nei grafici sopra, puoi vedere come la correlazione catturi sia la direzione sia la forza. La riga superiore mostra relazioni forti, dove i punti seguono un chiaro schema, mentre la riga inferiore mostra relazioni più deboli con maggiore dispersione. I grafici a sinistra mostrano relazioni positive, dove i valori aumentano insieme, e quelli a destra mostrano relazioni negative, dove una variabile diminuisce mentre l’altra aumenta. I valori di r mostrati in ogni grafico riassumono questi schemi.
La correlazione è particolarmente utile durante l’analisi esplorativa dei dati, in cui si esaminano le relazioni tra variabili. Rappresentare graficamente i dati rende più facile vedere gli schemi e determinare se una misura di correlazione come quella di Pearson è appropriata per i tuoi dati.
È anche importante ricordare che la correlazione descrive le relazioni osservate nei dati, non i meccanismi che le producono. Anche quando due variabili sono fortemente correlate, non significa che una variabile abbia causato il cambiamento dell’altra. La correlazione si limita a riassumere gli schemi esistenti. Ricorda il vecchio adagio: “la correlazione non implica causalità”.
Il coefficiente di correlazione di Pearson fornisce un modo formale per misurare la forza e la direzione di una relazione lineare tra due variabili continue. Riassume quanto da vicino i punti in uno scatter plot seguono un andamento rettilineo.
Il valore del coefficiente di correlazione di Pearson è sempre compreso tra −1 e +1.
|
Valore di r |
Interpretazione |
|
+1 |
Relazione lineare positiva perfetta |
|
0 |
Nessuna relazione lineare |
|
−1 |
Relazione lineare negativa perfetta |
Questi valori quantificano gli schemi discussi nella sezione precedente. Valori più vicini a +1 o −1 indicano una relazione lineare più forte, mentre valori più vicini a 0 indicano una relazione più debole. Il segno indica se la relazione è positiva o negativa.
Un punto chiave è che la correlazione di Pearson misura solo le relazioni lineari. Se due variabili seguono un andamento non lineare, il coefficiente di correlazione può essere vicino a zero anche quando le variabili sono chiaramente correlate. In altre parole, r = 0 non significa necessariamente che non esista alcuna relazione; significa che non esiste una relazione lineare tra le variabili.
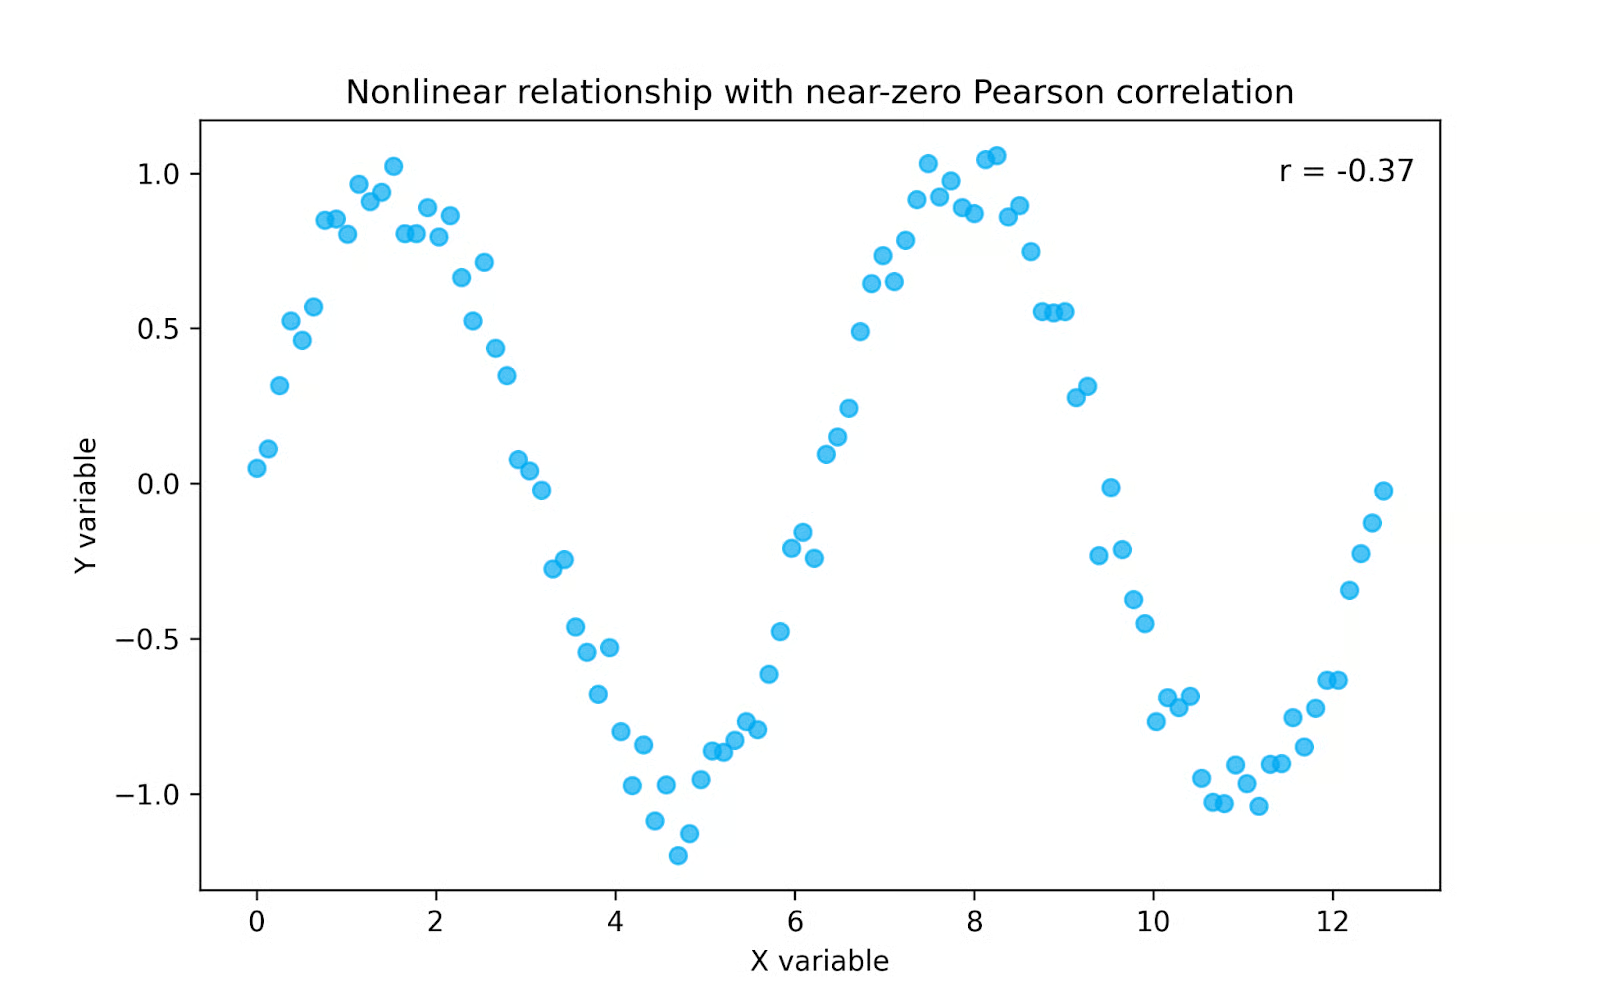
Nel grafico sopra, le variabili seguono chiaramente uno schema, ma non è una linea retta. Poiché la correlazione di Pearson misura solo relazioni lineari, il valore di r è vicino a zero anche se le variabili sono fortemente correlate. In casi come questo, una misura basata sui ranghi come la correlazione di Spearman può essere più appropriata, poiché può catturare schemi monotoni che non sono lineari.
Il coefficiente di correlazione di Pearson si calcola con una formula che confronta come due variabili cambiano insieme rispetto a quanto cambiano individualmente. È più comunemente scritto così:
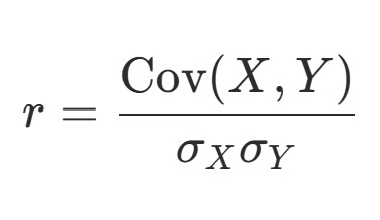
In questa espressione, Cov(X, Y) rappresenta la covarianza tra le due variabili, mentre σX e σY rappresentano le deviazioni standard di ciascuna variabile. La covarianza misura se due variabili tendono ad aumentare o diminuire insieme, ma la sua magnitudine dipende dalle unità delle variabili. Dividere per le deviazioni standard standardizza il risultato e garantisce che il coefficiente di correlazione di Pearson sia sempre compreso tra −1 e +1. Per una discussione più ampia su correlazione e covarianza, dai un’occhiata al nostro tutorial sull’argomento.
La correlazione di Pearson è essenzialmente una covarianza standardizzata. Mentre la covarianza ci dice se le variabili si muovono nella stessa o in direzione opposta, la correlazione scala questa informazione in modo che la forza della relazione possa essere interpretata in modo coerente tra dataset diversi.
Se hai mai dovuto fare questo calcolo a mano (grazie, corso di statistica!) probabilmente riconoscerai questa versione della formula, che rende i passaggi più espliciti:
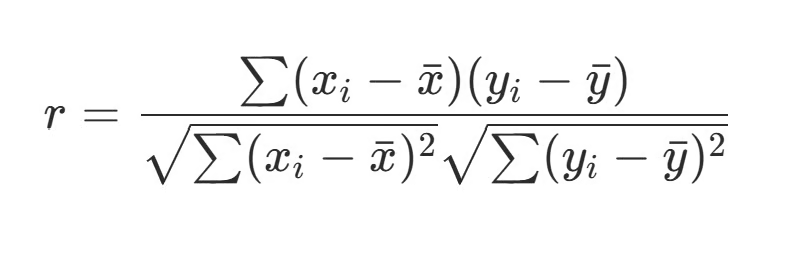
Qui, ogni osservazione è confrontata con la media della propria variabile. I termini (Xi − X̄) e (Yi − Ȳ) calcolano quanto ogni valore si discosta dalla media. Moltiplicare queste deviazioni misura se le variabili si muovono nella stessa direzione in ciascuna osservazione. Quando entrambe le deviazioni sono positive o entrambe negative, il loro prodotto è positivo, contribuendo a una correlazione positiva. Quando una deviazione è positiva e l’altra negativa, il prodotto è negativo, contribuendo a una correlazione negativa.
La logica di base del calcolo è semplice:
Questa struttura consente al coefficiente di correlazione di Pearson di fornire una misura standardizzata di quanto fortemente due variabili sono correlate linearmente, indipendentemente dalle loro unità o scale originali.
Facciamo insieme un breve esempio. Supponiamo di voler esaminare la relazione tra ore di studio e voti d’esame per un gruppo di studenti. Di seguito abbiamo un piccolo dataset per cinque studenti.
|
Studente |
Ore di studio (X) |
Voto d’esame (Y) |
|
Luther |
5 |
72 |
|
Alexandra |
2 |
70 |
|
Javier |
3 |
63 |
|
Jamie |
1 |
58 |
|
Auburn |
4 |
73 |
Il primo passaggio è sempre quello di tracciare i dati. Facciamolo qui sotto.
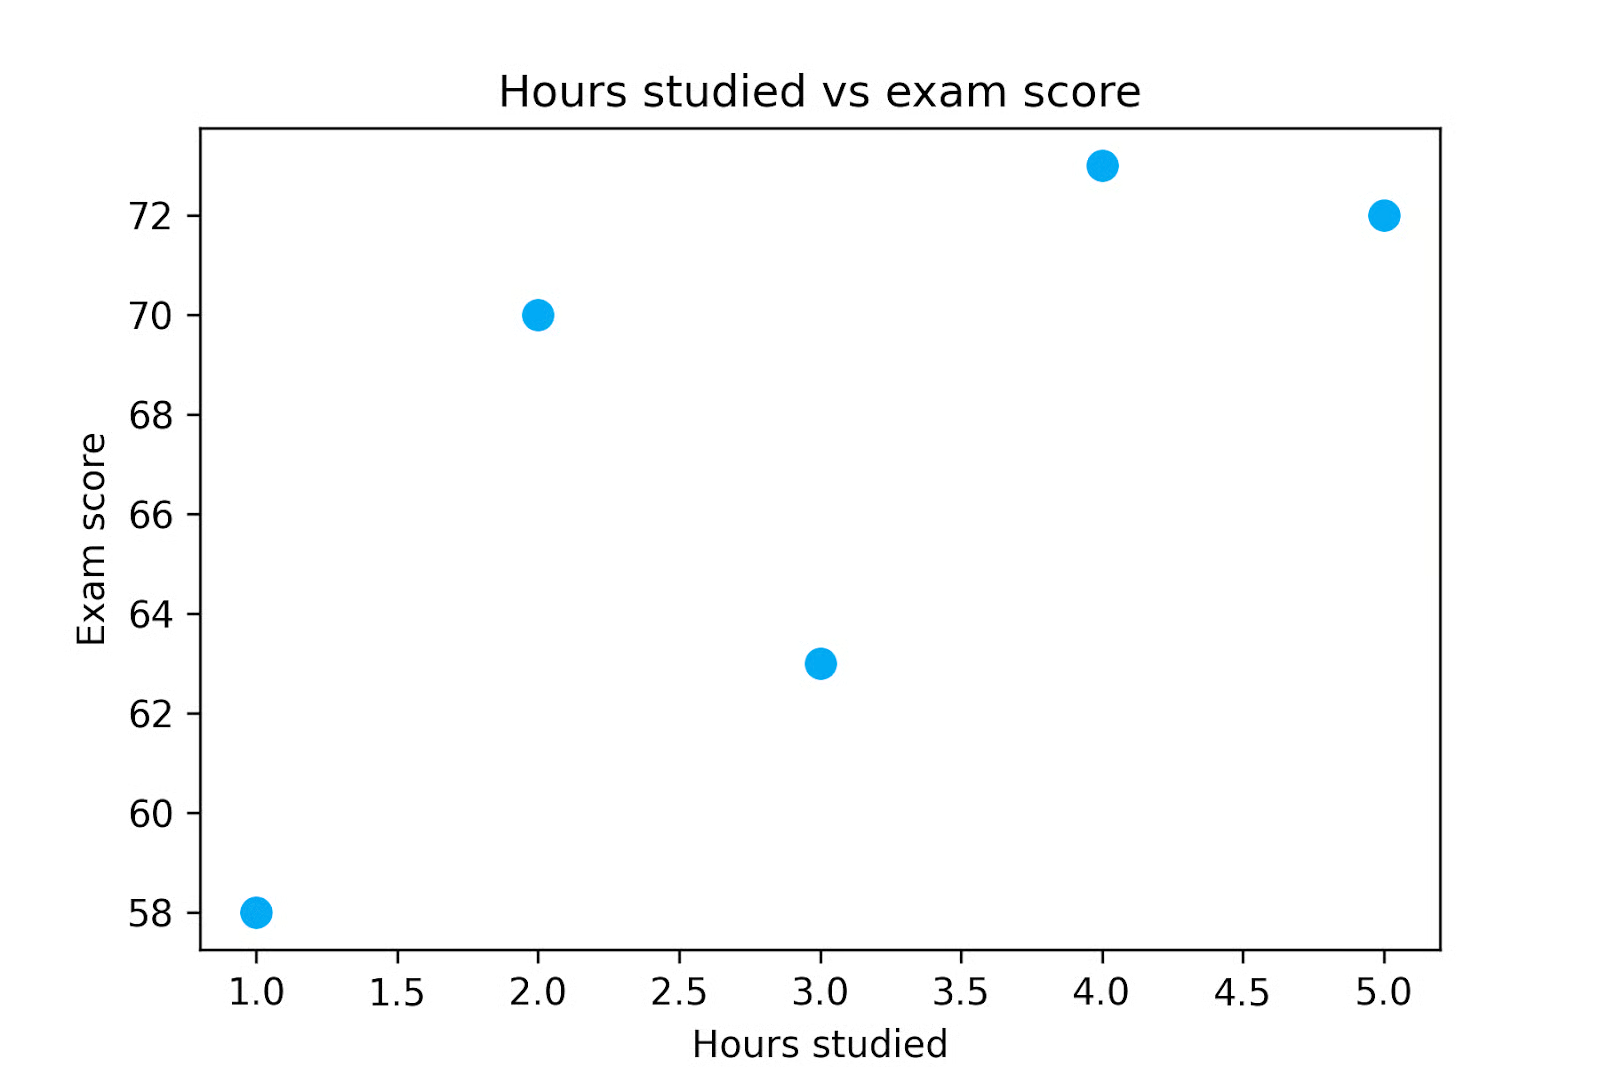
Quando rappresentiamo i dati, possiamo vedere che i voti d’esame tendono ad aumentare all’aumentare del tempo di studio, ma vogliamo quantificare questa relazione. Quindi calcoliamo il coefficiente di correlazione di Pearson per questo dataset.
Per prima cosa, dobbiamo calcolare la media di ciascuna variabile. In questo esempio, il numero medio di ore di studio è 3 e il voto medio d’esame è 67,2.
Successivamente, calcoliamo quanto ogni osservazione si discosta dalla propria media. Questi valori sono chiamati deviazioni dalla media.
Poi, moltiplichiamo le deviazioni per mostrare come le variabili si muovono insieme in ciascuna osservazione. Quando entrambe le deviazioni hanno lo stesso segno, il loro prodotto è positivo, contribuendo a una correlazione positiva. Quando le deviazioni hanno segni opposti, il prodotto è negativo e contribuisce a una correlazione negativa.
|
X |
Y |
X − X̄ |
Y − Ȳ |
(X − X̄)(Y − Ȳ) |
|
1 |
58 |
-2 |
-9.2 |
18.4 |
|
2 |
70 |
-1 |
2.8 |
-2.8 |
|
3 |
63 |
0 |
-4.2 |
0 |
|
4 |
73 |
1 |
5.8 |
5.8 |
|
5 |
72 |
2 |
4.8 |
9.6 |
Quando sommiamo i prodotti nell’ultima colonna otteniamo 31, che è il numeratore del nostro calcolo della correlazione di Pearson.
Successivamente, calcoliamo la variabilità di ciascuna variabile usando le loro deviazioni standard. Per farlo, eleviamo al quadrato le deviazioni nelle colonne 3 e 4 prima di sommarle.
Per X:
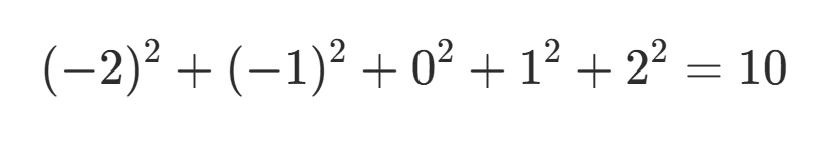
Per Y:
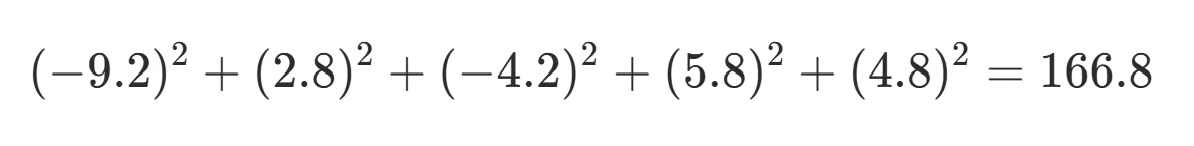
Poi prendiamo la radice quadrata di ciascuna somma:
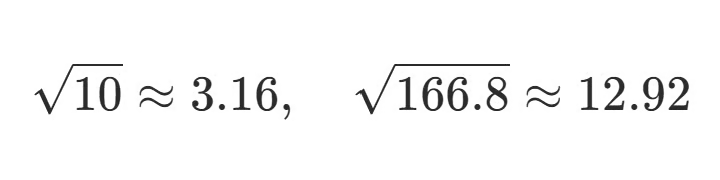
Infine, dividiamo il numeratore per il prodotto delle deviazioni standard:
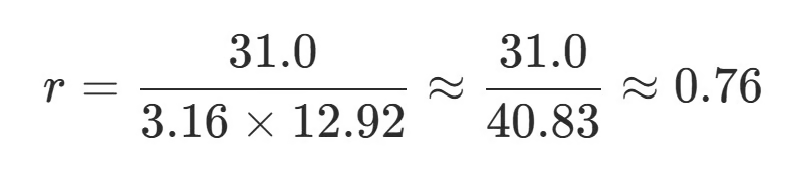
Questo passaggio finale ci fornisce il coefficiente di correlazione di Pearson, che in questo caso è circa 0,76, indicando una forte relazione lineare positiva. Possiamo concludere da ciò che il numero di ore studiate da uno studente è fortemente e positivamente correlato con il suo voto al test.
Tuttavia, non possiamo concludere che le ore studiate abbiano causato i voti. Per arrivare a quella conclusione, servirebbero ulteriori analisi o uno studio sperimentale.
Dall’esempio semplice sopra, si vede che calcolare a mano il coefficiente di correlazione di Pearson non è affatto pratico.
Per fortuna, la maggior parte dei software statistici include funzioni integrate per calcolarlo. Capire la meccanica del calcolo aiuta l’intuizione, ma nei flussi di lavoro reali il coefficiente è in genere calcolato automaticamente. Vediamo brevemente come calcolare il coefficiente di correlazione di Pearson con tre strumenti comuni: Excel, Python e R.
In Excel, il coefficiente di correlazione di Pearson è facile da calcolare usando la funzione CORREL(). Questa funzione accetta due intervalli di valori che rappresentano le variabili di interesse e restituisce il loro coefficiente di correlazione.
=CORREL(A1:A10, B1:B10)La funzione calcola direttamente r di Pearson dagli intervalli selezionati, rendendolo un modo rapido per esplorare le relazioni tra variabili nei fogli di calcolo.
In Python, il coefficiente di correlazione di Pearson è comunemente calcolato usando le librerie pandas o SciPy. Il metodo corr() in pandas calcola le correlazioni tra le colonne di un DataFrame:
import pandas as pd

pearson_df['hours_studied'].corr(pearson_df['exam_score'])
In alternativa, la funzione pearsonr() del modulo statistics di SciPy restituisce sia il coefficiente di correlazione sia un p-value per i test d’ipotesi:
from scipy.stats import pearsonr

pearsonr(pearson_df['hours_studied'], pearson_df['exam_score'])
Se sei alle prime armi con l’analisi dati in Python, puoi approfondire il lavoro con dataset tabellari nel nostro tutorial su pandas.
In R, il coefficiente di correlazione di Pearson si può calcolare con la funzione cor():
cor(x, y)Per impostazione predefinita, questa funzione calcola il coefficiente di correlazione di Pearson, anche se puoi specificare altri metodi di correlazione se lo desideri.
Ciascuno di questi tre strumenti rende facile calcolare rapidamente il coefficiente di correlazione di Pearson. Di fatto, proprio perché è così semplice, è comune che gli analisti generino una matrice di correlazione, che mostra le correlazioni a coppie tra più variabili contemporaneamente. Questo aiuta a identificare schemi e relazioni che potrebbero meritare ulteriori approfondimenti nelle fasi successive dell’analisi.
Una cosa è calcolare il coefficiente di correlazione di Pearson, ma come lo si interpreta? Ricorda che il coefficiente r descrive sia la direzione sia la forza di una relazione lineare tra due variabili.
Il segno di r indica la direzione della relazione. Un valore positivo significa che le variabili tendono ad aumentare insieme, mentre un valore negativo indica che una variabile tende a diminuire mentre l’altra aumenta.
La magnitudine di r descrive la forza dell’associazione lineare, con valori più vicini a 1 più forti rispetto a quelli più vicini a 0. Campi diversi possono avere tradizioni diverse su cosa considerare una relazione forte. In contesti sperimentali altamente controllati, come alcune aree della fisica o dell’ingegneria, correlazioni forti possono avvicinarsi a 1. In campi che coinvolgono sistemi biologici o sociali complessi, come medicina, sanità pubblica, economia o psicologia, correlazioni nell’intervallo 0,1–0,4 possono comunque essere significative, soprattutto quando le variabili sono difficili da misurare o gli effetti si accumulano su larga scala. Poiché gli standard variano tra le discipline, interpretare r richiede conoscenza del dominio e giudizio contestuale.
È anche importante notare che la correlazione di Pearson è sensibile ai valori estremi. Un singolo outlier può aumentare o diminuire sensibilmente il valore di r. Questo è uno dei motivi per cui è così importante tracciare i dati. Esaminare gli scatter plot insieme ai coefficienti di correlazione aiuta a identificare eventuali outlier che potrebbero esercitare un’influenza eccessiva.
I software statistici spesso forniscono un p-value insieme al coefficiente di correlazione di Pearson. Questo p-value testa quanto è probabile osservare una correlazione almeno forte quanto quella nei tuoi dati se in realtà non ci fosse alcuna relazione tra le variabili. Se è poco probabile che si verifichi per puro caso, diciamo che la relazione è statisticamente significativa.
Questo p-value si calcola convertendo il coefficiente di correlazione di Pearson in una statistica t e confrontandola con la distribuzione t. È simile a un test t di Student, ma qui l’obiettivo è testare se la correlazione vera è zero.
Con dataset di grandi dimensioni, anche un valore di r relativamente piccolo può comunque essere statisticamente significativo, pur rappresentando una relazione debole a livello individuale. Questo è importante, ad esempio, in sanità pubblica, dove una relazione debole può comunque causare impatti significativi sulla popolazione. Per questo motivo, è spesso utile distinguere tra la magnitudine della correlazione (r) e la sua significatività statistica (p-value).
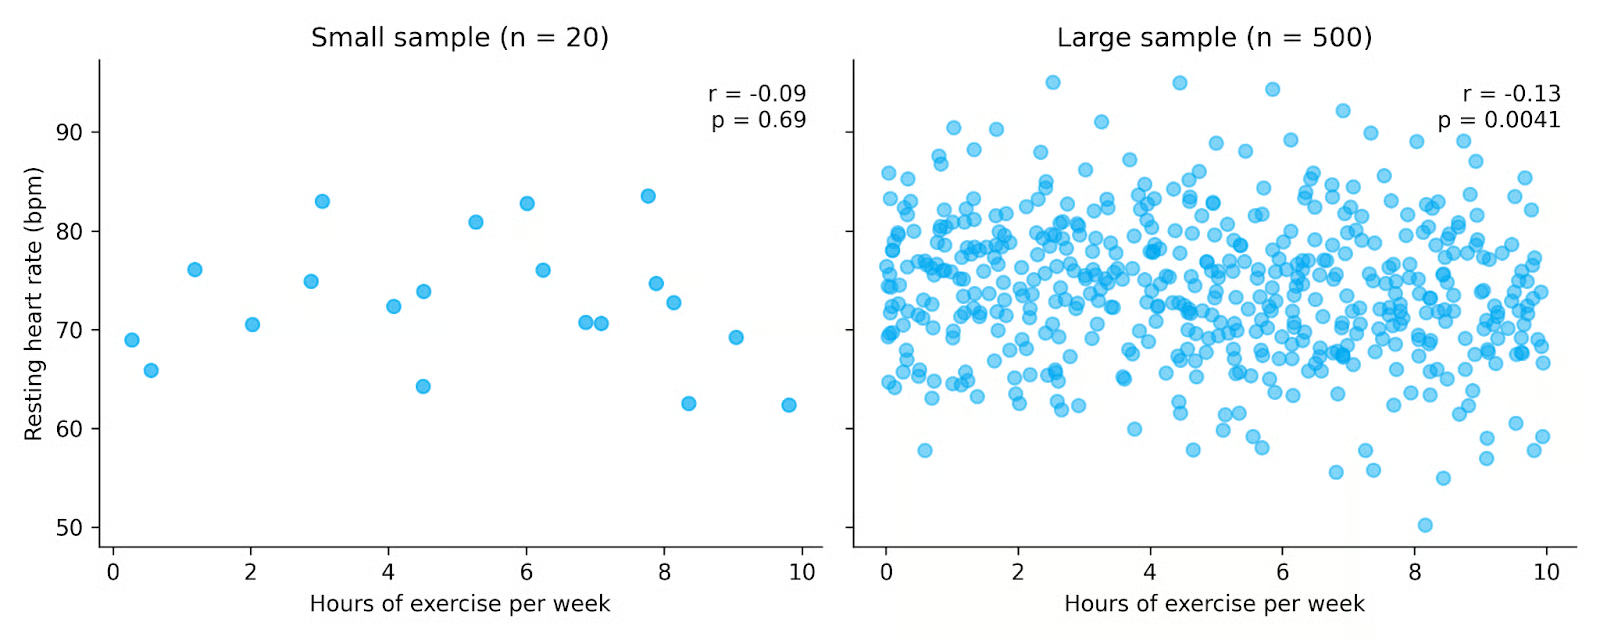
Nei grafici sopra, entrambi i dataset mostrano una relazione negativa debole tra esercizio fisico e frequenza cardiaca a riposo. Tuttavia, il dataset a destra include molte più osservazioni, rendendo la relazione statisticamente significativa anche se la correlazione resta piccola. Questo evidenzia come campioni più grandi aumentino la nostra capacità di individuare relazioni e perché sia importante considerare sia il valore di r sia il p-value quando si interpretano i risultati.
Il coefficiente di correlazione di Pearson è ampiamente utilizzato perché è semplice da calcolare e interpretare. Tuttavia, come molti strumenti statistici, funziona al meglio quando alcune assunzioni sui dati sono ragionevolmente soddisfatte.
Per prima cosa, la correlazione di Pearson assume una relazione lineare tra due variabili. Se la relazione reale segue un andamento curvilineo o non lineare, il coefficiente può sottostimare la forza dell’associazione o persino suggerire che non esiste alcuna relazione.
Un’altra assunzione è che le variabili analizzate siano continue. La correlazione di Pearson è progettata per variabili misurate su scale numeriche continue, come altezza, reddito, temperatura o voti d’esame. Se hai dati ordinali o discreti, potresti trovarti meglio usando la correlazione di Spearman o il tau di Kendall.
In generale, vorrai anche che i tuoi dati siano distribuiti normalmente. Questo è particolarmente importante se stai effettuando test d’ipotesi o calcolando intervalli di confidenza per il coefficiente di correlazione. Se le distribuzioni sono fortemente non normali, la correlazione stimata potrebbe descrivere comunque la relazione nel campione, ma il p-value ottenuto sarà probabilmente meno affidabile.
La correlazione di Pearson assume anche omoscedasticità, cioè che la variabilità di una variabile sia relativamente consistente lungo l’intero intervallo dell’altra variabile. In termini pratici, significa che la dispersione dei punti in uno scatter plot dovrebbe rimanere più o meno simile al crescere o diminuire dei valori. Quando la dispersione cambia sostanzialmente lungo l’intervallo dei dati, il coefficiente di correlazione potrebbe non catturare completamente la struttura della relazione. Come per la normalità, puoi comunque calcolare r se questa assunzione non è rispettata, ma i test inferenziali successivi saranno meno affidabili.
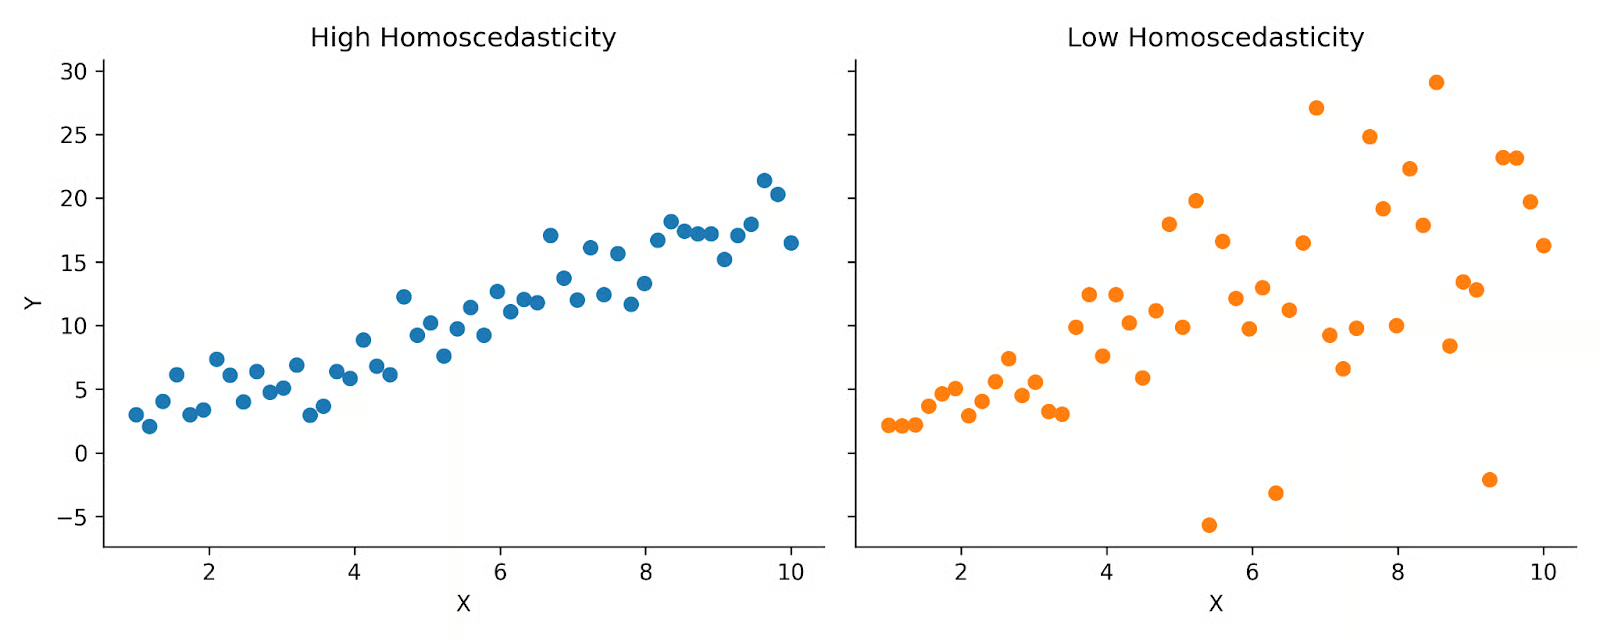
Sopra puoi vedere due grafici che mostrano alta e bassa omoscedasticità. A sinistra, i dati sono distribuiti in modo abbastanza uniforme lungo la distribuzione. A destra, invece, vedi una forma più a cono. La correlazione di Pearson presume che i tuoi dati assomiglino di più al grafico a sinistra.
Infine, come già discusso, la correlazione di Pearson è sensibile agli outlier. I valori estremi possono influenzare in modo sproporzionato il calcolo perché il coefficiente si basa su medie e deviazioni standard. Un singolo punto dati insolito può aumentare o diminuire sensibilmente la correlazione.
La correlazione di Pearson e quella di Spearman suonano molto simili e possono essere facilmente confuse. Sono entrambe misure della relazione tra due variabili, ma differiscono per il tipo di relazione che catturano e per le assunzioni su cui si basano.
Il coefficiente di correlazione di Pearson misura la forza di una relazione lineare tra due variabili continue. Al contrario, il coefficiente di correlazione di Spearman misura la forza di una relazione monotona, il che significa che le variabili si muovono nella stessa direzione ma non necessariamente a un ritmo costante. Una relazione monotona può essere lineare o non lineare, purché aumenti o diminuisca in modo coerente.
La correlazione di Spearman si calcola utilizzando i valori classificati (rank) dei dati anziché i valori grezzi. Convertendo i dati in ranghi, la correlazione di Spearman riduce l’impatto degli outlier e non richiede l’assunzione di linearità.
La correlazione di Pearson è considerata una misura parametrica perché si basa su assunzioni riguardo alla distribuzione dei dati. La correlazione di Spearman, invece, è considerata non parametrica, poiché non richiede le stesse assunzioni distributive ed è meno dipendente dalla normalità.
Quando le assunzioni per la correlazione di Pearson sono soddisfatte, può fornire una stima più precisa dell’effettiva associazione lineare rispetto alla correlazione di Spearman. Tuttavia, quando i nostri dati non rispettano questi requisiti, Spearman può comunque cogliere una relazione tra due variabili.
|
Coefficiente di correlazione |
Quando usarlo |
|
Correlazione di Pearson |
Relazione lineare; variabili continue; dati ben comportati |
|
Correlazione di Spearman |
Relazione monotona; presenza di outlier; dati ordinali o classificati |
La covarianza è un concetto strettamente correlato, ma differisce per come è scalata e interpretata.
La covarianza misura se due variabili tendono a muoversi nella stessa direzione o in direzioni opposte. Se le variabili aumentano insieme, la covarianza è positiva. Se una aumenta mentre l’altra diminuisce, la covarianza è negativa.
Tuttavia, la magnitudine della covarianza dipende dalle unità delle variabili. Ad esempio, la covarianza tra altezza misurata in centimetri e peso misurato in chilogrammi sarà numericamente diversa dalla covarianza tra altezza in pollici e peso in libbre. Questo rende difficile confrontare la covarianza tra diversi dataset.
Il coefficiente di correlazione di Pearson supera questo limite dividendo la covarianza per il prodotto delle deviazioni standard delle due variabili. Grazie a questa normalizzazione, la correlazione di Pearson è priva di unità e sempre compresa tra −1 e +1. Questo intervallo limitato la rende molto più facile da interpretare.
In termini semplici:
Sebbene il coefficiente di correlazione di Pearson sia ampiamente usato e facile da interpretare, presenta diverse limitazioni importanti.
La correlazione di Pearson dà il meglio se usata come parte di un flusso di lavoro esplorativo e analitico più ampio. Visualizza i tuoi dati, verifica che tutte le assunzioni siano rispettate e considera il contesto del tuo problema quando utilizzi e interpreti il coefficiente di correlazione di Pearson.
Il coefficiente di correlazione di Pearson è una misura statistica fondamentale utilizzata in una vasta gamma di discipline. Se ti interessa capire come la correlazione si inserisce nei flussi di lavoro reali, esplora il nostro tutorial sull’analisi esplorativa dei dati in Python. Se vuoi esplorare la correlazione in pratica, dai un’occhiata al nostro tutorial su pandas per vedere come le correlazioni vengono utilizzate in dataset reali.
Impara con DataCamp
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



