
कोर्स
डेटा कम्युनिकेशन कॉन्सेप्ट्स
3 घंटा
85.2K
मान लीजिए आप किसी कंपनी के डेटा को देख रहे हैं और नोटिस करते हैं कि जैसे-जैसे आपका विज्ञापन खर्च बढ़ता है, आपका राजस्व भी बढ़ता दिखता है। कोई भी निर्णय लेने से पहले, आप उस संबंध की मजबूती को परिमाणित करना चाहेंगे।
ऐसे संबंध को परिमाणित करने का सबसे प्रचलित तरीका पीयर्सन सहसंबंध गुणांक है। इसका उपयोग डेटा साइंस, अर्थशास्त्र, मनोविज्ञान और जीवविज्ञान सहित कई क्षेत्रों में किया जाता है। विश्लेषक अक्सर अन्वेषणात्मक डेटा विश्लेषण के दौरान सहसंबंध की गणना करते हैं ताकि अन्य तकनीकों पर जाने से पहले पैटर्न खोज सकें।
सूत्रों या गणनाओं को देखने से पहले, यह समझ विकसित करना उपयोगी है कि सहसंबंध क्या बताता है। बुनियादी तौर पर, सहसंबंध मापता है कि दो चर एक साथ कैसे चलते हैं, जैसा कि मैंने उल्लेख किया। यह इस प्रश्न का उत्तर देता है, “जब एक चर बढ़ता है, तो दूसरा क्या करता है?”
सहसंबंध व्यक्तिगत मानों के बजाय सह-आंदोलन के पैटर्न पर विशेष रूप से केंद्रित होता है। जब दो चर एक ही समय में बढ़ने या घटने की प्रवृत्ति रखते हैं, तो उनके बीच सकारात्मक संबंध होता है। जब दो चर विपरीत दिशाओं में चलते हैं (एक बढ़ता है जबकि दूसरा घटता है), तो उनका संबंध नकारात्मक होता है। और जब दोनों चरों के मान किसी सुसंगत पैटर्न का पालन नहीं करते दिखते, तो संभव है कि कोई संबंध न हो।
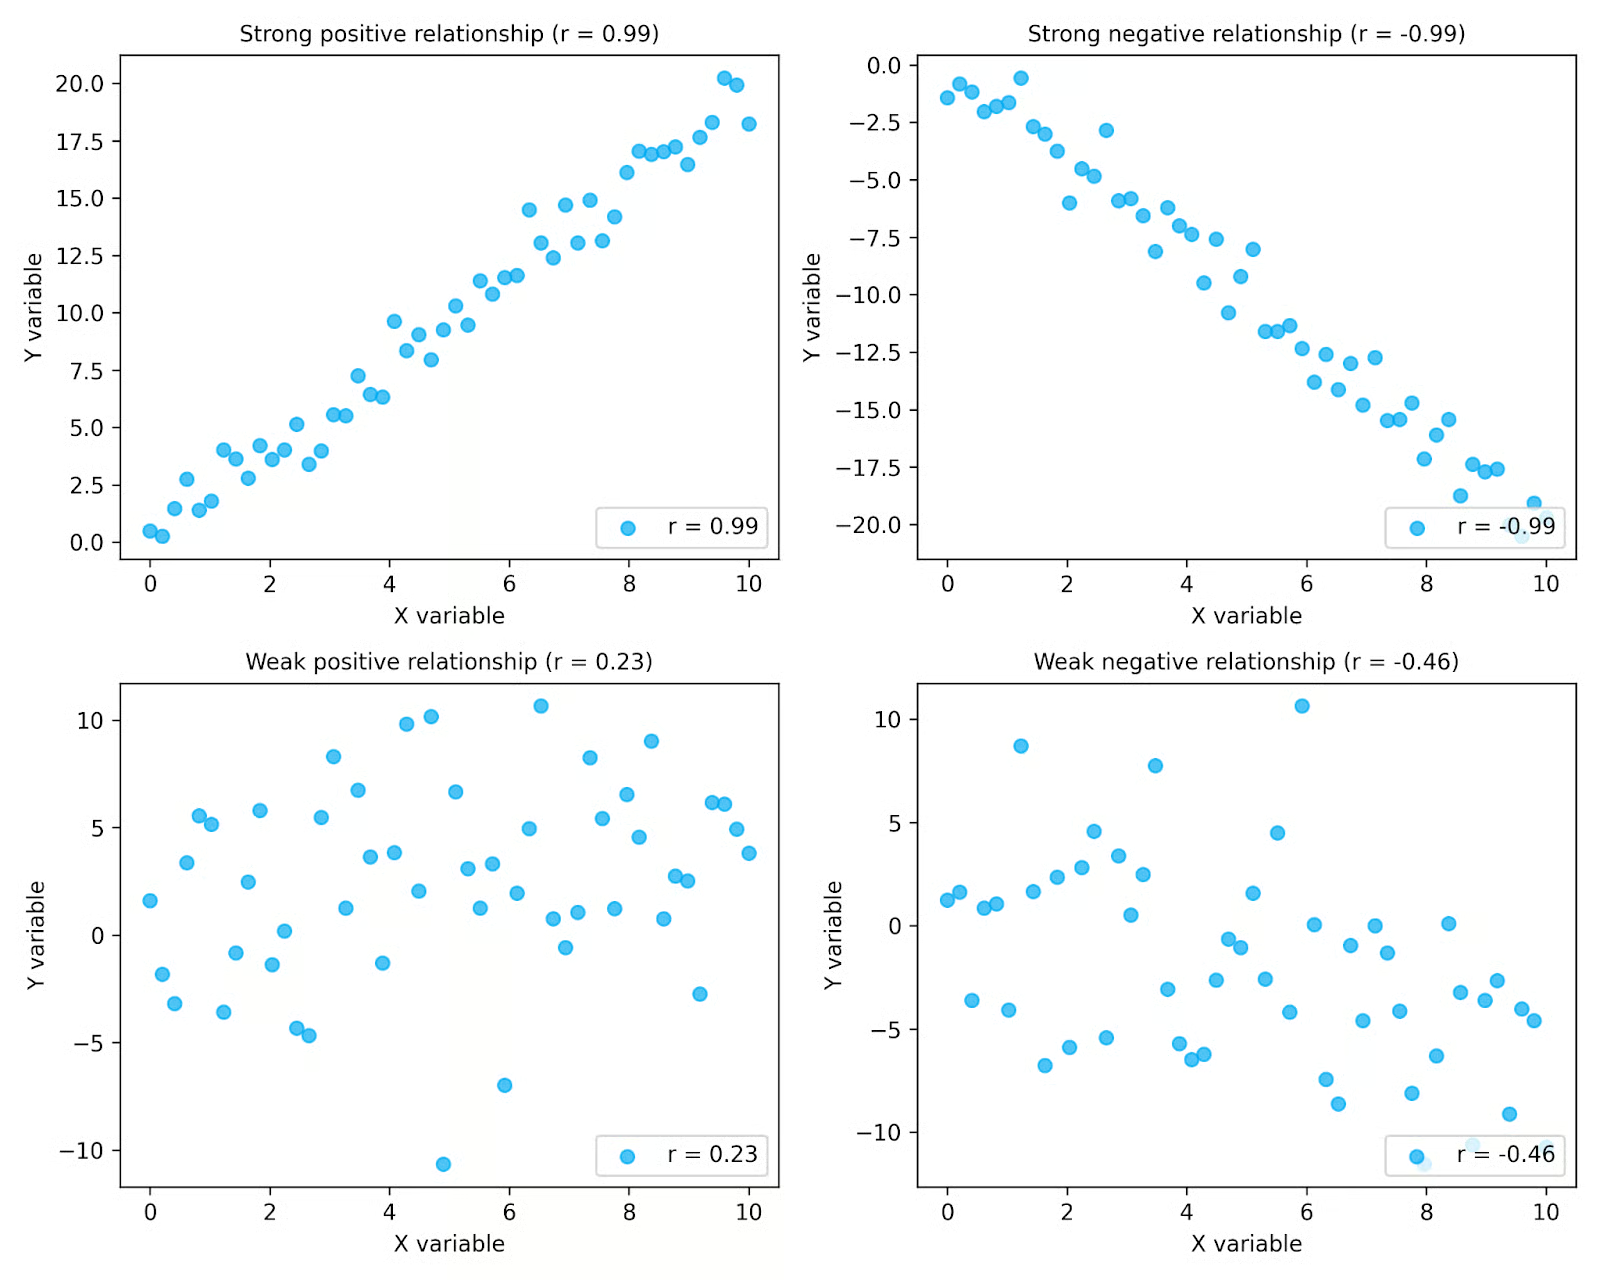
ऊपर के प्लॉट्स में, आप देख सकते हैं कि सहसंबंध दिशा और शक्ति दोनों को कैसे पकड़ता है। ऊपर की पंक्ति में मजबूत संबंध हैं, जहाँ बिंदु एक स्पष्ट पैटर्न का अनुसरण करते हैं, जबकि नीचे की पंक्ति में अधिक बिखराव के साथ कमजोर संबंध हैं। बाएँ के प्लॉट्स सकारात्मक संबंध दिखाते हैं, जहाँ मान साथ-साथ बढ़ते हैं, और दाएँ के प्लॉट्स नकारात्मक संबंध दिखाते हैं, जहाँ एक चर घटता है जब दूसरा बढ़ता है। प्रत्येक प्लॉट में दिखाए गए r मान इन पैटर्न्स का सार बताते हैं।
अन्वेषणात्मक डेटा विश्लेषण के दौरान सहसंबंध विशेष रूप से उपयोगी होता है, जहाँ विश्लेषक चरों के बीच संबंधों की जाँच करते हैं। अपने डेटा का प्लॉट बनाना पैटर्न देखने और यह निर्धारित करने में आसान बनाता है कि क्या पीयर्सन जैसा सहसंबंध मापक आपके डेटा के लिए उपयुक्त है।
यह याद रखना भी महत्वपूर्ण है कि सहसंबंध डेटा में देखे गए संबंधों का वर्णन करता है, उन तंत्रों का नहीं जो उन्हें उत्पन्न करते हैं। भले ही दो चर मजबूत रूप से सहसंबद्ध हों, इसका यह अर्थ नहीं कि एक चर ने दूसरे को बदलने का कारण बना। सहसंबंध केवल विद्यमान पैटर्न का सार प्रस्तुत करता है। बस इस पुराने कहावत को याद रखें, “सहसंबंध का अर्थ कारणता नहीं होता।”
पीयर्सन सहसंबंध गुणांक दो सतत चरों के बीच रैखिक संबंध की शक्ति और दिशा को मापने का औपचारिक तरीका देता है। यह सारांशित करता है कि स्कैटर प्लॉट में डेटा बिंदु किसी सीधी रेखा के पैटर्न का कितना नज़दीकी अनुसरण करते हैं।
पीयर्सन सहसंबंध गुणांक का मान हमेशा −1 और +1 के बीच होता है।
|
r का मान |
व्याख्या |
|
+1 |
सिद्ध सकारात्मक रैखिक संबंध |
|
0 |
कोई रैखिक संबंध नहीं |
|
−1 |
सिद्ध नकारात्मक रैखिक संबंध |
ये मान पिछले अनुभाग में चर्चा किए गए पैटर्न को परिमाणित करते हैं। +1 या −1 के करीब मान एक मजबूत रैखिक संबंध का संकेत देते हैं, जबकि 0 के करीब मान कमजोर संबंध का। संकेत बताता है कि संबंध सकारात्मक है या नकारात्मक।
एक महत्वपूर्ण बात यह है कि पीयर्सन का सहसंबंध केवल रैखिक संबंधों को मापता है। यदि दो चर गैर-रैखिक पैटर्न का अनुसरण करते हैं, तो सहसंबंध गुणांक 0 के करीब हो सकता है, भले ही चर स्पष्ट रूप से संबंधित हों। दूसरे शब्दों में, r = 0 का अर्थ यह नहीं कि कोई संबंध नहीं है; इसका अर्थ है कि चरों के बीच कोई रैखिक संबंध नहीं है।
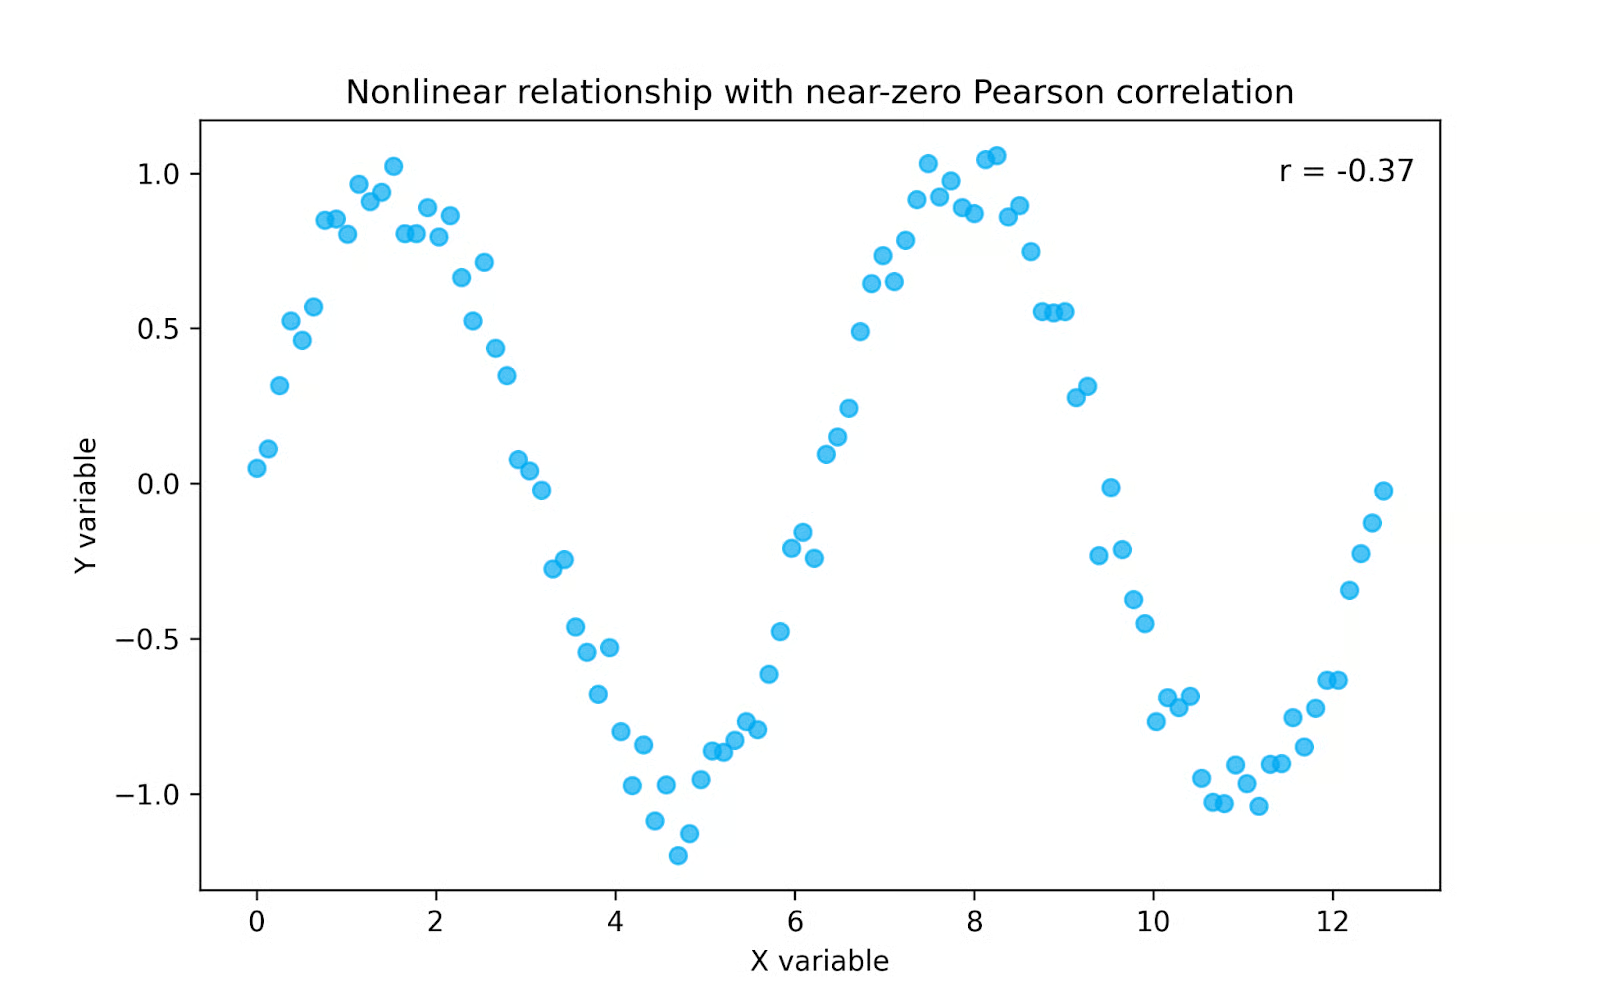
ऊपर के प्लॉट में, चर स्पष्ट रूप से एक पैटर्न का अनुसरण करते हैं, लेकिन वह सीधी रेखा नहीं है। क्योंकि पीयर्सन सहसंबंध केवल रैखिक संबंधों को मापता है, r का मान शून्य के करीब है, भले ही चर मजबूत रूप से संबंधित हों। ऐसे मामलों में, रैंक-आधारित मापक जैसे स्पीयरमैन सहसंबंध अधिक उपयुक्त हो सकता है, क्योंकि यह गैर-रैखिक मोनोटोनिक पैटर्न को पकड़ सकता है।
पीयर्सन का सहसंबंध गुणांक एक सूत्र से निकाला जाता है जो तुलना करता है कि दो चर एक साथ कितने बदलते हैं, इसके सापेक्ष कि वे व्यक्तिगत रूप से कितने बदलते हैं। इसे आमतौर पर इस प्रकार लिखा जाता है:
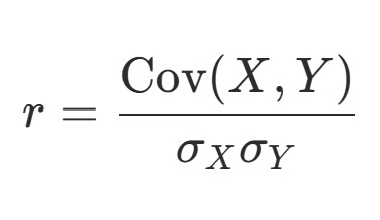
इस अभिव्यक्ति में, Cov(X, Y) दो चरों के बीच कोवेरिएंस को दर्शाता है, जबकि σX और σY प्रत्येक चर का मानक विचलन हैं। कोवेरिएंस मापता है कि क्या दो चर साथ-साथ बढ़ने या घटने की प्रवृत्ति रखते हैं, लेकिन इसका परिमाण चरों की इकाइयों पर निर्भर करता है। मानक विचलनों से भाग देने पर परिणाम मानकीकृत हो जाता है और सुनिश्चित करता है कि पीयर्सन सहसंबंध गुणांक हमेशा −1 और +1 के बीच रहे। सहसंबंध और कोवेरिएंस पर व्यापक चर्चा के लिए हमारा ट्यूटोरियल देखें।
मूलतः, पीयर्सन का सहसंबंध मानकीकृत कोवेरिएंस है। जहाँ कोवेरिएंस हमें बताता है कि चर एक ही या विपरीत दिशा में चलते हैं, वहीं सहसंबंध इस जानकारी को इस तरह स्केल करता है कि अलग-अलग डेटासेट में संबंध की ताकत को सुसंगत रूप से समझा जा सके।
यदि आपने कभी यह गणना हाथ से की है (धन्यवाद, सांख्यिकी कक्षा!) तो आप संभवतः सूत्र का यह रूप पहचानेंगे, जो चरणों को अधिक स्पष्ट बनाता है:
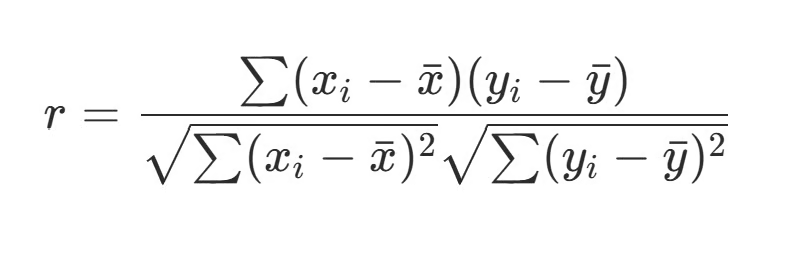
यहाँ, प्रत्येक प्रेक्षण की तुलना उसके चर के औसत से की जाती है। पद (Xi − X̄) और (Yi − Ȳ) गणना करते हैं कि प्रत्येक मान औसत से कितना दूर है। इन विचलनों का गुणन यह मापता है कि प्रत्येक प्रेक्षण पर चर एक ही दिशा में चलते हैं या नहीं। जब दोनों विचलन सकारात्मक होते हैं या दोनों नकारात्मक, तो उनका गुणनफल सकारात्मक होता है, जो सकारात्मक सहसंबंध में योगदान देता है। जब एक विचलन सकारात्मक और दूसरा नकारात्मक हो, तो उनका गुणनफल नकारात्मक होता है, जो नकारात्मक सहसंबंध में योगदान देता है।
गणना के पीछे का तर्क सरल है:
यह संरचना पीयर्सन सहसंबंध गुणांक को इस योग्य बनाती है कि वह दो चरों के बीच रैखिक संबंध की ताकत का एक मानकीकृत माप दे, चाहे उनकी मूल इकाइयाँ या पैमाने कुछ भी हों।
आइए एक छोटा उदाहरण साथ में देखते हैं। मान लें कि हम छात्रों के एक समूह के लिए पढ़ाई के घंटों और परीक्षा अंकों के बीच संबंध की जाँच करना चाहते हैं। नीचे हमारे पास पाँच छात्रों के लिए एक छोटा डेटासेट है।
|
छात्र |
पढ़ाई के घंटे (X) |
परीक्षा अंक (Y) |
|
Luther |
5 |
72 |
|
Alexandra |
2 |
70 |
|
Javier |
3 |
63 |
|
Jamie |
1 |
58 |
|
Auburn |
4 |
73 |
पहला कदम हमेशा अपने डेटा का प्लॉट बनाना होता है। तो आइए नीचे ऐसा ही करते हैं।
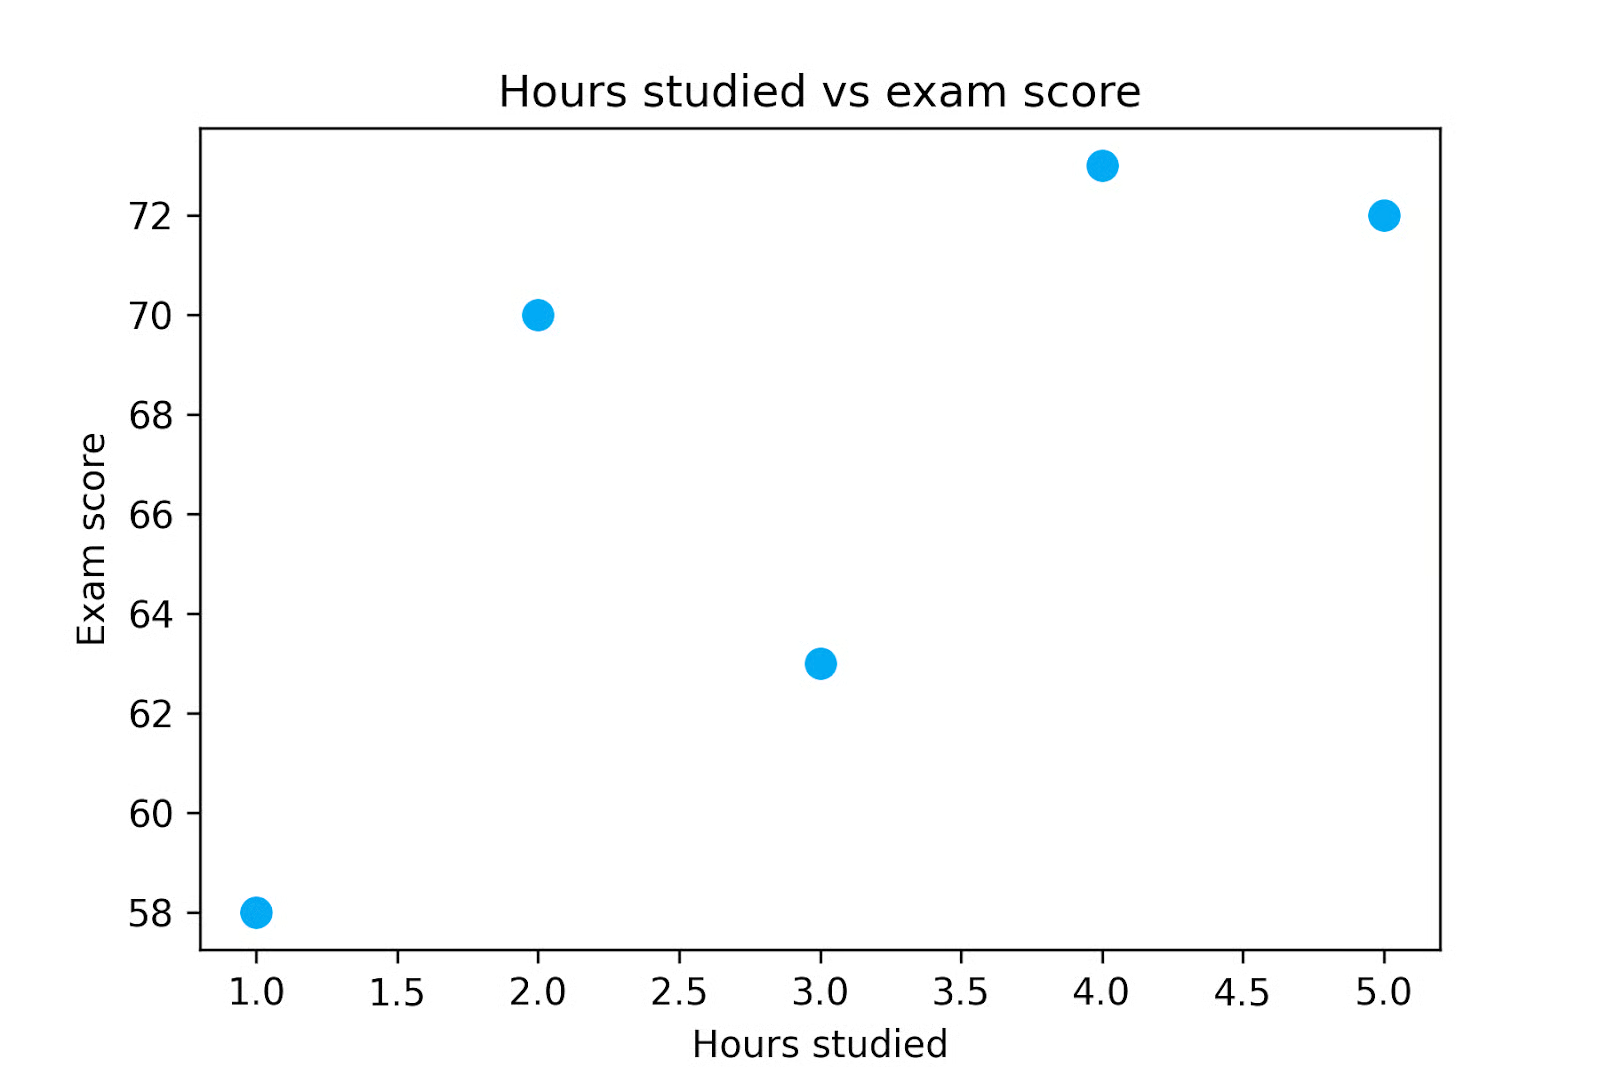
जब हम डेटा का प्लॉट बनाते हैं, तो हम देखते हैं कि जैसे-जैसे अध्ययन समय बढ़ता है, परीक्षा अंक बढ़ने की प्रवृत्ति रखते हैं, लेकिन हम इस संबंध को परिमाणित करना चाहेंगे। तो आइए इस डेटासेट के लिए पीयर्सन सहसंबंध गुणांक की गणना करें।
पहले, हमें प्रत्येक चर का औसत निकालना होगा। इस उदाहरण में, पढ़ाई के घंटों का औसत 3 है, और परीक्षा अंकों का औसत 67.2 है।
अगला, हम गणना करते हैं कि प्रत्येक प्रेक्षण अपने औसत से कितना दूर है। इन मानों को औसत से विचलन कहा जाता है।
फिर, हम विचलनों का गुणन करते हैं ताकि दिखा सकें कि प्रत्येक प्रेक्षण पर चर एक साथ कैसे चलते हैं। जब दोनों विचलनों का संकेत समान होता है, तो उनका गुणनफल सकारात्मक होता है, जो सकारात्मक सहसंबंध में योगदान देता है। जब विचलनों के संकेत विपरीत होते हैं, तो गुणनफल नकारात्मक होता है और नकारात्मक सहसंबंध में योगदान देता है।
|
X |
Y |
X − X̄ |
Y − Ȳ |
(X − X̄)(Y − Ȳ) |
|
1 |
58 |
-2 |
-9.2 |
18.4 |
|
2 |
70 |
-1 |
2.8 |
-2.8 |
|
3 |
63 |
0 |
-4.2 |
0 |
|
4 |
73 |
1 |
5.8 |
5.8 |
|
5 |
72 |
2 |
4.8 |
9.6 |
जब हम अंतिम स्तंभ में प्रोडक्ट्स का योग करते हैं तो 31 प्राप्त होता है, जो पीयर्सन सहसंबंध की गणना में हमारा अंश (न्यूमेरेटर) है।
इसके बाद, हम प्रत्येक चर की परिवर्तनशीलता उनके मानक विचलनों से गणना करते हैं। ऐसा करने के लिए, हम स्तंभ 3 और 4 में दिए गए विचलनों का वर्ग करते हैं और फिर उन्हें जोड़ते हैं।
X के लिए:
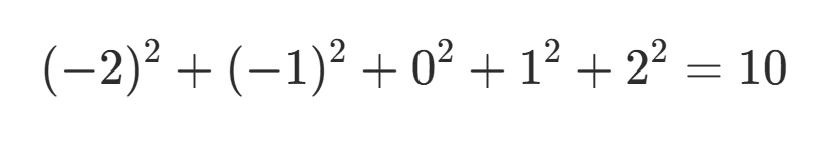
Y के लिए:
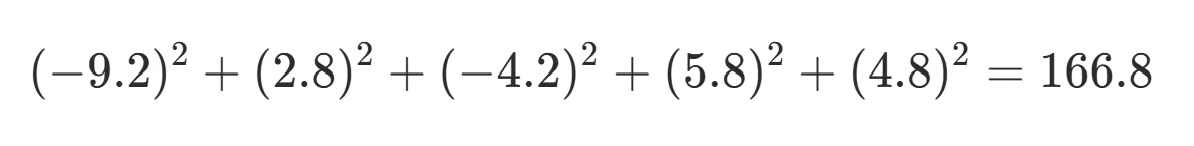
फिर हम प्रत्येक योग का वर्गमूल लेते हैं:
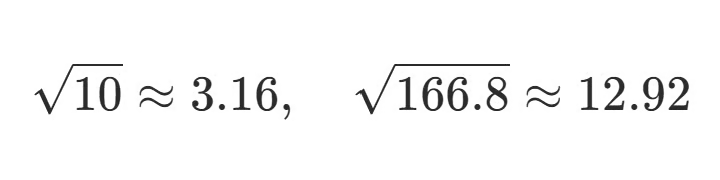
अंत में, हम अंश को मानक विचलनों के गुणनफल से भाग देते हैं:
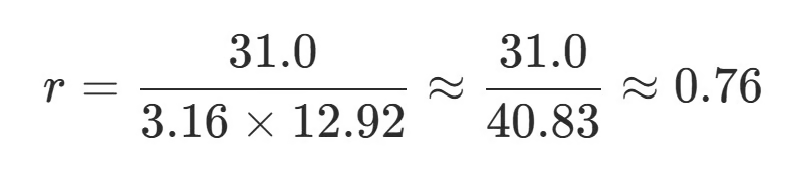
यह अंतिम चरण हमें हमारा पीयर्सन सहसंबंध गुणांक देता है, जो इस मामले में लगभग 0.76 है, जो एक मजबूत सकारात्मक रैखिक संबंध को दर्शाता है। हम इससे निष्कर्ष निकाल सकते हैं कि छात्र द्वारा पढ़ाई किए गए घंटों की संख्या उनके टेस्ट अंकों के साथ मजबूत और सकारात्मक रूप से सहसंबद्ध है।
हालाँकि, हम यह निष्कर्ष नहीं निकाल सकते कि पढ़ाई के घंटों ने उनके टेस्ट अंकों का कारण बना। ऐसा निष्कर्ष निकालने के लिए हमें अतिरिक्त विश्लेषण या एक प्रायोगिक अध्ययन की आवश्यकता होगी।
आप ऊपर के सरल उदाहरण से देख सकते हैं कि पीयर्सन सहसंबंध गुणांक को हाथ से निकालना व्यावहारिक नहीं है।
सौभाग्य से, अधिकांश सांख्यिकीय सॉफ्टवेयर में इसे गणना करने के लिए बिल्ट-इन फ़ंक्शन होते हैं। गणना की यांत्रिकी को समझना अंतर्दृष्टि के लिए सहायक है, लेकिन वास्तविक वर्कफ़्लो में गुणांक आमतौर पर स्वतः गणना हो जाता है। आइए संक्षेप में देखें कि Excel, Python और R जैसे तीन सामान्य टूल में पीयर्सन सहसंबंध गुणांक कैसे निकाला जाता है।
Excel में, पीयर्सन सहसंबंध गुणांक को CORREL() फ़ंक्शन से आसानी से निकाला जा सकता है। यह फ़ंक्शन दो रेंज लेता है जो रुचिकर चरों के मानों का प्रतिनिधित्व करते हैं और उनका सहसंबंध गुणांक लौटाता है।
=CORREL(A1:A10, B1:B10)यह फ़ंक्शन चयनित रेंज से सीधे पीयर्सन का r निकालता है, जो स्प्रेडशीट में चरों के बीच संबंधों का शीघ्र अन्वेषण करने का तरीका है।
Python में, पीयर्सन सहसंबंध गुणांक आमतौर पर pandas या SciPy लाइब्रेरी से निकाला जाता है। corr() मेथड pandas में DataFrame के कॉलमों के बीच सहसंबंध निकालती है:
import pandas as pd

pearson_df['hours_studied'].corr(pearson_df['exam_score'])
वैकल्पिक रूप से, SciPy के statistics मॉड्यूल का pearsonr() फ़ंक्शन सहसंबंध गुणांक और परिकल्पना परीक्षण के लिए p-value दोनों लौटाता है:
from scipy.stats import pearsonr

pearsonr(pearson_df['hours_studied'], pearson_df['exam_score'])
यदि आप Python-आधारित डेटा विश्लेषण में नए हैं, तो आप हमारे pandas ट्यूटोरियल में टेबुलर डेटासेट के साथ काम करने के बारे में और जान सकते हैं।
R में, पीयर्सन सहसंबंध गुणांक cor() फ़ंक्शन से निकाला जा सकता है:
cor(x, y)डिफ़ॉल्ट रूप से, यह फ़ंक्शन पीयर्सन सहसंबंध गुणांक की गणना करता है, हालाँकि आप चाहें तो अन्य सहसंबंध विधियाँ भी निर्दिष्ट कर सकते हैं।
ये तीनों टूल पीयर्सन सहसंबंध गुणांक को शीघ्रता से निकालना आसान बनाते हैं। दरअसल, यह इतना आसान है कि विश्लेषक अक्सर एक कोरिलेशन मैट्रिक्स बनाते हैं, जो एक साथ कई चरों के बीच युग्मित सहसंबंध दिखाती है। यह ऐसे पैटर्न और संबंधों की पहचान में मदद करता है जो विश्लेषण के अगले चरणों में आगे जाँच के योग्य हो सकते हैं।
पीयर्सन सहसंबंध गुणांक की गणना करना एक बात है, लेकिन इसकी व्याख्या कैसे करें? याद रखें कि गुणांक r दो चरों के बीच रैखिक संबंध की दिशा और शक्ति दोनों का वर्णन करता है।
r का चिह्न संबंध की दिशा बताता है। सकारात्मक मान का अर्थ है कि चर साथ-साथ बढ़ने की प्रवृत्ति रखते हैं, जबकि नकारात्मक मान दर्शाता है कि एक चर बढ़ता है तो दूसरा घटने की प्रवृत्ति रखता है।
r का परिमाण रैखिक संबद्धता की शक्ति का वर्णन करता है; 1 के निकट मान 0 के निकट मानों की तुलना में अधिक मजबूत होते हैं। विभिन्न क्षेत्रों में मजबूत संबंध की व्याख्या के अलग-अलग रिवाज हो सकते हैं। अत्यधिक नियंत्रित प्रायोगिक परिवेशों में, जैसे भौतिकी या इंजीनियरिंग के कुछ क्षेत्र, मजबूत सहसंबंध 1 के निकट हो सकते हैं। जबकि जटिल जैविक या सामाजिक प्रणालियों से जुड़े क्षेत्रों में, जैसे चिकित्सा, सार्वजनिक स्वास्थ्य, अर्थशास्त्र या मनोविज्ञान, 0.1 से 0.4 की सीमा के सहसंबंध भी सार्थक हो सकते हैं, खासकर जब चर को मापना कठिन हो या प्रभाव बड़े पैमाने पर संचित होते हों। क्योंकि मानक विधाएँ अनुशासन के अनुसार भिन्न होती हैं, r की व्याख्या के लिए डोमेन ज्ञान और संदर्भगत निर्णय आवश्यक होता है।
यह भी ध्यान देने योग्य है कि पीयर्सन सहसंबंध चरम मानों के प्रति संवेदनशील होता है। एक मात्र आउटलायर r के मान को काफी बढ़ा या घटा सकता है। यही कारण है कि अपने डेटा का प्लॉट बनाना इतना महत्वपूर्ण है। सहसंबंध गुणांकों के साथ स्कैटर प्लॉट्स की जाँच करने से ऐसे आउटलायर्स की पहचान में मदद मिलती है जो अनुपातहीन प्रभाव डाल सकते हैं।
सांख्यिकीय सॉफ्टवेयर अक्सर आपके पीयर्सन सहसंबंध गुणांक के साथ p-value भी देता है। यह p-value यह परीक्षण करता है कि यदि चरों के बीच वास्तव में कोई संबंध न हो तो आपके डेटा में कम से कम इतना मजबूत सहसंबंध देखे जाने की कितनी संभावना है। यदि केवल संयोग से ऐसा होना असंभाव्य है, तो हम कहते हैं कि संबंध सांख्यिकीय रूप से महत्वपूर्ण है।
यह p-value, पीयर्सन सहसंबंध गुणांक को t-सांख्यक में बदलकर और उसे t-वितरण से तुलना करके निकाला जाता है। यह Student के t-परीक्षण के समान है, लेकिन यहाँ लक्ष्य यह जाँचना है कि क्या वास्तविक सहसंबंध शून्य है।
बड़े डेटासेट के साथ, अपेक्षाकृत छोटा r मान भी सांख्यिकीय रूप से महत्वपूर्ण हो सकता है, यद्यपि वह व्यक्तिगत स्तर पर अभी भी कमजोर संबंध हो सकता है। यह सार्वजनिक स्वास्थ्य के लिए महत्वपूर्ण है, उदाहरण के लिए, जहाँ कमजोर संबंध भी जनसंख्या स्तर पर महत्वपूर्ण स्वास्थ्य प्रभाव डाल सकता है। इसी कारण, सहसंबंध के परिमाण (r) और उसकी सांख्यिकीय महत्वता (p-value) में भेद करना उपयोगी रहता है।
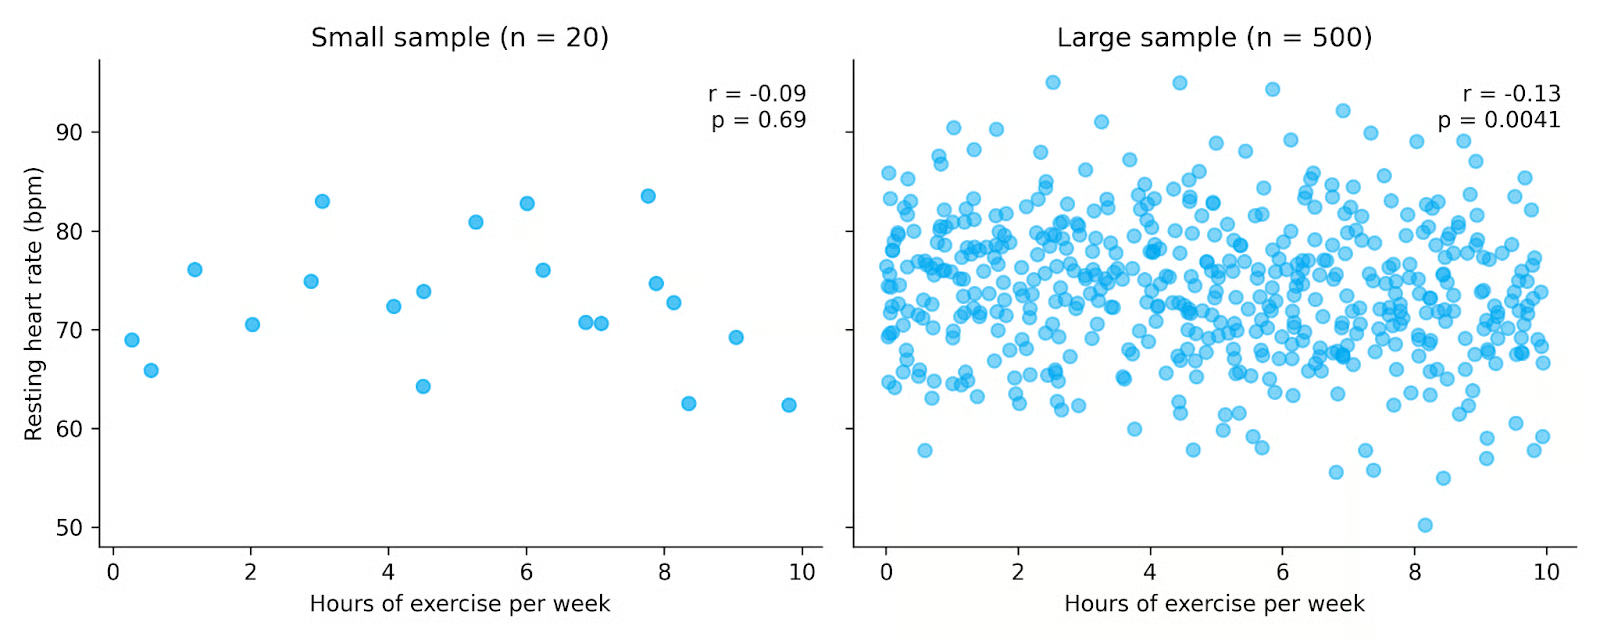
ऊपर के प्लॉट्स में, दोनों डेटासेट व्यायाम और रेस्टिंग हार्ट रेट के बीच एक कमजोर नकारात्मक संबंध दिखाते हैं। लेकिन दाएँ वाला डेटासेट बहुत अधिक प्रेक्षण रखता है, जिससे संबंध सांख्यिकीय रूप से महत्वपूर्ण हो जाता है, हालांकि सहसंबंध छोटा ही रहता है। यह दर्शाता है कि बड़े सैंपल साइज़ हमारी संबंधों को पहचानने की क्षमता बढ़ाते हैं, और परिणामों की व्याख्या करते समय r के मान और p-value दोनों पर विचार करना क्यों महत्वपूर्ण है।
पीयर्सन सहसंबंध गुणांक व्यापक रूप से उपयोग होता है क्योंकि इसे निकालना और समझना सरल है। हालांकि, कई सांख्यिकीय उपकरणों की तरह, यह तब सबसे अच्छा काम करता है जब डेटा के बारे में कुछ मान्यताएँ उचित रूप से संतुष्ट हों।
पहले, पीयर्सन सहसंबंध दो चरों के बीच रैखिक संबंध मानता है। यदि वास्तविक संबंध कोई वक्राकार या गैर-रैखिक पैटर्न का अनुसरण करता है, तो गुणांक संबद्धता की शक्ति को कम करके आँक सकता है या यहाँ तक कि कोई संबंध नहीं होने का संकेत दे सकता है।
एक अन्य मान्यता यह है कि जिन चरों का विश्लेषण किया जा रहा है वे सतत हों। पीयर्सन सहसंबंध को सतत संख्यात्मक पैमानों पर मापे गए चरों के लिए बनाया गया है, जैसे कद, आय, तापमान या परीक्षा अंक। यदि आपके पास क्रमिक (ordinal) या असतत डेटा है, तो स्पीयरमैन सहसंबंध या केंडल का टाउ उपयोग करना बेहतर हो सकता है।
आम तौर पर आप चाहेंगे कि आपका डेटा सामान्य (नॉर्मल) वितरण का अनुसरण करे। यह विशेष रूप से महत्वपूर्ण है यदि आप परिकल्पना परीक्षण कर रहे हैं या सहसंबंध गुणांक के लिए कॉन्फिडेंस इंटरवल निकाल रहे हैं। यदि वितरण अत्यंत गैर-सामान्य हैं, तो अनुमानित सहसंबंध नमूना संबंध का वर्णन तो कर सकता है, लेकिन आपको मिलने वाला p मान संभवतः कम विश्वसनीय होगा।
पीयर्सन सहसंबंध होमोस्केडैसिटी भी मानता है, अर्थात एक चर की परिवर्तनशीलता दूसरे चर की श्रेणी में अपेक्षाकृत सुसंगत हो। व्यावहारिक रूप से, इसका मतलब है कि स्कैटर प्लॉट में बिंदुओं का फैलाव, मानों के बढ़ने-घटने के साथ, लगभग समान रहना चाहिए। जब डेटा की पूरी श्रेणी में फैलाव काफी बदलता है, तो सहसंबंध गुणांक संबंध की संरचना को पूरी तरह से नहीं पकड़ पाता। सामान्यता की तरह, यदि आप इस मान्यता को तोड़ते हैं तब भी r निकाला जा सकता है, लेकिन बाद के अनुमानात्मक परीक्षण कम विश्वसनीय होंगे।
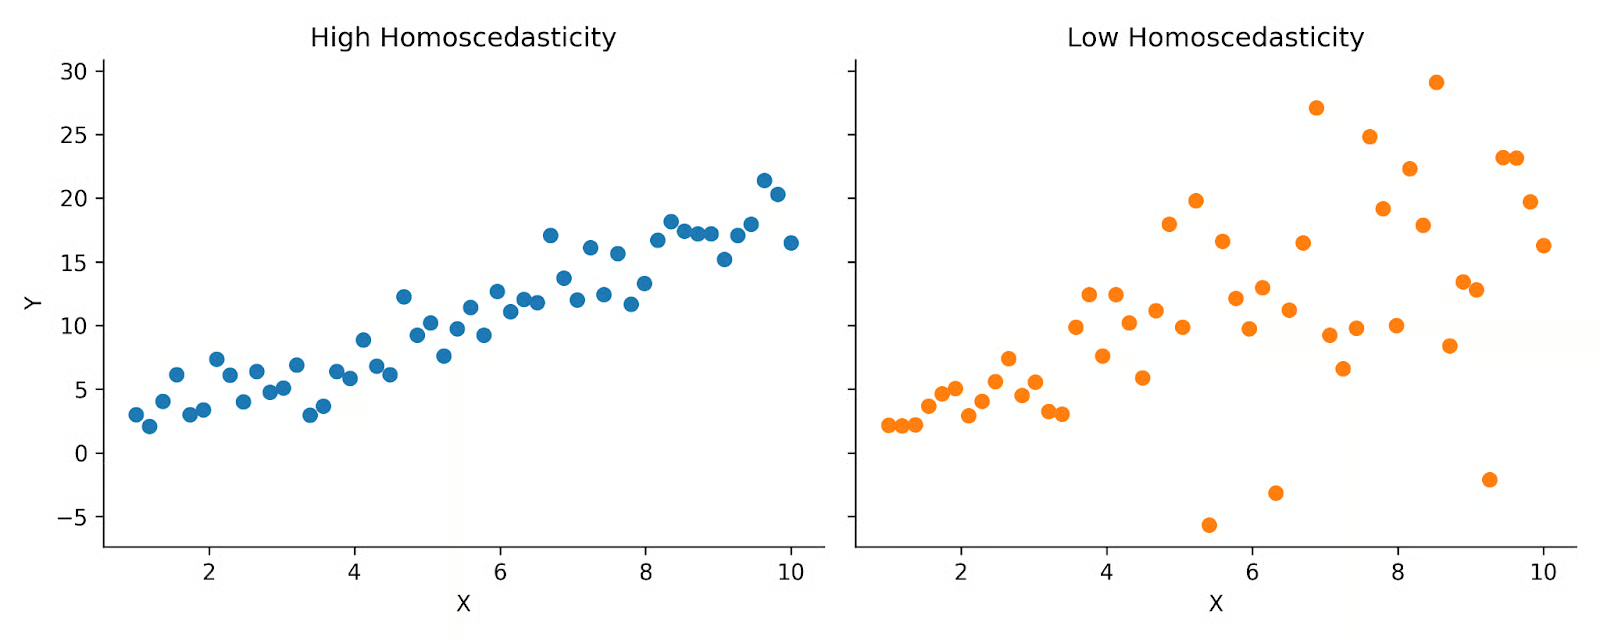
ऊपर आप उच्च बनाम निम्न होमोस्केडैसिटी दर्शाने वाले दो प्लॉट्स देख सकते हैं। बाएँ, डेटा पूरे वितरण में काफ़ी समान रूप से फैला है। लेकिन दाएँ, आप अधिक शंकु आकार देखते हैं। पीयर्सन सहसंबंध मानता है कि आपका डेटा बाएँ वाले प्लॉट जैसा दिखे।
अंत में, जैसा कि हमने पहले चर्चा की, पीयर्सन सहसंबंध आउटलायर्स के प्रति संवेदनशील है। क्योंकि गुणांक औसत और मानक विचलन पर आधारित है, चरम मान गणना को अनुपातहीन रूप से प्रभावित कर सकते हैं। एक मात्र असामान्य डेटा बिंदु सहसंबंध को काफ़ी बढ़ा या घटा सकता है।
पीयर्सन सहसंबंध और स्पीयरमैन सहसंबंध सुनने में बहुत समान लगते हैं और आसानी से भ्रमित हो सकते हैं। दोनों ही दो चरों के बीच संबंध का मापक हैं, लेकिन वे जिस प्रकार के संबंध को पकड़ते हैं और जिन मान्यताओं पर आधारित हैं, उनमें अंतर है।
पीयर्सन सहसंबंध गुणांक दो सतत चरों के बीच रैखिक संबंध की शक्ति को मापता है। इसके विपरीत, स्पीयरमैन सहसंबंध गुणांक मोनोटोनिक संबंध की शक्ति मापता है, अर्थात चर एक ही दिशा में चलते हैं लेकिन आवश्यक नहीं कि एक स्थिर दर से। जब तक संबंध लगातार बढ़ता या घटता रहे, मोनोटोनिक संबंध रैखिक या गैर-रैखिक हो सकता है।
स्पीयरमैन सहसंबंध कच्चे मानों के बजाय डेटा के रैंक किए गए मानों का उपयोग करके निकाला जाता है। डेटा को रैंकों में बदलकर, स्पीयरमैन सहसंबंध आउटलायर्स के प्रभाव को कम करता है और रैखिकता की मान्यता की आवश्यकता नहीं होती।
पीयर्सन सहसंबंध को पैरामीट्रिक मापक माना जाता है क्योंकि यह डेटा वितरण के बारे में मान्यताओं पर निर्भर करता है। वहीं स्पीयरमैन सहसंबंध अपरिमित (नॉनपैरामीट्रिक) माना जाता है, क्योंकि इसे वही वितरणात्मक मान्यताएँ आवश्यक नहीं होतीं और यह सामान्यता पर कम निर्भर होता है।
जब पीयर्सन सहसंबंध की मान्यताएँ पूरी होती हैं, तो यह स्पीयरमैन सहसंबंध की तुलना में वास्तविक रैखिक संबद्धता का अधिक सटीक आकलन दे सकता है। हालाँकि, जब हमारा डेटा इन मानकों को पूरा नहीं करता, तो स्पीयरमैन सहसंबंध तब भी दो चरों के बीच संबंध को पकड़ सकता है।
|
सहसंबंध गुणांक |
कब उपयोग करें |
|
पीयर्सन सहसंबंध |
रैखिक संबंध; सतत चर; सुव्यवस्थित डेटा |
|
स्पीयरमैन सहसंबंध |
मोनोटोनिक संबंध; आउटलायर्स की उपस्थिति; क्रमिक या रैंक किया गया डेटा |
कोवेरिएंस एक निकट से संबंधित अवधारणा है, लेकिन यह स्केलिंग और व्याख्या में भिन्न है।
कोवेरिएंस मापता है कि क्या दो चर एक ही दिशा में चलने की या विपरीत दिशा में चलने की प्रवृत्ति रखते हैं। यदि चर साथ-साथ बढ़ते हैं, तो कोवेरिएंस सकारात्मक होता है। यदि एक बढ़ता है जबकि दूसरा घटता है, तो कोवेरिएंस नकारात्मक होता है।
हालाँकि, कोवेरिएंस का परिमाण चरों की इकाइयों पर निर्भर करता है। उदाहरण के लिए, सेंटीमीटर में मापी ऊँचाई और किलोग्राम में मापा वज़न के बीच कोवेरिएंस, इंच में मापी ऊँचाई और पाउंड में मापे वज़न के बीच कोवेरिएंस से संख्यात्मक रूप से भिन्न होगा। इससे अलग-अलग डेटासेट्स में कोवेरिएंस की तुलना करना कठिन हो जाता है।
पीयर्सन सहसंबंध गुणांक इस सीमा को इस प्रकार संबोधित करता है कि कोवेरिएंस को दोनों चरों के मानक विचलनों के गुणनफल से भाग देता है। इस सामान्यीकरण के कारण, पीयर्सन सहसंबंध इकाई-रहित होता है और हमेशा −1 और +1 के बीच रहता है। यह सीमित परास इसकी व्याख्या को बहुत आसान बनाता है।
सरल शब्दों में:
यद्यपि पीयर्सन सहसंबंध गुणांक व्यापक रूप से उपयोग होता है और समझने में सरल है, इसकी कुछ महत्वपूर्ण सीमाएँ हैं।
पीयर्सन सहसंबंध का उपयोग व्यापक अन्वेषणात्मक और विश्लेषणात्मक वर्कफ़्लो के हिस्से के रूप में सबसे अच्छा होता है। अपने डेटा का विज़ुअलाइज़ेशन करें, सुनिश्चित करें कि सभी मान्यताएँ पूरी हों, और पीयर्सन सहसंबंध गुणांक का उपयोग और व्याख्या करते समय अपनी समस्या के संदर्भ पर विचार करें।
पीयर्सन सहसंबंध गुणांक एक बुनियादी सांख्यिकीय मापक है जिसका उपयोग अनेक विधाओं में किया जाता है। यदि आप जानना चाहते हैं कि सहसंबंध वास्तविक दुनिया के वर्कफ़्लो में कैसे फिट बैठता है, तो हमारे Python में अन्वेषणात्मक डेटा विश्लेषण पर ट्यूटोरियल देखें। यदि आप व्यवहार में सहसंबंध का अन्वेषण करना चाहते हैं, तो हमारे pandas ट्यूटोरियल देखें, जिसमें दिखाया गया है कि वास्तविक डेटासेट्स में सहसंबंध कैसे उपयोग किए जाते हैं।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स