50 % de descuento en DataCamp Premium. Más de 700 cursos a mitad de precio. Empieza a aprender hoy.
Imagina que estás revisando datos de tu empresa y notas que, a medida que aumentas la inversión en publicidad, los ingresos también parecen subir. Antes de tomar decisiones, querrás cuantificar la fuerza de esa relación.
El coeficiente de correlación de Pearson es el método de referencia para cuantificar esa relación. Se usa en multitud de disciplinas, como ciencia de datos, economía, psicología y biología. De hecho, durante el análisis exploratorio de datos, los analistas calculan correlaciones para detectar patrones antes de aplicar otras técnicas.
Antes de ver fórmulas o cálculos, ayuda construir una comprensión intuitiva de lo que describe la correlación. En pocas palabras, la correlación mide cómo se mueven juntas dos variables. Responde a la pregunta: «Cuando una variable aumenta, ¿qué hace la otra?».
La correlación se centra en patrones de comovimiento, no en valores individuales. Cuando dos variables tienden a aumentar o disminuir a la vez, tienen una relación positiva. Cuando tienden a moverse en direcciones opuestas (una sube mientras la otra baja), la relación es negativa. Y cuando no hay un patrón consistente, puede que no exista relación.
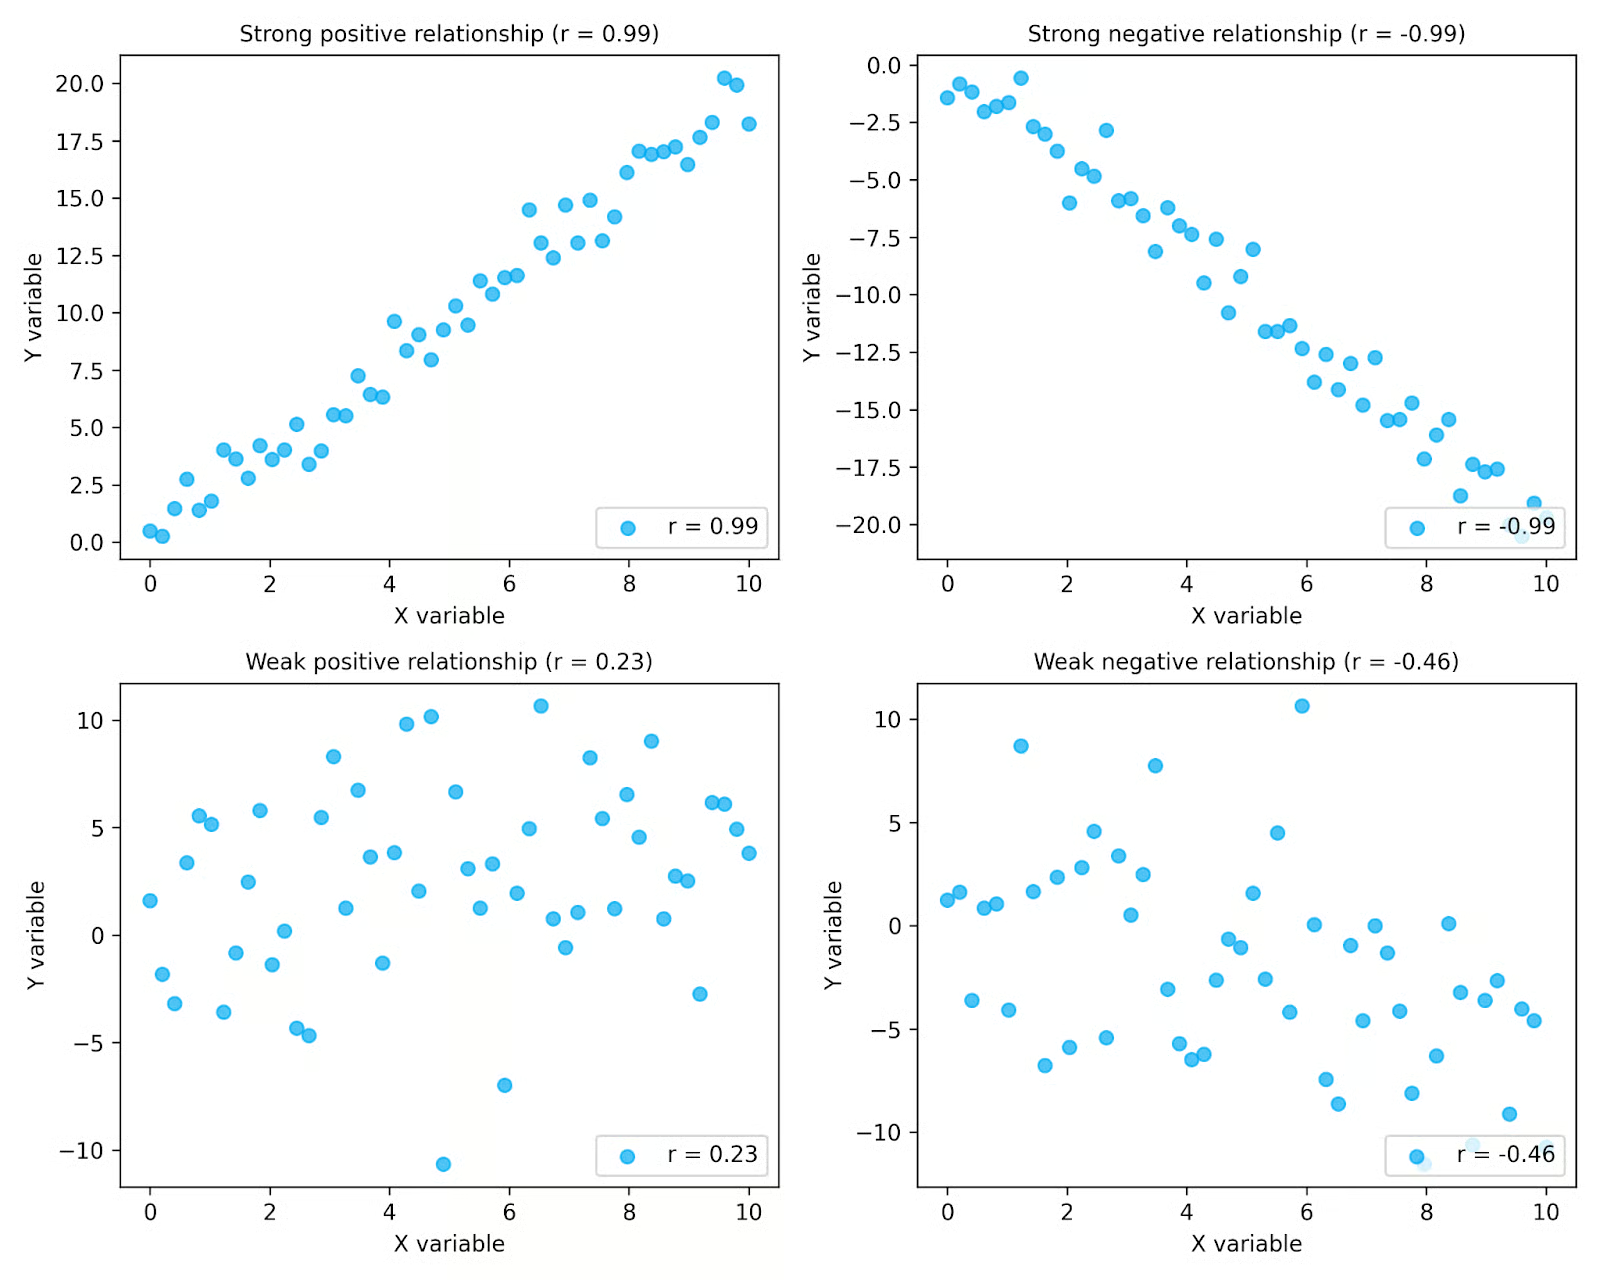
En los gráficos anteriores, puedes ver cómo la correlación captura dirección y fuerza. La fila superior muestra relaciones fuertes, con puntos que siguen un patrón claro; la inferior muestra relaciones más débiles, con mayor dispersión. Los gráficos de la izquierda muestran relaciones positivas (los valores aumentan juntos) y los de la derecha, negativas (una variable disminuye mientras la otra aumenta). Los valores de r resumen estos patrones.
La correlación es especialmente útil en análisis exploratorio de datos, donde se examinan las relaciones entre variables. Representar los datos en gráficos facilita detectar patrones y decidir si una medida como la de Pearson es adecuada.
También es clave recordar que la correlación describe relaciones observadas en los datos, no los mecanismos que las generan. Aunque dos variables estén fuertemente correlacionadas, no significa que una cause el cambio de la otra. La correlación solo resume los patrones existentes. Recuerda el clásico: «correlación no implica causalidad».
El coeficiente de correlación de Pearson mide formalmente la fuerza y la dirección de una relación lineal entre dos variables continuas. Resume cuán de cerca siguen los puntos de un diagrama de dispersión un patrón lineal.
El valor del coeficiente de correlación de Pearson siempre está entre −1 y +1.
|
Valor de r |
Interpretación |
|
+1 |
Relación lineal positiva perfecta |
|
0 |
Sin relación lineal |
|
−1 |
Relación lineal negativa perfecta |
Estos valores cuantifican los patrones comentados en la sección anterior. Cuanto más cerca estén de +1 o −1, más fuerte es la relación lineal; valores cercanos a 0 indican una relación débil. El signo indica si la relación es positiva o negativa.
Un punto clave: la correlación de Pearson mide solo relaciones lineales. Si dos variables siguen un patrón no lineal, el coeficiente puede ser cercano a cero aunque estén claramente relacionadas. Es decir, r = 0 no implica necesariamente ausencia de relación; implica que no hay relación lineal.
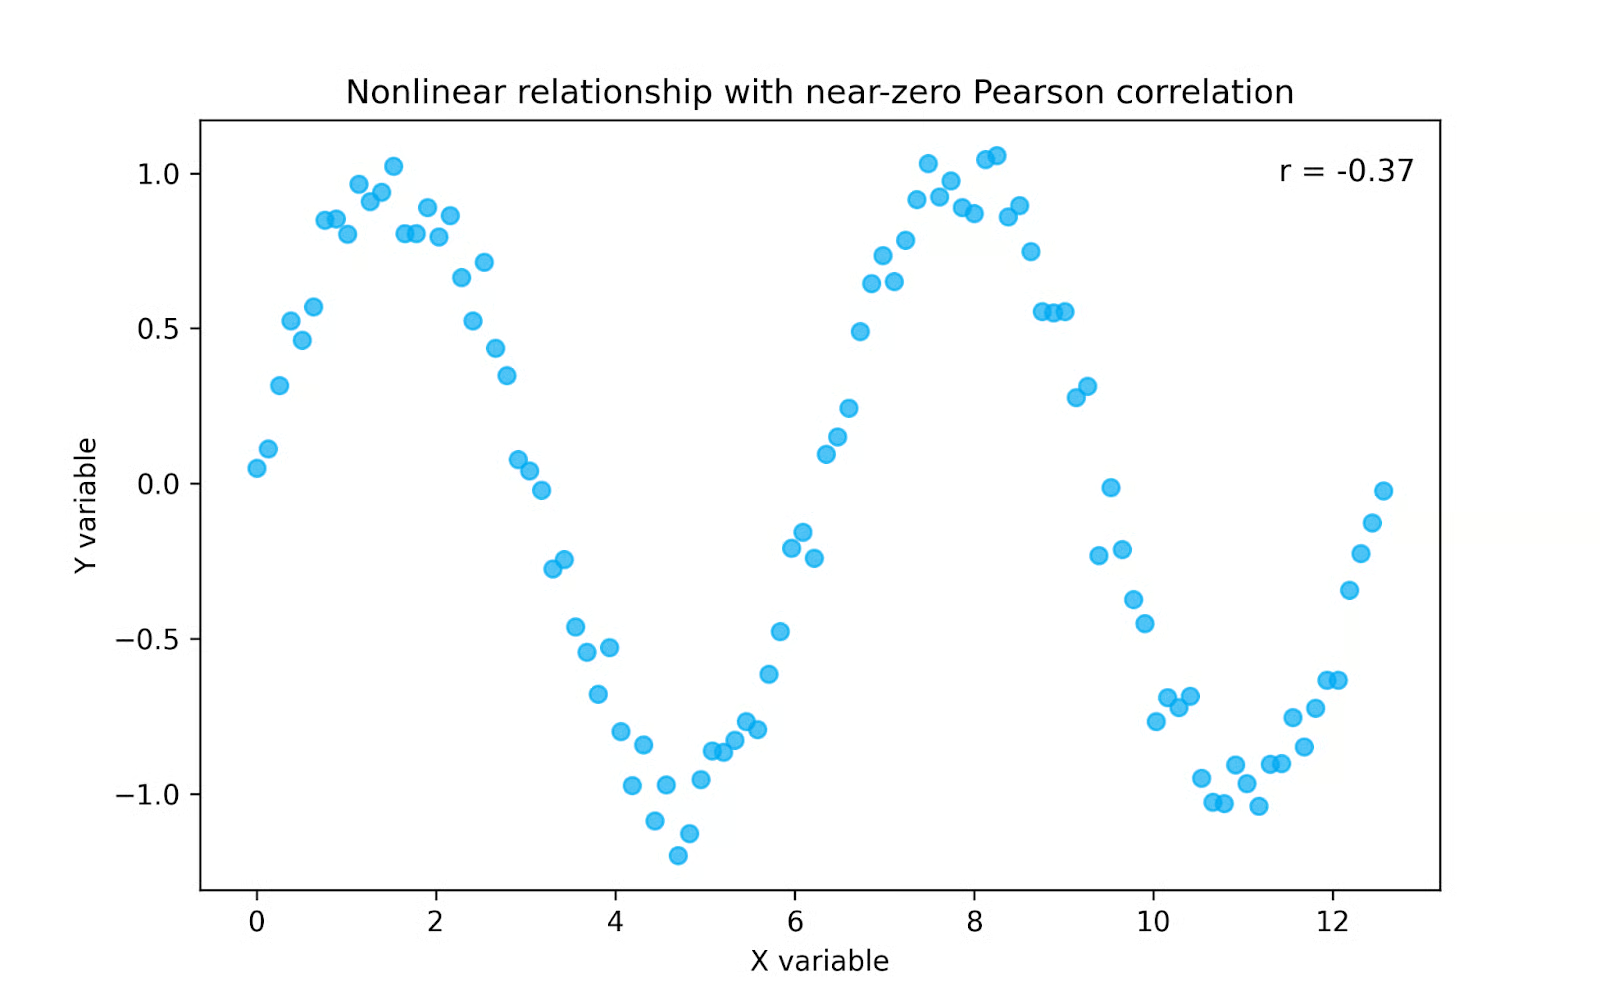
En el gráfico anterior, las variables siguen un patrón claro, pero no lineal. Como Pearson solo mide relaciones lineales, el valor de r es cercano a cero aunque exista una relación fuerte. En casos así, una medida basada en rangos como la correlación de Spearman puede ser más adecuada, ya que capta patrones monótonos no lineales.
El coeficiente de Pearson se calcula con una fórmula que compara cómo cambian dos variables juntas con respecto a cuánto cambian por separado. Habitualmente se escribe así:
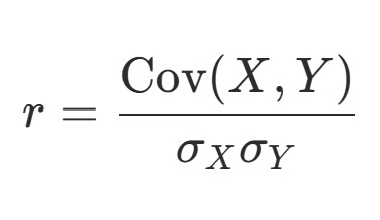
En esta expresión, Cov(X, Y) representa la covarianza entre las dos variables, mientras que σX y σY son las desviaciones estándar de cada una. La covarianza mide si dos variables tienden a aumentar o disminuir juntas, pero su magnitud depende de las unidades. Al dividir por las desviaciones estándar, estandarizamos el resultado y garantizamos que el coeficiente de Pearson siempre esté entre −1 y +1. Para una explicación más amplia sobre correlación y covarianza, echa un vistazo a nuestro tutorial.
La correlación de Pearson es, en esencia, una covarianza estandarizada. Mientras la covarianza indica si las variables se mueven en la misma u opuesta dirección, la correlación escala esa información para interpretar la fuerza de la relación de forma consistente entre distintos conjuntos de datos.
Si alguna vez has hecho este cálculo a mano (¡gracias, clase de estadística!), te sonará esta versión de la fórmula, que explicita mejor los pasos:
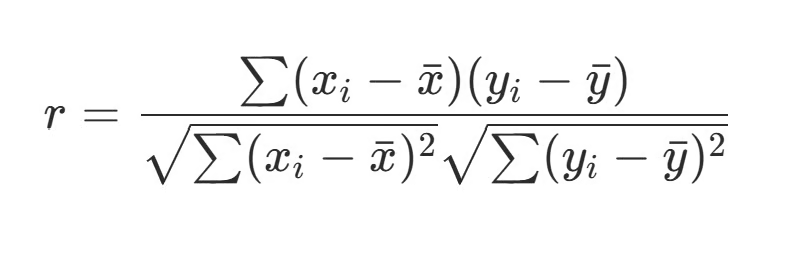
Aquí, cada observación se compara con la media de su variable. Los términos (Xi − X̄) y (Yi − Ȳ) calculan cuánto se aleja cada valor de la media. Al multiplicar estas desviaciones, medimos si las variables se mueven en la misma dirección en cada observación. Cuando ambas desviaciones son positivas o negativas, su producto es positivo y contribuye a una correlación positiva. Cuando una es positiva y la otra negativa, el producto es negativo y contribuye a una correlación negativa.
La lógica subyacente es sencilla:
Gracias a esta estructura, el coeficiente de Pearson ofrece una medida estandarizada de cuán fuerte es la relación lineal entre dos variables, independientemente de sus unidades o escalas originales.
Vamos a recorrer un ejemplo breve. Supongamos que queremos analizar la relación entre horas de estudio y notas de examen en un grupo de estudiantes. A continuación, tenemos un pequeño conjunto de datos de cinco estudiantes.
|
Estudiante |
Horas de estudio (X) |
Nota de examen (Y) |
|
Luther |
5 |
72 |
|
Alexandra |
2 |
70 |
|
Javier |
3 |
63 |
|
Jamie |
1 |
58 |
|
Auburn |
4 |
73 |
El primer paso es siempre representar los datos. Hagámoslo a continuación.
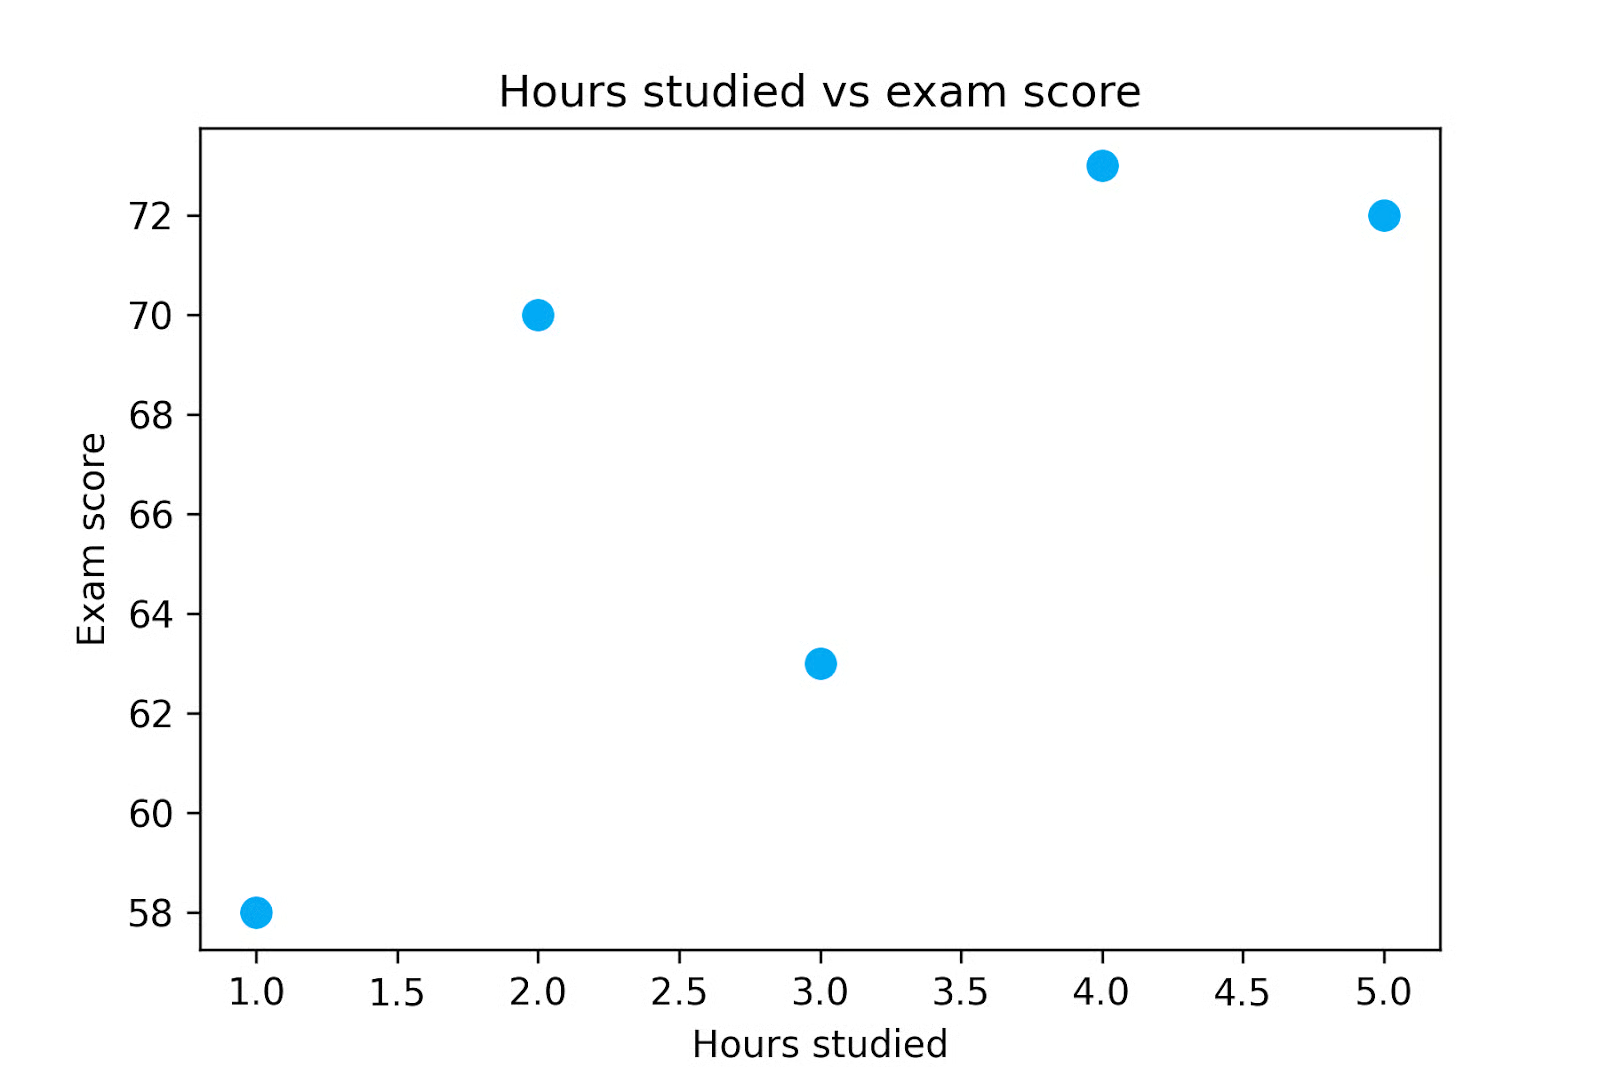
Al graficar los datos, vemos que las notas tienden a aumentar a medida que aumentan las horas de estudio, pero queremos cuantificar esta relación. Así que calculemos el coeficiente de correlación de Pearson para este conjunto.
Primero, calculamos la media de cada variable. En este ejemplo, el promedio de horas de estudio es 3 y la nota media es 67,2.
Después, calculamos cuánto se aleja cada observación de su media. Estos valores son las desviaciones respecto a la media.
Luego, multiplicamos las desviaciones para ver cómo se mueven juntas las variables en cada observación. Cuando ambas desviaciones tienen el mismo signo, su producto es positivo y contribuye a una correlación positiva. Cuando las deviaciones tienen signos opuestos, el producto es negativo y contribuye a una correlación negativa.
|
X |
Y |
X − X̄ |
Y − Ȳ |
(X − X̄)(Y − Ȳ) |
|
1 |
58 |
-2 |
-9.2 |
18.4 |
|
2 |
70 |
-1 |
2.8 |
-2.8 |
|
3 |
63 |
0 |
-4.2 |
0 |
|
4 |
73 |
1 |
5.8 |
5.8 |
|
5 |
72 |
2 |
4.8 |
9.6 |
Al sumar los productos de la última columna obtenemos 31, que es el numerador de nuestro cálculo de la correlación de Pearson.
Después, calculamos la variabilidad de cada variable mediante sus desviaciones estándar. Para ello elevamos al cuadrado las desviaciones de las columnas 3 y 4 antes de sumarlas.
Para X:
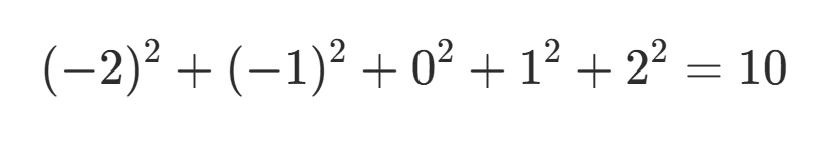
Para Y:
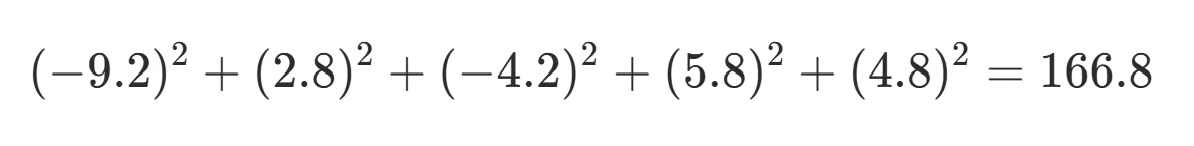
Luego tomamos la raíz cuadrada de cada suma:
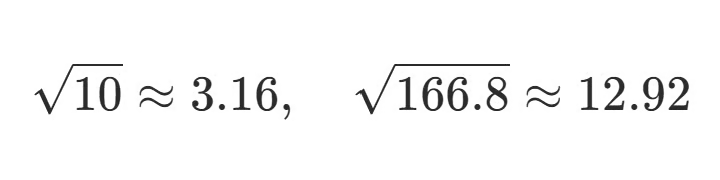
Por último, dividimos el numerador por el producto de las desviaciones estándar:
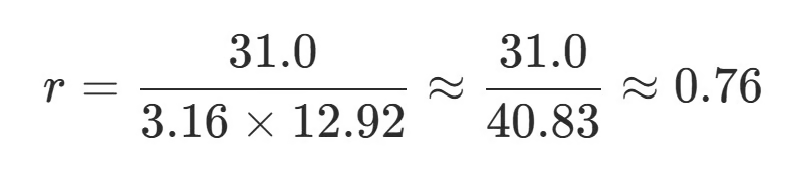
Este paso final nos da el coeficiente de correlación de Pearson, que en este caso es aproximadamente 0,76, lo que indica una relación lineal positiva fuerte. Podemos concluir que el número de horas de estudio se correlaciona de forma positiva y sólida con la nota del examen.
Sin embargo, no podemos afirmar que las horas de estudio causen la nota. Para ello, harían falta análisis adicionales o un estudio experimental.
Como has visto en el ejemplo, calcular a mano el coeficiente de Pearson no es práctico.
Por suerte, la mayoría del software estadístico incluye funciones para obtenerlo. Entender la mecánica ayuda a la intuición, pero en la práctica el coeficiente se calcula automáticamente. Veamos brevemente cómo hacerlo en tres herramientas comunes: Excel, Python y R.
En Excel, el coeficiente de correlación de Pearson se calcula fácilmente con la función CORREL(). Esta función toma dos rangos de valores que representan las variables de interés y devuelve su coeficiente de correlación.
=CORREL(A1:A10, B1:B10)La función calcula directamente r de Pearson a partir de los rangos seleccionados, lo que permite explorar rápidamente relaciones entre variables en hojas de cálculo.
En Python, el coeficiente de Pearson suele calcularse con las librerías pandas o SciPy. El método corr() de pandas calcula correlaciones entre columnas de un DataFrame:
import pandas as pd

pearson_df['hours_studied'].corr(pearson_df['exam_score'])
Alternativamente, la función pearsonr() del módulo de estadística de SciPy devuelve tanto el coeficiente de correlación como un p-valor para contrastes de hipótesis:
from scipy.stats import pearsonr

pearsonr(pearson_df['hours_studied'], pearson_df['exam_score'])
Si estás empezando con el análisis de datos en Python, puedes aprender más sobre cómo trabajar con datos tabulares en nuestro tutorial de pandas.
En R, el coeficiente de Pearson puede calcularse con la función cor():
cor(x, y)Por defecto, esta función calcula la correlación de Pearson, aunque puedes especificar otros métodos si lo deseas.
Estas tres herramientas facilitan calcular rápidamente el coeficiente de Pearson. De hecho, como es tan sencillo, es habitual generar una matriz de correlación, que muestra las correlaciones por pares entre múltiples variables. Esto ayuda a identificar patrones y relaciones que pueden merecer un análisis más profundo.
Una cosa es calcular el coeficiente de Pearson, y otra interpretarlo. Recuerda que r describe tanto la dirección como la fuerza de una relación lineal entre dos variables.
El signo de r indica la dirección de la relación. Un valor positivo significa que las variables tienden a aumentar juntas; un valor negativo indica que una tiende a disminuir cuando la otra aumenta.
La magnitud de r describe la fuerza de la asociación lineal: valores más próximos a 1 son más fuertes que los cercanos a 0. Cada campo tiene sus convenciones sobre qué se considera «fuerte». En entornos muy controlados, como algunas áreas de física o ingeniería, las correlaciones fuertes pueden acercarse a 1. En campos con sistemas biológicos o sociales complejos (medicina, salud pública, economía, psicología), correlaciones entre 0,1 y 0,4 pueden ser relevantes, especialmente cuando las variables son difíciles de medir o los efectos se acumulan a escala. Por eso, interpretar r exige conocimiento del dominio y juicio contextual.
También es importante notar que la correlación de Pearson es sensible a valores extremos. Un solo valor atípico puede aumentar o disminuir notablemente r. Esta es otra razón para graficar los datos: observar diagramas de dispersión junto a los coeficientes ayuda a detectar outliers con influencia excesiva.
El software estadístico suele proporcionar un p-valor junto a tu coeficiente de Pearson. Este p-valor evalúa la probabilidad de observar una correlación al menos tan fuerte como la de tus datos si en realidad no hubiera relación entre las variables. Si es poco probable por azar, decimos que la relación es estadísticamente significativa.
Este p-valor se calcula convirtiendo el coeficiente de Pearson en una estadística t y comparándola con la distribución t. Es similar a una prueba t de Student, pero aquí el objetivo es contrastar si la correlación verdadera es cero.
Con conjuntos de datos grandes, incluso un r pequeño puede ser estadísticamente significativo, aunque la relación sea débil a nivel individual. Esto es relevante en salud pública, por ejemplo, donde una relación débil puede tener un impacto considerable a nivel poblacional. Por ello, conviene distinguir entre la magnitud de la correlación (r) y su significación estadística (p-valor).
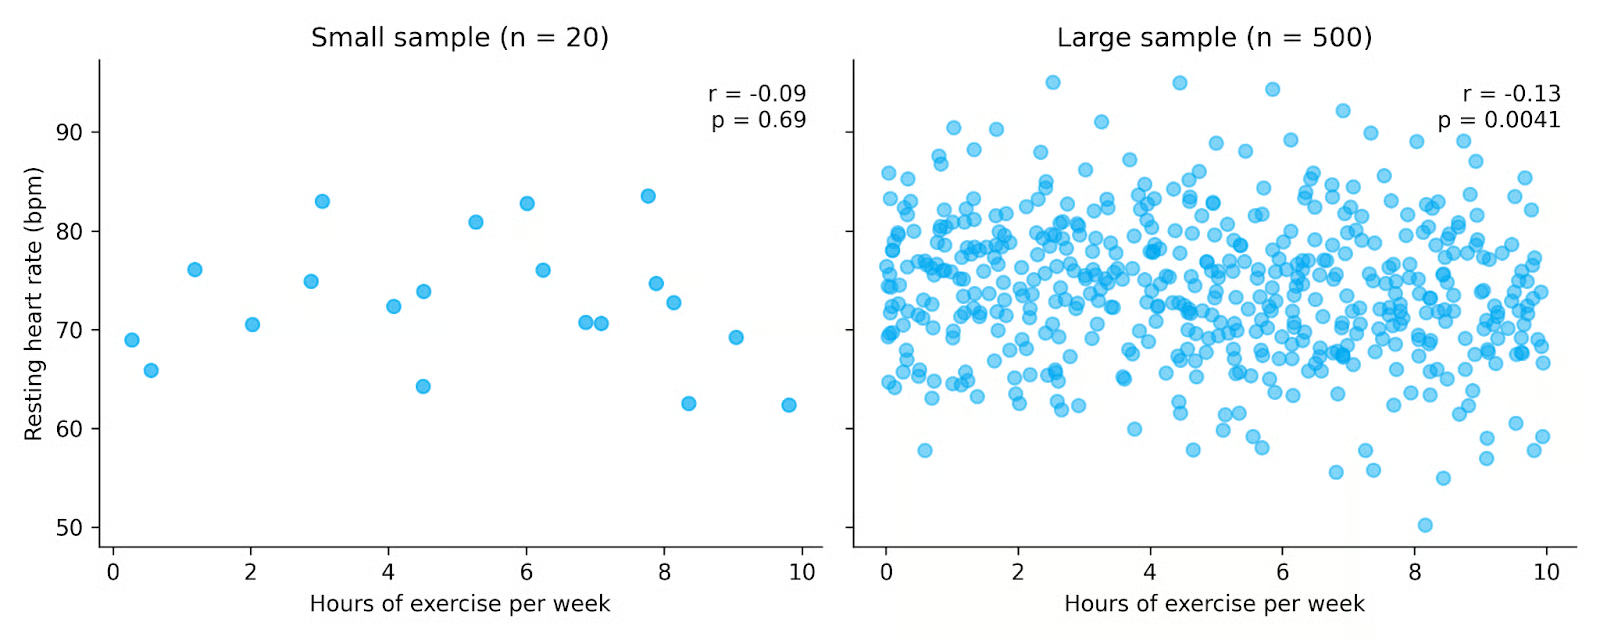
En los gráficos anteriores, ambos conjuntos muestran una relación negativa débil entre ejercicio y frecuencia cardiaca en reposo. No obstante, el de la derecha tiene muchas más observaciones, haciendo la relación estadísticamente significativa aunque la correlación sea pequeña. Esto ilustra cómo un mayor tamaño muestral aumenta la capacidad de detectar relaciones y por qué conviene considerar tanto r como el p-valor al interpretar resultados.
El coeficiente de Pearson es muy usado porque es fácil de calcular e interpretar. Sin embargo, como muchas herramientas estadísticas, funciona mejor cuando se cumplen razonablemente ciertos supuestos.
Primero, asume que la relación entre las dos variables es lineal. Si la relación real es curvada o no lineal, el coeficiente puede infraestimar la fuerza o incluso sugerir que no hay relación.
Otro supuesto es que las variables analizadas sean continuas. Pearson está diseñado para variables medidas en escalas numéricas continuas, como altura, ingresos, temperatura o notas. Si tienes datos ordinales o discretos, quizá te convenga usar correlación de Spearman o tau de Kendall.
Además, en general conviene que los datos sigan una distribución aproximadamente normal. Esto es especialmente importante si realizas contrastes de hipótesis o calculas intervalos de confianza para la correlación. Si las distribuciones son muy no normales, la correlación estimada puede describir la relación muestral, pero el p-valor será menos fiable.
La correlación de Pearson también asume homocedasticidad, es decir, que la variabilidad de una variable es relativamente constante a lo largo del rango de la otra. En términos prácticos, la dispersión de puntos en un diagrama debería ser similar a medida que los valores aumentan o disminuyen. Cuando la dispersión cambia mucho a lo largo del rango, r puede no capturar del todo la estructura de la relación. Como con la normalidad, puedes calcular r aunque se incumpla este supuesto, pero las inferencias posteriores serán menos fiables.
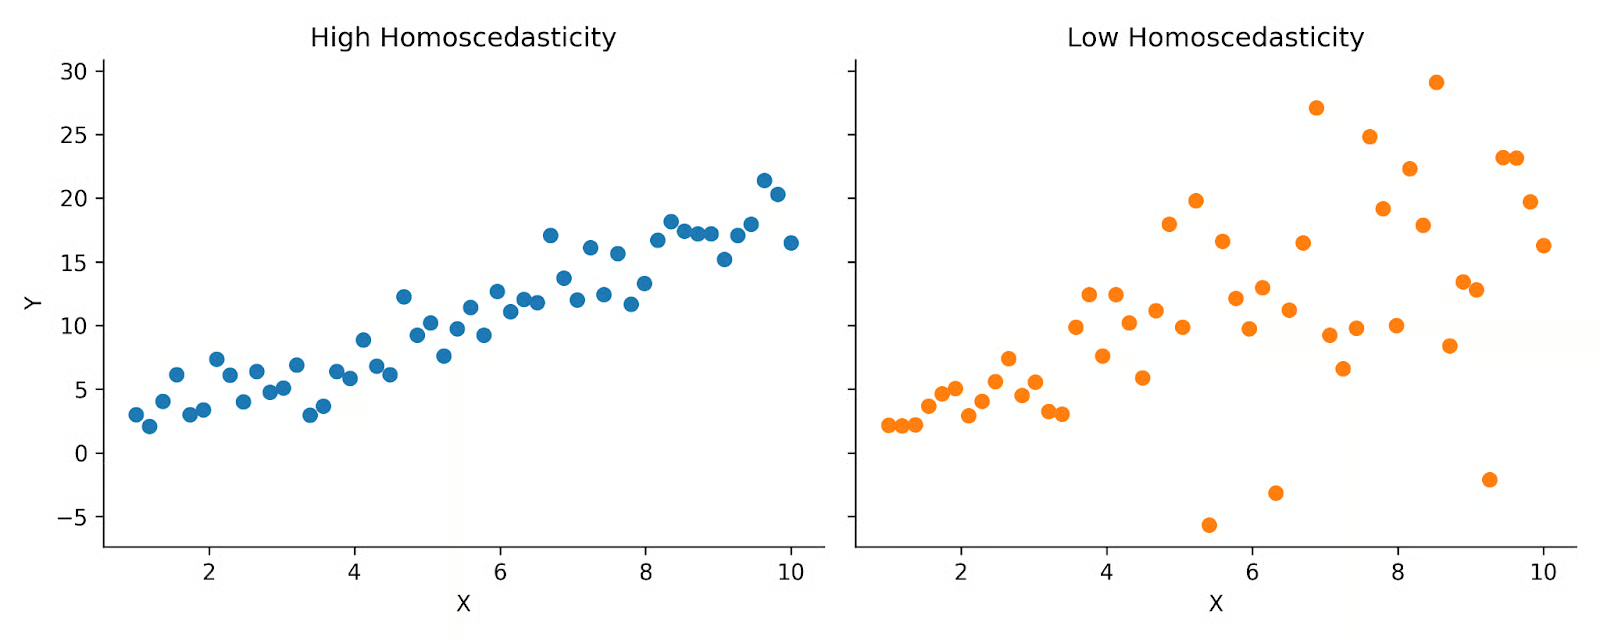
Arriba puedes ver dos gráficos que muestran alta frente a baja homocedasticidad. A la izquierda, los datos se reparten de forma bastante uniforme. A la derecha, se aprecia más una forma de cono. La correlación de Pearson asume que tus datos se parecen más al gráfico de la izquierda.
Por último, como ya comentamos, Pearson es sensible a outliers. Los valores extremos pueden influir de forma desproporcionada porque el coeficiente se basa en medias y desviaciones estándar. Un único dato inusual puede cambiar sustancialmente la correlación.
«Correlación de Pearson» y «de Spearman» suenan parecido y es fácil confundirlas. Ambas miden la relación entre dos variables, pero difieren en el tipo de relación que captan y en los supuestos en que se basan.
El coeficiente de Pearson mide la fuerza de una relación lineal entre dos variables continuas. En cambio, el de Spearman mide la fuerza de una relación monótona: las variables se mueven en la misma dirección, pero no necesariamente a un ritmo constante. Una relación monótona puede ser lineal o no, siempre que aumente o disminuya de forma consistente.
La correlación de Spearman se calcula con los valores ordenados (rangos) en lugar de los valores en bruto. Al convertir a rangos, reduce el impacto de outliers y no requiere el supuesto de linealidad.
Pearson se considera una medida paramétrica porque depende de supuestos sobre la distribución de los datos. Spearman es no paramétrica: no exige esos supuestos y depende menos de la normalidad.
Cuando se cumplen los supuestos de Pearson, puede proporcionar una estimación más precisa de la asociación lineal real que Spearman. Sin embargo, cuando los datos no cumplen esos requisitos, la correlación de Spearman puede seguir detectando relaciones entre variables.
|
Coeficiente de correlación |
Cuándo usarlo |
|
Correlación de Pearson |
Relación lineal; variables continuas; datos bien comportados |
|
Correlación de Spearman |
Relación monótona; presencia de outliers; datos ordinales o por rangos |
La covarianza es un concepto cercano, pero difiere en su escala e interpretación.
La covarianza mide si dos variables tienden a moverse en la misma dirección o en direcciones opuestas. Si aumentan juntas, la covarianza es positiva. Si una aumenta y la otra disminuye, es negativa.
Sin embargo, la magnitud de la covarianza depende de las unidades de las variables. Por ejemplo, la covarianza entre altura en centímetros y peso en kilogramos diferirá numéricamente de la covarianza entre altura en pulgadas y peso en libras. Esto dificulta compararla entre conjuntos de datos.
El coeficiente de Pearson resuelve esta limitación dividiendo la covarianza por el producto de las desviaciones estándar de ambas variables. Gracias a esta normalización, la correlación de Pearson no tiene unidades y siempre está entre −1 y +1. Este rango acotado facilita mucho su interpretación.
En resumen:
Aunque el coeficiente de Pearson está muy extendido y es fácil de interpretar, tiene varias limitaciones importantes.
La correlación de Pearson se usa mejor como parte de un flujo de trabajo exploratorio y analítico más amplio. Visualiza tus datos, comprueba los supuestos y ten en cuenta el contexto al usar e interpretar el coeficiente de Pearson.
El coeficiente de correlación de Pearson es una medida estadística fundamental usada en multitud de disciplinas. Si te interesa cómo encaja la correlación en flujos reales, explora nuestro tutorial de análisis exploratorio de datos en Python. Si quieres practicar la correlación, pásate por nuestro tutorial de pandas para ver cómo se usa en conjuntos de datos reales.
Aprende con DataCamp
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {blog} other {blogs}}
Vinita Silaparasetty
14 min
{count, plural, one {Tutorial} other {Tutoriales}}
Arunn Thevapalan
9 min
{count, plural, one {Tutorial} other {Tutoriales}}
Avinash Navlani
10 min
{count, plural, one {Tutorial} other {Tutoriales}}
Łukasz Deryło
10 min
{count, plural, one {Tutorial} other {Tutoriales}}
Josef Waples
8 min
{count, plural, one {Tutorial} other {Tutoriales}}
Kurtis Pykes
8 min