Lewati ke konten utama

Proximal Policy Optimization dengan PyTorch dan Gymnasium

Pelajari prinsip dasar Proximal Policy Optimization, termasuk implementasinya di PyTorch dengan Gymnasium!
Diperbarui 28 Sep 2026  · 15 mnt Baca

Jelajahi bersama AI

ChatGPTClaudePerplexity

Proximal Policy Optimization (PPO) adalah salah satu algoritma pilihan untuk menyelesaikan masalah Reinforcement Learning (RL). Algoritma ini dikembangkan pada tahun 2017 oleh John Schuman, salah satu pendiri OpenAI. 

PPO telah banyak digunakan di OpenAI untuk melatih model agar meniru perilaku manusia. Algoritma ini menyempurnakan metode sebelumnya seperti Trust Region Policy Optimization (TRPO) dan menjadi populer karena merupakan algoritma yang tangguh dan efisien. 

Dalam tutorial ini, kita mengulas PPO secara mendalam. Kita membahas teori dan menunjukkan cara mengimplementasikannya menggunakan PyTorch.

Memahami Proximal Policy Optimization (PPO)

Algoritma pembelajaran terawasi konvensional memperbarui parameter ke arah gradien paling curam. Jika pembaruan ini ternyata berlebihan, hal itu akan dikoreksi selama contoh pelatihan berikutnya yang saling independen.

Namun, contoh pelatihan dalam reinforcement learning terdiri dari aksi dan return agen. Dengan demikian, contoh pelatihan saling berkorelasi. Agen mengeksplorasi lingkungan untuk mencari tahu kebijakan (policy) yang optimal. Jadi, melakukan perubahan besar pada gradien dapat membuat kebijakan terjebak pada wilayah buruk dengan imbalan (reward) suboptimal. Karena agen perlu mengeksplorasi lingkungan, perubahan kebijakan yang besar membuat proses pelatihan tidak stabil. 

Metode berbasis trust region bertujuan menghindari masalah ini dengan memastikan pembaruan kebijakan berada dalam wilayah tepercaya. Wilayah tepercaya ini adalah wilayah yang dibatasi secara artifisial dalam ruang kebijakan tempat pembaruan diizinkan. Kebijakan yang diperbarui hanya dapat berada dalam wilayah tepercaya dari kebijakan lama. Memastikan pembaruan kebijakan bersifat inkremental mencegah ketidakstabilan.

Trust region policy updates (TRPO)

Algoritma Trust Region Policy Updates (TRPO) diajukan pada tahun 2015 oleh John Schulman (yang juga mengajukan PPO pada tahun 2017). Untuk mengukur perbedaan antara kebijakan lama dan kebijakan yang diperbarui, TRPO menggunakan divergensi Kullback-Leibler (KL). Divergensi KL digunakan untuk mengukur perbedaan antara dua distribusi probabilitas. TRPO terbukti efektif dalam menerapkan trust region. 

Masalah pada TRPO adalah kompleksitas komputasi yang terkait dengan divergensi KL. Penerapan divergensi KL harus diekspansi hingga orde kedua menggunakan metode numerik seperti deret Taylor. Hal ini mahal secara komputasi. PPO diajukan sebagai alternatif yang lebih sederhana dan lebih efisien untuk TRPO. PPO memotong (clip) rasio kebijakan untuk mendekati trust region tanpa perlu perhitungan kompleks yang melibatkan divergensi KL.

Inilah mengapa PPO menjadi lebih disukai daripada TRPO dalam menyelesaikan masalah RL. Berkat metode estimasi trust region yang lebih efisien, PPO secara efektif menyeimbangkan kinerja dan stabilitas. 

Pendekatan kebijakan proksimal (PPO)

PPO sering dianggap sebagai subkelas metode actor-critic, yang memperbarui gradien kebijakan berdasarkan fungsi nilai. Metode Advantage Actor-critic (A2C) menggunakan parameter yang disebut advantage. Ini mengukur selisih antara return yang diprediksi oleh critic dan return yang direalisasikan saat menerapkan kebijakan. 

Untuk memahami PPO, Anda perlu mengetahui komponennya:

  1. Actor mengeksekusi kebijakan. Ini diimplementasikan sebagai jaringan saraf. Diberi sebuah state sebagai input, ia menghasilkan aksi yang harus diambil. 
  2. Critic adalah jaringan saraf lain. Ia menerima state sebagai input dan menghasilkan nilai harapan dari state tersebut. Jadi, critic merepresentasikan fungsi nilai-state. 
  3. Metode berbasis policy gradient dapat memilih menggunakan fungsi objektif yang berbeda. Secara khusus, PPO menggunakan fungsi advantage. Fungsi advantage mengukur seberapa besar reward kumulatif (berdasarkan kebijakan yang diimplementasikan oleh actor) melampaui reward baseline yang diharapkan (sebagaimana diprediksi oleh critic). Tujuan PPO adalah meningkatkan kemungkinan memilih aksi dengan advantage tinggi. Tujuan optimisasi PPO menggunakan fungsi loss berdasarkan fungsi advantage ini. 
  4. Fungsi objektif bertingkat (clipped) adalah inovasi utama dalam PPO. Ini mencegah pembaruan kebijakan yang besar dalam satu iterasi pelatihan. Mekanisme ini membatasi seberapa banyak kebijakan diperbarui dalam satu iterasi. Untuk mengukur pembaruan kebijakan yang inkremental, metode berbasis kebijakan menggunakan rasio probabilitas kebijakan baru terhadap kebijakan lama. 
  5. Surrogate loss adalah fungsi objektif dalam PPO dan mempertimbangkan inovasi yang disebutkan sebelumnya. Perhitungannya sebagai berikut:
    1. Hitung rasio aktual (seperti dijelaskan sebelumnya) dan kalikan dengan advantage. 
    2. Clip rasio agar berada dalam rentang yang diinginkan. Kalikan rasio yang di-clip tersebut dengan advantage. 
    3. Ambil nilai minimum dari kedua besaran di atas. 
  6. Dalam praktiknya, sebuah suku entropi juga ditambahkan ke surrogate loss. Ini disebut entropy bonus. Bonus ini didasarkan pada distribusi matematis dari probabilitas aksi. Gagasan di balik entropy bonus adalah memasukkan sedikit tambahan keacakan secara terkontrol. Hal ini mendorong proses optimisasi untuk mengeksplorasi ruang aksi. Entropy bonus yang tinggi mempromosikan eksplorasi dibandingkan eksploitasi. 

Memahami mekanisme clipping

Misalkan di bawah kebijakan lama πold, probabilitas mengambil aksi a pada state s adalah πold(a|s). Di bawah kebijakan baru, probabilitas mengambil aksi yang sama a dari state yang sama s diperbarui menjadi πnew(a|s). Rasio probabilitas ini, sebagai fungsi dari parameter kebijakan θ, adalah r(θ). Ketika kebijakan baru membuat aksi lebih mungkin (pada state yang sama), rasionya lebih besar dari 1 dan sebaliknya. 

Mekanisme clipping membatasi rasio probabilitas ini sehingga probabilitas aksi baru harus berada dalam persentase tertentu dari probabilitas aksi lama. Misalnya, r(θ) dapat dibatasi berada antara 0,8 dan 1,2. Ini mencegah lompatan besar, yang pada gilirannya memastikan proses pelatihan stabil.

Di sisa artikel ini, Anda akan mempelajari cara merangkai komponen untuk implementasi sederhana PPO menggunakan PyTorch.

Sebelum mengimplementasikan PPO, kita perlu menginstal pustaka perangkat lunak prasyarat dan memilih lingkungan yang sesuai untuk menerapkan kebijakan. 

Menginstal PyTorch dan pustaka yang diperlukan 

Kita perlu menginstal perangkat lunak berikut: 

  • PyTorch dan pustaka lain, seperti numpy (untuk fungsi matematis dan statistik) dan matplotlib (untuk memplot grafik).
  • Paket perangkat lunak open-source Gym dari OpenAI, yaitu pustaka Python yang mensimulasikan berbagai lingkungan dan gim yang dapat diselesaikan menggunakan Reinforcement learning. Anda dapat menggunakan Gym API untuk membuat algoritme Anda berinteraksi dengan lingkungan. Karena fungsi gym kadang berubah selama proses upgrade, dalam contoh ini, kita kunci versinya ke 0.25.2.

Untuk menginstal di server atau mesin lokal, jalankan: 

$ pip install torch numpy matplotlib gym==0.25.2

Untuk menginstal menggunakan Notebook seperti Google Colab atau DataLab, gunakan: 

!pip install torch numpy matplotlib gym==0.25.2

Buat lingkungan CartPole

Gunakan OpenAI Gym untuk membuat dua instance (satu untuk pelatihan dan satu lagi untuk pengujian) dari lingkungan CartPole:

env_train = gym.make('CartPole-v1')
env_test = gym.make('CartPole-v1')

Sekarang, mari kita implementasikan PPO menggunakan PyTorch.

Mendefinisikan jaringan kebijakan

Seperti dijelaskan sebelumnya, PPO diimplementasikan sebagai model actor-critic. Actor menerapkan kebijakan, dan critic memprediksi nilai taksirannya. Kedua jaringan saraf actor dan critic menerima input yang sama—state pada setiap timestep. Dengan demikian, model actor dan critic dapat berbagi jaringan saraf umum, yang disebut arsitektur backbone. Actor dan critic dapat memperluas arsitektur backbone dengan lapisan tambahan. 

Definisikan jaringan backbone

Langkah-langkah berikut menjelaskan jaringan backbone:

  • Implementasikan jaringan dengan 3 lapisan - input, tersembunyi (hidden), dan output. 
  • Setelah lapisan input dan tersembunyi, kita gunakan fungsi aktivasi. Dalam tutorial ini, kita memilih ReLU karena efisien secara komputasi. 
  • Kita juga menerapkan fungsi dropout setelah lapisan input dan tersembunyi untuk mendapatkan jaringan yang andal. Fungsi dropout secara acak membuat beberapa neuron bernilai nol. Ini mengurangi ketergantungan pada neuron tertentu dan mencegah overfitting, sehingga membuat jaringan lebih tangguh. 

Kode di bawah ini mengimplementasikan backbone:

class BackboneNetwork(nn.Module):
    def __init__(self, in_features, hidden_dimensions, out_features, dropout):
        super().__init__()
        self.layer1 = nn.Linear(in_features, hidden_dimensions)
        self.layer2 = nn.Linear(hidden_dimensions, hidden_dimensions)
        self.layer3 = nn.Linear(hidden_dimensions, out_features)
        self.dropout = nn.Dropout(dropout)
    def forward(self, x):
        x = self.layer1(x)
        x = f.relu(x)
        x = self.dropout(x)
        x = self.layer2(x)
        x = f.relu(x)
        x = self.dropout(x)
        x = self.layer3(x)
        return x

Definisikan jaringan actor-critic

Sekarang, kita dapat menggunakan jaringan ini untuk mendefinisikan kelas actor-critic, ActorCritic. Actor memodelkan kebijakan dan memprediksi aksi. Critic memodelkan fungsi nilai dan memprediksi nilainya. Keduanya menerima state sebagai input. 

class ActorCritic(nn.Module):
    def __init__(self, actor, critic):
        super().__init__()
        self.actor = actor
        self.critic = critic
    def forward(self, state):
        action_pred = self.actor(state)
        value_pred = self.critic(state)
        return action_pred, value_pred

Instansiasi jaringan actor dan critic

Kita akan menggunakan jaringan yang didefinisikan di atas untuk membuat actor dan critic. Lalu, kita akan membuat agen yang mencakup actor dan critic. 

Sebelum membuat agen, inisialisasi parameter jaringan:

  • Dimensi lapisan tersembunyi, H, yang merupakan parameter yang dapat dikonfigurasi. Ukuran dan jumlah lapisan tersembunyi bergantung pada kompleksitas masalah. Kita akan menggunakan satu lapisan tersembunyi dengan dimensi 64 X 64. 
  • Fitur input, N, di mana N adalah ukuran array state. Lapisan input memiliki dimensi N X H. Dalam lingkungan CartPole, state adalah array 4 elemen. Jadi N adalah 4.
  • Fitur output dari jaringan actor, O, di mana O adalah jumlah aksi di lingkungan. Lapisan output actor memiliki dimensi H x O. Lingkungan CartPole memiliki 2 aksi. 
  • Fitur output dari jaringan critic. Karena jaringan critic hanya memprediksi nilai harapan (dengan input state tertentu), jumlah fitur output adalah 1. 
  • Dropout sebagai fraksi.

Kode berikut menunjukkan cara mendeklarasikan jaringan actor dan critic berdasarkan jaringan backbone:

def create_agent(hidden_dimensions, dropout):
    INPUT_FEATURES = env_train.observation_space.shape[0]
    HIDDEN_DIMENSIONS = hidden_dimensions
    ACTOR_OUTPUT_FEATURES = env_train.action_space.n
    CRITIC_OUTPUT_FEATURES = 1
    DROPOUT = dropout
    actor = BackboneNetwork(
            INPUT_FEATURES, HIDDEN_DIMENSIONS, ACTOR_OUTPUT_FEATURES, DROPOUT)
    critic = BackboneNetwork(
            INPUT_FEATURES, HIDDEN_DIMENSIONS, CRITIC_OUTPUT_FEATURES, DROPOUT)
    agent = ActorCritic(actor, critic)
    return agent

Menghitung return

Lingkungan memberikan reward dari setiap langkah ke langkah berikutnya, tergantung pada aksi agen. Reward, R, dinyatakan sebagai:

Return didefinisikan sebagai nilai terakumulasi dari reward masa depan yang diharapkan. Reward dari timestep yang semakin jauh di masa depan kurang bernilai dibanding reward langsung. Dengan demikian, return umumnya dihitung sebagai return terdiskon, G, yang didefinisikan sebagai:

Dalam tutorial ini (dan banyak referensi lainnya), istilah return mengacu pada return terdiskon. 

Untuk menghitung return:

  • Mulailah dengan reward yang diharapkan dari semua state di masa depan.
  • Kalikan setiap reward masa depan dengan eksponen faktor diskon, . Misalnya, reward yang diharapkan setelah 2 timestep (dari saat ini) dikalikan dengan 2. 
  • Jumlahkan semua reward masa depan yang telah didiskon untuk menghitung return. 
  • Normalisasi nilai return. 

Fungsi calculate_returns() melakukan komputasi ini, seperti ditunjukkan di bawah:

def calculate_returns(rewards, discount_factor):
    returns = []
    cumulative_reward = 0
    for r in reversed(rewards):
        cumulative_reward = r + cumulative_reward * discount_factor
        returns.insert(0, cumulative_reward)
    returns = torch.tensor(returns)
    # normalize the return
    returns = (returns - returns.mean()) / returns.std()
    return returns

Mengimplementasikan fungsi advantage

Advantage dihitung sebagai selisih antara nilai yang diprediksi oleh critic dan return yang diharapkan dari aksi yang dipilih oleh actor sesuai kebijakan. Untuk suatu aksi tertentu, advantage menyatakan manfaat mengambil aksi spesifik itu dibanding aksi rata-rata sembarang. 

Dalam makalah PPO asli (persamaan 10), advantage, dengan melihat ke depan hingga timestep T, dinyatakan sebagai:

Saat mengodekan algoritma, batasan melihat ke depan hingga sejumlah timestep tertentu diterapkan melalui ukuran batch. Jadi, persamaan di atas dapat disederhanakan sebagai selisih antara nilai dan return yang diharapkan. Return yang diharapkan dikuantifikasi dalam fungsi nilai state-aksi, Q. 

Dengan demikian, rumus sederhana di bawah ini menyatakan advantage dari memilih: 

  • sebuah aksi tertentu 
  • pada state tertentu 
  • di bawah kebijakan tertentu 
  • pada timestep tertentu 

Ini dinyatakan sebagai: 

OpenAI juga menggunakan rumus ini untuk mengimplementasikan RL. Fungsi calculate_advantages() yang ditunjukkan di bawah ini menghitung advantage:

def calculate_advantages(returns, values):
    advantages = returns - values
    # Normalize the advantage
    advantages = (advantages - advantages.mean()) / advantages.std()
    return advantages

Surrogate loss dan mekanisme clipping

Policy loss akan menjadi loss policy gradient standar tanpa teknik khusus seperti PPO. Policy gradient loss standar dihitung sebagai hasil kali dari:

  • Probabilitas aksi kebijakan 
  • Fungsi advantage, yang dihitung sebagai selisih antara:
    • Return kebijakan 
    • Nilai yang diharapkan

Policy gradient loss standar tidak dapat melakukan koreksi untuk perubahan kebijakan yang mendadak. Surrogate loss memodifikasi loss standar untuk membatasi besarnya perubahan kebijakan pada setiap iterasi. Nilainya adalah minimum dari dua besaran:

  • Hasil kali dari:
    • Rasio kebijakan. Rasio ini menyatakan perbedaan antara probabilitas aksi lama dan baru.  
    • Fungsi advantage 
  • Hasil kali dari:
    • Nilai terbatasi (clamped) dari rasio kebijakan. Rasio ini di-clip sehingga kebijakan yang diperbarui berada dalam persentase tertentu dari kebijakan lama. 
    • Fungsi advantage 

Untuk proses optimisasi, surrogate loss digunakan sebagai proksi untuk loss aktual. 

Mekanisme clipping

Rasio kebijakan, R, adalah perbedaan antara kebijakan baru dan lama dan diberikan sebagai rasio dari log probabilitas kebijakan di bawah parameter baru dan lama:

Rasio kebijakan yang di-clip, R', dibatasi sehingga: 

Diberikan advantage, At, seperti ditunjukkan pada bagian sebelumnya, dan rasio kebijakan, seperti ditunjukkan di atas, surrogate loss dihitung sebagai:
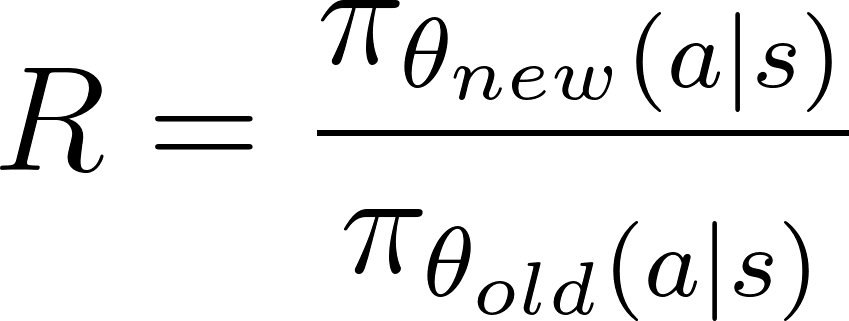
Kode di bawah ini menunjukkan cara mengimplementasikan mekanisme clipping dan surrogate loss. 

def calculate_surrogate_loss(
        actions_log_probability_old,
        actions_log_probability_new,
        epsilon,
        advantages):
    advantages = advantages.detach()
    policy_ratio = (
            actions_log_probability_new - actions_log_probability_old
            ).exp()
    surrogate_loss_1 = policy_ratio * advantages
    surrogate_loss_2 = torch.clamp(
            policy_ratio, min=1.0-epsilon, max=1.0+epsilon
            ) * advantages
    surrogate_loss = torch.min(surrogate_loss_1, surrogate_loss_2)
    return surrogate_loss

Sekarang, mari kita latih agen.

Menghitung policy loss dan value loss 

Kita sekarang siap menghitung policy loss dan value loss: 

  • Policy loss adalah jumlah dari surrogate loss dan entropy bonus. 
  • Value loss didasarkan pada selisih antara nilai yang diprediksi oleh critic dan return (reward kumulatif) yang dihasilkan oleh kebijakan. Perhitungan value loss menggunakan fungsi Smooth L1 Loss. Hal ini membantu menghaluskan fungsi loss dan membuatnya kurang sensitif terhadap outlier. 

Kedua loss di atas berupa tensor. Penurunan gradien didasarkan pada nilai skalar. Untuk mendapatkan satu nilai skalar yang merepresentasikan loss, gunakan fungsi .sum() untuk menjumlahkan elemen tensor. Fungsi di bawah ini menunjukkan caranya: 

def calculate_losses(
        surrogate_loss, entropy, entropy_coefficient, returns, value_pred):
    entropy_bonus = entropy_coefficient * entropy
    policy_loss = -(surrogate_loss + entropy_bonus).sum()
    value_loss = f.smooth_l1_loss(returns, value_pred).sum()
    return policy_loss, value_loss

Mendefinisikan loop pelatihan

Sebelum memulai proses pelatihan, buat sekumpulan buffer sebagai array kosong. Algoritma pelatihan akan menggunakan buffer ini untuk menyimpan informasi tentang aksi agen, state lingkungan, dan reward pada setiap timestep. Fungsi di bawah ini menginisialisasi buffer tersebut: 

def init_training():
    states = []
    actions = []
    actions_log_probability = []
    values = []
    rewards = []
    done = False
    episode_reward = 0
    return states, actions, actions_log_probability, values, rewards, done, episode_reward

Setiap iterasi pelatihan menjalankan agen dengan parameter kebijakan untuk iterasi tersebut. Agen berinteraksi dengan lingkungan dalam timestep pada sebuah loop hingga mencapai kondisi terminal. 

Setelah setiap timestep, aksi agen, reward, dan nilai ditambahkan ke buffer masing-masing. Ketika episode berakhir, fungsi mengembalikan set buffer yang diperbarui, yang merangkum hasil episode. 

Sebelum menjalankan loop pelatihan:

  • Setel model ke mode pelatihan menggunakan agent.train(). 
  • Reset lingkungan ke state acak menggunakan env.reset(). Ini adalah state awal untuk iterasi pelatihan ini. 

Langkah-langkah berikut menjelaskan apa yang terjadi pada setiap timestep di loop pelatihan: 

  • Teruskan state ke agen. 
  • Agen mengembalikan:
    • Aksi yang diprediksi mengingat state, berdasarkan kebijakan (actor). Teruskan tensor aksi yang diprediksi ini melalui fungsi softmax untuk mendapatkan himpunan probabilitas aksi.  
    • Nilai state yang diprediksi, berdasarkan critic.
  • Agen memilih aksi yang akan diambil:
    • Gunakan probabilitas aksi untuk memperkirakan distribusi probabilitas. 
    • Secara acak pilih aksi dengan mengambil sampel dari distribusi ini. Fungsi dist.sample() melakukan ini. 
  • Gunakan fungsi env.step() untuk meneruskan aksi ini ke lingkungan guna mensimulasikan respons lingkungan pada timestep ini. Berdasarkan aksi agen, lingkungan menghasilkan:
    • State baru
    • Reward
    • Nilai boolean done (ini menunjukkan apakah lingkungan telah mencapai state terminal)
  • Tambahkan ke buffer masing-masing nilai aksi agen, reward, nilai yang diprediksi, dan state baru. 

Episode pelatihan berakhir ketika fungsi env.step() mengembalikan true untuk nilai kembalian boolean done. 

Setelah episode berakhir, gunakan nilai yang terakumulasi dari setiap timestep untuk menghitung return kumulatif dari episode ini dengan menjumlahkan reward dari setiap timestep. Kita menggunakan fungsi calculate_returns() yang dijelaskan sebelumnya untuk melakukan ini. Input fungsi ini adalah faktor diskon dan buffer yang berisi reward dari setiap timestep. Kita menggunakan return ini dan nilai yang terakumulasi dari setiap timestep untuk menghitung advantage menggunakan fungsi calculate_advantages(). 

Fungsi Python berikut menunjukkan cara mengimplementasikan langkah-langkah ini:

def forward_pass(env, agent, optimizer, discount_factor):
    states, actions, actions_log_probability, values, rewards, done, episode_reward = init_training()
    state = env.reset()
    agent.train()
    while not done:
        state = torch.FloatTensor(state).unsqueeze(0)
        states.append(state)
        action_pred, value_pred = agent(state)
        action_prob = f.softmax(action_pred, dim=-1)
        dist = distributions.Categorical(action_prob)
        action = dist.sample()
        log_prob_action = dist.log_prob(action)
        state, reward, done, _ = env.step(action.item())
        actions.append(action)
        actions_log_probability.append(log_prob_action)
        values.append(value_pred)
        rewards.append(reward)
        episode_reward += reward
    states = torch.cat(states)
    actions = torch.cat(actions)
    actions_log_probability = torch.cat(actions_log_probability)
    values = torch.cat(values).squeeze(-1)
    returns = calculate_returns(rewards, discount_factor)
    advantages = calculate_advantages(returns, values)
    return episode_reward, states, actions, actions_log_probability, advantages, returns

Memperbarui parameter model

Setiap iterasi pelatihan menjalankan model melalui satu episode lengkap yang terdiri dari banyak timestep (hingga mencapai kondisi terminal). Pada setiap timestep, kita menyimpan parameter kebijakan, aksi agen, return, dan advantage. Setelah setiap iterasi, kita memperbarui model berdasarkan kinerja kebijakan melalui semua timestep pada iterasi tersebut. 

Jumlah maksimum timestep dalam lingkungan CartPole adalah 500. Dalam lingkungan yang lebih kompleks, jumlah timestep lebih banyak, bahkan jutaan. Dalam kasus seperti itu, dataset hasil pelatihan harus dipecah menjadi batch. Jumlah timestep dalam setiap batch disebut ukuran batch optimisasi. 

Jadi, langkah-langkah untuk memperbarui parameter model adalah:

  • Bagi dataset hasil pelatihan menjadi batch. 
  • Untuk setiap batch:
    • Dapatkan aksi agen dan nilai yang diprediksi untuk setiap state.
    • Gunakan aksi yang diprediksi ini untuk memperkirakan distribusi probabilitas aksi baru. 
    • Gunakan distribusi ini untuk menghitung entropi. 
    • Gunakan distribusi ini untuk mendapatkan log probabilitas dari aksi pada dataset hasil pelatihan. Ini adalah himpunan log probabilitas baru dari aksi pada dataset hasil pelatihan. Himpunan log probabilitas lama dari aksi-aksi yang sama dihitung dalam loop pelatihan yang dijelaskan pada bagian sebelumnya. 
    • Hitung surrogate loss menggunakan distribusi probabilitas aksi lama dan baru. 
    • Hitung policy loss dan value loss menggunakan surrogate loss, entropi, dan advantage. 
    • Jalankan .backward() secara terpisah pada policy loss dan value loss. Ini memperbarui gradien pada fungsi loss. 
    • Jalankan .step() pada optimizer untuk memperbarui parameter kebijakan. Dalam hal ini, kita menggunakan optimizer Adam untuk menyeimbangkan kecepatan dan ketangguhan. 
    • Akumulasikan policy loss dan value loss. 
  • Ulangi backward pass (operasi di atas) pada setiap batch beberapa kali, tergantung nilai parameter PPO_STEPS. Mengulang backward pass pada setiap batch efisien secara komputasi karena secara efektif menambah ukuran dataset pelatihan tanpa harus menjalankan forward pass tambahan. Jumlah langkah lingkungan dalam setiap pergantian antara sampling dan optimisasi disebut ukuran batch iterasi. 
  • Kembalikan rata-rata policy loss dan value loss.

Kode di bawah ini mengimplementasikan langkah-langkah tersebut:

def update_policy(
        agent,
        states,
        actions,
        actions_log_probability_old,
        advantages,
        returns,
        optimizer,
        ppo_steps,
        epsilon,
        entropy_coefficient):
    BATCH_SIZE = 128
    total_policy_loss = 0
    total_value_loss = 0
    actions_log_probability_old = actions_log_probability_old.detach()
    actions = actions.detach()
    training_results_dataset = TensorDataset(
            states,
            actions,
            actions_log_probability_old,
            advantages,
            returns)
    batch_dataset = DataLoader(
            training_results_dataset,
            batch_size=BATCH_SIZE,
            shuffle=False)
    for _ in range(ppo_steps):
        for batch_idx, (states, actions, actions_log_probability_old, advantages, returns) in enumerate(batch_dataset):
            # get new log prob of actions for all input states
            action_pred, value_pred = agent(states)
            value_pred = value_pred.squeeze(-1)
            action_prob = f.softmax(action_pred, dim=-1)
            probability_distribution_new = distributions.Categorical(
                    action_prob)
            entropy = probability_distribution_new.entropy()
            # estimate new log probabilities using old actions
            actions_log_probability_new = probability_distribution_new.log_prob(actions)
            surrogate_loss = calculate_surrogate_loss(
                    actions_log_probability_old,
                    actions_log_probability_new,
                    epsilon,
                    advantages)
            policy_loss, value_loss = calculate_losses(
                    surrogate_loss,
                    entropy,
                    entropy_coefficient,
                    returns,
                    value_pred)
            optimizer.zero_grad()
            policy_loss.backward()
            value_loss.backward()
            optimizer.step()
            total_policy_loss += policy_loss.item()
            total_value_loss += value_loss.item()
    return total_policy_loss / ppo_steps, total_value_loss / ppo_steps

Mari kita jalankan agen PPO.

Mengevaluasi kinerja 

Untuk mengevaluasi kinerja agen, buatlah lingkungan baru dan hitung reward kumulatif dari menjalankan agen di lingkungan baru ini. Anda perlu menyetel agen ke mode evaluasi menggunakan fungsi .eval(). Langkah-langkahnya sama seperti untuk loop pelatihan. Cuplikan kode di bawah ini mengimplementasikan fungsi evaluasi: 

def evaluate(env, agent):
    agent.eval()
    rewards = []
    done = False
    episode_reward = 0
    state = env.reset()
    while not done:
        state = torch.FloatTensor(state).unsqueeze(0)
        with torch.no_grad():
            action_pred, _ = agent(state)
            action_prob = f.softmax(action_pred, dim=-1)
        action = torch.argmax(action_prob, dim=-1)
        state, reward, done, _ = env.step(action.item())
        episode_reward += reward
    return episode_reward

Memvisualisasikan hasil pelatihan

Kita akan menggunakan pustaka Matplotlib untuk memvisualisasikan progres proses pelatihan. Fungsi di bawah ini menunjukkan cara memplot reward dari loop pelatihan dan pengujian:

def plot_train_rewards(train_rewards, reward_threshold):
    plt.figure(figsize=(12, 8))
    plt.plot(train_rewards, label='Training Reward')
    plt.xlabel('Episode', fontsize=20)
    plt.ylabel('Training Reward', fontsize=20)
    plt.hlines(reward_threshold, 0, len(train_rewards), color='y')
    plt.legend(loc='lower right')
    plt.grid()
    plt.show()
def plot_test_rewards(test_rewards, reward_threshold):
    plt.figure(figsize=(12, 8))
    plt.plot(test_rewards, label='Testing Reward')
    plt.xlabel('Episode', fontsize=20)
    plt.ylabel('Testing Reward', fontsize=20)
    plt.hlines(reward_threshold, 0, len(test_rewards), color='y')
    plt.legend(loc='lower right')
    plt.grid()
    plt.show()

Pada contoh plot di bawah, kami menampilkan reward pelatihan dan pengujian, yang diperoleh dengan menerapkan kebijakan di lingkungan pelatihan dan pengujian masing-masing. Perlu dicatat bahwa bentuk plot ini akan terlihat berbeda setiap kali Anda menjalankan kode. Ini karena sifat keacakan yang melekat pada proses pelatihan. 
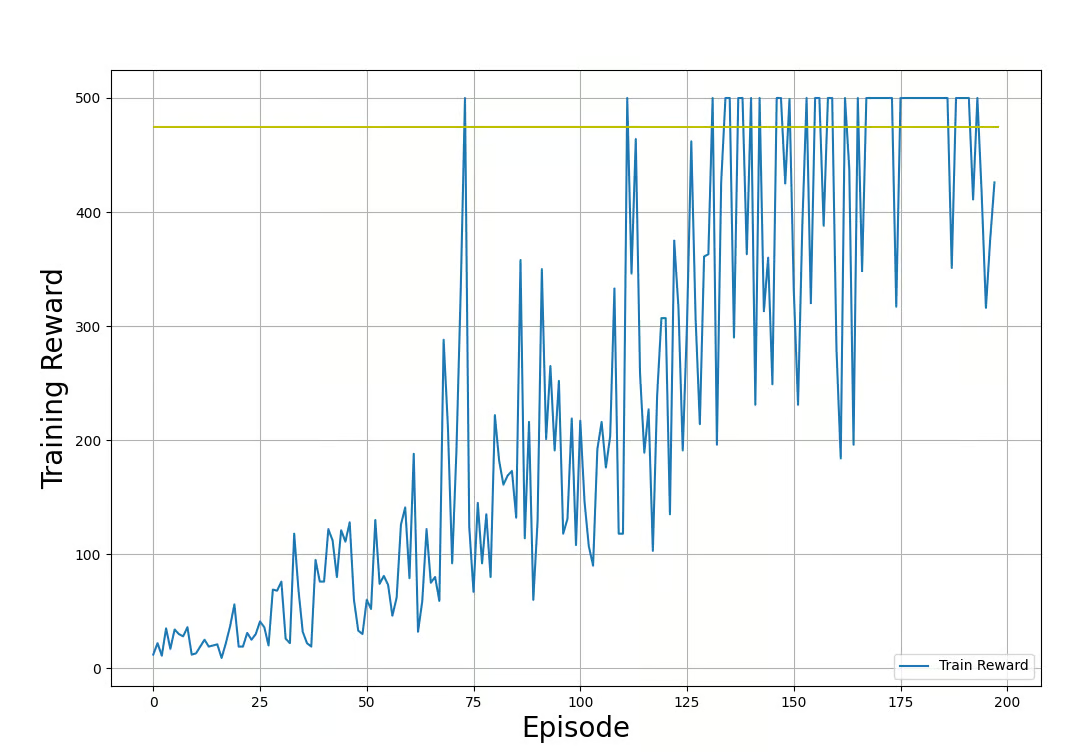
Plot dari reward pelatihan di setiap episode

Reward pelatihan (diperoleh dengan menerapkan kebijakan di lingkungan pelatihan). Gambar oleh Penulis.
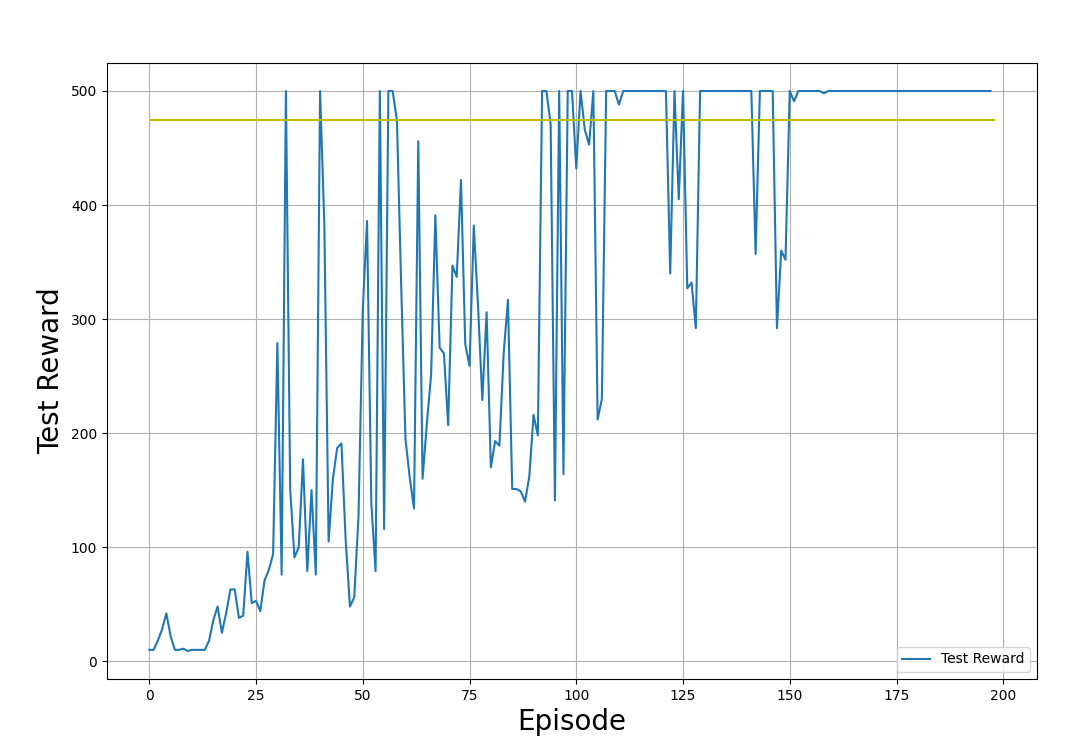
Reward pengujian (diperoleh dengan menerapkan kebijakan di lingkungan uji). Gambar oleh Penulis. 

Pada grafik keluaran di atas, amati progres proses pelatihan:

  • Reward dimulai dari nilai rendah. Seiring pelatihan berlangsung, reward meningkat. 
  • Reward berfluktuasi secara acak saat meningkat. Ini karena agen mengeksplorasi ruang kebijakan. 
  • Pelatihan berakhir, dan reward pengujian telah stabil di sekitar ambang batas (475) selama banyak iterasi. 
  • Reward dibatasi pada 500. Ini adalah batasan yang diberlakukan oleh lingkungan (Gym CartPole v1). 

Demikian pula, Anda dapat memplot value loss dan policy loss sepanjang iterasi:

def plot_losses(policy_losses, value_losses):
    plt.figure(figsize=(12, 8))
    plt.plot(value_losses, label='Value Losses')
    plt.plot(policy_losses, label='Policy Losses')
    plt.xlabel('Episode', fontsize=20)
    plt.ylabel('Loss', fontsize=20)
    plt.legend(loc='lower right')
    plt.grid()
    plt.show()

Contoh plot di bawah ini menunjukkan loss yang dilacak sepanjang episode pelatihan:
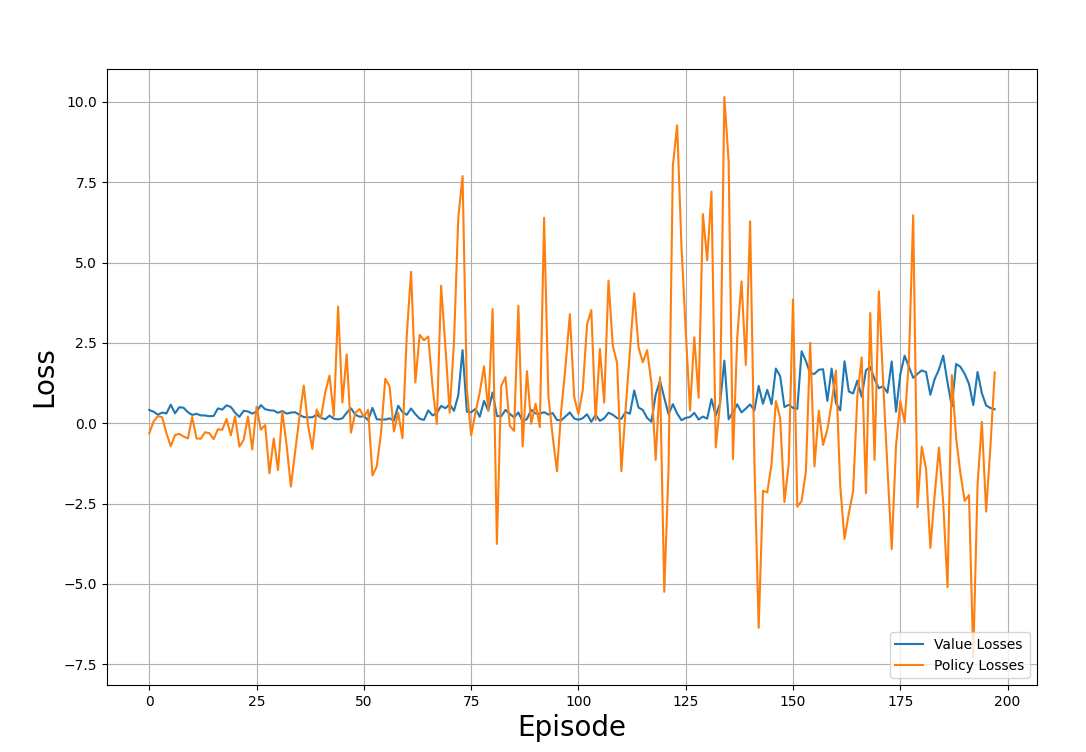
Value loss dan policy loss sepanjang proses pelatihan. Gambar oleh Penulis

Amati plot dan perhatikan:

  • Loss tampak terdistribusi secara acak dan tidak mengikuti pola tertentu. 
  • Ini khas pelatihan RL, di mana tujuannya bukan untuk meminimalkan loss tetapi memaksimalkan reward. 

Jalankan algoritma PPO

Sekarang Anda memiliki semua komponen untuk melatih agen menggunakan PPO. Untuk menyatukannya, Anda perlu:

  • Mendeklarasikan hiperparameter seperti faktor diskon, ukuran batch, laju pembelajaran, dll. 
  • Menginstansiasi buffer sebagai array null untuk menyimpan reward dan loss dari setiap iterasi. 
  • Membuat instance agen menggunakan fungsi create_agent().
  • Menjalankan forward dan backward pass secara iteratif menggunakan fungsi forward_pass() dan update_policy(). 
  • Menguji kinerja kebijakan menggunakan fungsi evaluate(). 
  • Menambahkan kebijakan, value loss, dan reward dari fungsi pelatihan dan evaluasi ke buffer masing-masing. 
  • Menghitung rata-rata reward dan loss selama beberapa timestep terakhir. Contoh di bawah merata-ratakan reward dan loss selama 40 timestep terakhir. 
  • Mencetak hasil evaluasi setiap beberapa langkah. Contoh di bawah mencetak setiap 10 langkah. 
  • Mengakhiri proses ketika reward rata-rata melewati ambang batas tertentu. 

Kode di bawah ini menunjukkan cara mendeklarasikan fungsi yang melakukan hal tersebut dalam Python:

def run_ppo():
    MAX_EPISODES = 500
    DISCOUNT_FACTOR = 0.99
    REWARD_THRESHOLD = 475
    PRINT_INTERVAL = 10
    PPO_STEPS = 8
    N_TRIALS = 100
    EPSILON = 0.2
    ENTROPY_COEFFICIENT = 0.01
    HIDDEN_DIMENSIONS = 64
    DROPOUT = 0.2
    LEARNING_RATE = 0.001
    train_rewards = []
    test_rewards = []
    policy_losses = []
    value_losses = []
    agent = create_agent(HIDDEN_DIMENSIONS, DROPOUT)
    optimizer = optim.Adam(agent.parameters(), lr=LEARNING_RATE)
    for episode in range(1, MAX_EPISODES+1):
        train_reward, states, actions, actions_log_probability, advantages, returns = forward_pass(
                env_train,
                agent,
                optimizer,
                DISCOUNT_FACTOR)
        policy_loss, value_loss = update_policy(
                agent,
                states,
                actions,
                actions_log_probability,
                advantages,
                returns,
                optimizer,
                PPO_STEPS,
                EPSILON,
                ENTROPY_COEFFICIENT)
        test_reward = evaluate(env_test, agent)
        policy_losses.append(policy_loss)
        value_losses.append(value_loss)
        train_rewards.append(train_reward)
        test_rewards.append(test_reward)
        mean_train_rewards = np.mean(train_rewards[-N_TRIALS:])
        mean_test_rewards = np.mean(test_rewards[-N_TRIALS:])
        mean_abs_policy_loss = np.mean(np.abs(policy_losses[-N_TRIALS:]))
        mean_abs_value_loss = np.mean(np.abs(value_losses[-N_TRIALS:]))
        if episode % PRINT_INTERVAL == 0:
            print(f'Episode: {episode:3} | \
                  Mean Train Rewards: {mean_train_rewards:3.1f} \
                  | Mean Test Rewards: {mean_test_rewards:3.1f} \
                  | Mean Abs Policy Loss: {mean_abs_policy_loss:2.2f} \
                  | Mean Abs Value Loss: {mean_abs_value_loss:2.2f}')
        if mean_test_rewards >= REWARD_THRESHOLD:
            print(f'Reached reward threshold in {episode} episodes')
            break
    plot_train_rewards(train_rewards, REWARD_THRESHOLD)
    plot_test_rewards(test_rewards, REWARD_THRESHOLD)
    plot_losses(policy_losses, value_losses)

Jalankan program: 

run_ppo()

Keluaran harus menyerupai sampel di bawah ini: 

Episode:  10 | Mean Train Rewards: 22.3 | Mean Test Rewards: 30.4 | Mean Abs Policy Loss: 0.37 | Mean Abs Value Loss: 0.39 
Episode:  20 | Mean Train Rewards: 38.6 | Mean Test Rewards: 69.8 | Mean Abs Policy Loss: 0.46 | Mean Abs Value Loss: 0.37 
.
.
.
Episode: 100 | Mean Train Rewards: 289.5 | Mean Test Rewards: 427.3 | Mean Abs Policy Loss: 1.73 | Mean Abs Value Loss: 0.21 
Episode: 110 | Mean Train Rewards: 357.7 | Mean Test Rewards: 461.4 | Mean Abs Policy Loss: 1.86 | Mean Abs Value Loss: 0.22 
Reached reward threshold in 116 episodes

Anda dapat melihat dan menjalankan program yang berfungsi di notebook DataLab ini!

Dalam machine learning, hiperparameter mengontrol proses pelatihan. Di bawah ini, saya jelaskan beberapa hiperparameter penting yang digunakan dalam PPO: 

  • Learning rate: Learning rate menentukan seberapa banyak parameter kebijakan dapat bervariasi pada setiap iterasi. Dalam stochastic gradient descent, besarnya pembaruan parameter kebijakan pada setiap iterasi ditentukan oleh hasil kali antara learning rate dan gradien. 
  • Parameter clipping: Ini juga disebut epsilon, ε. Ia menentukan sejauh mana rasio kebijakan di-clip. Rasio kebijakan baru dan lama diizinkan bervariasi dalam rentang [1-ε, 1+ε]. Saat berada di luar rentang ini, nilainya di-clip secara artifisial agar berada dalam rentang tersebut. 
  • Ukuran batch: Ini mengacu pada jumlah langkah yang dipertimbangkan untuk setiap pembaruan gradien. Dalam PPO, ukuran batch adalah jumlah timestep yang diperlukan untuk menerapkan kebijakan dan menghitung surrogate loss guna memperbarui parameter kebijakan. Dalam artikel ini, kami menggunakan ukuran batch 64. 
  • Langkah iterasi: Ini adalah jumlah kali setiap batch digunakan ulang untuk menjalankan backward pass. Kode dalam artikel ini menyebutnya PPO_STEPS. Dalam lingkungan yang kompleks, menjalankan forward pass berkali-kali mahal secara komputasi. Alternatif yang lebih efisien adalah menjalankan ulang setiap batch beberapa kali. Umumnya direkomendasikan menggunakan nilai antara 5 dan 10. 
  • Faktor diskon: Ini juga disebut gamma, γ. Ini menyatakan sejauh mana reward langsung lebih bernilai daripada reward masa depan. Ini mirip dengan konsep suku bunga dalam menghitung nilai waktu uang. Ketika mendekati 0, artinya reward masa depan kurang bernilai dan agen harus memprioritaskan reward langsung. Ketika mendekati 1, artinya reward masa depan penting. 
  • Koefisien entropi: Koefisien entropi menentukan entropy bonus, yang dihitung sebagai hasil kali antara koefisien entropi dan entropi distribusi. Peran entropy bonus adalah memasukkan lebih banyak keacakan ke dalam kebijakan. Ini mendorong agen untuk mengeksplorasi ruang kebijakan. Namun, pelatihan gagal konvergen ke kebijakan optimal ketika keacakan ini terlalu tinggi. 
  • Kriteria keberhasilan pelatihan: Anda perlu menetapkan kriteria untuk memutuskan kapan pelatihan berhasil. Cara umum untuk melakukan ini adalah dengan memberi kondisi bahwa reward rata-rata selama N percobaan (episode) terakhir berada di atas ambang batas tertentu. Dalam kode contoh di atas, ini dinyatakan dengan variabel N_TRIALS. Ketika ini disetel ke nilai yang lebih tinggi, pelatihan memakan waktu lebih lama karena kebijakan harus mencapai reward ambang batas selama lebih banyak episode. Ini juga menghasilkan kebijakan yang lebih tangguh namun lebih mahal secara komputasi. Perlu dicatat bahwa PPO adalah kebijakan stokastik, dan akan ada episode ketika agen tidak melewati ambang batas. Jadi, jika nilai N_TRIALS terlalu tinggi, pelatihan Anda mungkin tidak berakhir.

Strategi untuk mengoptimalkan kinerja PPO

Mengoptimalkan kinerja pelatihan algoritma PPO melibatkan trial and error dan bereksperimen dengan berbagai nilai hiperparameter. Namun, ada beberapa pedoman umum: 

  • Faktor diskon: Ketika reward jangka panjang penting, seperti pada lingkungan CartPole, di mana tiang harus tetap stabil dari waktu ke waktu, mulailah dengan nilai gamma moderat, seperti 0,99. 
  • Entropy bonus: Dalam lingkungan yang kompleks, agen harus mengeksplorasi ruang aksi untuk menemukan kebijakan optimal. Entropy bonus mempromosikan eksplorasi. Entropy bonus ditambahkan ke surrogate loss. Periksa besaran surrogate loss dan entropi distribusi sebelum memutuskan koefisien entropi. Dalam artikel ini, kami menggunakan koefisien entropi sebesar 0,01.
  • Parameter clipping: Parameter clipping menentukan seberapa berbeda kebijakan yang diperbarui dari kebijakan saat ini. Nilai parameter clipping yang besar mendorong eksplorasi lingkungan yang lebih baik, tetapi berisiko membuat pelatihan tidak stabil. Anda menginginkan parameter clipping yang memungkinkan eksplorasi bertahap sambil mencegah pembaruan yang membuat tidak stabil. Dalam artikel ini, kami menggunakan parameter clipping sebesar 0,2.
  • Learning rate: Ketika learning rate terlalu tinggi, kebijakan diperbarui dalam langkah besar, dan setiap iterasi serta proses pelatihan bisa menjadi tidak stabil. Ketika terlalu rendah, pelatihan memakan waktu terlalu lama.  Tutorial ini menggunakan learning rate 0,001, yang bekerja baik untuk lingkungan ini. Dalam banyak kasus, direkomendasikan menggunakan learning rate 1e-5. 

Tantangan dan Praktik Terbaik dalam PPO

Setelah menjelaskan konsep dan detail implementasi PPO, mari bahas tantangan dan praktik terbaiknya. 

Tantangan umum dalam melatih PPO

Meskipun PPO banyak digunakan, Anda perlu menyadari potensi tantangan untuk berhasil menyelesaikan masalah dunia nyata menggunakan teknik ini. Beberapa tantangan tersebut adalah:

  • Konvergensi lambat: Dalam lingkungan kompleks, PPO dapat tidak efisien dalam penggunaan sampel dan membutuhkan banyak interaksi dengan lingkungan untuk mencapai kebijakan optimal. Ini membuat pelatihan menjadi lambat dan mahal. 
  • Sensitivitas terhadap hiperparameter: PPO bergantung pada eksplorasi ruang kebijakan yang efisien. Stabilitas proses pelatihan dan kecepatan konvergensi sensitif terhadap nilai hiperparameter. Nilai optimal dari hiperparameter ini sering kali hanya dapat ditentukan melalui trial and error. 
  • Overfitting:  Lingkungan RL biasanya diinisialisasi dengan parameter acak. Pelatihan PPO didasarkan pada pencarian kebijakan optimal berdasarkan lingkungan agen. Terkadang, proses pelatihan berkumpul pada seperangkat parameter optimal untuk satu lingkungan tertentu tetapi tidak untuk lingkungan acak lainnya. Ini biasanya diatasi dengan melakukan banyak iterasi, masing-masing dengan lingkungan pelatihan yang diacak berbeda. 
  • Lingkungan dinamis: Lingkungan RL sederhana, seperti CartPole, bersifat statis - aturannya sama sepanjang waktu. Banyak lingkungan lain, seperti robot yang belajar berjalan di permukaan bergerak yang tidak stabil, bersifat dinamis - aturan lingkungan berubah seiring waktu. Untuk berkinerja baik dalam lingkungan seperti itu, PPO sering membutuhkan penyetelan tambahan. 
  • Eksplorasi vs eksploitasi: Mekanisme clipping dari PPO memastikan pembaruan kebijakan berada dalam wilayah tepercaya. Namun, hal ini juga dapat mencegah agen mengeksplorasi ruang aksi. Ini dapat menyebabkan konvergensi ke optimum lokal, terutama di lingkungan kompleks. Di sisi lain, membiarkan agen terlalu banyak mengeksplorasi dapat mencegahnya berkumpul ke kebijakan optimum mana pun. 

Praktik terbaik untuk melatih model PPO

Untuk mendapatkan hasil yang baik menggunakan PPO, saya merekomendasikan beberapa praktik terbaik, seperti:

  • Normalisasi fitur input: Menormalisasi nilai return dan advantage mengurangi variabilitas data dan menghasilkan pembaruan gradien yang stabil. Menormalisasi data membawa semua nilai ke rentang numerik yang konsisten. Ini membantu mengurangi efek outlier dan nilai ekstrem, yang jika tidak, dapat mendistorsi pembaruan gradien dan memperlambat konvergensi. 
  • Gunakan ukuran batch yang cukup besar: Batch kecil memungkinkan pembaruan dan pelatihan lebih cepat tetapi dapat menyebabkan konvergensi ke optimum lokal dan ketidakstabilan proses pelatihan. Ukuran batch yang lebih besar memungkinkan agen mempelajari kebijakan yang andal, sehingga proses pelatihan lebih stabil. Namun, ukuran batch yang terlalu besar juga tidak optimal. Selain meningkatkan biaya komputasi, ukuran tersebut membuat pembaruan kebijakan kurang responsif terhadap fungsi nilai karena pembaruan gradien didasarkan pada rata-rata yang diestimasi dari batch besar. Lebih jauh lagi, ini dapat menyebabkan overfitting pembaruan pada batch tertentu tersebut. 
  • Langkah iterasi: Umumnya disarankan untuk menggunakan ulang setiap batch selama 5-10 iterasi. Ini membuat proses pelatihan lebih efisien. Menggunakan ulang batch yang sama terlalu banyak kali menyebabkan overfitting. Kode menyebut hiperparameter ini sebagai PPO_STEPS. 
  • Lakukan evaluasi rutin: Untuk mendeteksi overfitting, penting untuk memantau efektivitas kebijakan secara berkala. Jika kebijakan ternyata tidak efektif dalam skenario tertentu, pelatihan lebih lanjut atau penyetelan mungkin diperlukan. 
  • Sesuaikan hiperparameter: Seperti dijelaskan sebelumnya, pelatihan PPO sensitif terhadap nilai hiperparameter. Eksperimenlah dengan berbagai nilai hiperparameter untuk menentukan set nilai yang tepat bagi masalah spesifik Anda. 
  • Jaringan backbone bersama: Seperti diilustrasikan dalam artikel ini, menggunakan backbone bersama mencegah ketidakseimbangan antara jaringan actor dan critic. Berbagi jaringan backbone antara actor dan critic membantu ekstraksi fitur bersama dan pemahaman umum tentang lingkungan. Ini membuat proses pembelajaran lebih efisien dan stabil. Ini juga membantu mengurangi kompleksitas ruang dan waktu komputasi algoritma. 
  • Jumlah dan ukuran lapisan tersembunyi: Tingkatkan jumlah lapisan tersembunyi dan dimensinya untuk lingkungan yang lebih kompleks. Masalah yang lebih sederhana seperti CartPole dapat diselesaikan dengan satu lapisan tersembunyi. Lapisan tersembunyi yang digunakan dalam artikel ini memiliki 64 dimensi. Membuat jaringan jauh lebih besar dari yang diperlukan adalah pemborosan komputasi dan dapat membuatnya tidak stabil. 
  • Early stopping: Menghentikan pelatihan saat metrik evaluasi terpenuhi membantu mencegah overtraining dan menghindari pemborosan sumber daya. Metrik evaluasi umum adalah ketika agen melampaui reward ambang batas selama N kejadian terakhir. 

Kesimpulan

Dalam artikel ini, kita membahas PPO sebagai cara untuk menyelesaikan masalah RL. Kita kemudian merinci langkah-langkah untuk mengimplementasikan PPO menggunakan PyTorch. Terakhir, kami menyajikan beberapa kiat kinerja dan praktik terbaik untuk PPO. 

Cara terbaik untuk belajar adalah dengan mengimplementasikan kodenya sendiri. Anda juga dapat memodifikasi kode agar berfungsi dengan lingkungan kendali klasik lainnya di Gym. Untuk mempelajari cara mengimplementasikan agen RL menggunakan Python dan Gymnasium OpenAI, ikuti kursus Reinforcement Learning with Gymnasium in Python!


Arun Nanda's photo
Author
Arun Nanda
LinkedIn

Arun adalah mantan pendiri startup yang gemar membangun hal-hal baru. Saat ini ia mengeksplorasi landasan teknis dan matematis Kecerdasan Buatan. Ia senang berbagi apa yang dipelajarinya, sehingga ia menulis tentang topik tersebut.

Selain di DataCamp, Anda dapat membaca publikasinya di Medium, Airbyte, dan Vultr.

Topik
Machine Learning
Python

Pelajari lebih lanjut tentang machine learning dengan kursus-kursus ini!

Kursus

Machine Learning dengan Model Berbasis Pohon di Python

5 jam
119.8K
Dalam kursus ini, Anda akan belajar cara menggunakan model berbasis pohon dan ensemble untuk regresi dan klasifikasi menggunakan scikit-learn.
Lihat DetailRight Arrow
Mulai Kursus
Lihat SelengkapnyaRight Arrow
Terkait

blogs

Tutorial Korelasi di R

Dapatkan pengenalan dasar-dasar korelasi di R: pelajari lebih lanjut tentang koefisien korelasi, matriks korelasi, plotting korelasi, dan sebagainya.
David Woods's photo

David Woods

13 mnt

blogs

12 Alternatif ChatGPT Terbaik yang Bisa Anda Coba pada 2026

Artikel ini menyajikan daftar alternatif ChatGPT yang akan meningkatkan produktivitas Anda.
Javier Canales Luna's photo

Javier Canales Luna

14 mnt

blogs

Spaghetti Plot dan Jalur Badai

Temukan alasan mengapa Anda sebaiknya (tidak) menggunakan spaghetti plot untuk menyampaikan ketidakpastian jalur prediksi badai serta dampaknya terhadap interpretasi.
Hugo Bowne-Anderson's photo

Hugo Bowne-Anderson

13 mnt

blogs

40 Pertanyaan Wawancara DBMS Teratas di 2026

Kuasai pertanyaan wawancara basis data, dari konsep SQL dasar hingga skenario desain sistem tingkat lanjut. Panduan mendalam ini mencakup semua yang Anda perlukan untuk sukses di wawancara DBMS dan meraih peran berikutnya.
Dario Radečić's photo

Dario Radečić

15 mnt

Lihat SelengkapnyaLihat Selengkapnya
