Khóa học
Machine Learning với mô hình dựa trên cây trong Python
5 giờ
119.8K
Trước khi triển khai PPO, chúng ta cần cài đặt các thư viện phần mềm tiên quyết và chọn một môi trường phù hợp để áp dụng chính sách.
Chúng ta cần cài đặt các phần mềm sau:
numpy (cho các hàm toán học và thống kê) và matplotlib (để vẽ biểu đồ).gym đôi khi thay đổi qua các lần nâng cấp, trong ví dụ này, chúng ta cố định phiên bản ở 0.25.2. Để cài đặt trên máy chủ hoặc máy cục bộ, chạy:
$ pip install torch numpy matplotlib gym==0.25.2Để cài đặt bằng Notebook như Google Colab hoặc DataLab, dùng:
!pip install torch numpy matplotlib gym==0.25.2Dùng OpenAI Gym để tạo hai thể hiện (một cho huấn luyện và một cho kiểm thử) của môi trường CartPole:
env_train = gym.make('CartPole-v1')
env_test = gym.make('CartPole-v1')Bây giờ, hãy triển khai PPO bằng PyTorch.
Như đã giải thích, PPO được triển khai theo mô hình actor-critic. Actor triển khai chính sách và critic dự đoán giá trị ước tính. Cả actor và critic đều nhận cùng đầu vào—trạng thái ở mỗi bước thời gian. Vì vậy, actor và critic có thể chia sẻ một mạng nơ-ron chung, được gọi là kiến trúc xương sống (backbone). Actor và critic có thể mở rộng backbone với các tầng bổ sung.
Các bước sau mô tả mạng xương sống:
Đoạn mã dưới đây triển khai backbone:
class BackboneNetwork(nn.Module):
    def __init__(self, in_features, hidden_dimensions, out_features, dropout):
        super().__init__()
        self.layer1 = nn.Linear(in_features, hidden_dimensions)
        self.layer2 = nn.Linear(hidden_dimensions, hidden_dimensions)
        self.layer3 = nn.Linear(hidden_dimensions, out_features)
        self.dropout = nn.Dropout(dropout)
    def forward(self, x):
        x = self.layer1(x)
        x = f.relu(x)
        x = self.dropout(x)
        x = self.layer2(x)
        x = f.relu(x)
        x = self.dropout(x)
        x = self.layer3(x)
return xGiờ chúng ta có thể dùng mạng này để định nghĩa lớp actor-critic, ActorCritic. Actor mô hình hóa chính sách và dự đoán hành động. Critic mô hình hóa hàm giá trị và dự đoán giá trị. Cả hai đều nhận trạng thái làm đầu vào.
class ActorCritic(nn.Module):
    def __init__(self, actor, critic):
        super().__init__()
        self.actor = actor
        self.critic = critic
    def forward(self, state):
        action_pred = self.actor(state)
        value_pred = self.critic(state)
return action_pred, value_predChúng ta sẽ dùng các mạng đã định nghĩa để tạo actor và critic. Sau đó, tạo một agent bao gồm actor và critic.
Trước khi tạo agent, khởi tạo các tham số của mạng:
Mã sau cho thấy cách khai báo mạng actor và critic dựa trên backbone:
def create_agent(hidden_dimensions, dropout):
    INPUT_FEATURES = env_train.observation_space.shape[0]
    HIDDEN_DIMENSIONS = hidden_dimensions
    ACTOR_OUTPUT_FEATURES = env_train.action_space.n
    CRITIC_OUTPUT_FEATURES = 1
    DROPOUT = dropout
    actor = BackboneNetwork(
            INPUT_FEATURES, HIDDEN_DIMENSIONS, ACTOR_OUTPUT_FEATURES, DROPOUT)
    critic = BackboneNetwork(
            INPUT_FEATURES, HIDDEN_DIMENSIONS, CRITIC_OUTPUT_FEATURES, DROPOUT)
    agent = ActorCritic(actor, critic)
return agentMôi trường cho phần thưởng khi chuyển từ mỗi bước sang bước kế tiếp, tùy theo hành động của tác tử. Phần thưởng, R, được biểu diễn là:

Return được định nghĩa là giá trị tích lũy của phần thưởng kỳ vọng trong tương lai. Phần thưởng ở các bước thời gian xa trong tương lai có giá trị thấp hơn phần thưởng tức thời. Vì vậy, return thường được tính là return chiết khấu, G, định nghĩa như sau:

Trong hướng dẫn này (và nhiều tài liệu khác), return đề cập đến return chiết khấu.
Để tính return:
Hàm calculate_returns() thực hiện các phép tính này, như dưới đây:
def calculate_returns(rewards, discount_factor):
    returns = []
    cumulative_reward = 0
    for r in reversed(rewards):
        cumulative_reward = r + cumulative_reward * discount_factor
        returns.insert(0, cumulative_reward)
    returns = torch.tensor(returns)
    # normalize the return
    returns = (returns - returns.mean()) / returns.std()
return returnsLợi thế được tính là chênh lệch giữa giá trị do critic dự đoán và return kỳ vọng từ các hành động do actor chọn theo chính sách. Với một hành động cho trước, lợi thế biểu thị lợi ích của việc chọn hành động cụ thể đó so với một hành động (trung bình) bất kỳ.
Trong bài báo PPO gốc (phương trình 10), lợi thế khi nhìn tới bước thời gian T được biểu diễn là:

Khi lập trình thuật toán, ràng buộc nhìn tới một số bước thời gian cố định được áp đặt thông qua kích thước batch. Do đó, phương trình trên có thể giản lược thành chênh lệch giữa giá trị và return kỳ vọng. Return kỳ vọng được lượng hóa trong hàm giá trị trạng thái–hành động, Q.
Vì vậy, công thức giản lược dưới đây biểu diễn lợi thế của việc chọn:
Được biểu diễn là:

OpenAI cũng dùng công thức này để triển khai RL. Hàm calculate_advantages() dưới đây tính lợi thế:
def calculate_advantages(returns, values):
    advantages = returns - values
    # Normalize the advantage
    advantages = (advantages - advantages.mean()) / advantages.std()
    return advantages
Mất mát chính sách sẽ là mất mát gradient chính sách tiêu chuẩn nếu không có các kỹ thuật đặc biệt như PPO. Mất mát gradient chính sách tiêu chuẩn được tính là tích của:
Mất mát gradient chính sách tiêu chuẩn không thể điều chỉnh cho các thay đổi đột ngột của chính sách. Mất mát thay thế sửa đổi mất mát tiêu chuẩn để hạn chế mức độ thay đổi chính sách trong mỗi lần lặp. Nó là giá trị nhỏ hơn của hai đại lượng:
Trong quá trình tối ưu hóa, mất mát thay thế được dùng như đại diện cho mất mát thực tế.
Tỉ số chính sách, R, là sự khác biệt giữa chính sách mới và cũ, được cho bởi tỉ số xác suất log của chính sách dưới tham số mới và cũ:
Tỉ số chính sách đã kẹp, R', bị ràng buộc sao cho:
Với lợi thế At như trên, và tỉ số chính sách như trên, mất mát thay thế được tính là:
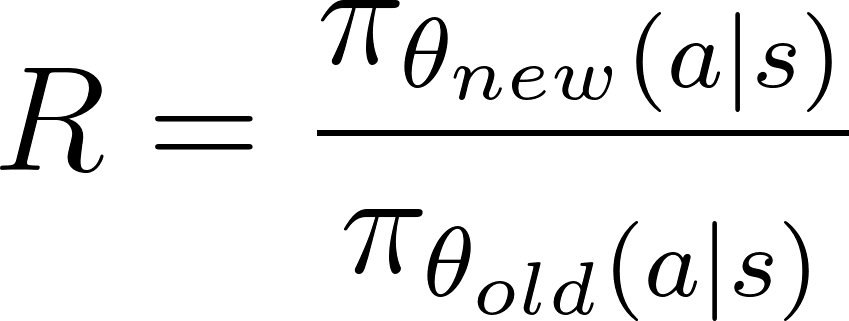
Đoạn mã dưới đây cho thấy cách triển khai cơ chế kẹp và mất mát thay thế.
def calculate_surrogate_loss(
        actions_log_probability_old,
        actions_log_probability_new,
        epsilon,
        advantages):
    advantages = advantages.detach()
    policy_ratio = (
            actions_log_probability_new - actions_log_probability_old
            ).exp()
    surrogate_loss_1 = policy_ratio * advantages
    surrogate_loss_2 = torch.clamp(
            policy_ratio, min=1.0-epsilon, max=1.0+epsilon
            ) * advantages
    surrogate_loss = torch.min(surrogate_loss_1, surrogate_loss_2)
return surrogate_lossGiờ hãy huấn luyện tác tử.
Chúng ta đã sẵn sàng để tính mất mát chính sách và giá trị:
Cả hai mất mát ở trên đều là tensor. Gradient descent dựa trên giá trị vô hướng. Để có một giá trị vô hướng đại diện cho mất mát, dùng hàm .sum() để cộng các phần tử tensor. Hàm dưới đây minh họa cách làm:
def calculate_losses(
        surrogate_loss, entropy, entropy_coefficient, returns, value_pred):
    entropy_bonus = entropy_coefficient * entropy
    policy_loss = -(surrogate_loss + entropy_bonus).sum()
    value_loss = f.smooth_l1_loss(returns, value_pred).sum()
return policy_loss, value_lossTrước khi bắt đầu quá trình huấn luyện, tạo một tập các bộ đệm (buffer) là mảng rỗng. Thuật toán huấn luyện sẽ dùng các bộ đệm này để lưu thông tin về hành động của tác tử, trạng thái của môi trường và phần thưởng ở mỗi bước thời gian. Hàm dưới đây khởi tạo các bộ đệm:
def init_training():
    states = []
    actions = []
    actions_log_probability = []
    values = []
    rewards = []
    done = False
    episode_reward = 0
    return states, actions, actions_log_probability, values, rewards, done, episode_reward
Mỗi lần lặp huấn luyện chạy tác tử với các tham số chính sách của vòng lặp đó. Tác tử tương tác với môi trường theo các bước thời gian trong một vòng lặp cho đến khi đạt điều kiện kết thúc.
Sau mỗi bước, hành động, phần thưởng và giá trị của tác tử được thêm vào các bộ đệm tương ứng. Khi tập kết thúc, hàm trả về tập bộ đệm đã cập nhật, tóm tắt kết quả của tập.
Trước khi chạy vòng lặp huấn luyện:
agent.train(). env.reset(). Đây là trạng thái bắt đầu cho vòng lặp huấn luyện này. Các bước sau giải thích những gì xảy ra ở mỗi bước thời gian trong vòng lặp huấn luyện:
dist.sample() thực hiện việc này. env.step() để truyền hành động này vào môi trường nhằm mô phỏng phản hồi của môi trường cho bước thời gian này. Dựa trên hành động của tác tử, môi trường sinh ra:done (chỉ báo môi trường đã đạt trạng thái kết thúc hay chưa)Tập huấn luyện kết thúc khi hàm env.step() trả về true cho giá trị boolean done.
Sau khi tập kết thúc, dùng các giá trị tích lũy ở mỗi bước để tính returns tích lũy của tập bằng cách cộng phần thưởng ở mỗi bước. Chúng ta dùng hàm calculate_returns() đã mô tả trước đó. Đầu vào của hàm này là hệ số chiết khấu và bộ đệm chứa phần thưởng của mỗi bước. Chúng ta dùng các returns này và các giá trị tích lũy ở mỗi bước để tính lợi thế bằng hàm calculate_advantages().
Hàm Python sau cho thấy cách triển khai các bước này:
def forward_pass(env, agent, optimizer, discount_factor):
    states, actions, actions_log_probability, values, rewards, done, episode_reward = init_training()
    state = env.reset()
    agent.train()
    while not done:
        state = torch.FloatTensor(state).unsqueeze(0)
        states.append(state)
        action_pred, value_pred = agent(state)
        action_prob = f.softmax(action_pred, dim=-1)
        dist = distributions.Categorical(action_prob)
        action = dist.sample()
        log_prob_action = dist.log_prob(action)
        state, reward, done, _ = env.step(action.item())
        actions.append(action)
        actions_log_probability.append(log_prob_action)
        values.append(value_pred)
        rewards.append(reward)
        episode_reward += reward
    states = torch.cat(states)
    actions = torch.cat(actions)
    actions_log_probability = torch.cat(actions_log_probability)
    values = torch.cat(values).squeeze(-1)
    returns = calculate_returns(rewards, discount_factor)
    advantages = calculate_advantages(returns, values)
return episode_reward, states, actions, actions_log_probability, advantages, returnsMỗi lần lặp huấn luyện chạy mô hình qua một tập hoàn chỉnh gồm nhiều bước thời gian (tới khi đạt điều kiện kết thúc). Ở mỗi bước, chúng ta lưu tham số chính sách, hành động của tác tử, returns và advantages. Sau mỗi lần lặp, chúng ta cập nhật mô hình dựa trên hiệu năng của chính sách qua tất cả các bước trong lần lặp đó.
Số bước thời gian tối đa trong môi trường CartPole là 500. Trong các môi trường phức tạp hơn, có nhiều bước thời gian hơn, thậm chí hàng triệu. Khi đó, tập dữ liệu kết quả huấn luyện phải được chia thành các batch. Số bước thời gian trong mỗi batch gọi là kích thước batch tối ưu hóa.
Vì vậy, các bước cập nhật tham số mô hình là:
.backward() riêng cho mất mát chính sách và mất mát giá trị. Điều này cập nhật gradient trên các hàm mất mát. .step() trên optimizer để cập nhật tham số chính sách. Ở đây, chúng ta dùng optimizer Adam để cân bằng tốc độ và độ vững. PPO_STEPS. Lặp lại lan truyền ngược trên mỗi batch tiết kiệm tính toán vì nó làm tăng hiệu quả kích thước tập huấn luyện mà không cần thêm các lần lan truyền xuôi. Số bước môi trường trong mỗi lần thay phiên giữa lấy mẫu và tối ưu hóa được gọi là kích thước batch vòng lặp. Đoạn mã dưới đây triển khai các bước trên:
def update_policy(
        agent,
        states,
        actions,
        actions_log_probability_old,
        advantages,
        returns,
        optimizer,
        ppo_steps,
        epsilon,
        entropy_coefficient):
    BATCH_SIZE = 128
    total_policy_loss = 0
    total_value_loss = 0
    actions_log_probability_old = actions_log_probability_old.detach()
    actions = actions.detach()
    training_results_dataset = TensorDataset(
            states,
            actions,
            actions_log_probability_old,
            advantages,
            returns)
    batch_dataset = DataLoader(
            training_results_dataset,
            batch_size=BATCH_SIZE,
            shuffle=False)
    for _ in range(ppo_steps):
        for batch_idx, (states, actions, actions_log_probability_old, advantages, returns) in enumerate(batch_dataset):
            # get new log prob of actions for all input states
            action_pred, value_pred = agent(states)
            value_pred = value_pred.squeeze(-1)
            action_prob = f.softmax(action_pred, dim=-1)
            probability_distribution_new = distributions.Categorical(
                    action_prob)
            entropy = probability_distribution_new.entropy()
            # estimate new log probabilities using old actions
            actions_log_probability_new = probability_distribution_new.log_prob(actions)
            surrogate_loss = calculate_surrogate_loss(
                    actions_log_probability_old,
                    actions_log_probability_new,
                    epsilon,
                    advantages)
            policy_loss, value_loss = calculate_losses(
                    surrogate_loss,
                    entropy,
                    entropy_coefficient,
                    returns,
                    value_pred)
            optimizer.zero_grad()
            policy_loss.backward()
            value_loss.backward()
            optimizer.step()
            total_policy_loss += policy_loss.item()
            total_value_loss += value_loss.item()
return total_policy_loss / ppo_steps, total_value_loss / ppo_stepsGiờ hãy chạy tác tử PPO.
Để đánh giá hiệu năng của tác tử, tạo một môi trường mới và tính phần thưởng tích lũy khi chạy tác tử trong môi trường này. Bạn cần đặt tác tử sang chế độ đánh giá bằng hàm .eval(). Các bước tương tự như vòng lặp huấn luyện. Đoạn mã dưới đây triển khai hàm đánh giá:
def evaluate(env, agent):
    agent.eval()
    rewards = []
    done = False
    episode_reward = 0
    state = env.reset()
    while not done:
        state = torch.FloatTensor(state).unsqueeze(0)
        with torch.no_grad():
            action_pred, _ = agent(state)
            action_prob = f.softmax(action_pred, dim=-1)
        action = torch.argmax(action_prob, dim=-1)
        state, reward, done, _ = env.step(action.item())
        episode_reward += reward
return episode_rewardChúng ta sẽ dùng thư viện Matplotlib để trực quan hóa tiến trình huấn luyện. Hàm dưới đây cho thấy cách vẽ phần thưởng từ cả vòng lặp huấn luyện và kiểm thử:
def plot_train_rewards(train_rewards, reward_threshold):
    plt.figure(figsize=(12, 8))
    plt.plot(train_rewards, label='Training Reward')
    plt.xlabel('Episode', fontsize=20)
    plt.ylabel('Training Reward', fontsize=20)
    plt.hlines(reward_threshold, 0, len(train_rewards), color='y')
    plt.legend(loc='lower right')
    plt.grid()
    plt.show()
def plot_test_rewards(test_rewards, reward_threshold):
plt.figure(figsize=(12, 8))
plt.plot(test_rewards, label='Testing Reward')
plt.xlabel('Episode', fontsize=20)
plt.ylabel('Testing Reward', fontsize=20)
plt.hlines(reward_threshold, 0, len(test_rewards), color='y')
plt.legend(loc='lower right')
plt.grid()
plt.show()Trong các biểu đồ ví dụ dưới đây, chúng tôi hiển thị phần thưởng huấn luyện và kiểm thử, thu được khi áp dụng chính sách trong môi trường huấn luyện và kiểm thử tương ứng. Lưu ý rằng hình dạng các đồ thị sẽ khác nhau mỗi lần chạy mã, do tính ngẫu nhiên vốn có của quá trình huấn luyện.
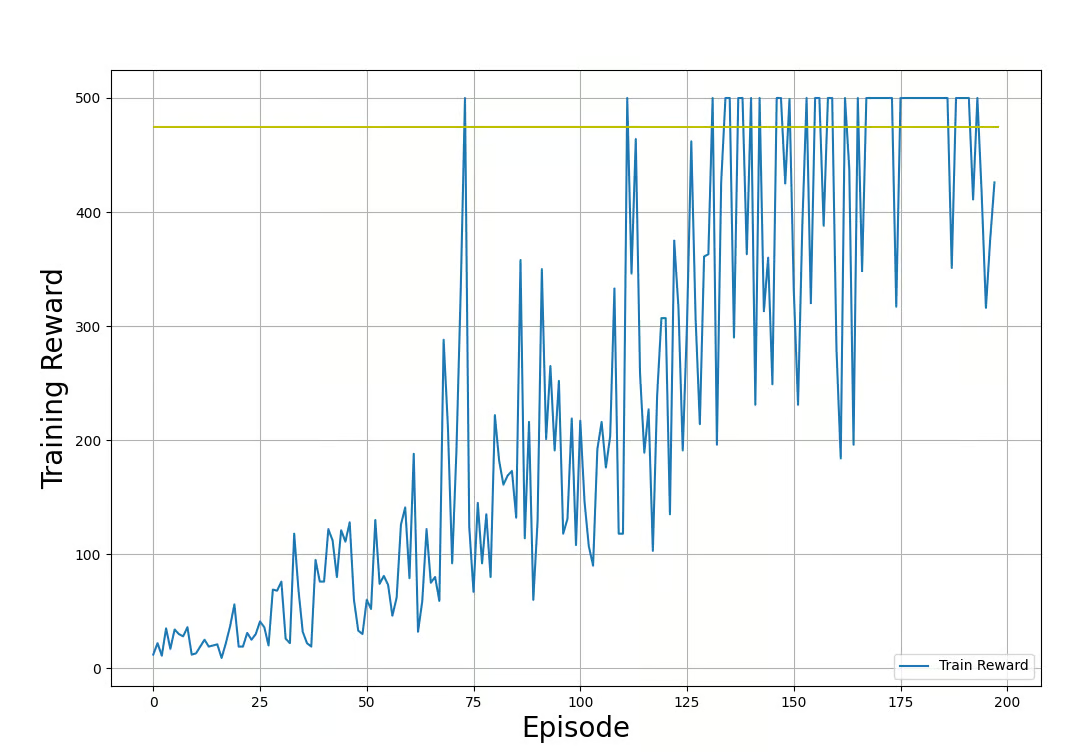
Phần thưởng huấn luyện (thu được khi áp dụng chính sách trong môi trường huấn luyện). Ảnh: Tác giả.
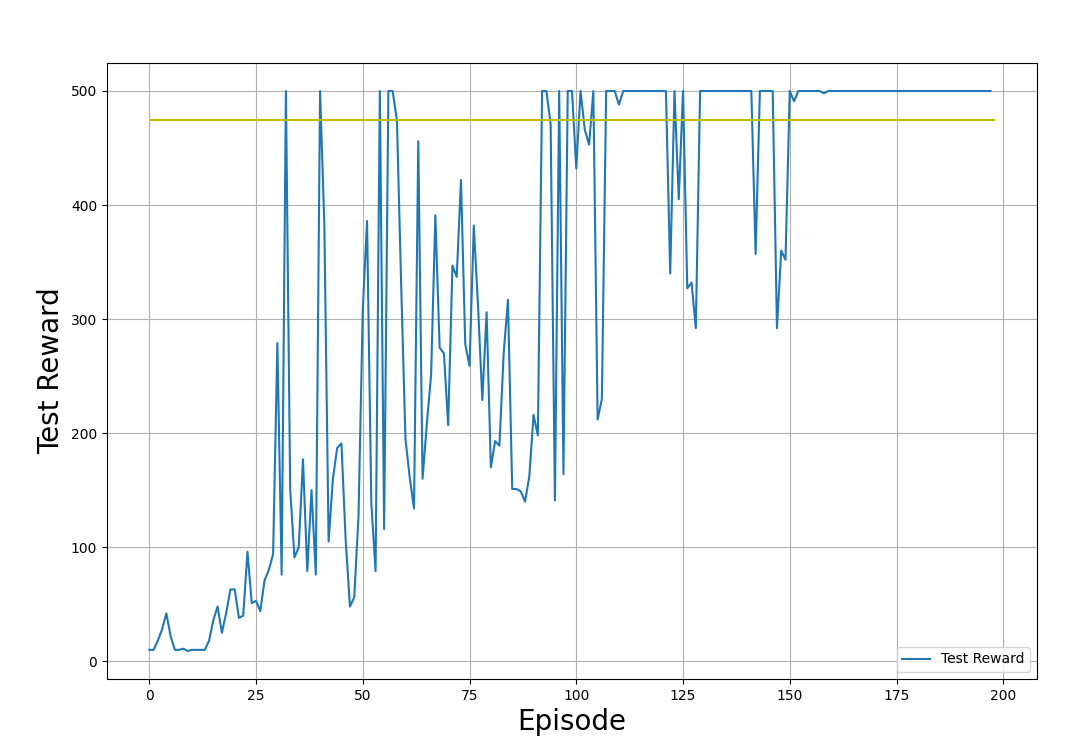
Phần thưởng kiểm thử (thu được khi áp dụng chính sách trong môi trường kiểm thử). Ảnh: Tác giả.
Trong các đồ thị đầu ra ở trên, hãy quan sát tiến trình huấn luyện:
Tương tự, bạn có thể vẽ mất mát giá trị và chính sách qua các lần lặp:
def plot_losses(policy_losses, value_losses):
    plt.figure(figsize=(12, 8))
    plt.plot(value_losses, label='Value Losses')
    plt.plot(policy_losses, label='Policy Losses')
    plt.xlabel('Episode', fontsize=20)
    plt.ylabel('Loss', fontsize=20)
    plt.legend(loc='lower right')
    plt.grid()
    plt.show()
Biểu đồ ví dụ dưới đây hiển thị các mất mát được theo dõi qua các tập huấn luyện:
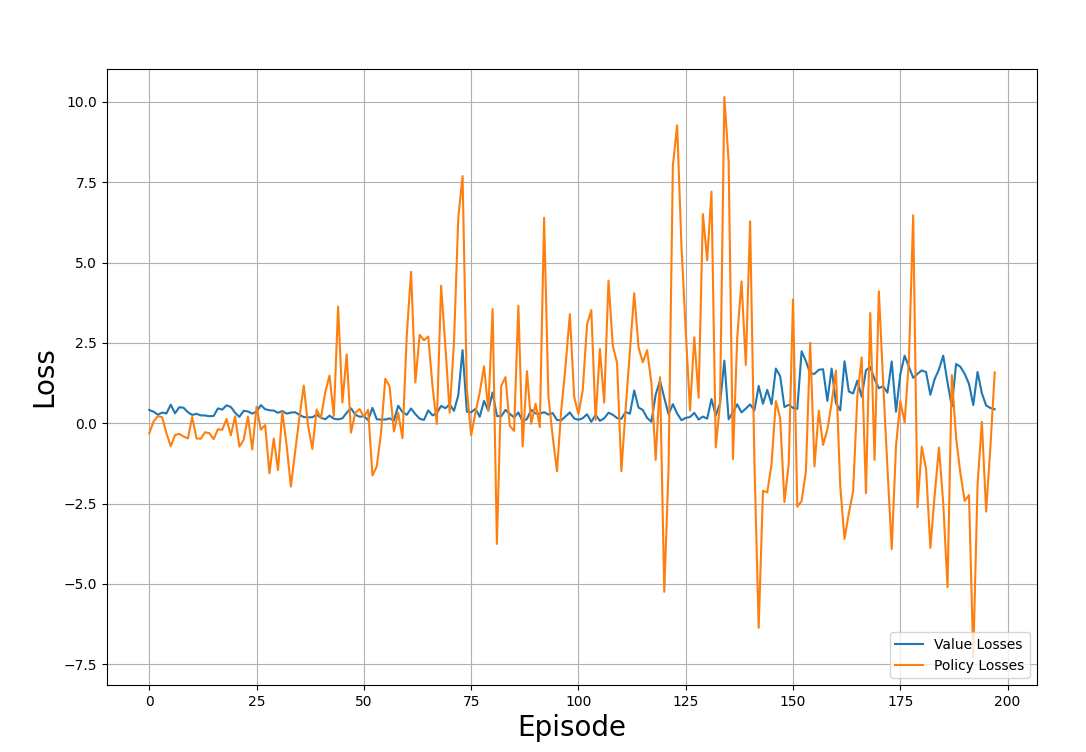
Mất mát giá trị và chính sách trong quá trình huấn luyện. Ảnh: Tác giả
Quan sát biểu đồ và lưu ý:
Bạn đã có tất cả các thành phần để huấn luyện tác tử bằng PPO. Để ghép lại, bạn cần:
create_agent().forward_pass() và update_policy(). evaluate(). Mã dưới đây cho thấy cách khai báo một hàm làm điều này trong Python:
def run_ppo():
    MAX_EPISODES = 500
    DISCOUNT_FACTOR = 0.99
    REWARD_THRESHOLD = 475
    PRINT_INTERVAL = 10
    PPO_STEPS = 8
    N_TRIALS = 100
    EPSILON = 0.2
    ENTROPY_COEFFICIENT = 0.01
    HIDDEN_DIMENSIONS = 64
    DROPOUT = 0.2
    LEARNING_RATE = 0.001
    train_rewards = []
    test_rewards = []
    policy_losses = []
    value_losses = []
    agent = create_agent(HIDDEN_DIMENSIONS, DROPOUT)
    optimizer = optim.Adam(agent.parameters(), lr=LEARNING_RATE)
    for episode in range(1, MAX_EPISODES+1):
        train_reward, states, actions, actions_log_probability, advantages, returns = forward_pass(
                env_train,
                agent,
                optimizer,
                DISCOUNT_FACTOR)
        policy_loss, value_loss = update_policy(
                agent,
                states,
                actions,
                actions_log_probability,
                advantages,
                returns,
                optimizer,
                PPO_STEPS,
                EPSILON,
                ENTROPY_COEFFICIENT)
        test_reward = evaluate(env_test, agent)
        policy_losses.append(policy_loss)
        value_losses.append(value_loss)
        train_rewards.append(train_reward)
        test_rewards.append(test_reward)
        mean_train_rewards = np.mean(train_rewards[-N_TRIALS:])
        mean_test_rewards = np.mean(test_rewards[-N_TRIALS:])
        mean_abs_policy_loss = np.mean(np.abs(policy_losses[-N_TRIALS:]))
        mean_abs_value_loss = np.mean(np.abs(value_losses[-N_TRIALS:]))
        if episode % PRINT_INTERVAL == 0:
            print(f'Episode: {episode:3} | \
                  Mean Train Rewards: {mean_train_rewards:3.1f} \
                  | Mean Test Rewards: {mean_test_rewards:3.1f} \
                  | Mean Abs Policy Loss: {mean_abs_policy_loss:2.2f} \
                  | Mean Abs Value Loss: {mean_abs_value_loss:2.2f}')
        if mean_test_rewards >= REWARD_THRESHOLD:
            print(f'Reached reward threshold in {episode} episodes')
            break
    plot_train_rewards(train_rewards, REWARD_THRESHOLD)
    plot_test_rewards(test_rewards, REWARD_THRESHOLD)
    plot_losses(policy_losses, value_losses)
Chạy chương trình:
run_ppo()Đầu ra sẽ tương tự ví dụ dưới đây:
Episode:  10 | Mean Train Rewards: 22.3 | Mean Test Rewards: 30.4 | Mean Abs Policy Loss: 0.37 | Mean Abs Value Loss: 0.39
Episode:  20 | Mean Train Rewards: 38.6 | Mean Test Rewards: 69.8 | Mean Abs Policy Loss: 0.46 | Mean Abs Value Loss: 0.37
.
.
.
Episode: 100 | Mean Train Rewards: 289.5 | Mean Test Rewards: 427.3 | Mean Abs Policy Loss: 1.73 | Mean Abs Value Loss: 0.21
Episode: 110 | Mean Train Rewards: 357.7 | Mean Test Rewards: 461.4 | Mean Abs Policy Loss: 1.86 | Mean Abs Value Loss: 0.22
Reached reward threshold in 116 episodes
Bạn có thể xem và chạy chương trình hoạt động trong notebook DataLab này!
Trong machine learning, siêu tham số kiểm soát quá trình huấn luyện. Dưới đây, tôi giải thích một số siêu tham số quan trọng dùng trong PPO:
PPO_STEPS. Trong môi trường phức tạp, chạy nhiều lần lan truyền xuôi rất tốn kém tính toán. Một cách hiệu quả hơn là tái sử dụng mỗi batch vài lần. Thường khuyến nghị dùng giá trị từ 5 đến 10. N_TRIALS. Khi đặt giá trị này cao hơn, huấn luyện mất nhiều thời gian hơn vì chính sách phải đạt phần thưởng ngưỡng trong nhiều tập hơn. Nó cũng giúp chính sách vững hơn nhưng tốn kém tính toán hơn. Lưu ý PPO là chính sách ngẫu nhiên, sẽ có những tập tác tử không vượt ngưỡng. Vì vậy nếu N_TRIALS quá cao, huấn luyện của bạn có thể không kết thúc.Tối ưu hiệu năng huấn luyện PPO đòi hỏi thử nghiệm và thay đổi các giá trị siêu tham số. Tuy nhiên, có một số hướng dẫn chung:
Sau khi giải thích các khái niệm và chi tiết triển khai PPO, hãy bàn về các thách thức và thực tiễn tốt.
Dù PPO được dùng rộng rãi, bạn cần nhận diện các thách thức tiềm ẩn để giải quyết thành công các bài toán thực tế bằng kỹ thuật này. Một số thách thức như:
Để đạt kết quả tốt với PPO, tôi khuyến nghị một số thực tiễn tốt như:
PPO_STEPS. Trong bài viết này, chúng ta đã thảo luận về PPO như một cách giải các bài toán RL. Sau đó, chúng ta chi tiết các bước triển khai PPO bằng PyTorch. Cuối cùng, chúng ta đưa ra một số mẹo hiệu năng và thực tiễn tốt cho PPO.
Cách học tốt nhất là tự bạn triển khai mã. Bạn cũng có thể sửa mã để hoạt động với các môi trường điều khiển cổ điển khác trong Gym. Để học cách triển khai các tác tử RL bằng Python và Gymnasium của OpenAI, hãy theo khóa học Reinforcement Learning with Gymnasium in Python!
Tìm hiểu thêm về machine learning với các khóa học này!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
