

1. De omgeving instellen
Voordat we PPO implementeren, moeten we de vereiste softwarebibliotheken installeren en een geschikte omgeving kiezen om het beleid toe te passen.
PyTorch en vereiste bibliotheken installeren
We moeten de volgende software installeren:
- PyTorch en andere softwarebibliotheken, zoals
numpy(voor wiskundige en statistische functies) enmatplotlib(voor het plotten van grafieken). - Het open-source Gym-softwarepakket van OpenAI, een Python-bibliotheek die verschillende omgevingen en games simuleert die met Reinforcement Learning kunnen worden opgelost. Je kunt de Gym API gebruiken om je algoritme met de omgeving te laten communiceren. Omdat de functionaliteit van
gymsoms verandert bij upgrades, bevriezen we in dit voorbeeld de versie op0.25.2.
Installeren op een server of lokale machine, voer uit:
$ pip install torch numpy matplotlib gym==0.25.2Installeren met een Notebook zoals Google Colabb of DataLab, gebruik:
!pip install torch numpy matplotlib gym==0.25.2De CartPole-omgeving(en) maken
Gebruik OpenAI Gym om twee instanties (één voor training en één voor testen) van de CartPole-omgeving te maken:
env_train = gym.make('CartPole-v1')
env_test = gym.make('CartPole-v1')2. PPO implementeren in PyTorch
Laten we nu PPO implementeren met PyTorch.
Het policy-netwerk definiëren
Zoals eerder uitgelegd, wordt PPO geïmplementeerd als een actor-critic-model. De actor implementeert het beleid, en de critic voorspelt de geschatte waarde. Beide neurale netwerken van actor en critic krijgen dezelfde input—de state op elke timestep. Daarom kunnen de actor- en critic-modellen een gemeenschappelijk neuraal netwerk delen, de backbone-architectuur. De actor en critic kunnen de backbone uitbreiden met extra lagen.
Definieer het backbone-netwerk
De volgende stappen beschrijven het backbone-netwerk:
- Implementeer een netwerk met 3 lagen: een input-, een verborgen en een outputlaag.
- Na de input- en verborgen laag gebruiken we een activatiefunctie. In deze tutorial kiezen we ReLU omdat die rekenkundig efficiënt is.
- We voegen ook een dropout-functie toe na de input- en verborgen lagen om een robuust netwerk te krijgen. De dropout-functie zet willekeurig sommige neuronen op nul. Dit vermindert de afhankelijkheid van specifieke neuronen en voorkomt overfitting, waardoor het netwerk robuuster wordt.
De onderstaande code implementeert de backbone:
class BackboneNetwork(nn.Module):
def __init__(self, in_features, hidden_dimensions, out_features, dropout):
super().__init__()
self.layer1 = nn.Linear(in_features, hidden_dimensions)
self.layer2 = nn.Linear(hidden_dimensions, hidden_dimensions)
self.layer3 = nn.Linear(hidden_dimensions, out_features)
self.dropout = nn.Dropout(dropout)
def forward(self, x):
x = self.layer1(x)
x = f.relu(x)
x = self.dropout(x)
x = self.layer2(x)
x = f.relu(x)
x = self.dropout(x)
x = self.layer3(x)
return xDefinieer het actor-critic-netwerk
Nu kunnen we dit netwerk gebruiken om de actor-critic-klasse ActorCritic te definiëren. De actor modelleert het beleid en voorspelt de actie. De critic modelleert de waarde-functie en voorspelt de waarde. Beiden nemen de state als input.
class ActorCritic(nn.Module):
def __init__(self, actor, critic):
super().__init__()
self.actor = actor
self.critic = critic
def forward(self, state):
action_pred = self.actor(state)
value_pred = self.critic(state)
return action_pred, value_predDe actor- en critic-netwerken instantiëren
We gebruiken de hierboven gedefinieerde netwerken om een actor en een critic te maken. Vervolgens maken we een agent, met daarin de actor en de critic.
Initialiseer vóór het maken van de agent de parameters van het netwerk:
- De dimensies van de verborgen laag, H, een configureerbare parameter. De grootte en het aantal verborgen lagen hangen af van de complexiteit van het probleem. We gebruiken een verborgen laag met afmetingen 64 × 64.
- Inputfeatures, N, waarbij N de grootte is van de state-array. De inputlaag heeft afmetingen N × H. In de CartPole-omgeving is de state een array van 4 elementen. Dus N is 4.
- Outputfeatures van het actor-netwerk, O, waarbij O het aantal acties in de omgeving is. De outputlaag van de actor heeft afmetingen H × O. De CartPole-omgeving heeft 2 acties.
- Outputfeatures van het critic-netwerk. Omdat het critic-netwerk alleen de verwachte waarde voorspelt (gegeven een inputstate), is het aantal outputfeatures 1.
- Dropout als fractie.
De volgende code laat zien hoe je de actor- en critic-netwerken declareert op basis van het backbone-netwerk:
def create_agent(hidden_dimensions, dropout):
INPUT_FEATURES = env_train.observation_space.shape[0]
HIDDEN_DIMENSIONS = hidden_dimensions
ACTOR_OUTPUT_FEATURES = env_train.action_space.n
CRITIC_OUTPUT_FEATURES = 1
DROPOUT = dropout
actor = BackboneNetwork(
INPUT_FEATURES, HIDDEN_DIMENSIONS, ACTOR_OUTPUT_FEATURES, DROPOUT)
critic = BackboneNetwork(
INPUT_FEATURES, HIDDEN_DIMENSIONS, CRITIC_OUTPUT_FEATURES, DROPOUT)
agent = ActorCritic(actor, critic)
return agentDe returns berekenen
De omgeving geeft een beloning bij elke stap naar de volgende, afhankelijk van de actie van de agent. De beloning, R, wordt uitgedrukt als:
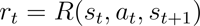
De return is gedefinieerd als de geaccumuleerde waarde van verwachte toekomstige beloningen. Beloningen van timesteps verder in de toekomst zijn minder waardevol dan directe beloningen. Daarom wordt de return vaak berekend als de gedisconteerde return, G, gedefinieerd als:
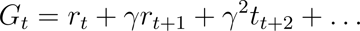
In deze tutorial (en veel andere referenties) verwijst return naar de gedisconteerde return.
Om de return te berekenen:
- Begin met de verwachte beloningen van alle toekomstige states.
- Vermenigvuldig elke toekomstige beloning met een macht van de discontovoet, . Bijvoorbeeld, de verwachte beloning na 2 timesteps (vanaf nu) wordt vermenigvuldigd met 2.
- Som alle gedisconteerde toekomstige beloningen om de return te berekenen.
- Normaliseer de waarde van de return.
De functie calculate_returns() voert deze berekeningen uit, zoals hieronder getoond:
def calculate_returns(rewards, discount_factor):
returns = []
cumulative_reward = 0
for r in reversed(rewards):
cumulative_reward = r + cumulative_reward * discount_factor
returns.insert(0, cumulative_reward)
returns = torch.tensor(returns)
# normalize the return
returns = (returns - returns.mean()) / returns.std()
return returnsDe advantage-functie implementeren
De advantage wordt berekend als het verschil tussen de waarde die door de critic is voorspeld en de verwachte return van de acties die door de actor volgens het beleid zijn gekozen. Voor een gegeven actie drukt de advantage het voordeel uit van het nemen van die specifieke actie boven een willekeurige (gemiddelde) actie.
In de oorspronkelijke PPO-paper (vergelijking 10) wordt de advantage, vooruitkijkend tot timestep T, uitgedrukt als:
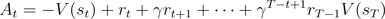
Tijdens het coderen van het algoritme wordt de beperking om vooruit te kijken tot een vast aantal timesteps afgedwongen via de batchgrootte. Dus kan de bovenstaande vergelijking worden vereenvoudigd tot het verschil tussen de waarde en de verwachte returns. De verwachte returns worden gekwantificeerd in de state-actie-waarde-functie, Q.
Zo drukt de vereenvoudigde formule hieronder de advantage uit van het kiezen van:
- een bepaalde actie
- in een gegeven state
- onder een bepaald beleid
- op een bepaald timestep
Dit wordt uitgedrukt als:

OpenAI gebruikt deze formule ook om RL te implementeren. De functie calculate_advantages() hieronder berekent de advantage:
def calculate_advantages(returns, values):
advantages = returns - values
# Normalize the advantage
advantages = (advantages - advantages.mean()) / advantages.std()
return advantagesSurrogate loss en clipping-mechanisme
De policy loss zou de standaard policy-gradient loss zijn zonder speciale technieken zoals PPO. De standaard policy-gradient loss wordt berekend als het product van:
- De actiekansen van het beleid
- De advantage-functie, berekend als het verschil tussen:
- De policy-return
- De verwachte waarde
De standaard policy-gradient loss kan abrupte beleidswijzigingen niet corrigeren. De surrogate loss wijzigt de standaard loss om te beperken hoeveel het beleid per iteratie kan veranderen. Het is de minimumwaarde van twee grootheden:
- Het product van:
- De policy-ratio. Deze ratio drukt het verschil uit tussen de oude en nieuwe actiekansen.
- De advantage-functie
- Het product van:
- De geklemde waarde van de policy-ratio. Deze ratio wordt geclipt zodat het geüpdatete beleid binnen een bepaald percentage van het oude beleid blijft.
- De advantage-functie
Voor het optimalisatieproces wordt de surrogate loss gebruikt als proxy voor de daadwerkelijke loss.
Het clipping-mechanisme
De policy-ratio, R, is het verschil tussen de nieuwe en oude policies en wordt gegeven als de verhouding van de logkansen van het beleid onder de nieuwe en oude parameters:
De geclipte policy-ratio, R', is zodanig begrensd dat:
Gegeven de advantage, At, zoals in de vorige sectie, en de policy-ratio zoals hierboven, wordt de surrogate loss berekend als:
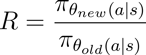
De onderstaande code laat zien hoe je het clipping-mechanisme en de surrogate loss implementeert.
def calculate_surrogate_loss(
actions_log_probability_old,
actions_log_probability_new,
epsilon,
advantages):
advantages = advantages.detach()
policy_ratio = (
actions_log_probability_new - actions_log_probability_old
).exp()
surrogate_loss_1 = policy_ratio * advantages
surrogate_loss_2 = torch.clamp(
policy_ratio, min=1.0-epsilon, max=1.0+epsilon
) * advantages
surrogate_loss = torch.min(surrogate_loss_1, surrogate_loss_2)
return surrogate_loss3. De agent trainen
Laten we nu de agent trainen.
Policy- en value loss berekenen
We zijn nu klaar om de policy- en value loss te berekenen:
- De policy loss is de som van de surrogate loss en de entropy bonus.
- De value loss is gebaseerd op het verschil tussen de waarde die door de critic is voorspeld en de returns (cumulatieve beloning) die door het beleid worden gegenereerd. Voor de value loss wordt de Smooth L1 Loss-functie gebruikt. Dit helpt om de verliesfunctie te verzachten en minder gevoelig te maken voor uitschieters.
Beide verliezen, zoals hierboven berekend, zijn tensors. Gradient descent is gebaseerd op scalars. Gebruik om één enkele scalar te krijgen die het verlies vertegenwoordigt de functie .sum() om de tensorelementen op te tellen. De onderstaande functie laat zien hoe je dit doet:
def calculate_losses(
surrogate_loss, entropy, entropy_coefficient, returns, value_pred):
entropy_bonus = entropy_coefficient * entropy
policy_loss = -(surrogate_loss + entropy_bonus).sum()
value_loss = f.smooth_l1_loss(returns, value_pred).sum()
return policy_loss, value_lossDe trainingslus definiëren
Maak, voordat je het trainingsproces start, een set buffers als lege arrays. Het trainingsalgoritme gebruikt deze buffers om informatie op te slaan over de acties van de agent, de states van de omgeving en de beloningen in elke timestep. De onderstaande functie initialiseert deze buffers:
def init_training():
states = []
actions = []
actions_log_probability = []
values = []
rewards = []
done = False
episode_reward = 0
return states, actions, actions_log_probability, values, rewards, done, episode_rewardElke trainingsiteratie draait de agent met de policy-parameters van die iteratie. De agent interageert met de omgeving in timesteps in een lus totdat een terminale conditie wordt bereikt.
Na elke timestep worden de actie, beloning en waarde van de agent toegevoegd aan de respectieve buffers. Wanneer de episode eindigt, geeft de functie de geüpdatete set buffers terug, die de resultaten van de episode samenvatten.
Voordat je de trainingslus start:
- Zet het model in trainingsmodus met
agent.train(). - Reset de omgeving naar een willekeurige state met
env.reset(). Dit is de startstate voor deze trainingsiteratie.
De volgende stappen beschrijven wat er gebeurt in elke timestep van de trainingslus:
- Geef de state door aan de agent.
- De agent retourneert:
- De voorspelde actie gegeven de state, op basis van het beleid (actor). Geef deze voorspelde actietensor door de softmax-functie om de set actiekansen te krijgen.
- De voorspelde waarde van de state, op basis van de critic.
- De agent kiest de te nemen actie:
- Gebruik de actiekansen om de kansverdeling te schatten.
- Kies willekeurig een actie door een sample uit deze verdeling te trekken. De functie
dist.sample()doet dit. - Gebruik de functie
env.step()om deze actie aan de omgeving door te geven en de reactie van de omgeving voor deze timestep te simuleren. Op basis van de actie van de agent genereert de omgeving: - De nieuwe state
- De beloning
- De booleaanse returnwaarde
done(dit geeft aan of de omgeving een terminale staat heeft bereikt) - Voeg aan de respectieve buffers de waarden toe van de actie van de agent, de beloningen, de voorspelde waarden en de nieuwe state.
De trainingsepisode eindigt wanneer de functie env.step() true retourneert voor de booleaanse returnwaarde done.
Na het beëindigen van de episode gebruik je de verzamelde waarden uit elke timestep om de cumulatieve returns van deze episode te berekenen door de beloningen per timestep op te tellen. We gebruiken hiervoor de eerder beschreven functie calculate_returns(). De inputs van deze functie zijn de discontovoet en de buffer met de beloningen per timestep. We gebruiken deze returns en de verzamelde waarden per timestep om de advantages te berekenen met de functie calculate_advantages().
De volgende Python-functie laat zien hoe je deze stappen implementeert:
def forward_pass(env, agent, optimizer, discount_factor):
states, actions, actions_log_probability, values, rewards, done, episode_reward = init_training()
state = env.reset()
agent.train()
while not done:
state = torch.FloatTensor(state).unsqueeze(0)
states.append(state)
action_pred, value_pred = agent(state)
action_prob = f.softmax(action_pred, dim=-1)
dist = distributions.Categorical(action_prob)
action = dist.sample()
log_prob_action = dist.log_prob(action)
state, reward, done, _ = env.step(action.item())
actions.append(action)
actions_log_probability.append(log_prob_action)
values.append(value_pred)
rewards.append(reward)
episode_reward += reward
states = torch.cat(states)
actions = torch.cat(actions)
actions_log_probability = torch.cat(actions_log_probability)
values = torch.cat(values).squeeze(-1)
returns = calculate_returns(rewards, discount_factor)
advantages = calculate_advantages(returns, values)
return episode_reward, states, actions, actions_log_probability, advantages, returnsDe modelparameters updaten
Elke trainingsiteratie draait het model door een volledige episode met veel timesteps (totdat een terminale conditie wordt bereikt). In elke timestep slaan we de policy-parameters, de actie van de agent, de returns en de advantages op. Na elke iteratie updaten we het model op basis van de prestaties van het beleid over alle timesteps in die iteratie.
Het maximale aantal timesteps in de CartPole-omgeving is 500. In complexere omgevingen zijn er meer timesteps, zelfs miljoenen. In zulke gevallen moet de trainingsresultatenset in batches worden opgesplitst. Het aantal timesteps per batch heet de optimalisatie-batchgrootte.
De stappen om de modelparameters te updaten zijn dus:
- Splits de trainingsresultatenset in batches.
- Voor elke batch:
- Haal de actie van de agent en de voorspelde waarde op voor elke state.
- Gebruik deze voorspelde acties om de nieuwe actiekansverdeling te schatten.
- Gebruik deze verdeling om de entropie te berekenen.
- Gebruik deze verdeling om de logkans van de acties in de trainingsresultatenset te krijgen. Dit is de nieuwe set logkansen van de acties in de trainingsresultatenset. De oude set logkansen van dezezelfde acties is berekend in de trainingslus die in de vorige sectie is uitgelegd.
- Bereken de surrogate loss met de oude en nieuwe kansverdelingen van de acties.
- Bereken de policy loss en de value loss met de surrogate loss, de entropie en de advantages.
- Voer
.backward()apart uit op de policy- en value loss. Dit werkt de gradiënten op de verliesfuncties bij. - Voer
.step()uit op de optimizer om de policy-parameters bij te werken. In dit geval gebruiken we de Adam-optimizer om snelheid en robuustheid te balanceren. - Accumuleer de policy- en value loss.
- Herhaal de backward pass (de bovenstaande handelingen) op elke batch enkele keren, afhankelijk van de waarde van de parameter
PPO_STEPS. De backward pass per batch herhalen is rekenkundig efficiënt omdat het de effectieve grootte van de trainingsset vergroot zonder extra forward passes. Het aantal omgevingsstappen in elke afwisseling tussen sampling en optimalisatie heet de iteratie-batchgrootte. - Retourneer de gemiddelde policy loss en value loss.
De onderstaande code implementeert deze stappen:
def update_policy(
agent,
states,
actions,
actions_log_probability_old,
advantages,
returns,
optimizer,
ppo_steps,
epsilon,
entropy_coefficient):
BATCH_SIZE = 128
total_policy_loss = 0
total_value_loss = 0
actions_log_probability_old = actions_log_probability_old.detach()
actions = actions.detach()
training_results_dataset = TensorDataset(
states,
actions,
actions_log_probability_old,
advantages,
returns)
batch_dataset = DataLoader(
training_results_dataset,
batch_size=BATCH_SIZE,
shuffle=False)
for _ in range(ppo_steps):
for batch_idx, (states, actions, actions_log_probability_old, advantages, returns) in enumerate(batch_dataset):
# get new log prob of actions for all input states
action_pred, value_pred = agent(states)
value_pred = value_pred.squeeze(-1)
action_prob = f.softmax(action_pred, dim=-1)
probability_distribution_new = distributions.Categorical(
action_prob)
entropy = probability_distribution_new.entropy()
# estimate new log probabilities using old actions
actions_log_probability_new = probability_distribution_new.log_prob(actions)
surrogate_loss = calculate_surrogate_loss(
actions_log_probability_old,
actions_log_probability_new,
epsilon,
advantages)
policy_loss, value_loss = calculate_losses(
surrogate_loss,
entropy,
entropy_coefficient,
returns,
value_pred)
optimizer.zero_grad()
policy_loss.backward()
value_loss.backward()
optimizer.step()
total_policy_loss += policy_loss.item()
total_value_loss += value_loss.item()
return total_policy_loss / ppo_steps, total_value_loss / ppo_steps4. De PPO-agent uitvoeren
Laten we de PPO-agent eindelijk draaien.
De prestaties evalueren
Om de prestaties van de agent te evalueren, maak je een nieuwe omgeving aan en bereken je de cumulatieve beloningen door de agent in deze nieuwe omgeving te laten draaien. Je moet de agent in evaluatiemodus zetten met de functie .eval(). De stappen zijn hetzelfde als voor de trainingslus. De onderstaande code implementeert de evaluatiefunctie:
def evaluate(env, agent):
agent.eval()
rewards = []
done = False
episode_reward = 0
state = env.reset()
while not done:
state = torch.FloatTensor(state).unsqueeze(0)
with torch.no_grad():
action_pred, _ = agent(state)
action_prob = f.softmax(action_pred, dim=-1)
action = torch.argmax(action_prob, dim=-1)
state, reward, done, _ = env.step(action.item())
episode_reward += reward
return episode_rewardTrainingsresultaten visualiseren
We gebruiken de bibliotheek Matplotlib om de voortgang van het trainingsproces te visualiseren. De onderstaande functie laat zien hoe je de beloningen uit zowel de trainings- als de testlussen kunt plotten:
def plot_train_rewards(train_rewards, reward_threshold):
plt.figure(figsize=(12, 8))
plt.plot(train_rewards, label='Training Reward')
plt.xlabel('Episode', fontsize=20)
plt.ylabel('Training Reward', fontsize=20)
plt.hlines(reward_threshold, 0, len(train_rewards), color='y')
plt.legend(loc='lower right')
plt.grid()
plt.show()def plot_test_rewards(test_rewards, reward_threshold):
plt.figure(figsize=(12, 8))
plt.plot(test_rewards, label='Testing Reward')
plt.xlabel('Episode', fontsize=20)
plt.ylabel('Testing Reward', fontsize=20)
plt.hlines(reward_threshold, 0, len(test_rewards), color='y')
plt.legend(loc='lower right')
plt.grid()
plt.show()In de voorbeeldplots hieronder tonen we de trainings- en testbeloningen, verkregen door het beleid respectievelijk in de trainings- en testomgevingen toe te passen. Let op: de vorm van deze plots zal er elke keer dat je de code draait anders uitzien. Dit komt door de willekeur die inherent is aan het trainingsproces.
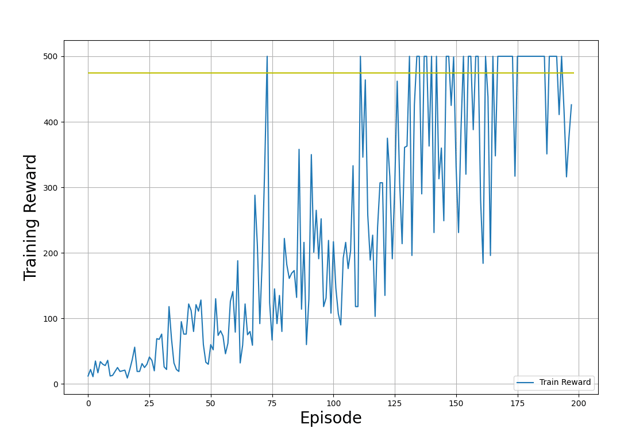
Trainingsbeloningen (verkregen door het beleid in de trainingsomgeving toe te passen). Afbeelding door de auteur.
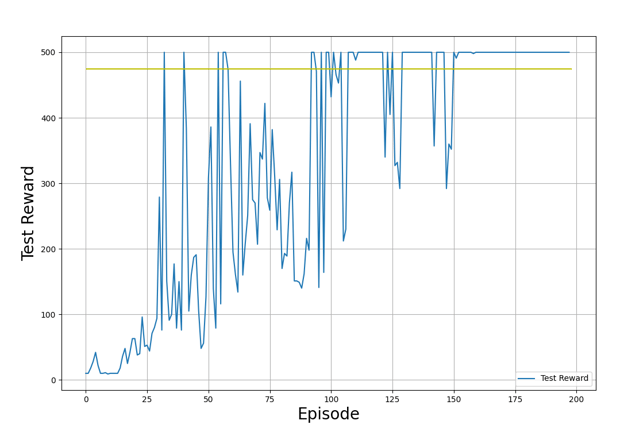
Testbeloningen (verkregen door het beleid in de testomgeving toe te passen). Afbeelding door de auteur.
Bekijk in de bovenstaande grafieken de voortgang van het trainingsproces:
- De beloning start laag. Naarmate de training vordert, nemen de beloningen toe.
- De beloningen schommelen willekeurig terwijl ze stijgen. Dit komt doordat de agent de beleidsruimte verkent.
- De training stopt, en de testbeloningen stabiliseren zich gedurende veel iteraties rond de drempel (475).
- De beloningen zijn begrensd op 500. Dit zijn beperkingen die door de omgeving (Gym CartPole v1) worden opgelegd.
Op dezelfde manier kun je de value- en policy-losses door de iteraties heen plotten:
def plot_losses(policy_losses, value_losses):
plt.figure(figsize=(12, 8))
plt.plot(value_losses, label='Value Losses')
plt.plot(policy_losses, label='Policy Losses')
plt.xlabel('Episode', fontsize=20)
plt.ylabel('Loss', fontsize=20)
plt.legend(loc='lower right')
plt.grid()
plt.show()De voorbeeldplot hieronder toont de verliezen die door de trainingsepisodes heen zijn bijgehouden:
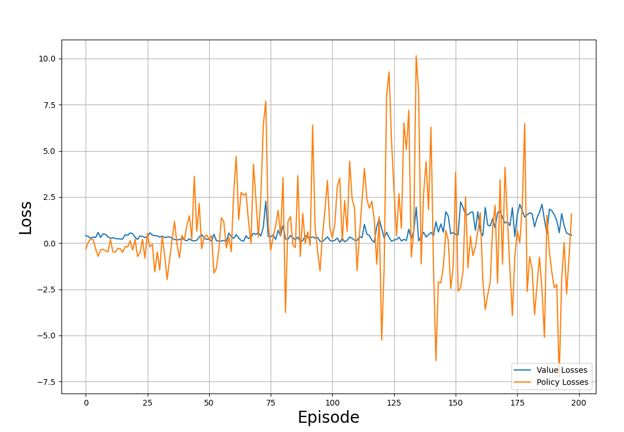
Value- en policy-losses tijdens het trainingsproces. Afbeelding door de auteur
Bekijk de plot en let op:
- De verliezen lijken willekeurig verdeeld en volgen geen patroon.
- Dit is typisch voor RL-training, waar het doel niet is om de loss te minimaliseren maar om de beloningen te maximaliseren.
Voer het PPO-algoritme uit
Je hebt nu alle componenten om de agent te trainen met PPO. Om alles bij elkaar te brengen, moet je:
- Hyperparameters declareren zoals discontovoet, batchgrootte, learning rate, enz.
- Buffers initialiseren als lege arrays om de beloningen en verliezen van elke iteratie op te slaan.
- Een agent-instantie maken met de functie
create_agent(). - Iteratief voorwaartse en achterwaartse passes uitvoeren met de functies
forward_pass()enupdate_policy(). - De prestaties van het beleid testen met de functie
evaluate(). - De policy- en value-losses, en de beloningen uit de trainings- en evaluatiefuncties toevoegen aan de bijbehorende buffers.
- Het gemiddelde van de beloningen en verliezen over de laatste paar tijdstappen berekenen. Het onderstaande voorbeeld neemt het gemiddelde over de laatste 40 tijdstappen.
- De resultaten van de evaluatie om de paar stappen printen. Het onderstaande voorbeeld print elke 10 stappen.
- Het proces beëindigen wanneer de gemiddelde beloning een bepaalde drempel overschrijdt.
De onderstaande code laat zien hoe je in Python een functie declareert die dit doet:
def run_ppo():
MAX_EPISODES = 500
DISCOUNT_FACTOR = 0.99
REWARD_THRESHOLD = 475
PRINT_INTERVAL = 10
PPO_STEPS = 8
N_TRIALS = 100
EPSILON = 0.2
ENTROPY_COEFFICIENT = 0.01
HIDDEN_DIMENSIONS = 64
DROPOUT = 0.2
LEARNING_RATE = 0.001
train_rewards = []
test_rewards = []
policy_losses = []
value_losses = []
agent = create_agent(HIDDEN_DIMENSIONS, DROPOUT)
optimizer = optim.Adam(agent.parameters(), lr=LEARNING_RATE)
for episode in range(1, MAX_EPISODES+1):
train_reward, states, actions, actions_log_probability, advantages, returns = forward_pass(
env_train,
agent,
optimizer,
DISCOUNT_FACTOR)
policy_loss, value_loss = update_policy(
agent,
states,
actions,
actions_log_probability,
advantages,
returns,
optimizer,
PPO_STEPS,
EPSILON,
ENTROPY_COEFFICIENT)
test_reward = evaluate(env_test, agent)
policy_losses.append(policy_loss)
value_losses.append(value_loss)
train_rewards.append(train_reward)
test_rewards.append(test_reward)
mean_train_rewards = np.mean(train_rewards[-N_TRIALS:])
mean_test_rewards = np.mean(test_rewards[-N_TRIALS:])
mean_abs_policy_loss = np.mean(np.abs(policy_losses[-N_TRIALS:]))
mean_abs_value_loss = np.mean(np.abs(value_losses[-N_TRIALS:]))
if episode % PRINT_INTERVAL == 0:
print(f'Episode: {episode:3} | \
Mean Train Rewards: {mean_train_rewards:3.1f} \
| Mean Test Rewards: {mean_test_rewards:3.1f} \
| Mean Abs Policy Loss: {mean_abs_policy_loss:2.2f} \
| Mean Abs Value Loss: {mean_abs_value_loss:2.2f}')
if mean_test_rewards >= REWARD_THRESHOLD:
print(f'Reached reward threshold in {episode} episodes')
break
plot_train_rewards(train_rewards, REWARD_THRESHOLD)
plot_test_rewards(test_rewards, REWARD_THRESHOLD)
plot_losses(policy_losses, value_losses)Voer het programma uit:
run_ppo()De output zou op het onderstaande voorbeeld moeten lijken:
Episode: 10 | Mean Train Rewards: 22.3 | Mean Test Rewards: 30.4 | Mean Abs Policy Loss: 0.37 | Mean Abs Value Loss: 0.39
Episode: 20 | Mean Train Rewards: 38.6 | Mean Test Rewards: 69.8 | Mean Abs Policy Loss: 0.46 | Mean Abs Value Loss: 0.37
.
.
.
Episode: 100 | Mean Train Rewards: 289.5 | Mean Test Rewards: 427.3 | Mean Abs Policy Loss: 1.73 | Mean Abs Value Loss: 0.21
Episode: 110 | Mean Train Rewards: 357.7 | Mean Test Rewards: 461.4 | Mean Abs Policy Loss: 1.86 | Mean Abs Value Loss: 0.22
Reached reward threshold in 116 episodesJe kunt het werkende programma bekijken en draaien in deze DataLab-notebook!
5. Hyperparametertuning en -optimalisatie
In machine learning sturen hyperparameters het trainingsproces. Hieronder leg ik enkele belangrijke hyperparameters uit die in PPO worden gebruikt:
- Learning rate: De learning rate bepaalt hoeveel de beleidsparameters per iteratie mogen variëren. Bij stochastische gradient descent wordt de hoeveelheid waarmee de beleidsparameters per iteratie worden bijgewerkt bepaald door het product van de learning rate en de gradiënt.
- Clipping-parameter: Dit wordt ook wel epsilon, ε, genoemd. Deze bepaalt in welke mate de beleidsratio wordt geclipped. De verhouding van het nieuwe en oude beleid mag variëren in het bereik [1-ε, 1+ε]. Als deze daarbuiten valt, wordt hij kunstmatig geclipped tot binnen dit bereik.
- Batchgrootte: Dit is het aantal stappen dat per gradiëntupdate wordt meegenomen. In PPO is de batchgrootte het aantal tijdstappen dat nodig is om het beleid toe te passen en de surrogaatloss te berekenen om de beleidsparameters bij te werken. In dit artikel gebruikten we een batchgrootte van 64.
- Iteratiestappen: Dit is het aantal keren dat elke batch opnieuw wordt gebruikt om de backward pass uit te voeren. De code in dit artikel verwijst hiernaar als
PPO_STEPS. In complexe omgevingen is het vaak rekenintensief om de forward pass vaak te draaien. Een efficiënter alternatief is om elke batch een paar keer te hergebruiken. Meestal wordt een waarde tussen 5 en 10 aanbevolen. - Discontovoet: Dit wordt ook wel gamma, γ, genoemd. Het drukt uit in welke mate directe beloningen waardevoller zijn dan toekomstige beloningen. Dit lijkt op het renteconcept bij het berekenen van de tijdswaarde van geld. Wanneer dichter bij 0 ligt, betekent dit dat toekomstige beloningen minder waardevol zijn en de agent directe beloningen moet prioriteren. Wanneer dichter bij 1 ligt, betekent dit dat toekomstige beloningen belangrijk zijn.
- Entropiecoëfficiënt: De entropiecoëfficiënt bepaalt de entropiebonus, die wordt berekend als het product van de entropiecoëfficiënt en de entropie van de distributie. De rol van de entropiebonus is om meer willekeur in het beleid te introduceren. Dit moedigt de agent aan om de beleidsruimte te verkennen. Als deze willekeur echter te hoog is, convergeert de training niet naar een optimaal beleid.
- Succescriteria voor de training: Je moet criteria instellen om te bepalen wanneer de training geslaagd is. Een gangbare manier is om als voorwaarde te stellen dat de gemiddelde beloningen over de laatste N trials (episodes) boven een bepaalde drempel liggen. In de voorbeeldcode hierboven wordt dit uitgedrukt met de variabele
N_TRIALS. Als deze op een hogere waarde is ingesteld, duurt de training langer omdat het beleid de drempelbeloning over meer episodes moet behalen. Het resulteert ook in een robuuster beleid, maar is rekenkundig duurder. Merk op dat PPO een stochastisch beleid is en dat er episodes zullen zijn waarin de agent de drempel niet haalt. Als de waarde vanN_TRIALSte hoog is, kan het zijn dat je training niet stopt.
Strategieën om PPO-prestaties te optimaliseren
Het optimaliseren van de prestaties bij het trainen van PPO-algoritmen draait om trial-and-error en experimenteren met verschillende hyperparametertwaarden. Er zijn echter enkele algemene richtlijnen:
- Discontovoet: Wanneer langetermijnbeloningen belangrijk zijn, zoals in de CartPole-omgeving waar de paal over tijd stabiel moet blijven, begin dan met een gematigde gamma-waarde, zoals 0,99.
- Entropiebonus: In complexe omgevingen moet de agent de actie-ruimte verkennen om het optimale beleid te vinden. De entropiebonus bevordert verkenning. De entropiebonus wordt toegevoegd aan de surrogaatloss. Controleer de grootteorde van de surrogaatloss en de entropie van de verdeling voordat je de entropiecoëfficiënt bepaalt. In dit artikel gebruikten we een entropiecoëfficiënt van 0,01.
- Clipping-parameter: De clipping-parameter bepaalt hoe verschillend het bijgewerkte beleid mag zijn van het huidige beleid. Een grote waarde van de clipping-parameter moedigt betere verkenning van de omgeving aan, maar brengt het risico met zich mee dat de training instabiel wordt. Je wilt een clipping-parameter die geleidelijke verkenning toestaat terwijl destabiliserende updates worden voorkomen. In dit artikel gebruikten we een clipping-parameter van 0,2.
- Learning rate: Als de learning rate te hoog is, wordt het beleid met grote stappen geüpdatet, en kan elke iteratie en het trainingsproces instabiel worden. Als hij te laag is, duurt de training te lang. In deze tutorial is een learning rate van 0,001 gebruikt, wat goed werkt voor de omgeving. In veel gevallen wordt aanbevolen een learning rate van 1e-5 te gebruiken.
Uitdagingen en best practices bij PPO
Na de concepten en implementatiedetails van PPO te hebben uitgelegd, bespreken we de uitdagingen en best practices.
Veelvoorkomende uitdagingen bij het trainen van PPO
Hoewel PPO veel wordt gebruikt, moet je je bewust zijn van mogelijke uitdagingen om echte problemen met deze techniek succesvol op te lossen. Enkele van dergelijke uitdagingen zijn:
- Trage convergentie: In complexe omgevingen kan PPO sample-inefficiënt zijn en veel interacties met de omgeving nodig hebben om tot het optimale beleid te convergeren. Dit maakt het trainen traag en kostbaar.
- Gevoeligheid voor hyperparameters: PPO is afhankelijk van het efficiënt verkennen van de beleidsruimte. De stabiliteit van het trainingsproces en de snelheid van convergentie zijn gevoelig voor de waarden van de hyperparameters. De optimale waarden van deze hyperparameters kunnen vaak alleen door trial-and-error worden bepaald.
- Overfitting: RL-omgevingen worden doorgaans geïnitialiseerd met willekeurige parameters. PPO-training is gebaseerd op het vinden van het optimale beleid op basis van de omgeving van de agent. Soms convergeert het trainingsproces naar een set optimale parameters voor één specifieke omgeving, maar niet voor willekeurig gevarieerde omgevingen. Dit wordt meestal aangepakt door veel iteraties te hebben, elk met een anders gerandomiseerde trainingsomgeving.
- Dynamische omgevingen: Simpele RL-omgevingen, zoals de CartPole-omgeving, zijn statisch — de regels blijven door de tijd heen hetzelfde. Veel andere omgevingen, zoals een robot die leert lopen op een onstabiel bewegend oppervlak, zijn dynamisch — de regels van de omgeving veranderen met de tijd. Om in zulke omgevingen goed te presteren, heeft PPO vaak extra finetuning nodig.
- Exploratie vs. exploitatie: Het clippingmechanisme van PPO zorgt ervoor dat beleidsupdates binnen een vertrouwde regio blijven. Het verhindert echter ook dat de agent de actieruimte verkent. Dit kan leiden tot convergentie naar lokale optima, vooral in complexe omgevingen. Aan de andere kant kan te veel verkenning voorkomen dat de agent naar enig optimaal beleid convergeert.
Best practices voor het trainen van PPO-modellen
Om goede resultaten met PPO te behalen, raad ik enkele best practices aan, zoals:
- Normaliseer invoerkenmerken: Het normaliseren van de waarden van returns en advantages vermindert de variabiliteit in de data en leidt tot stabiele gradiëntupdates. Door de data te normaliseren, komen alle waarden in een consistente numerieke range. Dit helpt het effect van uitschieters en extreme waarden te verminderen, die anders de gradiëntupdates zouden kunnen vertekenen en de convergentie zouden vertragen.
- Gebruik voldoende grote batchgroottes: Kleine batches maken snellere updates en training mogelijk, maar kunnen leiden tot convergentie naar lokale optima en instabiliteit in het trainingsproces. Grotere batches stellen de agent in staat robuuste beleidslijnen te leren, wat leidt tot een stabieler trainingsproces. Te grote batches zijn echter ook suboptimaal. Naast hogere rekenkosten maken ze beleidsupdates minder responsief op de valuefunctie omdat de gradiëntupdates zijn gebaseerd op gemiddelden over grote batches. Bovendien kan het leiden tot overfitting van de updates op die specifieke batch.
- Iteratiestappen: Het is over het algemeen aan te raden om elke batch 5–10 iteraties te hergebruiken. Dit maakt het trainingsproces efficiënter. Het te vaak hergebruiken van dezelfde batch leidt tot overfitting. De code verwijst naar deze hyperparameter als
PPO_STEPS. - Voer regelmatige evaluaties uit: Om overfitting te detecteren, is het essentieel om periodiek de effectiviteit van het beleid te monitoren. Als het beleid in bepaalde scenario’s ineffectief blijkt, kan verdere training of fine-tuning nodig zijn.
- Tune de hyperparameters: Zoals eerder uitgelegd, is PPO-training gevoelig voor de waarden van de hyperparameters. Experimenteer met verschillende waarden om de juiste set voor jouw specifieke probleem te bepalen.
- Gedeelde backbone-netwerk: Zoals in dit artikel is geïllustreerd, voorkomt het gebruik van een gedeelde backbone onevenwichtigheden tussen de actor- en critic-netwerken. Het delen van een backbone tussen actor en critic helpt bij gedeelde feature-extractie en een gemeenschappelijk begrip van de omgeving. Dit maakt het leerproces efficiënter en stabieler. Het helpt ook de computationele ruimte- en tijdcomplexiteit van het algoritme te verminderen.
- Aantal en grootte van verborgen lagen: Vergroot het aantal verborgen lagen en dimensies voor complexere omgevingen. Simpelere problemen zoals CartPole kunnen met één verborgen laag worden opgelost. De verborgen laag die in dit artikel is gebruikt heeft 64 dimensies. Het netwerk veel groter maken dan nodig is, is rekenkundig verspilling en kan het instabiel maken.
- Vroegtijdig stoppen: Stop de training wanneer aan de evaluatiemetingen is voldaan om overtraining te voorkomen en verspilling van resources te vermijden. Een veelgebruikte evaluatiemaatstaf is wanneer de agent de drempelbeloningen over de afgelopen N gebeurtenissen overschrijdt.
Conclusie
In dit artikel hebben we PPO besproken als een manier om RL-problemen op te lossen. Vervolgens hebben we de stappen uiteengezet om PPO te implementeren met PyTorch. Tot slot gaven we enkele prestatietips en best practices voor PPO.
De beste manier om te leren is door de code zelf te implementeren. Je kunt de code ook aanpassen voor andere klassieke controle-omgevingen in Gym. Wil je leren hoe je RL-agents implementeert met Python en OpenAI’s Gymnasium, volg dan de cursus Reinforcement Learning with Gymnasium in Python!



Proximal Policy Optimization (PPO) is een van de favoriete algoritmen om Reinforcement Learning (RL)-problemen op te lossen. Het werd in 2017 ontwikkeld door John Schuman, medeoprichter van OpenAI.
PPO is bij OpenAI op grote schaal gebruikt om modellen te trainen die mensachtig gedrag nabootsen. Het bouwt voort op eerdere methoden zoals Trust Region Policy Optimization (TRPO) en is populair geworden omdat het een robuust en efficiënt algoritme is.
In deze tutorial duiken we diep in PPO. We behandelen de theorie en laten zien hoe je het implementeert met PyTorch.
Proximal Policy Optimization (PPO) begrijpen
Conventionele supervised learning-algoritmen werken de parameters bij in de richting van de steilste gradiënt. Als zo’n update te groot blijkt, wordt dit gecorrigeerd in latere trainingsvoorbeelden die onafhankelijk van elkaar zijn.
In reinforcement learning bestaan de trainingsvoorbeelden echter uit de acties en returns van de agent. Daardoor zijn de trainingsvoorbeelden met elkaar gecorreleerd. De agent verkent de omgeving om het optimale beleid te vinden. Grote aanpassingen van de gradiënt kunnen ertoe leiden dat het beleid vastloopt in een slechte regio met suboptimale beloningen. Omdat de agent de omgeving moet verkennen, maken grote beleidswijzigingen het trainingsproces instabiel.
Trust-region-methoden proberen dit probleem te vermijden door te zorgen dat policy-updates binnen een vertrouwde regio blijven. Deze trusted region is een kunstmatig begrensde regio binnen de policy-ruimte waarbinnen updates zijn toegestaan. Het geüpdatete beleid mag alleen binnen een trusted region van het oude beleid liggen. Door policy-updates incrementeel te houden, voorkom je instabiliteit.
Trust region policy updates (TRPO)
Het algoritme Trust Region Policy Updates (TRPO) werd in 2015 voorgesteld door John Schulman (die in 2017 ook PPO voorstelde). Om het verschil tussen het oude en het geüpdatete beleid te meten, gebruikt TRPO de Kullback-Leibler (KL) divergentie. KL-divergentie meet het verschil tussen twee kansverdelingen. TRPO bleek effectief in het implementeren van trust regions.
Het probleem met TRPO is de rekenkundige complexiteit die gepaard gaat met KL-divergentie. De toepassing van KL-divergentie moet met numerieke methoden zoals Taylor-expansie tot de tweede orde worden benaderd. Dat is rekenintensief. PPO werd voorgesteld als een eenvoudiger en efficiënter alternatief voor TRPO. PPO clipt de verhouding van de policies om de trust region te benaderen zonder complexe berekeningen met KL-divergentie.
Daarom heeft PPO de voorkeur gekregen boven TRPO bij het oplossen van RL-problemen. Dankzij de efficiëntere manier om trust regions te schatten, balanceert PPO prestaties en stabiliteit effectief.
Proximale policy-approximatie (PPO)
PPO wordt vaak gezien als een subclass van actor-critic-methoden, die de policy-gradients updaten op basis van de waarde-functie. Advantage Actor-Critic (A2C)-methoden gebruiken een parameter genaamd de advantage. Deze meet het verschil tussen de returns die door de critic zijn voorspeld en de gerealiseerde returns door het beleid te implementeren.
Om PPO te begrijpen, moet je de componenten kennen:
Het clipping-mechanisme begrijpen
Stel dat onder het oude beleid πold, de kans om actie a te nemen in state s gelijk is aan πold(a|s). Onder het nieuwe beleid is de kans om dezelfde actie a te nemen vanuit dezelfde state s geüpdatet naar πnew(a|s). De verhouding van deze kansen, als functie van de policy-parameters θ, is r(θ). Wanneer het nieuwe beleid de actie waarschijnlijker maakt (in dezelfde state), is de verhouding groter dan 1 en omgekeerd.
Het clipping-mechanisme beperkt deze waarschijnlijkheidsverhouding zodanig dat de nieuwe actiekansen binnen een bepaald percentage van de oude actiekansen moeten liggen. Bijvoorbeeld, r(θ) kan worden begrensd tussen 0,8 en 1,2. Dit voorkomt grote sprongen en zorgt zo voor een stabiel trainingsproces.
In de rest van dit artikel leer je hoe je de componenten samenstelt voor een eenvoudige implementatie van PPO met PyTorch.