Corso
Machine Learning con modelli ad alberi in Python
5 ore
119.8K
Prima di implementare PPO, dobbiamo installare le librerie software necessarie e scegliere un ambiente adatto in cui applicare la politica.
Dobbiamo installare il seguente software:
numpy (per funzioni matematiche e statistiche) e matplotlib (per tracciare grafici).gym talvolta cambia con gli aggiornamenti, in questo esempio blocchiamo la versione a 0.25.2. Per installare su un server o una macchina locale, esegui:
$ pip install torch numpy matplotlib gym==0.25.2Per installare usando un Notebook come Google Colab o DataLab, usa:
!pip install torch numpy matplotlib gym==0.25.2Usa OpenAI Gym per creare due istanze (una per il training e una per il test) dell’ambiente CartPole:
env_train = gym.make('CartPole-v1')
env_test = gym.make('CartPole-v1')Ora implementiamo PPO con PyTorch.
Come spiegato sopra, PPO è implementata come modello actor-critic. L’actor implementa la politica e il critic ne predice il valore stimato. Entrambe le reti neurali, actor e critic, ricevono lo stesso input: lo stato a ogni timestep. Perciò, actor e critic possono condividere una rete neurale comune, detta backbone. Actor e critic possono estendere il backbone con layer aggiuntivi.
I passaggi seguenti descrivono la rete backbone:
Il codice seguente implementa il backbone:
class BackboneNetwork(nn.Module):
    def __init__(self, in_features, hidden_dimensions, out_features, dropout):
        super().__init__()
        self.layer1 = nn.Linear(in_features, hidden_dimensions)
        self.layer2 = nn.Linear(hidden_dimensions, hidden_dimensions)
        self.layer3 = nn.Linear(hidden_dimensions, out_features)
        self.dropout = nn.Dropout(dropout)
    def forward(self, x):
        x = self.layer1(x)
        x = f.relu(x)
        x = self.dropout(x)
        x = self.layer2(x)
        x = f.relu(x)
        x = self.dropout(x)
        x = self.layer3(x)
return xOra possiamo usare questa rete per definire la classe actor-critic, ActorCritic. L’actor modella la politica e predice l’azione. Il critic modella la funzione di valore e predice il valore. Entrambi prendono lo stato in input.
class ActorCritic(nn.Module):
    def __init__(self, actor, critic):
        super().__init__()
        self.actor = actor
        self.critic = critic
    def forward(self, state):
        action_pred = self.actor(state)
        value_pred = self.critic(state)
return action_pred, value_predUseremo le reti definite sopra per creare un actor e un critic. Quindi creeremo un agente che includa actor e critic.
Prima di creare l’agente, inizializza i parametri della rete:
Il codice seguente mostra come dichiarare le reti di actor e critic basate sul backbone:
def create_agent(hidden_dimensions, dropout):
    INPUT_FEATURES = env_train.observation_space.shape[0]
    HIDDEN_DIMENSIONS = hidden_dimensions
    ACTOR_OUTPUT_FEATURES = env_train.action_space.n
    CRITIC_OUTPUT_FEATURES = 1
    DROPOUT = dropout
    actor = BackboneNetwork(
            INPUT_FEATURES, HIDDEN_DIMENSIONS, ACTOR_OUTPUT_FEATURES, DROPOUT)
    critic = BackboneNetwork(
            INPUT_FEATURES, HIDDEN_DIMENSIONS, CRITIC_OUTPUT_FEATURES, DROPOUT)
    agent = ActorCritic(actor, critic)
return agentL’ambiente fornisce una ricompensa passando da uno step al successivo, in base all’azione dell’agente. La ricompensa, R, è espressa come:

Il return è definito come il valore accumulato delle ricompense future attese. Le ricompense in timestep più lontani nel futuro valgono meno delle ricompense immediate. Perciò, il return è comunemente calcolato come return scontato, G, definito come:

In questo tutorial (e in molte altre fonti), con return si intende il return scontato.
Per calcolare il return:
La funzione calculate_returns() esegue questi calcoli, come mostrato di seguito:
def calculate_returns(rewards, discount_factor):
    returns = []
    cumulative_reward = 0
    for r in reversed(rewards):
        cumulative_reward = r + cumulative_reward * discount_factor
        returns.insert(0, cumulative_reward)
    returns = torch.tensor(returns)
    # normalize the return
    returns = (returns - returns.mean()) / returns.std()
return returnsL’advantage è calcolato come differenza tra il valore predetto dal critic e il return atteso dalle azioni scelte dall’actor secondo la politica. Per una data azione, l’advantage esprime il beneficio di compiere quella specifica azione rispetto a un’azione arbitraria (media).
Nell’articolo originale su PPO (equazione 10), l’advantage, guardando avanti fino al timestep T, è espresso come:

Nel codice, il vincolo di guardare avanti fino a un numero fissato di timestep è applicato tramite la dimensione del batch. Quindi, l’equazione può essere semplificata come differenza tra il valore e i return attesi. I return attesi sono quantificati nella funzione di valore stato-azione, Q.
La formula semplificata sotto esprime quindi l’advantage di scegliere:
Ed è espressa come:

OpenAI usa anche questa formula per implementare l’RL. La funzione calculate_advantages() mostrata sotto calcola l’advantage:
def calculate_advantages(returns, values):
    advantages = returns - values
    # Normalize the advantage
    advantages = (advantages - advantages.mean()) / advantages.std()
return advantagesLa policy loss, senza tecniche speciali come PPO, sarebbe la classica loss del policy gradient standard. La policy gradient loss standard è calcolata come prodotto di:
La policy gradient loss standard non può correggere cambiamenti bruschi della politica. La surrogate loss modifica la loss standard per limitare l’ampiezza del cambiamento della politica a ogni iterazione. È il minimo tra due quantità:
Nel processo di ottimizzazione, la surrogate loss è usata come proxy della loss effettiva.
Il rapporto di politica, R, è la differenza tra la nuova e la vecchia politica ed è dato dal rapporto tra le probabilità logaritmiche della politica sotto i nuovi e i vecchi parametri:
Il rapporto di politica troncato, R', è vincolato in modo tale che:
Dato l’advantage, At, come mostrato nella sezione precedente, e il rapporto di politica come sopra, la surrogate loss si calcola come:
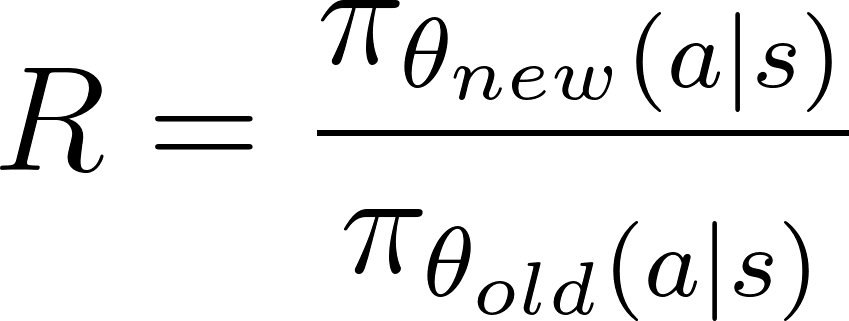
Il codice qui sotto mostra come implementare il meccanismo di clipping e la surrogate loss.
def calculate_surrogate_loss(
        actions_log_probability_old,
        actions_log_probability_new,
        epsilon,
        advantages):
    advantages = advantages.detach()
    policy_ratio = (
            actions_log_probability_new - actions_log_probability_old
            ).exp()
    surrogate_loss_1 = policy_ratio * advantages
    surrogate_loss_2 = torch.clamp(
            policy_ratio, min=1.0-epsilon, max=1.0+epsilon
            ) * advantages
    surrogate_loss = torch.min(surrogate_loss_1, surrogate_loss_2)
return surrogate_lossOra addestriamo l’agente.
Siamo pronti a calcolare le loss di policy e di valore:
Entrambe le loss, come calcolate sopra, sono tensori. La discesa del gradiente si basa su valori scalari. Per ottenere un singolo valore scalare che rappresenti la loss, usa la funzione .sum() per sommare gli elementi del tensore. La funzione seguente mostra come fare:
def calculate_losses(
        surrogate_loss, entropy, entropy_coefficient, returns, value_pred):
    entropy_bonus = entropy_coefficient * entropy
    policy_loss = -(surrogate_loss + entropy_bonus).sum()
    value_loss = f.smooth_l1_loss(returns, value_pred).sum()
return policy_loss, value_lossPrima di iniziare il training, crea un set di buffer come array vuoti. L’algoritmo di training userà questi buffer per salvare informazioni sulle azioni dell’agente, sugli stati dell’ambiente e sulle ricompense a ogni timestep. La funzione seguente inizializza questi buffer:
def init_training():
    states = []
    actions = []
    actions_log_probability = []
    values = []
    rewards = []
    done = False
    episode_reward = 0
    return states, actions, actions_log_probability, values, rewards, done, episode_reward
Ogni iterazione di training esegue l’agente con i parametri di politica di quell’iterazione. L’agente interagisce con l’ambiente in timestep in un loop finché non raggiunge una condizione terminale.
Dopo ogni timestep, l’azione dell’agente, la ricompensa e il valore vengono aggiunti ai rispettivi buffer. Quando l’episodio termina, la funzione restituisce il set aggiornato di buffer, che riassume i risultati dell’episodio.
Prima di eseguire il training loop:
agent.train(). env.reset(). Questo è lo stato iniziale per questa iterazione di training. I passaggi seguenti spiegano cosa succede a ogni timestep nel training loop:
dist.sample() esegue questa operazione. env.step() per passare questa azione all’ambiente e simulare la risposta per questo timestep. In base all’azione dell’agente, l’ambiente genera:done (indica se l’ambiente ha raggiunto uno stato terminale)L’episodio di training termina quando la funzione env.step() restituisce true per il valore booleano done.
Dopo la terminazione dell’episodio, usa i valori accumulati a ogni timestep per calcolare i return cumulati dell’episodio sommando le ricompense di ciascun timestep. Usiamo la funzione calculate_returns() descritta prima. Gli input di questa funzione sono il fattore di sconto e il buffer con le ricompense di ogni timestep. Usiamo questi return e i valori accumulati a ogni timestep per calcolare gli advantage con la funzione calculate_advantages().
La funzione Python seguente mostra come implementare questi passaggi:
def forward_pass(env, agent, optimizer, discount_factor):
    states, actions, actions_log_probability, values, rewards, done, episode_reward = init_training()
    state = env.reset()
    agent.train()
    while not done:
        state = torch.FloatTensor(state).unsqueeze(0)
        states.append(state)
        action_pred, value_pred = agent(state)
        action_prob = f.softmax(action_pred, dim=-1)
        dist = distributions.Categorical(action_prob)
        action = dist.sample()
        log_prob_action = dist.log_prob(action)
        state, reward, done, _ = env.step(action.item())
        actions.append(action)
        actions_log_probability.append(log_prob_action)
        values.append(value_pred)
        rewards.append(reward)
        episode_reward += reward
    states = torch.cat(states)
    actions = torch.cat(actions)
    actions_log_probability = torch.cat(actions_log_probability)
    values = torch.cat(values).squeeze(-1)
    returns = calculate_returns(rewards, discount_factor)
    advantages = calculate_advantages(returns, values)
return episode_reward, states, actions, actions_log_probability, advantages, returnsOgni iterazione di training esegue il modello attraverso un episodio completo composto da molti timestep (fino alla condizione terminale). A ogni timestep salviamo i parametri della politica, l’azione dell’agente, i return e gli advantage. Dopo ogni iterazione, aggiorniamo il modello in base alle prestazioni della politica lungo tutti i timestep di quell’iterazione.
Il numero massimo di timestep nell’ambiente CartPole è 500. In ambienti più complessi, i timestep sono molti di più, anche milioni. In tali casi, il dataset dei risultati del training deve essere suddiviso in batch. Il numero di timestep in ciascun batch è chiamato optimization batch size.
Quindi, i passaggi per aggiornare i parametri del modello sono:
.backward() separatamente sulle loss di policy e di valore. Questo aggiorna i gradienti delle funzioni di loss. .step() sull’ottimizzatore per aggiornare i parametri della politica. In questo caso usiamo l’ottimizzatore Adam per bilanciare velocità e robustezza. PPO_STEPS. Ripetere la backward pass su ogni batch è efficiente dal punto di vista computazionale perché aumenta di fatto la dimensione del dataset di training senza dover eseguire ulteriori forward pass. Il numero di step dell’ambiente in ogni alternanza tra campionamento e ottimizzazione è chiamato iteration batch size. Il codice seguente implementa questi passaggi:
def update_policy(
        agent,
        states,
        actions,
        actions_log_probability_old,
        advantages,
        returns,
        optimizer,
        ppo_steps,
        epsilon,
        entropy_coefficient):
    BATCH_SIZE = 128
    total_policy_loss = 0
    total_value_loss = 0
    actions_log_probability_old = actions_log_probability_old.detach()
    actions = actions.detach()
    training_results_dataset = TensorDataset(
            states,
            actions,
            actions_log_probability_old,
            advantages,
            returns)
    batch_dataset = DataLoader(
            training_results_dataset,
            batch_size=BATCH_SIZE,
            shuffle=False)
    for _ in range(ppo_steps):
        for batch_idx, (states, actions, actions_log_probability_old, advantages, returns) in enumerate(batch_dataset):
            # get new log prob of actions for all input states
            action_pred, value_pred = agent(states)
            value_pred = value_pred.squeeze(-1)
            action_prob = f.softmax(action_pred, dim=-1)
            probability_distribution_new = distributions.Categorical(
                    action_prob)
            entropy = probability_distribution_new.entropy()
            # estimate new log probabilities using old actions
            actions_log_probability_new = probability_distribution_new.log_prob(actions)
            surrogate_loss = calculate_surrogate_loss(
                    actions_log_probability_old,
                    actions_log_probability_new,
                    epsilon,
                    advantages)
            policy_loss, value_loss = calculate_losses(
                    surrogate_loss,
                    entropy,
                    entropy_coefficient,
                    returns,
                    value_pred)
            optimizer.zero_grad()
            policy_loss.backward()
            value_loss.backward()
            optimizer.step()
            total_policy_loss += policy_loss.item()
            total_value_loss += value_loss.item()
return total_policy_loss / ppo_steps, total_value_loss / ppo_stepsEseguiamo finalmente l'agente PPO.
Per valutare le prestazioni dell'agente, crea un nuovo ambiente e calcola le ricompense cumulative eseguendo l'agente in questo nuovo ambiente. Devi impostare l'agente in modalità valutazione usando la funzione .eval(). I passaggi sono gli stessi del ciclo di training. Il frammento di codice qui sotto implementa la funzione di valutazione:
def evaluate(env, agent):
    agent.eval()
    rewards = []
    done = False
    episode_reward = 0
    state = env.reset()
    while not done:
        state = torch.FloatTensor(state).unsqueeze(0)
        with torch.no_grad():
            action_pred, _ = agent(state)
            action_prob = f.softmax(action_pred, dim=-1)
        action = torch.argmax(action_prob, dim=-1)
        state, reward, done, _ = env.step(action.item())
        episode_reward += reward
return episode_rewardUseremo la libreria Matplotlib per visualizzare l'andamento del processo di training. La funzione qui sotto mostra come tracciare le ricompense sia del loop di training sia di quello di test:
def plot_train_rewards(train_rewards, reward_threshold):
    plt.figure(figsize=(12, 8))
    plt.plot(train_rewards, label='Training Reward')
    plt.xlabel('Episode', fontsize=20)
    plt.ylabel('Training Reward', fontsize=20)
    plt.hlines(reward_threshold, 0, len(train_rewards), color='y')
    plt.legend(loc='lower right')
    plt.grid()
    plt.show()
def plot_test_rewards(test_rewards, reward_threshold):
plt.figure(figsize=(12, 8))
plt.plot(test_rewards, label='Testing Reward')
plt.xlabel('Episode', fontsize=20)
plt.ylabel('Testing Reward', fontsize=20)
plt.hlines(reward_threshold, 0, len(test_rewards), color='y')
plt.legend(loc='lower right')
plt.grid()
plt.show()Nei grafici di esempio qui sotto mostriamo le ricompense di training e di test, ottenute applicando la policy rispettivamente negli ambienti di training e di test. Nota che la forma di questi grafici apparirà diversa ogni volta che esegui il codice. Questo è dovuto alla casualità intrinseca del processo di training.
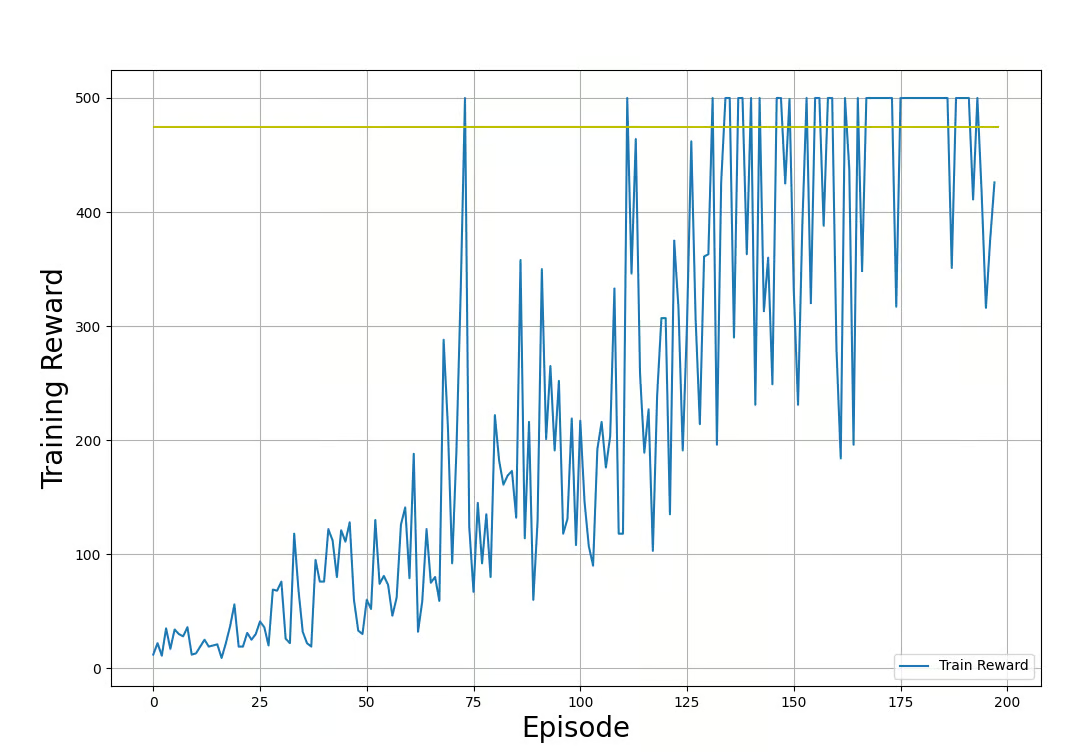
Ricompense di training (ottenute applicando la policy nell'ambiente di training). Immagine dell'autore.
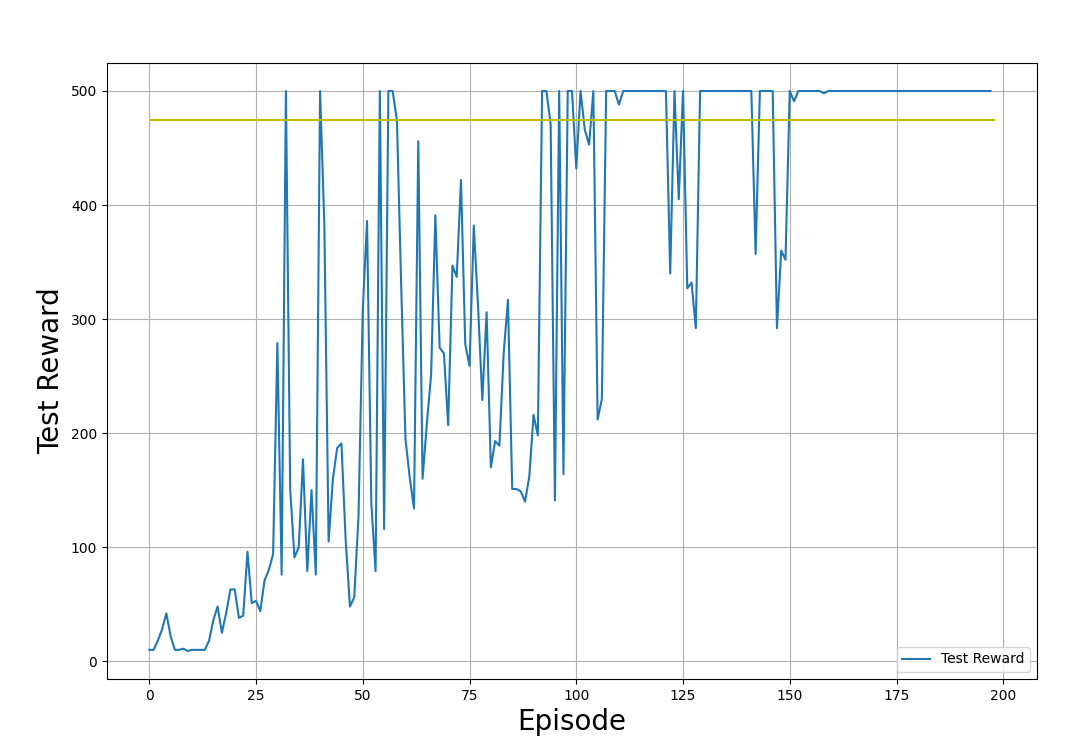
Ricompense di test (ottenute applicando la policy nell'ambiente di test). Immagine dell'autore.
Nei grafici di output mostrati sopra, osserva l'andamento del processo di training:
Allo stesso modo, puoi tracciare le perdite della value function e della policy nel corso delle iterazioni:
def plot_losses(policy_losses, value_losses):
    plt.figure(figsize=(12, 8))
    plt.plot(value_losses, label='Value Losses')
    plt.plot(policy_losses, label='Policy Losses')
    plt.xlabel('Episode', fontsize=20)
    plt.ylabel('Loss', fontsize=20)
    plt.legend(loc='lower right')
    plt.grid()
    plt.show()
Il grafico di esempio qui sotto mostra le perdite tracciate durante gli episodi di training:
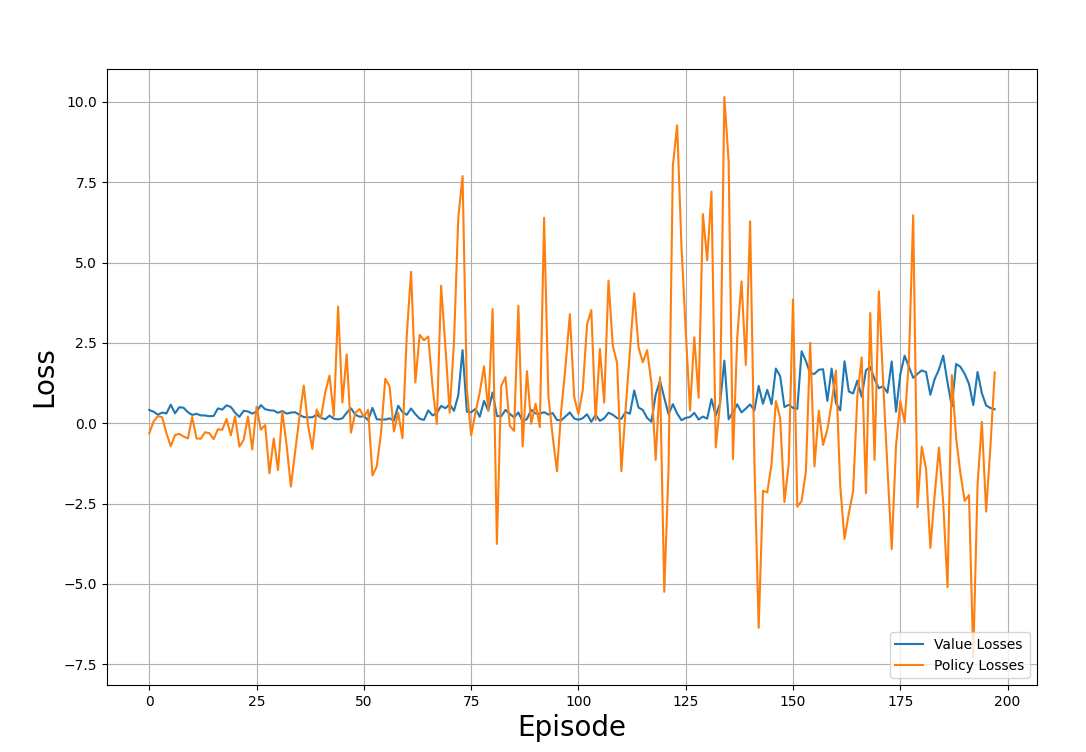
Perdite di value e policy durante il processo di training. Immagine dell'autore
Osserva il grafico e nota:
Ora hai tutti i componenti per addestrare l'agente usando PPO. Per mettere tutto insieme, devi:
create_agent().forward_pass() e update_policy(). evaluate(). Il codice qui sotto mostra come dichiarare in Python una funzione che fa tutto questo:
def run_ppo():
    MAX_EPISODES = 500
    DISCOUNT_FACTOR = 0.99
    REWARD_THRESHOLD = 475
    PRINT_INTERVAL = 10
    PPO_STEPS = 8
    N_TRIALS = 100
    EPSILON = 0.2
    ENTROPY_COEFFICIENT = 0.01
    HIDDEN_DIMENSIONS = 64
    DROPOUT = 0.2
    LEARNING_RATE = 0.001
    train_rewards = []
    test_rewards = []
    policy_losses = []
    value_losses = []
    agent = create_agent(HIDDEN_DIMENSIONS, DROPOUT)
    optimizer = optim.Adam(agent.parameters(), lr=LEARNING_RATE)
    for episode in range(1, MAX_EPISODES+1):
        train_reward, states, actions, actions_log_probability, advantages, returns = forward_pass(
                env_train,
                agent,
                optimizer,
                DISCOUNT_FACTOR)
        policy_loss, value_loss = update_policy(
                agent,
                states,
                actions,
                actions_log_probability,
                advantages,
                returns,
                optimizer,
                PPO_STEPS,
                EPSILON,
                ENTROPY_COEFFICIENT)
        test_reward = evaluate(env_test, agent)
        policy_losses.append(policy_loss)
        value_losses.append(value_loss)
        train_rewards.append(train_reward)
        test_rewards.append(test_reward)
        mean_train_rewards = np.mean(train_rewards[-N_TRIALS:])
        mean_test_rewards = np.mean(test_rewards[-N_TRIALS:])
        mean_abs_policy_loss = np.mean(np.abs(policy_losses[-N_TRIALS:]))
        mean_abs_value_loss = np.mean(np.abs(value_losses[-N_TRIALS:]))
        if episode % PRINT_INTERVAL == 0:
            print(f'Episode: {episode:3} | \
                  Mean Train Rewards: {mean_train_rewards:3.1f} \
                  | Mean Test Rewards: {mean_test_rewards:3.1f} \
                  | Mean Abs Policy Loss: {mean_abs_policy_loss:2.2f} \
                  | Mean Abs Value Loss: {mean_abs_value_loss:2.2f}')
        if mean_test_rewards >= REWARD_THRESHOLD:
            print(f'Reached reward threshold in {episode} episodes')
            break
    plot_train_rewards(train_rewards, REWARD_THRESHOLD)
    plot_test_rewards(test_rewards, REWARD_THRESHOLD)
    plot_losses(policy_losses, value_losses)
Esegui il programma:
run_ppo()L'output dovrebbe assomigliare all'esempio qui sotto:
Episode:  10 | Mean Train Rewards: 22.3 | Mean Test Rewards: 30.4 | Mean Abs Policy Loss: 0.37 | Mean Abs Value Loss: 0.39
Episode:  20 | Mean Train Rewards: 38.6 | Mean Test Rewards: 69.8 | Mean Abs Policy Loss: 0.46 | Mean Abs Value Loss: 0.37
.
.
.
Episode: 100 | Mean Train Rewards: 289.5 | Mean Test Rewards: 427.3 | Mean Abs Policy Loss: 1.73 | Mean Abs Value Loss: 0.21
Episode: 110 | Mean Train Rewards: 357.7 | Mean Test Rewards: 461.4 | Mean Abs Policy Loss: 1.86 | Mean Abs Value Loss: 0.22
Reached reward threshold in 116 episodes
Puoi visualizzare ed eseguire il programma funzionante in questo notebook DataLab!
Nel machine learning, gli iperparametri controllano il processo di training. Di seguito spiego alcuni degli iperparametri importanti usati in PPO:
PPO_STEPS. In ambienti complessi, eseguire molte volte il forward pass è costoso dal punto di vista computazionale. Un'alternativa più efficiente è ri-eseguire ogni batch alcune volte. In genere si consiglia un valore tra 5 e 10. N_TRIALS. Quando è impostata su un valore più alto, il training richiede più tempo perché la policy deve raggiungere la soglia di ricompensa su più episodi. Inoltre, porta a una policy più robusta ma più costosa computazionalmente. Nota che PPO è una policy stocastica e ci saranno episodi in cui l'agente non supera la soglia. Quindi, se il valore di N_TRIALS è troppo alto, il tuo training potrebbe non terminare.Ottimizzare le prestazioni del training di algoritmi PPO richiede prove ed errori ed esperimenti con diversi valori di iperparametri. Tuttavia, ci sono alcune linee guida generali:
Dopo aver spiegato i concetti e i dettagli implementativi di PPO, vediamo ora le sfide e le buone pratiche.
Anche se PPO è ampiamente usato, devi conoscere le possibili criticità per risolvere con successo problemi reali con questa tecnica. Alcune di queste sfide sono:
Per ottenere buoni risultati con PPO, raccomando alcune best practice, tra cui:
PPO_STEPS. In questo articolo abbiamo discusso PPO come metodo per risolvere problemi di RL. Abbiamo poi dettagliato i passaggi per implementare PPO con PyTorch. Infine, abbiamo presentato alcuni suggerimenti di performance e best practice per PPO.
Il modo migliore per imparare è implementare tu stesso il codice. Puoi anche modificare il codice per funzionare con altri ambienti di controllo classici in Gym. Per imparare come implementare agenti RL usando Python e Gymnasium di OpenAI, segui il corso Reinforcement Learning with Gymnasium in Python!
Scopri di più sul machine learning con questi corsi!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



