
Cursus
Big Data Fundamentals met PySpark
4 uur
67K
PySpark is de Python-API voor Apache Spark, ontworpen voor parallelle en gedistribueerde gegevensverwerking over clusters. De juiste join-operatie kiezen voor jouw behoeften beïnvloedt de snelheid van je job, het verbruik van resources en het algehele succes.
Werken met omvangrijke datasets betekent vaak data integreren uit meerdere bronnen. Deze informatie effectief combineren is essentieel voor nauwkeurige analyses en waardevolle inzichten. PySpark-joins bieden krachtige manieren om afzonderlijke datasets te combineren op basis van gedeelde sleutels.
Inefficiënte joins kunnen echter de snelheid en betrouwbaarheid van je gegevensverwerking ernstig aantasten wanneer je werkt met enorme datasets met miljoenen of zelfs miljarden records over gedistribueerde clusters.
Heb je joins meegemaakt die traag analyseren of zelfs falen bij grootschalige data? Dan is deze gids voor jou. Hij helpt beginnende tot gevorderde data scientists, developers en engineers om beheersing en vertrouwen te krijgen bij het uitvoeren van PySpark-joins.
Wil je hands-on oefenen om vertrouwd te raken met PySpark? Bekijk dan onze skill track Big Data with PySpark.
Zoals je zult ontdekken in onze blogpost Leer PySpark vanaf nul, is een van de belangrijkste functies van PySpark de mogelijkheid om grote datasets samen te voegen. PySpark-join-operaties zijn essentieel om grote datasets te combineren op basis van gedeelde kolommen, waardoor efficiënte dataintegratie, vergelijking en analyse op schaal mogelijk wordt.
Ze spelen een cruciale rol bij het verwerken van big data door relaties bloot te leggen en betekenisvolle inzichten te halen uit gedistribueerde databronnen.
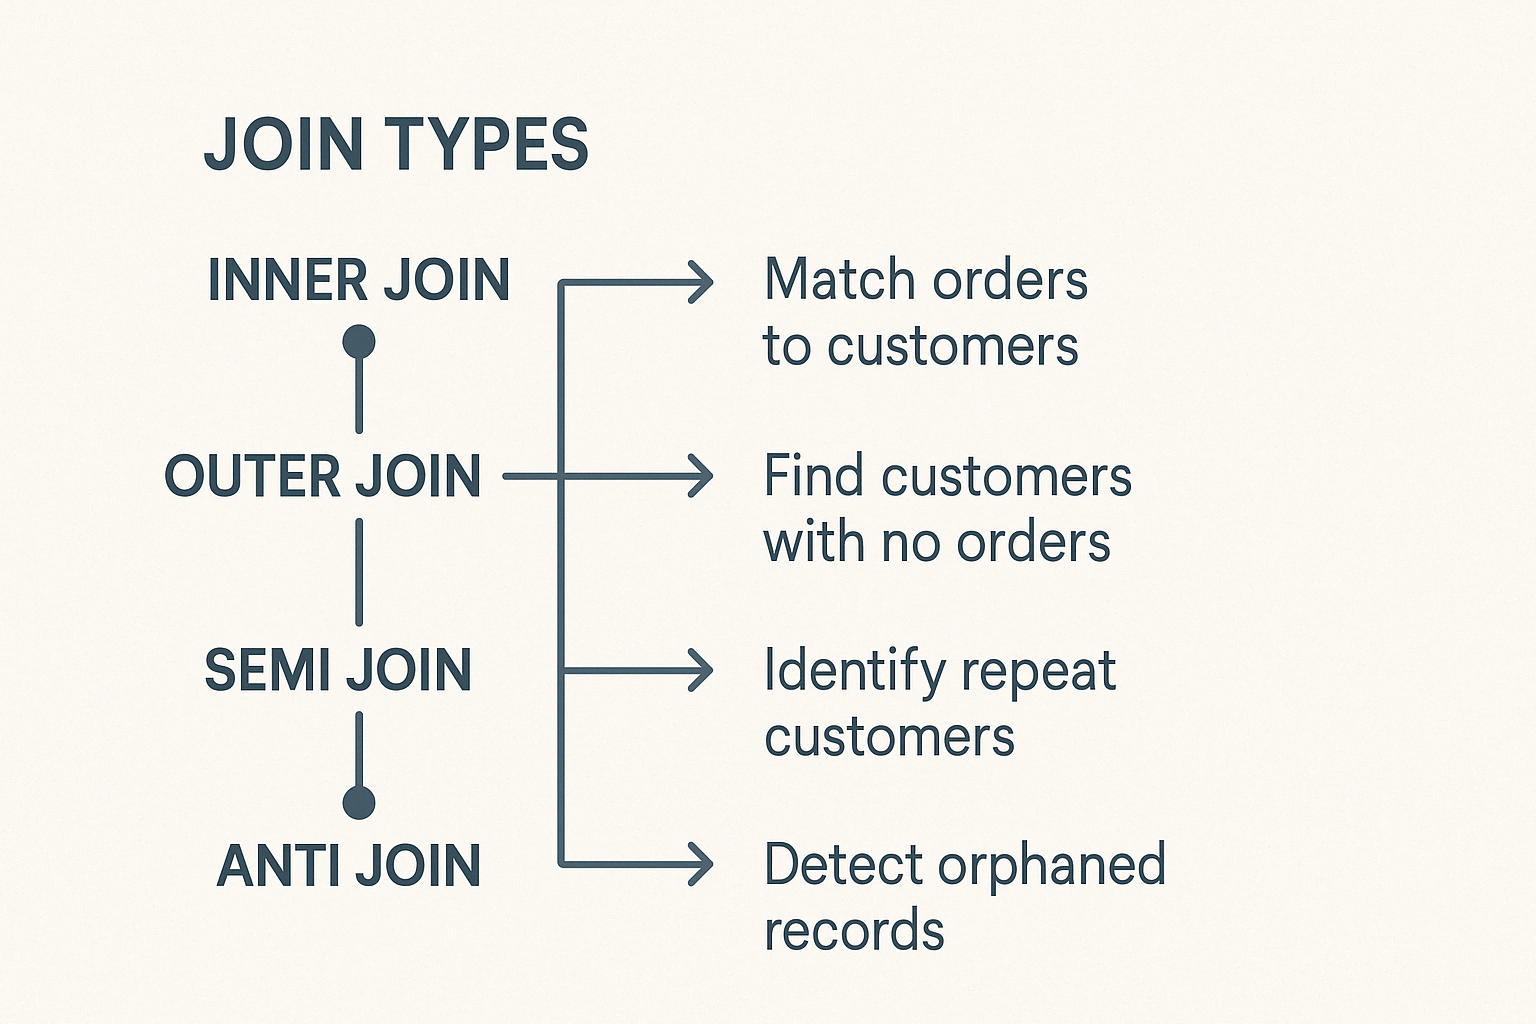
PySpark biedt verschillende soorten joins, zoals inner joins, outer joins, left- en right-joins, semi-joins en anti-joins, die elk voor verschillende analytische doelen dienen.
Werken met joins op grote datasets kan echter uitdagingen opleveren, zoals scheefgetrokken data (skew), shuffle-overhead en geheugengrenzen. Daarom is het cruciaal om de juiste join-strategie te kiezen voor prestaties en nauwkeurigheid.
Inzicht in de interne werking van PySpark is essentieel voor het efficiënt joinen van grote datasets, zoals we laten zien in onze Introductiecursus PySpark. Deze sectie schetst het conceptuele kader achter de join-uitvoering van PySpark en de rol van de optimizer.
PySpark voert joins uit in een gedistribueerde rekenomgeving, wat betekent dat het grote datasets opsplitst in kleinere partitities en ze parallel verwerkt over een cluster van machines. Wanneer een join wordt gestart, verdeelt PySpark het werk over deze nodes, met als doel een gebalanceerde verwerking om de uitvoering te versnellen en knelpunten te vermijden.
De kern van dit proces is Catalyst, Sparks krachtige query-optimalisatie-engine. Catalyst bepaalt hoe join-operaties worden uitgevoerd. Het beslist over partitioneringsstrategieën, detecteert wanneer data-shuffling nodig is en past prestatie-optimalisaties toe zoals predicate pushdown en broadcast-joins. Deze geautomatiseerde optimalisatie zorgt voor efficiënte uitvoering zonder dat handmatige tuning door de developer nodig is.
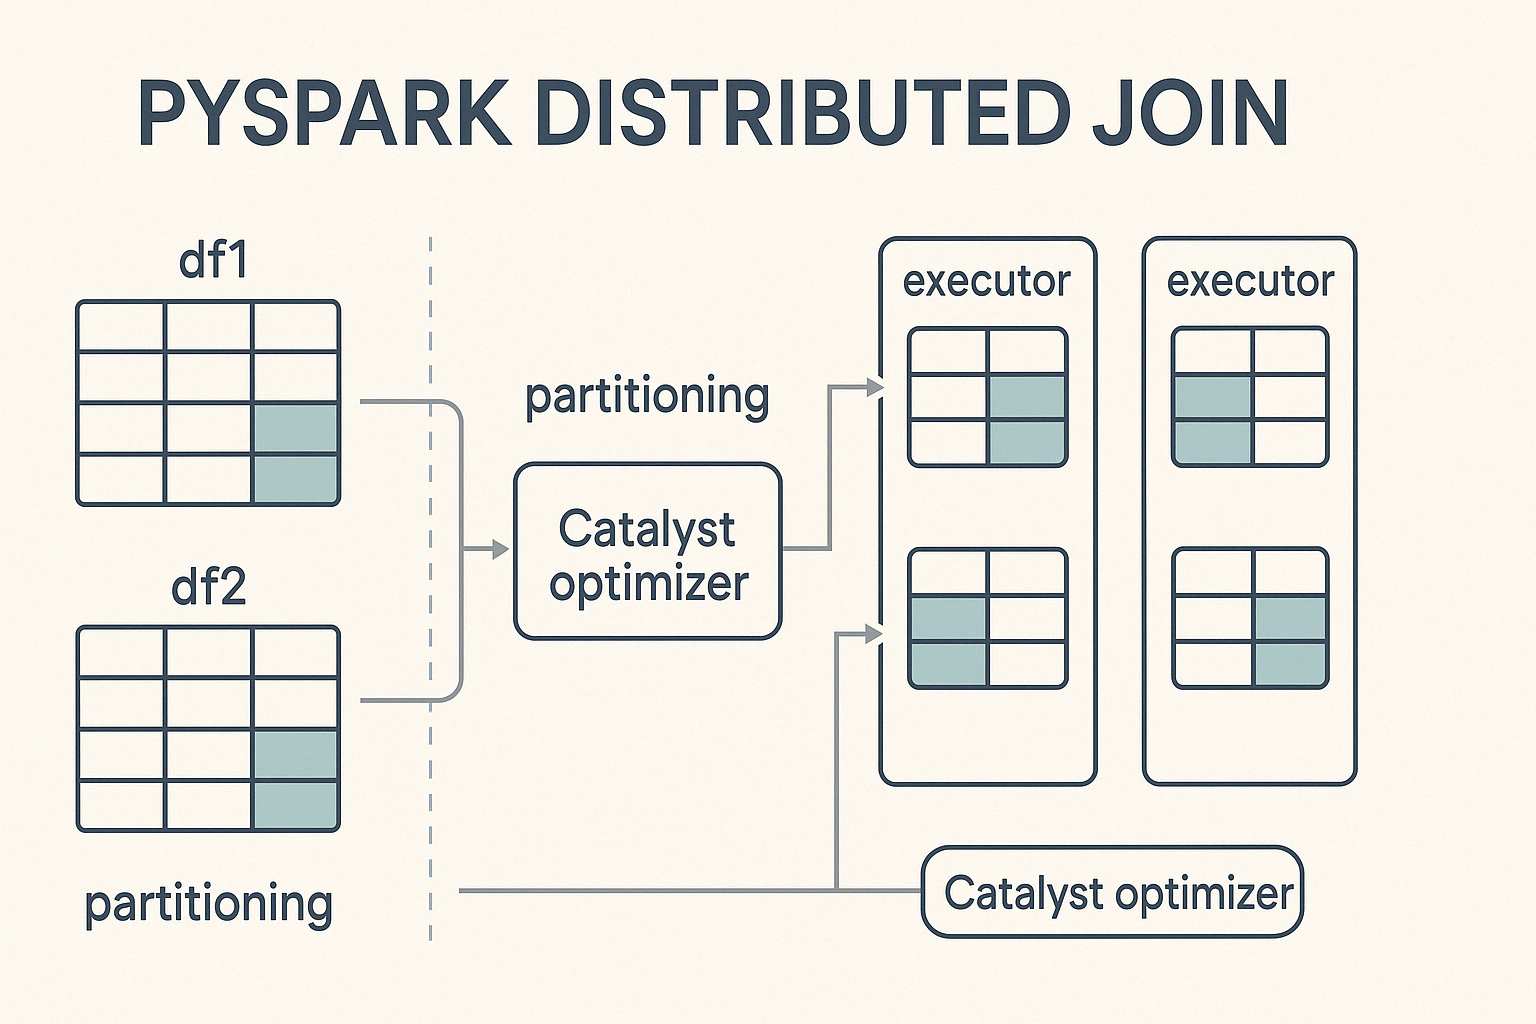
Om joins in PySpark uit te voeren, volg je een eenvoudige syntaxis waarbij je de DataFrames, een join-voorwaarde en het type join opgeeft dat je wilt uitvoeren.
from pyspark.sql import SparkSession

# Initialize Spark session
spark = SparkSession.builder.appName("PySpark Joins Example").getOrCreate()

# Perform a join
joined_df = df1.join(df2, on="key", how="inner")
In dit voorbeeld:
df1 en df2 zijn de DataFrames die je wilt joinen.df1.key == df2.key is de join-voorwaarde, die bepaalt hoe rijen uit elk DataFrame moeten worden gematcht.inner' specifies the join type, which could also be left, right,, outer, semi, or anti` depending on the desired result.Volg onze Getting Started with PySpark-tutorial voor instructies om PySpark te installeren en bovenstaande joins zonder fouten uit te voeren.
PySpark bevat verschillende soorten joins, elk geschikt voor specifieke datataken. Door ze te begrijpen, kies je bewuster.
De inner join combineert rijen uit twee DataFrames wanneer er overeenkomende sleutels in beide bestaan. Rijen zonder overeenkomstige sleutels worden uitgesloten. Dit is het meest gebruikte en standaard join-type in PySpark.
Typische gebruikssituaties zijn:
PySpark ondersteunt left, right en full outer joins.
De left outer join geeft alle rijen van het linker DataFrame terug en de overeenkomende rijen uit het rechter DataFrame. Wanneer er geen overeenkomstige sleutel in het rechter DataFrame staat, worden de rechterkolommen met null-waarden gevuld.
Use cases:
De right outer join spiegelt de logica van de left join. Hij geeft alle rijen van het rechter DataFrame terug en de overeenkomende rijen uit het linker DataFrame, waarbij ontbrekende matches uit de linkerkolommen met nulls worden gevuld.
Voorbeeldscenario:
De full outer join geeft alle beschikbare rijen uit beide DataFrames terug, waarbij niet-overeenkomende items met nulls worden gevuld. Dit helpt om discrepanties of datalacunes tussen twee datasets op te sporen.
Semi- en anti-joins hebben een gespecialiseerde functie:
Een semi-join geeft rijen terug uit het linker DataFrame waarvoor overeenkomende sleutels bestaan in het rechter DataFrame. Hij voegt geen kolommen uit het rechter DataFrame toe en vermijdt duplicaten, waardoor hij ideaal is voor existence-checks.
Voorbeeld use case:
Een anti-join geeft rijen terug uit één DataFrame die geen overeenkomende sleutel hebben in het tweede DataFrame.
Voorbeeld use case:
Cross joins genereren data door elke rij in het ene DataFrame te paren met elke rij in een ander. Tenzij expliciet gewenst, vermijd cross joins, omdat ze datasets drastisch vergroten.
Gebruik ze met beleid voor specifieke scenario’s zoals:
Grootschalige joins vereisen zorgvuldige optimalisatie. Overweeg de volgende technieken:
Broadcast-joins verbeteren de prestaties door kleinere DataFrames naar alle nodes te repliceren, waardoor dure shuffles worden geëlimineerd.
Voorbeeldsyntaxis:
from pyspark.sql.functions import broadcast

joined_df = large_df.join(broadcast(small_df), "id", "inner")
Houd rekening met de geheugengrenzen van je systeem; het broadcasten van te grote DataFrames werkt niet effectief.
Data skew betekent dat data ongelijk over partitities is verdeeld, wat knelpunten veroorzaakt. Technieken om skew te verminderen zijn onder meer:
Efficiënte join-prestaties in PySpark hangen sterk af van het minimaliseren van shuffle-overhead, die optreedt wanneer data over nodes moet worden verplaatst om aan join-voorwaarden te voldoen. Een van de meest effectieve manieren om deze overhead te verminderen, is door de partitities van de te joinen DataFrames op elkaar af te stemmen.
Houd deze best practices in gedachten:
repartition() of broadcast() verstandig: Gebruik repartition() voor grote datasets waarbij een gelijkmatige verdeling mogelijk is, en broadcast() voor aanzienlijk kleinere tabellen om shuffling volledig te vermijden.PySpark bevat gespecialiseerde mechanismen voor veeleisendere gevallen, waarmee je nog meer efficiëntie kunt halen:
Range-joins gebruik je als je rijen matcht op basis van numerieke of tijdgebaseerde voorwaarden in plaats van exacte gelijkheid. Deze joins zijn gebruikelijk in scenario’s met tijdreeksdata, zoals loganalyse, event-tracking of IoT-sensorstreams.
Best practices voor efficiënte range-joins zijn onder meer:
rangeBetween of between.Voorbeelden van use cases zijn:
Joins met streamingdata brengen unieke uitdagingen met zich mee vanwege het continue en vaak onvoorspelbare karakter. Belangrijke kwesties zijn laat binnenkomende events, out-of-order data en de noodzaak om state efficiënt in de tijd te beheren.
PySpark pakt deze uitdagingen aan met watermarks, die een drempel definiëren voor hoe lang het systeem op late data moet wachten voordat het wordt weggegooid. Door een watermark in te stellen op event-time-kolommen kan PySpark late data efficiënt beheren en het resourceverbruik optimaliseren.
Watermarks zijn vooral nuttig bij het joinen van twee streamingbronnen of een stream met een statische dataset, zodat zowel prestaties als consistentie in realtime datapijplijnen behouden blijven.
Joins spelen een cruciale rol bij het voorbereiden van data voor machine learning-modellen, bijvoorbeeld bij het bouwen van modellen met Spark MLlib. Het consolideren van deze features in één, uniforme dataset is essentieel voor nauwkeurige modeltraining en -evaluatie.
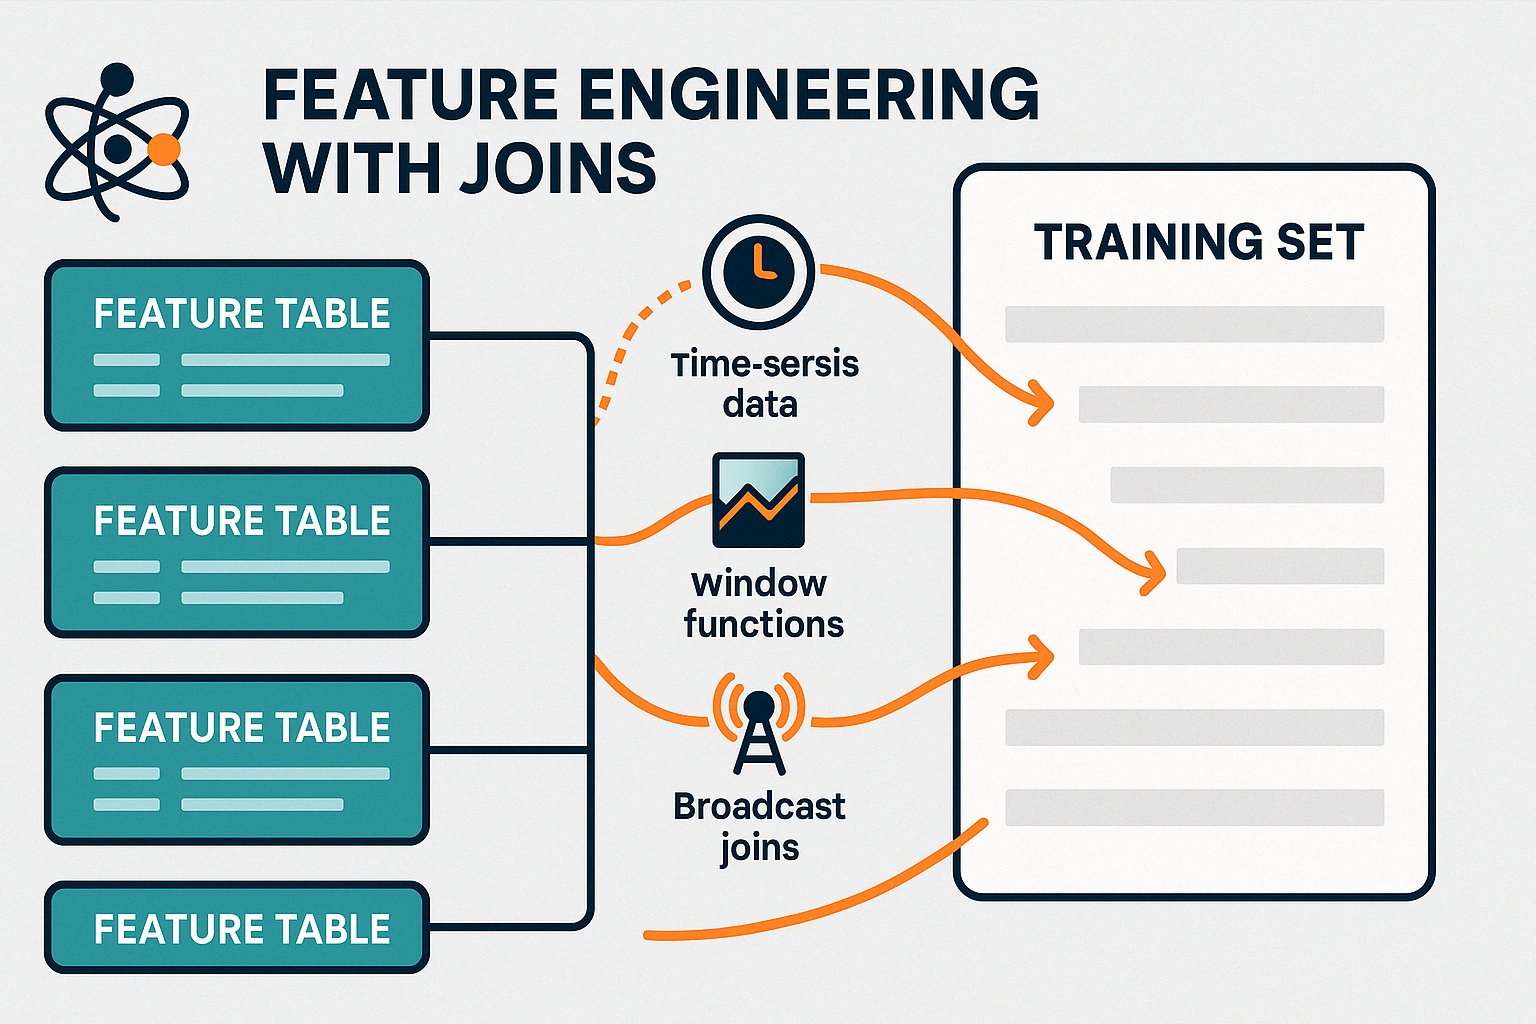
Door deze joins efficiënt te beheren, maakt PySpark realtime feature engineering mogelijk, ter ondersteuning van zowel online leersystemen als up-to-date batch-trainingspijplijnen.
Je kunt leren hoe je voorspellingen doet met data in Apache Spark, met decision trees, logistische regressie, lineaire regressie, ensembles en pipelines in onze Machine Learning with PySpark-cursus.
Join-operaties in gedistribueerd rekenen vereisen regelmatige aandacht om potentiële problemen te voorkomen.
Efficiënte join-operaties kunnen de algehele pijplijnsnelheid en het resourcegebruik drastisch verbeteren. Dit zijn belangrijke praktijken om te volgen:
repartition() of coalesce() om partitiegroottes aan te passen voor meer gebalanceerde parallelle verwerking.Zelfs kleine misstappen in join-logica kunnen leiden tot grote problemen in prestaties of datanauwkeurigheid. Dit zijn veelvoorkomende valkuilen om op te letten:
Zelfs goed gestructureerde joins kunnen prestatie- of uitvoeringsproblemen tegenkomen.
Dit zijn veelvoorkomende problemen en hoe je ze aanpakt:
PySpark-joins zijn een hoeksteen van grootschalige gegevensverwerking en maken krachtige en efficiënte analyses over enorme datasets mogelijk. Correct toegepast onthullen ze betekenisvolle relaties die leiden tot diepere inzichten en slimmere beslissingen.
Hoewel performance-tuning uitdagingen kan opleveren, zoals het omgaan met data skew of het optimaliseren van partitionering, is het beheersen van deze aspecten de sleutel tot het bouwen van robuuste datapijplijnen.
Of je nu realtime streams joint of features consolideert voor machine learning: het verfijnen van je join-strategieën kan de uitvoeringstijd, resource-efficiëntie en analytische precisie aanzienlijk verbeteren.
Wil je dieper duiken in bigdata-verwerking met PySpark en werken aan je expertise in data engineering? Bekijk dan onze Big Data Fundamentals with PySpark skill track.
Topcursussen bij DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

