
Kursus
Fundamental Big Data dengan PySpark
4 jam
67K
PySpark adalah API Python untuk Apache Spark, yang dirancang untuk pemrosesan data paralel dan terdistribusi di seluruh kluster. Memilih operasi join yang tepat untuk kebutuhan Anda memengaruhi kecepatan job, konsumsi sumber daya, dan keberhasilan keseluruhan.
Bekerja dengan dataset yang luas sering kali berarti mengintegrasikan data dari beberapa sumber. Menggabungkan informasi ini secara efektif sangat penting untuk analisis yang akurat dan wawasan yang bermakna. Join PySpark menyediakan cara yang andal untuk menggabungkan dataset terpisah berdasarkan key yang sama.
Namun, join yang tidak efisien dapat sangat memengaruhi kecepatan dan keandalan pemrosesan data saat menangani dataset yang sangat besar berisi jutaan atau bahkan miliaran rekaman di kluster terdistribusi.
Apakah Anda pernah mengalami join yang gagal dengan analisis lambat atau pada data berskala besar? Jika ya, panduan ini untuk Anda. Ini akan membantu data scientist, developer, dan engineer tingkat menengah menguasai dan percaya diri saat melakukan join PySpark.
Jika Anda mencari latihan praktis untuk membiasakan diri dengan PySpark, lihat alur keterampilan Big Data with PySpark kami.
Seperti yang akan Anda temukan dalam posting blog Belajar PySpark dari Nol kami, salah satu fitur utama PySpark adalah kemampuan untuk menggabungkan dataset besar. Operasi join PySpark sangat penting untuk menggabungkan dataset besar berdasarkan kolom yang sama, sehingga memungkinkan integrasi data, perbandingan, dan analisis skala besar yang efisien.
Join memainkan peran penting dalam menangani big data dengan membantu mengungkap hubungan dan mengekstrak wawasan bermakna di seluruh sumber data terdistribusi.
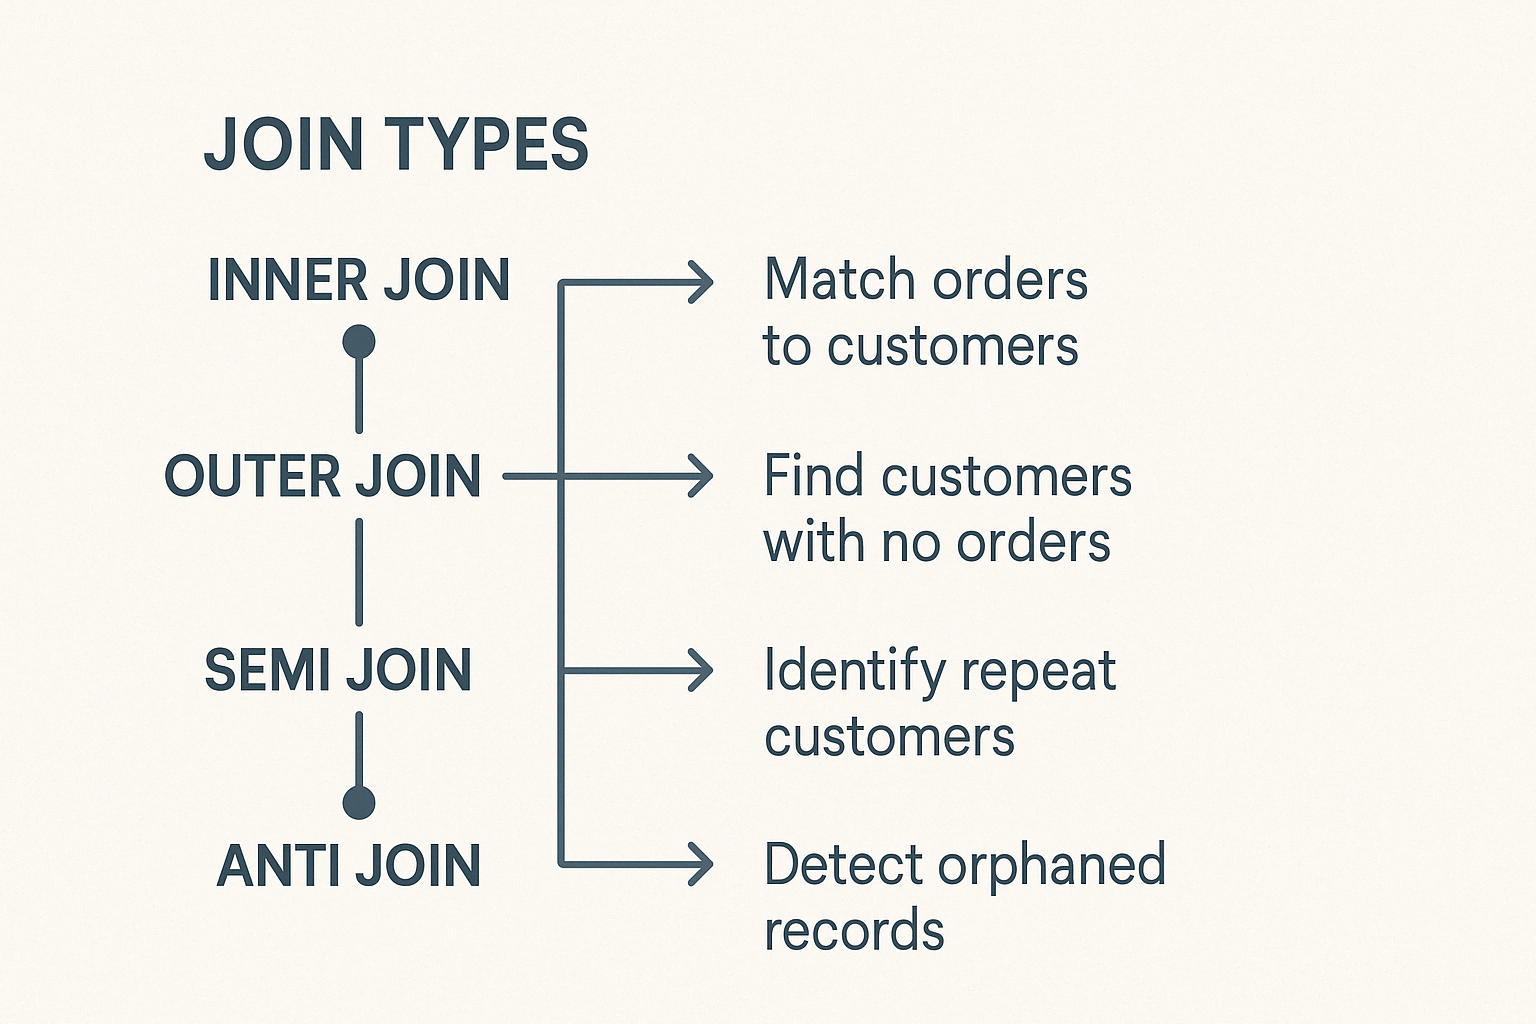
PySpark menawarkan beberapa jenis join, seperti inner join, outer join, left dan right join, semi join, dan anti join, yang masing-masing melayani tujuan analitis berbeda.
Namun, bekerja dengan join pada dataset besar dapat menimbulkan tantangan seperti skew data, beban shuffle, dan keterbatasan memori, sehingga memilih strategi join yang tepat untuk kinerja dan akurasi menjadi sangat krusial.
Memahami operasi internal PySpark sangat penting untuk menggabungkan dataset besar secara efisien, seperti yang kami tunjukkan dalam kursus Introduction to PySpark kami. Bagian ini menguraikan kerangka konseptual di balik eksekusi join PySpark dan peran optimizernya.
PySpark melakukan join dalam lingkungan komputasi terdistribusi, artinya ia membagi dataset besar menjadi partisi-partisi lebih kecil dan memprosesnya secara paralel di seluruh kluster mesin. Ketika sebuah join dipicu, PySpark mendistribusikan pekerjaan di antara node-node ini, bertujuan untuk komputasi yang seimbang guna mempercepat eksekusi dan menghindari bottleneck.
Inti dari proses ini adalah Catalyst, mesin optimasi kueri Spark yang andal. Catalyst menentukan bagaimana operasi join dieksekusi. Ia memutuskan strategi pemartisian, mendeteksi kapan shuffling data diperlukan, dan menerapkan optimasi kinerja seperti predicate pushdown dan broadcast join. Optimasi otomatis ini memastikan eksekusi efisien tanpa memerlukan penyetelan manual dari developer.
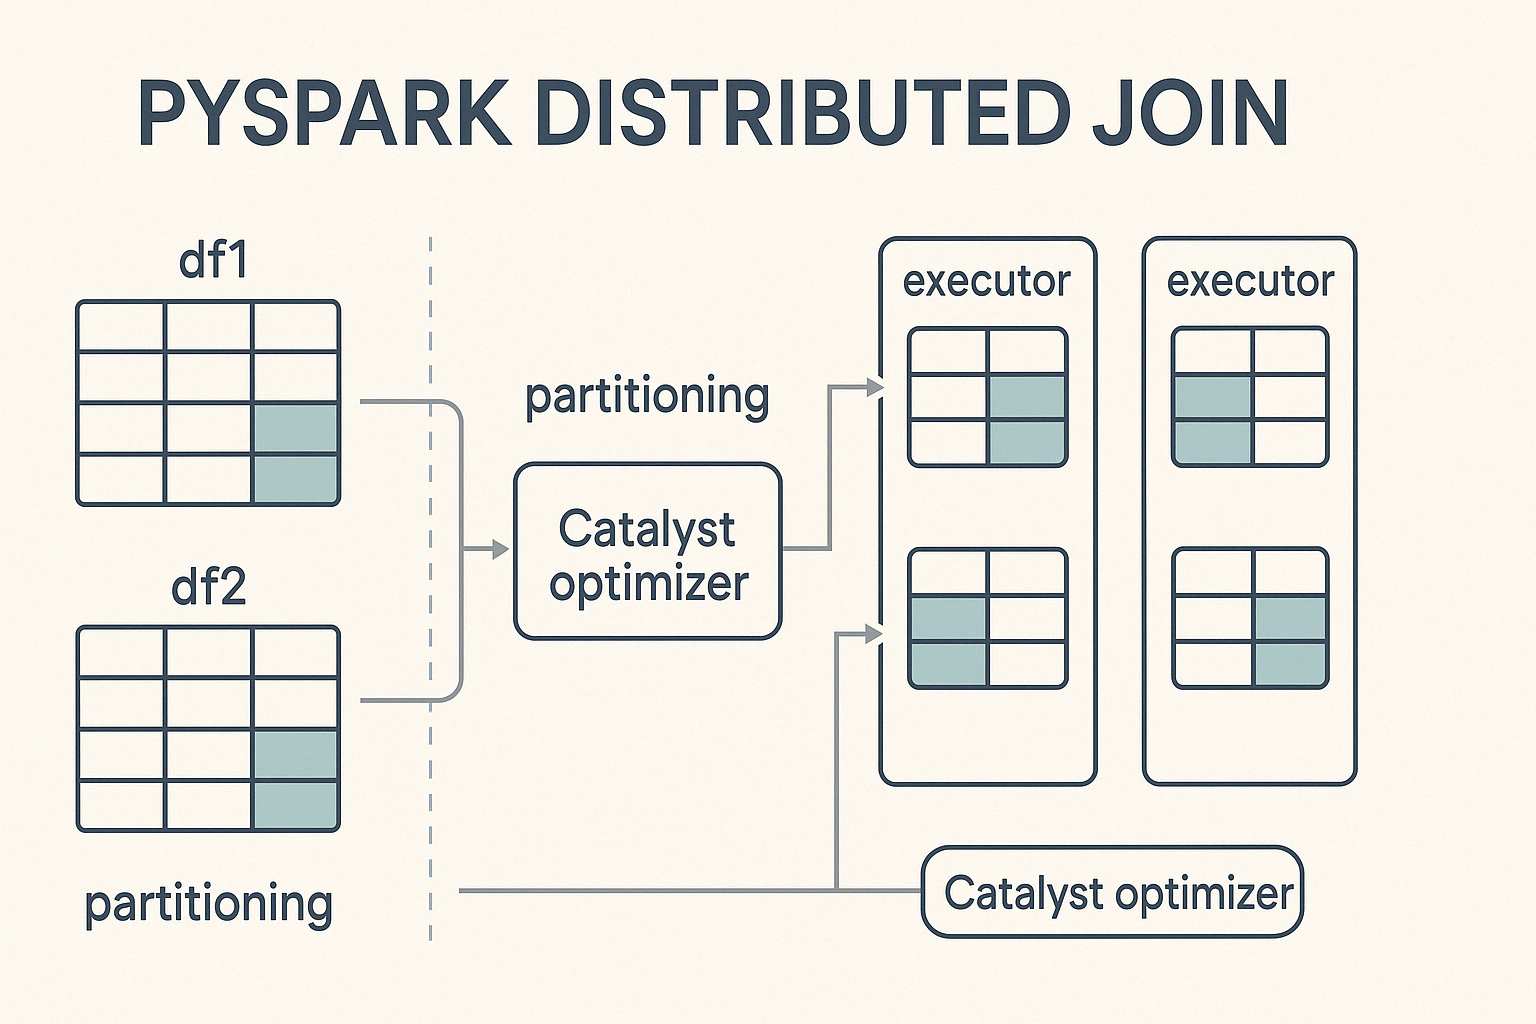
Untuk melakukan join di PySpark, Anda mengikuti sintaks sederhana yang melibatkan penentuan DataFrame, kondisi join, dan jenis join yang akan dijalankan.
from pyspark.sql import SparkSession

# Initialize Spark session
spark = SparkSession.builder.appName("PySpark Joins Example").getOrCreate()

# Perform a join
joined_df = df1.join(df2, on="key", how="inner")
Dalam contoh ini:
df1 dan df2 adalah DataFrame yang akan dijoin.df1.key == df2.key adalah kondisi join, yang menentukan bagaimana baris dari masing-masing DataFrame harus dicocokkan.inner' specifies the join type, which could also be left, right,, outer, semi, or anti` depending on the desired result.Ikuti tutorial Getting Started with PySpark kami untuk petunjuk cara memasang PySpark dan menjalankan join di atas tanpa error.
PySpark mencakup berbagai jenis join, masing-masing cocok untuk tugas data yang berbeda. Memahaminya membantu Anda memilih dengan bijak.
Inner join menggabungkan baris dari dua DataFrame ketika terdapat key yang cocok di keduanya. Baris tanpa key yang cocok akan dikecualikan. Ini adalah jenis join paling umum dan default di PySpark.
Skenario penggunaan umum meliputi:
PySpark mendukung left, right, dan full outer join.
Left outer join mengembalikan semua baris dari DataFrame kiri dan baris yang cocok dari DataFrame kanan. Ketika tidak ada key yang cocok di DataFrame kanan, nilai null akan mengisi kolom di sisi kanan.
Contoh penggunaan:
Right outer join mencerminkan logika left join. Ini mengembalikan semua baris dari DataFrame kanan dan baris yang cocok dari DataFrame kiri, mengisi kecocokan yang hilang dari kolom kiri dengan null.
Contoh skenario:
Full Outer Join mengembalikan semua baris yang tersedia dari kedua DataFrame, mengisi entri yang tidak cocok dengan null. Ini membantu menemukan ketidaksesuaian atau celah data antara dua dataset.
Semi dan anti join melayani fungsi khusus:
Semi join mengembalikan baris dari DataFrame kiri di mana key yang cocok ada di DataFrame kanan. Join ini tidak menambahkan kolom dari DataFrame kanan dan menghindari duplikasi, sehingga ideal untuk pemeriksaan keberadaan.
Contoh kasus penggunaan:
Anti join mengembalikan baris dari satu DataFrame yang tidak memiliki key yang cocok di DataFrame kedua.
Contoh kasus penggunaan:
Cross join membuat data dengan memasangkan setiap baris dalam satu DataFrame dengan setiap baris dari DataFrame lain. Kecuali memang diinginkan, hindari cross join karena akan secara drastis memperbesar dataset.
Gunakan secara hati-hati untuk skenario khusus seperti:
Join berskala besar memerlukan optimasi yang cermat. Pertimbangkan teknik-teknik berikut:
Broadcast join meningkatkan kinerja dengan mereplikasi DataFrame yang lebih kecil ke semua node, menghilangkan shuffle yang mahal.
Contoh sintaks:
from pyspark.sql.functions import broadcast

joined_df = large_df.join(broadcast(small_df), "id", "inner")
Perhatikan batas memori sistem Anda; melakukan broadcast pada DataFrame yang terlalu besar tidak akan bekerja efektif.
Skew data berarti data tidak terdistribusi merata di seluruh partisi, yang menciptakan bottleneck. Teknik untuk mengurangi skew meliputi:
Kinerja join yang efisien di PySpark sangat bergantung pada meminimalkan beban shuffle, yang terjadi ketika data perlu dipindahkan antar-node untuk memenuhi kondisi join. Salah satu cara paling efektif untuk mengurangi beban ini adalah dengan menyelaraskan partisi dari DataFrame yang dijoin.
Ingat praktik terbaik berikut:
repartition() atau broadcast() dengan bijak: Gunakan repartition() untuk dataset besar yang memungkinkan distribusi seragam, dan broadcast() untuk tabel yang jauh lebih kecil agar sepenuhnya menghindari shuffle.PySpark mencakup mekanisme khusus untuk kasus yang lebih menuntut, memungkinkan efisiensi yang lebih besar:
Range join digunakan saat mencocokkan baris berdasarkan kondisi numerik atau berbasis waktu, bukan kesetaraan tepat. Join ini umum pada skenario yang melibatkan data deret waktu, seperti analisis log, pelacakan peristiwa, atau aliran sensor IoT.
Praktik terbaik untuk range join yang efisien meliputi:
rangeBetween atau between.Contoh use case meliputi:
Melakukan join pada data streaming menghadirkan tantangan unik karena sifatnya yang kontinu dan sering kali tidak terduga. Isu utama mencakup peristiwa yang terlambat tiba, data tidak berurutan, dan kebutuhan untuk mengelola state secara efisien dari waktu ke waktu.
PySpark mengatasi tantangan ini menggunakan watermark, yang mendefinisikan ambang batas untuk berapa lama sistem harus menunggu data terlambat sebelum membuangnya. Dengan menetapkan watermark pada kolom event-time, PySpark dapat mengelola data terlambat secara efisien dan mengoptimalkan penggunaan sumber daya.
Watermark sangat berguna saat melakukan join dua sumber streaming atau antara stream dan dataset statis, membantu menjaga kinerja dan konsistensi dalam pipeline data real-time.
Join memainkan peran penting dalam menyiapkan data untuk model machine learning, misalnya saat membangun model dengan Spark MLlib. Mengonsolidasikan fitur-fitur ini ke dalam satu dataset terpadu sangat penting untuk pelatihan dan evaluasi model yang akurat.
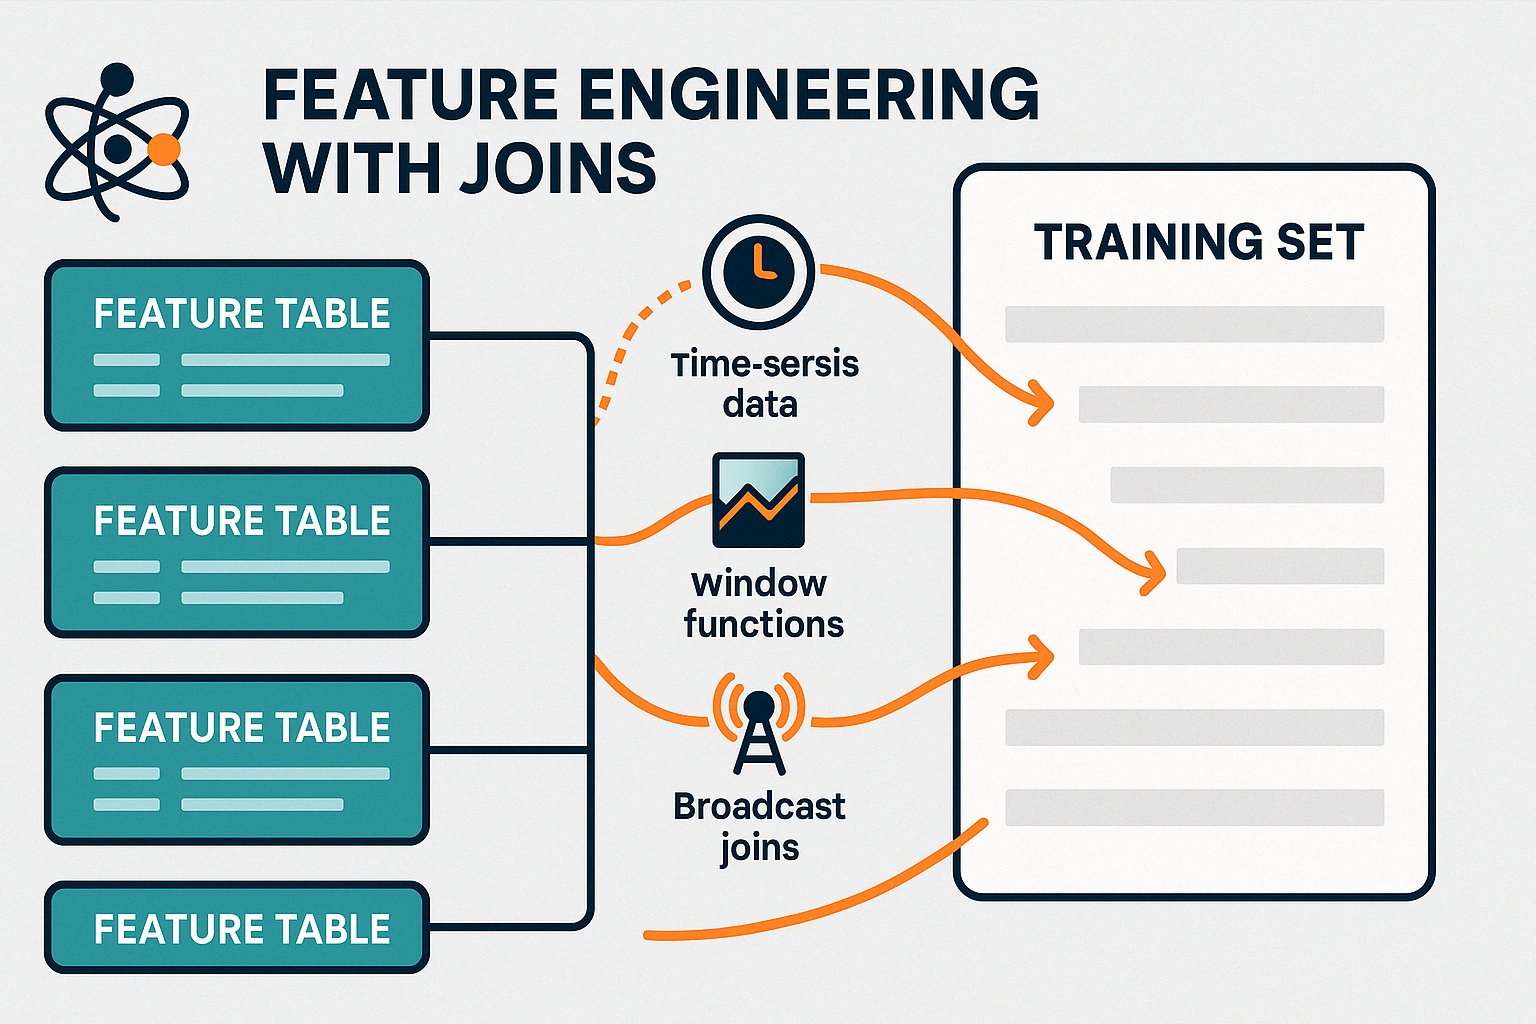
Dengan mengelola join ini secara efisien, PySpark memungkinkan rekayasa fitur real-time, mendukung sistem pembelajaran online dan pipeline pelatihan batch yang selalu mutakhir.
Anda dapat mempelajari cara membuat prediksi dari data dengan Apache Spark, menggunakan decision tree, logistic regression, linear regression, ensemble, dan pipeline melalui kursus Machine Learning with PySpark kami.
Operasi join dalam komputasi terdistribusi memerlukan perhatian rutin untuk menghindari potensi masalah.
Operasi join yang efisien dapat secara drastis meningkatkan kecepatan pipeline keseluruhan dan penggunaan sumber daya. Berikut praktik-praktik kunci yang perlu diikuti:
repartition() atau coalesce() untuk menyesuaikan ukuran partisi agar pemrosesan paralel lebih seimbang.Bahkan kesalahan kecil dalam logika join dapat menyebabkan masalah besar pada kinerja atau akurasi data. Berikut jebakan umum yang perlu diwaspadai:
Bahkan join yang tersusun baik pun dapat mengalami masalah kinerja atau eksekusi.
Berikut masalah umum dan cara menanganinya:
Join PySpark adalah pilar pemrosesan data skala besar, yang memungkinkan analisis yang andal dan efisien di seluruh dataset masif. Jika digunakan dengan benar, join mengungkap hubungan bermakna yang mendorong wawasan lebih dalam dan keputusan yang lebih cerdas.
Walaupun penyetelan kinerja dapat menghadirkan tantangan, seperti menangani skew data atau mengoptimalkan pemartisian, menguasai aspek-aspek ini adalah kunci untuk membangun pipeline data yang andal.
Baik Anda melakukan join pada stream real-time atau mengonsolidasikan fitur untuk machine learning, memperhalus strategi join dapat secara signifikan meningkatkan kecepatan eksekusi, efisiensi sumber daya, dan ketepatan analitis.
Untuk mendalami lebih jauh, jelajahi pemrosesan big data dengan PySpark, dan menuju menjadi pakar rekayasa data melalui alur keterampilan Big Data Fundamentals with PySpark kami.
Kursus Teratas DataCamp
Kursus
Kursus
Kursus
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



