
Corso
Fondamenti di Big Data con PySpark
4 ore
67K
PySpark è l’API Python di Apache Spark, progettata per l’elaborazione di dati in parallelo e in modo distribuito su cluster. Scegliere l’operazione di join corretta per le tue esigenze influisce sulla velocità dei job, sul consumo di risorse e sul successo complessivo.
Lavorare con dataset estesi significa spesso integrare dati da più fonti. Combinare queste informazioni in modo efficace è essenziale per un’analisi accurata e per ottenere insight significativi. I join in PySpark offrono modi potenti per combinare dataset separati basandosi su chiavi condivise.
Tuttavia, join inefficienti possono compromettere gravemente la velocità e l’affidabilità dell’elaborazione dei dati quando si lavora con dataset enormi contenenti milioni o addirittura miliardi di record su cluster distribuiti.
Ti è capitato di eseguire join che falliscono o risultano lenti con dati su larga scala? Se sì, questa guida fa per te. Aiuterà data scientist, sviluppatori e ingegneri di livello intermedio a padroneggiare e affrontare con sicurezza i join in PySpark.
Se cerchi esercizi pratici per prendere confidenza con PySpark, dai un’occhiata alla nostra skill track Big Data with PySpark.
Come scoprirai nel nostro post Impara PySpark da zero, una delle funzionalità principali di PySpark è la capacità di unire grandi dataset. Le operazioni di join in PySpark sono essenziali per combinare grandi dataset basandosi su colonne condivise, consentendo un’integrazione, un confronto e un’analisi dei dati efficienti su larga scala.
Svolgono un ruolo critico nella gestione dei big data, aiutando a scoprire relazioni ed estrarre insight significativi tra fonti distribuite.
PySpark offre diversi tipi di join, come inner join, outer join, left e right join, semi join e anti join, ognuno con finalità analitiche diverse.
Tuttavia, lavorare con join su grandi dataset può introdurre sfide come dati sbilanciati (skew), overhead di shuffle e vincoli di memoria, rendendo cruciale la scelta della strategia di join giusta per prestazioni e accuratezza.
Comprendere il funzionamento interno di PySpark è fondamentale per unire grandi dataset in modo efficiente, come mostriamo nel nostro corso Introduction to PySpark. Questa sezione delinea il quadro concettuale alla base dell’esecuzione dei join in PySpark e il ruolo del suo ottimizzatore.
PySpark esegue i join in un ambiente di calcolo distribuito, il che significa che suddivide grandi dataset in partizioni più piccole e le elabora in parallelo su un cluster di macchine. Quando un join viene attivato, PySpark distribuisce il lavoro tra questi nodi, puntando a un calcolo bilanciato per accelerare l’esecuzione ed evitare colli di bottiglia.
Al centro di questo processo c’è Catalyst, il potente motore di ottimizzazione delle query di Spark. Catalyst determina come vengono eseguite le operazioni di join. Decide le strategie di partizionamento, rileva quando è necessario lo shuffle dei dati e applica ottimizzazioni delle prestazioni come il predicate pushdown e i broadcast join. Questa ottimizzazione automatica garantisce un’esecuzione efficiente senza richiedere tuning manuale da parte dello sviluppatore.
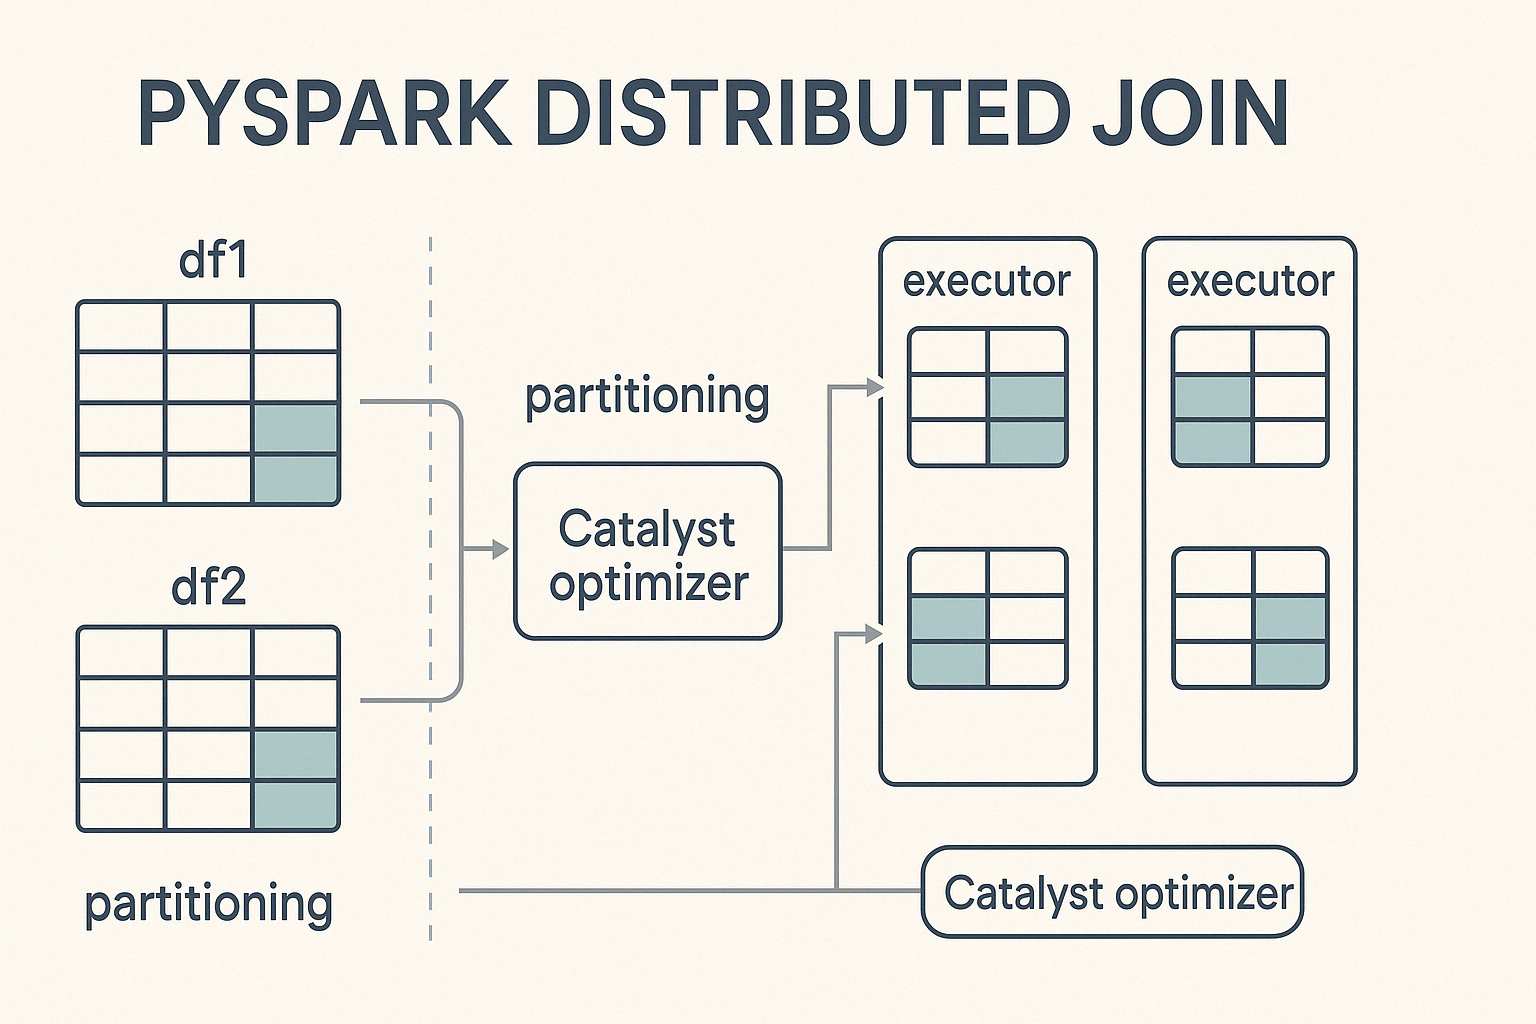
Per eseguire join in PySpark, si segue una sintassi semplice che prevede di specificare i DataFrame, una condizione di join e il tipo di join da eseguire.
from pyspark.sql import SparkSession

# Initialize Spark session
spark = SparkSession.builder.appName("PySpark Joins Example").getOrCreate()

# Perform a join
joined_df = df1.join(df2, on="key", how="inner")
In questo esempio:
df1 e df2 sono i DataFrame da unire.df1.key == df2.key è la condizione di join, che determina come devono essere abbinate le righe di ciascun DataFrame.inner' specifies the join type, which could also be left, right,, outer, semi, or anti` depending on the desired result.Segui il nostro tutorial Getting Started with PySpark per istruzioni su come installare PySpark ed eseguire i join sopra senza errori.
PySpark include diversi tipi di join, ciascuno adatto a compiti sui dati distinti. Capirli ti aiuta a scegliere in modo consapevole.
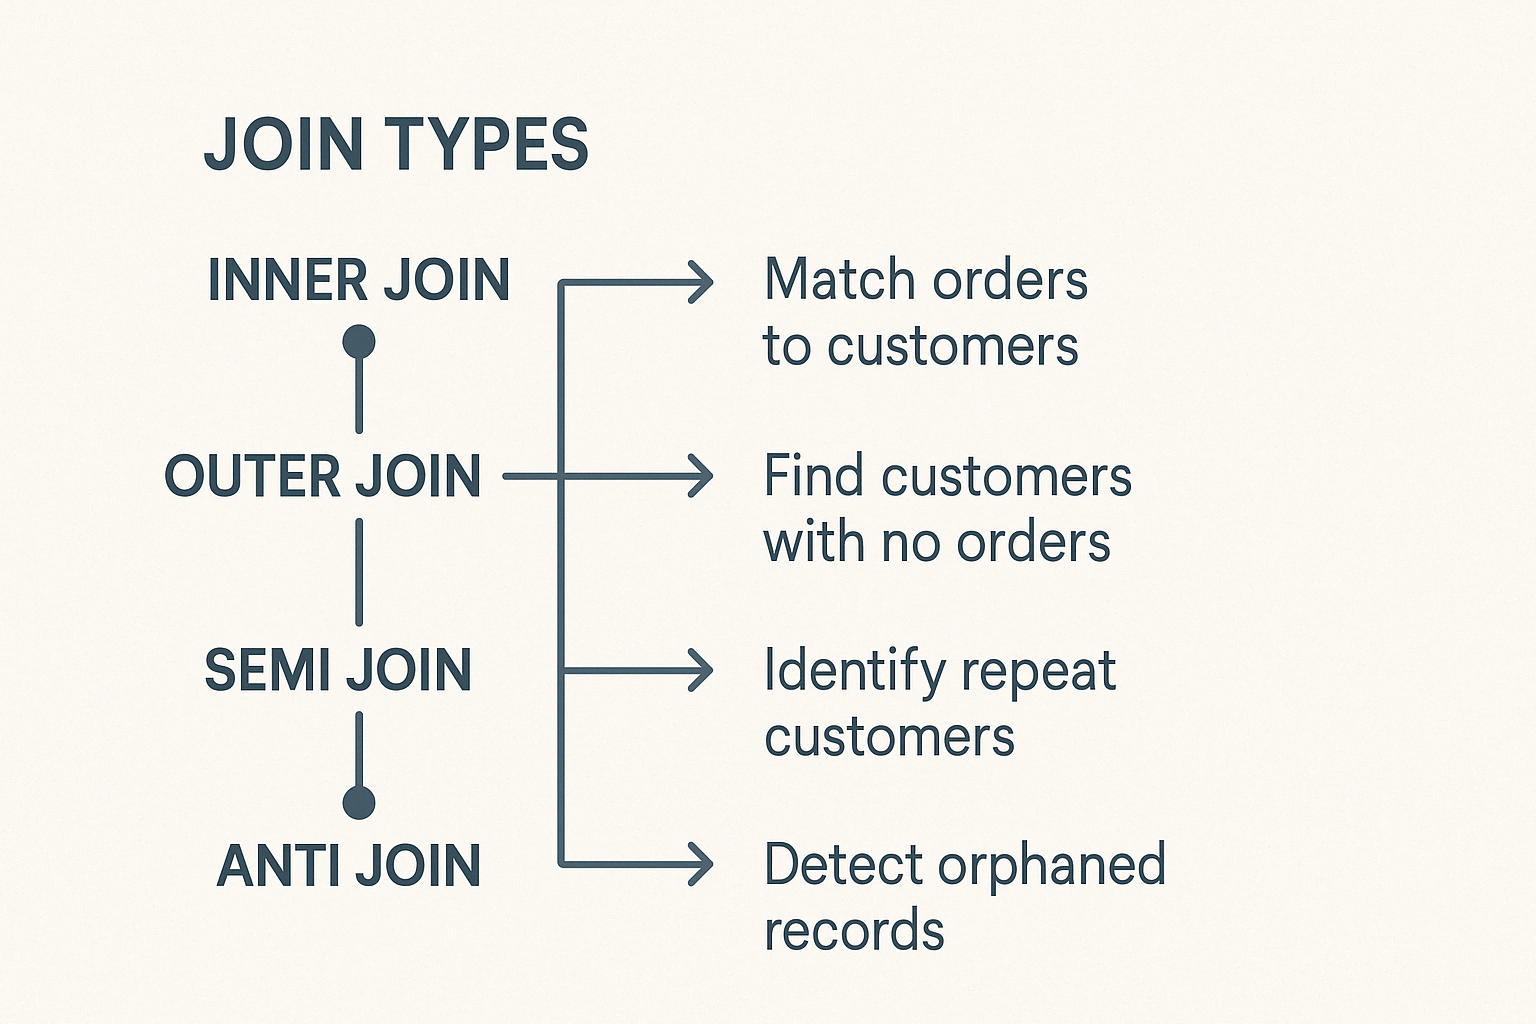
L’inner join combina le righe di due DataFrame quando esistono chiavi corrispondenti in entrambi. Le righe senza chiavi corrispondenti vengono escluse. È il tipo di join più comune e quello predefinito in PySpark.
Scenari d’uso tipici includono:
PySpark supporta left, right e full outer join.
Il left outer join restituisce tutte le righe del DataFrame di sinistra e le righe corrispondenti del DataFrame di destra. Quando non compare alcuna chiave corrispondente nel DataFrame di destra, le colonne di destra vengono riempite con valori null.
Casi d’uso:
Il right outer join rispecchia la logica del left join. Restituisce tutte le righe del DataFrame di destra e le righe corrispondenti del DataFrame di sinistra, riempiendo con null le corrispondenze mancanti nelle colonne di sinistra.
Scenario di esempio:
Il full outer join restituisce tutte le righe disponibili di entrambi i DataFrame, riempiendo con null le voci non corrispondenti. Aiuta a individuare discrepanze o lacune tra due dataset.
I semi e gli anti join hanno funzioni specifiche:
Un semi join restituisce le righe del DataFrame di sinistra in cui esistono chiavi corrispondenti nel DataFrame di destra. Non aggiunge colonne dal DataFrame di destra ed evita i duplicati, rendendolo ideale per verifiche di esistenza.
Esempio d’uso:
Un anti join restituisce le righe di un DataFrame che non hanno alcuna chiave corrispondente nel secondo DataFrame.
Esempio d’uso:
I cross join creano dati abbinando ogni riga di un DataFrame con ogni riga di un altro. A meno che non siano specificamente desiderati, evita i cross join, poiché ampliano drasticamente i dataset.
Usali con cautela per scenari specifici come:
I join su larga scala richiedono un’ottimizzazione attenta. Considera le seguenti tecniche:
I broadcast join migliorano le prestazioni replicando i DataFrame più piccoli su tutti i nodi, eliminando shuffle costosi.
Esempio di sintassi:
from pyspark.sql.functions import broadcast

joined_df = large_df.join(broadcast(small_df), "id", "inner")
Tieni presente i limiti di memoria del tuo sistema; fare broadcast di DataFrame eccessivamente grandi non funziona in modo efficace.
Lo skew dei dati significa che i dati non sono distribuiti uniformemente tra le partizioni, creando colli di bottiglia. Tecniche per ridurre lo skew includono:
Le prestazioni dei join in PySpark dipendono fortemente dalla minimizzazione dell’overhead di shuffle, che si verifica quando i dati devono essere spostati tra i nodi per soddisfare le condizioni di join. Uno dei modi più efficaci per ridurre questo overhead è allineare le partizioni dei DataFrame da unire.
Tieni a mente queste best practice:
repartition() o broadcast() con criterio: usa repartition() per grandi dataset in cui è possibile una distribuzione uniforme e broadcast() per tabelle significativamente più piccole per evitare del tutto lo shuffle.PySpark include meccanismi specializzati per casi più impegnativi, consentendo un’efficienza ancora maggiore:
I range join si usano quando si abbinano righe in base a condizioni numeriche o temporali, piuttosto che sull’uguaglianza esatta. Questi join sono comuni in scenari di serie temporali, come analisi di log, tracciamento eventi o flussi di sensori IoT.
Le best practice per range join efficienti includono:
rangeBetween o between.Esempi di casi d’uso includono:
Eseguire join su dati in streaming introduce sfide uniche per via della natura continua e spesso imprevedibile. Le questioni chiave includono eventi in ritardo, dati fuori ordine e la necessità di gestire lo stato in modo efficiente nel tempo.
PySpark affronta queste sfide usando le watermark, che definiscono una soglia per quanto a lungo il sistema dovrebbe attendere dati in ritardo prima di scartarli. Impostando una watermark sulle colonne di event time, PySpark può gestire in modo efficiente i dati in ritardo e ottimizzare l’uso delle risorse.
Le watermark sono particolarmente utili quando si uniscono due sorgenti in streaming o un flusso con un dataset statico, aiutando a mantenere prestazioni e coerenza nelle pipeline di dati in tempo reale.
I join svolgono un ruolo cruciale nella preparazione dei dati per i modelli di machine learning, ad esempio quando si costruiscono modelli con Spark MLlib. Consolidare queste feature in un unico dataset unificato è essenziale per un addestramento e una valutazione accurati del modello.
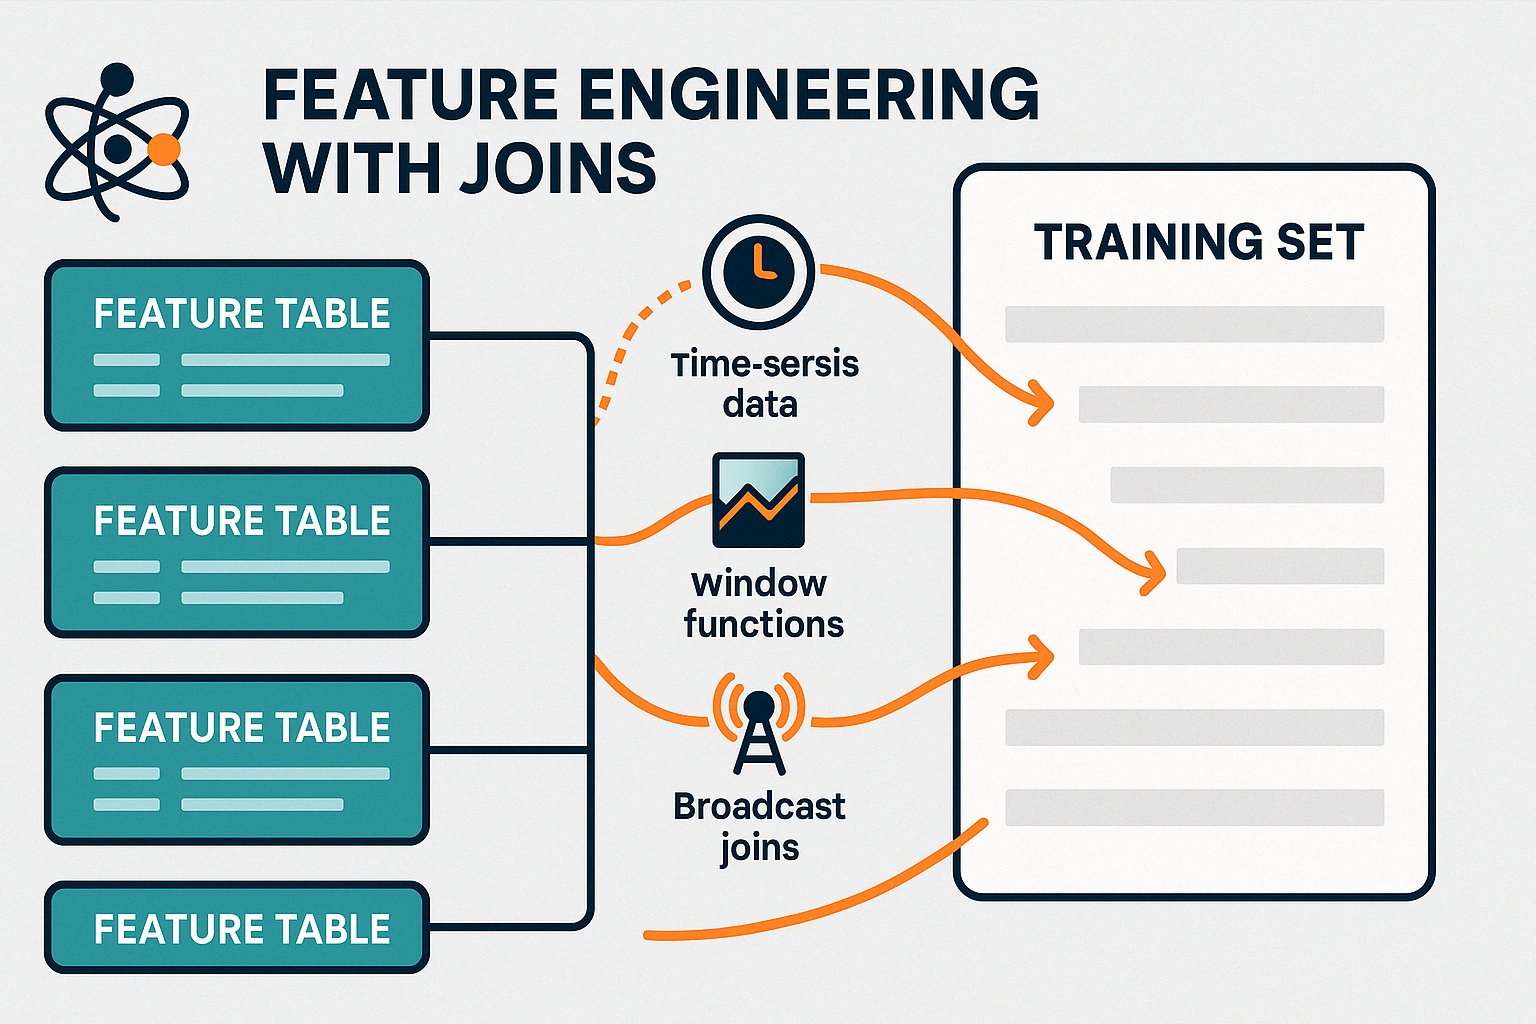
Gestendo in modo efficiente questi join, PySpark abilita il feature engineering in tempo reale, supportando sia sistemi di apprendimento online sia pipeline di training batch aggiornate.
Puoi imparare a fare previsioni dai dati con Apache Spark, usando alberi decisionali, regressione logistica, regressione lineare, ensemble e pipeline con il nostro corso Machine Learning with PySpark.
Le operazioni di join nel calcolo distribuito richiedono attenzione costante per evitare potenziali problemi.
Join eseguiti in modo efficiente possono migliorare drasticamente la velocità complessiva della pipeline e l’uso delle risorse. Ecco le pratiche chiave da seguire:
repartition() o coalesce() per regolare la dimensione delle partizioni e ottenere un’elaborazione parallela più bilanciata.Anche piccoli errori nella logica di join possono causare gravi problemi di prestazioni o accuratezza dei dati. Ecco le insidie comuni da tenere d’occhio:
Anche join ben strutturati possono incontrare problemi di prestazioni o di esecuzione.
Ecco problemi comuni e come affrontarli:
I join in PySpark sono una pietra angolare dell’elaborazione dei dati su larga scala, consentendo analisi potenti ed efficienti su dataset massivi. Se usati correttamente, rivelano relazioni significative che guidano insight più profondi e decisioni più informate.
Sebbene l’ottimizzazione delle prestazioni possa presentare sfide, come la gestione dello skew dei dati o l’ottimizzazione del partizionamento, padroneggiare questi aspetti è fondamentale per costruire pipeline di dati robuste.
Che tu stia unendo stream in tempo reale o consolidando feature per il machine learning, affinare le tue strategie di join può migliorare sensibilmente la velocità di esecuzione, l’efficienza delle risorse e la precisione analitica.
Per approfondire, esplora l’elaborazione dei big data con PySpark e avvicinati a diventare un esperto di data engineering con la nostra skill track Big Data Fundamentals with PySpark.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



