
Khóa học
Nền tảng Big Data với PySpark
4 giờ
67K
PySpark là API Python cho Apache Spark, được thiết kế để xử lý dữ liệu song song và phân tán trên các cụm máy. Việc chọn đúng phép join phù hợp với nhu cầu của bạn sẽ ảnh hưởng đến tốc độ job, mức tiêu thụ tài nguyên và thành công tổng thể.
Làm việc với các tập dữ liệu lớn thường đồng nghĩa với việc tích hợp dữ liệu từ nhiều nguồn. Kết hợp hiệu quả thông tin này là điều thiết yếu để phân tích chính xác và rút ra insight có ý nghĩa. Các phép join trong PySpark cung cấp những cách mạnh mẽ để kết hợp các tập dữ liệu riêng biệt dựa trên khóa chung.
Tuy nhiên, các phép join kém hiệu quả có thể ảnh hưởng nghiêm trọng đến tốc độ và độ tin cậy xử lý dữ liệu khi làm việc với những tập dữ liệu khổng lồ chứa hàng triệu hay hàng tỷ bản ghi trên các cụm phân tán.
Bạn đã từng gặp các phép join chậm chạp hoặc thậm chí thất bại khi xử lý dữ liệu quy mô lớn chưa? Nếu có, bài hướng dẫn này dành cho bạn. Nó sẽ giúp các nhà khoa học dữ liệu, lập trình viên và kỹ sư ở mức trung cấp nắm vững và tự tin khi thực hiện join trong PySpark.
Nếu bạn muốn thực hành để làm quen với PySpark, hãy xem lộ trình kỹ năng Big Data với PySpark của chúng tôi.
Như bạn sẽ thấy trong bài viết Học PySpark từ con số 0 của chúng tôi, một trong những tính năng chính của PySpark là khả năng trộn (merge) các tập dữ liệu lớn. Các phép join trong PySpark là yếu tố thiết yếu để kết hợp các tập dữ liệu lớn dựa trên các cột chung, cho phép tích hợp dữ liệu, so sánh và phân tích hiệu quả ở quy mô lớn.
Chúng đóng vai trò quan trọng trong xử lý dữ liệu lớn bằng cách giúp phát hiện quan hệ và trích xuất insight có ý nghĩa trên các nguồn dữ liệu phân tán.
PySpark cung cấp nhiều loại join như inner join, outer join, left và right join, semi join và anti join, mỗi loại phục vụ các mục đích phân tích khác nhau.
Tuy nhiên, làm việc với join trên các tập dữ liệu lớn có thể phát sinh thách thức như lệch phân phối dữ liệu (skew), chi phí shuffle và hạn chế bộ nhớ, khiến việc chọn đúng chiến lược join trở nên tối quan trọng cho hiệu năng và độ chính xác.
Hiểu các hoạt động nội bộ của PySpark là rất quan trọng để join các tập dữ liệu lớn một cách hiệu quả, như chúng tôi trình bày trong khóa Introduction to PySpark của chúng tôi. Phần này phác thảo khung khái niệm đằng sau quá trình thực thi join của PySpark và vai trò của bộ tối ưu hóa.
PySpark thực hiện join trong môi trường tính toán phân tán, nghĩa là nó chia các tập dữ liệu lớn thành các phân vùng nhỏ hơn và xử lý song song trên một cụm máy. Khi một join được kích hoạt, PySpark phân phối công việc giữa các nút này, hướng tới cân bằng tính toán để tăng tốc thực thi và tránh nút thắt cổ chai.
Trọng tâm của quy trình này là Catalyst, bộ máy tối ưu hóa truy vấn mạnh mẽ của Spark. Catalyst quyết định cách thực thi các phép join. Nó quyết định chiến lược phân vùng, phát hiện khi nào cần shuffle dữ liệu và áp dụng các tối ưu hiệu năng như đẩy điều kiện lọc (predicate pushdown) và broadcast join. Việc tối ưu hóa tự động này đảm bảo thực thi hiệu quả mà không cần nhà phát triển phải tinh chỉnh thủ công.
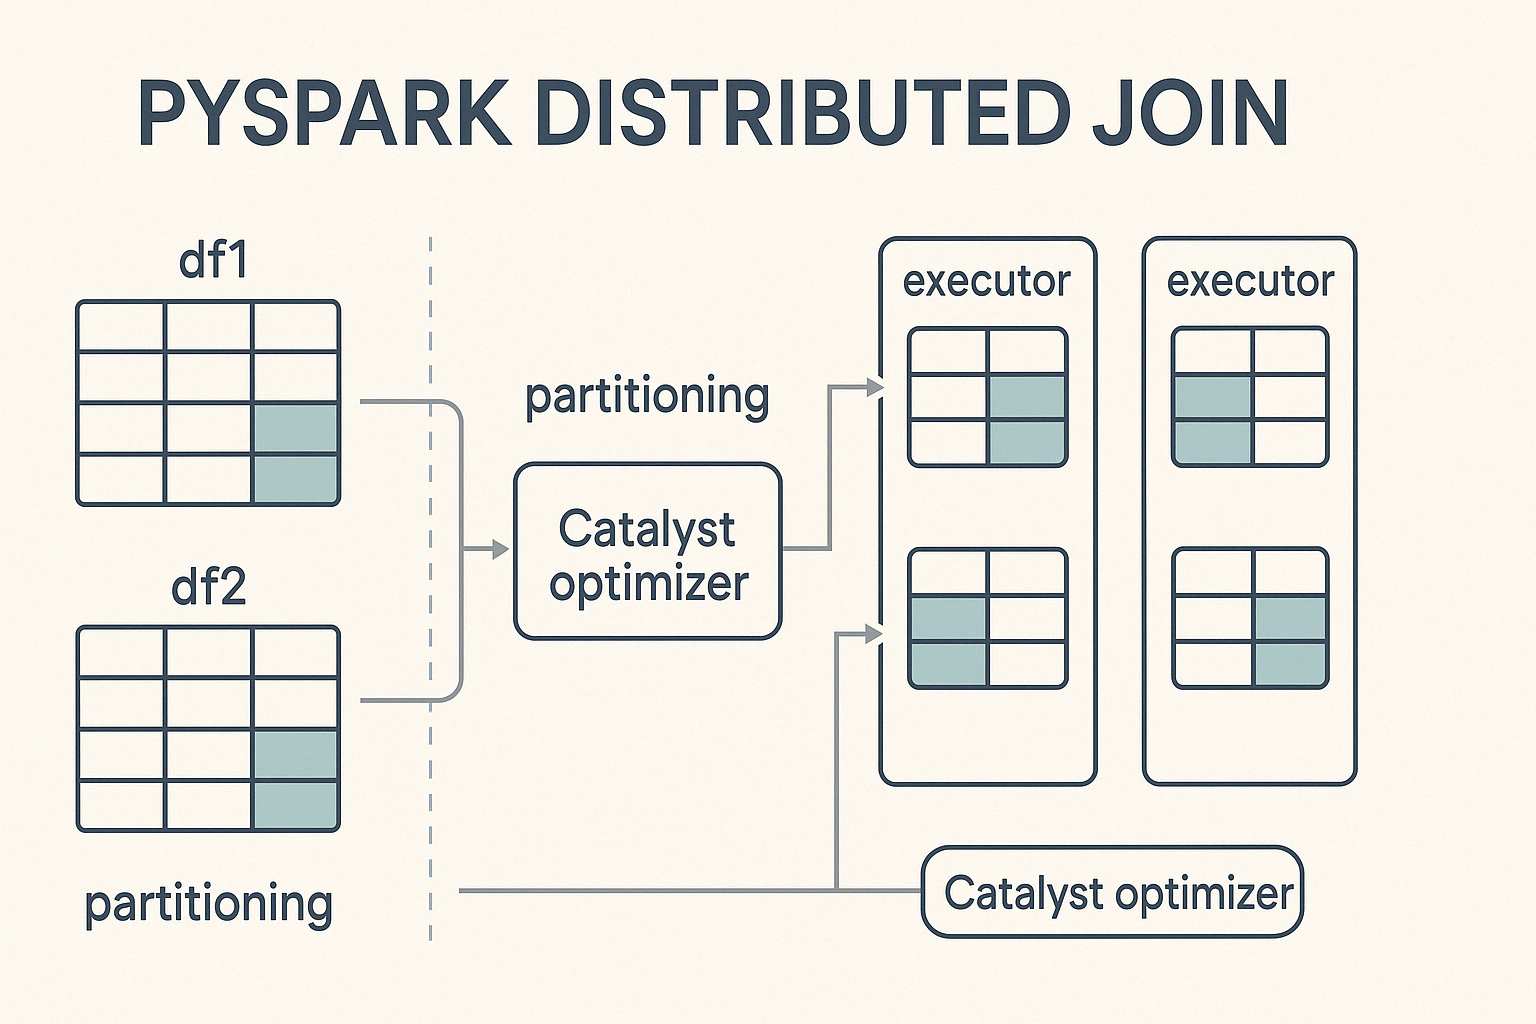
Để thực hiện join trong PySpark, bạn theo cú pháp đơn giản gồm chỉ định DataFrame, điều kiện join và loại join cần thực thi.
from pyspark.sql import SparkSession

# Initialize Spark session
spark = SparkSession.builder.appName("PySpark Joins Example").getOrCreate()

# Perform a join
joined_df = df1.join(df2, on="key", how="inner")
Trong ví dụ này:
df1 và df2 là các DataFrame sẽ được join.df1.key == df2.key là điều kiện join, xác định cách ghép các hàng từ mỗi DataFrame.inner' specifies the join type, which could also be left, right,, outer, semi, or anti` depending on the desired result.Hãy xem hướng dẫn Bắt đầu với PySpark của chúng tôi để biết cách cài đặt PySpark và chạy các phép join trên mà không gặp lỗi.
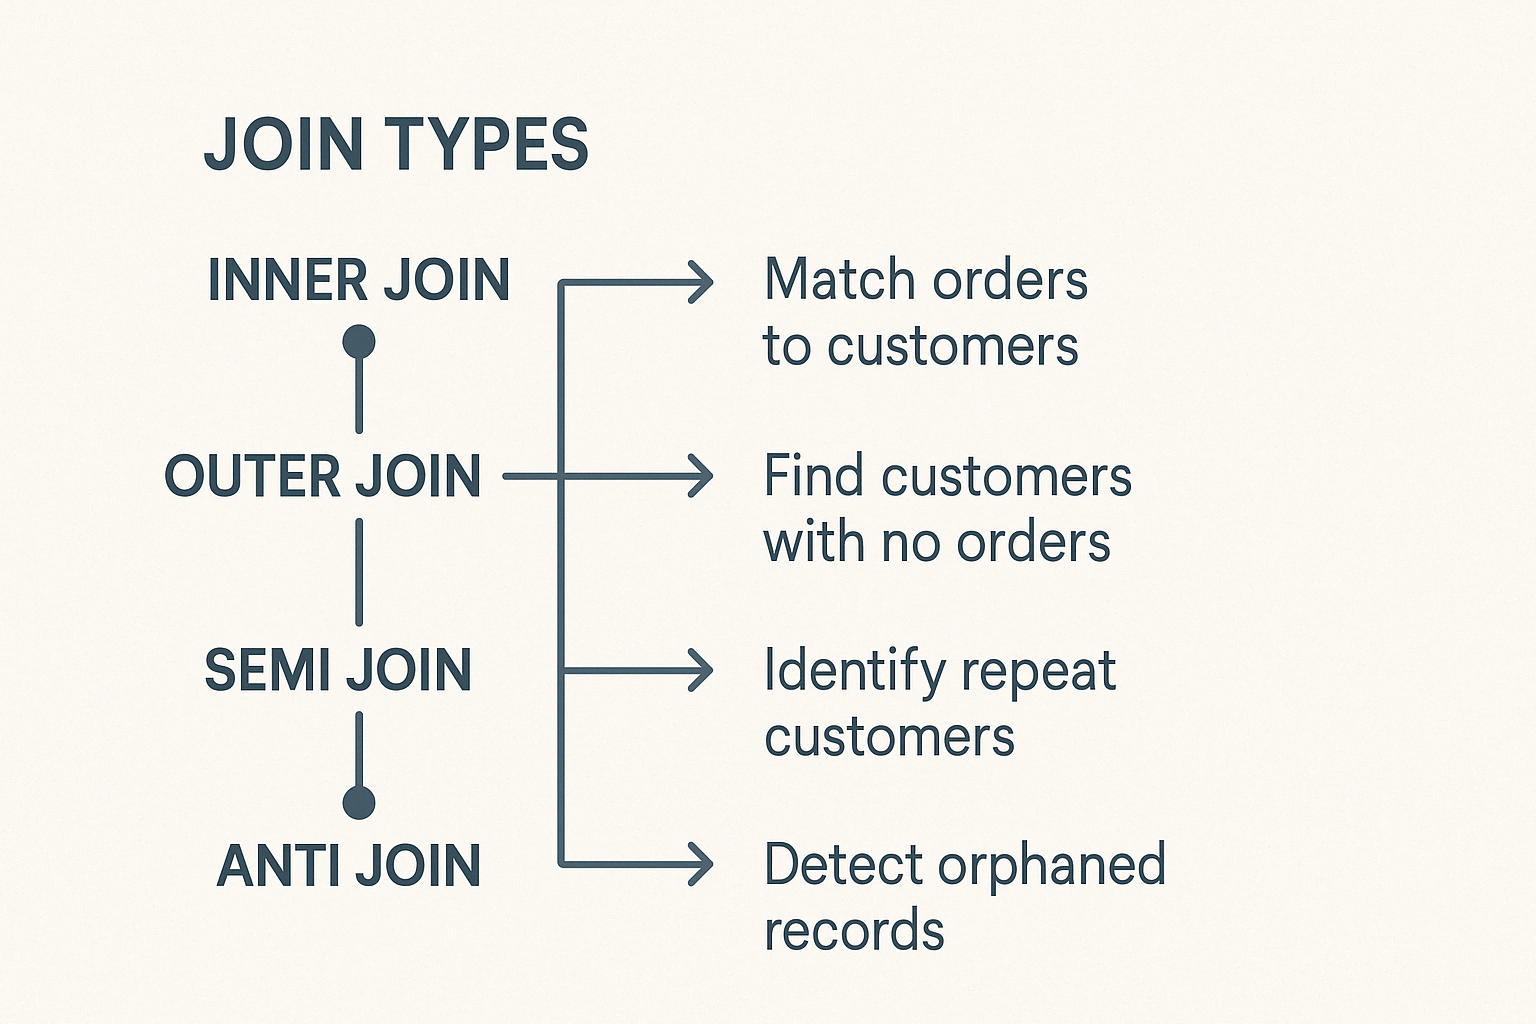
PySpark bao gồm nhiều kiểu join khác nhau, mỗi kiểu phù hợp với từng tác vụ dữ liệu riêng. Hiểu rõ các kiểu này giúp bạn lựa chọn sáng suốt.
Inner join kết hợp các hàng từ hai DataFrame khi tồn tại khóa khớp ở cả hai bên. Các hàng không có khóa khớp sẽ bị loại. Đây là loại join phổ biến nhất và là mặc định trong PySpark.
Tình huống sử dụng điển hình gồm:
PySpark hỗ trợ left, right và full outer join.
Left outer join trả về tất cả các hàng từ DataFrame bên trái và các hàng khớp từ DataFrame bên phải. Khi không có khóa khớp ở DataFrame bên phải, các cột phía phải sẽ được điền null.
Trường hợp sử dụng:
Right outer join phản chiếu logic của left join. Nó trả về tất cả các hàng từ DataFrame bên phải và các hàng khớp từ DataFrame bên trái, điền null cho các khớp thiếu ở phía trái.
Ví dụ tình huống:
Full outer join trả về mọi hàng có sẵn từ cả hai DataFrame, điền null cho các mục không khớp. Nó giúp phát hiện sai lệch hoặc khoảng trống dữ liệu giữa hai tập dữ liệu.
Semi và anti join phục vụ các chức năng chuyên biệt:
Semi join trả về các hàng từ DataFrame bên trái nơi tồn tại khóa khớp ở DataFrame bên phải. Nó không thêm cột từ DataFrame bên phải và tránh trùng lặp, rất lý tưởng cho các kiểm tra sự tồn tại.
Ví dụ trường hợp sử dụng:
Anti join trả về các hàng từ một DataFrame không có khóa khớp trong DataFrame thứ hai.
Ví dụ trường hợp sử dụng:
Cross join tạo dữ liệu bằng cách ghép mọi hàng ở một DataFrame với mọi hàng ở DataFrame khác. Trừ khi thực sự cần, hãy tránh cross join vì chúng làm phình to tập dữ liệu một cách mạnh mẽ.
Chỉ nên dùng thận trọng cho các kịch bản cụ thể như:
Join ở quy mô lớn đòi hỏi tối ưu hóa cẩn trọng. Hãy cân nhắc các kỹ thuật sau:
Broadcast join cải thiện hiệu năng bằng cách nhân bản các DataFrame nhỏ trên mọi nút, loại bỏ các shuffle tốn kém.
Ví dụ cú pháp:
from pyspark.sql.functions import broadcast

joined_df = large_df.join(broadcast(small_df), "id", "inner")
Hãy lưu ý giới hạn bộ nhớ của hệ thống; broadcast các DataFrame quá lớn sẽ không hiệu quả.
Lệch phân phối dữ liệu xảy ra khi dữ liệu không được phân bổ đều giữa các phân vùng, tạo ra nút thắt cổ chai. Các kỹ thuật giảm skew gồm:
Hiệu năng join trong PySpark phụ thuộc nhiều vào việc giảm thiểu chi phí shuffle, xảy ra khi dữ liệu cần được di chuyển giữa các nút để đáp ứng điều kiện join. Một trong những cách hiệu quả nhất để giảm chi phí này là căn chỉnh các phân vùng của các DataFrame được join.
Ghi nhớ các thực hành sau:
repartition() hoặc broadcast() hợp lý: Dùng repartition() cho các tập dữ liệu lớn có thể phân phối đều, và broadcast() cho các bảng nhỏ hơn đáng kể để tránh shuffle hoàn toàn.PySpark bao gồm các cơ chế chuyên biệt cho những trường hợp đòi hỏi cao hơn, cho phép hiệu quả hơn nữa:
Range join được dùng khi ghép các hàng dựa trên điều kiện số hoặc theo thời gian, thay vì so khớp bằng nhau tuyệt đối. Các join này thường gặp trong bối cảnh dữ liệu chuỗi thời gian, như phân tích log, theo dõi sự kiện hoặc luồng cảm biến IoT.
Thực hành tốt nhất để thực hiện range join hiệu quả bao gồm:
rangeBetween hoặc between.Ví dụ trường hợp sử dụng gồm:
Join dữ liệu streaming mang lại những thách thức riêng do tính liên tục và thường khó đoán. Các vấn đề chính gồm sự kiện đến muộn, dữ liệu sai thứ tự và nhu cầu quản lý trạng thái hiệu quả theo thời gian.
PySpark xử lý các thách thức này bằng watermark, xác định ngưỡng cho thời gian hệ thống chờ dữ liệu đến muộn trước khi loại bỏ. Bằng cách đặt watermark trên các cột thời gian sự kiện, PySpark có thể quản lý hiệu quả dữ liệu đến muộn và tối ưu sử dụng tài nguyên.
Watermark đặc biệt hữu ích khi join hai nguồn streaming hoặc join một luồng với tập dữ liệu tĩnh, giúp duy trì cả hiệu năng và tính nhất quán trong pipeline dữ liệu thời gian thực.
Join đóng vai trò quan trọng trong chuẩn bị dữ liệu cho mô hình máy học, ví dụ khi xây dựng mô hình với Spark MLlib. Việc hợp nhất các đặc trưng này vào một tập dữ liệu thống nhất là điều thiết yếu để huấn luyện và đánh giá mô hình chính xác.
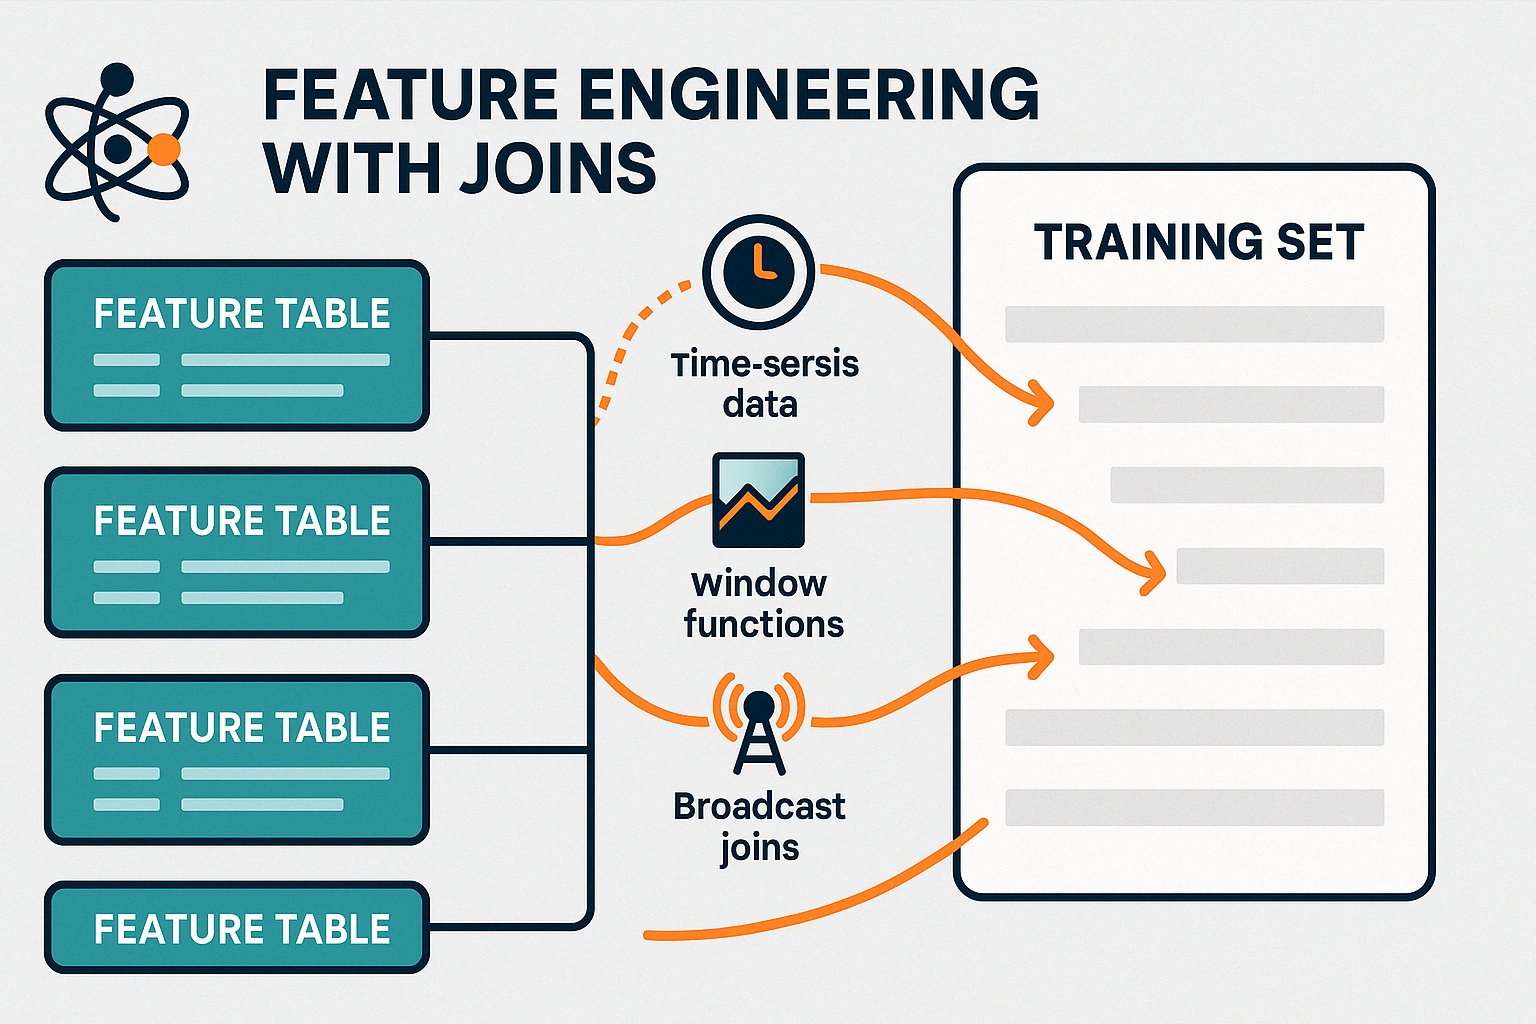
Bằng cách quản lý hiệu quả các phép join này, PySpark cho phép xây dựng đặc trưng thời gian thực, hỗ trợ cả hệ thống học trực tuyến và các pipeline huấn luyện batch luôn cập nhật.
Bạn có thể học cách dự đoán từ dữ liệu với Apache Spark, sử dụng cây quyết định, hồi quy logistic, hồi quy tuyến tính, tập hợp (ensemble) và pipeline với khóa Machine Learning with PySpark của chúng tôi.
Các phép join trong môi trường tính toán phân tán cần được quan tâm thường xuyên để tránh những vấn đề tiềm ẩn.
Các phép join hiệu quả có thể cải thiện mạnh mẽ tốc độ pipeline tổng thể và việc sử dụng tài nguyên. Dưới đây là những thực hành chủ chốt cần tuân theo:
repartition() hoặc coalesce() để điều chỉnh kích thước phân vùng, giúp xử lý song song cân bằng hơn.Chỉ một vài sơ suất nhỏ trong logic join cũng có thể dẫn tới vấn đề lớn về hiệu năng hoặc độ chính xác dữ liệu. Dưới đây là các sai lầm phổ biến cần cảnh giác:
Ngay cả các phép join được thiết kế tốt cũng có thể gặp vấn đề về hiệu năng hoặc thực thi.
Dưới đây là những vấn đề thường gặp và cách khắc phục:
Các phép join trong PySpark là nền tảng của xử lý dữ liệu quy mô lớn, cho phép phân tích mạnh mẽ và hiệu quả trên các tập dữ liệu khổng lồ. Khi dùng đúng cách, chúng làm lộ ra các mối quan hệ có ý nghĩa, thúc đẩy insight sâu hơn và quyết định thông minh hơn.
Dù việc tinh chỉnh hiệu năng có thể nhiều thách thức, như xử lý lệch phân phối hay tối ưu phân vùng, nắm vững các khía cạnh này là chìa khóa xây dựng pipeline dữ liệu vững chắc.
Dù bạn đang join các luồng thời gian thực hay hợp nhất đặc trưng cho máy học, việc tinh chỉnh chiến lược join có thể cải thiện đáng kể tốc độ thực thi, hiệu quả tài nguyên và độ chính xác phân tích.
Để tìm hiểu sâu hơn về xử lý dữ liệu lớn với PySpark và hướng tới trở thành chuyên gia kỹ thuật dữ liệu, hãy khám phá lộ trình Big Data Fundamentals with PySpark của chúng tôi.
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
