

在本篇 PyTorch 教程中,我们将讲解支撑神经网络的核心函数,并从零开始构建一个属于我们的网络。本文的主要目标是演示 PyTorch(一个优化的深度学习张量库)的基础用法,同时为您提供有关神经网络工作原理的详细背景知识。
注意:查看此 DataCamp workspace,即可跟随本文中的代码一起实践。
什么是神经网络?
神经网络也称为人工神经网络(ANN)。这种架构是深度学习的基础。深度学习是机器学习的一个子集,研究受人脑结构和功能启发的算法。简单来说,神经网络是模仿生物神经元彼此传递信号的架构基础。
因此,您常会看到一些资料先用五分钟梳理人脑的神经结构,以帮助从视觉上理解神经网络的工作方式。但当您没有额外五分钟时,把神经网络定义为将输入映射到期望输出的函数会更容易理解。
通用的神经网络架构包括以下部分:
- 输入层:数据通过输入层进入网络。输入层中的神经元数量等于数据中的特征数。输入层在技术上不被视为网络的层,因为此处不进行计算。
- 隐藏层:输入层与输出层之间的层称为隐藏层。网络可以有任意数量的隐藏层——隐藏层越多,网络越复杂。
- 输出层:输出层用于生成预测。
- 神经元:每一层都有一组神经元,并与其他层的神经元交互。
- 激活函数:执行非线性变换,帮助模型从数据中学习复杂模式。
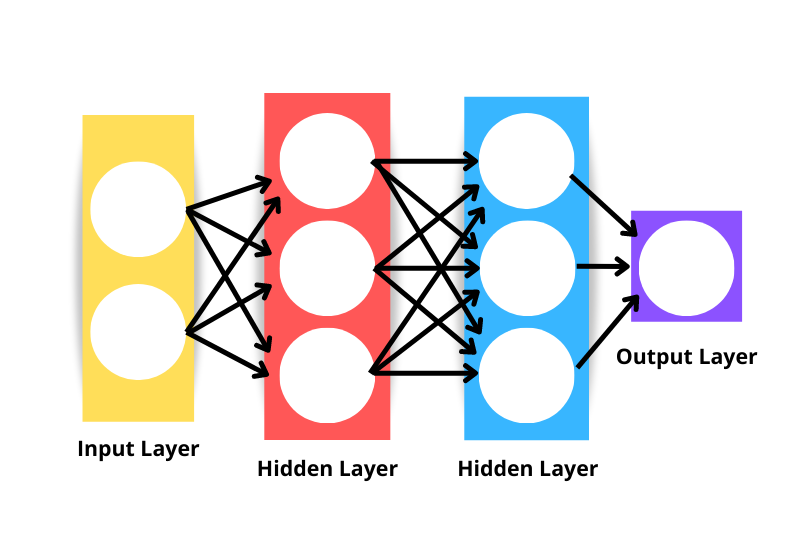
请注意,上图中的神经网络被视为三层网络而非四层——这是因为我们不把输入层计入层数。因此,网络的层数等于隐藏层数加上输出层。
神经网络如何工作?
让我们把算法拆解为更小的组件,以更好地理解神经网络的工作方式。
权重初始化
权重初始化是神经网络架构中的首个组件。我们设定的初始权重定义了神经网络模型优化过程的起点。
如何设置权重很重要,尤其是在构建深层网络时。这是因为深层网络更容易遭遇梯度爆炸或梯度消失问题。梯度消失和梯度爆炸超出了本文的范围,但它们都描述了算法无法有效学习的情形。
尽管权重初始化不能完全解决梯度消失或爆炸问题,但确实有助于预防。
以下是几种常见的权重初始化方式:
零初始化
零初始化指将权重全部设为零。这并不是一个好方案,因为神经网络将无法打破对称性——它不会学习。
当使用常数来初始化权重时,我们可以预期网络表现较差,因为各层会学到相同的东西。如果所有隐藏单元的输出对代价的影响相同,那么梯度也会相同。
随机初始化
随机初始化可以打破对称性,这比零初始化要好,但一些因素仍会影响模型的整体质量。
例如,如果权重被随机初始化为较大的值,则每次矩阵乘法都可能产生显著更大的数值。在这种情况下应用 sigmoid 激活函数,输出会接近 1,从而减缓学习速度。
另一个可能出现问题的情形是权重被随机初始化为很小的值。这样每次矩阵乘法会产生显著较小的数值,应用 sigmoid 后输出会更接近 0,同样会降低学习速度。
Xavier/Glorot 初始化
Xavier 或 Glorot 初始化是一种启发式的权重初始化方法。常见于在加权和后使用 tanh 或 sigmoid 激活函数的场景。该方法最早由 Xavier Glorot 和 Yoshua Bengio 在 2010 年的研究论文 Understanding the difficulty of training deep feedforward neural networks 中提出。该技术旨在保持网络各层的方差一致,以防止梯度爆炸或消失。
He/Kaiming 初始化
He 或 Kaiming 初始化是另一种启发式方法。与 Xavier 不同,He 初始化对权重使用了不同的缩放因子,考虑了激活函数的非线性。
因此,当层中使用 ReLU 激活函数时,推荐采用 He 初始化。您可以在 He 等人的论文 Delving Deep into Rectifiers: Surpassing Human-Level Performance on ImageNet Classification 中了解更多。
前向传播
神经网络通过对输入进行加权求和并加上偏置项,然后应用激活函数进行非线性变换来工作。在加权求和中,每个权重决定了各特征的重要性(即其对输出预测的贡献程度)。
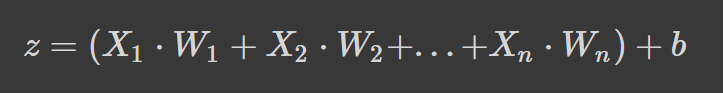
上式即为加权求和加偏置项,其中:
- z 表示某个神经元输入的加权和
- Wn 表示权重
- Xn 表示自变量,
- b 为偏置项。
如果这个公式看起来很熟悉,是因为它就是线性回归。如果不在神经元中引入非线性,我们得到的就是线性回归这一简单模型。非线性变换使神经网络能够学习复杂模式。
激活函数
我们在权重初始化部分已经提到了一些激活函数,现在您也了解了它们在神经网络架构中的重要性。
让我们更深入地了解一些常见的激活函数,您在阅读论文或他人代码时很可能会见到它们。
Sigmoid
Sigmoid 函数的曲线呈“S”形,取值范围在 0 到 1 之间。它是可微的,意味着在任意两点都能求得斜率;同时是单调的,即并非全程严格递增或递减。通常在二分类问题中使用 sigmoid 激活函数。
以下是用 Python 可视化 sigmoid 函数的示例:
# Sigmoid function in Python
import matplotlib.pyplot as plt
import numpy as np
x = np.linspace(-5, 5, 50)
z = 1/(1 + np.exp(-x))
plt.subplots(figsize=(8, 5))
plt.plot(x, z)
plt.grid()
plt.show()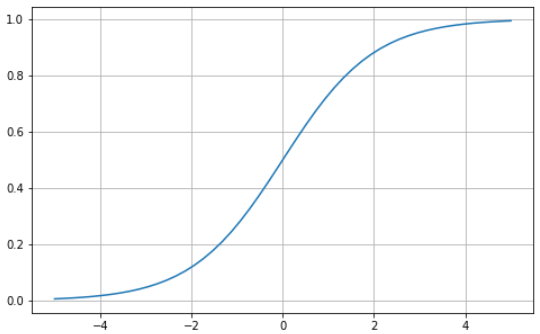
Tanh
双曲正切(tanh)与 sigmoid 一样也是“S”形曲线,但取值范围在 -1 到 1 之间。因此,较小的输入会映射到更接近 -1,较大的输入映射到更接近 1。
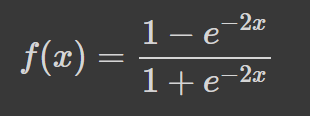
下面是用 Python 可视化 tanh 函数的示例:
# tanh function in Python
import matplotlib.pyplot as plt
import numpy as np
x = np.linspace(-5, 5, 50)
z = np.tanh(x)
plt.subplots(figsize=(8, 5))
plt.plot(x, z)
plt.grid()
plt.show()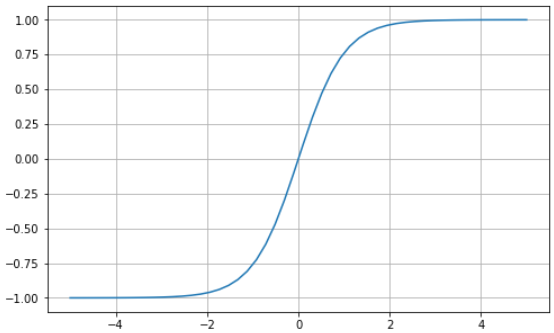
Softmax
Softmax 通常用作输出层的激活函数。它是 sigmoid 在多维情形下的推广,因此用于在多于两个标签上预测类别归属。
修正线性单元(ReLU)
在构建深层神经网络时使用 sigmoid 或 tanh 风险较大,因为它们更容易受到梯度消失问题影响。修正线性单元(ReLU)激活函数正是为解决此问题而提出,并且常作为许多神经网络的默认激活函数。
以下是用 Python 可视化 ReLU 函数的示例:
# ReLU in Python
import matplotlib.pyplot as plt
import numpy as np
x = np.linspace(-5, 5, 50)
z = [max(0, i) for i in x]
plt.subplots(figsize=(8, 5))
plt.plot(x, z)
plt.grid()
plt.show()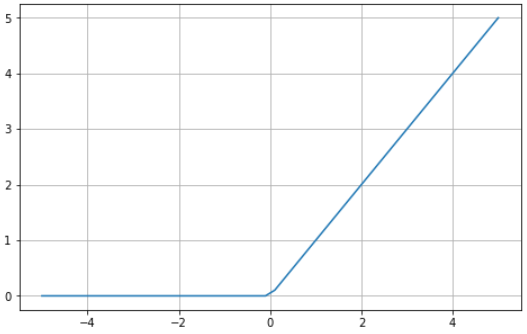
ReLU 的取值范围为 0 到正无穷:当输入小于或等于 0 时,函数返回 0;当输入大于 0 时,函数返回输入值本身(例如输入为 2 则返回 2)。总体而言,ReLU 的行为与线性函数非常相似,使其更易于优化与实现。
从输入层到输出层的这个过程称为前向传递或前向传播。在此阶段,模型产生的输出用于计算代价函数,以评估每次迭代后神经网络的表现。随后这些信息会沿网络反向传递,以校正权重,从而使模型在称为反向传播的过程中做出更好的预测。
反向传播
在第一次前向传播结束时,网络使用尚未调优的初始权重进行预测。因此,模型给出的预测很可能并不准确。利用前向传播计算得到的损失,我们将信息沿网络反向传播,以微调权重,这个过程称为反向传播。
归根到底,我们是在借助优化函数帮助识别能降低误差率的权重,使模型更可靠并提升其对新样本的泛化能力。其背后的数学原理超出本文范围,感兴趣的读者可在我们的课程 了解更多关于反向传播,课程为Python 深度学习入门。
PyTorch 教程:从零构建神经网络的分步演练
在本节中,我们将使用 PyTorch 库构建一个简单的人工神经网络模型。查看这个 DataCamp workspace 以便跟随代码一起操作
PyTorch 是最流行的深度学习库之一。与 TensorFlow 相比,它提供了更直接的调试体验。它还有诸多优势,例如分布式训练、强大的生态系统、云端支持、可编写生产级代码等。您可以在技能路径 Introduction to Deep Learning with PyTorch 中进一步了解 PyTorch。
下面开始教程。
数据定义与准备
本教程将使用 scikit-learn 的 make_circles 数据集——参见文档。这是一个玩具数据集,由一个二维平面上的大圆与小圆组成,包含两个特征。我们的示例中使用了 10,000 个样本,并向数据添加了标准差为 0.05 的高斯噪声。
在构建神经网络之前,先将数据划分为训练集和测试集是一个良好实践,这样我们就可以在未见过的数据上评估模型表现。
import matplotlib.pyplot as plt
from sklearn.datasets import make_circles
from sklearn.model_selection import train_test_split
# Create a dataset with 10,000 samples.
X, y = make_circles(n_samples = 10000,
noise= 0.05,
random_state=26)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=.33, random_state=26)
# Visualize the data.
fig, (train_ax, test_ax) = plt.subplots(ncols=2, sharex=True, sharey=True, figsize=(10, 5))
train_ax.scatter(X_train[:, 0], X_train[:, 1], c=y_train, cmap=plt.cm.Spectral)
train_ax.set_title("Training Data")
train_ax.set_xlabel("Feature #0")
train_ax.set_ylabel("Feature #1")
test_ax.scatter(X_test[:, 0], X_test[:, 1], c=y_test)
test_ax.set_xlabel("Feature #0")
test_ax.set_title("Testing data")
plt.show()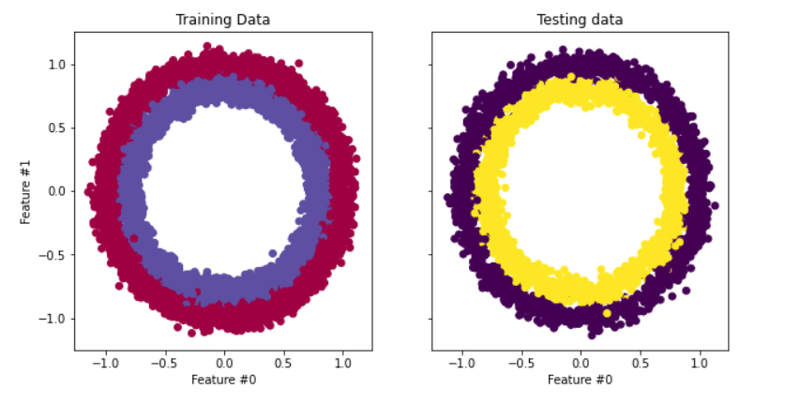
下一步是将训练与测试数据从 NumPy 数组转换为PyTorch 张量。为此,我们将为训练与测试文件创建自定义数据集;同时借助 PyTorch 的 Dataloader 模块以批量方式训练数据。代码如下:
import warnings
warnings.filterwarnings("ignore")
!pip install torch -q
import torch
import numpy as np
from torch.utils.data import Dataset, DataLoader
# Convert data to torch tensors
class Data(Dataset):
def __init__(self, X, y):
self.X = torch.from_numpy(X.astype(np.float32))
self.y = torch.from_numpy(y.astype(np.float32))
self.len = self.X.shape[0]
def __getitem__(self, index):
return self.X[index], self.y[index]
def __len__(self):
return self.len
batch_size = 64
# Instantiate training and test data
train_data = Data(X_train, y_train)
train_dataloader = DataLoader(dataset=train_data, batch_size=batch_size, shuffle=True)
test_data = Data(X_test, y_test)
test_dataloader = DataLoader(dataset=test_data, batch_size=batch_size, shuffle=True)
# Check it's working
for batch, (X, y) in enumerate(train_dataloader):
print(f"Batch: {batch+1}")
print(f"X shape: {X.shape}")
print(f"y shape: {y.shape}")
break
"""
Batch: 1
X shape: torch.Size([64, 2])
y shape: torch.Size([64])
"""现在我们继续实现并训练神经网络。
神经网络实现与模型训练
我们将实现一个简单的两层神经网络,使用 ReLU 激活函数(torch.nn.functional.relu)。为此,我们将创建一个名为 NeuralNetwork 的类,继承自 nn.Module(PyTorch 中所有神经网络模块的基类)。
代码如下:
import torch
from torch import nn
from torch import optim
input_dim = 2
hidden_dim = 10
output_dim = 1
class NeuralNetwork(nn.Module):
def __init__(self, input_dim, hidden_dim, output_dim):
super(NeuralNetwork, self).__init__()
self.layer_1 = nn.Linear(input_dim, hidden_dim)
nn.init.kaiming_uniform_(self.layer_1.weight, nonlinearity="relu")
self.layer_2 = nn.Linear(hidden_dim, output_dim)
def forward(self, x):
x = torch.nn.functional.relu(self.layer_1(x))
x = torch.nn.functional.sigmoid(self.layer_2(x))
return x
model = NeuralNetwork(input_dim, hidden_dim, output_dim)
print(model)
"""
NeuralNetwork(
(layer_1): Linear(in_features=2, out_features=10, bias=True)
(layer_2): Linear(in_features=10, out_features=1, bias=True)
)
"""就是这样。
要训练模型,我们必须定义用于计算梯度的损失函数和用于更新参数的优化器。本文演示中我们将使用二元交叉熵和随机梯度下降,学习率为 0.1。
learning_rate = 0.1
loss_fn = nn.BCELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=lea让我们开始训练模型
num_epochs = 100
loss_values = []
for epoch in range(num_epochs):
for X, y in train_dataloader:
# zero the parameter gradients
optimizer.zero_grad()
# forward + backward + optimize
pred = model(X)
loss = loss_fn(pred, y.unsqueeze(-1))
loss_values.append(loss.item())
loss.backward()
optimizer.step()
print("Training Complete")
"""
Training Complete
"""由于我们记录了损失值,可以将其随时间的变化进行可视化。
step = range(len(loss_values))
fig, ax = plt.subplots(figsize=(8,5))
plt.plot(step, np.array(loss_values))
plt.title("Step-wise Loss")
plt.xlabel("Epochs")
plt.ylabel("Loss")
plt.show()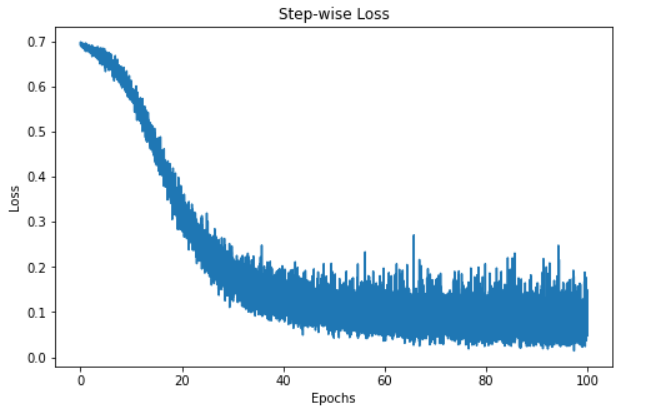
上图展示了模型在 100 个 epoch 内的损失值。最初损失约为 0.7,随后逐步下降——这表明模型的预测在不断改进。不过大约在第 60 个 epoch 附近似乎出现了平台期,可能有多种原因,例如模型处于损失函数的局部或全局极小值附近。
尽管如此,模型已经训练完毕,可以对新样本进行预测——下一节我们看看如何实现。
预测与模型评估
使用我们的 PyTorch 神经网络进行预测非常简单。
import itertools # Import this at the top of your script
# Initialize required variables
y_pred = []
y_test = []
correct = 0
total = 0
"""
We're not training so we don't need to calculate the gradients for our outputs
"""
with torch.no_grad():
for X, y in test_dataloader:
outputs = model(X) # Get model outputs
predicted = np.where(outputs.numpy() < 0.5, 0, 1) # Convert to NumPy and apply threshold
predicted = list(itertools.chain(*predicted)) # Flatten predictions
y_pred.append(predicted) # Append predictions
y_test.append(y.numpy()) # Append true labels as NumPy
total += y.size(0) # Increment total count
correct += (predicted == y.numpy()).sum().item() # Count correct predictions
print(f'Accuracy of the network on the 3300 test instances: {100 * correct // total}%')
"""
Accuracy of the network on the 3300 test instances: 97%
"""
注意:每次运行代码都会产生不同的输出,因此您可能无法得到相同结果。
上述代码在不计算梯度的情况下,遍历存储于 test_dataloader 变量中的测试批次。我们对批次中的样本进行预测,并将结果存入 outputs 变量。接着,将小于 0.5 的值设为 0,将大于等于 0.5 的值设为 1。随后把这些值追加到预测列表中。
之后,我们将批次中样本的真实类别数累加到名为 total 的变量中。然后通过统计预测值等于真实类别的数量来计算正确预测的个数,并将每个批次的正确预测数累加到 correct 变量。
要计算整体模型的准确率,我们将正确预测的数量乘以 100(得到百分比),然后除以测试集中的样本数。我们的模型达到了 97% 的准确率。接着我们通过混淆矩阵和 scikit-learn 的 classification_report 进一步分析模型表现。
from sklearn.metrics import classification_report
from sklearn.metrics import confusion_matrix
import seaborn as sns
y_pred = list(itertools.chain(*y_pred))
y_test = list(itertools.chain(*y_test))
print(classification_report(y_test, y_pred))
"""
precision recall f1-score support
0.0 0.98 0.97 0.98 1635
1.0 0.98 0.98 0.98 1665
accuracy 0.98 3300
macro avg 0.98 0.98 0.98 3300
weighted avg 0.98 0.98 0.98 3300
"""
cf_matrix = confusion_matrix(y_test, y_pred)
plt.subplots(figsize=(8, 5))
sns.heatmap(cf_matrix, annot=True, cbar=False, fmt="g")
plt.show()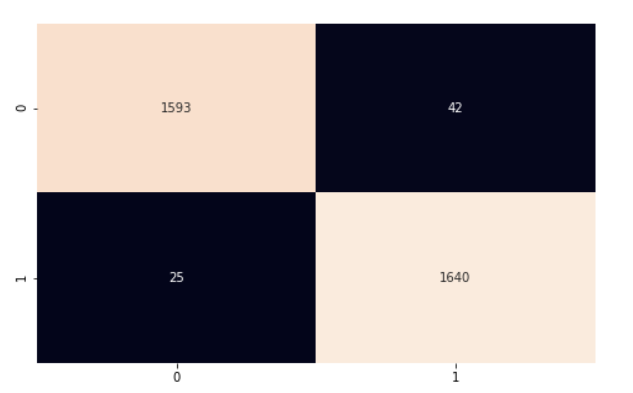
我们的模型表现相当不错。建议您探索这份代码并尝试做些修改,以加深对本文内容的理解。
在本篇 PyTorch 教程中,我们介绍了神经网络的基础知识,并使用 Python 的深度学习库 PyTorch 来实现网络。我们使用了 scikit-learn 的圆形数据集来训练一个用于分类的两层神经网络。随后对数据进行了预测,并使用准确率指标对结果进行了评估。