

इस PyTorch ट्यूटोरियल में, हम उन कोर फ़ंक्शनों को कवर करेंगे जो न्यूरल नेटवर्क को शक्ति देते हैं और शुरुआत से अपना खुद का नेटवर्क बनाएंगे। इस लेख का प्राथमिक उद्देश्य आपको PyTorch, एक ऑप्टिमाइज़्ड डीप लर्निंग टेंसर लाइब्रेरी, की बुनियादी समझ देना है, साथ ही यह पृष्ठभूमि भी प्रदान करना है कि न्यूरल नेटवर्क कैसे काम करते हैं।
नोट: इस DataCamp वर्कस्पेस को देखें ताकि आप इस लेख में लिखे गए कोड के साथ फ़ॉलो कर सकें।
न्यूरल नेटवर्क क्या हैं?
न्यूरल नेटवर्क को आर्टिफिशियल न्यूरल नेटवर्क (ANNs) भी कहा जाता है। यह आर्किटेक्चर डीप लर्निंग की नींव है, जो मशीन लर्निंग का एक उपसमुच्चय है और ऐसे एल्गोरिद्म पर केंद्रित है जो मानव मस्तिष्क की संरचना और कार्य से प्रेरणा लेते हैं। सरल शब्दों में, न्यूरल नेटवर्क उन आर्किटेक्चर का आधार हैं जो इस बात की नकल करते हैं कि जैविक न्यूरॉन्स एक-दूसरे को कैसे संकेत भेजते हैं।
नतीजतन, आप अक्सर ऐसे संसाधन पाएंगे जो आपको दृश्य रूप से समझाने के लिए पहले पाँच मिनट मानव मस्तिष्क की न्यूरल संरचना को मैप करने में लगाते हैं कि एक न्यूरल नेटवर्क कैसे काम करता है। लेकिन जब आपके पास अतिरिक्त पाँच मिनट नहीं हैं, तो न्यूरल नेटवर्क को एक ऐसे फ़ंक्शन के रूप में परिभाषित करना आसान है जो इनपुट्स को वांछित आउटपुट्स से मैप करता है।
सामान्य न्यूरल नेटवर्क आर्किटेक्चर में निम्न शामिल होते हैं:
- इनपुट लेयर: डेटा को नेटवर्क में इनपुट लेयर के माध्यम से फीड किया जाता है। इनपुट लेयर में न्यूरॉन्स की संख्या डेटा में फीचर्स की संख्या के बराबर होती है। तकनीकी रूप से इनपुट लेयर को नेटवर्क की लेयर नहीं माना जाता क्योंकि इस बिंदु पर कोई गणना नहीं होती।
- हिडन लेयर: इनपुट और आउटपुट लेयर के बीच की लेयर्स को हिडन लेयर्स कहा जाता है। किसी नेटवर्क में हिडन लेयर्स की संख्या मनमानी हो सकती है—जितनी अधिक हिडन लेयर्स होंगी, नेटवर्क उतना ही जटिल होगा।
- आउटपुट लेयर: आउटपुट लेयर का उपयोग प्रेडिक्शन करने के लिए किया जाता है।
- न्यूरॉन्स: प्रत्येक लेयर में न्यूरॉन्स का एक समूह होता है जो अन्य लेयर्स के न्यूरॉन्स के साथ अंतःक्रिया करते हैं।
- एक्टिवेशन फ़ंक्शन: गैर-रेखीय परिवर्तन करता है ताकि मॉडल डेटा से जटिल पैटर्न सीख सके।
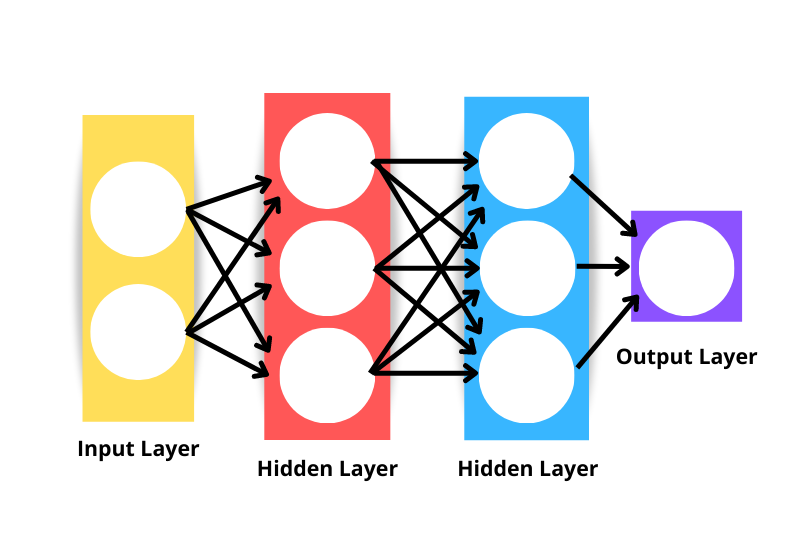
ध्यान दें कि ऊपर दी गई छवि में दर्शाया गया न्यूरल नेटवर्क तीन-लेयर न्यूरल नेटवर्क माना जाएगा, चार नहीं—क्योंकि हम इनपुट लेयर को लेयर में शामिल नहीं करते। इसलिए, किसी नेटवर्क में लेयर्स की संख्या = हिडन लेयर्स की संख्या + आउटपुट लेयर।
न्यूरल नेटवर्क कैसे काम करते हैं?
आइए एल्गोरिद्म को छोटे घटकों में बाँटें ताकि यह बेहतर समझ सकें कि न्यूरल नेटवर्क कैसे काम करते हैं।
वेट इनिशियलाइज़ेशन
वेट इनिशियलाइज़ेशन न्यूरल नेटवर्क आर्किटेक्चर का पहला घटक है। प्रारंभिक वेट्स वह शुरुआती बिंदु निर्धारित करते हैं जहाँ से न्यूरल नेटवर्क मॉडल का ऑप्टिमाइज़ेशन प्रोसेस शुरू होता है।
वेट्स कैसे सेट किए जाते हैं, यह खासकर डीप नेटवर्क बनाते समय महत्वपूर्ण है। इसका कारण यह है कि डीप नेटवर्क में एक्सप्लोडिंग या वैनिशिंग ग्रेडिएंट की समस्या की संभावना अधिक होती है। वैनिशिंग और एक्सप्लोडिंग ग्रेडिएंट समस्याएँ इस लेख के दायरे से बाहर हैं, लेकिन दोनों उन स्थितियों का वर्णन करती हैं जिनमें एल्गोरिद्म सीखने में विफल रहता है।
हालाँकि वेट इनिशियलाइज़ेशन वैनिशिंग या एक्सप्लोडिंग ग्रेडिएंट समस्या को पूरी तरह हल नहीं करता, यह निश्चित रूप से उसकी रोकथाम में योगदान देता है।
यहाँ कुछ सामान्य वेट इनिशियलाइज़ेशन तरीके हैं:
ज़ीरो इनिशियलाइज़ेशन
ज़ीरो इनिशियलाइज़ेशन का मतलब है कि वेट्स को शून्य से इनिशियलाइज़ किया जाए। यह अच्छा समाधान नहीं है क्योंकि हमारा न्यूरल नेटवर्क सिमेट्री नहीं तोड़ पाएगा—यह नहीं सीखेगा।
जब भी किसी स्थिर मान का उपयोग न्यूरल नेटवर्क के वेट्स को इनिशियलाइज़ करने के लिए किया जाता है, तो इसके खराब प्रदर्शन की उम्मीद की जा सकती है क्योंकि सभी लेयर्स एक ही चीज़ सीखेंगी। यदि सभी हिडन यूनिट आउटपुट्स का कॉस्ट पर समान प्रभाव है, तो ग्रेडिएंट्स भी समान होंगे।
रैंडम इनिशियलाइज़ेशन
रैंडम इनिशियलाइज़ेशन सिमेट्री को तोड़ता है, इसलिए यह ज़ीरो इनिशियलाइज़ेशन से बेहतर है, पर कुछ कारक मॉडल की कुल गुणवत्ता को प्रभावित कर सकते हैं।
उदाहरण के लिए, यदि वेट्स बड़े मानों से रैंडम इनिशियलाइज़ किए गए हैं, तो हर मैट्रिक्स मल्टिप्लिकेशन का परिणाम काफी बड़ा मान होगा। ऐसी स्थिति में अगर सिग्मॉइड एक्टिवेशन फ़ंक्शन लगाया जाए, तो परिणाम एक के पास का मान होगा, जो लर्निंग रेट को धीमा कर देता है।
एक और स्थिति जिसमें रैंडम इनिशियलाइज़ेशन समस्या पैदा कर सकता है, वह है जब वेट्स बहुत छोटे मानों से इनिशियलाइज़ किए जाएँ। तब हर मैट्रिक्स मल्टिप्लिकेशन बहुत छोटे मान उत्पन्न करेगा और सिग्मॉइड लगाने पर आउटपुट शून्य के पास का होगा, जो सीखने की गति को फिर धीमा कर देता है।
Xavier/Glorot इनिशियलाइज़ेशन
Xavier या Glorot इनिशियलाइज़ेशन—दोनों नामों से जाना जाता है—वेट्स को इनिशियलाइज़ करने का एक ह्यूरिस्टिक तरीका है। यह तरीका तब आम तौर पर देखा जाता है जब वेटेड एवरेज पर tanh या सिग्मॉइड एक्टिवेशन फ़ंक्शन लगाया जाता है। यह तरीका पहली बार 2010 के शोध पत्र Understanding the difficulty of training deep feedforward neural networks में Xavier Glorot और Yoshua Bengio द्वारा प्रस्तावित किया गया था। इस तकनीक का उद्देश्य नेटवर्क भर में वेरिएंस को समान रखना है ताकि ग्रेडिएंट्स के एक्सप्लोड या वैनिश होने से रोका जा सके।
He/Kaiming इनिशियलाइज़ेशन
He या Kaiming इनिशियलाइज़ेशन एक और ह्यूरिस्टिक तरीका है। He और Xavier ह्यूरिस्टिक में अंतर यह है कि He इनिशियलाइज़ेशन वेट्स के लिए अलग स्केलिंग फैक्टर का उपयोग करता है जो एक्टिवेशन फ़ंक्शनों की नॉन-लिनियरिटी को ध्यान में रखता है।
इसलिए, जब लेयर्स में ReLU एक्टिवेशन फ़ंक्शन का उपयोग किया जाता है, तो He इनिशियलाइज़ेशन अनुशंसित तरीका है। इस तरीके के बारे में अधिक जानने के लिए देखें Delving Deep into Rectifiers: Surpassing Human-Level Performance on ImageNet Classification (He और सह-लेखक)।
फ़ॉरवर्ड प्रोपेगेशन
न्यूरल नेटवर्क वेटेड एवरेज में एक बायस टर्म जोड़कर और उस पर एक्टिवेशन फ़ंक्शन लगाकर गैर-रेखीय परिवर्तन लागू करते हैं। वेटेड एवरेज की संरचना में, प्रत्येक वेट यह निर्धारित करता है कि प्रत्येक फीचर का महत्व कितना है (अर्थात, आउटपुट की भविष्यवाणी में उसका योगदान कितना है)।
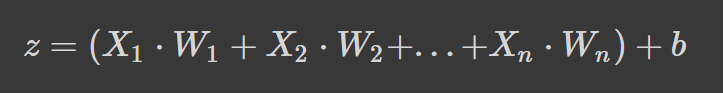
ऊपर का फ़ॉर्मूला वेटेड एवरेज में एक बायस टर्म जोड़ता है, जहाँ
- z किसी न्यूरॉन के इनपुट का वेटेड सम है
- Wn वेट्स को दर्शाता है
- Xn स्वतंत्र चलों (इंडिपेंडेंट वेरिएबल्स) को दर्शाता है, और
- b बायस टर्म है।
यदि यह फ़ॉर्मूला परिचित लगता है, तो ऐसा इसलिए है क्योंकि यह लीनियर रिग्रेशन है। यदि हम न्यूरॉन्स में नॉन-लिनियरिटी नहीं लाएँ, तो हमारे पास लीनियर रिग्रेशन होगा, जो एक सरल मॉडल है। गैर-रेखीय परिवर्तन हमारे न्यूरल नेटवर्क को जटिल पैटर्न सीखने देता है।
एक्टिवेशन फ़ंक्शंस
हम वेट इनिशियलाइज़ेशन अनुभाग में कुछ एक्टिवेशन फ़ंक्शंस का उल्लेख कर चुके हैं, और अब आप जानते हैं कि वे न्यूरल नेटवर्क आर्किटेक्चर में कितने महत्वपूर्ण हैं।
आइए कुछ सामान्य एक्टिवेशन फ़ंक्शंस में गहराई से देखें जिन्हें आप शोध पत्रों और दूसरों के कोड में अक्सर देखेंगे।
Sigmoid
सिग्मॉइड फ़ंक्शन की विशेषता एक “S”-आकृति वक्र है जो शून्य और एक के बीच सीमित है। यह डिफ़्रेन्शियेबल है, यानी वक्र का ढाल किसी भी दो बिंदुओं पर निकाला जा सकता है, और मोनोटोनिक है, यानी यह पूरी तरह न तो बढ़ता है न घटता है। आप आमतौर पर बाइनरी क्लासिफिकेशन समस्याओं के लिए सिग्मॉइड एक्टिवेशन फ़ंक्शन का उपयोग करेंगे।
यहाँ Python का उपयोग करके अपना सिग्मॉइड फ़ंक्शन विज़ुअलाइज़ करने का तरीका है:
# Sigmoid function in Python
import matplotlib.pyplot as plt
import numpy as np
x = np.linspace(-5, 5, 50)
z = 1/(1 + np.exp(-x))
plt.subplots(figsize=(8, 5))
plt.plot(x, z)
plt.grid()
plt.show()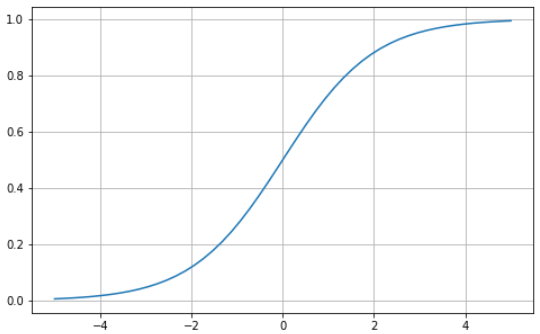
Tanh
हाइपरबोलिक टैन्जेंट (tanh) का “S”-आकृति वक्र सिग्मॉइड के समान है, सिवाय इसके कि इसके मान -1 और 1 के बीच सीमित होते हैं। इसलिए, छोटे इनपुट -1 के करीब और बड़े इनपुट 1 के करीब मैप होते हैं।
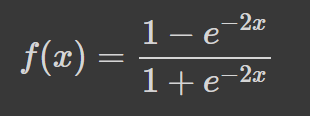
यहाँ Python में tanh फ़ंक्शन का एक उदाहरण विज़ुअलाइज़ेशन है:
# tanh function in Python
import matplotlib.pyplot as plt
import numpy as np
x = np.linspace(-5, 5, 50)
z = np.tanh(x)
plt.subplots(figsize=(8, 5))
plt.plot(x, z)
plt.grid()
plt.show()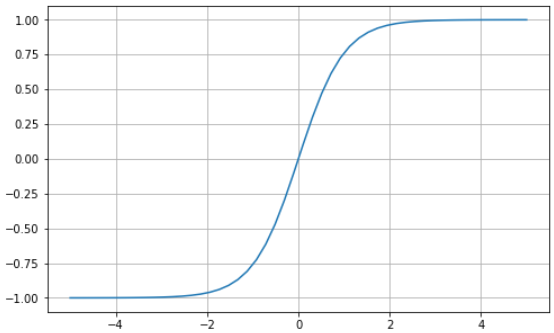
Softmax
सॉफ्टमैक्स फ़ंक्शन आमतौर पर आउटपुट लेयर में एक्टिवेशन फ़ंक्शन के रूप में उपयोग किया जाता है। यह सिग्मॉइड फ़ंक्शन का बहु-आयाम में सामान्यीकरण है। इसलिए, इसका उपयोग दो से अधिक लेबल्स पर वर्ग-सदस्यता (क्लास मेंबरशिप) की भविष्यवाणी करने के लिए किया जाता है।
Rectified Linear Unit (ReLU)
सिग्मॉइड या tanh फ़ंक्शन का उपयोग करके डीप न्यूरल नेटवर्क बनाना जोखिम भरा है क्योंकि इनमें वैनिशिंग ग्रेडिएंट समस्या की संभावना अधिक होती है। रेक्टिफाइड लिनियर यूनिट (ReLU) एक्टिवेशन फ़ंक्शन इस समस्या के समाधान के रूप में आया और कई न्यूरल नेटवर्क्स के लिए अक्सर डिफ़ॉल्ट एक्टिवेशन फ़ंक्शन होता है।
यहाँ Python में ReLU फ़ंक्शन का एक दृश्य उदाहरण है:
# ReLU in Python
import matplotlib.pyplot as plt
import numpy as np
x = np.linspace(-5, 5, 50)
z = [max(0, i) for i in x]
plt.subplots(figsize=(8, 5))
plt.plot(x, z)
plt.grid()
plt.show()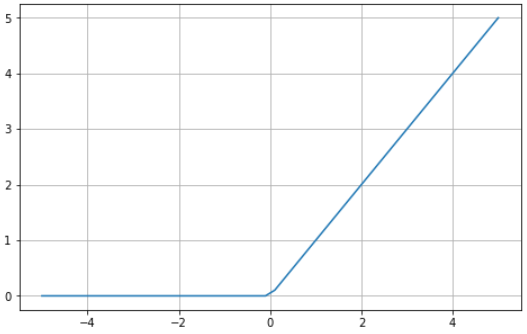
ReLU शून्य और अनंत के बीच सीमित है: ध्यान दें कि इनपुट मान जो शून्य से कम या बराबर हैं, उनके लिए फ़ंक्शन शून्य लौटाता है, और शून्य से बड़े मानों के लिए, फ़ंक्शन वही इनपुट मान लौटाता है (अर्थात, यदि आप दो इनपुट करते हैं तो दो ही लौटेगा)। अंततः, ReLU का व्यवहार रैखिक फ़ंक्शन से काफ़ी मिलता-जुलता है, जिससे इसे ऑप्टिमाइज़ और इम्प्लीमेंट करना कहीं आसान हो जाता है।
इनपुट से आउटपुट लेयर तक की प्रक्रिया को फ़ॉरवर्ड पास या फ़ॉरवर्ड प्रोपेगेशन कहा जाता है। इस चरण के दौरान, मॉडल द्वारा उत्पन्न आउटपुट का उपयोग कॉस्ट फ़ंक्शन की गणना के लिए किया जाता है ताकि प्रत्येक इटरेशन के बाद देखा जा सके कि न्यूरल नेटवर्क कैसा प्रदर्शन कर रहा है। फिर यह जानकारी वेट्स को सुधारने के लिए मॉडल के माध्यम से वापस भेजी जाती है, ताकि मॉडल बेहतर भविष्यवाणी कर सके—इसे बैकप्रोपेगेशन कहते हैं।
बैकप्रोपेगेशन
पहले फ़ॉरवर्ड पास के अंत में, नेटवर्क इनिशियलाइज़ किए गए, यानी अनट्यून किए हुए, वेट्स का उपयोग करके भविष्यवाणी करता है। इसलिए, यह बहुत संभव है कि मॉडल की भविष्यवाणियाँ सटीक न हों। फ़ॉरवर्ड प्रोपेगेशन से निकले लॉस का उपयोग करके, हम जानकारी को नेटवर्क में पीछे की ओर पास करते हैं ताकि वेट्स को फाइन-ट्यून किया जा सके—इसे बैकप्रोपेगेशन कहते हैं।
अंततः, हम ऑप्टिमाइज़ेशन फ़ंक्शन का उपयोग ऐसे वेट्स खोजने में सहायता के लिए कर रहे हैं जो त्रुटि दर को कम कर सकें, जिससे मॉडल अधिक विश्वसनीय बने और नए उदाहरणों पर बेहतर सामान्यीकरण कर सके। यह गणित कैसे काम करता है, यह इस लेख के दायरे से बाहर है, पर रुचि रखने वाले पाठक हमारे बैकप्रोपेगेशन पाठ को Introduction to Deep Learning in Python कोर्स में देख सकते हैं।
PyTorch ट्यूटोरियल: शुरुआत से न्यूरल नेटवर्क बनाने की चरण-दर-चरण प्रक्रिया
इस अनुभाग में, हम PyTorch लाइब्रेरी का उपयोग करके एक सरल आर्टिफ़िशियल न्यूरल नेटवर्क मॉडल बनाएंगे। कोड के साथ फ़ॉलो करने के लिए इस DataCamp वर्कस्पेस को देखें
PyTorch डीप लर्निंग के लिए सबसे लोकप्रिय लाइब्रेरियों में से एक है। यह TensorFlow की तुलना में अधिक प्रत्यक्ष डिबगिंग अनुभव प्रदान करता है। इसके कई अन्य फायदे भी हैं, जैसे डिस्ट्रिब्यूटेड ट्रेनिंग, मज़बूत इकोसिस्टम, क्लाउड सपोर्ट, प्रोडक्शन-रेडी कोड लिखने की सुविधा, आदि। आप PyTorch के बारे में अधिक जान सकते हैं Introduction to Deep Learning with PyTorch स्किल ट्रैक में।
चलिए ट्यूटोरियल शुरू करते हैं।
डेटा परिभाषा और तैयारी
हम इस ट्यूटोरियल में scikit-learn का make_circles डेटासेट उपयोग करेंगे—दस्तावेज़ देखें। यह एक टॉय डेटासेट है जिसमें द्वि-आयामी प्लेन पर एक बड़ा और उसके अंदर एक छोटा वृत्त होता है, और दो फीचर्स होते हैं। हमारे डेमो के लिए, हमने 10,000 सैंपल्स लिए और डेटा में 0.05 स्टैंडर्ड डिविएशन का गॉसियन शोर जोड़ा।
न्यूरल नेटवर्क बनाने से पहले, यह अच्छी प्रैक्टिस है कि हम अपने डेटा को ट्रेनिंग और टेस्टिंग सेट में विभाजित करें ताकि अनदेखे डेटा पर मॉडल के प्रदर्शन का मूल्यांकन कर सकें।
import matplotlib.pyplot as plt
from sklearn.datasets import make_circles
from sklearn.model_selection import train_test_split
# Create a dataset with 10,000 samples.
X, y = make_circles(n_samples = 10000,
noise= 0.05,
random_state=26)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=.33, random_state=26)
# Visualize the data.
fig, (train_ax, test_ax) = plt.subplots(ncols=2, sharex=True, sharey=True, figsize=(10, 5))
train_ax.scatter(X_train[:, 0], X_train[:, 1], c=y_train, cmap=plt.cm.Spectral)
train_ax.set_title("Training Data")
train_ax.set_xlabel("Feature #0")
train_ax.set_ylabel("Feature #1")
test_ax.scatter(X_test[:, 0], X_test[:, 1], c=y_test)
test_ax.set_xlabel("Feature #0")
test_ax.set_title("Testing data")
plt.show()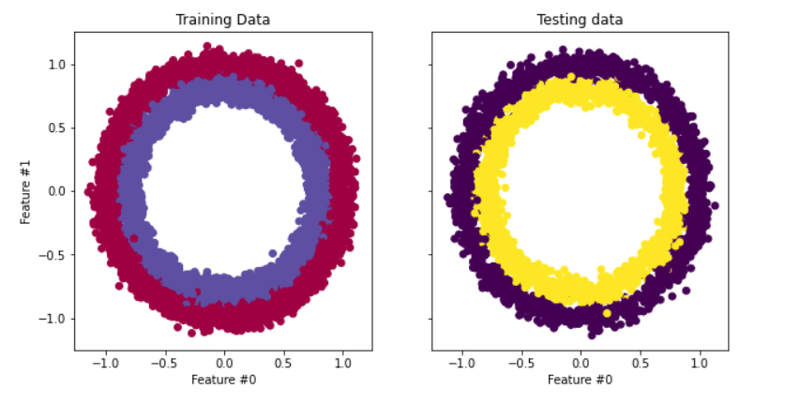
अगला चरण ट्रेनिंग और टेस्टिंग डेटा को NumPy ऐरे से PyTorch टेंसर में बदलना है। इसके लिए हम अपने ट्रेनिंग और टेस्ट फ़ाइलों के लिए एक कस्टम डेटासेट बनाएँगे। हम PyTorch के Dataloader मॉड्यूल का भी उपयोग करेंगे ताकि हम अपने डेटा को बैचों में ट्रेन कर सकें। यह रहा कोड:
import warnings
warnings.filterwarnings("ignore")
!pip install torch -q
import torch
import numpy as np
from torch.utils.data import Dataset, DataLoader
# Convert data to torch tensors
class Data(Dataset):
def __init__(self, X, y):
self.X = torch.from_numpy(X.astype(np.float32))
self.y = torch.from_numpy(y.astype(np.float32))
self.len = self.X.shape[0]
def __getitem__(self, index):
return self.X[index], self.y[index]
def __len__(self):
return self.len
batch_size = 64
# Instantiate training and test data
train_data = Data(X_train, y_train)
train_dataloader = DataLoader(dataset=train_data, batch_size=batch_size, shuffle=True)
test_data = Data(X_test, y_test)
test_dataloader = DataLoader(dataset=test_data, batch_size=batch_size, shuffle=True)
# Check it's working
for batch, (X, y) in enumerate(train_dataloader):
print(f"Batch: {batch+1}")
print(f"X shape: {X.shape}")
print(f"y shape: {y.shape}")
break
"""
Batch: 1
X shape: torch.Size([64, 2])
y shape: torch.Size([64])
"""अब आइए अपने न्यूरल नेटवर्क को इम्प्लीमेंट करने और ट्रेन करने की ओर बढ़ें।
न्यूरल नेटवर्क इम्प्लीमेंटेशन और मॉडल ट्रेनिंग
हम एक सरल दो-लेयर वाला न्यूरल नेटवर्क इम्प्लीमेंट करेंगे जो ReLU एक्टिवेशन फ़ंक्शन (torch.nn.functional.relu) का उपयोग करता है। इसके लिए हम NeuralNetwork नाम का एक क्लास बनाएँगे जो nn.Module (PyTorch में सभी न्यूरल नेटवर्क मॉड्यूल्स का बेस क्लास) से इनहेरिट करेगा।
यह रहा कोड:
import torch
from torch import nn
from torch import optim
input_dim = 2
hidden_dim = 10
output_dim = 1
class NeuralNetwork(nn.Module):
def __init__(self, input_dim, hidden_dim, output_dim):
super(NeuralNetwork, self).__init__()
self.layer_1 = nn.Linear(input_dim, hidden_dim)
nn.init.kaiming_uniform_(self.layer_1.weight, nonlinearity="relu")
self.layer_2 = nn.Linear(hidden_dim, output_dim)
def forward(self, x):
x = torch.nn.functional.relu(self.layer_1(x))
x = torch.nn.functional.sigmoid(self.layer_2(x))
return x
model = NeuralNetwork(input_dim, hidden_dim, output_dim)
print(model)
"""
NeuralNetwork(
(layer_1): Linear(in_features=2, out_features=10, bias=True)
(layer_2): Linear(in_features=10, out_features=1, bias=True)
)
"""और बस इतना ही।
मॉडल को ट्रेन करने के लिए हमें एक लॉस फ़ंक्शन परिभाषित करना होगा ताकि उससे ग्रेडिएंट्स निकाले जा सकें और एक ऑप्टिमाइज़र ताकि पैरामीटर्स अपडेट किए जा सकें। हमारे डेमो के लिए, हम बाइनरी क्रॉसएंट्रॉपी और स्टोकेस्टिक ग्रेडिएंट डिसेंट का उपयोग 0.1 लर्निंग रेट के साथ करेंगे।
learning_rate = 0.1
loss_fn = nn.BCELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=leaचलिए अपना मॉडल ट्रेन करते हैं
num_epochs = 100
loss_values = []
for epoch in range(num_epochs):
for X, y in train_dataloader:
# zero the parameter gradients
optimizer.zero_grad()
# forward + backward + optimize
pred = model(X)
loss = loss_fn(pred, y.unsqueeze(-1))
loss_values.append(loss.item())
loss.backward()
optimizer.step()
print("Training Complete")
"""
Training Complete
"""क्योंकि हमने लॉस मानों को ट्रैक किया है, हम समय के साथ मॉडल के लॉस को विज़ुअलाइज़ कर सकते हैं।
step = range(len(loss_values))
fig, ax = plt.subplots(figsize=(8,5))
plt.plot(step, np.array(loss_values))
plt.title("Step-wise Loss")
plt.xlabel("Epochs")
plt.ylabel("Loss")
plt.show()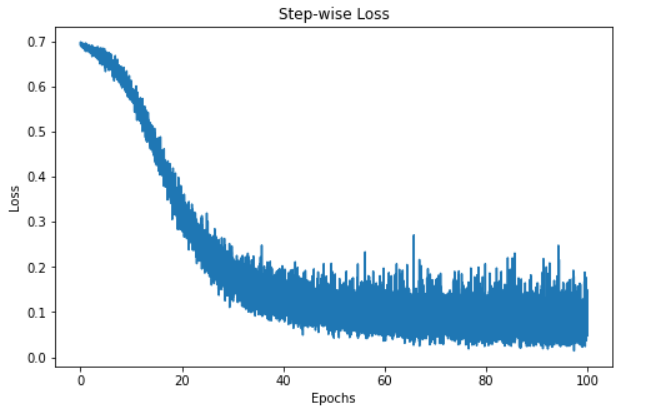
ऊपर का विज़ुअलाइज़ेशन हमारे मॉडल का 100 epochs में लॉस दिखाता है। शुरुआती तौर पर लॉस 0.7 से शुरू होता है और धीरे-धीरे घटता है—यह बताता है कि समय के साथ हमारा मॉडल अपनी भविष्यवाणियाँ बेहतर करता गया है। हालाँकि, लगभग 60वें epoch के आसपास मॉडल प्लेटो होता दिखता है, जिसके कई कारण हो सकते हैं, जैसे मॉडल लॉस फ़ंक्शन के किसी लोकल या ग्लोबल मिनिमम के पास पहुँच गया हो।
फिर भी, मॉडल ट्रेन हो चुका है और नए उदाहरणों पर भविष्यवाणी करने के लिए तैयार है—अगले सेक्शन में देखते हैं यह कैसे करें।
प्रेडिक्शंस और मॉडल मूल्यांकन
अपने PyTorch न्यूरल नेटवर्क से भविष्यवाणी करना काफ़ी सरल है।
import itertools # Import this at the top of your script
# Initialize required variables
y_pred = []
y_test = []
correct = 0
total = 0
"""
We're not training so we don't need to calculate the gradients for our outputs
"""
with torch.no_grad():
for X, y in test_dataloader:
outputs = model(X) # Get model outputs
predicted = np.where(outputs.numpy() < 0.5, 0, 1) # Convert to NumPy and apply threshold
predicted = list(itertools.chain(*predicted)) # Flatten predictions
y_pred.append(predicted) # Append predictions
y_test.append(y.numpy()) # Append true labels as NumPy
total += y.size(0) # Increment total count
correct += (predicted == y.numpy()).sum().item() # Count correct predictions
print(f'Accuracy of the network on the 3300 test instances: {100 * correct // total}%')
"""
Accuracy of the network on the 3300 test instances: 97%
"""
नोट: कोड के हर रन में अलग आउटपुट आ सकता है, इसलिए आपके परिणाम समान न भी हों।
ऊपर का कोड बिना ग्रेडिएंट्स की गणना किए, test_dataloader वेरिएबल में संग्रहीत टेस्ट बैचों के माध्यम से लूप करता है। फिर हम बैच की इंस्टेंसों की भविष्यवाणी करते हैं और परिणामों को outputs नामक वेरिएबल में रखते हैं। अगला कदम है 0.5 से कम मानों को 0 और 0.5 के बराबर या उससे बड़े मानों को 1 सेट करना। इन मानों को फिर हमारी प्रेडिक्शंस की सूची में जोड़ दिया जाता है।
उसके बाद, हम बैच में इंस्टेंसों के वास्तविक लेबल्स की गिनती को total नामक वेरिएबल में जोड़ते हैं। फिर हम सही भविष्यवाणियों की संख्या की गणना करते हैं—यानी जितनी भविष्यवाणियाँ वास्तविक क्लास से मेल खाती हैं—और उनका योग लेते हैं। प्रत्येक बैच के लिए सही भविष्यवाणियों की कुल संख्या को बढ़ाकर correct वेरिएबल में रखा जाता है।
कुल मॉडल एक्यूरेसी निकालने के लिए, हम सही भविष्यवाणियों की संख्या को 100 से गुणा करते हैं (प्रतिशत पाने के लिए) और फिर उसे अपने टेस्ट सेट में मौजूद इंस्टेंसों की संख्या से भाग दे देते हैं। हमारे मॉडल की एक्यूरेसी 97% आई। बेहतर समझ के लिए हम कन्फ्यूज़न मैट्रिक्स और scikit-learn के classification_report का उपयोग करते हैं ताकि मॉडल के प्रदर्शन का गहन आकलन कर सकें।
from sklearn.metrics import classification_report
from sklearn.metrics import confusion_matrix
import seaborn as sns
y_pred = list(itertools.chain(*y_pred))
y_test = list(itertools.chain(*y_test))
print(classification_report(y_test, y_pred))
"""
precision recall f1-score support
0.0 0.98 0.97 0.98 1635
1.0 0.98 0.98 0.98 1665
accuracy 0.98 3300
macro avg 0.98 0.98 0.98 3300
weighted avg 0.98 0.98 0.98 3300
"""
cf_matrix = confusion_matrix(y_test, y_pred)
plt.subplots(figsize=(8, 5))
sns.heatmap(cf_matrix, annot=True, cbar=False, fmt="g")
plt.show()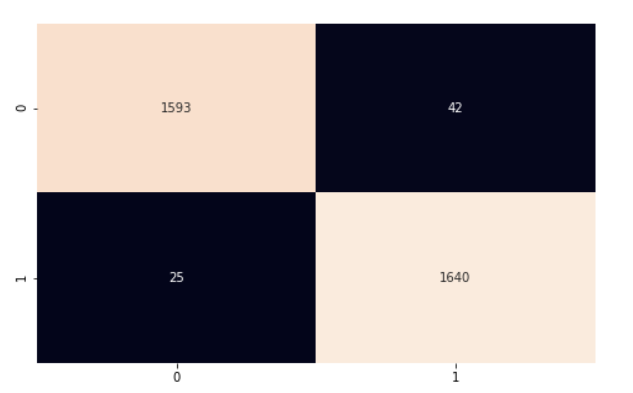
हमारा मॉडल काफ़ी अच्छा प्रदर्शन कर रहा है। मैं आपको प्रोत्साहित करता हूँ कि आप कोड को एक्सप्लोर करें और कुछ बदलाव करें, ताकि इस लेख में कवर की गई बातों को और मज़बूती से समझ सकें।
इस PyTorch ट्यूटोरियल में, हमने न्यूरल नेटवर्क की बुनियादी नींव को कवर किया और डीप लर्निंग के लिए Python लाइब्रेरी PyTorch का उपयोग करके अपना नेटवर्क इम्प्लीमेंट किया। हमने scikit-learn के सर्कल्स डेटासेट का उपयोग करके वर्गीकरण के लिए दो-लेयर वाला न्यूरल नेटवर्क ट्रेन किया। इसके बाद हमने डेटा पर भविष्यवाणियाँ कीं और एक्यूरेसी मेट्रिक का उपयोग करके अपने परिणामों का मूल्यांकन किया।