

细想一下,R 中有许多函数都会用到公式:ggplot2、stats、lattice 和 dplyr 等包都用到了它们!在使用 glm()、lm()、facet_wrap() 等函数时,您常常会用到这些 R 对象。那么,这些公式究竟是什么?为什么要使用它们?
R 中的数据结构
由于公式是 R 编程语言中的一种特殊类,先简要回顾一下这门语言可用的数据类型和数据结构是很有必要的。
请记住,R 是一门面向对象的编程语言:语言围绕对象组织。一切皆对象。
从头开始:在编程中,您通过数据结构来存储数据,通过函数来处理数据。数据结构是对计算机内存中数据进行组织的接口。正如 R 语言定义 所述,R 不提供对计算机内存的直接访问,而是提供了若干可称为“对象”的专用数据结构。每种数据结构都旨在优化存储、访问或处理的某一方面。
R 中五种主要的数据结构是:
- 原子向量,
- 列表,
- 矩阵,
- 数据框,以及
- 数组
# Create variables
a <- c(1,2,3,4,5,6,7,8,9)
b <- list(x = LifeCycleSavings[,1], y = LifeCycleSavings[,2])
提示:您可以使用 typeof() 函数返回 R 对象的类型。对象的类型能告诉您更多关于对象(R 内部)类型或存储模式的信息:
# Retrieve the types of `a` and `b`
typeof(a)
typeof(b)
'double'
'list'
在上面的示例中,您定义了变量 a 和 b,可以看到这些数据结构都包含数据元素的序列。这些元素可以是相同或不同的数据类型。R 中有以下 6 种原子数据类型:
- numeric,例如
100、5、4,包括整数; - character,例如
"Hello"、"True"或"23.4",由键盘字符组成的字符串; - logical,例如
TRUE或FALSE,由“真值”组成; - raw,例如
48 65 6c 6c 6f,由比特组成; - complex,例如
2+5i,包含复数;最后, - double,例如
3.14,包含小数。
R 中几乎所有对象都有附加的属性。例如,您也许已经知道,矩阵和数组本质上只是附加了 dim 属性以及可选的 dimnames 属性的向量。属性用于实现 R 中使用的类结构。作为一门面向对象的语言,类与方法的概念是其核心。类是对象的定义。它定义了对象包含哪些信息以及如何使用该对象。
请看以下示例:
# Retrieve the classes of `a` and `b`
class(a)
class(b)
'numeric'
'list'
注意,如果对象没有 class 属性,它将具有隐式类,“matrix”“array”或 mode() 函数的结果。
您可能会遇到的一些特殊类包括日期和公式;而后者正是本教程的主题!
R 中的公式是什么?
正如您在本教程的介绍中读到的,使用 ggplot2 等包或 lm() 等函数时,您可能已经见过公式的身影。由于您通常在这些函数调用中使用公式来表达统计模型的思想,因此很自然地,您经常会在建模函数以及某些图形函数中使用这些 R 对象。
对吗?
然而,公式并不限于模型。它们是一种强大的通用工具,允许您捕获两件事:
- 未求值的表达式,以及
- 创建该表达式时的上下文或环境。
这就解释了为什么在函数调用中使用公式可以生成“特殊行为”:它们可以在不对变量求值的情况下捕获变量的值,从而让函数来解释它们。
在回顾了数据结构之后,您可以将这些 R 对象描述为“语言”对象或未求值的表达式,它们的类是“formula”,并且具有存储环境的属性。
在上一节中,您看到对象具有某些(R 内部)类型,指示对象是如何存储的。在这种情况下,公式是一种“language”类型的对象。
但这究竟意味着什么?
通常,当您处理 R 语言本身时,会遇到此类对象。看下面的示例会更容易理解:
# Retrieve the object type
typeof(quote(x * 10))
# Retrieve the class
class(quote(x * 10))
'language'
'call'
在上面的示例中,您让 R 返回 quote(x*10) 的类型和类。结果显示,quote(x*10) 的类型是 'language',其 class 是 'call'。
这显然不是公式,因为您需要 class() 返回 'formula' 才行!
那么什么才是呢?
R 中公式的一个特征是波浪号运算符 ~。通过这个运算符,您实际上在说:“捕获这段代码的含义,但先不要立刻求值”。这也解释了为什么可以将 R 中的公式视为一种“引用(quoting)”运算符。
但公式到底长什么样?仔细看下面的代码行:
# A formula
c <- y ~ x
d <- y ~ x + b
# Double check the class of `c`
class(c)
'formula'
波浪号(~)左侧的变量称为“因变量”,而右侧的变量称为“自变量”,并用加号 + 连接。
需要知道的是,这些变量的称呼会根据上下文而变化。您可能已经见过自变量被称为“预测(变量)”“控制变量”“特征”等。同样,因变量也可能被称为“响应变量”“结果变量”或“标签”。
注意,尽管您在上面的代码块中定义的公式 d 包含一些变量,但公式的基本结构其实只是波浪号 ~ 加上至少一个自变量(右侧变量)。
请记住,公式实际上是带有存储环境属性的语言对象:
# Return the type of `d`
typeof(d)
# Retrieve the attributes of `d`
attributes(d)
'language'
$class
[1] "formula"
$.Environment
<environment: R_GlobalEnv>
如上面的示例所示,包含在公式中的变量可以是向量等。不过,您经常会看到,公式中包含的变量来自数据框,就像下面的示例:
Sepal.Width ~ Petal.Width + log(Petal.Length) + Species
注意,在创建公式本身时,不会访问已分配给公式中符号的任何数据值。
既然知道了 R 中公式的外观和含义,有必要提到基础的公式对象会因为是一侧公式还是双侧公式而不同。如果左侧没有变量,就像 ~ x 这样,您看到的是一侧公式。
这也意味着一侧公式的长度为 2,而双侧公式的长度为 3。
还不太信服?看下面的代码块。您可以借助方括号 [[ 和 ]] 访问公式的元素。
e <- ~ x + y + z
f <- y ~ x + b
# Return the length of `g`
length(e)
length(f)
# Retrieve the elements at index 1 and 2
e[[1]]
e[[2]]
f[[3]]
2
3
`~`
x + y + z
x + b为什么在 R 中使用公式?
如您所见,公式是一种强大的通用工具,允许您在不对变量求值的情况下捕获变量的值,以便函数进行解释。这已经解答了为何应在 R 中使用公式的一个方面。
此外,您还会用这些 R 对象来表达变量之间的关系。
例如,在下面代码块的第一行,您用第一行代码表达“y 是 x、a 和 b 的函数”;当然,您也会遇到更复杂的公式,比如第二行代码,表示“萼片宽度是花瓣宽度的函数,并按物种进行条件分组”。
y ~ x + a + b
Sepal.Width ~ Petal.Width | Species
y ~ x + a + b
Sepal.Width ~ Petal.Width | Species在 R 中使用公式
既然您已经了解了这些特殊 R 对象的“是什么”和“为什么”,接下来就来学习如何使用基础和更复杂的公式!本节中,您不仅会看到如何创建并连接基础公式,还会了解如何借助运算符构建更复杂的公式。
如何在 R 中创建公式
您已经会了!本教程中已经有一些示例了,但我们再回顾一下:
y ~ x
~ x + y + z
g <- y ~ x + b
没错——直接键入公式即可!
不过,您可能会遇到需要或希望从某个 R 对象(如字符串)创建公式的情况。在这种情形下,您可以使用 formula 或 as.formula() 函数:
"y ~ x1 + x2"
h <- as.formula("y ~ x1 + x2")
h <- formula("y ~ x1 + x2")
很简单!
如何连接多个公式
要将多个公式“粘”在一起,有两种方式。首先,您可以为每个公式创建单独的变量,然后使用 list():
# Create variables
i <- y ~ x
j <- y ~ x + x1
k <- y ~ x + x1 + x2
# Concatentate
formulae <- list(as.formula(i),as.formula(j),as.formula(k))
# Double check the class of the list elements
class(formulae[[1]])
'formula'
或者,您也可以使用 lapply() 函数,将包含所有公式的向量作为第一个参数传入,并将 as.formula 作为要应用到该向量每个元素的函数:
# Join all with `c()`
l <- c(i, j, k)
# Apply `as.formula` to all elements of `f`
lapply(l, as.formula)
[[1]]
y ~ x
[[2]]
y ~ x + x1
[[3]]
y ~ x + x1 + x2
公式运算符
掌握这些基础后,您就可以深入一些更复杂的公式了!上文中您已经看到,公式的特征是波浪号 ~。除了该符号之外,您还需要因变量和自变量,自变量之间可以用加号 + 连接。
但不止如此!
除了 + 符号,还有其他符号可以为公式增加特殊含义:
-用于移除项;:用于交互作用;*用于交叉;%in%用于嵌套;以及^用于将交叉限制到指定的次数。
接下来您会看到这些运算符的所有示例!先从 + 和 - 运算符开始:
# Use multiple independent variables
y ~ x1 + x2
# Ignore objects in an analysis
y ~ x1 - x2
注意,您最常在回归建模时需要 : 和 * 符号,用来指定交互项。如上所述,前者用于交互,意味着只包含变量之间的交互,而不包含变量本身。这与后者形成对比,后者用于交叉:它会包含两个变量以及它们的交互。
要小心!使用这些运算符时,有些公式看起来不同,但实际上是等价的。考虑以下示例,它们会产生相同的回归:
y ~ x1 * x2
y ~ x1 + x2 + x1:x2
不确定它们如何相同?看下面的 R 代码块:
# Set seed
set.seed(123)
# Data
x = rnorm(5)
x2 = rnorm(5)
y = rnorm(5)
# Model frame
model.frame(y ~ x * x2, data = data.frame(x = x, y = y, x2=x2))
| y | x | x2 |
|---|---|---|
| 1.7150650 | -0.56047565 | 1.2240818 |
| 0.4609162 | -0.23017749 | 0.3598138 |
| -1.2650612 | 1.55870831 | 0.4007715 |
| -0.6868529 | 0.07050839 | 0.1106827 |
| -0.4456620 | 0.12928774 | -0.5558411 |
model.frame(y ~ x + x2 + x:x2, data = data.frame(x = x, y = y, x2))
| y | x | x2 |
|---|---|---|
| 1.7150650 | -0.56047565 | 1.2240818 |
| 0.4609162 | -0.23017749 | 0.3598138 |
| -1.2650612 | 1.55870831 | 0.4007715 |
| -0.6868529 | 0.07050839 | 0.1106827 |
| -0.4456620 | 0.12928774 | -0.5558411 |
如果您还不了解 model.frame() 函数,不用担心;稍后您将在本教程中看到更多内容!
此外,下面是一个嵌套的示例,它可以展开为 y ~ a + a:b:
y ~ a + b %in% a
这些运算符都很酷,但如果您实际上想进行算术运算怎么办?比如,您想在模型中同时包含 x 和 x^2。这时,您可能会忍不住写出这样的公式:y ~ x + x^2。
但结果会符合预期吗?来看一下!
model.frame( y ~ x + x^2, data = data.frame(x = rnorm(5), y = rnorm(5)))
y ~ x + x^2
| y | x |
|---|---|
| -0.2053091 | 1.18231565 |
| -0.3030972 | 0.04779636 |
| -0.7621604 | 0.86382418 |
| -0.1377784 | -1.18333097 |
| -0.3813125 | -1.25247842 |
这并不是您所期望的结果!
在上面的示例中,您没有保护算术表达式,因此 R 会丢弃 x^2 项,因为它被视为 x 的重复项。
为什么呢?
x 会给出 x 的主效应,而 x^2 会给出 x 的主效应和二阶交互。最终,您只会在模型框架中包含 x,因为主效应已经由公式中的 x 项包含了,而 x^2 项中用于获得二阶交互的交叉对象并不存在。
为避免这种情况,您有几种解决方案:
- 您可以提前计算并存储所有变量
- 使用
I()或“As-is”运算符:y ~ x + I(x^2)
看下面的示例,理解在代码中加入 I() 函数的效果:
model.frame( y ~ x + I(x^2), data = data.frame(x = rnorm(5), y = rnorm(5)))
y ~ x + I(x^2)| y | x | I(x^2) |
|---|---|---|
| 1.414090 | -0.1996230 | 0.039849.... |
| 1.777646 | -1.0675904 | 1.139749.... |
| 1.710137 | -1.4071841 | 1.980167.... |
| 1.259111 | -1.3747289 | 1.889879.... |
| -1.490866 | 0.8323668 | 0.692834.... |
这最后一行代码实际上是在告诉 R,在使用公式之前先计算 x^2 的值。另请注意,您也可以使用“As-is”运算符对模型中的变量进行缩放;只需将相关变量名包在 I() 中:
y ~ I(2 * x)
上面的示例看起来可能有些抽象,我们再看看其他情形;例如,多项式回归。在这种情况下,您需要使用 I() 函数。另一方面,对于仅限于 depth=2 交互的析因 ANOVA 模型,则不需要该函数,因为您希望展开为包含 a、b、c 主效应以及它们二阶交互的公式:
# Polynomial Regression
y ~ x + I(x^2) + I(x^3)
# Factorial ANOVA
y ~ (a*b*c)^2
最后,还有一个在处理多个变量时非常有用的特性——. 运算符。在公式中使用该运算符,表示引用矩阵中尚未包含在模型中的所有其他变量。例如,当您要对矩阵或数据框进行回归且不想逐个输入所有变量时,这就很方便:
y ~ .
如何在 R 中检查公式
创建好公式后,您可能还想对其进行检查。本节将向您介绍一些可用于进一步探索您创建的这些特殊 R 对象的工具!
注意,在前面的章节中您已经看到了一些检查公式的方法:例如 attributes()、typeof()、class() 等函数。
terms() 函数
要检查和比较不同的公式,您可以使用 terms() 函数:
m <- formula("y ~ x1 + x2")
terms(m)
y ~ x1 + x2
attr(,"variables")
list(y, x1, x2)
attr(,"factors")
x1 x2
y 0 0
x1 1 0
x2 0 1
attr(,"term.labels")
[1] "x1" "x2"
attr(,"order")
[1] 1 1
attr(,"intercept")
[1] 1
attr(,"response")
[1] 1
attr(,".Environment")
<environment: R_GlobalEnv>all.vars
如果您想知道模型中的变量名,可以使用 all.vars。该函数会返回一个字符向量,包含公式中出现的所有名称:
print(all.vars(m))
[1] "y" "x1" "x2"update() 函数
如果要在不将公式转换为字符的情况下修改它,您可以使用 update() 函数:
update(y ~ x1 + x2, ~. + x3)
y ~ x1 + x2 + x3
注意,您也可以通过使用 as.character() 将公式转换为字符来更新它;然后使用 paste() 可以非常快速地构建公式。例如,如果您想在公式中添加另一个右侧变量,直接拼接即可:
as.formula(paste("y ~ x1 + x2", "x3", sep = "+"))
factors <- c("x2", "x3")
as.formula(paste("y~", paste(factors, collapse="+")))
y ~ x1 + x2 + x3
y ~ x2 + x3
在上面的代码块中,您可以看到,您可以使用 sep 或 collapse 参数来指定在公式项之间使用的分隔字符。
不过,使用 paste() 并不是调整公式的唯一方式:您还可以使用 reformulate():
reformulate(termlabels = factors, response = 'y')
y ~ x2 + x3
is.formula()
将变量传递给 is.formula() 函数,双重检查它是否是一个公式。请注意,该函数属于 plyr 库,因此在调用 is.formula() 之前,您需要先在工作空间中加载它!
# Load `plyr`
library(plyr)
# Check `m`
is.formula(m)
TRUE
何时使用公式
到目前为止,您已经了解到 R 公式是通用工具,并不局限于建模,而且也看到了可以使用公式的一些示例。本节将深入探讨这个话题:您将看到一些可以利用这些工具的场景。当然,我们会涵盖 lattice 和 stats 等包的建模和图形函数,还会涉及 dplyr 中的非标准求值。
建模函数
R 在统计建模方面非常出色。如您所知,统计建模是一种简化的、数学形式化的方式来近似现实,并可选择性地从这种近似中进行预测。统计模型通常以理想化的形式表示数据生成过程。要进行统计建模,您需要建模函数。
R 中的建模函数是需要 formula 对象作为参数的典型例子。您可能会在这些函数中看到的其他参数有 data(允许您指定在模型持续期间要附加的数据框)、用于选择要使用数据的 subset 等。一般来说,如果想知道要向某个特定函数传递哪些参数,请不要犹豫,在 R 控制台中使用 help() 函数或 ?。
建模函数会返回包含拟合信息的模型对象。print()、summary()、plot()、anova() 等通用 R 函数会针对特定对象类定义方法,以返回适合该类对象的信息。
最知名的建模函数之一可能是 lm(),它使用了上述所有参数。您使用 lm() 来拟合线性模型。它可用于执行回归、单层次的方差分析和协方差分析。我们来看一个使用 lm() 并借助 print() 检查模型的示例:
lm.m <- lm(Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
data = iris,
subset = Sepal.Length > 4.6)
print(lm.m)
Call:
lm(formula = Sepal.Width ~ Petal.Width + log(Petal.Length) +
Species, data = iris, subset = Sepal.Length > 4.6)
Coefficients:
(Intercept) Petal.Width log(Petal.Length) Speciesversicolor
3.1531 0.6620 0.4612 -1.9265
Speciesvirginica
-2.3088 lm() 首先使用公式及其相应环境,将变量之间的关系转换为创建包含数据的数据框。
还有 model.frame() 方法(您已在本教程中见过一个示例),它通常用于在无其他参数的情况下,从拟合对象中检索或重新创建模型框架。这使您能够检索与原始调用中除 formula、subset 和 weights 之外的参数相对应的数据框列:例如,glm() 方法会处理 offset、etastart 和 mustart。
在下面的代码块中,您会看到使用 model.frame() 函数获取拟合对象的数据框;注意代码与上面的代码块略有不同:subset 参数被稍作修改。
stats::model.frame(formula = Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
data = iris,
subset = Sepal.Length > 6.9,
drop.unused.levels = TRUE)
| Sepal.Width | Petal.Width | log(Petal.Length) | Species | |
|---|---|---|---|---|
| 51 | 3.2 | 1.4 | 1.547563 | versicolor |
| 103 | 3.0 | 2.1 | 1.774952 | virginica |
| 106 | 3.0 | 2.1 | 1.887070 | virginica |
| 108 | 2.9 | 1.8 | 1.840550 | virginica |
| 110 | 3.6 | 2.5 | 1.808289 | virginica |
| 118 | 3.8 | 2.2 | 1.902108 | virginica |
| 119 | 2.6 | 2.3 | 1.931521 | virginica |
| 123 | 2.8 | 2.0 | 1.902108 | virginica |
| 126 | 3.2 | 1.8 | 1.791759 | virginica |
| 130 | 3.0 | 1.6 | 1.757858 | virginica |
| 131 | 2.8 | 1.9 | 1.808289 | virginica |
| 132 | 3.8 | 2.0 | 1.856298 | virginica |
| 136 | 3.0 | 2.3 | 1.808289 | virginica |
提示:stats 包中还有更多支持使用公式的函数,例如 aggregate()。
对于线性混合效应模型(可对观测者差异等因素带来的变异建模为随机效应),您可以使用 nlme 包的 lme() 函数。在这里,您同样会看到,formula 是需要提供给建模函数的第一个参数,同时也有 data 参数!
# Load packages
library(MASS)
library(nlme)
# Get some data
data(oats)
# Adjust the data names and columns
names(oats) = c('block', 'variety', 'nitrogen', 'yield')
oats$mainplot = oats$variety
oats$subplot = oats$nitrogen
# Fit a non-linear mixed-effects model
nlme.m = lme(yield ~ variety*nitrogen,
random = ~ 1|block/mainplot,
data = oats)
# Retrieve a summary
summary(nlme.m)
Linear mixed-effects model fit by REML
Data: oats
AIC BIC logLik
559.0285 590.4437 -264.5143
Random effects:
Formula: ~1 | block
(Intercept)
StdDev: 14.64496
Formula: ~1 | mainplot %in% block
(Intercept) Residual
StdDev: 10.29863 13.30727
Fixed effects: yield ~ variety * nitrogen
Value Std.Error DF t-value p-value
(Intercept) 80.00000 9.106958 45 8.784492 0.0000
varietyMarvellous 6.66667 9.715028 10 0.686222 0.5082
varietyVictory -8.50000 9.715028 10 -0.874933 0.4021
nitrogen0.2cwt 18.50000 7.682957 45 2.407927 0.0202
nitrogen0.4cwt 34.66667 7.682957 45 4.512152 0.0000
nitrogen0.6cwt 44.83333 7.682957 45 5.835427 0.0000
varietyMarvellous:nitrogen0.2cwt 3.33333 10.865342 45 0.306786 0.7604
varietyVictory:nitrogen0.2cwt -0.33333 10.865342 45 -0.030679 0.9757
varietyMarvellous:nitrogen0.4cwt -4.16667 10.865342 45 -0.383482 0.7032
varietyVictory:nitrogen0.4cwt 4.66667 10.865342 45 0.429500 0.6696
varietyMarvellous:nitrogen0.6cwt -4.66667 10.865342 45 -0.429500 0.6696
varietyVictory:nitrogen0.6cwt 2.16667 10.865342 45 0.199411 0.8428
Correlation:
(Intr) vrtyMr vrtyVc ntr0.2 ntr0.4 ntr0.6
varietyMarvellous -0.533
varietyVictory -0.533 0.500
nitrogen0.2cwt -0.422 0.395 0.395
nitrogen0.4cwt -0.422 0.395 0.395 0.500
nitrogen0.6cwt -0.422 0.395 0.395 0.500 0.500
varietyMarvellous:nitrogen0.2cwt 0.298 -0.559 -0.280 -0.707 -0.354 -0.354
varietyVictory:nitrogen0.2cwt 0.298 -0.280 -0.559 -0.707 -0.354 -0.354
varietyMarvellous:nitrogen0.4cwt 0.298 -0.559 -0.280 -0.354 -0.707 -0.354
varietyVictory:nitrogen0.4cwt 0.298 -0.280 -0.559 -0.354 -0.707 -0.354
varietyMarvellous:nitrogen0.6cwt 0.298 -0.559 -0.280 -0.354 -0.354 -0.707
varietyVictory:nitrogen0.6cwt 0.298 -0.280 -0.559 -0.354 -0.354 -0.707
vM:0.2 vV:0.2 vM:0.4 vV:0.4 vM:0.6
varietyMarvellous
varietyVictory
nitrogen0.2cwt
nitrogen0.4cwt
nitrogen0.6cwt
varietyMarvellous:nitrogen0.2cwt
varietyVictory:nitrogen0.2cwt 0.500
varietyMarvellous:nitrogen0.4cwt 0.500 0.250
varietyVictory:nitrogen0.4cwt 0.250 0.500 0.500
varietyMarvellous:nitrogen0.6cwt 0.500 0.250 0.500 0.250
varietyVictory:nitrogen0.6cwt 0.250 0.500 0.250 0.500 0.500
Standardized Within-Group Residuals:
Min Q1 Med Q3 Max
-1.81300898 -0.56144838 0.01758044 0.63864476 1.57034166
Number of Observations: 72
Number of Groups:
block mainplot %in% block
6 18 注意,除了 nlme,还有诸如 lme4 等包,也专门用于拟合线性和广义线性混合效应模型。
另一个关于建模函数和公式的示例是 nls(),用于建立非线性模型:
# Set seed
set.seed(20160227)
# Data
x <- seq(0,50,1)
y <- ((runif(1,10,20)*x)/(runif(1,0,10)+x))+rnorm(51,0,1)
# Non-linear model
nls.m <- nls(y ~ a*x/(b+x),
start=c(a=4, b=1))
最后一个示例是用于构建广义线性模型(GLM)的函数。在 R 中,您可以使用 glm() 来实现。同样老生常谈,您仍要使用 formula 和 data 参数:
# Load package
library(MPDiR)
# Get the data
data(Chromatic)
# Model
glm.m <- glm(Thresh ~ Axis:(I(Age^-1) + Age),
family = Gamma(link = "identity"),
data = Chromatic)
# Get back a summary
summary(glm.m)
Call:
glm(formula = Thresh ~ Axis:(I(Age^-1) + Age), family = Gamma(link = "identity"),
data = Chromatic)
Deviance Residuals:
Min 1Q Median 3Q Max
-1.2160 -0.3728 -0.0805 0.2311 1.2932
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 3.282e-04 9.965e-05 3.294 0.00106 **
AxisDeutan:I(Age^-1) 7.803e-03 3.686e-04 21.172 < 2e-16 ***
AxisProtan:I(Age^-1) 8.271e-03 3.863e-04 21.410 < 2e-16 ***
AxisTritan:I(Age^-1) 1.166e-02 5.284e-04 22.065 < 2e-16 ***
AxisDeutan:Age 1.521e-05 3.418e-06 4.450 1.06e-05 ***
AxisProtan:Age 1.540e-05 3.434e-06 4.484 9.10e-06 ***
AxisTritan:Age 4.812e-05 5.838e-06 8.241 1.48e-15 ***
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
(Dispersion parameter for Gamma family taken to be 0.2054848)
Null deviance: 543.35 on 510 degrees of freedom
Residual deviance: 100.40 on 504 degrees of freedom
AIC: -4777.6
Number of Fisher Scoring iterations: 6在进入图形函数前,还有一件事值得了解:当您在 lm() 等建模函数中使用公式时,会发生从公式到函数的标准转换。要解释究竟发生了哪种转换,让我们回到本教程前面出现过的示例:
lm.m <- lm(Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
data = iris,
subset = Sepal.Length > 4.6)
虽然这段代码的目的是拟合线性回归模型,但公式既用于指定符号化模型,也用于生成所需的设计矩阵。设计矩阵是对预测变量或自变量集合的二维表示,其中数据实例为行、变量属性为列。设计矩阵也称为 X 矩阵。
也就是说,公式方法还定义了设计矩阵中应包含哪些列。
但这究竟意味着什么?看看下面的代码:
# A formula
y ~ x
# A converted formula
y = a_1 + a_2 * x
这是一个简单转换的示例:y ~ x 会被翻译为 y = a_1 + a_2 * x。
要查看并理解 R 实际做了什么,您可以使用 model_matrix() 函数。该函数会创建一个设计或模型矩阵,例如将因子展开为一组哑变量(取决于对比设置),并以类似方式展开交互项。
别忘了传入数据框 df 和公式,以获得一个定义模型方程的 tibble:
# Load packages
library(tidyverse)
library(modelr)
# A data frame
df <- tribble(
~y, ~x1, ~x2,
4, 2, 5,
5, 1, 6
)
# Model matrix
model_matrix(df, y ~ x1)
| (Intercept) | x1 |
|---|---|
| 1 | 2 |
| 1 | 1 |
您会看到多出了一列 (Intercept)。这是 R 的默认行为。不过,R 添加截距的方式只是添加一列全为 1 的列。如果您不想要它,需要在公式中显式加上 -1 来去掉它,就像这样:
model_matrix(df, y ~ x1-1)
| x1 |
|---|
| 2 |
| 1 |
另请注意,当您向模型中添加更多变量时,模型矩阵会以不意外的方式增长。
model_matrix(df, y ~ x1 + x2)
| (Intercept) | x1 | x2 |
|---|---|---|
| 1 | 2 | 5 |
| 1 | 1 | 6 |
R 中的图形函数
您会在 R 的图形函数中再次见到公式。相关包很多,本教程仅聚焦于 graphics、lattice、ggplot2 和 ggformula。
graphics
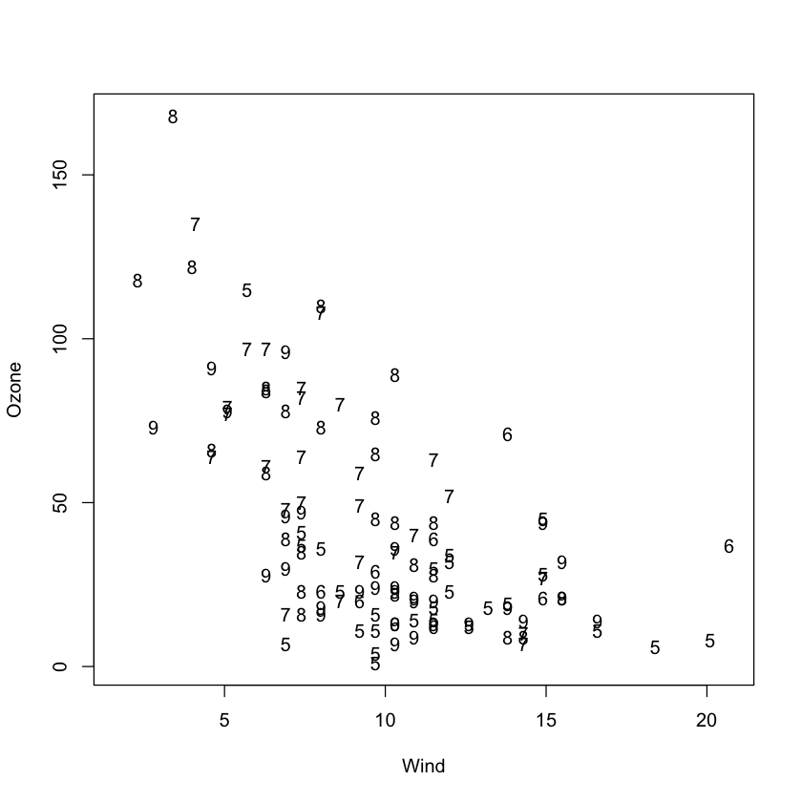
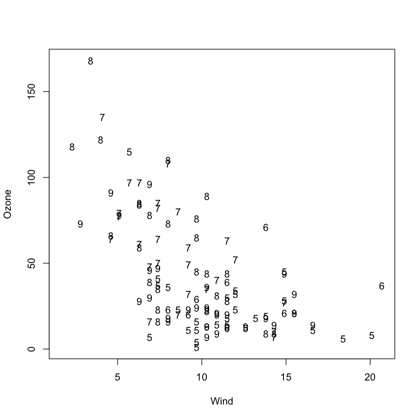
基础 R 包 graphics 允许您使用公式来指定散点图,或通过公式添加点、线或文本。看下面的示例:
# Get data
data(airquality)
# Plot
plot(Ozone ~ Wind, data = airquality, pch = as.character(Month))
如果您想了解更多,请查看此页面。
lattice
lattice 是一个构建于 grid 图形之上的包。它是一个通用图形包,为 base 图形中许多绘图函数提供了替代实现。具体示例包括使用 xyplot() 的散点图、使用 barchart() 的条形图,以及使用 bwplot() 的箱线图。
提示:想要进一步了解 lattice?可以考虑参加 DataCamp 的 使用 lattice 进行 R 数据可视化课程。
该包的特别之处在于,它使用统计模型的公式记法来描述期望的图形,更具体地说,是要绘制的变量。它还添加了管道字符或竖线 | 来指定条件变量:
# Load package
library(lattice)
# Plot histogram
histogram(~ Ozone | factor(Month),
data = airquality,
layout = c(2, 3),
xlab = "Ozone (ppb)")
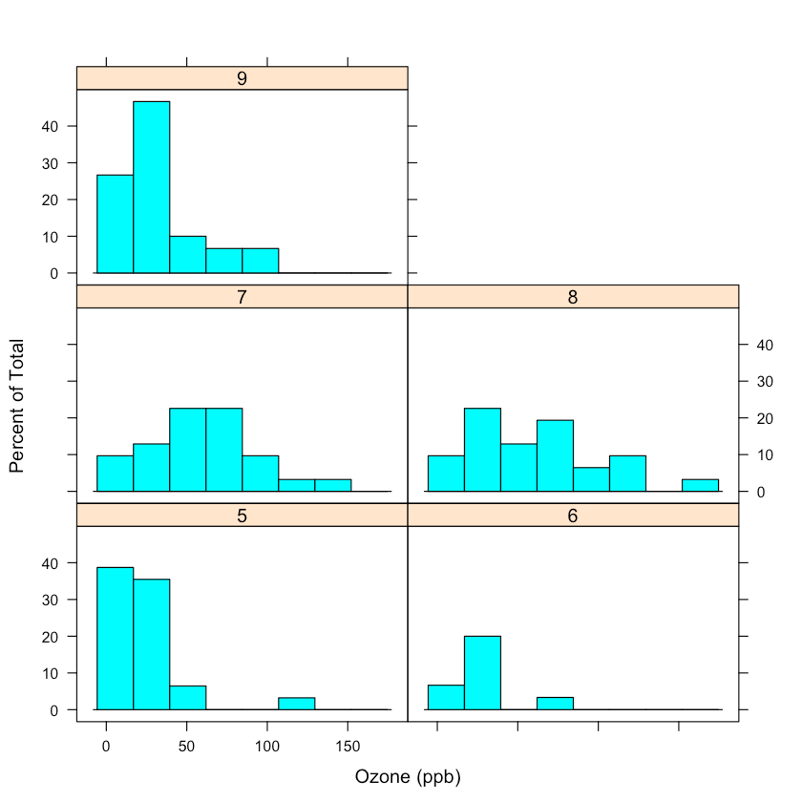
注意,与建模函数类似,lattice 库中的函数也有 formula 参数和 data 参数,这也正是人们的期望!
请记住,您也可以省略上面代码块中的 data 参数,但那样您需要先附加数据:
# Load package
library(lattice)
# Attach data
attach(airquality)
# Plot
histogram(~ Ozone | factor(Month),
layout = c(2, 3),
xlab = "Ozone (ppb)")
ggplot2
您可以在多种 ggplot2 函数中使用公式:
geom_smooth()或stats_smooth(),用于指定平滑函数中要使用的公式;这会影响拟合的形式。facet_wrap(),用于指定分面绘图的面板。facet_grid(),用于指定需要绘制的行和列,是否使用分面均可。
# Load package
library(ggplot2)
# Plot
ggplot(mpg, aes(displ, hwy)) +
geom_point() +
geom_smooth(method = "lm",
formula = y ~ splines::bs(x, 3),
se = FALSE)
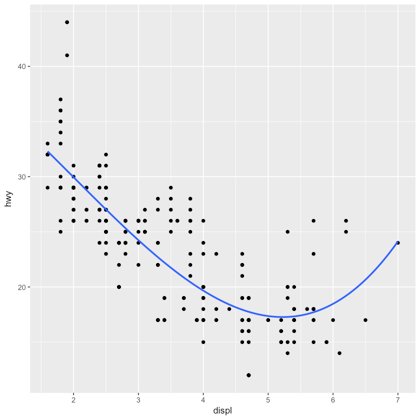
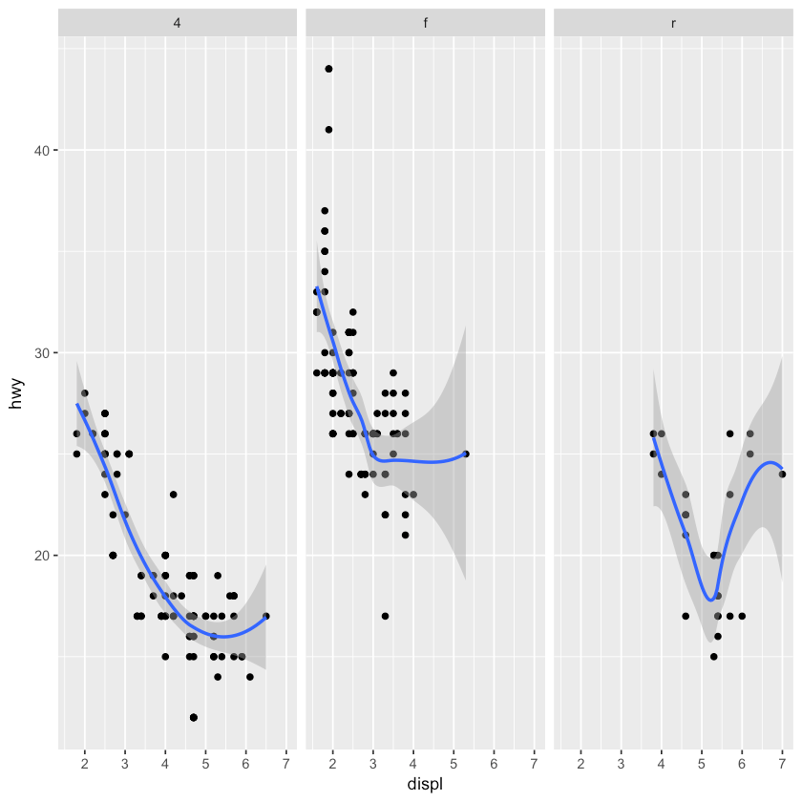
请注意,为创建该图,公式使用的是字母 x 和 y,而不是变量名。使用 facet_wrap() 时则不是这样:
ggplot(mpg, aes(displ, hwy)) +
geom_point() +
geom_smooth(span = 0.8) +
facet_wrap(~drv)
ggformula
ggformula 包目前构建于 ggplot2 之上,但提供了一个基于公式的接口。这与 lattice 接口类似。您还会发现,该包使用管道运算符将更简单的组件构建为更复杂的图形。
提示:如果您想了解更多关于R 中的管道运算符,请参考此教程。
使用 ggformula 创建图形的基本方式是
gf_plottype(formula, data = mydata)注意,函数 gf_plottype() 实际上以 gf 开头,是为了提醒您正在使用基于公式的 ggplot2 接口函数;g 代表 ggplot2,f 代表“formula”。
请看下面的示例,看看在 R 代码中它是什么样子:
# Load package
library(ggformula)
# Plot
gf_point(mpg ~ hp, data = mtcars)
当然,这只是一个基础图;使用这个可视化包,您可以做得更多!您可以选择不同的图元类型及其特定属性,可以制作一变量或双变量图,调整图元位置,等等。本教程不会对该包展开更多细节,但这里的要点是:该包让公式成为制作图形的主要“原料”!
如果您想了解本教程之外的更多内容,请在此处阅读 ggformula 包,或参阅该包的 RDocumentation 页面。
dplyr
dplyr 是一个使用非标准求值的包的例子。其他例子如 library(magrittr) 与 library("magrittr"),两者都能正常工作,即使一行带引号另一行不带!将这些 library() 示例与 install.packages() 做个对比:
# This will work
install.packages("magrittr")
# This won't work
install.packages(magrittr)
在 R 中,通常当您在命名对象的某个部分时需要使用引号,但在某些函数(如 library())中却不需要。这些函数被设计为以非标准方式工作。更甚者,其中一些函数甚至缺少标准方式!
就 dplyr 而言,您会发现该包的大多数函数与其他函数一样工作:所有函数都使用标准求值(SE)。不过,在交互式使用时,函数也提供了非标准求值(NSE),这能为您省下一些输入。
(说实话,敲那些引号的确让人头大!)
这就是为什么大多数 dplyr 函数使用非标准求值。它们不遵循 R 通常的求值规则。相反,它们会捕获您输入的表达式,并以自定义方式对其求值。
然而,这并不意味着这些函数没有标准求值变体。每个使用非标准求值的函数都有(并且应该有)一个标准求值“逃生通道”来进行实际计算。标准求值的函数应以下划线 _ 结尾。也就是说,dplyr 包中存在多组动词:select()、select_()、mutate()、mutate_(),等等。
在交互式使用时,这些函数会先用 lazyeval 包进行求值,然后再发送给该函数的标准求值版本。这意味着,在幕后,select() 会用 lazyeval 求值并发送至 select_()。
综上,有三种方式可以在标准求值函数中引用 dplyr 与 lazyeval 所理解的变量:
- 公式,
quote(),以及- 字符串
# Load `dplyr`
library(dplyr)
# NSE evaluation
select(iris, Sepal.Length, Petal.Length)
# standard evaluation
select_(iris, ~Sepal.Length)
select_(iris, ~Sepal.Length, ~Petal.Length) #works
select_(iris, quote(Sepal.Length), quote(Petal.Length)) # yes!
select_(iris, "Sepal.Length", "Petal.Length", "Species")
提示:如果您想进一步了解非标准求值,可以阅读 Hadley Wickham 的《Advanced R》一书中关于该主题的章节。
R 公式相关包
此前,您已经看到可以使用 as.formula、update()、all.vars 等函数创建并检查公式。这些都是简单的操作与处理,那么对于更高级的公式处理呢?也许下面这些包会引起您的兴趣!
Formula 包
不久前,该包已在 CRAN 上发布。对于想要将公式提升到更高层次的人来说,这个包非常理想。它扩展了基础的 formula 类。
更具体地说,Formula 对象扩展了基本的公式对象:使用该包,您实际上可以定义接受额外公式运算符 |(用于分隔多个部分)的公式,或在左侧潜在地容纳所有公式运算符(包括管道字符)以支持多响应。
您将能够创建的公式示例包括:
- 多部分公式,如
y ~ x1 + x2 | u1 + u2 + u3 | v1 + v2 - 多响应公式,如
y1 + y2 ~ x1 + x2 + x3 - 多部分响应,如
y1 | y2 + y3 ~ x,以及 - 上述三者的任意组合。
# Load package
library(Formula)
# Create formulas
f1 <- y ~ x1 + x2 | z1 + z2 + z3
F1 <- Formula(f1)
# Retrieve the class of `F1`
class(F1)
- 'Formula'
- 'formula'
注意,在该包中 as.formula() 和 is.formula() 也已更新:您将分别使用 is.Formula() 和 as.Formula()!
更多信息请见这里。
formula.tools
这个包近期发布,为您提供了“用于操作公式、表达式、调用、赋值和其他 R 对象的编程工具”。内容很多,但本质上就是:您可以使用该包访问和修改公式结构,以及提取并替换这些 R 对象的名称和符号。该包由 Christopher Brown 编写。
使用该包时,您可能会发现以下内容很有用:
get.vars():不同于all.vars(),该函数会从多种 R 对象中提取变量名,但所有符号等都会被内插为变量名。invert():您可以用该函数反转对象(如公式)中的运算符。is.one.sided():该函数非常适合判断公式是一侧还是双侧。
请记住,形如 ~x 的公式是一侧公式;形如 x~y 的则是双侧公式。
- ...
还有更多可探索!
太棒了!您已经通读了这篇关于 R 公式的教程。如果您想进一步阅读,强烈推荐 Hadley Wickham 的《R for Data Science》一书,其中有一章完全专门介绍 R 中的公式和模型族。
查看 DataCamp 的Tidyverse 入门教程。
您还能想到有哪些使用公式的场景,或有哪些可以用来操作公式的包吗?欢迎在 Twitter 上告诉我:@willems_karlijn。