Kurs
R’ye Giriş
4 sa
3.1M
Düşününce, R’de birçok fonksiyon formülleri kullanır: ggplot2, stats, lattice ve dplyr gibi paketlerin hepsi bunları kullanır! Bu R nesnelerini kullanacağınız fonksiyonlara yaygın örnekler arasında glm(), lm(), facet_wrap() vb. yer alır. Peki bu formüller tam olarak nedir ve neden kullanmalısınız?
Formüller R programlama dilinde özel bir sınıf olduğundan, bu dilde elinizin altında bulunan veri türlerini ve veri yapılarını kısaca gözden geçirmek iyi bir fikirdir.
Unutmayın R nesne yönelimli bir programlama dilidir: dil nesneler etrafında örgütlenmiştir. R’de her şey bir nesnedir.
En baştan başlayalım: programlamada veri yapıları verinizi saklar, fonksiyonlar ise onu işler. Bir veri yapısı, bilgisayar belleğinde düzenlenmiş verilere arayüzdür. R Dil Tanımı’nın belirttiği gibi, R bilgisayarın belleğine doğrudan erişim sağlamaz; bunun yerine "nesneler" diyeceğiniz bir dizi uzmanlaşmış veri yapısı sağlar. Veri yapıları, depolama, erişim veya işlemeye ilişkin belirli bir yönü optimize etmek üzere tasarlanır.
R’deki beş temel veri yapısı şunlardır:
# Create variables
a <- c(1,2,3,4,5,6,7,8,9)

b <- list(x = LifeCycleSavings[,1], y = LifeCycleSavings[,2])
İpucu: Bir R nesnesinin türünü döndürmek için typeof() fonksiyonunu kullanabilirsiniz. Bir nesnenin türü, herhangi bir nesnenin (R dahili) türü veya depolama kipine dair daha fazla bilgi verir:
# Retrieve the types of `a` and `b`
typeof(a)

typeof(b)
'double'
'list'
Yukarıdaki, a ve b değişkenlerini tanımladığınız örnekte, veri yapıların veri öğeleri dizileri içerdiğini görürsünüz. Bu öğeler aynı ya da farklı veri türlerinden olabilir. R’de aşağıdaki 6 atomik veri türünü bulabilirsiniz:
100, 5, 4 gibi sayısal (numeric); tamsayıları da kapsar."Hello", "True" veya "23.4" gibi karakter (character); klavye karakterlerinden oluşan dizgelerden oluşur;TRUE veya FALSE gibi mantıksal (logical); "doğruluk değerlerinden" oluşur;48 65 6c 6c 6f gibi ham (raw); bitlerden oluşur;2+5i gibi kompleks (complex); karmaşık sayıları içerir; ve son olarak,3.14 gibi double; ondalık sayıları içerir.R’de neredeyse tüm nesnelerin onlara ekli öznitelikleri (attributes) vardır. Örneğin, matrislerin ve dizilerin aslında vektörler olduğunu ve bu vektörlere dim ve isteğe bağlı olarak dimnames özniteliğinin eklendiğini zaten biliyor olabilirsiniz. Öznitelikler, R’de kullanılan sınıf yapısını uygulamak için kullanılır. Nesne yönelimli bir programlama dili olarak, sınıf kavramı ve yöntemler (methods) merkezi önemdedir. Bir sınıf, bir nesnenin tanımıdır. Nesnenin hangi bilgileri içerdiğini ve nasıl kullanılabileceğini tanımlar.
Aşağıdaki örneğe göz atın:
# Retrieve the classes of `a` and `b`
class(a)

class(b)
'numeric'
'list'
Not bir nesnenin class özniteliği yoksa, örtük bir sınıfa sahiptir: "matrix", "array" veya mode() fonksiyonunun sonucu.
Karşılaşabileceğiniz özel sınıflardan bazıları Dates ve Formulas’tır; Ve sonuncusu bugünkü eğitimin konusudur!
Bu eğitimin girişinde okuduğunuz gibi, ggplot2 gibi paketlerle çalışırken veya lm() gibi fonksiyonlarda formülleri zaten görmüş olabilirsiniz. Genellikle istatistiksel bir model fikrini ifade etmek için bu fonksiyon çağrılarında formülleri kullandığınızdan, bu R nesnelerini hem modelleme fonksiyonlarında hem de bazı görsel fonksiyonlarda sık sık kullanmanız mantıklıdır.
Öyle değil mi?
Ancak, formüller sadece modellere özgü değildir. Değerlendirmeden iki şeyi yakalamanıza izin veren güçlü, genel amaçlı araçlardır:
Bu, fonksiyon çağrılarının içinde "özel davranış" üretmek için formüllerin neden kullanıldığını açıklar: değişkenlerin değerlerini değerlendirmeden yakalamanıza izin verirler, böylece fonksiyon tarafından yorumlanabilirler.
Veri yapıları aklınızdayken, bu R nesnelerini sınıfı "formula" olan ve ortamı saklayan bir özniteliğe sahip "dil" nesneleri veya değerlendirilmemiş ifadeler olarak tanımlayabilirsiniz.
Önceki bölümde, nesnelerin nesnenin nasıl depolandığını gösteren belirli (R dahili) türlere sahip olduğunu gördünüz. Bu durumda, bir formül "language" türünde bir nesnedir.
Ama bu tam olarak ne anlama geliyor?
Genellikle bu tür nesnelerle R dilinin kendisini işlerken karşılaşırsınız. Bunu daha iyi anlamak için aşağıdaki örneğe bakın:
# Retrieve the object type
typeof(quote(x * 10))

# Retrieve the class
class(quote(x * 10))
'language'
'call'
Yukarıdaki örnekte, R’den quote(x*10) ifadesinin türünü ve sınıfını döndürmesini istersiniz. Sonuç olarak, quote(x*10)’un türünün 'language' ve class’ının 'call' olduğunu görürsünüz.
Bu kesinlikle bir formül değildir; çünkü class()’ın 'formula' döndürmesi gerekirdi!
Peki ne öyledir?
R’de formülleri karakterize eden şey tilde işleci ~’dır. Bu işleçle aslında şunu söyleyebilirsiniz: "Bu kodun anlamını yakala, ama hemen değerlendirme". Bu da R’de bir formülü bir "alıntılama" (quoting) işleci olarak düşünebilmenizi açıklar.
Ancak bir formül tam olarak nasıl görünür? Aşağıdaki kod satırına daha yakından bakın:
# A formula
c <- y ~ x
d <- y ~ x + b

# Double check the class of `c`
class(c)
'formula'
Tildenin (~) sol tarafındaki değişkene "bağımlı değişken" denir, sağ taraftakilere ise "bağımsız değişkenler" denir ve artı işaretleri + ile birleştirilir.
Bu değişkenler için kullanılan adların bağlama bağlı olarak değiştiğini bilmek iyidir. Bağımsız değişkenleri "yordayıcı (predictor)", "kontrol edilen değişken", "özellik (feature)" vb. olarak görmüş olabilirsiniz. Benzer şekilde, bağımlı değişkenleri "yanıt değişkeni", "çıktı değişkeni" veya "etiket" olarak görebilirsiniz.
Not yukarıdaki kod parçasında tanımladığınız d formülü birkaç değişken içerse de, bir formülün temel yapısının aslında sadece tilde sembolü ~ ve en az bir bağımsız veya sağ taraf değişkeni olduğunu unutmayın.
Unutmayın formüller aslında ortamı saklayan özniteliklere sahip dil nesneleridir:
# Return the type of `d`
typeof(d)

# Retrieve the attributes of `d`
attributes(d)
'language'
$class
[1] "formula"

$.Environment
<environment: R_GlobalEnv>
Yukarıdaki örneklerde gördüğünüz gibi, bir formüle dahil edilen değişkenler örneğin vektörler olabilir. Ancak, formüllere dahil edilen değişkenlerin çoğunlukla bir veri çerçevesinden geldiğini de sık sık görürsünüz; tıpkı aşağıdaki örnekte olduğu gibi:
Sepal.Width ~ Petal.Width + log(Petal.Length) + Species
Not formülün kendisi oluşturulurken, formüldeki sembollere atanmış herhangi bir veri değeri erişilmez.
Artık R’de formüllerin nasıl göründüğünü ve ne olduğunu bildiğinize göre, altta yatan formül nesnesinin tek taraflı veya çift taraflı bir formülünüz olup olmamasına bağlı olarak değiştiğini belirtmek iyi olur. İlki, sol taraftaki değişkene bakarak anlaşılır. Eğer hiç yoksa, ~ x örneğindeki gibi, tek taraflı bir formülünüz vardır.
Bu aynı zamanda tek taraflı bir formülün uzunluğunun 2 olacağı, çift taraflı formülün ise 3 olacağı anlamına gelir.
Hâlâ tam ikna olmadınız mı? Aşağıdaki kod parçasına göz atın. Bir formülün öğelerine köşeli parantezler yardımıyla erişebilirsiniz: [[ ve ]].
e <- ~ x + y + z
f <- y ~ x + b

# Return the length of `g`
length(e)
length(f)

# Retrieve the elements at index 1 and 2
e[[1]]
e[[2]]
f[[3]]
2
3
`~`


x + y + z


x + bGördüğünüz gibi formüller, değişkenlerin değerlerini değerlendirmeden yakalamanıza olanak tanıyan güçlü, genel amaçlı araçlardır; böylece fonksiyon tarafından yorumlanabilirler. Bu, R’de neden formül kullanmanız gerektiğinin cevabının bir parçasıdır.
Ayrıca bu R nesnelerini değişkenler arasındaki bir ilişkiyi ifade etmek için kullanırsınız.
Örneğin, aşağıdaki kod parçasının ilk satırında, ilk satırla "y, x, a ve b’nin bir fonksiyonudur" demiş olursunuz; Elbette, ikinci satırdaki gibi daha karmaşık formüllerle de karşılaşabilirsiniz; burada "sepal genişliği, türlere koşullu olarak petal genişliğinin bir fonksiyonudur" demek istersiniz.
y ~ x + a + b

Sepal.Width ~ Petal.Width | Species
y ~ x + a + b


Sepal.Width ~ Petal.Width | SpeciesArtık bu özel R nesnelerinin "ne" ve "neden"ine dair daha çok şey bildiğinize göre, temel ve daha karmaşık formülleri nasıl kullanabileceğinizi öğrenme zamanı! Bu bölümde sadece temel formülleri nasıl oluşturup birleştirebileceğinizi değil, aynı zamanda işleçlerin (operatörlerin) yardımıyla daha karmaşık olanları nasıl kurabileceğinizi de keşfedeceksiniz.
Bunu zaten biliyorsunuz! Bu eğitimde bazı örnekleri gördünüz, ama kısaca yineleyelim:
y ~ x
~ x + y + z
g <- y ~ x + b
Doğru - Formülü doğrudan yazabilirsiniz!
Ancak, kendinizi bir R nesnesinden, örneğin bir dizgeden, formül oluşturmanız gereken veya oluşturmak isteyeceğiniz bir durumda bulabilirsiniz. Bu gibi durumlarda formula veya as.formula() fonksiyonunu kullanabilirsiniz:
"y ~ x1 + x2"

h <- as.formula("y ~ x1 + x2")

h <- formula("y ~ x1 + x2")
Kolay!
Birden fazla formülü bir araya getirmek veya yapıştırmak için iki seçeneğiniz var. İlk olarak, her formül için ayrı değişkenler oluşturup ardından list() kullanabilirsiniz:
# Create variables
i <- y ~ x
j <- y ~ x + x1
k <- y ~ x + x1 + x2

# Concatentate
formulae <- list(as.formula(i),as.formula(j),as.formula(k))

# Double check the class of the list elements
class(formulae[[1]])
'formula'
Alternatif olarak, ilk argüman olarak tüm formüllerinizi içeren bir vektörü ve her vektör öğesine uygulamak istediğiniz fonksiyon olarak as.formula’yı geçirerek lapply() fonksiyonunu da kullanabilirsiniz:
# Join all with `c()`
l <- c(i, j, k)

# Apply `as.formula` to all elements of `f`
lapply(l, as.formula)
[[1]]
y ~ x

[[2]]
y ~ x + x1

[[3]]
y ~ x + x1 + x2
Bu temellerle, daha karmaşık formüllere dalmaya hazırsınız! Yukarıda, formülleri karakterize edenin tilde sembolü ~ olduğunu gördünüz. Buna ek olarak, bağımlı ve bağımsız değişkenlere de ihtiyaç duyduğunuzu ve bunların artı işareti + ile birleştirilebileceğini gördünüz.
Fakat dahası da var!
+ sembolüne ek olarak, formüllerinize özel anlam katabilecek başka semboller de vardır:
-;:;*;%in%; ve^.Bu işleçlerin tümüne ilişkin örnekleri bu bölümün geri kalanında göreceksiniz! Önce + ve - işleçleriyle başlayalım:
# Use multiple independent variables
y ~ x1 + x2

# Ignore objects in an analysis
y ~ x1 - x2
Not regresyon modelleme bağlamında en çok : ve * sembollerine ihtiyaç duyarsınız; burada etkileşim terimlerini belirtmeniz gerekir. Yukarıda okuduğunuz gibi, ilki etkileşim için kullanılır; bu, yalnızca değişkenlerin etkileşimini, değişkenlerin kendilerini değil, istediğiniz anlamına gelir. Bu, iki değişkeni ve etkileşimlerini dahil etmek için kullanılan, çaprazlama sembolü olan ikincisiyle tezat oluşturur.
Dikkatli olun! Bu işleçleri kullanarak bazı formüller farklı görünebilir ama aslında eşdeğer olabilir. Aşağıdaki örnekleri düşünün; aynı regresyonu üretirler:
y ~ x1 * x2

y ~ x1 + x2 + x1:x2
Bunların nasıl aynı olabileceğinden emin değil misiniz? Aşağıdaki R kod parçalarını göz önünde bulundurun:
# Set seed
set.seed(123)

# Data
x = rnorm(5)
x2 = rnorm(5)
y = rnorm(5)

# Model frame
model.frame(y ~ x * x2, data = data.frame(x = x, y = y, x2=x2))
| y | x | x2 |
|---|---|---|
| 1.7150650 | -0.56047565 | 1.2240818 |
| 0.4609162 | -0.23017749 | 0.3598138 |
| -1.2650612 | 1.55870831 | 0.4007715 |
| -0.6868529 | 0.07050839 | 0.1106827 |
| -0.4456620 | 0.12928774 | -0.5558411 |
model.frame(y ~ x + x2 + x:x2, data = data.frame(x = x, y = y, x2))
| y | x | x2 |
|---|---|---|
| 1.7150650 | -0.56047565 | 1.2240818 |
| 0.4609162 | -0.23017749 | 0.3598138 |
| -1.2650612 | 1.55870831 | 0.4007715 |
| -0.6868529 | 0.07050839 | 0.1106827 |
| -0.4456620 | 0.12928774 | -0.5558411 |
model.frame() fonksiyonunu henüz bilmiyorsanız endişelenmeyin; bu eğitimin ilerleyen kısımlarında bundan daha çok göreceksiniz!
Ek olarak, iç içe geçirmeye bir örnek de burada; bunu y ~ a + a:b’ye genişletebilirsiniz:
y ~ a + b %in% a
Tüm bu işleçler gerçekten harika, peki aritmetik bir işlem yapmak isterseniz ne olacak? Diyelim ki modelinize x ve x^2’yi dahil etmek istiyorsunuz. Bu gibi durumlarda, şu formülü yazmaya meyledebilirsiniz: y ~ x + x^2.
Ancak sonuç tam olarak istediğiniz gibi olacak mı? Bir bakın!
model.frame( y ~ x + x^2, data = data.frame(x = rnorm(5), y = rnorm(5)))
y ~ x + x^2
| y | x |
|---|---|
| -0.2053091 | 1.18231565 |
| -0.3030972 | 0.04779636 |
| -0.7621604 | 0.86382418 |
| -0.1377784 | -1.18333097 |
| -0.3813125 | -1.25247842 |
Bu beklediğiniz sonuç değil!
Yukarıdaki örnekte aritmetik ifadeyi korumuyorsunuz ve bunun bir sonucu olarak R, x^2 terimini x’in tekrarı olarak değerlendirip düşürür.
Neden?
x, x’in ana etkisini verir ve x^2 ise x’in ana etkisini ve ikinci dereceden etkileşimini verir. Sonuçta, formüldeki x teriminden ana etki zaten dahil edildiğinden, model çerçevesine x’i dahil etmiş olursunuz ve x^2 terimindeki ikinci dereceden etkileşimleri elde etmek için x ile çaprazlanacak bir şey yoktur.
Bunu önlemek için birkaç çözümünüz var:
I() veya "as-is" işleçini kullanabilirsiniz: y ~ x + I(x^2)I() fonksiyonunu kodunuza eklemenin sonuçlarını anlamak için aşağıdaki örneğe bakın:
model.frame( y ~ x + I(x^2), data = data.frame(x = rnorm(5), y = rnorm(5)))
y ~ x + I(x^2)| y | x | I(x^2) |
|---|---|---|
| 1.414090 | -0.1996230 | 0.039849.... |
| 1.777646 | -1.0675904 | 1.139749.... |
| 1.710137 | -1.4071841 | 1.980167.... |
| 1.259111 | -1.3747289 | 1.889879.... |
| -1.490866 | 0.8323668 | 0.692834.... |
Bu son kod satırı aslında R’ye formülü kullanmadan önce x^2 değerlerini hesaplamasını söyler. Not ayrıca bir modeli ölçeklemek için de "as-is" işleçini kullanabileceğinizi unutmayın; ilgili değişken adını I() içine sarmanız yeterlidir:
y ~ I(2 * x)
Yukarıdaki örnekleri gördüğünüzde tüm bunlar biraz soyut görünebilir, o yüzden başka durumlara bakalım; örneğin, polinom regresyon. Bu gibi durumlarda I() fonksiyonu ile çalışmanız gerekir. Öte yandan, depth=2 etkileşimlerle sınırlı bir faktöriyel ANOVA modeli için bu fonksiyona ihtiyacınız olmayacaktır; çünkü a, b ve c’nin ana etkilerini ve onların ikinci dereceden etkileşimlerini içeren bir formüle açılım yapmak istersiniz:
# Polynomial Regression
y ~ x + I(x^2) + I(x^3)

# Factorial ANOVA
y ~ (a*b*c)^2
Son olarak, birden fazla değişkenle çalışırken faydalı bulacağınız başka bir özellik de . işleçidir. Bu işleci bir formül içinde kullandığınızda, henüz modele dahil edilmemiş matristeki diğer tüm değişkenlere atıfta bulunursunuz. Bu, örneğin bir matris veya veri çerçevesinde regresyon çalıştırmak ve tüm değişkenleri tek tek yazmak istemediğinizde kullanışlıdır:
y ~ .
Bir formül oluşturduğunuzda, onu incelemek de isteyebilirsiniz. Bu bölümde, oluşturduğunuz bu özel R nesnelerini daha fazla keşfetmek için kullanabileceğiniz bazı araçlarla tanışacaksınız!
Not önceki bölümlerde formülleri incelemenin bazı yollarını zaten gördünüz: attributes(), typeof(), class() gibi fonksiyonlar.
terms() fonksiyonuFarklı formülleri incelemek ve karşılaştırmak için terms() fonksiyonunu kullanabilirsiniz:
m <- formula("y ~ x1 + x2")
terms(m)
y ~ x1 + x2
attr(,"variables")
list(y, x1, x2)
attr(,"factors")
   x1 x2
y   0  0
x1  1  0
x2  0  1
attr(,"term.labels")
[1] "x1" "x2"
attr(,"order")
[1] 1 1
attr(,"intercept")
[1] 1
attr(,"response")
[1] 1
attr(,".Environment")
<environment: R_GlobalEnv>all.varsModeldeki değişkenlerin adlarını bilmek istiyorsanız all.vars’ı kullanabilirsiniz. Bu fonksiyonla, bir formülde geçen tüm adları içeren bir karakter vektörü döndürürsünüz:
print(all.vars(m))
[1] "y" "x1" "x2"update() fonksiyonuFormülleri karaktere dönüştürmeden değiştirmek için update() fonksiyonunu kullanabilirsiniz:
update(y ~ x1 + x2, ~. + x3)
y ~ x1 + x2 + x3
Not formülü as.character() ile karaktere dönüştürerek de güncelleyebilirdiniz; sonra paste() kullanarak formülleri çok hızlı inşa edebilirsiniz. Örneğin, formülünüze başka bir sağ taraf değişkeni eklemek isterseniz, onu basitçe birleştirebilirsiniz:
as.formula(paste("y ~ x1 + x2", "x3", sep = "+"))

factors <- c("x2", "x3")
as.formula(paste("y~", paste(factors, collapse="+")))
y ~ x1 + x2 + x3


y ~ x2 + x3
Yukarıdaki kod parçasında, formülünüzdeki terimleri ayırmak için bir karakter dizisi belirtmek üzere sep veya collapse argümanlarını kullanabileceğinizi görürsünüz.
Ancak, formülünüzde değişiklik yapmak için paste() kesinlikle tek yol değildir: reformulate()’ı da kullanabilirsiniz:
reformulate(termlabels = factors, response = 'y')
y ~ x2 + x3
is.formula()Bir değişkenin formül olup olmadığını is.formula() fonksiyonuna geçirerek iki kez kontrol edin. Bu fonksiyonun plyr kütüphanesinin bir parçası olduğunu unutmayın; bu yüzden is.formula()’yı çağırmadan önce çalışma alanınızda bu kütüphaneyi kullanılabilir hale getirmelisiniz!
# Load `plyr`
library(plyr)

# Check `m`
is.formula(m)
TRUE
Şimdiye kadar, R formüllerinin modellemeyle sınırlı olmayan genel amaçlı araçlar olduğunu ve formülleri kullanabileceğiniz bazı örnekleri gördünüz. Bu bölümde, bu son konuya daha derinlemesine gireceksiniz: bu araçları avantajınıza kullanabileceğiniz bazı durumları göreceksiniz. Elbette, lattice ve stats gibi paketlerin modelleme ve görsel fonksiyonlarını ele alacaksınız, ancak dplyr’daki standart dışı değerlendirmeyi de kapsayacaksınız.
İstatistiksel modelleme yapmanız gerektiğinde R harikadır. Bildiğiniz gibi, istatistiksel modelleme gerçeği basitleştirilmiş, matematiksel olarak biçimlendirilmiş bir yolla yaklaştırma ve isteğe bağlı olarak bu yaklaşımdan tahminler yapma yöntemidir. İstatistiksel bir model sıklıkla veri üretim sürecini idealleştirilmiş bir biçimde temsil eder. İstatistiksel modelleme yapmak için modelleme fonksiyonlarına ihtiyacınız vardır.
R’deki modelleme fonksiyonları, bir argüman olarak formula nesnesine ihtiyaç duyduğunuz tipik bir örnektir. Bu fonksiyonlarda bulunabilecek diğer argümanlar arasında, model süresi boyunca iliştirmek istediğiniz bir veri çerçevesini belirtmenize olanak tanıyan data, kullanmak istediğiniz verileri seçmek için subset vb. yer alır... Genel olarak, belirli bir fonksiyona hangi argümanları geçirmeniz gerektiğini bilmek istiyorsanız, R konsolunuzda help() fonksiyonunu veya ? işaretini kullanmaktan çekinmeyin.
Modelleme fonksiyonları, uyumla (fit) ilgili tüm bilgileri içeren bir model nesnesi döndürür. print(), summary(), plot(), anova() vb. gibi genel R fonksiyonlarının, bu tür nesne için uygun bilgileri döndürecek şekilde belirli nesne sınıfları için tanımlanmış yöntemleri olacaktır.
Muhtemelen en bilinen modelleme fonksiyonlarından biri, yukarıda açıklanan tüm argümanları kullanan lm()’dir. lm()’yi doğrusal modelleri uyarlamak için kullanırsınız. Bunu regresyon, tek tabakalı varyans analizi ve kovaryans analizi yapmak için kullanabilirsiniz. lm()’yi kullandığınız ve modeli print() yardımıyla incelediğiniz bir örneğe bakalım:
lm.m <- lm(Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
        data = iris,
        subset = Sepal.Length > 4.6)

print(lm.m)
Call:
lm(formula = Sepal.Width ~ Petal.Width + log(Petal.Length) +
    Species, data = iris, subset = Sepal.Length > 4.6)

Coefficients:
      (Intercept)        Petal.Width  log(Petal.Length)  Speciesversicolor
           3.1531             0.6620             0.4612            -1.9265
 Speciesvirginica
          -2.3088
lm() başlangıçta formülü ve uygun ortamı kullanarak değişkenler arasındaki ilişkileri, verileri içeren bir veri çerçevesine çevirmek için kullanır.
Ayrıca, bu eğitimde bir örneğini gördüğünüz model.frame() yöntemleri de vardır; bunlar çoğunlukla ek argüman olmadan, uyarlanmış nesneden model çerçevesini almak veya yeniden oluşturmak için kullanılır. Bu, formula, subset ve weights dışındaki özgün çağrının argümanlarına karşılık gelen veri çerçevesi sütunlarını almanızı sağlar: örneğin, glm() yöntemi offset, etastart ve mustart’ı ele alır.
Aşağıdaki kod parçasında, model.frame() fonksiyonunu, uyarlanmış nesnenin bir veri çerçevesini geri almak için kullandığınızı görüyorsunuz; Kodun yukarıda gördüğünüz kod parçasından biraz farklı olduğuna dikkat edin: subset argümanı biraz değiştirilmiştir.
stats::model.frame(formula = Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
                   data = iris,
                   subset = Sepal.Length > 6.9,
                   drop.unused.levels = TRUE)
| Sepal.Width | Petal.Width | log(Petal.Length) | Species | |
|---|---|---|---|---|
| 51 | 3.2 | 1.4 | 1.547563 | versicolor |
| 103 | 3.0 | 2.1 | 1.774952 | virginica |
| 106 | 3.0 | 2.1 | 1.887070 | virginica |
| 108 | 2.9 | 1.8 | 1.840550 | virginica |
| 110 | 3.6 | 2.5 | 1.808289 | virginica |
| 118 | 3.8 | 2.2 | 1.902108 | virginica |
| 119 | 2.6 | 2.3 | 1.931521 | virginica |
| 123 | 2.8 | 2.0 | 1.902108 | virginica |
| 126 | 3.2 | 1.8 | 1.791759 | virginica |
| 130 | 3.0 | 1.6 | 1.757858 | virginica |
| 131 | 2.8 | 1.9 | 1.808289 | virginica |
| 132 | 3.8 | 2.0 | 1.856298 | virginica |
| 136 | 3.0 | 2.3 | 1.808289 | virginica |
İpucu: stats paketinde formülleri kullanmanıza olanak tanıyan daha fazla fonksiyon vardır; örneğin aggregate().
Gözlemci farklılıkları gibi faktörlerin sonucu olan varyasyonu hesaba katmak üzere rasgele etkileri modellemenize olanak tanıyan doğrusal karışık etkili modeller için, nlme paketini lme() fonksiyonu ile kullanabilirsiniz. Burada da, modelleme fonksiyonuna sağlamanız gereken ilk argümanın formula olduğunu ve bir de data argümanı olduğunu görürsünüz!
# Load packages
library(MASS)
library(nlme)

# Get some data
data(oats)

# Adjust the data names and columns
names(oats) = c('block', 'variety', 'nitrogen', 'yield')
oats$mainplot = oats$variety
oats$subplot = oats$nitrogen

# Fit a non-linear mixed-effects model
nlme.m = lme(yield ~ variety*nitrogen,
             random = ~ 1|block/mainplot,
             data = oats)

# Retrieve a summary
summary(nlme.m)
Linear mixed-effects model fit by REML
 Data: oats
       AIC      BIC    logLik
  559.0285 590.4437 -264.5143

Random effects:
 Formula: ~1 | block
        (Intercept)
StdDev:    14.64496

 Formula: ~1 | mainplot %in% block
        (Intercept) Residual
StdDev:    10.29863 13.30727

Fixed effects: yield ~ variety * nitrogen
                                    Value Std.Error DF   t-value p-value
(Intercept)                      80.00000  9.106958 45  8.784492  0.0000
varietyMarvellous                 6.66667  9.715028 10  0.686222  0.5082
varietyVictory                   -8.50000  9.715028 10 -0.874933  0.4021
nitrogen0.2cwt                   18.50000  7.682957 45  2.407927  0.0202
nitrogen0.4cwt                   34.66667  7.682957 45  4.512152  0.0000
nitrogen0.6cwt                   44.83333  7.682957 45  5.835427  0.0000
varietyMarvellous:nitrogen0.2cwt  3.33333 10.865342 45  0.306786  0.7604
varietyVictory:nitrogen0.2cwt    -0.33333 10.865342 45 -0.030679  0.9757
varietyMarvellous:nitrogen0.4cwt -4.16667 10.865342 45 -0.383482  0.7032
varietyVictory:nitrogen0.4cwt     4.66667 10.865342 45  0.429500  0.6696
varietyMarvellous:nitrogen0.6cwt -4.66667 10.865342 45 -0.429500  0.6696
varietyVictory:nitrogen0.6cwt     2.16667 10.865342 45  0.199411  0.8428
 Correlation:
                                 (Intr) vrtyMr vrtyVc ntr0.2 ntr0.4 ntr0.6
varietyMarvellous                -0.533
varietyVictory                   -0.533  0.500
nitrogen0.2cwt                   -0.422  0.395  0.395
nitrogen0.4cwt                   -0.422  0.395  0.395  0.500
nitrogen0.6cwt                   -0.422  0.395  0.395  0.500  0.500
varietyMarvellous:nitrogen0.2cwt  0.298 -0.559 -0.280 -0.707 -0.354 -0.354
varietyVictory:nitrogen0.2cwt     0.298 -0.280 -0.559 -0.707 -0.354 -0.354
varietyMarvellous:nitrogen0.4cwt  0.298 -0.559 -0.280 -0.354 -0.707 -0.354
varietyVictory:nitrogen0.4cwt     0.298 -0.280 -0.559 -0.354 -0.707 -0.354
varietyMarvellous:nitrogen0.6cwt  0.298 -0.559 -0.280 -0.354 -0.354 -0.707
varietyVictory:nitrogen0.6cwt     0.298 -0.280 -0.559 -0.354 -0.354 -0.707
                                 vM:0.2 vV:0.2 vM:0.4 vV:0.4 vM:0.6
varietyMarvellous
varietyVictory
nitrogen0.2cwt
nitrogen0.4cwt
nitrogen0.6cwt
varietyMarvellous:nitrogen0.2cwt
varietyVictory:nitrogen0.2cwt     0.500
varietyMarvellous:nitrogen0.4cwt  0.500  0.250
varietyVictory:nitrogen0.4cwt     0.250  0.500  0.500
varietyMarvellous:nitrogen0.6cwt  0.500  0.250  0.500  0.250
varietyVictory:nitrogen0.6cwt     0.250  0.500  0.250  0.500  0.500

Standardized Within-Group Residuals:
        Min          Q1         Med          Q3         Max
-1.81300898 -0.56144838  0.01758044  0.63864476  1.57034166

Number of Observations: 72
Number of Groups:
              block mainplot %in% block
                  6                  18
Not nlme’nin yanı sıra, doğrusal ve genelleştirilmiş doğrusal karışık etkili modelleri uyarlamaya adanmış lme4 gibi başka paketler de vardır.
Modelleme fonksiyonları ve formüllerin varlığına başka bir örnek nls()’dir; bunu doğrusal olmayan modeller oluşturmak için kullanırsınız:
# Set seed
set.seed(20160227)

# Data
x <- seq(0,50,1)
y <- ((runif(1,10,20)*x)/(runif(1,0,10)+x))+rnorm(51,0,1)

# Non-linear model
nls.m <- nls(y ~ a*x/(b+x),
             start=c(a=4, b=1))
Son örnek olarak, Genelleştirilmiş Doğrusal Modelleri (GLM) oluşturmak için kullanabileceğiniz fonksiyonlar var. R’de bunu yapmak için glm() fonksiyonunu kullanabilirsiniz. Muhtemelen artık kulağa tanıdık geliyor, ama burada da formula ve data argümanlarını kullanırsınız:
# Load package
library(MPDiR)

# Get the data
data(Chromatic)

# Model
glm.m <- glm(Thresh ~ Axis:(I(Age^-1) + Age),
             family = Gamma(link = "identity"),
             data = Chromatic)

# Get back a summary
summary(glm.m)
Call:
glm(formula = Thresh ~ Axis:(I(Age^-1) + Age), family = Gamma(link = "identity"),
    data = Chromatic)

Deviance Residuals:
    Min       1Q   Median       3Q      Max
-1.2160  -0.3728  -0.0805   0.2311   1.2932

Coefficients:
                      Estimate Std. Error t value Pr(>|t|)
(Intercept)          3.282e-04  9.965e-05   3.294  0.00106 **
AxisDeutan:I(Age^-1) 7.803e-03  3.686e-04  21.172  < 2e-16 ***
AxisProtan:I(Age^-1) 8.271e-03  3.863e-04  21.410  < 2e-16 ***
AxisTritan:I(Age^-1) 1.166e-02  5.284e-04  22.065  < 2e-16 ***
AxisDeutan:Age       1.521e-05  3.418e-06   4.450 1.06e-05 ***
AxisProtan:Age       1.540e-05  3.434e-06   4.484 9.10e-06 ***
AxisTritan:Age       4.812e-05  5.838e-06   8.241 1.48e-15 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

(Dispersion parameter for Gamma family taken to be 0.2054848)

    Null deviance: 543.35  on 510  degrees of freedom
Residual deviance: 100.40  on 504  degrees of freedom
AIC: -4777.6

Number of Fisher Scoring iterations: 6
Görsel fonksiyonlara geçmeden önce bilmek için iyi bir şey daha var: lm() gibi modelleme fonksiyonlarında formülleri kullandığınızda, formülden fonksiyonlara standart bir dönüşüm gerçekleşir. Tam olarak ne tür bir dönüşümün gerçekleştiğini açıklamak için, bu eğitimde daha önce gördüğünüz örneğe dönmelisiniz:
lm.m <- lm(Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
           data = iris,
           subset = Sepal.Length > 4.6)
Bu kod parçasının amacı bir doğrusal regresyon modeli uyarlamak olsa da, formül hem sembolik modeli belirtmek hem de istenen tasarım matrisini üretmek için kullanılır. Tasarım matrisi, yordayıcı veya bağımsız değişken kümesinin iki boyutlu temsildir; veri örnekleri satırlarda, değişken öznitelikleri sütunlardadır. Tasarım matrisi X matrisi olarak da bilinir.
Öyleyse, formül yöntemi hangi sütunların tasarım matrisine dahil edilmesi gerektiğini de tanımlar.
Peki bunların hepsi tam olarak ne anlama geliyor? Aşağıdaki kod satırlarına bakalım:
# A formula
y ~ x

# A converted formula
y = a_1 + a_2 * x
Bu basit bir dönüşüm örneğidir: y ~ x, y = a_1 + a_2 * x’e çevrilir.
R’de gerçekte ne olduğunu görmek ve anlamak için model_matrix() fonksiyonunu kullanabilirsiniz. Bu fonksiyon, örneğin karşıtlıklara (contrasts) bağlı olarak faktörleri bir dizi kukla (dummy) değişkene genişleterek ve etkileşimleri benzer şekilde genişleterek bir tasarım ya da model matrisi oluşturur.
Model denklemini tanımlayan bir tibble almak için df veri çerçevesini ve formülü geçirmeyi unutmayın:
# Load packages
library(tidyverse)
library(modelr)

# A data frame
df <- tribble(
  ~y, ~x1, ~x2,
  4, 2, 5,
  5, 1, 6
)

# Model matrix
model_matrix(df, y ~ x1)
| (Intercept) | x1 |
|---|---|
| 1 | 2 |
| 1 | 1 |
Fazladan bir (Intercept) sütunu görünüyor. Bu, R tarafındaki varsayılan davranıştır. Ancak R’nin modele sabiti (intercept) ekleme şekli, tamamı birlerden oluşan bir sütuna sahip olmaktır. Bunu istemiyorsanız, formüle -1 ekleyerek açıkça düşürmeniz gerekir; şöyle:
model_matrix(df, y ~ x1-1)
| x1 |
|---|
| 2 |
| 1 |
Not modele daha fazla değişken eklediğinizde model matrisinin beklenmedik olmayan bir şekilde büyüdüğünü de unutmayın.
model_matrix(df, y ~ x1 + x2)
| (Intercept) | x1 | x2 |
|---|---|---|
| 1 | 2 | 5 |
| 1 | 1 | 6 |
R’de formülleri bulacağınız bir diğer önemli yer de görsel fonksiyonlardır. Bir sürü paket mevcut olduğundan bu eğitim yalnızca graphics, lattice, ggplot2 ve ggformula üzerinde duracaktır.
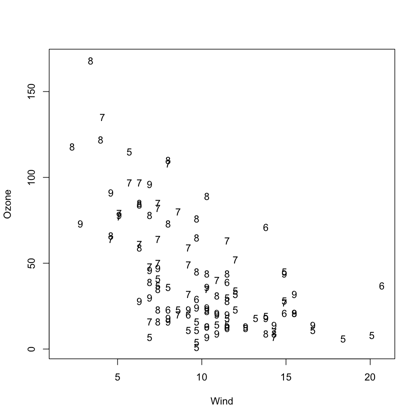
graphicsTemel R paketi graphics, bir saçılım grafiği belirtmenize veya bir formül kullanarak nokta, çizgi ya da metin eklemenize olanak tanır. Aşağıdaki örneğe bakın:
# Get data
data(airquality)

# Plot
plot(Ozone ~ Wind, data = airquality, pch = as.character(Month))
Daha fazla bilgi istiyorsanız bu sayfayı incelemekten çekinmeyin.
latticelattice, grid grafikler üzerine inşa edilmiş bir pakettir. Temel grafiklerde mevcut birçok çizim fonksiyonunun alternatif uygulamalarını sağlayan genel amaçlı bir grafik paketidir. Özel örnekler arasında xyplot() fonksiyonu ile saçılım grafikleri, barchart() ile çubuk grafikler ve bwplot() ile kutu grafikleri yer alır.
İpucu: lattice hakkında daha fazla bilgi edinmek ister misiniz? DataCamp’in R’de lattice ile Veri Görselleştirme kursunu düşünün.
Bu paketi özel kılan, istenen grafiği ve daha spesifik olarak çizilecek değişkenleri tanımlamak için istatistiksel modellerin formül gösterimini kullanmasıdır. Ayrıca koşullama değişkenini belirtmek için dikey çubuk ya da boru karakteri | ekler:
# Load package
library(lattice)

# Plot histogram
histogram(~ Ozone | factor(Month),
          data = airquality,
          layout = c(2, 3),
          xlab = "Ozone (ppb)")
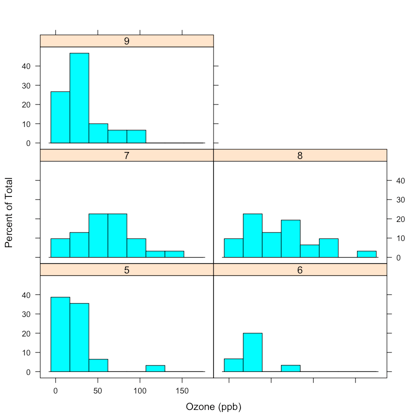
Not modelleme fonksiyonlarına benzer şekilde, lattice kütüphanesindeki fonksiyonlarda da bir formula argümanının yanı sıra beklendiği gibi bir data argümanı vardır!
Yukarıdaki kod parçasında data argümanını da atlayabileceğinizi unutmayın; ama o zaman veriyi iliştirmeniz gerekir:
# Load package
library(lattice)

# Attach data
attach(airquality)

# Plot
histogram(~ Ozone | factor(Month),
          layout = c(2, 3),
          xlab = "Ozone (ppb)")
ggplot2Formülleri çeşitli ggplot2 fonksiyonlarında kullanabilirsiniz:
geom_smooth() veya stats_smooth(); Bu, uyumun biçimini etkiler.facet_wrap().facet_grid().# Load package
library(ggplot2)
# Plot
ggplot(mpg, aes(displ, hwy)) +
geom_point() +
geom_smooth(method = "lm",
formula = y ~ splines::bs(x, 3),
se = FALSE)
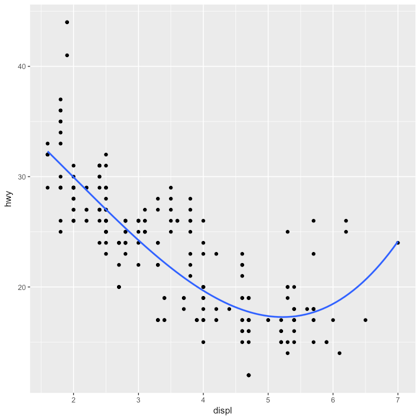
Bu grafiği oluşturmak için formülün değişken adlarını değil x ve y harflerini kullandığına dikkat edin. Bu durum facet_wrap() kullandığınızda böyle değildir:
ggplot(mpg, aes(displ, hwy)) +
  geom_point() +
  geom_smooth(span = 0.8) +
  facet_wrap(~drv)
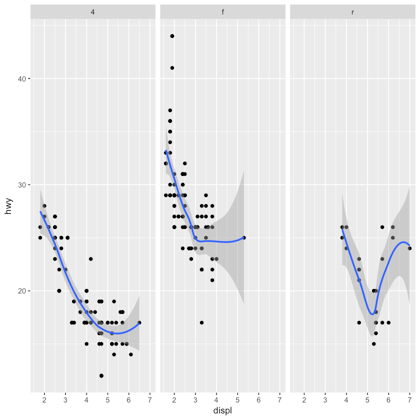
ggplot2 hakkında daha fazla bilgi almak ister misiniz? bu kursa göz atın veya dokümantasyonu inceleyin.
ggformulaggformula paketi şu anda ggplot2 üzerine inşa edilmiştir, ancak formüllere dayalı bir arayüz sağlar. Bu, lattice arayüzünde bulduğunuza benzer. Ayrıca bu pakette daha basit bileşenlerden daha karmaşık grafikler oluşturmak için boru (pipe) işleçinin kullanıldığını da göreceksiniz.
İpucu: R’de pipe işleci hakkında daha fazla bilgi istiyorsanız bu eğitimi düşünün.
ggformula ile bir grafik oluşturmanın temel yolu şöyledir
gf_plottype(formula, data = mydata)Not gf_plottype() fonksiyonunun aslında gf ile başladığını unutmayın; bu, ggplot2’ye formül tabanlı arayüzler olan fonksiyonlarla çalıştığınızı hatırlatmak içindir; g ggplot2’yi, f ise “formül”ü ifade eder.
Bunun R kodunda nasıl göründüğünü görmek için aşağıdaki örneğe bakın:
# Load package
library(ggformula)

# Plot
gf_point(mpg ~ hp, data = mtcars)
Elbette bu sadece temel bir grafik; Bu görselleştirme paketiyle çok daha fazlasını yapabilirsiniz! Farklı bir glif türü ve bu glifler için belirli öznitelikler seçebilir, tek ya da iki değişkenli grafikler yapabilir, gliflerin konumlarını ayarlayabilirsiniz ve daha fazlasını. Bu eğitim bu pakete çok daha fazla ayrıntıyla girmeyecek, ancak buradaki ana çıkarım, bu paketin grafik yapmanın ana bileşeni olarak formülleri benimsemiş olmasıdır!
Bu eğitimde ele aldıklarınızın ötesinde daha fazla bilgi istiyorsanız, ggformula paketi hakkında buradan okuyun veya paketin RDocumentation sayfasına bakın.
dplyrdplyr, Standart Dışı Değerlendirme (Non-Standard Evaluation) ile çalışan bir pakete örnektir. Diğer örnekler library(magrittr) ile library("magrittr")’dır; birinde tırnaklar varken diğerinde yoktur ama her ikisi de gayet iyi çalışır! library() örneklerini, örneğin install.packages() ile karşılaştırın:
# This will work
install.packages("magrittr")

# This won't work
install.packages(magrittr)
R’de genellikle bir nesnenin bir parçasını adlandırırken tırnak işaretlerini kullanmanız gerekir, ancak bazı fonksiyonlarda —örneğin library()— buna gerek yoktur. Bu fonksiyonlar standart olmayan bir şekilde çalışacak şekilde tasarlanmıştır. Dahası, bazı bu fonksiyonların standart bir yolu bile yoktur!
dplyr ile ilgili olarak, bu paketin çoğu fonksiyonunun diğer fonksiyonlar gibi çalıştığını göreceksiniz: tüm fonksiyonlar Standart Değerlendirme (SE) kullanır. Ancak, etkileşimli kullanım için fonksiyonların Standart Dışı Değerlendirmesi (NSE) de vardır; bu da size yazımda tasarruf sağlar.
(Kabul edelim, tüm o tırnakları yazmak göz korkutucu olabilir!)
Bu yüzden çoğu dplyr fonksiyonu standart dışı değerlendirme kullanır. Olağan R değerlendirme kurallarını takip etmezler. Bunun yerine, yazdığınız ifadeyi yakalar ve özel bir şekilde değerlendirirler.
Bu, bu fonksiyonların standart değerlendirme varyantına sahip olmadığı anlamına gelmez. Standart dışı değerlendirme kullanan her fonksiyonun, gerçek hesaplamayı yapan standart değerlendirme kaçağı (escape hatch) olmalı ve vardır. Standart değerlendirme fonksiyonu _ ile bitmelidir. Bu da dplyr paketinde birden fazla eylemci (verb) olduğu anlamına gelir: select(), select_(), mutate(), mutate_() vb.
Etkileşimli olarak kullanıldığında, bu fonksiyonlar önce lazyeval paketiyle değerlendirilir, sonra fonksiyonun standart değerlendirme sürümüne gönderilir. Yani kaputun altında, select() lazyeval paketi ile değerlendirilir ve select_()’a gönderilir.
Tüm bunlar söylendikten sonra, dplyr ve lazyeval’in anladığı, standart değerlendirme fonksiyonlarında değişkenleri alıntılamanın (quote) 3 yolu vardır:
quote() ve# Load `dplyr`
library(dplyr)
# NSE evaluation
select(iris, Sepal.Length, Petal.Length)
# standard evaluation
select_(iris, ~Sepal.Length)
select_(iris, ~Sepal.Length, ~Petal.Length) #works
select_(iris, quote(Sepal.Length), quote(Petal.Length)) # yes!
select_(iris, "Sepal.Length", "Petal.Length", "Species")
İpucu: standart dışı değerlendirme hakkında daha fazla okumak isterseniz, Hadley Wickham’ın Advanced R kitabındaki bu konuyla ilgili bölümü değerlendirin.
Daha önce, as.formula, update(), all.vars gibi fonksiyonları kullanarak formüllerinizi oluşturabileceğinizi ve inceleyebileceğinizi gördünüz... Bunların hepsi basit işlem ve manipülasyonlardı, peki ya formüllerle gelişmiş manipülasyonlar? Belki aşağıdaki paketler ilginizi çeker!
Formula PaketiYakın zamanda bu paket CRAN’de yayımlandı. Formülleri bir üst seviyeye taşımak isteyenler için idealdir. Bu paket, temel formula sınıfını genişletir.
Daha spesifik olarak, Formula nesneleri temel formül nesnelerini genişletir: bu paketle, birden çok parçayı ayıran veya potansiyel olarak tüm formül işleçlerini (boru karakteri dahil) sol tarafta tutarak birden fazla yanıtı desteklemek için | gibi ek bir formül işleci kabul eden formüller tanımlayabilirsiniz.
Oluşturabileceğiniz formüllere örnekler şunlardır:
y ~ x1 + x2 | u1 + u2 + u3 | v1 + v2 gibi çok parçalı formüllery1 + y2 ~ x1 + x2 + x3 gibi çok yanıtlı formüllery1 | y2 + y3 ~ x gibi çok parçalı yanıtlar ve# Load package
library(Formula)
# Create formulas
f1 <- y ~ x1 + x2 | z1 + z2 + z3
F1 <- Formula(f1)
# Retrieve the class of `F1`
class(F1)
Not as.formula() ve is.formula() fonksiyonlarının da bu pakette güncellendiğini unutmayın: bunun yerine is.Formula() ve as.Formula() kullanacaksınız!
Daha fazlasını buradan okuyun.
formula.toolsBu paket yakın zamanda yayımlandı ve size "formüller, ifadeler, çağrılar, atamalar ve diğer R Nesnelerini manipüle etmek için programatik yardımcılar" sağlar. Bu oldukça fazla, ama özünde hepsi şuna çıkar: Bu paketi, formül yapılarına erişmek ve onları değiştirmek ile bu R nesnelerinin adlarını ve sembollerini çıkarmak ve değiştirmek için kullanabilirsiniz. Paket Christopher Brown tarafından yazılmıştır.
Bu paketle çalışırken faydalı bulabileceğiniz bazı şeyler şunlardır:
get.vars(): all.vars() yerine, bu fonksiyon çeşitli R nesnelerinden değişken adlarını çıkarır; ancak tüm semboller vb. değişken adlarına dönüştürülür.invert(): bu fonksiyonu bir nesnedeki, örneğin bir formüldeki, işleçleri tersine çevirmek için kullanabilirsiniz.is.one.sided(): bir fonksiyonun tek taraflı mı yoksa çift taraflı mı olduğunu belirlemek için çok kullanışlıdır.Unutmayın bir formül, şöyle görünüyorsa tek taraflıdır: ~x; x~y olarak formüle edildiğinde iki taraflı olur.
Yaşasın! R formülleri üzerine bu eğitimi tamamladınız. Daha fazla okumak isterseniz, Hadley Wickham’ın R’de formüllere ve model ailelerine tamamen adanmış bir bölümü olan R for Data Science kitabına mutlaka göz atın.
DataCamp’in Tidyverse’e Başlangıç: Eğitim içeriğini inceleyin.
Formülleri bulabileceğiniz başka örnekler ya da formülleri manipüle etmek için kullanabileceğiniz başka paketler aklınıza geliyor mu? Twitter’da bana bildirmekten çekinmeyin: @willems_karlijn.
R Kursları
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




