

Khi bạn để ý, rất nhiều hàm trong R sử dụng công thức: các package như ggplot2, stats, lattice và dplyr đều dùng! Những ví dụ phổ biến về các hàm mà bạn sẽ dùng các đối tượng R này là glm(), lm(), facet_wrap(), v.v. Nhưng chính xác thì những “công thức” này là gì, và vì sao bạn nên dùng chúng?
Cấu trúc dữ liệu trong R
Vì công thức là một lớp đặc biệt trong ngôn ngữ lập trình R, nên thật tốt nếu bạn điểm lại nhanh các kiểu dữ liệu và cấu trúc dữ liệu hiện có trong ngôn ngữ này.
Ghi nhớ R là một ngôn ngữ lập trình hướng đối tượng: ngôn ngữ này được tổ chức xoay quanh các đối tượng. Mọi thứ trong R đều là đối tượng.
Hãy bắt đầu từ căn bản: trong lập trình, bạn làm việc với cấu trúc dữ liệu để lưu trữ dữ liệu, và hàm để xử lý chúng. Cấu trúc dữ liệu là giao diện đến dữ liệu được tổ chức trong bộ nhớ máy tính. Như Định nghĩa Ngôn ngữ R nêu rõ, R không cung cấp truy cập trực tiếp tới bộ nhớ máy tính mà thay vào đó cung cấp một số cấu trúc dữ liệu chuyên biệt mà bạn có thể gọi là "đối tượng". Mỗi cấu trúc dữ liệu được thiết kế để tối ưu hóa một khía cạnh nào đó của lưu trữ, truy cập hoặc xử lý.
Năm cấu trúc dữ liệu chính trong R là:
- Vector nguyên tử,
- List,
- Matrix,
- Data frame, và
- Array
# Create variables
a <- c(1,2,3,4,5,6,7,8,9)
b <- list(x = LifeCycleSavings[,1], y = LifeCycleSavings[,2])
Mẹo: bạn có thể dùng hàm typeof() để trả về kiểu của một đối tượng R. Kiểu của một đối tượng cho bạn biết thêm về kiểu (nội bộ R) hoặc chế độ lưu trữ của bất kỳ đối tượng nào:
# Retrieve the types of `a` and `b`
typeof(a)
typeof(b)
'double'
'list'
Trong ví dụ trên nơi bạn định nghĩa biến a và b, bạn có thể thấy các cấu trúc dữ liệu chứa các dãy phần tử dữ liệu. Những phần tử này có thể cùng hoặc khác kiểu dữ liệu. Bạn có thể tìm thấy 6 kiểu dữ liệu nguyên tử sau trong R:
- numeric, chẳng hạn
100,5,4, bao gồm số nguyên. - character, chẳng hạn
"Hello","True", hoặc"23.4", gồm các chuỗi ký tự bàn phím; - logical, như
TRUEhoặcFALSE, gồm các "giá trị chân trị"; - raw, như
48 65 6c 6c 6f, gồm các bit; - complex, như
2+5i, bao gồm số phức; Và cuối cùng, - double, như
3.14, bao gồm số thập phân.
Hầu như mọi đối tượng trong R đều có thuộc tính đi kèm. Ví dụ, bạn có thể đã biết ma trận và mảng đơn giản là các vector với thuộc tính dim và tùy chọn dimnames gắn vào vector. Thuộc tính được dùng để triển khai cấu trúc lớp được sử dụng trong R. Là một ngôn ngữ hướng đối tượng, khái niệm lớp cùng với phương thức là trung tâm. Lớp là một định nghĩa của đối tượng. Nó xác định đối tượng chứa thông tin gì và có thể được sử dụng như thế nào.
Xem ví dụ sau:
# Retrieve the classes of `a` and `b`
class(a)
class(b)
'numeric'
'list'
Lưu ý rằng nếu một đối tượng không có thuộc tính class, nó sẽ có một lớp ngầm định, "matrix", "array" hoặc kết quả của hàm mode().
Một số lớp đặc biệt mà bạn có thể gặp là Date và Formula; Và lớp sau chính là chủ đề của hướng dẫn hôm nay!
Công thức trong R là gì?
Như bạn đã đọc trong phần mở đầu, bạn có thể đã thấy công thức xuất hiện khi làm việc với các package như ggplot2 hoặc trong các hàm như lm(). Vì bạn thường dùng công thức trong các lời gọi hàm này để diễn đạt ý tưởng về một mô hình thống kê, nên hoàn toàn hợp lý khi bạn thường dùng các đối tượng R này trong các hàm mô hình hóa cũng như trong một số hàm đồ họa.
Đúng không?
Tuy nhiên, công thức không chỉ giới hạn ở mô hình. Chúng là một công cụ mạnh mẽ, dùng chung, cho phép bạn nắm bắt hai điều:
- Một biểu thức chưa được đánh giá, và
- Ngữ cảnh hoặc môi trường nơi biểu thức được tạo ra.
Điều này giải thích vì sao công thức được dùng trong các lời gọi hàm để tạo ra "hành vi đặc biệt": chúng cho phép bạn giữ lại giá trị của các biến mà không đánh giá ngay, để hàm có thể diễn giải chúng.
Với các cấu trúc dữ liệu còn mới trong đầu, bạn có thể mô tả các đối tượng R này là các đối tượng “ngôn ngữ” hoặc các biểu thức chưa được đánh giá có lớp là “formula” và có một thuộc tính lưu trữ môi trường.
Ở phần trước, bạn đã thấy các đối tượng có những kiểu (nội bộ R) nhất định cho biết đối tượng được lưu trữ như thế nào. Trong trường hợp này, một công thức là một đối tượng có kiểu "language".
Nhưng chính xác điều đó nghĩa là gì?
Bạn thường bắt gặp kiểu đối tượng này khi bạn đang xử lý chính ngôn ngữ R. Hãy xem ví dụ sau để hiểu rõ hơn:
# Retrieve the object type
typeof(quote(x * 10))
# Retrieve the class
class(quote(x * 10))
'language'
'call'
Trong ví dụ trên, bạn yêu cầu R trả về kiểu và lớp của quote(x*10). Kết quả, bạn thấy kiểu của quote(x*10) là 'language', và class là 'call'.
Đây chắc chắn không phải là một công thức, vì bạn sẽ cần class() trả về 'formula'!
Vậy cái gì mới là công thức?
Một đặc trưng của công thức trong R là toán tử dấu ngã ~. Với toán tử này, bạn có thể nói: "hãy giữ nguyên ý nghĩa của đoạn mã này, mà chưa đánh giá ngay”. Điều đó cũng lý giải vì sao bạn có thể xem công thức trong R như một toán tử “trích dẫn”.
Nhưng một công thức trông chính xác như thế nào? Xem kỹ dòng mã sau:
# A formula
c <- y ~ x
d <- y ~ x + b
# Double check the class of `c`
class(c)
'formula'
Biến ở phía bên trái của dấu ngã (~) được gọi là "biến phụ thuộc", trong khi các biến ở phía bên phải được gọi là "biến độc lập" và được nối với nhau bằng dấu cộng +.
Bạn nên biết rằng tên gọi của các biến này thay đổi tùy ngữ cảnh. Bạn có thể đã thấy biến độc lập xuất hiện như "predictor (variable)", "controlled variable", "feature", v.v. Tương tự, bạn có thể bắt gặp biến phụ thuộc là "response variable", "outcome variable" hoặc "label".
Lưu ý rằng, dù công thức d bạn định nghĩa ở khối mã trên chứa một vài biến, cấu trúc cơ bản của một công thức thực ra chỉ là ký hiệu dấu ngã ~ và ít nhất một biến độc lập ở bên phải.
Ghi nhớ rằng công thức thực chất là các đối tượng ngôn ngữ có thuộc tính lưu trữ môi trường:
# Return the type of `d`
typeof(d)
# Retrieve the attributes of `d`
attributes(d)
'language'
$class
[1] "formula"
$.Environment
<environment: R_GlobalEnv>
Như bạn đã thấy trong các ví dụ trên, các biến được đưa vào một công thức có thể là vector, chẳng hạn. Tuy nhiên, bạn sẽ thường thấy các biến trong công thức đến từ một data frame, giống như trong ví dụ sau:
Sepal.Width ~ Petal.Width + log(Petal.Length) + Species
Lưu ý rằng mọi giá trị dữ liệu đã được gán cho các ký hiệu trong công thức sẽ không được truy cập khi chính công thức được tạo ra.
Giờ bạn đã biết công thức trông thế nào và chúng là gì trong R, cũng nên nhắc rằng đối tượng công thức cơ bản sẽ khác nhau tùy bạn có công thức một vế hay hai vế. Bạn có thể nhận ra loại đầu tiên bằng cách nhìn biến phía bên trái. Nếu không có, như trong ~ x, bạn có công thức một vế.
Điều này cũng có nghĩa công thức một vế sẽ có độ dài là 2, còn công thức hai vế sẽ có độ dài là 3.
Chưa tin hẳn? Xem khối mã sau. Bạn có thể truy cập các phần tử của một công thức nhờ dấu ngoặc vuông: [[ và ]].
e <- ~ x + y + z
f <- y ~ x + b
# Return the length of `g`
length(e)
length(f)
# Retrieve the elements at index 1 and 2
e[[1]]
e[[2]]
f[[3]]
2
3
`~`
x + y + z
x + bVì sao dùng công thức trong R?
Như bạn đã thấy, công thức là công cụ mạnh mẽ, dùng chung cho phép bạn giữ lại giá trị của các biến mà không đánh giá chúng ngay để hàm có thể diễn giải. Đó đã là một phần câu trả lời vì sao bạn nên dùng công thức trong R.
Ngoài ra, bạn dùng các đối tượng R này để diễn đạt mối quan hệ giữa các biến.
Ví dụ, ở dòng đầu tiên trong khối mã dưới đây, bạn nói "y là hàm của x, a và b"; Dĩ nhiên, bạn cũng có thể gặp công thức phức tạp hơn, như ở dòng thứ hai, nơi bạn muốn nói "bề rộng đài hoa (sepal width) là hàm của bề rộng cánh hoa (petal width), có điều kiện theo loài".
y ~ x + a + b
Sepal.Width ~ Petal.Width | Species
y ~ x + a + b
Sepal.Width ~ Petal.Width | SpeciesSử dụng công thức trong R
Giờ bạn đã biết thêm về "cái gì" và "vì sao" của các đối tượng R đặc biệt này, đã đến lúc học cách bạn có thể dùng các công thức cơ bản cũng như phức tạp hơn! Trong phần này, bạn sẽ không chỉ thấy cách tạo và nối các công thức cơ bản, mà còn khám phá cách xây dựng các công thức phức tạp hơn với sự trợ giúp của các toán tử.
Cách tạo một công thức trong R
Bạn đã biết làm điều này! Bạn đã thấy một vài ví dụ trong hướng dẫn này, nhưng hãy điểm lại:
y ~ x
~ x + y + z
g <- y ~ x + b
Đúng vậy - Bạn chỉ cần gõ công thức!
Tuy nhiên, bạn có thể sẽ rơi vào tình huống cần hoặc muốn tạo một công thức từ một đối tượng R, như một chuỗi. Trong các trường hợp đó, bạn có thể dùng hàm formula hoặc as.formula():
"y ~ x1 + x2"
h <- as.formula("y ~ x1 + x2")
h <- formula("y ~ x1 + x2")
Dễ thôi!
Cách nối các công thức
Để ghép hoặc gom nhiều công thức lại với nhau, bạn có hai lựa chọn. Thứ nhất, bạn có thể tạo biến riêng cho từng công thức rồi dùng list():
# Create variables
i <- y ~ x
j <- y ~ x + x1
k <- y ~ x + x1 + x2
# Concatentate
formulae <- list(as.formula(i),as.formula(j),as.formula(k))
# Double check the class of the list elements
class(formulae[[1]])
'formula'
Hoặc, bạn cũng có thể dùng hàm lapply(), trong đó bạn truyền vào một vector với tất cả công thức của bạn làm đối số thứ nhất và as.formula là hàm bạn muốn áp dụng lên từng phần tử của vector đó:
# Join all with `c()`
l <- c(i, j, k)
# Apply `as.formula` to all elements of `f`
lapply(l, as.formula)
[[1]]
y ~ x
[[2]]
y ~ x + x1
[[3]]
y ~ x + x1 + x2
Các toán tử trong công thức
Với những điều cơ bản này, bạn đã sẵn sàng đào sâu vào một số công thức phức tạp hơn! Ở trên, bạn đã thấy đặc trưng của công thức là ký hiệu dấu ngã ~. Bên cạnh ký hiệu đó, bạn cũng thấy bạn cần các biến phụ thuộc và độc lập, và chúng có thể được nối bằng dấu cộng +.
Nhưng còn nhiều hơn thế!
Ngoài ký hiệu +, còn có những ký hiệu khác có thể thêm ý nghĩa đặc biệt cho công thức của bạn:
-để loại bỏ các hạng;:cho tương tác;*cho phép giao;%in%cho lồng nhau; Và^để giới hạn phép giao đến bậc được chỉ định.
Bạn sẽ thấy ví dụ của tất cả các toán tử này trong phần còn lại! Hãy bắt đầu với các toán tử + và -:
# Use multiple independent variables
y ~ x1 + x2
# Ignore objects in an analysis
y ~ x1 - x2
Lưu ý rằng bạn sẽ thường cần các ký hiệu : và * trong bối cảnh mô hình hồi quy, nơi bạn cần chỉ định các hạng tương tác. Như bạn đã đọc ở trên, ký hiệu thứ nhất dùng cho tương tác, nghĩa là bạn chỉ muốn phần tương tác của các biến, chứ không phải các biến tự thân. Điều này trái ngược với ký hiệu thứ hai, dùng cho phép giao: bạn dùng nó để bao gồm cả hai biến và tương tác của chúng.
Hãy cẩn thận! Khi dùng các toán tử này, một số công thức có thể trông khác nhau nhưng thực ra tương đương. Xem các ví dụ sau, chúng sẽ tạo ra cùng một hồi quy:
y ~ x1 * x2
y ~ x1 + x2 + x1:x2
Chưa chắc vì sao hai công thức này có thể giống nhau? Xem các khối mã R sau:
# Set seed
set.seed(123)
# Data
x = rnorm(5)
x2 = rnorm(5)
y = rnorm(5)
# Model frame
model.frame(y ~ x * x2, data = data.frame(x = x, y = y, x2=x2))
| y | x | x2 |
|---|---|---|
| 1.7150650 | -0.56047565 | 1.2240818 |
| 0.4609162 | -0.23017749 | 0.3598138 |
| -1.2650612 | 1.55870831 | 0.4007715 |
| -0.6868529 | 0.07050839 | 0.1106827 |
| -0.4456620 | 0.12928774 | -0.5558411 |
model.frame(y ~ x + x2 + x:x2, data = data.frame(x = x, y = y, x2))
| y | x | x2 |
|---|---|---|
| 1.7150650 | -0.56047565 | 1.2240818 |
| 0.4609162 | -0.23017749 | 0.3598138 |
| -1.2650612 | 1.55870831 | 0.4007715 |
| -0.6868529 | 0.07050839 | 0.1106827 |
| -0.4456620 | 0.12928774 | -0.5558411 |
Đừng lo nếu bạn chưa biết hàm model.frame(); Bạn sẽ xem thêm ở phần sau của hướng dẫn!
Thêm nữa, đây là ví dụ về lồng nhau, bạn có thể khai triển thành y ~ a + a:b:
y ~ a + b %in% a
Tất cả các toán tử này thực sự rất hay, nhưng nếu bạn muốn thực hiện một phép toán số học thực sự thì sao? Giả sử bạn muốn đưa x và x^2 vào mô hình. Trong các trường hợp như vậy, bạn có thể bị cám dỗ viết công thức: y ~ x + x^2.
Nhưng kết quả có đúng như bạn muốn không? Xem nhé!
model.frame( y ~ x + x^2, data = data.frame(x = rnorm(5), y = rnorm(5)))
y ~ x + x^2
| y | x |
|---|---|
| -0.2053091 | 1.18231565 |
| -0.3030972 | 0.04779636 |
| -0.7621604 | 0.86382418 |
| -0.1377784 | -1.18333097 |
| -0.3813125 | -1.25247842 |
Đó không phải là kết quả bạn kỳ vọng!
Trong ví dụ trên, bạn không “bảo vệ” biểu thức số học và hậu quả là R sẽ bỏ hạng x^2, vì nó được coi là trùng lặp với x.
Tại sao vậy?
x sẽ cho bạn hiệu ứng chính của x, và x^2 sẽ cho bạn hiệu ứng chính và tương tác bậc hai của x. Cuối cùng, bạn sẽ chỉ đưa x vào model frame vì hiệu ứng chính của x đã có từ hạng x trong công thức, và không có gì để “giao” với x để tạo ra các tương tác bậc hai trong hạng x^2.
Để tránh điều này, bạn có vài giải pháp:
- Bạn có thể tính toán và lưu sẵn tất cả biến
- Bạn dùng toán tử
I()hay "as-is":y ~ x + I(x^2)
Xem ví dụ sau để hiểu hệ quả của việc thêm hàm I() vào mã của bạn:
model.frame( y ~ x + I(x^2), data = data.frame(x = rnorm(5), y = rnorm(5)))
y ~ x + I(x^2)| y | x | I(x^2) |
|---|---|---|
| 1.414090 | -0.1996230 | 0.039849.... |
| 1.777646 | -1.0675904 | 1.139749.... |
| 1.710137 | -1.4071841 | 1.980167.... |
| 1.259111 | -1.3747289 | 1.889879.... |
| -1.490866 | 0.8323668 | 0.692834.... |
Dòng mã cuối này thực sự bảo R tính giá trị của x^2 trước khi dùng công thức. Lưu ý thêm rằng bạn có thể dùng toán tử “as-is” để chuẩn hóa một biến cho mô hình; Bạn chỉ cần bao tên biến liên quan trong I():
y ~ I(2 * x)
Tất cả điều này có thể có vẻ khá trừu tượng khi xem các ví dụ trên, nên hãy đề cập vài trường hợp khác; Ví dụ, hồi quy đa thức. Trong các trường hợp này, bạn sẽ cần làm việc với hàm I(). Với mô hình ANOVA nhân tố bị giới hạn ở các tương tác depth=2, ngược lại, bạn sẽ không cần hàm này vì bạn muốn khai triển ra một công thức chứa hiệu ứng chính cho a, b và c cùng với các tương tác bậc hai của chúng:
# Polynomial Regression
y ~ x + I(x^2) + I(x^3)
# Factorial ANOVA
y ~ (a*b*c)^2
Cuối cùng, có một tính năng khác sẽ hữu ích khi bạn làm việc với nhiều biến, đó là toán tử .. Khi bạn dùng toán tử này trong một công thức, bạn tham chiếu đến tất cả các biến khác trong ma trận mà chưa được đưa vào mô hình. Điều này tiện lợi, ví dụ, khi bạn muốn chạy hồi quy trên ma trận hoặc dataframe và không muốn gõ hết tên biến:
y ~ .
Cách kiểm tra công thức trong R
Khi bạn đã tạo công thức, bạn có thể cũng muốn kiểm tra nó. Phần này sẽ giới thiệu một số công cụ bạn có thể dùng để khám phá kỹ hơn các đối tượng R đặc biệt mà bạn đã tạo!
Lưu ý rằng bạn đã thấy một số cách để kiểm tra công thức ở các phần trước: bạn đã thấy các hàm như attributes(), typeof(), class(), v.v.
terms() function
Để kiểm tra và so sánh các công thức khác nhau, bạn có thể dùng hàm terms():
m <- formula("y ~ x1 + x2")
terms(m)
y ~ x1 + x2
attr(,"variables")
list(y, x1, x2)
attr(,"factors")
x1 x2
y 0 0
x1 1 0
x2 0 1
attr(,"term.labels")
[1] "x1" "x2"
attr(,"order")
[1] 1 1
attr(,"intercept")
[1] 1
attr(,"response")
[1] 1
attr(,".Environment")
<environment: R_GlobalEnv>all.vars
Nếu bạn muốn biết tên các biến trong mô hình, bạn có thể dùng all.vars. Với hàm này, bạn trả về một vector ký tự chứa tất cả các tên xuất hiện trong một công thức:
print(all.vars(m))
[1] "y" "x1" "x2"update() function
Để chỉnh sửa công thức mà không chuyển chúng sang dạng ký tự, bạn có thể dùng hàm update():
update(y ~ x1 + x2, ~. + x3)
y ~ x1 + x2 + x3
Lưu ý rằng bạn cũng có thể cập nhật công thức bằng cách chuyển nó thành ký tự với as.character(); Sau đó, bạn có thể xây dựng công thức rất nhanh bằng cách dùng paste(). Ví dụ, nếu bạn muốn thêm một biến phía bên phải vào công thức, bạn chỉ cần paste nó:
as.formula(paste("y ~ x1 + x2", "x3", sep = "+"))
factors <- c("x2", "x3")
as.formula(paste("y~", paste(factors, collapse="+")))
y ~ x1 + x2 + x3
y ~ x2 + x3
Trong khối mã trên, bạn có thể thấy bạn có thể dùng đối số sep hoặc collapse để chỉ định một chuỗi ký tự ngăn cách các hạng trong công thức.
Tuy nhiên, dùng paste() chắc chắn không phải cách duy nhất để điều chỉnh công thức: bạn cũng có thể dùng reformulate():
reformulate(termlabels = factors, response = 'y')
y ~ x2 + x3
is.formula()
Kiểm tra lại xem biến của bạn có phải là công thức không bằng cách truyền nó vào hàm is.formula(). Lưu ý rằng hàm này là một phần của thư viện plyr, nên bạn cần nạp thư viện này vào workspace trước khi gọi is.formula()!
# Load `plyr`
library(plyr)
# Check `m`
is.formula(m)
TRUE
Khi nào nên dùng công thức
Đến lúc này, bạn đã đọc rằng công thức trong R là công cụ dùng chung không chỉ giới hạn trong mô hình, và bạn đã thấy một số ví dụ nơi bạn có thể dùng công thức. Phần này, bạn sẽ đi sâu hơn vào chủ đề sau: bạn sẽ xem một số trường hợp bạn có thể tận dụng các công cụ này. Dĩ nhiên, bạn sẽ đề cập các hàm mô hình và đồ họa của các package như lattice và stats, nhưng bạn cũng sẽ đề cập đánh giá không tiêu chuẩn trong dplyr.
Các hàm mô hình
R rất tuyệt khi bạn cần làm mô hình thống kê. Như bạn đã biết, mô hình thống kê là cách đơn giản hóa, được hình thức hóa toán học để xấp xỉ thực tế và tùy chọn đưa ra dự đoán từ xấp xỉ này. Một mô hình thống kê thường biểu diễn quá trình sinh dữ liệu dưới dạng lý tưởng hóa. Để làm mô hình thống kê, bạn cần các hàm mô hình.
Các hàm mô hình trong R là một ví dụ điển hình nơi bạn cần một đối tượng formula làm đối số. Các đối số khác mà bạn có thể thấy trong các hàm này là data, cho phép bạn chỉ định một data frame bạn muốn “đính kèm” trong suốt quá trình mô hình, subset để chọn dữ liệu bạn muốn dùng, ... Nói chung, nếu bạn muốn biết nên truyền những đối số nào cho hàm cụ thể, đừng ngần ngại dùng hàm help() hoặc ? trong console R của bạn.
Các hàm mô hình trả về một đối tượng mô hình chứa toàn bộ thông tin về độ khớp. Các hàm tổng quát của R như print(), summary(), plot(), anova(), v.v. sẽ có các phương thức được định nghĩa cho các lớp đối tượng cụ thể để trả về thông tin phù hợp cho kiểu đối tượng đó.
Có lẽ một trong những hàm mô hình hóa nổi tiếng nhất là lm(), dùng tất cả các đối số vừa mô tả. Bạn dùng lm() để khớp các mô hình tuyến tính. Bạn có thể dùng nó để thực hiện hồi quy, phân tích phương sai một tầng và phân tích hiệp phương sai. Hãy xem ví dụ nơi bạn dùng lm() và kiểm tra mô hình với print():
lm.m <- lm(Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
data = iris,
subset = Sepal.Length > 4.6)
print(lm.m)
Call:
lm(formula = Sepal.Width ~ Petal.Width + log(Petal.Length) +
Species, data = iris, subset = Sepal.Length > 4.6)
Coefficients:
(Intercept) Petal.Width log(Petal.Length) Speciesversicolor
3.1531 0.6620 0.4612 -1.9265
Speciesvirginica
-2.3088 lm() ban đầu sử dụng công thức và môi trường phù hợp để chuyển mối quan hệ giữa các biến thành việc tạo một data frame chứa dữ liệu.
Cũng có các phương thức model.frame(), mà bạn đã thấy một ví dụ trong hướng dẫn này, thường được dùng để truy xuất hoặc tái tạo model frame từ đối tượng đã khớp, mà không có đối số nào khác. Điều này cho phép bạn truy xuất các cột của data frame tương ứng với các đối số của lời gọi ban đầu ngoài formula, subset và weights: ví dụ, phương thức glm() xử lý offset, etastart và mustart.
Trong khối mã sau, bạn thấy bạn dùng hàm model.frame() để nhận lại một data frame từ đối tượng đã khớp; Lưu ý rằng mã hơi khác với khối bạn đã thấy ở trên: đối số subset đã được chỉnh một chút.
stats::model.frame(formula = Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
data = iris,
subset = Sepal.Length > 6.9,
drop.unused.levels = TRUE)
| Sepal.Width | Petal.Width | log(Petal.Length) | Species | |
|---|---|---|---|---|
| 51 | 3.2 | 1.4 | 1.547563 | versicolor |
| 103 | 3.0 | 2.1 | 1.774952 | virginica |
| 106 | 3.0 | 2.1 | 1.887070 | virginica |
| 108 | 2.9 | 1.8 | 1.840550 | virginica |
| 110 | 3.6 | 2.5 | 1.808289 | virginica |
| 118 | 3.8 | 2.2 | 1.902108 | virginica |
| 119 | 2.6 | 2.3 | 1.931521 | virginica |
| 123 | 2.8 | 2.0 | 1.902108 | virginica |
| 126 | 3.2 | 1.8 | 1.791759 | virginica |
| 130 | 3.0 | 1.6 | 1.757858 | virginica |
| 131 | 2.8 | 1.9 | 1.808289 | virginica |
| 132 | 3.8 | 2.0 | 1.856298 | virginica |
| 136 | 3.0 | 2.3 | 1.808289 | virginica |
Mẹo: còn có nhiều hàm khác trong package stats cho phép bạn dùng công thức, như aggregate().
Với các mô hình hồi quy hỗn hợp tuyến tính, cho phép bạn mô hình hóa hiệu ứng ngẫu nhiên để tính đến biến thiên do các yếu tố như khác biệt giữa người quan sát, bạn có thể dùng package nlme với hàm lme(). Ở đây cũng vậy, bạn thấy formula là đối số đầu tiên bạn cần đưa cho hàm mô hình, và còn có đối số data!
# Load packages
library(MASS)
library(nlme)
# Get some data
data(oats)
# Adjust the data names and columns
names(oats) = c('block', 'variety', 'nitrogen', 'yield')
oats$mainplot = oats$variety
oats$subplot = oats$nitrogen
# Fit a non-linear mixed-effects model
nlme.m = lme(yield ~ variety*nitrogen,
random = ~ 1|block/mainplot,
data = oats)
# Retrieve a summary
summary(nlme.m)
Linear mixed-effects model fit by REML
Data: oats
AIC BIC logLik
559.0285 590.4437 -264.5143
Random effects:
Formula: ~1 | block
(Intercept)
StdDev: 14.64496
Formula: ~1 | mainplot %in% block
(Intercept) Residual
StdDev: 10.29863 13.30727
Fixed effects: yield ~ variety * nitrogen
Value Std.Error DF t-value p-value
(Intercept) 80.00000 9.106958 45 8.784492 0.0000
varietyMarvellous 6.66667 9.715028 10 0.686222 0.5082
varietyVictory -8.50000 9.715028 10 -0.874933 0.4021
nitrogen0.2cwt 18.50000 7.682957 45 2.407927 0.0202
nitrogen0.4cwt 34.66667 7.682957 45 4.512152 0.0000
nitrogen0.6cwt 44.83333 7.682957 45 5.835427 0.0000
varietyMarvellous:nitrogen0.2cwt 3.33333 10.865342 45 0.306786 0.7604
varietyVictory:nitrogen0.2cwt -0.33333 10.865342 45 -0.030679 0.9757
varietyMarvellous:nitrogen0.4cwt -4.16667 10.865342 45 -0.383482 0.7032
varietyVictory:nitrogen0.4cwt 4.66667 10.865342 45 0.429500 0.6696
varietyMarvellous:nitrogen0.6cwt -4.66667 10.865342 45 -0.429500 0.6696
varietyVictory:nitrogen0.6cwt 2.16667 10.865342 45 0.199411 0.8428
Correlation:
(Intr) vrtyMr vrtyVc ntr0.2 ntr0.4 ntr0.6
varietyMarvellous -0.533
varietyVictory -0.533 0.500
nitrogen0.2cwt -0.422 0.395 0.395
nitrogen0.4cwt -0.422 0.395 0.395 0.500
nitrogen0.6cwt -0.422 0.395 0.395 0.500 0.500
varietyMarvellous:nitrogen0.2cwt 0.298 -0.559 -0.280 -0.707 -0.354 -0.354
varietyVictory:nitrogen0.2cwt 0.298 -0.280 -0.559 -0.707 -0.354 -0.354
varietyMarvellous:nitrogen0.4cwt 0.298 -0.559 -0.280 -0.354 -0.707 -0.354
varietyVictory:nitrogen0.4cwt 0.298 -0.280 -0.559 -0.354 -0.707 -0.354
varietyMarvellous:nitrogen0.6cwt 0.298 -0.559 -0.280 -0.354 -0.354 -0.707
varietyVictory:nitrogen0.6cwt 0.298 -0.280 -0.559 -0-354 -0.354 -0.707
vM:0.2 vV:0.2 vM:0.4 vV:0.4 vM:0.6
varietyMarvellous
varietyVictory
nitrogen0.2cwt
nitrogen0.4cwt
nitrogen0.6cwt
varietyMarvellous:nitrogen0.2cwt
varietyVictory:nitrogen0.2cwt 0.500
varietyMarvellous:nitrogen0.4cwt 0.500 0.250
varietyVictory:nitrogen0.4cwt 0.250 0.500 0.500
varietyMarvellous:nitrogen0.6cwt 0.500 0.250 0.500 0.250
varietyVictory:nitrogen0.6cwt 0.250 0.500 0.250 0.500 0.500
Standardized Within-Group Residuals:
Min Q1 Med Q3 Max
-1.81300898 -0.56144838 0.01758044 0.63864476 1.57034166
Number of Observations: 72
Number of Groups:
block mainplot %in% block
6 18 Lưu ý rằng ngoài nlme, còn có các package khác, như lme4, cũng dành cho việc khớp các mô hình hỗn hợp tuyến tính và hỗn hợp tuyến tính tổng quát.
Một ví dụ khác về các hàm mô hình và sự hiện diện của công thức là nls(), bạn sẽ dùng để xây dựng các mô hình phi tuyến:
# Set seed
set.seed(20160227)
# Data
x <- seq(0,50,1)
y <- ((runif(1,10,20)*x)/(runif(1,0,10)+x))+rnorm(51,0,1)
# Non-linear model
nls.m <- nls(y ~ a*x/(b+x),
start=c(a=4, b=1))
Ví dụ cuối cùng là các hàm bạn có thể dùng để xây dựng Mô hình Tuyến tính Tổng quát (GLM). Trong R, bạn có thể dùng hàm glm() để làm điều này. Có thể đã hơi lặp lại, nhưng ở đây bạn cũng dùng các đối số formula và data:
# Load package
library(MPDiR)
# Get the data
data(Chromatic)
# Model
glm.m <- glm(Thresh ~ Axis:(I(Age^-1) + Age),
family = Gamma(link = "identity"),
data = Chromatic)
# Get back a summary
summary(glm.m)
Call:
glm(formula = Thresh ~ Axis:(I(Age^-1) + Age), family = Gamma(link = "identity"),
data = Chromatic)
Deviance Residuals:
Min 1Q Median 3Q Max
-1.2160 -0.3728 -0.0805 0.2311 1.2932
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 3.282e-04 9.965e-05 3.294 0.00106 **
AxisDeutan:I(Age^-1) 7.803e-03 3.686e-04 21.172 < 2e-16 ***
AxisProtan:I(Age^-1) 8.271e-03 3.863e-04 21.410 < 2e-16 ***
AxisTritan:I(Age^-1) 1.166e-02 5.284e-04 22.065 < 2e-16 ***
AxisDeutan:Age 1.521e-05 3.418e-06 4.450 1.06e-05 ***
AxisProtan:Age 1.540e-05 3.434e-06 4.484 9.10e-06 ***
AxisTritan:Age 4.812e-05 5.838e-06 8.241 1.48e-15 ***
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
(Dispersion parameter for Gamma family taken to be 0.2054848)
Null deviance: 543.35 on 510 degrees of freedom
Residual deviance: 100.40 on 504 degrees of freedom
AIC: -4777.6
Number of Fisher Scoring iterations: 6Trước khi chuyển sang các hàm đồ họa, còn một điều nữa đáng biết: khi bạn dùng công thức trong các hàm mô hình như lm(), sẽ có một chuyển đổi tiêu chuẩn từ công thức sang hàm. Để giải thích chính xác kiểu chuyển đổi nào diễn ra, bạn nên quay lại ví dụ bạn đã thấy trước đó trong hướng dẫn:
lm.m <- lm(Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
data = iris,
subset = Sepal.Length > 4.6)
Trong khi mục đích của khối mã này là khớp các mô hình hồi quy tuyến tính, công thức được dùng để chỉ định mô hình ký hiệu cũng như tạo ma trận thiết kế dự kiến. Ma trận thiết kế là biểu diễn hai chiều của tập biến độc lập (predictor) nơi các bản ghi dữ liệu là hàng và các thuộc tính biến là cột. Ma trận thiết kế còn được biết như ma trận X.
Nói vậy để thấy, phương thức công thức cũng định nghĩa các cột nên được đưa vào ma trận thiết kế.
Nhưng chính xác tất cả điều đó nghĩa là gì? Hãy xem các dòng mã sau:
# A formula
y ~ x
# A converted formula
y = a_1 + a_2 * x
Đây là một ví dụ chuyển đổi đơn giản: y ~ x được dịch thành y = a_1 + a_2 * x.
Để xem và hiểu R thực sự làm gì, bạn có thể dùng hàm model_matrix(). Hàm này tạo một ma trận thiết kế hoặc mô hình bằng cách, ví dụ, khai triển các nhân tố thành một tập biến giả (dummy), tùy vào đối sánh (contrasts), và khai triển các tương tác tương tự.
Đừng quên truyền vào data frame df và công thức để nhận về một tibble định nghĩa phương trình mô hình:
# Load packages
library(tidyverse)
library(modelr)
# A data frame
df <- tribble(
~y, ~x1, ~x2,
4, 2, 5,
5, 1, 6
)
# Model matrix
model_matrix(df, y ~ x1)
| (Intercept) | x1 |
|---|---|
| 1 | 2 |
| 1 | 1 |
Có một cột (Intercept) xuất hiện thêm. Đây là hành vi mặc định của R. Tuy nhiên, cách R thêm hệ số chặn vào mô hình chỉ là có một cột toàn số 1. Nếu bạn không muốn điều này, bạn cần bỏ nó đi rõ ràng bằng cách thêm -1 vào công thức, như sau:
model_matrix(df, y ~ x1-1)
| x1 |
|---|
| 2 |
| 1 |
Lưu ý thêm rằng ma trận mô hình sẽ tăng theo cách không gây ngạc nhiên khi bạn thêm nhiều biến hơn vào mô hình.
model_matrix(df, y ~ x1 + x2)
| (Intercept) | x1 | x2 |
|---|---|---|
| 1 | 2 | 5 |
| 1 | 1 | 6 |
Các hàm đồ họa trong R
Một nơi quan trọng khác nơi bạn sẽ thấy công thức trong R là các hàm đồ họa. Có rất nhiều package ngoài kia, nên hướng dẫn này chỉ tập trung vào graphics, lattice, ggplot2 và ggformula.
graphics
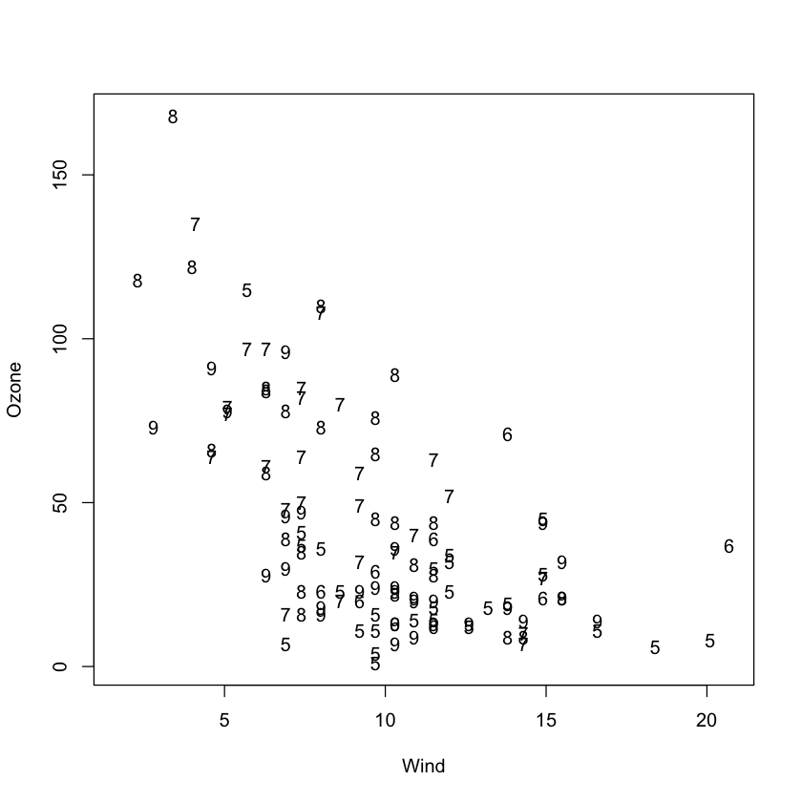
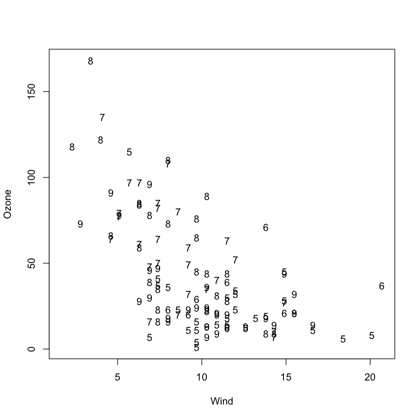
Package cơ bản R graphics cho phép bạn chỉ định biểu đồ phân tán hoặc thêm điểm, đường hoặc văn bản bằng một công thức. Xem ví dụ sau:
# Get data
data(airquality)
# Plot
plot(Ozone ~ Wind, data = airquality, pch = as.character(Month))
Nếu bạn muốn biết thêm, đừng ngần ngại xem trang này.
lattice
lattice là một package được xây dựng trên grid graphics. Đây là một package đồ họa dùng chung cung cấp các triển khai thay thế cho nhiều hàm vẽ có sẵn trong đồ họa cơ bản. Ví dụ cụ thể gồm biểu đồ phân tán với hàm xyplot(), biểu đồ cột với barchart(), và boxplot với bwplot().
Mẹo: bạn muốn học thêm về lattice? Hãy cân nhắc khóa học Trực quan hóa dữ liệu trong R với lattice của DataCamp.
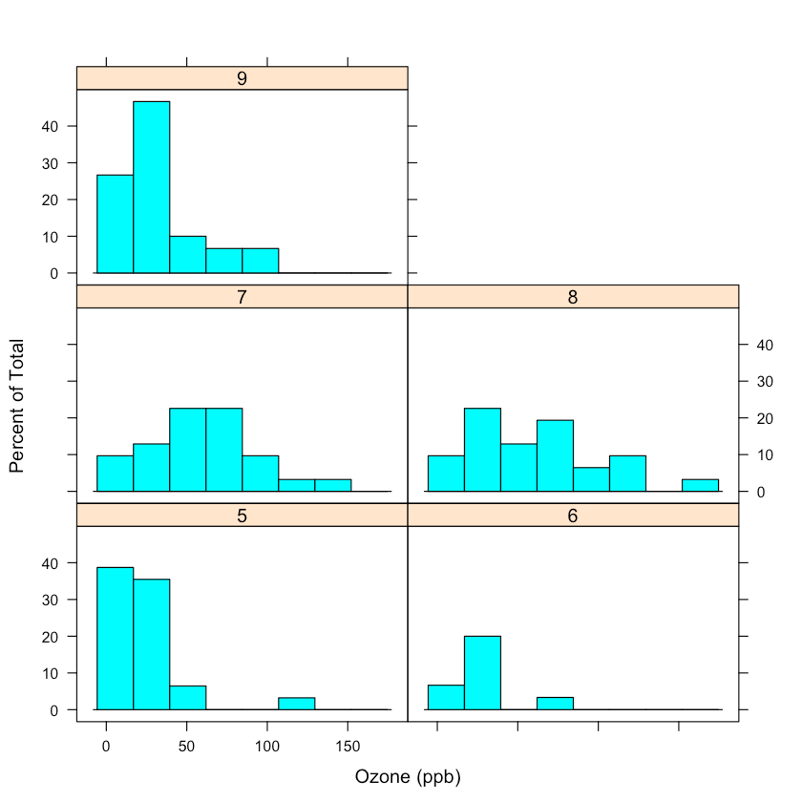
Điểm đặc biệt của package này là nó dùng ký pháp công thức của các mô hình thống kê để mô tả biểu đồ mong muốn, và cụ thể hơn là các biến để vẽ. Nó cũng thêm ký tự ống đứng | để chỉ định biến điều kiện:
# Load package
library(lattice)
# Plot histogram
histogram(~ Ozone | factor(Month),
data = airquality,
layout = c(2, 3),
xlab = "Ozone (ppb)")
Lưu ý rằng cũng như các hàm mô hình, các hàm trong thư viện lattice ngoài đối số formula còn có đối số data, đúng như kỳ vọng!
Nhớ rằng bạn cũng có thể bỏ đối số data trong khối mã trên, nhưng khi đó bạn cần attach dữ liệu:
# Load package
library(lattice)
# Attach data
attach(airquality)
# Plot
histogram(~ Ozone | factor(Month),
layout = c(2, 3),
xlab = "Ozone (ppb)")
ggplot2
Bạn có thể dùng công thức trong nhiều hàm của ggplot2:
geom_smooth()hoặcstats_smooth(), để chỉ định công thức dùng trong hàm làm mượt; Điều này sẽ ảnh hưởng đến dạng của đường khớp.facet_wrap(), để chỉ định các ô (panel) để vẽ.facet_grid(), để chỉ định các hàng và cột cần vẽ, có hoặc không phân ô.
# Load package
library(ggplot2)
# Plot
ggplot(mpg, aes(displ, hwy)) +
geom_point() +
geom_smooth(method = "lm",
formula = y ~ splines::bs(x, 3),
se = FALSE)
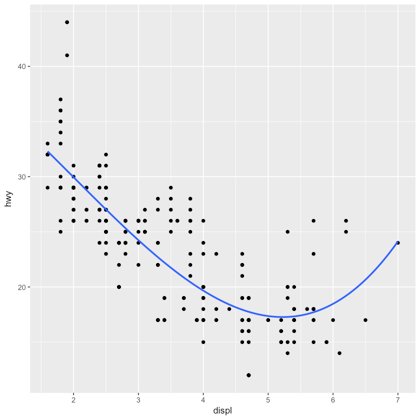
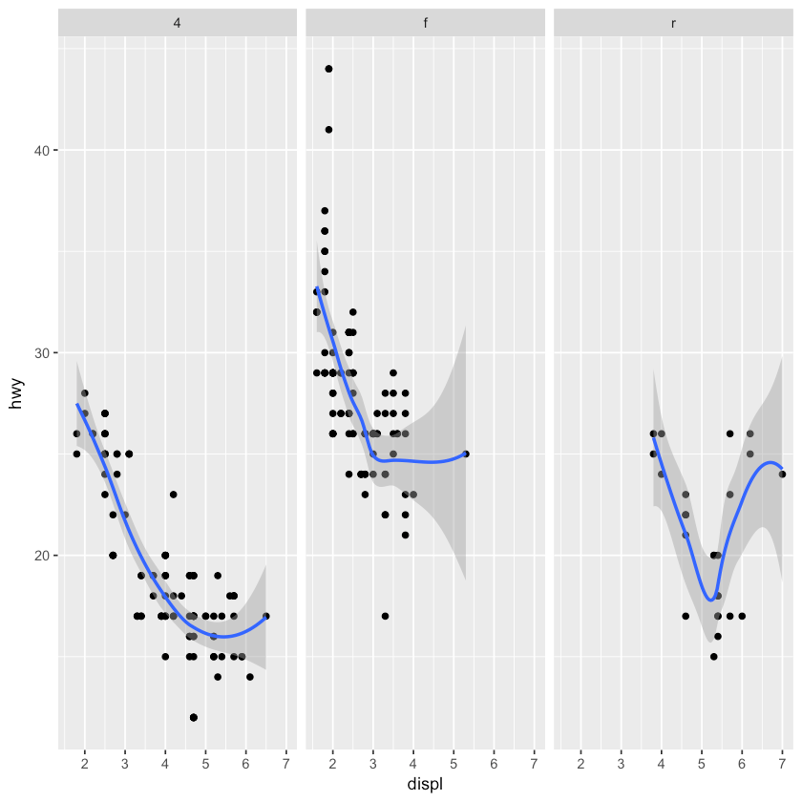
Lưu ý rằng, để tạo biểu đồ này, công thức sử dụng các chữ cái x và y, không phải tên biến. Điều này không như vậy khi bạn dùng facet_wrap():
ggplot(mpg, aes(displ, hwy)) +
geom_point() +
geom_smooth(span = 0.8) +
facet_wrap(~drv)
Muốn tìm hiểu thêm về ggplot2? Xem khóa học này hoặc đọc tài liệu.
ggformula
Package ggformula hiện xây dựng trên ggplot2, nhưng cung cấp một giao diện dựa trên công thức. Điều này tương tự như bạn thấy trong giao diện lattice. Bạn cũng sẽ thấy toán tử pipe được dùng trong package này để xây dựng đồ họa phức tạp hơn từ các thành phần đơn giản hơn.
Mẹo: nếu bạn muốn biết thêm về toán tử pipe trong R, hãy xem hướng dẫn này.
Cách cơ bản để tạo một biểu đồ với ggformula là
gf_plottype(formula, data = mydata)Lưu ý rằng hàm gf_plottype() thực sự bắt đầu bằng gf, nhằm nhắc bạn rằng bạn đang làm việc với các hàm là giao diện dựa trên công thức cho ggplot2; Chữ g là viết tắt của ggplot2 và f là “formula.”
Xem ví dụ sau để thấy điều này trông như thế nào trong mã R:
# Load package
library(ggformula)
# Plot
gf_point(mpg ~ hp, data = mtcars)
Dĩ nhiên, đây chỉ là một biểu đồ cơ bản; Bạn có thể làm được nhiều hơn với package trực quan hóa này! Bạn có thể chọn kiểu glyph khác và các thuộc tính cụ thể cho các glyph đó, bạn có thể tạo biểu đồ 1 hoặc 2 biến, điều chỉnh vị trí của glyph, v.v. Hướng dẫn này sẽ không đi sâu hơn về package này, nhưng điểm mấu chốt ở đây là package này đã biến công thức thành thành phần chính để tạo biểu đồ!
Nếu bạn muốn biết nhiều hơn những gì đã đề cập trong hướng dẫn này, hãy đọc về package ggformula tại đây hoặc xem trang RDocumentation của package.
dplyr
dplyr là một ví dụ về package làm việc với Đánh giá Không Tiêu Chuẩn (Non-Standard Evaluation). Ví dụ khác là library(magrittr) so với library("magrittr"), cả hai đều hoạt động hoàn hảo, dù một dòng có ngoặc kép còn dòng kia thì không! Hãy so sánh các ví dụ về library() với install.packages(), chẳng hạn:
# This will work
install.packages("magrittr")
# This won't work
install.packages(magrittr)
Trong R, bạn thường cần dùng ngoặc kép bất cứ khi nào bạn đặt tên một phần của đối tượng, nhưng trong một số hàm -như library()- bạn không cần. Những hàm này được thiết kế để hoạt động theo cách không tiêu chuẩn. Hơn nữa, một số trong các hàm này còn không có cách tiêu chuẩn!
Đối với dplyr, bạn sẽ thấy hầu hết các hàm của package này hoạt động giống các hàm khác: tất cả dùng Đánh giá Tiêu Chuẩn (SE). Tuy nhiên, để sử dụng tương tác, các hàm cũng có đánh giá không tiêu chuẩn (NSE), giúp bạn đỡ phải gõ nhiều.
(Thừa nhận đi, gõ tất cả những dấu ngoặc kép có thể là một việc nản lòng!)
Đó là lý do hầu hết các hàm dplyr dùng đánh giá không tiêu chuẩn. Chúng không tuân theo các quy tắc đánh giá thông thường của R. Thay vào đó, chúng ghi nhận biểu thức bạn gõ và đánh giá nó theo cách tùy biến.
Tuy vậy, điều đó không có nghĩa các hàm này không có biến thể đánh giá tiêu chuẩn. Mỗi hàm dùng đánh giá không tiêu chuẩn đều có (và nên có) một phiên bản “thoát” đánh giá tiêu chuẩn thực hiện tính toán thực. Hàm đánh giá tiêu chuẩn nên kết thúc bằng _. Điều này nghĩa là có nhiều động từ trong package dplyr: select(), select_(), mutate(), mutate_(), v.v.
Khi dùng tương tác, các hàm này trước tiên sẽ được đánh giá với package lazyeval trước khi được gửi đến phiên bản đánh giá tiêu chuẩn của hàm. Điều đó có nghĩa, bên dưới, select() được đánh giá bằng package lazyeval và gửi đến select_().
Nói vậy để thấy, có 3 cách để “trích dẫn” biến trong các hàm đánh giá tiêu chuẩn mà dplyr và lazyeval hiểu:
- Công thức,
quote(), và- Chuỗi
# Load `dplyr`
library(dplyr)
# NSE evaluation
select(iris, Sepal.Length, Petal.Length)
# standard evaluation
select_(iris, ~Sepal.Length)
select_(iris, ~Sepal.Length, ~Petal.Length) #works
select_(iris, quote(Sepal.Length), quote(Petal.Length)) # yes!
select_(iris, "Sepal.Length", "Petal.Length", "Species")
Mẹo: nếu bạn muốn đọc thêm về đánh giá không tiêu chuẩn, hãy xem chương về chủ đề này trong cuốn Advanced R của Hadley Wickham.
Các package về công thức R
Trước đó, bạn đã thấy bạn có thể tạo và kiểm tra công thức bằng các hàm như as.formula, update(), all.vars, ... Đó đều là các thao tác và chỉnh sửa đơn giản, nhưng còn các thao tác nâng cao với công thức thì sao? Có thể các package sau sẽ hữu ích với bạn!
Formula Package
Gần đây, package này đã được xuất bản trên CRAN. Package này lý tưởng cho những ai muốn đưa công thức lên tầm cao mới. Package này mở rộng lớp cơ bản formula.
Cụ thể hơn, các đối tượng Formula mở rộng các đối tượng công thức cơ bản: với package này, bạn có thể định nghĩa các công thức chấp nhận một toán tử công thức bổ sung | để tách nhiều phần hoặc có thể chứa tất cả các toán tử công thức (bao gồm ký tự ống đứng) ở phía bên trái để hỗ trợ nhiều biến đáp ứng.
Ví dụ về các công thức bạn có thể tạo là:
- Công thức nhiều phần, như
y ~ x1 + x2 | u1 + u2 + u3 | v1 + v2 - Công thức nhiều đáp ứng, như
y1 + y2 ~ x1 + x2 + x3 - Đáp ứng nhiều phần, như
y1 | y2 + y3 ~ x, và - Kết hợp của ba loại trên.
# Load package
library(Formula)
# Create formulas
f1 <- y ~ x1 + x2 | z1 + z2 + z3
F1 <- Formula(f1)
# Retrieve the class of `F1`
class(F1)
- 'Formula'
- 'formula'
Lưu ý rằng các hàm as.formula() và is.formula() cũng đã được cập nhật trong package này: bạn sẽ dùng is.Formula() và as.Formula() thay thế!
Đọc thêm tại đây.
formula.tools
Package này mới được phát hành gần đây và cung cấp cho bạn "các tiện ích lập trình để thao tác công thức, biểu thức, lời gọi, phép gán và các đối tượng R khác". Nghe rất nhiều, nhưng về cốt lõi là thế này: bạn có thể dùng package này để truy cập và sửa đổi cấu trúc công thức cũng như trích xuất và thay thế tên và ký hiệu của các đối tượng R đó. Package này do Christopher Brown viết.
Một số điều bạn có thể thấy hữu ích khi làm việc với package này gồm:
get.vars(): thay vìall.vars(), hàm này sẽ trích xuất tên biến từ nhiều đối tượng R khác nhau, nhưng mọi ký hiệu, v.v. sẽ được nội suy thành tên biến.invert(): bạn có thể dùng hàm này để đảo ngược các toán tử trong một đối tượng, như một công thức.is.one.sided(): hàm này rất hữu ích để xác định một công thức là một vế hay hai vế.
Ghi nhớ rằng một công thức một vế trông như thế này: ~x; Nó sẽ là hai vế khi viết là x~y.
- ...
Còn nhiều điều để khám phá!
Tuyệt vời! Bạn đã đi hết hướng dẫn về công thức R này. Nếu muốn đọc thêm về chúng, nhất định hãy xem cuốn R for Data Science của Hadley Wickham, trong đó có một chương hoàn toàn dành cho công thức và các họ mô hình trong R.
Hãy xem Hướng dẫn bắt đầu với Tidyverse của DataCamp.
Bạn có nghĩ ra thêm trường hợp nào có thể tìm thấy công thức hoặc các package khác để thao tác công thức không? Hãy cho tôi biết trên Twitter: @willems_karlijn.

