
Last chance! 50% off DataCamp Premium
Sale ends in
Als je erover nadenkt, maken veel functies in R gebruik van formules: pakketten zoals ggplot2, stats, lattice en dplyr gebruiken ze allemaal! Veelvoorkomende voorbeelden van functies waarin je deze R-objecten gebruikt zijn glm(), lm(), facet_wrap(), enzovoort. Maar wat zijn die formules nu precies, en waarom zou je ze gebruiken?
Omdat formules een speciale klasse in de programmeertaal R vormen, is het een goed idee om kort de datatypen en datastructuren te herhalen die je in deze taal tot je beschikking hebt.
Onthoud dat R een objectgeoriënteerde programmeertaal is: de taal is rond objecten georganiseerd. Alles in R is een object.
Laten we bij het begin beginnen: in programmeren werk je met datastructuren die je data opslaan, en functies die ze verwerken. Een datastructuur is de interface naar data die in het geheugen van de computer is georganiseerd. Zoals de R Language Definition stelt, geeft R geen directe toegang tot het geheugen van de computer, maar biedt het een aantal gespecialiseerde datastructuren die je als "objecten" kunt aanduiden. Datastructuren zijn elk ontworpen om een bepaald aspect van opslag, toegang of verwerking te optimaliseren.
De vijf belangrijkste datastructuren in R zijn:
# Create variables
a <- c(1,2,3,4,5,6,7,8,9)

b <- list(x = LifeCycleSavings[,1], y = LifeCycleSavings[,2])
Tip: je kunt de functie typeof() gebruiken om het type van een R-object terug te geven. Het type van een object vertelt je meer over het (R-internal) type of de opslagmodus van een object:
# Retrieve the types of `a` and `b`
typeof(a)

typeof(b)
'double'
'list'
In het bovenstaande voorbeeld waarin je de variabelen a en b definieerde, zie je dat de datastructuren reeksen data-elementen bevatten. Deze elementen kunnen van hetzelfde of van verschillende datatypen zijn. Je vindt de volgende 6 atomaire datatypen in R:
100, 5, 4, omvat gehele getallen."Hello", "True" of "23.4", bestaat uit tekenreeksen van toetsenbordtekens;TRUE of FALSE, bestaat uit "waarheidswaarden";48 65 6c 6c 6f, bestaat uit bits;2+5i, omvat complexe getallen; en tot slot3.14, omvat decimale getallen.Bijna alle objecten hebben in R attributen. Je weet wellicht al dat matrices en arrays simpelweg vectors zijn met het attribuut dim en optioneel dimnames toegevoegd aan de vector. Attributen worden gebruikt om de klassenstructuur te implementeren die in R wordt gebruikt. Als objectgeoriënteerde programmeertaal zijn het concept van klassen, samen met methoden, centraal. Een klasse is een definitie van een object. Het bepaalt welke informatie het object bevat en hoe dat object kan worden gebruikt.
Bekijk het volgende voorbeeld:
# Retrieve the classes of `a` and `b`
class(a)

class(b)
'numeric'
'list'
Let op dat als een object geen class-attribuut heeft, het een impliciete klasse heeft, "matrix", "array" of het resultaat van de functie mode().
Enkele van de speciale klassen die je kunt tegenkomen zijn Dates en Formulas; En die laatste is het onderwerp van deze tutorial!
Zoals je in de inleiding van deze tutorial las, heb je formules misschien al gezien bij het werken met pakketten zoals ggplot2 of in functies zoals lm(). Omdat je meestal formules binnen deze functiemanieren gebruikt om het idee van een statistisch model uit te drukken, is het logisch dat je deze R-objecten vaak gebruikt in modelleringsfuncties en in sommige grafische functies.
Toch?
Formules zijn echter niet beperkt tot modellen. Het zijn krachtige hulpmiddelen voor algemeen gebruik waarmee je twee dingen kunt vastleggen:
Dit verklaart waarom formules binnen functiemanieren worden gebruikt om "speciaal gedrag" te genereren: ze stellen je in staat om de waarden van variabelen vast te leggen zonder ze te evalueren, zodat de functie ze kan interpreteren.
Met de datastructuren vers in het geheugen kun je deze R-objecten vervolgens beschrijven als "language"-objecten of niet-geëvalueerde expressies met de klasse "formula" en een attribuut dat de omgeving opslaat.
In de vorige sectie zag je dat objecten bepaalde (R-interne) typen hebben die aangeven hoe het object is opgeslagen. In dit geval is een formule een object van het type "language".
Maar wat betekent dat precies?
Wel, je komt dit soort objecten meestal tegen wanneer je de R-taal zelf verwerkt. Bekijk het volgende voorbeeld om dit beter te begrijpen:
# Retrieve the object type
typeof(quote(x * 10))

# Retrieve the class
class(quote(x * 10))
'language'
'call'
In het bovenstaande voorbeeld vraag je R om het type en de klasse van quote(x*10) terug te geven. Daardoor zie je dat het type van quote(x*10) 'language' is en de class 'call' is.
Dit is zeker geen formule, want je zou de class() 'formula' moeten laten teruggeven!
Maar wat dan wel?
Iets wat formules in R kenmerkt, is de tilde-operator ~. Met deze operator kun je eigenlijk zeggen: "vang de betekenis van deze code, zonder die meteen te evalueren". Dat verklaart ook waarom je een formule in R kunt zien als een "quoting"-operator.
Maar hoe ziet een formule er precies uit? Kijk eens goed naar de volgende coderegel:
# A formula
c <- y ~ x
d <- y ~ x + b

# Double check the class of `c`
class(c)
'formula'
De variabele aan de linkerkant van een tilde (~) wordt de "afhankelijke variabele" genoemd, terwijl de variabelen aan de rechterkant de "onafhankelijke variabelen" worden genoemd en door plustekens + met elkaar worden verbonden.
Het is goed om te weten dat de namen voor deze variabelen veranderen afhankelijk van de context. Je hebt onafhankelijke variabelen misschien al gezien als "predictor (variabele)", "gecontroleerde variabele", "feature", enzovoort. Evenzo kun je afhankelijke variabelen tegenkomen als "responsvariabele", "uitkomstvariabele" of "label".
Let op dat, ook al bevat de formule d die je in het codeblok hierboven definieerde een aantal variabelen, de basisstructuur van een formule eigenlijk alleen het tilde-symbool ~ is en minimaal één onafhankelijke of rechterhandvariabele.
Onthoud dat formules eigenlijk taalobjecten zijn met attributen die de omgeving opslaan:
# Return the type of `d`
typeof(d)

# Retrieve the attributes of `d`
attributes(d)
'language'
$class
[1] "formula"

$.Environment
<environment: R_GlobalEnv>
Zoals je in de bovenstaande voorbeelden zag, kunnen de variabelen die in een formule zijn opgenomen bijvoorbeeld vectors zijn. Vaak zie je echter dat de variabelen die in formules voorkomen, uit een dataframe komen, net als in het volgende voorbeeld:
Sepal.Width ~ Petal.Width + log(Petal.Length) + Species
Let op dat eventuele datapunten die aan de symbolen in de formule zijn toegewezen, niet worden benaderd wanneer de formule zelf wordt gemaakt.
Nu je weet hoe formules eruitzien en wat ze zijn in R, is het goed om te vermelden dat het onderliggende formuleobject varieert, afhankelijk van of je een eenzijdige of tweezijdige formule hebt. Je herkent de eerste door naar de variabele aan de linkerkant te kijken. Als die ontbreekt, zoals in ~ x, heb je een eenzijdige formule.
Dit betekent ook dat een eenzijdige formule een lengte van 2 heeft, terwijl de tweezijdige formule een lengte van 3 heeft.
Niet helemaal overtuigd? Bekijk het volgende codeblok. Je kunt de elementen van een formule benaderen met behulp van de vierkante haken: [[ en ]].
e <- ~ x + y + z
f <- y ~ x + b

# Return the length of `g`
length(e)
length(f)

# Retrieve the elements at index 1 and 2
e[[1]]
e[[2]]
f[[3]]
2
3
`~`


x + y + z


x + bZoals je hebt gezien, zijn formules krachtige hulpmiddelen voor algemeen gebruik waarmee je de waarden van variabelen kunt vastleggen zonder ze te evalueren, zodat de functie ze kan interpreteren. Dat is al een deel van het antwoord op de vraag waarom je formules in R zou gebruiken.
Daarnaast gebruik je deze R-objecten om een relatie tussen variabelen uit te drukken.
Bijvoorbeeld, in de eerste regel code in het onderstaande codeblok zeg je met de eerste regel code "y is een functie van x, a en b"; Natuurlijk kun je ook complexere formules tegenkomen, zoals in de tweede regel code, waar je bedoelt te zeggen "de kelkbladbreedte is een functie van kroonbladbreedte, geconditioneerd op soort".
y ~ x + a + b

Sepal.Width ~ Petal.Width | Species
y ~ x + a + b


Sepal.Width ~ Petal.Width | SpeciesNu je meer weet over het "wat" en het "waarom" van deze speciale R-objecten, is het tijd om te leren hoe je basis- én complexere formules kunt gebruiken! In deze sectie zie je niet alleen hoe je eenvoudige formules maakt en samenvoegt, maar ontdek je ook hoe je complexere formules kunt opbouwen met behulp van operatoren.
Dat weet je al! Je hebt in deze tutorial al wat voorbeelden gezien, maar laten we het nog eens op een rijtje zetten:
y ~ x
~ x + y + z
g <- y ~ x + b
Precies — je kunt de formule gewoon intypen!
Toch kom je waarschijnlijk in een situatie terecht waarin je een formule moet of wilt maken vanuit een R-object, zoals een string. In zulke gevallen kun je de functie formula of as.formula() gebruiken:
"y ~ x1 + x2"

h <- as.formula("y ~ x1 + x2")

h <- formula("y ~ x1 + x2")
Makkelijk!
Om meerdere formules aan elkaar te plakken of samen te brengen, heb je twee opties. Ten eerste kun je aparte variabelen voor elke formule maken en vervolgens list() gebruiken:
# Create variables
i <- y ~ x
j <- y ~ x + x1
k <- y ~ x + x1 + x2

# Concatentate
formulae <- list(as.formula(i),as.formula(j),as.formula(k))

# Double check the class of the list elements
class(formulae[[1]])
'formula'
Als alternatief kun je ook de functie lapply() gebruiken, waarbij je als eerste argument een vector met al je formules doorgeeft en as.formula als de functie die je op elk element van die vector wilt toepassen:
# Join all with `c()`
l <- c(i, j, k)

# Apply `as.formula` to all elements of `f`
lapply(l, as.formula)
[[1]]
y ~ x

[[2]]
y ~ x + x1

[[3]]
y ~ x + x1 + x2
Met deze basis ben je klaar om dieper in te gaan op complexere formules! Hierboven heb je al gezien dat wat formules kenmerkt het tilde-symbool ~ is. Daarnaast heb je gezien dat je ook afhankelijke en onafhankelijke variabelen nodig hebt en dat deze met het plusteken + kunnen worden samengevoegd.
Maar er is meer!
Naast het symbool + zijn er ook andere symbolen die een speciale betekenis aan je formules kunnen toevoegen:
- om termen te verwijderen;: voor interactie;* voor kruisen;%in% voor nesten; en^ om kruisen te beperken tot de opgegeven graad.Je ziet voorbeelden van al deze operatoren in de rest van deze sectie! Laten we eerst beginnen met de operatoren + en -:
# Use multiple independent variables
y ~ x1 + x2

# Ignore objects in an analysis
y ~ x1 - x2
Let op dat je het vaakst de symbolen : en * nodig hebt in een regressiemodelcontext, waarin je interactietermen moet specificeren. Zoals je hierboven hebt gelezen, wordt het eerste symbool gebruikt voor interactie, wat betekent dat je alleen de interactie van de variabelen wilt, en niet de variabelen zelf. Dit staat in contrast met het laatste symbool, dat wordt gebruikt voor kruisen: je gebruikt het om twee variabelen en hun interactie op te nemen.
Wees voorzichtig! Door deze operatoren te gebruiken, kunnen sommige formules er anders uitzien maar toch equivalent zijn. Bekijk de volgende voorbeelden, die dezelfde regressie opleveren:
y ~ x1 * x2

y ~ x1 + x2 + x1:x2
Niet zeker hoe deze twee hetzelfde kunnen zijn? Bekijk de volgende R-codeblokken:
# Set seed
set.seed(123)

# Data
x = rnorm(5)
x2 = rnorm(5)
y = rnorm(5)

# Model frame
model.frame(y ~ x * x2, data = data.frame(x = x, y = y, x2=x2))
| y | x | x2 |
|---|---|---|
| 1.7150650 | -0.56047565 | 1.2240818 |
| 0.4609162 | -0.23017749 | 0.3598138 |
| -1.2650612 | 1.55870831 | 0.4007715 |
| -0.6868529 | 0.07050839 | 0.1106827 |
| -0.4456620 | 0.12928774 | -0.5558411 |
model.frame(y ~ x + x2 + x:x2, data = data.frame(x = x, y = y, x2))
| y | x | x2 |
|---|---|---|
| 1.7150650 | -0.56047565 | 1.2240818 |
| 0.4609162 | -0.23017749 | 0.3598138 |
| -1.2650612 | 1.55870831 | 0.4007715 |
| -0.6868529 | 0.07050839 | 0.1106827 |
| -0.4456620 | 0.12928774 | -0.5558411 |
Maak je geen zorgen als je de functie model.frame() nog niet kent; Later in deze tutorial zie je hier meer over!
Daarnaast volgt hier een voorbeeld van nesten, dat je kunt uitbreiden tot y ~ a + a:b:
y ~ a + b %in% a
Al deze operatoren zijn erg handig, maar wat als je een rekenkundige bewerking wilt uitvoeren? Stel dat je x en x^2 in je model wilt opnemen. In zulke gevallen ben je misschien geneigd om de volgende formule te schrijven: y ~ x + x^2.
Maar is het resultaat precies wat je wilt? Kijk maar!
model.frame( y ~ x + x^2, data = data.frame(x = rnorm(5), y = rnorm(5)))
y ~ x + x^2
| y | x |
|---|---|
| -0.2053091 | 1.18231565 |
| -0.3030972 | 0.04779636 |
| -0.7621604 | 0.86382418 |
| -0.1377784 | -1.18333097 |
| -0.3813125 | -1.25247842 |
Dat is niet het resultaat dat je verwachtte!
In het bovenstaande voorbeeld bescherm je de rekenkundige expressie niet en als gevolg daarvan laat R de term x^2 vallen, omdat die wordt beschouwd als een duplicaat van x.
Waarom is dit?
x geeft je het hoofdeffect van x, en x^2 zou je het hoofdeffect en de tweedegraadsinteractie van x geven. Uiteindelijk neem je x op in het model frame omdat het hoofdeffect van x al is opgenomen via de term x in de formule, en er niets is om x mee te kruisen om de tweedegraadsinteracties in de term x^2 te krijgen.
Om dit te voorkomen, heb je een paar oplossingen:
I()- of "as-is"-operator: y ~ x + I(x^2)Bekijk het volgende voorbeeld om de gevolgen van het toevoegen van de functie I() aan je code te begrijpen:
model.frame( y ~ x + I(x^2), data = data.frame(x = rnorm(5), y = rnorm(5)))
y ~ x + I(x^2)| y | x | I(x^2) |
|---|---|---|
| 1.414090 | -0.1996230 | 0.039849.... |
| 1.777646 | -1.0675904 | 1.139749.... |
| 1.710137 | -1.4071841 | 1.980167.... |
| 1.259111 | -1.3747289 | 1.889879.... |
| -1.490866 | 0.8323668 | 0.692834.... |
Deze laatste coderegel vertelt R eigenlijk om de waarden van x^2 te berekenen voordat de formule wordt gebruikt. Let op ook dat je de "as-is"-operator kunt gebruiken om een variabele voor een model te schalen; Je hoeft alleen de betreffende variabelenaam in I() te zetten:
y ~ I(2 * x)
Dit lijkt allemaal nogal abstract bij de bovenstaande voorbeelden, dus laten we nog een paar andere gevallen behandelen; Neem bijvoorbeeld de polynomiale regressie. In zulke gevallen moet je met de functie I() werken. Voor een factoriële ANOVA die beperkt is tot depth=2-interacties heb je deze functie daarentegen niet nodig, omdat je wilt uitvouwen naar een formule die de hoofdeffecten voor a, b en c bevat, samen met hun tweedegraadsinteracties:
# Polynomial Regression
y ~ x + I(x^2) + I(x^3)

# Factorial ANOVA
y ~ (a*b*c)^2
Tot slot is er nog één andere functie die je handig zult vinden wanneer je met meerdere variabelen werkt, en dat is de operator .. Wanneer je deze operator in een formule gebruikt, verwijs je naar alle andere variabelen in de matrix die nog niet in het model zijn opgenomen. Dit is handig, bijvoorbeeld wanneer je een regressie wilt draaien op een matrix of dataframe en je niet alle variabelen wilt typen:
y ~ .
Als je een formule hebt gemaakt, wil je die misschien ook inspecteren. In deze sectie maak je kennis met enkele tools die je kunt gebruiken om de speciale R-objecten die je hebt gemaakt verder te verkennen!
Let op dat je in de vorige secties al enkele manieren hebt gezien waarop je formules kunt onderzoeken: je zag functies zoals attributes(), typeof(), class(), enz.
terms()-functieOm verschillende formules te onderzoeken en te vergelijken, kun je de functie terms() gebruiken:
m <- formula("y ~ x1 + x2")
terms(m)
y ~ x1 + x2
attr(,"variables")
list(y, x1, x2)
attr(,"factors")
   x1 x2
y   0  0
x1  1  0
x2  0  1
attr(,"term.labels")
[1] "x1" "x2"
attr(,"order")
[1] 1 1
attr(,"intercept")
[1] 1
attr(,"response")
[1] 1
attr(,".Environment")
<environment: R_GlobalEnv>all.varsAls je de namen van de variabelen in het model wilt weten, kun je all.vars gebruiken. Met deze functie geef je een character vector terug die alle namen bevat die in een formule voorkomen:
print(all.vars(m))
[1] "y" "x1" "x2"update()-functieOm formules aan te passen zonder ze naar character om te zetten, kun je de functie update() gebruiken:
update(y ~ x1 + x2, ~. + x3)
y ~ x1 + x2 + x3
Let op dat je de formule ook had kunnen updaten door die met as.character() naar character te converteren; Vervolgens kun je heel snel formules opbouwen met paste(). Als je bijvoorbeeld nog een rechterhandvariabele aan je formule wilt toevoegen, kun je die er eenvoudig aan plakken:
as.formula(paste("y ~ x1 + x2", "x3", sep = "+"))

factors <- c("x2", "x3")
as.formula(paste("y~", paste(factors, collapse="+")))
y ~ x1 + x2 + x3


y ~ x2 + x3
In het bovenstaande codeblok zie je dat je gebruik kunt maken van de argumenten sep of collapse om een tekenreeks aan te geven waarmee je de termen binnen je formule scheidt.
Maar paste() is zeker niet de enige manier om aanpassingen aan je formule te doen: je kunt ook reformulate() gebruiken:
reformulate(termlabels = factors, response = 'y')
y ~ x2 + x3
is.formula()Controleer dubbel of je variabele een formule is door die door te geven aan de functie is.formula(). Houd er rekening mee dat deze functie deel uitmaakt van de plyr-bibliotheek, dus je moet die beschikbaar maken in je workspace voordat je is.formula() aanroept!
# Load `plyr`
library(plyr)

# Check `m`
is.formula(m)
TRUE
Tot nu toe heb je al gelezen dat de R-formules hulpmiddelen voor algemeen gebruik zijn die niet beperkt zijn tot modelleren en je hebt enkele voorbeelden gezien waar je formules kunt gebruiken. In deze sectie ga je dieper in op dit laatste onderwerp: je ziet een aantal gevallen waarin je deze tools in je voordeel kunt gebruiken. Natuurlijk behandel je modelleer- en grafische functies van pakketten zoals lattice en stats, maar je gaat ook in op non-standard evaluation in dplyr.
R is geweldig wanneer je statistisch wilt modelleren. Zoals je al weet, is statistisch modelleren een vereenvoudigde, wiskundig geformaliseerde manier om de werkelijkheid te benaderen en eventueel voorspellingen te doen op basis van die benadering. Een statistisch model stelt het proces dat data genereert vaak in geïdealiseerde vorm voor. Om statistisch te modelleren, heb je modelleringsfuncties nodig.
De modelleringsfuncties in R zijn een typisch voorbeeld waarbij je een formula-object als argument nodig hebt. Andere argumenten die je in deze functies kunt tegenkomen zijn data, waarmee je een dataframe kunt specificeren dat je voor de duur van het model wilt koppelen, subset om de data te selecteren die je wilt gebruiken, ... In het algemeen, als je wilt weten welke argumenten je aan een specifieke functie moet doorgeven, aarzel dan niet om de functie help() of ? in je R-console te gebruiken.
De modelleringsfuncties retourneren een modelobject dat alle informatie over de fit bevat. Generieke R-functies zoals print(), summary(), plot(), anova(), enz. hebben methoden gedefinieerd voor specifieke objectklassen om informatie terug te geven die bij dat soort object past.
Waarschijnlijk een van de bekendste modelleringsfuncties is lm(), die alle hierboven beschreven argumenten gebruikt. Je gebruikt lm() om lineaire modellen te fitten. Je kunt het gebruiken om regressie, enkel strata-analyse van variantie en covariantieanalyse uit te voeren. Laten we een voorbeeld bekijken waarin je lm() gebruikt en het model inspecteert met behulp van print():
lm.m <- lm(Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
        data = iris,
        subset = Sepal.Length > 4.6)

print(lm.m)
Call:
lm(formula = Sepal.Width ~ Petal.Width + log(Petal.Length) +
    Species, data = iris, subset = Sepal.Length > 4.6)

Coefficients:
      (Intercept)        Petal.Width  log(Petal.Length)  Speciesversicolor
           3.1531             0.6620             0.4612            -1.9265
 Speciesvirginica
          -2.3088
lm() gebruikt aanvankelijk de formule en de juiste omgeving om de relaties tussen variabelen te vertalen naar het creëren van een dataframe met de data.
Er zijn ook de model.frame()-methoden, waarvan je in deze tutorial al een voorbeeld zag, die meestal worden gebruikt om het modelframe uit het gefitte object op te halen of te recreëren, zonder andere argumenten. Hiermee kun je kolommen van het dataframe ophalen die overeenkomen met argumenten van de originele aanroep anders dan formula, subset en weights: de glm()-methode behandelt bijvoorbeeld offset, etastart en mustart.
In het volgende codeblok zie je dat je de functie model.frame() gebruikt om een dataframe van het gefitte object terug te krijgen; Let op dat de code iets verschilt van het codeblok dat je hierboven zag: het argument subset is licht aangepast.
stats::model.frame(formula = Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
                   data = iris,
                   subset = Sepal.Length > 6.9,
                   drop.unused.levels = TRUE)
| Sepal.Width | Petal.Width | log(Petal.Length) | Species | |
|---|---|---|---|---|
| 51 | 3.2 | 1.4 | 1.547563 | versicolor |
| 103 | 3.0 | 2.1 | 1.774952 | virginica |
| 106 | 3.0 | 2.1 | 1.887070 | virginica |
| 108 | 2.9 | 1.8 | 1.840550 | virginica |
| 110 | 3.6 | 2.5 | 1.808289 | virginica |
| 118 | 3.8 | 2.2 | 1.902108 | virginica |
| 119 | 2.6 | 2.3 | 1.931521 | virginica |
| 123 | 2.8 | 2.0 | 1.902108 | virginica |
| 126 | 3.2 | 1.8 | 1.791759 | virginica |
| 130 | 3.0 | 1.6 | 1.757858 | virginica |
| 131 | 2.8 | 1.9 | 1.808289 | virginica |
| 132 | 3.8 | 2.0 | 1.856298 | virginica |
| 136 | 3.0 | 2.3 | 1.808289 | virginica |
Tip: er zijn nog meer functies in het pakket stats die je met formules kunt gebruiken, zoals aggregate().
Voor lineaire gemengde-effectenmodellen, waarmee je random effects kunt modelleren om variatie te verklaren die het gevolg is van factoren zoals waarnemersverschillen, kun je het pakket nlme gebruiken met de functie lme(). Ook hier zie je dat formula het eerste argument is dat je aan de modelleringsfunctie moet doorgeven, en er is ook een data-argument!
# Load packages
library(MASS)
library(nlme)

# Get some data
data(oats)

# Adjust the data names and columns
names(oats) = c('block', 'variety', 'nitrogen', 'yield')
oats$mainplot = oats$variety
oats$subplot = oats$nitrogen

# Fit a non-linear mixed-effects model
nlme.m = lme(yield ~ variety*nitrogen,
             random = ~ 1|block/mainplot,
             data = oats)

# Retrieve a summary
summary(nlme.m)
Linear mixed-effects model fit by REML
 Data: oats
       AIC      BIC    logLik
  559.0285 590.4437 -264.5143

Random effects:
 Formula: ~1 | block
        (Intercept)
StdDev:    14.64496

 Formula: ~1 | mainplot %in% block
        (Intercept) Residual
StdDev:    10.29863 13.30727

Fixed effects: yield ~ variety * nitrogen
                                    Value Std.Error DF   t-value p-value
(Intercept)                      80.00000  9.106958 45  8.784492  0.0000
varietyMarvellous                 6.66667  9.715028 10  0.686222  0.5082
varietyVictory                   -8.50000  9.715028 10 -0.874933  0.4021
nitrogen0.2cwt                   18.50000  7.682957 45  2.407927  0.0202
nitrogen0.4cwt                   34.66667  7.682957 45  4.512152  0.0000
nitrogen0.6cwt                   44.83333  7.682957 45  5.835427  0.0000
varietyMarvellous:nitrogen0.2cwt  3.33333 10.865342 45  0.306786  0.7604
varietyVictory:nitrogen0.2cwt    -0.33333 10.865342 45 -0.030679  0.9757
varietyMarvellous:nitrogen0.4cwt -4.16667 10.865342 45 -0.383482  0.7032
varietyVictory:nitrogen0.4cwt     4.66667 10.865342 45  0.429500  0.6696
varietyMarvellous:nitrogen0.6cwt -4.66667 10.865342 45 -0.429500  0.6696
varietyVictory:nitrogen0.6cwt     2.16667 10.865342 45  0.199411  0.8428
 Correlation:
                                 (Intr) vrtyMr vrtyVc ntr0.2 ntr0.4 ntr0.6
varietyMarvellous                -0.533
varietyVictory                   -0.533  0.500
nitrogen0.2cwt                   -0.422  0.395  0.395
nitrogen0.4cwt                   -0.422  0.395  0.395  0.500
nitrogen0.6cwt                   -0.422  0.395  0.395  0.500  0.500
varietyMarvellous:nitrogen0.2cwt  0.298 -0.559 -0.280 -0.707 -0.354 -0.354
varietyVictory:nitrogen0.2cwt     0.298 -0.280 -0.559 -0.707 -0.354 -0.354
varietyMarvellous:nitrogen0.4cwt  0.298 -0.559 -0.280 -0.354 -0.707 -0.354
varietyVictory:nitrogen0.4cwt     0.298 -0.280 -0.559 -0.354 -0.707 -0.354
varietyMarvellous:nitrogen0.6cwt  0.298 -0.559 -0.280 -0-354 -0.354 -0.707
varietyVictory:nitrogen0.6cwt     0.298 -0.280 -0.559 -0.354 -0.354 -0.707
                                 vM:0.2 vV:0.2 vM:0.4 vV:0.4 vM:0.6
varietyMarvellous
varietyVictory
nitrogen0.2cwt
nitrogen0.4cwt
nitrogen0.6cwt
varietyMarvellous:nitrogen0.2cwt
varietyVictory:nitrogen0.2cwt     0.500
varietyMarvellous:nitrogen0.4cwt  0.500  0.250
varietyVictory:nitrogen0.4cwt     0.250  0.500  0.500
varietyMarvellous:nitrogen0.6cwt  0.500  0.250  0.500  0.250
varietyVictory:nitrogen0.6cwt     0.250  0.500  0.250  0.500  0.500

Standardized Within-Group Residuals:
        Min          Q1         Med          Q3         Max
-1.81300898 -0.56144838  0.01758044  0.63864476  1.57034166

Number of Observations: 72
Number of Groups:
              block mainplot %in% block
                  6                  18
Let op dat er naast nlme ook andere pakketten zijn, zoals het pakket lme4, dat ook is gericht op het fitten van lineaire en gegeneraliseerde lineaire gemengde-effectenmodellen.
Een ander voorbeeld van modelleringsfuncties en het gebruik van formules is nls(), dat je zou gebruiken om niet-lineaire modellen te maken:
# Set seed
set.seed(20160227)

# Data
x <- seq(0,50,1)
y <- ((runif(1,10,20)*x)/(runif(1,0,10)+x))+rnorm(51,0,1)

# Non-linear model
nls.m <- nls(y ~ a*x/(b+x),
             start=c(a=4, b=1))
Een laatste voorbeeld zijn functies die je kunt gebruiken om Generalized Linear Models (GLM) te bouwen. In R kun je hiervoor gebruikmaken van de functie glm(). Het wordt wellicht een beetje voorspelbaar, maar ook hier maak je gebruik van de argumenten formula en data:
# Load package
library(MPDiR)

# Get the data
data(Chromatic)

# Model
glm.m <- glm(Thresh ~ Axis:(I(Age^-1) + Age),
             family = Gamma(link = "identity"),
             data = Chromatic)

# Get back a summary
summary(glm.m)
Call:
glm(formula = Thresh ~ Axis:(I(Age^-1) + Age), family = Gamma(link = "identity"),
    data = Chromatic)

Deviance Residuals:
    Min       1Q   Median       3Q      Max
-1.2160  -0.3728  -0.0805   0.2311   1.2932

Coefficients:
                      Estimate Std. Error t value Pr(>|t|)
(Intercept)          3.282e-04  9.965e-05   3.294  0.00106 **
AxisDeutan:I(Age^-1) 7.803e-03  3.686e-04  21.172  < 2e-16 ***
AxisProtan:I(Age^-1) 8.271e-03  3.863e-04  21.410  < 2e-16 ***
AxisTritan:I(Age^-1) 1.166e-02  5.284e-04  22.065  < 2e-16 ***
AxisDeutan:Age       1.521e-05  3.418e-06   4.450 1.06e-05 ***
AxisProtan:Age       1.540e-05  3.434e-06   4.484 9.10e-06 ***
AxisTritan:Age       4.812e-05  5.838e-06   8.241 1.48e-15 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

(Dispersion parameter for Gamma family taken to be 0.2054848)

    Null deviance: 543.35  on 510  degrees of freedom
Residual deviance: 100.40  on 504  degrees of freedom
AIC: -4777.6

Number of Fisher Scoring iterations: 6
Voordat je doorgaat naar de grafische functies, is er nog iets dat goed is om te weten: wanneer je formules gebruikt in modelleringsfuncties zoals lm(), vindt er een standaardconversie plaats van formule naar functies. Om uit te leggen welk type conversie precies plaatsvindt, moet je terugkeren naar het voorbeeld dat je eerder in deze tutorial zag:
lm.m <- lm(Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
           data = iris,
           subset = Sepal.Length > 4.6)
Hoewel het doel van dit codeblok is om een lineair regressiemodel te fitten, wordt de formule gebruikt om het symbolische model te specificeren én om de beoogde designmatrix te genereren. Een designmatrix is de tweedimensionale representatie van de set van predictoren of onafhankelijke variabelen waarbij data-instanties in rijen staan en variabele-attributen in kolommen. De designmatrix staat ook bekend als de X-matrix.
Dat gezegd hebbende, de formulemethode definieert ook de kolommen die in de designmatrix moeten worden opgenomen.
Maar wat betekent dat allemaal precies? Laten we naar de volgende regels code kijken:
# A formula
y ~ x

# A converted formula
y = a_1 + a_2 * x
Dit is een voorbeeld van een eenvoudige conversie: y ~ x wordt vertaald naar y = a_1 + a_2 * x.
Om te zien en te begrijpen wat er in R daadwerkelijk gebeurt, kun je de functie model_matrix() gebruiken. Deze functie maakt een design- of modelmatrix door bijvoorbeeld factoren uit te breiden naar een set dummyvariabelen, afhankelijk van de contrasten, en interacties op een vergelijkbare manier uit te breiden.
Vergeet niet het dataframe df en de formule door te geven om een tibble terug te krijgen die de modelequatie definieert:
# Load packages
library(tidyverse)
library(modelr)

# A data frame
df <- tribble(
  ~y, ~x1, ~x2,
  4, 2, 5,
  5, 1, 6
)

# Model matrix
model_matrix(df, y ~ x1)
| (Intercept) | x1 |
|---|---|
| 1 | 2 |
| 1 | 1 |
Er verschijnt een extra kolom (Intercept). Dit is standaardgedrag aan R-zijde. De manier waarop R de intercept aan het model toevoegt, is simpelweg door een kolom met enen te hebben. Als je dit niet wilt, moet je die expliciet weglaten door -1 aan de formule toe te voegen, zo:
model_matrix(df, y ~ x1-1)
| x1 |
|---|
| 2 |
| 1 |
Let op ook dat de modelmatrix op een niet-verrassende manier groeit wanneer je meer variabelen aan het model toevoegt.
model_matrix(df, y ~ x1 + x2)
| (Intercept) | x1 | x2 |
|---|---|---|
| 1 | 2 | 5 |
| 1 | 1 | 6 |
Een andere belangrijke plek waar je formules in R tegenkomt, zijn de grafische functies. Er zijn heel wat pakketten, dus deze tutorial richt zich alleen op graphics, lattice, ggplot2 en ggformula.
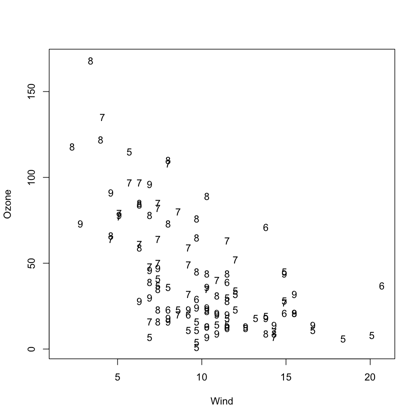
graphicsHet basis-R-pakket graphics laat je een scatterplot specificeren of punten, lijnen of tekst toevoegen met een formule. Bekijk het volgende voorbeeld:
# Get data
data(airquality)

# Plot
plot(Ozone ~ Wind, data = airquality, pch = as.character(Month))
Wil je meer weten, kijk dan zeker op deze pagina.
latticelattice is een pakket dat is gebouwd op grid graphics. Het is een grafisch pakket voor algemeen gebruik dat alternatieve implementaties biedt van veel van de plotfuncties die in base graphics beschikbaar zijn. Specifieke voorbeelden zijn scatterplots met de functie xyplot(), staafdiagrammen met de functie barchart() en boxplots met de functie bwplot().
Tip: wil je meer leren over lattice? Overweeg DataCamp’s cursus Data Visualisatie in R met lattice.
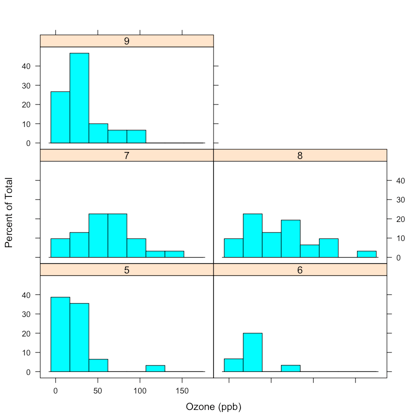
Wat dit pakket zo bijzonder maakt, is dat het de formuliernotatie van statistische modellen gebruikt om de gewenste plot te beschrijven, en meer specifiek de te plotten variabelen. Het voegt ook het pijp- of verticale streepje | toe om de conditionerende variabele te specificeren:
# Load package
library(lattice)

# Plot histogram
histogram(~ Ozone | factor(Month),
          data = airquality,
          layout = c(2, 3),
          xlab = "Ozon (ppb)")
Let op dat, net als de modelleringsfuncties, de functies in de bibliotheek lattice naast een argument formula ook een argument data hebben, precies zoals je zou verwachten!
Onthoud dat je het argument data in het bovenstaande codeblok ook had kunnen weglaten, maar dan had je de data moeten attachen:
# Load package
library(lattice)

# Attach data
attach(airquality)

# Plot
histogram(~ Ozone | factor(Month),
          layout = c(2, 3),
          xlab = "Ozon (ppb)")
ggplot2Je kunt formules gebruiken in verschillende ggplot2-functies:
geom_smooth() of stats_smooth(), om de formule te specificeren die in de smoothing-functie wordt gebruikt; Dit beïnvloedt de vorm van de fit.facet_wrap(), om panelen voor het plotten te specificeren.facet_grid(), om de rijen en kolommen te specificeren die moeten worden geplot, met of zonder facetten.# Load package
library(ggplot2)
# Plot
ggplot(mpg, aes(displ, hwy)) +
geom_point() +
geom_smooth(method = "lm",
formula = y ~ splines::bs(x, 3),
se = FALSE)
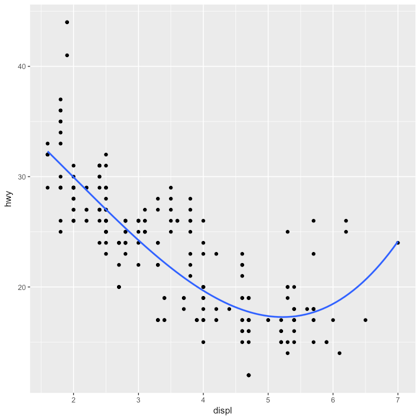
Let op dat de formule om deze plot te maken de letters x en y gebruikt, niet de namen van de variabelen. Dat is niet zo wanneer je facet_wrap() gebruikt:
ggplot(mpg, aes(displ, hwy)) +
  geom_point() +
  geom_smooth(span = 0.8) +
  facet_wrap(~drv)
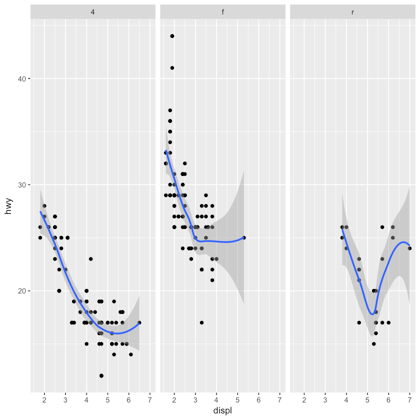
Wil je meer leren over ggplot2? Bekijk deze cursus of raadpleeg de documentatie.
ggformulaHet pakket ggformula bouwt momenteel voort op ggplot2, maar biedt een interface die gebaseerd is op formules. Dit lijkt op wat je in de lattice-interface vindt. Je zult ook zien dat de pipe-operator in dit pakket wordt gebruikt om complexere grafieken te bouwen uit eenvoudigere componenten.
Tip: als je meer wilt weten over de pipe-operator in R, bekijk dan deze tutorial.
De basismanier om met ggformula een plot te maken is
gf_plottype(formula, data = mydata)Let op dat de functie gf_plottype() daadwerkelijk begint met gf, wat je eraan herinnert dat je werkt met functies die formulegebaseerde interfaces naar ggplot2 zijn; De g staat voor ggplot2 en f voor “formula”.
Bekijk het volgende voorbeeld om te zien hoe dit eruitziet in R-code:
# Load package
library(ggformula)

# Plot
gf_point(mpg ~ hp, data = mtcars)
Dit is natuurlijk slechts een basisgrafiek; Je kunt veel meer met dit visualisatiepakket! Je kunt een ander glyph-type en specifieke attributen voor die glyphs kiezen, je kunt grafieken met één of twee variabelen maken, de posities van de glyphs aanpassen, enzovoort. Deze tutorial gaat niet veel dieper in op dit pakket, maar de belangrijkste boodschap hier is dat dit pakket formules tot het hoofdingrediënt voor het maken van grafieken heeft gemaakt!
Wil je meer weten dan wat je in deze tutorial hebt behandeld? Lees dan over het pakket ggformula hier of raadpleeg de RDocumentation-pagina over het pakket.
dplyrdplyr is een voorbeeld van een pakket dat werkt met Non-Standard Evaluation. Andere voorbeelden zijn library(magrittr) versus library("magrittr"), die allebei prima werken, hoewel er in de ene regel aanhalingstekens staan en in de andere niet! Vergelijk deze voorbeelden van library() bijvoorbeeld met install.packages():
# This will work
install.packages("magrittr")

# This won't work
install.packages(magrittr)
In R moet je meestal de aanhalingstekens gebruiken wanneer je een deel van een object benoemt, maar in sommige functies — zoals library() — hoeft dat niet. Deze functies zijn ontworpen om op een niet-standaard manier te werken. Bovendien missen sommige van deze functies zelfs een standaardmanier!
Wat dplyr betreft, zul je merken dat de meeste functies van dit pakket net als andere functies werken: alle functies gebruiken Standard Evaluation (SE). Voor interactief gebruik hebben functies echter ook een Non-Standard Evaluation (NSE), wat je wat typwerk bespaart.
(Laten we eerlijk zijn, al die aanhalingstekens typen kan een hele klus zijn!)
Daarom gebruiken de meeste dplyr-functies non-standard evaluation. Ze volgen niet de gebruikelijke R-regels voor evaluatie. In plaats daarvan leggen ze de expressie vast die je hebt getypt en evalueren die op een aangepaste manier.
Dat betekent echter niet dat deze functies geen variant met standaard-evaluatie hebben. Elke functie die non-standard evaluation gebruikt, heeft (en zou moeten hebben) een escape-hash met standaard-evaluatie die de daadwerkelijke berekening uitvoert. De standaard-evaluatiefunctie zou moeten eindigen met _. Dit betekent dan dat er meerdere werkwoorden in het pakket dplyr zijn: select(), select_(), mutate(), mutate_(), enzovoort.
Wanneer ze interactief worden gebruikt, worden deze functies eerst geëvalueerd met het pakket lazyeval voordat ze naar de versie met standaard-evaluatie van de functie worden gestuurd. Dat betekent dat select() onder de motorkap wordt geëvalueerd met het pakket lazyeval en wordt doorgestuurd naar select_().
Al met al zijn er 3 manieren om variabelen te quoten in functies met standaard-evaluatie die dplyr en lazyeval begrijpen:
quote(), en# Load `dplyr`
library(dplyr)
# NSE evaluation
select(iris, Sepal.Length, Petal.Length)
# standard evaluation
select_(iris, ~Sepal.Length)
select_(iris, ~Sepal.Length, ~Petal.Length) #works
select_(iris, quote(Sepal.Length), quote(Petal.Length)) # yes!
select_(iris, "Sepal.Length", "Petal.Length", "Species")
Tip: als je meer over non-standard evaluation wilt lezen, overweeg dan het hoofdstuk over dit onderwerp in Hadley Wickham’s boek Advanced R te lezen.
Eerder heb je gezien dat je je formules kunt maken en inspecteren met functies zoals as.formula, update(), all.vars, ... Dit waren allemaal eenvoudige bewerkingen en manipulaties, maar hoe zit het met geavanceerde manipulaties met formules? Misschien zijn de volgende pakketten interessant voor je!
Formula-pakketOnlangs is dit pakket op CRAN gepubliceerd. Dit pakket is ideaal voor wie formules naar een hoger niveau wil tillen. Dit pakket breidt de basisklasse formula uit.
Meer specifiek breiden Formula-objecten de basisformuleobjecten uit: met dit pakket kun je formules definiëren die een extra formule-operator | accepteren die meerdere delen scheidt, of die potentieel alle formule-operatoren (inclusief het pijpkarakter) aan de linkerkant kunnen bevatten om meerdere responses te ondersteunen.
Voorbeelden van formules die je kunt maken zijn:
y ~ x1 + x2 | u1 + u2 + u3 | v1 + v2y1 + y2 ~ x1 + x2 + x3y1 | y2 + y3 ~ x, en# Load package
library(Formula)
# Create formulas
f1 <- y ~ x1 + x2 | z1 + z2 + z3
F1 <- Formula(f1)
# Retrieve the class of `F1`
class(F1)
Let op dat de functies as.formula() en is.formula() in dit pakket ook zijn geüpdatet: je gebruikt in plaats daarvan is.Formula() en as.Formula()!
Lees meer hier.
formula.toolsDit pakket is onlangs uitgebracht en biedt je "programmeerhulpmiddelen voor het manipuleren van formules, expressies, aanroepen, toewijzingen en andere R-objecten". Dat is een hele mond vol, maar in essentie komt het hierop neer: je kunt dit pakket gebruiken om toegang te krijgen tot en wijzigingen aan te brengen in formulestructuren, evenals om namen en symbolen van die R-objecten te extraheren en te vervangen. Dit pakket is geschreven door Christopher Brown.
Een paar dingen die je nuttig kunt vinden bij het werken met dit pakket zijn de volgende:
get.vars(): in plaats van all.vars() zal deze functie variabelenamen uit verschillende R-objecten extraheren, maar alle symbolen, enz. worden geïnterpoleerd naar namen van variabelen.invert(): je kunt deze functie gebruiken om de operatoren in een object, zoals een formule, te inverteren.is.one.sided(): deze functie is erg handig om te bepalen of een formule een- of tweezijdig is.Onthoud dat een formule eenzijdig is als die er zo uitziet: ~x; Hij is tweezijdig wanneer geformuleerd als x~y.
Hoera! Je bent door deze tutorial over R-formules heen. Als je er meer over wilt lezen, bekijk dan zeker Hadley Wickham’s boek R for Data Science, waarin een hoofdstuk volledig is gewijd aan formules en modelfamilies in R.
Bekijk DataCamp’s Aan de slag met de Tidyverse: Tutorial.
Kun je nog meer gevallen bedenken waarin je formules tegenkomt of meer pakketten die je kunt gebruiken om formules te manipuleren? Laat het me gerust weten op Twitter: @willems_karlijn.
R-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

