RMSE(均方根误差)是一种在回归分析中常用的准确性评估指标,用于度量回归模型中误差的平均幅度。
与量化可解释方差的 R-squared 不同,RMSE 直接以与响应变量相同的单位衡量预测误差。这使其在目标是最小化误差幅度并以贴近现实的方式解读模型表现时尤为有用。
本文将探讨 RMSE 的含义、计算方法、解读方式以及常见误区。我们还将通过 Python 和 R 的示例,观察 RMSE 在不同建模条件下的表现。
什么是 RMSE?
RMSE 是观测值与预测值之间差异的平方的平均值再开平方。它是一种广泛使用的回归指标,告诉我们平均而言可以预期多大的预测误差。
RMSE 的数学公式为:
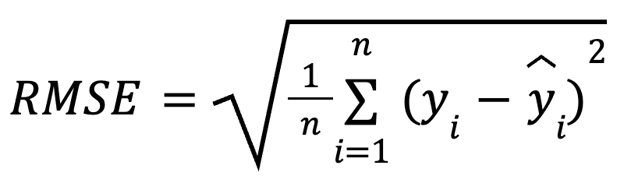
其中:
- yi 是第 i 个观测的真实值,
- ŷ, 是第 i 个观测的预测值,
- n 为观测总数。
在取平均之前对残差平方,RMSE 会对较大的误差施加更重惩罚。这种敏感性使其在不希望出现较大预测错误时是一个很好的选择。RMSE 始终为非负,且数值越小表明模型拟合越好。
计算 RMSE 的三种等价方法
RMSE 的计算很简单:计算残差、平方、求平均、再开平方即可。
我们来看几种不同的计算方式。
基于残差
该方法先用真实值减去预测值得到残差,然后将每个残差平方、对所有平方残差求平均,最后取平方根。
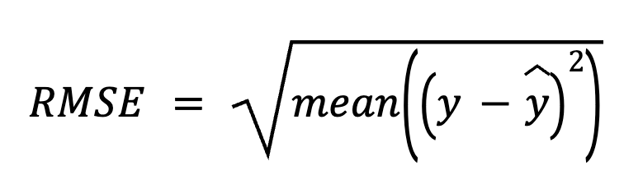
其中:
这种直接方法突出体现了预测误差本身。
基于均方误差(MSE)
这看起来像是重述,但其实更进一步:RMSE 就是 MSE 的平方根。
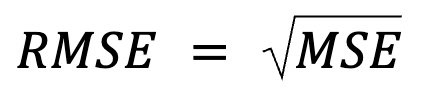
其中:
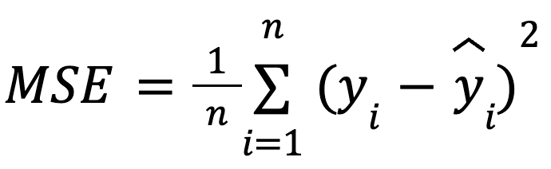
并且:
- yi 为第 i 个观测的真实值,
- ŷ, 为第 i 个观测的预测值,
- n 为观测总数。
这种形式很有用,因为 MSE 是模型优化中的常见损失函数。这一等价关系在机器学习中尤为重要,训练时常通过梯度下降来最小化 MSE。
补充说明:正因为 RMSE 引入了平方根,许多机器学习算法在训练时并不直接最小化 RMSE。MSE 更受青睐,因为其导数更简单(平方根带来非线性)。RMSE 则常在事后用于以可解释的单位报告性能。
矩阵形式
在多元回归中,RMSE 也可通过矩阵代数由残差向量推导:
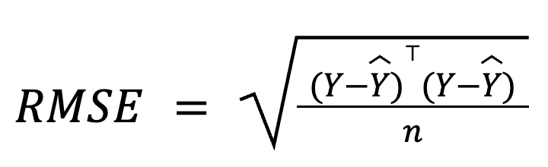
其中:
- Y 为真实值的列向量,
- ŷ 为预测值的列向量,
- n 为观测数。
这种基于矩阵的表述紧凑且计算高效,尤其适用于大型数据集或模型流水线。如需学习相关数学,我们有专门的线性代数课程。
如何解读 RMSE
RMSE 被解读为平均预测误差,用于判定模型的预测准确性。简单说,它展示了预测值平均偏离真实值的程度,且单位与结果变量一致。
较低的 RMSE 表明平均预测误差更小,也即预测更准确,但“可接受”的 RMSE 完全取决于具体语境。例如,在以毫米预测杏仁大小时 RMSE 为 2 可能不错,但在以吨预测年度杏仁产量时就不那么有说服力。
要让 RMSE 有意义,应在相同数据上训练的模型之间进行比较,或与历史表现进行基准对比。
何时使用 RMSE
RMSE 尤其适用于以下情形:
- 当绝对预测准确性至关重要时
- 在同一数据集上比较模型时
- 当模型误差s 呈正态分布
- 当我们的目标是最小化大误差时
- 当需要用自然单位解释误差时
不过,RMSE 也有缺点:
- 对离群值敏感。 少数大的残差会对 RMSE 产生不成比例的影响,从而造成误导。
- 未归一化。 这意味着若不对目标变量进行缩放,就无法在不同数据集和目标尺度之间进行比较。
Python 与 R 的 RMSE 示例
现在我们用 Kaggle 的冰淇淋销量数据集进行演示,分别在 Python 和 R 中构建两个模型,并计算各自的 RMSE:
- 模型 1: 使用相关预测变量(温度)。
- 模型 2: 添加一个随机且无关的预测变量。
Python 示例
我们先从 Python 开始。
import pandas as pd
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error
df = pd.read_csv("Ice Cream.csv")
X = df[['Temperature']]
y = df['Revenue']
model1 = LinearRegression()
model1.fit(X, y)
pred1 = model1.predict(X)
rmse1 = np.sqrt(mean_squared_error(y, pred1))
print(f"Model 1 RMSE: {rmse1:.3f}")
np.random.seed(0)
df['Noise'] = np.random.normal(0, 1, size=len(df))
X2 = df[['Temperature', 'Noise']]
model2 = LinearRegression()
model2.fit(X2, y)
pred2 = model2.predict(X2)
rmse2 = np.sqrt(mean_squared_error(y, pred2))
print(f"Model 2 RMSE: {rmse2:.3f}")技术支持
Model 1 RMSE: 24.915
Model 2 RMSE: 24.911
技术支持
可以看到,模型 2 的 RMSE 与模型 1 非常接近。尽管模型 2 看起来更复杂,但由于仅加入了不提供有效信息的随机噪声,其实际预测准确性可能会变差。
若想提升您在 Python 中的回归技能,请参加以下课程:
R 示例
现在我们来试试 R。
df <- read.csv("Ice Cream.csv")
model1 <- lm(Revenue ~ Temperature, data = df)
pred1 <- predict(model1, df)
rmse1 <- sqrt(mean((df$Revenue - pred1)^2))
cat("Model 1 RMSE:", round(rmse1, 3), "\n")
set.seed(0)
df$Noise <- rnorm(nrow(df), mean = 0, sd = 1)
model2 <- lm(Revenue ~ Temperature + Noise, data = df)
pred2 <- predict(model2, df)
rmse2 <- sqrt(mean((df$Revenue - pred2)^2))
cat("Model 2 RMSE:", round(rmse2, 3), "\n")技术支持
Model 1 RMSE: 24.915
Model 2 RMSE: 24.915技术支持
这里我在 R 中重现了相同示例。加入无关预测变量后,RMSE 完全不变。这说明在加入噪声变量时,RMSE 不一定会变化,尤其当模型给予它们极小权重时。不过,复杂度仍会上升,模型在新数据上的泛化可能变差。
您也许注意到两个示例之间有小差异:在 Python 中,加入无关预测变量后 RMSE 略有下降;而在 R 中,RMSE 保持不变。原因在于两个环境生成的随机噪声并不完全相同(尽管我确保其来自相同分布)。
如果您在编译 R 代码或结果解读方面遇到困难,可以试试我们的课程:
RMSE 与相关指标对比
RMSE 隶属于更广泛的回归误差指标家族。我们简要比较它与其他指标,澄清差异,并指出各自更适用的场景。
RMSE vs. MAE
RMSE 因对残差平方而对大误差惩罚更重,因此对离群值更敏感。相反,MAE(平均绝对误差)对离群值更稳健,对所有误差一视同仁,在不关注离群值时更适合衡量典型误差大小。RMSE 最小化的是平方损失,而 MAE 最小化绝对损失。
一般来说,当大误差代价特别高时使用 RMSE;当希望获得类似中位数视角、对离群值不敏感的误差度量时使用 MAE。
RMSE vs. R-squared
RMSE 以原始单位给出平均误差,因此在实际解读上更直观。相比之下,R-squared 描述模型解释了多少方差,但并不指示预测误差的大小。
二者常配合使用:R-squared 评估相对拟合度,RMSE 衡量绝对表现。
RMSE vs. MSE
RMSE 只是 MSE 的平方根,更易解读,因为其单位与结果变量一致。
除了解读层面,MSE 在机器学习训练的优化中尤为有用。请记住,若直接优化 RMSE,平方根函数会让模型对较大误差赋予更多权重。另外,MSE 的导数光滑,适合与随机梯度下降等基于梯度的算法配合,从而高效收敛。简言之,RMSE 更易解读,因为结果在数据尺度上,但深度学习通常优化的是 MSE 而非 RMSE。
RMSE vs. MAPE
MAPE(平均绝对百分比误差)以百分比返回误差,便于跨数据集比较。然而,当真实值接近零时会失效,变得不稳定。RMSE 避免了这一问题,在存在较小目标值时更可靠。
RMSE vs. 对数似然
还有一个有趣的关系:在高斯误差下,RMSE 与负对数似然在形式上是等价的。或者更准确地说,在误差服从正态分布(方差恒定)的假设下,最小化 RMSE 等价于最大化(回归模型的)对数似然。我并不是说仅靠 RMSE 就能估计完整的对数似然,而是说在正态误差假设下,最小化 RMSE 隐含地最大化对数似然。
然而,当误差具有偏态或存在离群值时,Huber 或分位数损失等替代方案可能表现更好。无论如何,我们应将度量选择视为模型设计决策,而非事后补救。
关于 RMSE 的常见误解
让我们澄清一些关于 RMSE 的常见误区:
- “低 RMSE 保证模型具有良好的泛化能力。” 并非必然。模型在训练数据上的 RMSE 可能很低,但由于过拟合,在新的未见数据上表现仍可能很差。要有效评估泛化能力,需要进行交叉验证或使用独立测试集。
- “RMSE 能判断模型是否过拟合。” 单看 RMSE 做不到。必须在训练集与验证集之间比较:如果训练 RMSE 很低而验证 RMSE 高很多,那就意味着过拟合。
- “评价 RMSE 好坏有统一阈值。” 并没有。RMSE 是否“好”完全取决于语境、领域以及结果变量的单位。换言之,离开语境,RMSE 数值没有意义。
结论
总而言之,RMSE 是一种实用、可解释且直观的预测准确性度量,它以目标变量的单位传达平均预测误差。尤其在关注误差幅度时,它是评估回归表现的首选指标之一。
不过,应将 RMSE 与 R-squared、MAE 以及交叉验证分数等指标结合使用,以更全面地评估模型质量。我们不应盲目依赖该指标,而应始终考虑尺度、语境和模型复杂度。此外,将 RMSE 与可视化诊断结合能帮助发现偏差。
简而言之,RMSE 告诉我们模型平均而言“差”在何处、差多少,且是以真实世界的单位来表达——在构建预测系统时,这是一种非常重要的视角。
如果文中有任何地方让您感到困惑,也不必担心。我们有许多优质资源可供参考:


RMSE(均方根误差)是一种在回归分析中常用的准确性评估指标,用于度量回归模型中误差的平均幅度。
与量化可解释方差的 R-squared 不同,RMSE 直接以与响应变量相同的单位衡量预测误差。这使其在目标是最小化误差幅度并以贴近现实的方式解读模型表现时尤为有用。
本文将探讨 RMSE 的含义、计算方法、解读方式以及常见误区。我们还将通过 Python 和 R 的示例,观察 RMSE 在不同建模条件下的表现。
什么是 RMSE?
RMSE 是观测值与预测值之间差异的平方的平均值再开平方。它是一种广泛使用的回归指标,告诉我们平均而言可以预期多大的预测误差。
RMSE 的数学公式为:
其中:
在取平均之前对残差平方,RMSE 会对较大的误差施加更重惩罚。这种敏感性使其在不希望出现较大预测错误时是一个很好的选择。RMSE 始终为非负,且数值越小表明模型拟合越好。
计算 RMSE 的三种等价方法
RMSE 的计算很简单:计算残差、平方、求平均、再开平方即可。
我们来看几种不同的计算方式。
基于残差
该方法先用真实值减去预测值得到残差,然后将每个残差平方、对所有平方残差求平均,最后取平方根。
其中:
这种直接方法突出体现了预测误差本身。
基于均方误差(MSE)
这看起来像是重述,但其实更进一步:RMSE 就是 MSE 的平方根。
其中:
并且:
这种形式很有用,因为 MSE 是模型优化中的常见损失函数。这一等价关系在机器学习中尤为重要,训练时常通过梯度下降来最小化 MSE。
补充说明:正因为 RMSE 引入了平方根,许多机器学习算法在训练时并不直接最小化 RMSE。MSE 更受青睐,因为其导数更简单(平方根带来非线性)。RMSE 则常在事后用于以可解释的单位报告性能。
矩阵形式
在多元回归中,RMSE 也可通过矩阵代数由残差向量推导:
其中:
这种基于矩阵的表述紧凑且计算高效,尤其适用于大型数据集或模型流水线。如需学习相关数学,我们有专门的线性代数课程。
如何解读 RMSE
RMSE 被解读为平均预测误差,用于判定模型的预测准确性。简单说,它展示了预测值平均偏离真实值的程度,且单位与结果变量一致。
较低的 RMSE 表明平均预测误差更小,也即预测更准确,但“可接受”的 RMSE 完全取决于具体语境。例如,在以毫米预测杏仁大小时 RMSE 为 2 可能不错,但在以吨预测年度杏仁产量时就不那么有说服力。
要让 RMSE 有意义,应在相同数据上训练的模型之间进行比较,或与历史表现进行基准对比。
何时使用 RMSE
RMSE 尤其适用于以下情形:
不过,RMSE 也有缺点:
Python 与 R 的 RMSE 示例
现在我们用 Kaggle 的冰淇淋销量数据集进行演示,分别在 Python 和 R 中构建两个模型,并计算各自的 RMSE:
Python 示例
我们先从 Python 开始。
可以看到,模型 2 的 RMSE 与模型 1 非常接近。尽管模型 2 看起来更复杂,但由于仅加入了不提供有效信息的随机噪声,其实际预测准确性可能会变差。
若想提升您在 Python 中的回归技能,请参加以下课程:
R 示例
现在我们来试试 R。
这里我在 R 中重现了相同示例。加入无关预测变量后,RMSE 完全不变。这说明在加入噪声变量时,RMSE 不一定会变化,尤其当模型给予它们极小权重时。不过,复杂度仍会上升,模型在新数据上的泛化可能变差。
您也许注意到两个示例之间有小差异:在 Python 中,加入无关预测变量后 RMSE 略有下降;而在 R 中,RMSE 保持不变。原因在于两个环境生成的随机噪声并不完全相同(尽管我确保其来自相同分布)。
如果您在编译 R 代码或结果解读方面遇到困难,可以试试我们的课程:
RMSE 与相关指标对比
RMSE 隶属于更广泛的回归误差指标家族。我们简要比较它与其他指标,澄清差异,并指出各自更适用的场景。
RMSE vs. MAE
RMSE 因对残差平方而对大误差惩罚更重,因此对离群值更敏感。相反,MAE(平均绝对误差)对离群值更稳健,对所有误差一视同仁,在不关注离群值时更适合衡量典型误差大小。RMSE 最小化的是平方损失,而 MAE 最小化绝对损失。
一般来说,当大误差代价特别高时使用 RMSE;当希望获得类似中位数视角、对离群值不敏感的误差度量时使用 MAE。
RMSE vs. R-squared
RMSE 以原始单位给出平均误差,因此在实际解读上更直观。相比之下,R-squared 描述模型解释了多少方差,但并不指示预测误差的大小。
二者常配合使用:R-squared 评估相对拟合度,RMSE 衡量绝对表现。
RMSE vs. MSE
RMSE 只是 MSE 的平方根,更易解读,因为其单位与结果变量一致。
除了解读层面,MSE 在机器学习训练的优化中尤为有用。请记住,若直接优化 RMSE,平方根函数会让模型对较大误差赋予更多权重。另外,MSE 的导数光滑,适合与随机梯度下降等基于梯度的算法配合,从而高效收敛。简言之,RMSE 更易解读,因为结果在数据尺度上,但深度学习通常优化的是 MSE 而非 RMSE。
RMSE vs. MAPE
MAPE(平均绝对百分比误差)以百分比返回误差,便于跨数据集比较。然而,当真实值接近零时会失效,变得不稳定。RMSE 避免了这一问题,在存在较小目标值时更可靠。
RMSE vs. 对数似然
还有一个有趣的关系:在高斯误差下,RMSE 与负对数似然在形式上是等价的。或者更准确地说,在误差服从正态分布(方差恒定)的假设下,最小化 RMSE 等价于最大化(回归模型的)对数似然。我并不是说仅靠 RMSE 就能估计完整的对数似然,而是说在正态误差假设下,最小化 RMSE 隐含地最大化对数似然。
然而,当误差具有偏态或存在离群值时,Huber 或分位数损失等替代方案可能表现更好。无论如何,我们应将度量选择视为模型设计决策,而非事后补救。
关于 RMSE 的常见误解
让我们澄清一些关于 RMSE 的常见误区:
结论
总而言之,RMSE 是一种实用、可解释且直观的预测准确性度量,它以目标变量的单位传达平均预测误差。尤其在关注误差幅度时,它是评估回归表现的首选指标之一。
不过,应将 RMSE 与 R-squared、MAE 以及交叉验证分数等指标结合使用,以更全面地评估模型质量。我们不应盲目依赖该指标,而应始终考虑尺度、语境和模型复杂度。此外,将 RMSE 与可视化诊断结合能帮助发现偏差。
简而言之,RMSE 告诉我们模型平均而言“差”在何处、差多少,且是以真实世界的单位来表达——在构建预测系统时,这是一种非常重要的视角。
如果文中有任何地方让您感到困惑,也不必担心。我们有许多优质资源可供参考: