Snowflake Arctic 是文本嵌入领域的一项创新成果,提供了一套强大的工具,旨在简化在企业数据上采用 AI 的过程。
在本教程中,我们将概览 Snowflake Arctic,完成环境搭建,探索集成技巧,并分享最佳实践与故障排查建议。我们还将展示真实用例,讨论未来发展,并提供持续学习与支持的资源。
如果您想进一步了解 Snowflake,请查看这门课程:Introduction to Snowflake 。
什么是 Snowflake Arctic?
那么,Snowflake Arctic 究竟是什么?它是一套完整的工具集,旨在简化在 Snowflake 数据云中集成与部署 AI 的流程。其核心是提供了一系列嵌入模型,帮助我们高效地从数据中提取有价值的洞见。
此外,它还包含一个通用型的大语言模型(LLM),可胜任广泛任务,从生成 SQL 查询与编程代码到遵循复杂指令。
Arctic 的一大亮点在于与 Snowflake 数据云的无缝集成。这种紧密耦合使我们能够在现有数据基础设施内直接发挥 AI 的威力,确保安全且流畅的体验。
重要的是,Snowflake Arctic 家族中的所有模型均采用 Apache 2.0 许可证发布,允许用于学术和商业目的。
架构与性能
Snowflake Arctic 由三大组件构成:
Snowflake Arctic 的组件。
Snowflake Arctic 的架构基于稠密专家混合(MoE)混合型 Transformer 设计,这一关键创新实现了高效扩展与适应性。该方法利用由 128 个专业专家组成、总计 4800 亿参数的庞大网络,每个专家都针对特定任务进行了微调。
不过,并非每次查询都会激活所有专家。Arctic 采用 top-2 门控机制,为每个输入仅选择两个最相关的专家,因此仅激活约 170 亿参数。该优化在显著降低计算开销的同时,仍能在面向企业的一系列任务中保持顶级表现。
关键特性
Snowflake Arctic 之所以脱颖而出,主要得益于以下四个关键特性:
Snowflake Arctic 的四大关键特性。
首先,它非常智能 。Arctic 擅长处理复杂任务,如生成 SQL 查询、编写代码和遵循详细指令。在行业基准测试中,它稳定优于同类模型,展现出处理复杂真实场景的能力。
其次,Arctic 注重高效 。其独特架构在消耗更少计算资源的同时,仍能提供顶级性能。这意味着显著的成本节省,适用于各种规模的组织。
第三,Snowflake Arctic 拥抱开源 。它采用 Apache 2.0 许可证,任何人都可访问其代码与模型权重。
最后,Arctic 专注于企业级 AI 。它为满足企业的特定需求而打造,能在数据分析、流程自动化与决策支持等任务中提供高质量结果。
Snowflake Arctic 模型
为满足多样化的企业级 AI 需求,Snowflake 在 Arctic 家族中提供了两大主力模型:
Snowflake Arctic Instruct: 该变体擅长从自然语言提示中生成高质量回复。Snowflake Arctic Base: 该版本是通用的基础语言模型,可在多种应用中直接使用,无需进一步微调。
Snowflake Arctic 文本嵌入模型
除了主模型外,Snowflake 还在 Apache 2.0 许可证下提供了五款专注信息检索任务的文本嵌入模型。下表展示了多种 Snowflake Arctic 模型在 Massive Text Embedding Benchmark(MTEB)检索任务上的表现,以 NDCG@10 衡量。
不同 Snowflake 模型的 MTEB 检索分数。来源:Hugging Face 。
首先,我们可以看到,模型规模越大,整体性能呈上升趋势。最大的模型 "snowflake-arctic-embed-l" 取得了最高的 NDCG@10 分数 55.98,使用了 3.35 亿参数和 1024 维嵌入。这表明模型规模对于捕捉文本数据中复杂语义关系至关重要。
有趣的是,将嵌入维度从 384 提升到 1024 能提升 "snowflake-arctic-embed-l" 的得分,凸显了嵌入维度对检索精度的影响。但也有例外,即 "snowflake-arctic-embed-xs" 模型。尽管其参数量显著更少(2200 万),在相同的 384 嵌入维度下,它的表现与更大模型相当。这表明在某些场景中,模型效率与架构优化可以弥补单纯参数规模的不足。
Snowflake Arctic:演示
在动手实现技术细节之前,我们先看一下该模型的实际表现,例如 SQL 生成、编码与指令跟随等任务。
通过 Hugging Face 上的 Streamlit 演示 ,我们可以向模型发出请求、调整模型参数并获得回复。
Snowflake Arctic 演示。
我们先让模型生成一条 SQL 查询:
使用 Snowflake Arctic 进行 SQL 生成示例。
为了对比,我们将相同请求提交给 ChatGPT-4o:
使用 ChatGPT-4o 进行 SQL 生成示例。
可以看到,结果相同(且格式更整洁)。我们可以得出结论:Arctic 表现不错。
接着,让我们请求 Arctic 编写一些 Python 代码:
Snowflake Arctic 生成的 Python 代码。
对 ChatGPT-4o 提供相同提示,我们得到如下结果,同样准确:
ChatGPT-4o 生成的 Python 代码。
尽管 Arctic 与 ChatGPT-4o 完成了相同任务,但它们在效率和内存使用方面的方法有所不同。两者都通过 os.listdir() 与 open() 高效读取文件。
不过,ChatGPT-4o 通过字典列表创建 DataFrame 的方法,相比 Arctic 使用列表的列表,可能会稍多占用内存,因为 Pandas 可能需要对字典做额外处理。尽管差异不大,ChatGPT-4o 的模块化代码结构提升了可读性与可维护性。
如果您想进一步了解如何选择合适的 LLM,请查看这篇教程:LLM 分类:如何为您的应用选择最佳 LLM 。
Snowflake Arctic 环境搭建
既然我们已了解 Snowflake Arctic 模型的能力,接下来聚焦于如何访问和配置 Snowflake Arctic。
环境特性
使用 Arctic 模型对资源要求较高,因此我们将使用 Arctic 家族中最小的模型 snowflake-arctic-embed-xs,它占用的计算资源最少。
下方展示了本教程所用环境的特性——我们通过运行 nvidia-smi 命令来查看:
! nvidia- smi技术支持
Snowflake Arctic 教程所用 GPU 的特性。
除了 NVIDIA L4 GPU,环境还有以下特性,可在 Resources 部分查看:
62.8 GB 系统内存
22.5 GB GPU 显存
201.2 GB 磁盘
计算引擎后端特性。
安装依赖库
本实操教程主要需要两个库:torch 与 transformers(以下代码在笔记本中运行):
% % bash
pip - qqq install transformers>= 4.39 .0
pip - qqq install torch技术支持
随后导入所需的子库:
import torch
from transformers import AutoTokenizer, AutoModel
from torch. nn. functional import cosine_similarity技术支持 加载模型与分词器
接下来加载 snowflake-arctic-embed-xs 嵌入模型及其对应分词器:
model_checkpoint = "Snowflake/snowflake-arctic-embed-xs"
tokenizer = AutoTokenizer. from_pretrained ( model_checkpoint)
model = AutoModel. from_pretrained ( model_checkpoint, add_pooling_layer= False) 技术支持 我们根据 model_checkpoint 指定的预训练模型进行加载,并不添加额外的池化层,该层通常用于降低模型输出的维度。
使用 Snowflake Arctic 进行文档相似度搜索
在完成全部准备后,本节的核心用例是:为给定文档找出最相似的前 N 篇文档,并给出对应的余弦相似度分数。步骤如下:
使用嵌入模型为初始原始文档生成嵌入。
对给定查询文档,使用相同嵌入模型生成其嵌入。
计算查询与各文档嵌入之间的相似度。
返回相似度最高的前 N 篇文档及其分数。
使用 Snowflake Arctic 进行文档相似度搜索。
我们可以用以下两个辅助函数实现上述步骤:generate_embedding() 与 find_similar_documents()。
def generate_embedding ( document) :
inputs = tokenizer ( document, padding= True, truncation= True,
return_tensors= 'pt' , max_length= 512 )
embedding = model ( ** inputs) [ 0 ] [ : , 0 ]
return embedding
def find_similar_documents ( query_document, document_embeddings , top_n= 5 ) :
query_embedding = generate_embedding ( query_document)
similarity_scores = [ cosine_similarity ( query_embedding,
doc_embedding) . item ( ) for doc_embedding in document_embeddings]
sorted_indices = torch. argsort ( torch. tensor ( similarity_scores) ,
descending= True)
top_documents = [ documents[ idx] for idx in sorted_indices[ : top_n] ]
top_scores = [ similarity_scores[ idx] for idx in sorted_indices[ : top_n] ]
return top_documents, top_scores技术支持 generate_embedding() 函数接收文档作为输入并生成其嵌入。find_similar_documents() 接收查询文档、已有文档的嵌入,以及希望返回的相似文档数量。
为简化说明,我们使用五个简单示例:
documents = [
"This is a tutorial about Snowflake Arctic Embedding models" ,
"Arctic-embed is a state-of-the-art text embedding model." ,
"Snowflake provides various cloud data warehousing solutions." ,
"Embedding models are used for representing text as dense vectors." ,
"The Arctic-embed model is based on the transformer architecture."
] 技术支持 接下来生成嵌入:
document_embeddings = [ generate_embedding ( doc) for doc in documents] 技术支持 将“What is the Arctic-embed model?” 作为查询文档,查找相似文档:
query_document = "What is the Arctic-embed model?"
top_documents, top_scores = find_similar_documents ( query_document, document_embeddings) 技术支持 最后,我们遍历所有 Top 文档,打印文档内容及其与查询文档的相似度分数。
print ( "Query Document:" )
print ( query_document)
print ( "\nTop Similar Documents:" )
for doc, score in zip ( top_documents, top_scores) :
print ( f"Document: {doc}" )
print ( f"Similarity Score: {score:.4f}" )
print ( ) 技术支持
第二篇文档的余弦相似度最高(94.99%),因此最为相似。
五篇原始文档。
三维文档可视化
当我们在三维空间中可视化这些文档时,可以直观看到彼此更接近的文档。
原始嵌入为 512 维,无法直接可视化。最简单的方法是使用主成分分析(PCA)降维。如果您想了解更多关于 PCA 的内容,请查看本教程:Python 中的主成分分析(PCA) 。
在使用 PCA 之前,我们需要修改 find_similar_documents() 函数,以返回 PCA 将使用的文档嵌入。
def find_similar_documents ( query_document, documents, top_n= 5 ) :
query_embedding = generate_embedding ( query_document)
document_embeddings = [ generate_embedding ( doc) for doc in documents]
similarity_scores = [ cosine_similarity ( query_embedding, doc_embedding) . item ( ) for doc_embedding in document_embeddings]
sorted_indices = torch. argsort ( torch. tensor ( similarity_scores) , descending= True)
top_documents = [ documents[ idx] for idx in sorted_indices[ : top_n] ]
top_scores = [ similarity_scores[ idx] for idx in sorted_indices[ : top_n] ]
return top_documents, top_scores, document_embeddings技术支持 我们还需要导入一些用于生成可视化的模块。
from sklearn. decomposition import PCA
import matplotlib. pyplot as plt
from mpl_toolkits. mplot3d import Axes3D技术支持 现在按以下步骤创建三维可视化:
重塑嵌入以适配 PCA 的输入格式。
将嵌入降至三维。
创建降维后嵌入的三维可视化。
top_documents, top_scores, document_embeddings = find_similar_documents ( query_document, documents)
# Reshape the embeddings
reshaped_embeddings = torch. stack ( document_embeddings) . detach ( ) . numpy ( )
reshaped_embeddings = reshaped_embeddings. reshape ( reshaped_embeddings. shape[ 0 ] , - 1 )
# Apply PCA to reduce the embeddings to 3 dimensions
pca = PCA ( n_components= 3 )
reduced_embeddings = pca. fit_transform ( reshaped_embeddings)
# Create a 3D plot
fig = plt. figure ( figsize= ( 8 , 6 ) )
ax = fig. add_subplot ( 111 , projection= '3d' )
# Plot the document embeddings
for i, doc in enumerate ( documents) :
ax. scatter ( reduced_embeddings[ i, 0 ] , reduced_embeddings[ i, 1 ] , reduced_embeddings[ i, 2 ] , marker= 'o' , label= f"Document {i+1}" )
# Plot the query document embedding
query_embedding = generate_embedding ( query_document)
reshaped_query_embedding = query_embedding. detach ( ) . numpy ( ) . reshape ( 1 , - 1 )
reduced_query_embedding = pca. transform ( reshaped_query_embedding)
ax. scatter ( reduced_query_embedding[ 0 , 0 ] , reduced_query_embedding[ 0 , 1 ] ,
reduced_query_embedding[ 0 , 2 ] , marker= '*' , s= 100 , color= 'red' ,
label= "Query Document" )
ax. set_xlabel ( 'PC1' )
ax. set_ylabel ( 'PC2' )
ax. set_zlabel ( 'PC3' )
ax. legend ( )
plt. title ( 'Document Embeddings in 3D Space' )
plt. show ( ) 技术支持
使用 PCA 可视化文档相似度。
第二篇文档(橙色)与查询文档(红色星标)最近。第五篇文档(紫色)次之,而第三篇文档(绿色)最远。
将 Snowflake Arctic 集成到 Streamlit
笔记本是进行试验与快速可视化的强大工具,深受数据科学家和研究人员欢迎。然而,在生产环境中部署模型或应用时,笔记本可能不是最佳选择。此时就轮到 Streamlit 发挥作用。
Streamlit 是一个 Python 库,用于为数据科学与机器学习项目构建交互式 Web 应用。它让您无需深厚的前端开发经验,也能轻松将数据科学项目转化为可投入生产的应用。
下面是本节将要构建应用的落地页。
Streamlit 应用的落地页。
教授 Streamlit 不在本教程范围内,但您可以通过这篇教程从零开始学习:Python 教程:Streamlit 。
基础集成技巧
本节我们将探索如何使用 Streamlit 为我们的文档相似度搜索项目创建 Web 应用。要运行 Streamlit 应用,需将代码写入一个 Python 文件(扩展名为 .py ),并在终端执行以下命令:
不过,使用 Streamlit 的第一步,是通过 pip 安装它:
pip install streamlit技术支持
用于构建该 Streamlit 应用的代码略长,请耐心阅读。我们也会在代码块之后进行讲解。
import streamlit as st
from transformers import AutoTokenizer, AutoModel
import torch
from torch. nn. functional import cosine_similarity
from sklearn. decomposition import PCA
import matplotlib. pyplot as plt
from mpl_toolkits. mplot3d import Axes3D
model_checkpoint = "Snowflake/snowflake-arctic-embed-xs"
tokenizer = AutoTokenizer. from_pretrained ( model_checkpoint)
model = AutoModel. from_pretrained ( model_checkpoint, add_pooling_layer= False)
def generate_embedding ( document) :
inputs = tokenizer ( document, padding= True, truncation= True, return_tensors= 'pt' , max_length= 512 )
embedding = model ( ** inputs) [ 0 ] [ : , 0 ]
return embedding
def find_similar_documents ( query_document, documents, top_n= 5 ) :
query_embedding = generate_embedding ( query_document)
document_embeddings = [ generate_embedding ( doc) for doc in documents]
similarity_scores = [ cosine_similarity ( query_embedding, doc_embedding) . item ( ) for doc_embedding in document_embeddings]
sorted_indices = torch. argsort ( torch. tensor ( similarity_scores) , descending= True)
top_documents = [ documents[ idx] for idx in sorted_indices[ : top_n] ]
top_scores = [ similarity_scores[ idx] for idx in sorted_indices[ : top_n] ]
return top_documents, top_scores, document_embeddings
# Sample documents
documents = [
"This is a tutorial about Snowflake Arctic Embedding models" ,
"Arctic-embed is a state-of-the-art text embedding model." ,
"Snowflake provides various cloud data warehousing solutions." ,
"Embedding models are used for representing text as dense vectors." ,
"The Arctic-embed model is based on the transformer architecture."
]
# Streamlit app
st. title ( "Document Similarity Search With Snowflake Arctic" )
query_document = st. text_input ( "Enter your query document:" )
top_k = st. number_input ( "Enter the number of top documents to retrieve (K):" , min_value= 1 , value= 3 , step= 1 )
if st. button ( "Search" ) :
top_documents, top_scores, document_embeddings = find_similar_documents ( query_document, documents, top_n= top_k)
st. subheader ( "Top {} Similar Documents:" . format ( top_k) )
for i, ( doc, score) in enumerate ( zip ( top_documents, top_scores) ) :
st. write ( "{}. Document: {}" . format ( i+ 1 , doc) )
st. write ( " Similarity Score: {:.4f}" . format ( score) )
# Reshape the embeddings
reshaped_embeddings = torch. stack ( document_embeddings) . detach ( ) . numpy ( )
reshaped_embeddings = reshaped_embeddings. reshape ( reshaped_embeddings. shape[ 0 ] , - 1 )
# Apply PCA to reduce the embeddings to 3 dimensions
pca = PCA ( n_components= 3 )
reduced_embeddings = pca. fit_transform ( reshaped_embeddings)
# Create a 3D plot
fig = plt. figure ( figsize= ( 8 , 6 ) )
ax = fig. add_subplot ( 111 , projection= '3d' )
# Plot the document embeddings
for i, doc in enumerate ( documents) :
ax. scatter ( reduced_embeddings[ i, 0 ] , reduced_embeddings[ i, 1 ] , reduced_embeddings[ i, 2 ] , marker= 'o' , label= f"Document {i+1}" )
# Plot the query document embedding
query_embedding = generate_embedding ( query_document)
reshaped_query_embedding = query_embedding. detach ( ) . numpy ( ) . reshape ( 1 , - 1 )
reduced_query_embedding = pca. transform ( reshaped_query_embedding)
ax. scatter ( reduced_query_embedding[ 0 , 0 ] , reduced_query_embedding[ 0 , 1 ] , reduced_query_embedding[ 0 , 2 ] , marker= '*' , s= 100 , color= 'red' , label= "Query Document" )
ax. set_xlabel ( 'PC1' )
ax. set_ylabel ( 'PC2' )
ax. set_zlabel ( 'PC3' )
ax. legend ( )
plt. title ( 'Document Embeddings in 3D Space' )
st. pyplot ( fig) 技术支持 使用上述代码,我们创建了一个名为“Document Similarity Search With Snowflake Arctic”的 Streamlit 应用。关于该代码,有以下几点说明:
应用允许用户使用 st.text_input() 输入查询文档,并通过 st.number_input() 指定需要返回的 Top 文档数量(K)。
当用户点击 Search 按钮(st.button("Search"))时,将以查询文档、文档列表及指定的 top_k 值调用 find_similar_documents() 函数。
应用通过 st.subheader() 与 st.write() 展示 Top K 相似文档及其相似度分数。
为便于可视化,对文档嵌入进行重塑并使用 PCA 降至三维。
使用 Matplotlib 创建三维图,以展示文档嵌入与查询文档嵌入。
通过 st.pyplot(fig) 在 Streamlit 应用中展示三维图。
该 Streamlit 部分的代码重点在于创建交互式用户界面,让用户可以输入查询文档,指定返回的相似文档数量,并查看结果及文档嵌入的三维可视化。
本文完整代码可在此 Jupyter Notebook 中获取。
我们可通过命令 streamlit run app.py 启动应用并进入落地页。提供相同查询文档并将 Top K 设为 3,可得到如下结果:
在 Streamlit 中集成 Snowflake Arctic。
高级配置建议
在使用如 Arctic 这样的大语言模型时,务必在目标环境中充分测试与验证配置,以确保最优性能与可靠性。下面是一些配置建议:
量化: 降低权重精度以缩小模型体积并加速推理。撰稿时量化后的检查点尚不可用,未来将同时支持 Hugging Face 推理与 vLLM 。硬件加速: 利用 GPU,并采用混合精度训练与推理。蒸馏: 让更小的“学生”模型模仿更大的“教师”模型。缓存与预处理: 缓存常用嵌入并离线预处理数据。监控与日志: 跟踪性能、资源使用与错误,便于优化。扩展与负载均衡: 部署多实例并均衡分发请求。安全与访问控制: 实施认证、授权与安全通信。持续优化: 持续监测、分析并尝试新技术。
最佳实践与故障排查
为确保 Snowflake Arctic 的最佳性能与稳定运行,遵循最佳实践并为潜在问题做好排查准备至关重要。本节将基于真实基准与学术研究,分享用于增强性能的技巧与方法。
来源:Arctic Cloud 。
以下是一些增强能力的建议:
使用向量化执行引擎以加速数学计算(GSMBK)。
缓存常用学术数据集与预计算结果。
通过批量技术与本地中转优化数据加载。
尽量贴近存储进行计算,减少数据搬移。
对计算密集型任务(GSM8K、MMLU)利用并行处理。
在学术基准上监测性能并解决瓶颈。
与学术界合作并吸收最新研究成果。
持续测试与基准评测,定位改进空间。
推理性能
Snowflake Arctic 在推理与训练场景中都表现突出。在推理时,它相较其他模型始终能提供更优的性能/成本比。随着激活参数的增加,这种效率优势仍在延续,即便在约 600 亿激活参数的水平上,依旧显著优于 Mixtral 与 Llama 3 等竞争对手。
Arctic 推理效率。来源:Snowflake.com 。
训练性能
在训练方面,这一趋势同样延续:Arctic 再次展现了最佳的性能/成本比。随着算力规模提升,其效率进一步扩大,在 16 倍算力时可达约 70%,远超 DBRX、Llama 3、Code Llama 与 Yi 等模型。这些结果凸显了 Arctic 的价值主张:以更低的计算成本实现高质量性能,对注重资源的企业而言极具吸引力。
Arctic 训练效率。来源:Snowflake.com 。
用于优化推理与训练性能的一些技巧包括但不限于:
利用 Snowflake 的可扩展架构,在大规模数据集上训练 Snowflake Arctic。
使用 Snowflake 的分布式计算并行训练工作负载,缩短时间。
使用 Snowflake 的数据缓存存储常用数据与中间结果,加速训练。
通过批量加载与本地中转优化数据加载,以保持性能并降低成本。
结合 Snowflake 工具与自定义方案监测训练进度与性能指标。
进行超参数调优,以平衡模型性能与训练成本。
使用 Snowflake 具成本优势的计算资源以扩展推理工作负载。
利用 Snowflake 的数据仓库能力实现高效推理流水线。
持续监测与分析推理性能指标,挖掘优化机会。
Snowflake Arctic 的未来
Snowflake Arctic 在性能与成本效率上的出色表现,为语言模型树立了新标杆。未来的发展方向可能包括更先进的自然语言理解、更优的多任务学习,以及对特定领域应用的更佳支持。随着 Snowflake 的持续创新,用户将获得更强大且更通用的工具。
Snowflake 提供了优秀的社区与完善的支持资源。用户可以在 Snowflake 社区论坛中交流、分享与互学。官方网站 上也提供了详尽的文档与教程,帮助用户更好地理解并用好 Snowflake Arctic 的各项功能。
结语
Snowflake Arctic 在文本嵌入领域具有颠覆性,能为企业释放数据潜能提供强大而高效的解决方案。其与 Snowflake 数据云的无缝集成及可扩展架构,使其成为希望精简数据检索与分析流程的组织的理想选择。
在本指南中,我们系统性地介绍了 Snowflake Arctic 的核心能力,涵盖从搭建与配置到高级集成技巧与实用应用。通过利用其先进特性与性能优化,企业可在文本嵌入任务中实现更高的效率与准确性。
如果您想进一步了解 Snowflake,请查看这篇教程:Snowflake 入门教程 。


Snowflake Arctic 是文本嵌入领域的一项创新成果,提供了一套强大的工具,旨在简化在企业数据上采用 AI 的过程。
在本教程中,我们将概览 Snowflake Arctic,完成环境搭建,探索集成技巧,并分享最佳实践与故障排查建议。我们还将展示真实用例,讨论未来发展,并提供持续学习与支持的资源。
如果您想进一步了解 Snowflake,请查看这门课程:Introduction to Snowflake。
什么是 Snowflake Arctic?
那么,Snowflake Arctic 究竟是什么?它是一套完整的工具集,旨在简化在 Snowflake 数据云中集成与部署 AI 的流程。其核心是提供了一系列嵌入模型,帮助我们高效地从数据中提取有价值的洞见。
此外,它还包含一个通用型的大语言模型(LLM),可胜任广泛任务,从生成 SQL 查询与编程代码到遵循复杂指令。
Arctic 的一大亮点在于与 Snowflake 数据云的无缝集成。这种紧密耦合使我们能够在现有数据基础设施内直接发挥 AI 的威力,确保安全且流畅的体验。
重要的是,Snowflake Arctic 家族中的所有模型均采用 Apache 2.0 许可证发布,允许用于学术和商业目的。
架构与性能
Snowflake Arctic 由三大组件构成:
Snowflake Arctic 的组件。
Snowflake Arctic 的架构基于稠密专家混合(MoE)混合型 Transformer 设计,这一关键创新实现了高效扩展与适应性。该方法利用由 128 个专业专家组成、总计 4800 亿参数的庞大网络,每个专家都针对特定任务进行了微调。
不过,并非每次查询都会激活所有专家。Arctic 采用 top-2 门控机制,为每个输入仅选择两个最相关的专家,因此仅激活约 170 亿参数。该优化在显著降低计算开销的同时,仍能在面向企业的一系列任务中保持顶级表现。
关键特性
Snowflake Arctic 之所以脱颖而出,主要得益于以下四个关键特性:
Snowflake Arctic 的四大关键特性。
首先,它非常智能。Arctic 擅长处理复杂任务,如生成 SQL 查询、编写代码和遵循详细指令。在行业基准测试中,它稳定优于同类模型,展现出处理复杂真实场景的能力。
其次,Arctic 注重高效。其独特架构在消耗更少计算资源的同时,仍能提供顶级性能。这意味着显著的成本节省,适用于各种规模的组织。
第三,Snowflake Arctic 拥抱开源。它采用 Apache 2.0 许可证,任何人都可访问其代码与模型权重。
最后,Arctic 专注于企业级 AI。它为满足企业的特定需求而打造,能在数据分析、流程自动化与决策支持等任务中提供高质量结果。
Snowflake Arctic 模型
为满足多样化的企业级 AI 需求,Snowflake 在 Arctic 家族中提供了两大主力模型:
Snowflake Arctic 文本嵌入模型
除了主模型外,Snowflake 还在 Apache 2.0 许可证下提供了五款专注信息检索任务的文本嵌入模型。下表展示了多种 Snowflake Arctic 模型在 Massive Text Embedding Benchmark(MTEB)检索任务上的表现,以 NDCG@10 衡量。
不同 Snowflake 模型的 MTEB 检索分数。来源:Hugging Face。
首先,我们可以看到,模型规模越大,整体性能呈上升趋势。最大的模型 "snowflake-arctic-embed-l" 取得了最高的 NDCG@10 分数 55.98,使用了 3.35 亿参数和 1024 维嵌入。这表明模型规模对于捕捉文本数据中复杂语义关系至关重要。
有趣的是,将嵌入维度从 384 提升到 1024 能提升 "snowflake-arctic-embed-l" 的得分,凸显了嵌入维度对检索精度的影响。但也有例外,即 "snowflake-arctic-embed-xs" 模型。尽管其参数量显著更少(2200 万),在相同的 384 嵌入维度下,它的表现与更大模型相当。这表明在某些场景中,模型效率与架构优化可以弥补单纯参数规模的不足。
Snowflake Arctic:演示
在动手实现技术细节之前,我们先看一下该模型的实际表现,例如 SQL 生成、编码与指令跟随等任务。
通过 Hugging Face 上的 Streamlit 演示,我们可以向模型发出请求、调整模型参数并获得回复。
Snowflake Arctic 演示。
我们先让模型生成一条 SQL 查询:
使用 Snowflake Arctic 进行 SQL 生成示例。
为了对比,我们将相同请求提交给 ChatGPT-4o: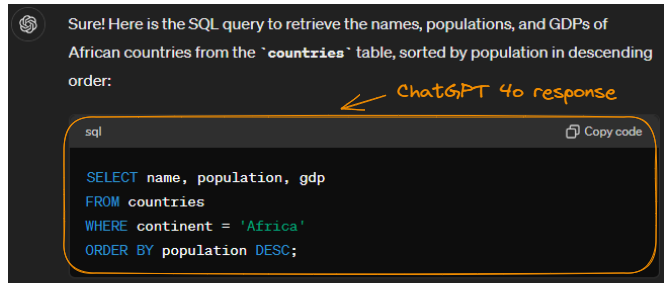
使用 ChatGPT-4o 进行 SQL 生成示例。
可以看到,结果相同(且格式更整洁)。我们可以得出结论:Arctic 表现不错。
接着,让我们请求 Arctic 编写一些 Python 代码:
Snowflake Arctic 生成的 Python 代码。
对 ChatGPT-4o 提供相同提示,我们得到如下结果,同样准确:
ChatGPT-4o 生成的 Python 代码。
尽管 Arctic 与 ChatGPT-4o 完成了相同任务,但它们在效率和内存使用方面的方法有所不同。两者都通过
os.listdir()与open()高效读取文件。不过,ChatGPT-4o 通过字典列表创建 DataFrame 的方法,相比 Arctic 使用列表的列表,可能会稍多占用内存,因为 Pandas 可能需要对字典做额外处理。尽管差异不大,ChatGPT-4o 的模块化代码结构提升了可读性与可维护性。
如果您想进一步了解如何选择合适的 LLM,请查看这篇教程:LLM 分类:如何为您的应用选择最佳 LLM。
Snowflake Arctic 环境搭建
既然我们已了解 Snowflake Arctic 模型的能力,接下来聚焦于如何访问和配置 Snowflake Arctic。
环境特性
使用 Arctic 模型对资源要求较高,因此我们将使用 Arctic 家族中最小的模型 snowflake-arctic-embed-xs,它占用的计算资源最少。
下方展示了本教程所用环境的特性——我们通过运行
nvidia-smi命令来查看:Snowflake Arctic 教程所用 GPU 的特性。
除了 NVIDIA L4 GPU,环境还有以下特性,可在 Resources 部分查看:
计算引擎后端特性。
安装依赖库
本实操教程主要需要两个库:
torch与transformers(以下代码在笔记本中运行):随后导入所需的子库:
加载模型与分词器
接下来加载 snowflake-arctic-embed-xs 嵌入模型及其对应分词器:
我们根据
model_checkpoint指定的预训练模型进行加载,并不添加额外的池化层,该层通常用于降低模型输出的维度。使用 Snowflake Arctic 进行文档相似度搜索
在完成全部准备后,本节的核心用例是:为给定文档找出最相似的前 N 篇文档,并给出对应的余弦相似度分数。步骤如下:
使用 Snowflake Arctic 进行文档相似度搜索。
我们可以用以下两个辅助函数实现上述步骤:
generate_embedding()与find_similar_documents()。generate_embedding()函数接收文档作为输入并生成其嵌入。find_similar_documents()接收查询文档、已有文档的嵌入,以及希望返回的相似文档数量。为简化说明,我们使用五个简单示例:
接下来生成嵌入:
将“What is the Arctic-embed model?” 作为查询文档,查找相似文档:
最后,我们遍历所有 Top 文档,打印文档内容及其与查询文档的相似度分数。
第二篇文档的余弦相似度最高(94.99%),因此最为相似。
五篇原始文档。
三维文档可视化
当我们在三维空间中可视化这些文档时,可以直观看到彼此更接近的文档。
原始嵌入为 512 维,无法直接可视化。最简单的方法是使用主成分分析(PCA)降维。如果您想了解更多关于 PCA 的内容,请查看本教程:Python 中的主成分分析(PCA)。
在使用 PCA 之前,我们需要修改
find_similar_documents()函数,以返回 PCA 将使用的文档嵌入。我们还需要导入一些用于生成可视化的模块。
现在按以下步骤创建三维可视化:
使用 PCA 可视化文档相似度。
第二篇文档(橙色)与查询文档(红色星标)最近。第五篇文档(紫色)次之,而第三篇文档(绿色)最远。
将 Snowflake Arctic 集成到 Streamlit
笔记本是进行试验与快速可视化的强大工具,深受数据科学家和研究人员欢迎。然而,在生产环境中部署模型或应用时,笔记本可能不是最佳选择。此时就轮到 Streamlit 发挥作用。
Streamlit 是一个 Python 库,用于为数据科学与机器学习项目构建交互式 Web 应用。它让您无需深厚的前端开发经验,也能轻松将数据科学项目转化为可投入生产的应用。
下面是本节将要构建应用的落地页。
Streamlit 应用的落地页。
教授 Streamlit 不在本教程范围内,但您可以通过这篇教程从零开始学习:Python 教程:Streamlit。
基础集成技巧
本节我们将探索如何使用 Streamlit 为我们的文档相似度搜索项目创建 Web 应用。要运行 Streamlit 应用,需将代码写入一个 Python 文件(扩展名为 .py),并在终端执行以下命令:
不过,使用 Streamlit 的第一步,是通过
pip安装它:用于构建该 Streamlit 应用的代码略长,请耐心阅读。我们也会在代码块之后进行讲解。
使用上述代码,我们创建了一个名为“Document Similarity Search With Snowflake Arctic”的 Streamlit 应用。关于该代码,有以下几点说明:
st.text_input()输入查询文档,并通过st.number_input()指定需要返回的 Top 文档数量(K)。st.button("Search"))时,将以查询文档、文档列表及指定的top_k值调用find_similar_documents()函数。st.subheader()与st.write()展示 Top K 相似文档及其相似度分数。st.pyplot(fig)在 Streamlit 应用中展示三维图。该 Streamlit 部分的代码重点在于创建交互式用户界面,让用户可以输入查询文档,指定返回的相似文档数量,并查看结果及文档嵌入的三维可视化。
本文完整代码可在此 Jupyter Notebook 中获取。
我们可通过命令
streamlit run app.py启动应用并进入落地页。提供相同查询文档并将 Top K 设为 3,可得到如下结果:在 Streamlit 中集成 Snowflake Arctic。
高级配置建议
在使用如 Arctic 这样的大语言模型时,务必在目标环境中充分测试与验证配置,以确保最优性能与可靠性。下面是一些配置建议:
最佳实践与故障排查
为确保 Snowflake Arctic 的最佳性能与稳定运行,遵循最佳实践并为潜在问题做好排查准备至关重要。本节将基于真实基准与学术研究,分享用于增强性能的技巧与方法。
来源:Arctic Cloud。
以下是一些增强能力的建议:
推理性能
Snowflake Arctic 在推理与训练场景中都表现突出。在推理时,它相较其他模型始终能提供更优的性能/成本比。随着激活参数的增加,这种效率优势仍在延续,即便在约 600 亿激活参数的水平上,依旧显著优于 Mixtral 与 Llama 3 等竞争对手。
Arctic 推理效率。来源:Snowflake.com。
训练性能
在训练方面,这一趋势同样延续:Arctic 再次展现了最佳的性能/成本比。随着算力规模提升,其效率进一步扩大,在 16 倍算力时可达约 70%,远超 DBRX、Llama 3、Code Llama 与 Yi 等模型。这些结果凸显了 Arctic 的价值主张:以更低的计算成本实现高质量性能,对注重资源的企业而言极具吸引力。
Arctic 训练效率。来源:Snowflake.com。
用于优化推理与训练性能的一些技巧包括但不限于:
Snowflake Arctic 的未来
Snowflake Arctic 在性能与成本效率上的出色表现,为语言模型树立了新标杆。未来的发展方向可能包括更先进的自然语言理解、更优的多任务学习,以及对特定领域应用的更佳支持。随着 Snowflake 的持续创新,用户将获得更强大且更通用的工具。
Snowflake 提供了优秀的社区与完善的支持资源。用户可以在 Snowflake 社区论坛中交流、分享与互学。官方网站上也提供了详尽的文档与教程,帮助用户更好地理解并用好 Snowflake Arctic 的各项功能。
结语
Snowflake Arctic 在文本嵌入领域具有颠覆性,能为企业释放数据潜能提供强大而高效的解决方案。其与 Snowflake 数据云的无缝集成及可扩展架构,使其成为希望精简数据检索与分析流程的组织的理想选择。
在本指南中,我们系统性地介绍了 Snowflake Arctic 的核心能力,涵盖从搭建与配置到高级集成技巧与实用应用。通过利用其先进特性与性能优化,企业可在文本嵌入任务中实现更高的效率与准确性。
如果您想进一步了解 Snowflake,请查看这篇教程:Snowflake 入门教程。