
कोर्स
Large Language Models (LLMs) कॉन्सेप्ट्स
2 घंटा
111.9K
Snowflake Arctic टेक्स्ट एम्बेडिंग्स के क्षेत्र में एक अभिनव विकास है, जो एंटरप्राइज डेटा पर AI अपनाने की प्रक्रिया को सरल बनाने के लिए तैयार शक्तिशाली टूल्स का सेट प्रदान करता है।
इस ट्यूटोरियल में, हम Snowflake Arctic का एक ओवरव्यू देंगे, सेटअप प्रक्रिया से गुजरेंगे, इंटीग्रेशन तकनीकों का अन्वेषण करेंगे, और सर्वोत्तम प्रथाएँ तथा ट्रबलशूटिंग टिप्स साझा करेंगे। हम वास्तविक दुनिया के उपयोग मामलों को भी दिखाएँगे, भविष्य के विकास पर चर्चा करेंगे, और सतत समर्थन व सीखने के लिए संसाधन प्रदान करेंगे।
यदि आप Snowflake के बारे में और सीखना चाहते हैं, तो यह Introduction to Snowflake कोर्स देखें।
तो, Snowflake Arctic वास्तव में क्या है? यह टूल्स का एक व्यापक सूट है, जिसे Snowflake Data Cloud के भीतर AI के इंटीग्रेशन और परिनियोजन को सरल बनाने के लिए डिज़ाइन किया गया है। अपने मूल में, Snowflake Arctic एम्बेडिंग मॉडलों का एक संग्रह प्रदान करता है, जो हमें अपने डेटा से मूल्यवान अंतर्दृष्टि कुशलतापूर्वक निकालने में सक्षम बनाता है।
इसके अतिरिक्त, इसमें एक बहु-उद्देश्यीय Large Language Model (LLM) शामिल है, जो SQL क्वेरी और प्रोग्रामिंग कोड जनरेट करने से लेकर जटिल निर्देशों का पालन करने तक, व्यापक कार्यों को संभालने में सक्षम है।
Arctic की एक प्रमुख विशेषता इसका Snowflake Data Cloud के साथ निर्बाध इंटीग्रेशन है। यह घनिष्ठ एकीकरण हमें अपने मौजूदा डेटा इंफ्रास्ट्रक्चर के भीतर सीधे AI की शक्ति का लाभ उठाने देता है, जिससे सुरक्षित और सुगम अनुभव सुनिश्चित होता है।
महत्वपूर्ण बात यह है कि Snowflake Arctic परिवार के सभी मॉडल Apache 2.0 लाइसेंस के अंतर्गत उपलब्ध हैं, जिससे हम उन्हें शैक्षणिक और वाणिज्यिक दोनों उद्देश्यों के लिए उपयोग कर सकते हैं।
Snowflake Arctic के तीन मुख्य घटक हैं:
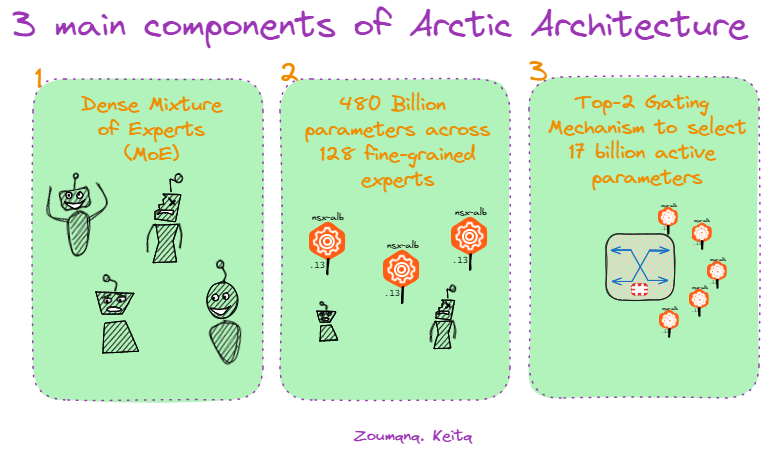
Snowflake Arctic के घटक।
Snowflake Arctic की आर्किटेक्चर Dense Mixture of Experts (MoE) हाइब्रिड ट्रांसफॉर्मर डिज़ाइन पर आधारित है—एक प्रमुख नवाचार जो कुशल स्केलिंग और अनुकूलता सक्षम करता है। यह दृष्टिकोण 128 विशिष्ट एक्सपर्ट्स में वितरित 480 अरब पैरामीटर्स के विशाल नेटवर्क का उपयोग करता है, जिनमें से प्रत्येक विशिष्ट कार्यों के लिए फाइन-ट्यून किया गया है।
हालाँकि, हर क्वेरी के लिए सभी एक्सपर्ट्स सक्रिय नहीं होते। Arctic एक टॉप-2 गेटिंग मैकेनिज्म अपनाता है, जो प्रत्येक इनपुट के लिए केवल दो सबसे प्रासंगिक एक्सपर्ट्स का चयन करता है, इस प्रकार केवल 17 अरब पैरामीटर्स सक्रिय होते हैं। यह ऑप्टिमाइज़ेशन गणनात्मक ओवरहेड को काफी कम करता है, जबकि एंटरप्राइज-केंद्रित कार्यों की विस्तृत शृंखला में उच्च-स्तरीय प्रदर्शन बनाए रखता है।
Snowflake Arctic निम्नलिखित चार प्रमुख विशेषताओं के कारण अलग दिखता है:
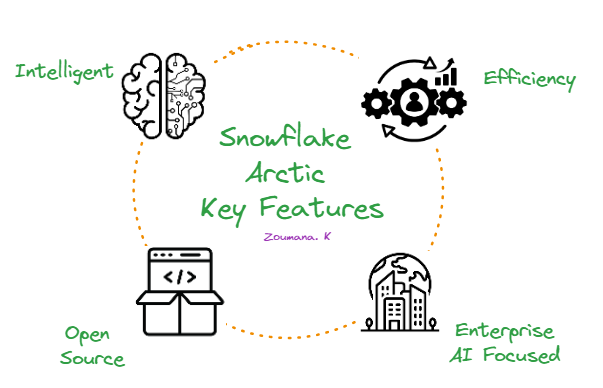
Snowflake Arctic की चार प्रमुख विशेषताएँ।
सबसे पहले, यह उल्लेखनीय रूप से बुद्धिमान है। Arctic SQL क्वेरी जनरेट करने, कोड लिखने और विस्तृत निर्देशों का पालन करने जैसे जटिल कार्यों में उत्कृष्ट है। उद्योग बेंचमार्क परीक्षणों में, यह समान मॉडलों से लगातार बेहतर प्रदर्शन करता है, जो जटिल, वास्तविक दुनिया के परिदृश्यों को संभालने की इसकी क्षमता दर्शाता है।
दूसरा, Arctic दक्षता के लिए डिज़ाइन किया गया है। इसकी विशिष्ट आर्किटेक्चर कम गणनात्मक संसाधनों का उपयोग करते हुए उच्च-स्तरीय प्रदर्शन प्रदान करती है। इसका अर्थ है महत्वपूर्ण लागत बचत, जो इसे सभी आकार के संगठनों के लिए आकर्षक विकल्प बनाती है।
तीसरा, Snowflake Arctic ओपन सोर्स को अपनाता है। यह Apache 2.0 लाइसेंस के अंतर्गत उपलब्ध है, जिससे सभी को इसके कोड और मॉडल वेट्स तक पहुँच मिलती है।
अंत में, Arctic एंटरप्राइज AI पर केंद्रित है। यह विशेष रूप से व्यवसायों की जरूरतों को संबोधित करने के लिए बनाया गया है, और डेटा विश्लेषण, प्रोसेस ऑटोमेशन, और निर्णय समर्थन जैसे कार्यों के लिए उच्च-गुणवत्ता के परिणाम देता है।
विविध एंटरप्राइज AI आवश्यकताओं को पूरा करने के लिए, Snowflake ने Snowflake Arctic परिवार के भीतर दो मुख्य मॉडल पेश किए हैं:
मुख्य मॉडलों के अलावा, Snowflake Apache 2.0 लाइसेंस के अंतर्गत पाँच टेक्स्ट एम्बेडिंग मॉडलों का परिवार भी प्रदान करता है—जो सभी सूचना पुनर्प्राप्ति कार्यों पर केंद्रित हैं। नीचे दी गई तालिका Massive Text Embedding Benchmark (MTEB) रिट्रीवल टास्क पर विभिन्न Snowflake Arctic मॉडलों के प्रदर्शन को दर्शाती है, जिसे NDCG@10 से मापा गया है।
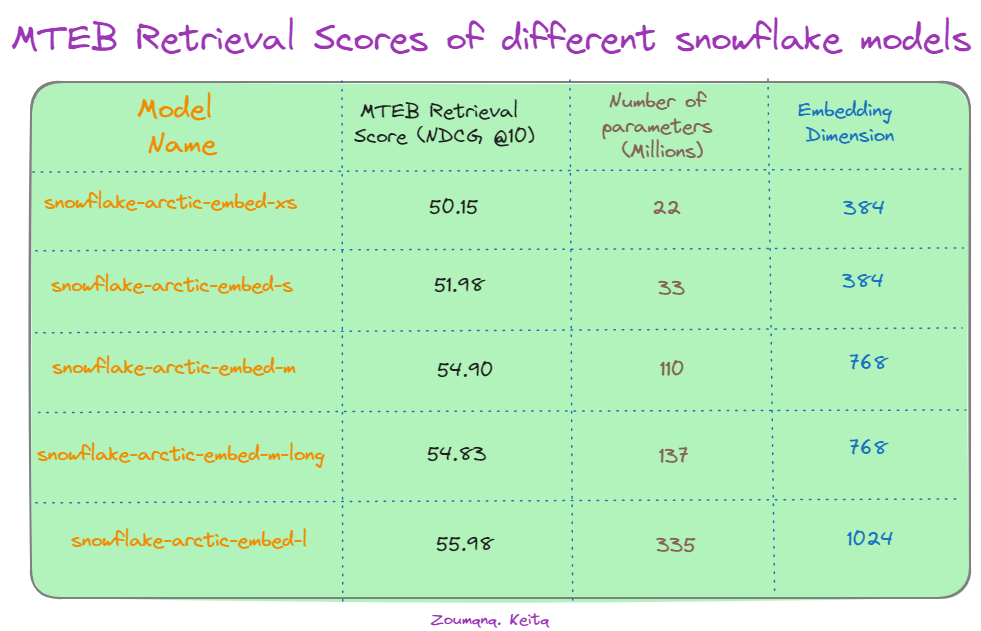
विभिन्न Snowflake मॉडलों के MTEB रिट्रीवल स्कोर। स्रोत: Hugging Face।
सबसे पहले, हम देखते हैं कि मॉडल के आकार में वृद्धि के साथ प्रदर्शन में सुधार की एक सामान्य प्रवृत्ति है। सबसे बड़ा मॉडल, "snowflake-arctic-embed-l," 335 मिलियन पैरामीटर्स और 1024 एम्बेडिंग डाइमेंशनों का उपयोग करते हुए, 55.98 का सर्वोच्च NDCG@10 स्कोर प्राप्त करता है। यह सुझाव देता है कि मॉडल स्केल टेक्स्ट डेटा के भीतर जटिल सैमांटिक संबंधों को पकड़ने में महत्वपूर्ण भूमिका निभाता है।
दिलचस्प बात यह है कि एम्बेडिंग डाइमेंशन को 384 से 1024 तक बढ़ाने से "snowflake-arctic-embed-l" मॉडल के स्कोर में सुधार होता है, जो रिट्रीवल सटीकता पर एम्बेडिंग आकार के प्रभाव को रेखांकित करता है। हालाँकि, एक उल्लेखनीय अपवाद "snowflake-arctic-embed-xs" मॉडल है। कम पैरामीटर्स (22 मिलियन) होने के बावजूद, यह 384 की समान एम्बेडिंग डाइमेंशन के साथ बड़े मॉडलों के तुलनीय प्रदर्शन देता है। यह इंगित करता है कि कुछ परिदृश्यों में मॉडल दक्षता और आर्किटेक्चरल ऑप्टिमाइज़ेशंस केवल पैरामीटर काउंट के फायदों की भरपाई कर सकते हैं।
तकनीकी इम्प्लीमेंटेशन पर हाथ गंदे करने से पहले, आइए मॉडल को एक्शन में देखें—SQL जनरेशन, कोडिंग और निर्देशों का पालन जैसे अलग-अलग कार्य करते हुए।
Hugging Face पर Streamlit डेमो से, हम मॉडल को कुछ रिक्वेस्ट दे सकते हैं, मॉडल के पैरामीटर्स समायोजित कर सकते हैं, और एक प्रतिक्रिया प्राप्त कर सकते हैं।
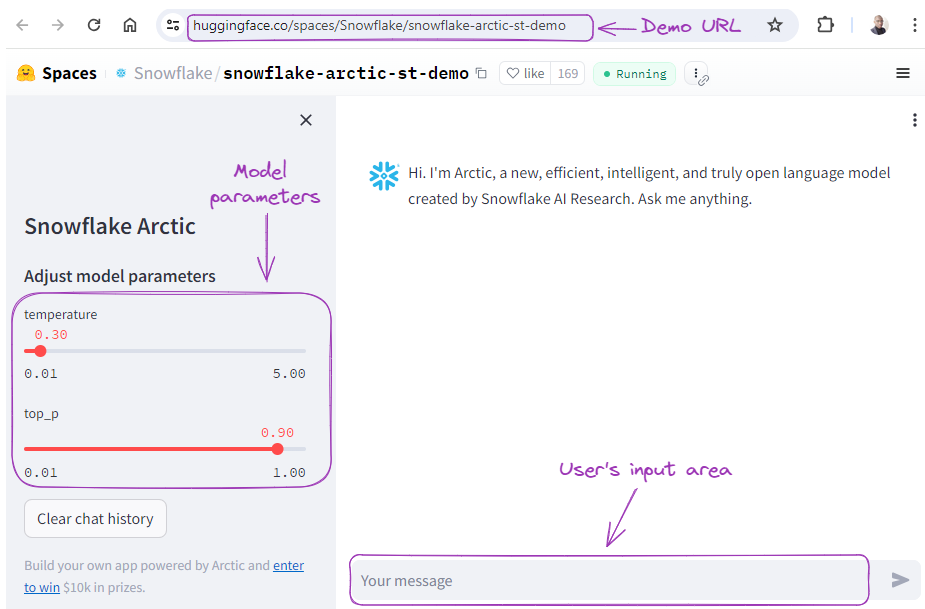
Snowflake Arctic डेमो।
पहले, मॉडल से एक SQL क्वेरी जनरेट करने के लिए कहें:
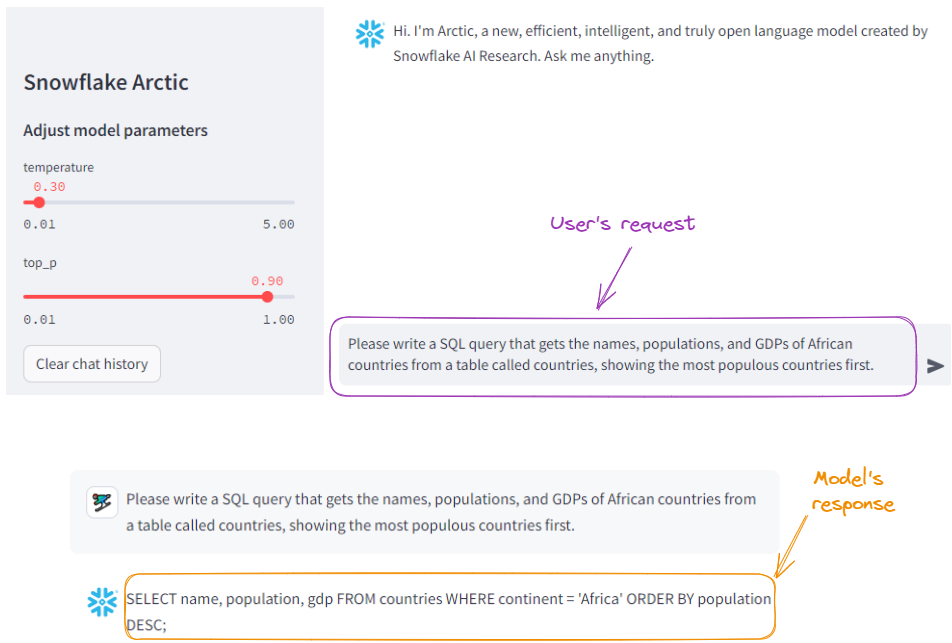
Snowflake Arctic के साथ SQL जनरेशन उदाहरण।
तुलना के लिए, वही रिक्वेस्ट ChatGPT-4o को सबमिट करें: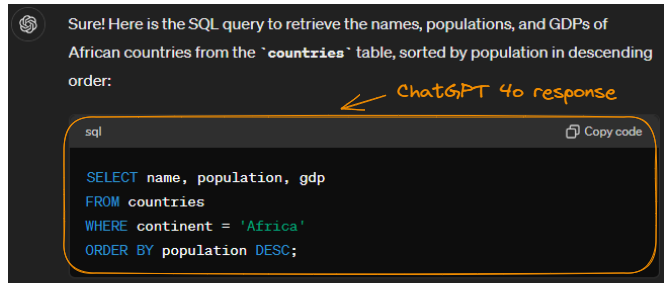
ChatGPT-4o के साथ SQL जनरेशन उदाहरण।
ध्यान दें कि इसने वही परिणाम जनरेट किया (और फ़ॉर्मेटिंग अधिक साफ़ है)। हम निष्कर्ष निकाल सकते हैं कि Arctic ने अच्छा काम किया।
अब Arctic से कुछ Python कोड लिखने के लिए कहें:
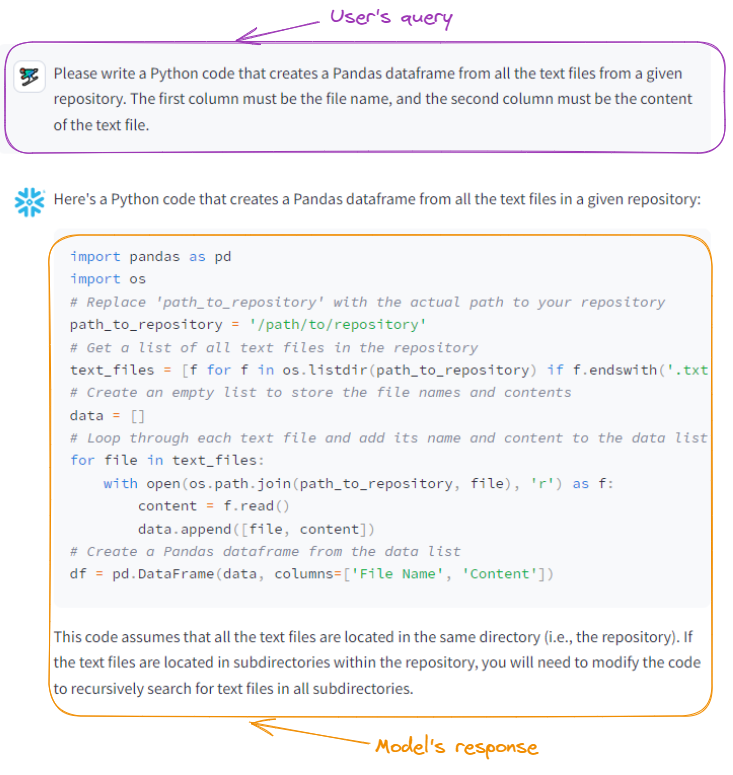
Snowflake Arctic Python कोड जनरेट करता है।
उसी प्रॉम्प्ट को ChatGPT-4o को देने पर हमें निम्नलिखित परिणाम मिलता है, जो सटीक भी है:
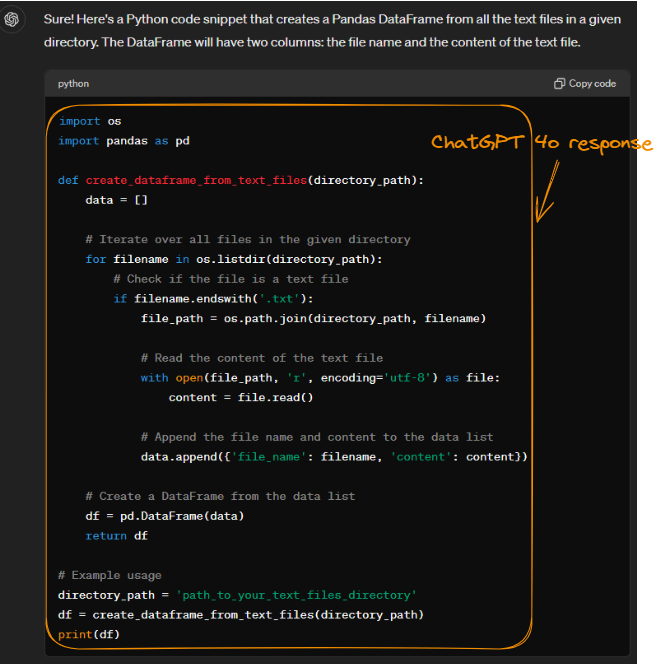
ChatGPT-4o द्वारा जनरेट किया गया Python कोड।
हालाँकि Arctic और ChatGPT-4o दोनों समान कार्य पूरा करते हैं, उनकी दक्षता और मेमोरी उपयोग में अंतर है। दोनों मॉडल os.listdir() और open() का उपयोग करके फ़ाइलें कुशलतापूर्वक पढ़ते हैं।
हालाँकि, सूचियों की डिक्शनरी से DataFrame बनाने का ChatGPT-4o का तरीका, सूचियों की सूची का उपयोग करने वाले Arctic के तरीके की तुलना में थोड़ी अधिक मेमोरी खा सकता है। ऐसा इसलिए क्योंकि Pandas डिक्शनरी को संभालने के लिए अतिरिक्त प्रोसेसिंग कर सकता है। इस छोटे से अंतर के बावजूद, ChatGPT-4o की मॉड्यूलर कोड संरचना पठनीयता और अनुरक्षण क्षमता बढ़ाती है।
यदि आप सही LLM चुनने के बारे में अधिक जानना चाहते हैं, तो यह ट्यूटोरियल देखें: LLM Classification: How to Select the Best LLM।
अब जबकि हम Snowflake Arctic मॉडल की क्षमताओं को जानते हैं, आइए Snowflake Arctic तक पहुँच और कॉन्फ़िगरेशन पर ध्यान दें।
Arctic मॉडल का उपयोग संसाधन-सघन है, इसलिए हम Arctic परिवार के सबसे छोटे मॉडल snowflake-arctic-embed-xs का उपयोग करेंगे, जो सबसे कम कंप्यूटेशनल संसाधन लेता है।
नीचे, हम इस ट्यूटोरियल के लिए उपयोग किए जा रहे पर्यावरण की विशेषताएँ देखते हैं—हम nvidia-smi कमांड चलाकर ये विशेषताएँ प्रदर्शित करते हैं:
!nvidia-smi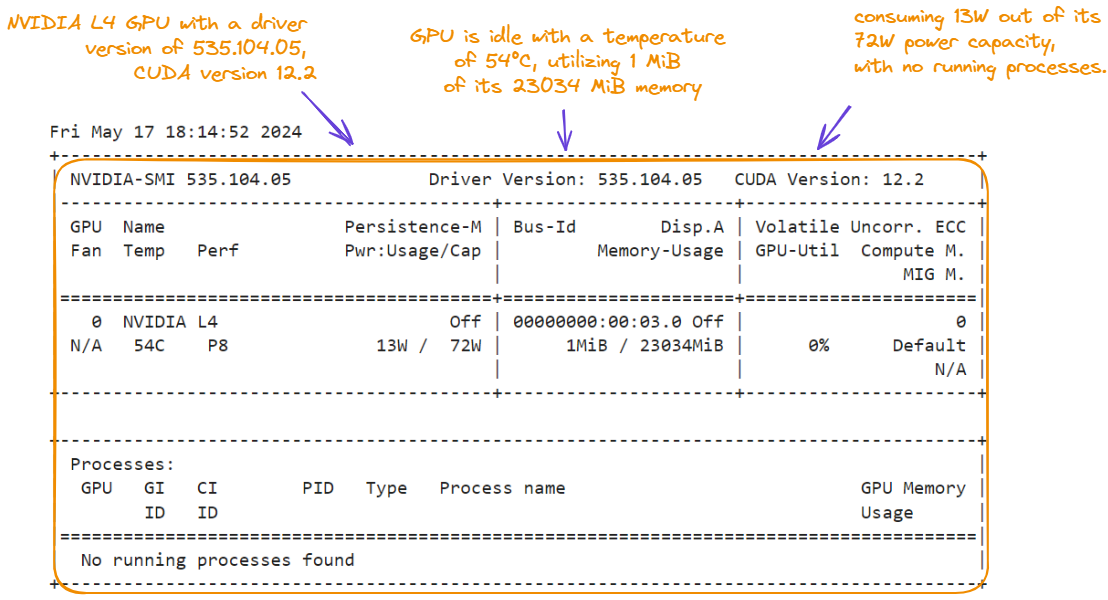
Snowflake Arctic ट्यूटोरियल के लिए GPU विशेषताएँ।
NVIDIA L4 GPU के अलावा, पर्यावरण में निम्नलिखित विशेषताएँ हैं, जिन्हें Resources सेक्शन में पाया जा सकता है:
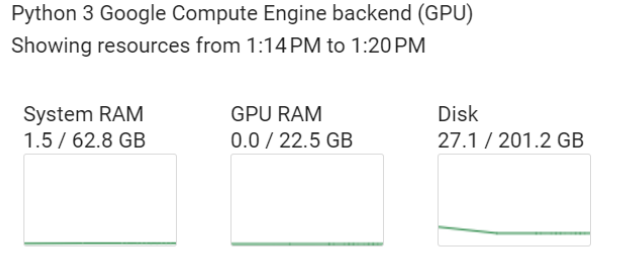
कंप्यूट इंजन बैकएंड की विशेषताएँ।
इस हैंड्स-ऑन ट्यूटोरियल के लिए दो मुख्य लाइब्रेरीज़ आवश्यक हैं: torch और transformers (हम नीचे दिया कोड एक नोटबुक से चलाते हैं):
%%bash
pip -qqq install transformers>=4.39.0
pip -qqq install torch
इसके बाद, हम आवश्यक सब-लाइब्रेरीज़ इम्पोर्ट करते हैं:
import torch
from transformers import AutoTokenizer, AutoModel
from torch.nn.functional import cosine_similarityआइए snowflake-arctic-embed-xs एम्बेडिंग मॉडल और उसके अनुरूप टोकनाइज़र को लोड करके आगे बढ़ते हैं:
model_checkpoint = "Snowflake/snowflake-arctic-embed-xs"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = AutoModel.from_pretrained(model_checkpoint, add_pooling_layer=False)
हम model_checkpoint द्वारा निर्दिष्ट प्री-ट्रेंड मॉडल को बिना किसी अतिरिक्त पूलिंग लेयर के लोड करते हैं, जो मॉडल के आउटपुट के डाइमेंशन को कम करने के लिए उपयोग होती है।
सभी आवश्यकताओं के सफलतापूर्वक सेटअप के साथ, इस खंड का मुख्य उपयोग मामला है—किसी दिए गए दस्तावेज़ के लिए सबसे समान शीर्ष N दस्तावेज़ों को उनकी कोसाइन समानता स्कोर सहित खोजना। ऐसा करने के लिए, हम ये पाँच मुख्य चरण लेते हैं:
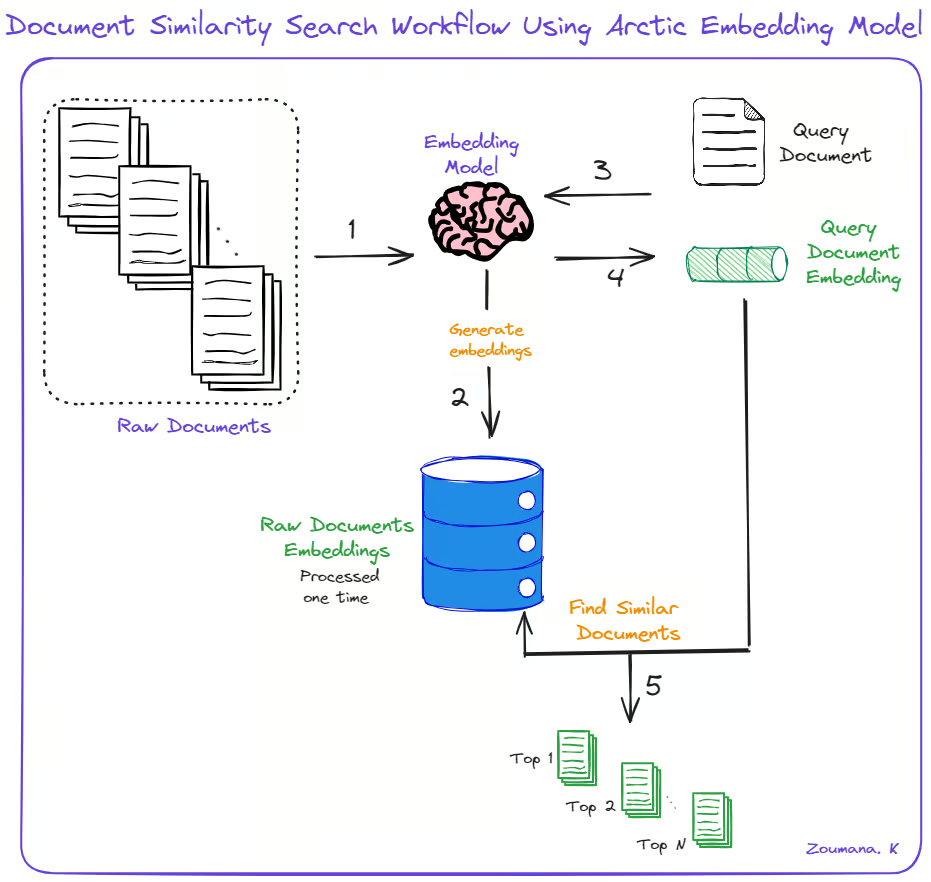
Snowflake Arctic का उपयोग करके दस्तावेज़ समानता खोज।
हम ऊपर दिए गए चरणों को निम्नलिखित हेल्पर फ़ंक्शंस का उपयोग करके इम्प्लीमेंट कर सकते हैं: generate_embedding() और find_similar_documents()।
def generate_embedding(document):
    inputs = tokenizer(document, padding=True, truncation=True,
                       return_tensors='pt', max_length=512)

    embedding = model(**inputs)[0][:, 0]
    return embedding


def find_similar_documents(query_document, document_embeddings , top_n=5):

    query_embedding = generate_embedding(query_document)

    similarity_scores = [cosine_similarity(query_embedding,
                                           doc_embedding).item() for doc_embedding in document_embeddings]

    sorted_indices = torch.argsort(torch.tensor(similarity_scores),
                                   descending=True)

    top_documents = [documents[idx] for idx in sorted_indices[:top_n]]
    top_scores = [similarity_scores[idx] for idx in sorted_indices[:top_n]]

    return top_documents, top_scores
generate_embedding() फ़ंक्शन किसी दस्तावेज़ को इनपुट लेकर उसकी एम्बेडिंग जनरेट करता है। find_similar_documents() एक क्वेरी दस्तावेज़, मौजूदा दस्तावेज़ों की एम्बेडिंग्स, और लौटाए जाने वाले समान दस्तावेज़ों की इच्छित संख्या को इनपुट लेता है।
सरलता के लिए, हम पाँच सरल उदाहरणों का उपयोग करते हैं:
documents = [
    "This is a tutorial about Snowflake Arctic Embedding models",
    "Arctic-embed is a state-of-the-art text embedding model.",
    "Snowflake provides various cloud data warehousing solutions.",
    "Embedding models are used for representing text as dense vectors.",
    "The Arctic-embed model is based on the transformer architecture."
]
इसके बाद, हम एम्बेडिंग्स जनरेट करते हैं:
document_embeddings = [generate_embedding(doc) for doc in documents]आइए “What is the Arctic-embed model?” को अपने क्वेरी दस्तावेज़ के रूप में चुनें और समान दस्तावेज़ ढूँढें:
query_document = "What is the Arctic-embed model?"
top_documents, top_scores = find_similar_documents(query_document, document_embeddings)
अंत में, हम सभी शीर्ष दस्तावेज़ों पर लूप लगाते हैं ताकि दस्तावेज़ की सामग्री और क्वेरी दस्तावेज़ के साथ उसकी समानता स्कोर को प्रिंट किया जा सके।
print("Query Document:")
print(query_document)
print("\nTop Similar Documents:")
for doc, score in zip(top_documents, top_scores):
    print(f"Document: {doc}")
    print(f"Similarity Score: {score:.4f}")
    print()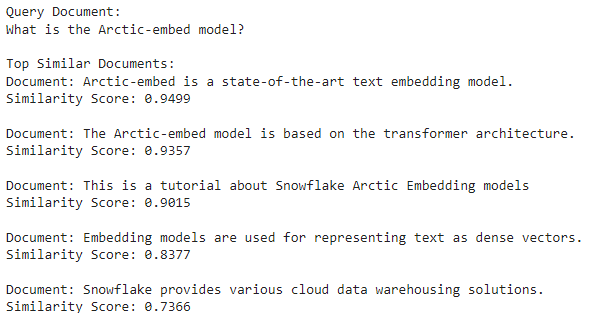
दूसरा दस्तावेज़ सबसे अधिक समान है क्योंकि इसका कोसाइन समानता स्कोर सबसे अधिक (94.99%) है।
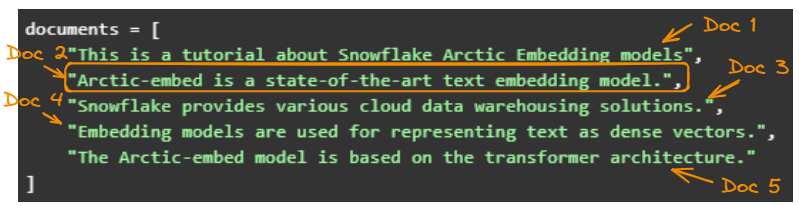
पाँच मूल दस्तावेज़।
जब हम दस्तावेज़ों को 3D स्पेस में विज़ुअलाइज़ करते हैं, तो हम एक-दूसरे के क़रीब दस्तावेज़ों को देख सकते हैं।
मूल एम्बेडिंग्स में 512 डाइमेंशन हैं, जिन्हें विज़ुअलाइज़ करना संभव नहीं है। सबसे आसान तरीका Principal Component Analysis (PCA) का उपयोग करके डाइमेंशन को घटाना है। यदि आप PCA के बारे में और सीखना चाहते हैं, तो यह ट्यूटोरियल देखें: Principal Component Analysis (PCA) in Python।
PCA का उपयोग करने से पहले, हमें find_similar_documents() फ़ंक्शन में संशोधन करना होगा ताकि वह दस्तावेज़ एम्बेडिंग्स लौटाए, जिन्हें PCA उपयोग करेगा।
def find_similar_documents(query_document, documents, top_n=5):
    query_embedding = generate_embedding(query_document)
    document_embeddings = [generate_embedding(doc) for doc in documents]

    similarity_scores = [cosine_similarity(query_embedding, doc_embedding).item() for doc_embedding in document_embeddings]
    sorted_indices = torch.argsort(torch.tensor(similarity_scores), descending=True)

    top_documents = [documents[idx] for idx in sorted_indices[:top_n]]
    top_scores = [similarity_scores[idx] for idx in sorted_indices[:top_n]]

    return top_documents, top_scores, document_embeddings
हम कुछ मॉड्यूल भी इम्पोर्ट करते हैं जो विज़ुअलाइज़ेशन जनरेट करने के लिए आवश्यक हैं।
from sklearn.decomposition import PCA
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D
अब 3D विज़ुअलाइज़ेशन बनाएँ, इन चरणों द्वारा:
top_documents, top_scores, document_embeddings = find_similar_documents(query_document, documents)

# Reshape the embeddings
reshaped_embeddings = torch.stack(document_embeddings).detach().numpy()
reshaped_embeddings = reshaped_embeddings.reshape(reshaped_embeddings.shape[0], -1)

# Apply PCA to reduce the embeddings to 3 dimensions
pca = PCA(n_components=3)
reduced_embeddings = pca.fit_transform(reshaped_embeddings)

# Create a 3D plot
fig = plt.figure(figsize=(8, 6))
ax = fig.add_subplot(111, projection='3d')

# Plot the document embeddings
for i, doc in enumerate(documents):
    ax.scatter(reduced_embeddings[i, 0], reduced_embeddings[i, 1], reduced_embeddings[i, 2], marker='o', label=f"Document {i+1}")

# Plot the query document embedding
query_embedding = generate_embedding(query_document)
reshaped_query_embedding = query_embedding.detach().numpy().reshape(1, -1)
reduced_query_embedding = pca.transform(reshaped_query_embedding)
ax.scatter(reduced_query_embedding[0, 0], reduced_query_embedding[0, 1],
           reduced_query_embedding[0, 2], marker='*', s=100, color='red',
           label="Query Document")

ax.set_xlabel('PC1')
ax.set_ylabel('PC2')
ax.set_zlabel('PC3')
ax.legend()
plt.title('Document Embeddings in 3D Space')
plt.show()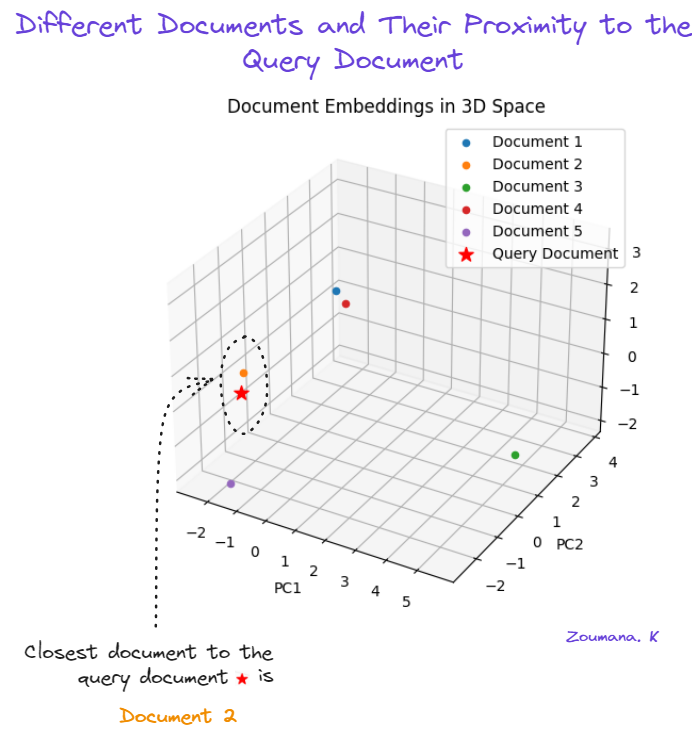
PCA का उपयोग करके दस्तावेज़ समानता का विज़ुअलाइज़ेशन।
दूसरा दस्तावेज़ (नारंगी) क्वेरी दस्तावेज़ (लाल सितारा) के सबसे क़रीब है। पाँचवाँ दस्तावेज़ (बैंगनी) दूसरा सबसे क़रीब है, जबकि तीसरा दस्तावेज़ (हरा) सबसे दूर है।
नोटबुक्स प्रयोग और त्वरित विज़ुअलाइज़ेशन के लिए शक्तिशाली टूल्स हैं, जो डेटा वैज्ञानिकों और शोधकर्ताओं के बीच लोकप्रिय हैं। हालाँकि, प्रोडक्शन वातावरण में मॉडल या एप्लिकेशन परिनियोजित करने के मामले में नोटबुक्स सबसे उपयुक्त विकल्प नहीं हो सकते। यहीं Streamlit काम आता है।
Streamlit एक Python लाइब्रेरी है जो डेटा साइंस और मशीन लर्निंग प्रोजेक्ट्स के लिए इंटरैक्टिव वेब एप्लिकेशन विकसित करना आसान बनाती है। यह व्यापक वेब डेवलपमेंट ज्ञान के बिना डेटा साइंस प्रोजेक्ट्स को प्रोडक्शन-रेडी एप्लिकेशन में बदलना सरल कर देता है।
नीचे वह लैंडिंग पेज है जिसे हम इस खंड में बनाएँगे।
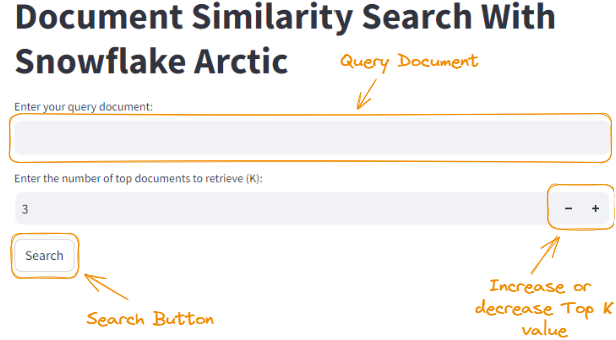
Streamlit एप्लिकेशन का लैंडिंग पेज।
Streamlit सिखाना इस ट्यूटोरियल के दायरे से बाहर है, लेकिन आप इसे शुरू से इस Python Tutorial: Streamlit में सीख सकते हैं।
इस खंड में, हम अपने दस्तावेज़ समानता खोज प्रोजेक्ट के लिए एक वेब एप्लिकेशन बनाने हेतु Streamlit का उपयोग करना सीखेंगे। किसी Streamlit एप्लिकेशन को चलाने के लिए, कोड को एक Python फ़ाइल (एक .py एक्सटेंशन के साथ) में होना चाहिए और टर्मिनल में निम्न कमांड चलानी होगी:
streamlit run app.pyहालाँकि, Streamlit का उपयोग करने का पहला चरण है इसे pip कमांड से इंस्टॉल करना:
pip install streamlitजिस कोड का उपयोग हमने Streamlit एप्लिकेशन बनाने के लिए किया, वह थोड़ा लंबा है, इसलिए उसे ध्यान से पढ़ें। हम कोड ब्लॉक के बाद इसकी व्याख्या भी करेंगे।
import streamlit as st
from transformers import AutoTokenizer, AutoModel
import torch
from torch.nn.functional import cosine_similarity
from sklearn.decomposition import PCA
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D


model_checkpoint = "Snowflake/snowflake-arctic-embed-xs"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = AutoModel.from_pretrained(model_checkpoint, add_pooling_layer=False)


def generate_embedding(document):
    inputs = tokenizer(document, padding=True, truncation=True, return_tensors='pt', max_length=512)
    embedding = model(**inputs)[0][:, 0]
    return embedding


def find_similar_documents(query_document, documents, top_n=5):
    query_embedding = generate_embedding(query_document)
    document_embeddings = [generate_embedding(doc) for doc in documents]


    similarity_scores = [cosine_similarity(query_embedding, doc_embedding).item() for doc_embedding in document_embeddings]
    sorted_indices = torch.argsort(torch.tensor(similarity_scores), descending=True)


    top_documents = [documents[idx] for idx in sorted_indices[:top_n]]
    top_scores = [similarity_scores[idx] for idx in sorted_indices[:top_n]]


    return top_documents, top_scores, document_embeddings


# Sample documents
documents = [
    "This is a tutorial about Snowflake Arctic Embedding models",
    "Arctic-embed is a state-of-the-art text embedding model.",
    "Snowflake provides various cloud data warehousing solutions.",
    "Embedding models are used for representing text as dense vectors.",
    "The Arctic-embed model is based on the transformer architecture."
]


# Streamlit app
st.title("Document Similarity Search With Snowflake Arctic")


query_document = st.text_input("Enter your query document:")
top_k = st.number_input("Enter the number of top documents to retrieve (K):", min_value=1, value=3, step=1)


if st.button("Search"):
    top_documents, top_scores, document_embeddings = find_similar_documents(query_document, documents, top_n=top_k)


    st.subheader("Top {} Similar Documents:".format(top_k))
    for i, (doc, score) in enumerate(zip(top_documents, top_scores)):
        st.write("{}. Document: {}".format(i+1, doc))
        st.write("   Similarity Score: {:.4f}".format(score))


    # Reshape the embeddings
    reshaped_embeddings = torch.stack(document_embeddings).detach().numpy()
    reshaped_embeddings = reshaped_embeddings.reshape(reshaped_embeddings.shape[0], -1)


    # Apply PCA to reduce the embeddings to 3 dimensions
    pca = PCA(n_components=3)
    reduced_embeddings = pca.fit_transform(reshaped_embeddings)


    # Create a 3D plot
    fig = plt.figure(figsize=(8, 6))
    ax = fig.add_subplot(111, projection='3d')


    # Plot the document embeddings
    for i, doc in enumerate(documents):
        ax.scatter(reduced_embeddings[i, 0], reduced_embeddings[i, 1], reduced_embeddings[i, 2], marker='o', label=f"Document {i+1}")


    # Plot the query document embedding
    query_embedding = generate_embedding(query_document)
    reshaped_query_embedding = query_embedding.detach().numpy().reshape(1, -1)
    reduced_query_embedding = pca.transform(reshaped_query_embedding)
    ax.scatter(reduced_query_embedding[0, 0], reduced_query_embedding[0, 1], reduced_query_embedding[0, 2], marker='*', s=100, color='red', label="Query Document")


    ax.set_xlabel('PC1')
    ax.set_ylabel('PC2')
    ax.set_zlabel('PC3')
    ax.legend()
    plt.title('Document Embeddings in 3D Space')


    st.pyplot(fig)
ऊपर दिए गए कोड का उपयोग करके, हमने "Document Similarity Search With Snowflake Arctic" नाम का एक Streamlit ऐप बनाया। कोड के बारे में कुछ टिप्पणियाँ:
st.text_input() के माध्यम से क्वेरी दस्तावेज़ दर्ज करने और st.number_input() के माध्यम से प्राप्त किए जाने वाले शीर्ष दस्तावेज़ों (K) की संख्या निर्दिष्ट करने देता है।st.button("Search")) पर क्लिक करता है, तो find_similar_documents() फ़ंक्शन क्वेरी दस्तावेज़, दस्तावेज़ों की सूची और निर्दिष्ट top_k मान के साथ कॉल होता है।st.subheader() और st.write() का उपयोग करते हुए शीर्ष K समान दस्तावेज़ों और उनके समानता स्कोर दिखाता है।st.pyplot(fig) का उपयोग करके दिखाया जाता है।कोड का Streamlit भाग एक इंटरैक्टिव यूज़र इंटरफ़ेस बनाने पर केंद्रित है, जहाँ उपयोगकर्ता एक क्वेरी दस्तावेज़ दर्ज कर सकता है, प्राप्त किए जाने वाले शीर्ष समान दस्तावेज़ों की संख्या निर्दिष्ट कर सकता है, और परिणामों को दस्तावेज़ एम्बेडिंग्स के 3D विज़ुअलाइज़ेशन के साथ देख सकता है।
लेख का पूरा कोड इस Jupyter Notebook में उपलब्ध है।
हम streamlit run app.py कमांड से एप्लिकेशन शुरू कर सकते हैं, जो हमें लैंडिंग पेज पर ले जाएगा। वही क्वेरी दस्तावेज़ प्रदान करने और Top K को 3 सेट करने पर हमें निम्नलिखित परिणाम मिलता है:
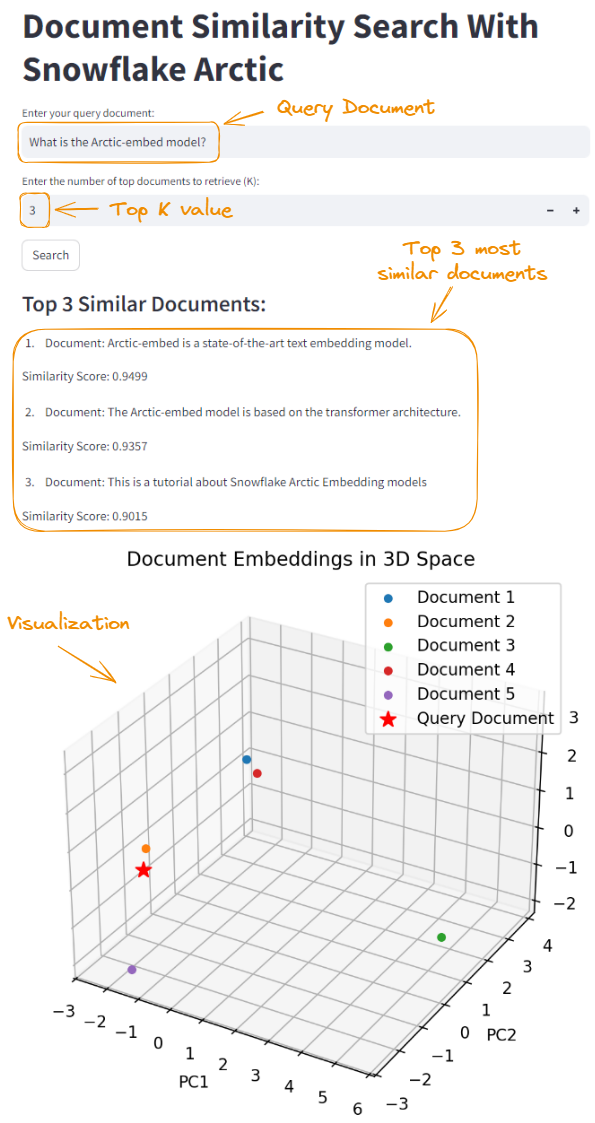
Streamlit का उपयोग करके Snowflake Arctic इंटीग्रेशन।
Arctic जैसे बड़े भाषा मॉडलों के साथ काम करते समय, अपने लक्ष्य वातावरण में कॉन्फ़िगरेशन का अच्छी तरह परीक्षण और वैधीकरण करना महत्वपूर्ण है। यह सर्वोत्तम प्रदर्शन और विश्वसनीयता सुनिश्चित करता है। ध्यान रखने के लिए कुछ कॉन्फ़िगरेशन टिप्स:
Snowflake Arctic के सर्वोत्तम प्रदर्शन और सुचारू संचालन के लिए, सर्वोत्तम प्रथाओं का पालन करना और संभावित समस्याओं के लिए तैयार रहना आवश्यक है। इस खंड में, हम वास्तविक दुनिया के बेंचमार्क और अकादमिक शोध के आधार पर प्रदर्शन बढ़ाने के टिप्स और ट्रिक्स का अन्वेषण करेंगे।
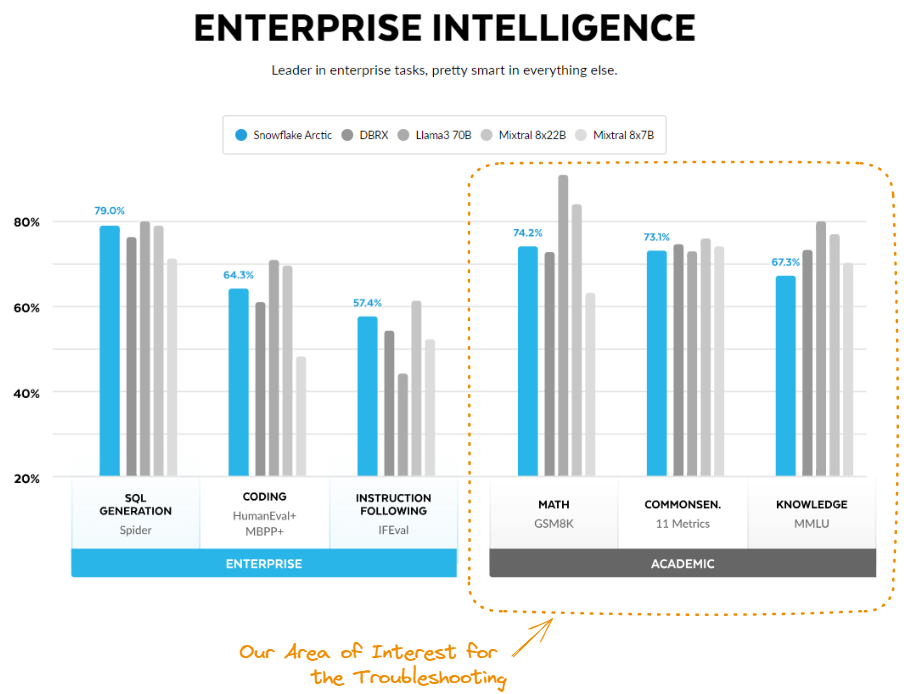
स्रोत: Arctic Cloud।
इसकी क्षमताओं को बढ़ाने के लिए कुछ टिप्स और ट्रिक्स:
Snowflake Arctic का प्रदर्शन इंफ़ेरेंस और ट्रेनिंग दोनों परिदृश्यों में अलग दिखाई देता है। इंफ़ेरेंस के दौरान, यह अन्य मॉडलों की तुलना में लगातार बेहतर प्रदर्शन/लागत अनुपात देता है। जैसे-जैसे अधिक पैरामीटर्स सक्रिय होते हैं, यह दक्षता बेहतर होती जाती है, और लगभग 60 अरब सक्रिय पैरामीटर्स पर भी उल्लेखनीय बढ़त बनाए रखती है, Mixtral और Llama 3 जैसे प्रतिस्पर्धियों से बेहतर प्रदर्शन करते हुए।
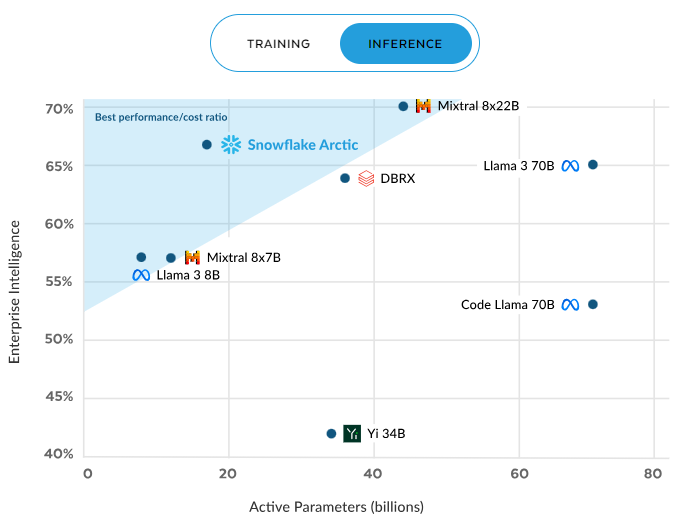
Arctic इंफ़ेरेंस दक्षता। स्रोत: Snowflake.com।
यह प्रवृत्ति ट्रेनिंग में भी जारी रहती है, जहाँ Arctic फिर से सर्वश्रेष्ठ प्रदर्शन/लागत अनुपात का दावा करता है। बढ़ते कम्प्यूट के साथ यह दक्षता स्केल होती है, 16X कम्प्यूट पर लगभग 70% तक पहुँचती है, जो DBRX, Llama 3, Code Llama और Yi जैसे मॉडलों से बहुत आगे है। ये परिणाम Arctic के वैल्यू प्रपोज़िशन को रेखांकित करते हैं: उच्च-गुणवत्ता का प्रदर्शन, अपेक्षाकृत कम कम्प्यूटेशनल लागत पर—जो संसाधन-सचेत एंटरप्राइजेज के लिए इसे आकर्षक विकल्प बनाता है।
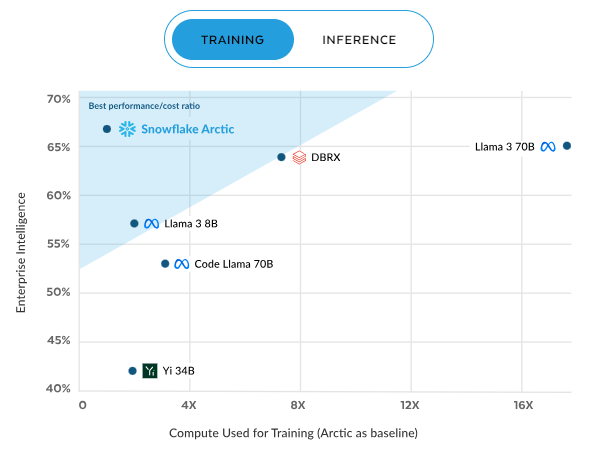
Arctic ट्रेनिंग दक्षता। स्रोत: Snowflake.com।
इंफ़ेरेंस और ट्रेनिंग के प्रदर्शन को ऑप्टिमाइज़ करने के लिए कुछ टिप्स और ट्रिक्स—इन तक सीमित नहीं:
Snowflake Arctic का प्रभावशाली प्रदर्शन और लागत-दक्षता ने भाषा मॉडलों के लिए एक नया मानक स्थापित किया है। भविष्य के विकास में उन्नत नैचुरल लैंग्वेज अंडरस्टैंडिंग, बेहतर मल्टी-टास्क लर्निंग, और डोमेन-विशिष्ट अनुप्रयोगों के लिए बेहतर समर्थन शामिल हो सकता है। जैसे-जैसे Snowflake नवाचार करेगा, उपयोगकर्ता और अधिक शक्तिशाली और बहुमुखी टूल्स की अपेक्षा कर सकते हैं।
Snowflake एक बेहतरीन कम्युनिटी और व्यापक सपोर्ट संसाधन प्रदान करता है। उपयोगकर्ता Snowflake कम्युनिटी फ़ोरम पर जुड़ सकते हैं, ज्ञान साझा कर सकते हैं, और एक-दूसरे से सीख सकते हैं। विस्तृत दस्तावेज़ीकरण और ट्यूटोरियल्स आधिकारिक वेबसाइट पर उपलब्ध हैं, जो उपयोगकर्ताओं को Snowflake Arctic की सुविधाओं को नेविगेट और अधिकतम करने में मदद करते हैं।
Snowflake Arctic टेक्स्ट एम्बेडिंग्स के क्षेत्र में एक गेम-चेंजर है, जो एंटरप्राइजेज को अपने डेटा की पूरी क्षमता अनलॉक करने के लिए एक शक्तिशाली और कुशल समाधान प्रदान करता है। Snowflake Data Cloud के साथ इसका निर्बाध इंटीग्रेशन और स्केलेबल आर्किटेक्चर इसे उन संगठनों के लिए आदर्श विकल्प बनाता है जो अपने डेटा रिट्रीवल और विश्लेषण प्रक्रियाओं को सुव्यवस्थित करना चाहते हैं।
इस गाइड में, हमने Snowflake Arctic की कोर क्षमताओं का अन्वेषण किया—इसके सेटअप और कॉन्फ़िगरेशन से लेकर एडवांस्ड इंटीग्रेशन तकनीकों और व्यावहारिक अनुप्रयोगों तक। इसकी उन्नत विशेषताओं और प्रदर्शन ऑप्टिमाइज़ेशंस का लाभ उठाकर, एंटरप्राइजेज अपनी टेक्स्ट एम्बेडिंग ऑपरेशंस में बेहतर दक्षता और सटीकता हासिल कर सकते हैं।
यदि आप Snowflake के बारे में और सीखना चाहते हैं, तो यह Snowflake Tutorial for Beginners देखें।
LLMs के बारे में और जानें!
कोर्स
कोर्स
कोर्स