Snowflake Arctic, Snowflake Data Cloud içinde yapay zekâ entegrasyonunu ve dağıtımını basitleştirmek için tasarlanmış kurumsal düzeyde dil modeli ailesidir.
Snowflake Arctic, metin gömmeleri alanında yenilikçi bir gelişme olup, kurumsal veriler üzerinde yapay zekâyı benimseme sürecini basitleştirmek için tasarlanmış güçlü bir araç seti sunar.
Bu eğitimde Snowflake Arctic’e genel bir bakış sunacak, kurulum sürecinden geçecek, entegrasyon tekniklerini inceleyecek ve en iyi uygulamalar ile sorun giderme ipuçlarını paylaşacağız. Ayrıca gerçek dünya kullanım örneklerini sergileyecek, gelecekteki gelişmeleri tartışacak ve sürekli destek ve öğrenme için kaynaklar sağlayacağız.
Snowflake hakkında daha fazla bilgi edinmek isterseniz, şu Introduction to Snowflake kursuna göz atın.
Snowflake Arctic Nedir?
Peki, Snowflake Arctic tam olarak nedir? Snowflake Data Cloud içinde yapay zekânın entegrasyonunu ve dağıtımını basitleştirmek üzere tasarlanmış kapsamlı bir araç paketidir. Temelinde, verilerimizden değerli içgörüleri verimli şekilde çıkarmamızı sağlayan bir gömme modeli koleksiyonu sunar.
Buna ek olarak, SQL sorguları ve programlama kodu üretmekten karmaşık talimatları izlemeye kadar geniş bir görev yelpazesini ele alabilen çok amaçlı bir Büyük Dil Modeli (LLM) de içerir.
Arctic’in öne çıkan özelliklerinden biri, Snowflake Data Cloud ile kusursuz entegrasyonudur. Bu sıkı bağ, mevcut veri altyapımız içinde doğrudan yapay zekâ gücünden yararlanmamıza olanak tanıyarak güvenli ve akıcı bir deneyim sağlar.
Önemli olarak, Snowflake Arctic ailesindeki tüm modeller Apache 2.0 lisansı altında sunulmaktadır ve bu sayede hem akademik hem de ticari amaçlarla kullanılabilir.
Mimari ve performans
Snowflake Arctic’in üç ana bileşeni vardır:
Snowflake Arctic’in bileşenleri.
Snowflake Arctic’in mimarisi, verimli ölçeklenebilirlik ve uyarlanabilirlik sağlayan bir yenilik olan Yoğun Uzman Karışımı (MoE) hibrit dönüştürücü tasarımına dayanmaktadır. Bu yaklaşım, her biri belirli görevler için ince ayar yapılmış 128 uzman arasında dağıtılmış 480 milyar parametreden oluşan geniş bir ağdan yararlanır.
Ancak her sorgu için tüm uzmanlar etkinleştirilmez. Arctic, her girdi için yalnızca en ilgili iki uzmanın seçildiği top-2 kapılama mekanizmasını kullanır ve böylece yalnızca 17 milyar parametreyi etkinleştirir. Bu optimizasyon, kurumsal odaklı geniş bir görev yelpazesinde üst düzey performansı korurken hesaplama yükünü önemli ölçüde azaltır.
Temel özellikler
Snowflake Arctic aşağıdaki dört temel özellikle öne çıkar:
Snowflake Arctic’in dört temel özelliği.
Her şeyden önce, son derece zekidir. Arctic, SQL sorguları üretme, kod yazma ve ayrıntılı talimatları izleme gibi karmaşık görevlerde başarılıdır. Sektör ölçüt testlerinde benzer modelleri tutarlı biçimde geride bırakarak gerçek dünyadaki karmaşık senaryoları ele alma becerisini gösterir.
İkinci olarak, Arctic verimlilik için tasarlanmıştır. Benzersiz mimarisi, daha az hesaplama kaynağı tüketirken üst düzey performans sunmasına olanak tanır. Bu da önemli maliyet tasarruflarına dönüşerek her ölçekten kuruluş için cazip bir seçenek hâline getirir.
Üçüncü olarak, Snowflake Arctic açık kaynağı benimser. Apache 2.0 lisansı altında sunulur ve herkesin koduna ve model ağırlıklarına erişmesine imkân tanır.
Son olarak, Arctic kurumsal yapay zekâya odaklanır. İşletmelerin özel ihtiyaçlarını karşılamak üzere tasarlanmıştır ve veri analizi, süreç otomasyonu ve karar destek gibi görevlerde yüksek kaliteli sonuçlar üretir.
Snowflake Arctic modelleri
Çeşitli kurumsal yapay zekâ gereksinimlerini karşılamak için Snowflake, Snowflake Arctic ailesi içinde iki ana model sunmuştur:
Snowflake Arctic Instruct: Bu varyant, doğal dil istemlerinden yüksek kaliteli yanıtlar üretmede üstündür.
Snowflake Arctic Base: Bu sürüm, ek ince ayar gerektirmeden çeşitli uygulamalarda kullanılabilen çok yönlü bir temel dil modelidir.
Snowflake Arctic metin gömme modelleri
Ana modellere ek olarak Snowflake, Apache 2.0 lisansı altında bilgi erişimi görevlerine odaklanan beş metin gömme modelinden oluşan bir aile sunar. Aşağıdaki tablo, NDCG@10 ile ölçülen Massive Text Embedding Benchmark (MTEB) erişim görevinde çeşitli Snowflake Arctic modellerinin performansını göstermektedir.
Farklı Snowflake modellerinin MTEB erişim skorları. Kaynak: Hugging Face.
İlk olarak, model boyutu arttıkça performansın genel olarak iyileştiği bir eğilim görüyoruz. En büyük model olan "snowflake-arctic-embed-l", 335 milyon parametre ve 1024 gömme boyutu kullanarak 55.98 ile en yüksek NDCG@10 skoruna ulaşıyor. Bu da model ölçeğinin, metin verilerindeki karmaşık anlamsal ilişkileri yakalamada önemli bir rol oynadığını gösteriyor.
Dikkat çekici bir şekilde, gömme boyutunun 384’ten 1024’e artırılması, "snowflake-arctic-embed-l" modeli için skorları iyileştiriyor ve gömme boyutunun erişim doğruluğu üzerindeki etkisini vurguluyor. Ancak kayda değer bir istisna, "snowflake-arctic-embed-xs" modelidir. Çok daha az parametreye (22 milyon) sahip olmasına rağmen, 384 gömme boyutuna sahip daha büyük modellerle karşılaştırılabilir performans sergiler. Bu durum, belirli senaryolarda model verimliliği ve mimari optimizasyonların, salt parametre sayısının getirdiği faydaları dengeleyebileceğini düşündürür.
Snowflake Arctic: Demo
Teknik uygulamaya geçmeden önce, modeli SQL üretimi, kod yazma ve talimatları izleme gibi farklı görevlerde çalışırken görelim.
Önce modelden bir SQL sorgusu üretmesini isteyelim:
Snowflake Arctic ile SQL üretimi örneği.
Karşılaştırma için aynı isteği ChatGPT-4o’ya gönderelim:
ChatGPT-4o ile SQL üretimi örneği.
Aynı sonucu (daha temiz biçimlendirmeyle) ürettiğine dikkat edin. Arctic’in iyi bir iş çıkardığı sonucuna varabiliriz.
Arctic’ten biraz Python kodu yazmasını isteyelim:
Snowflake Arctic Python kodu üretiyor.
Aynı istemi ChatGPT-4o’ya vererek aşağıdaki, yine doğru olan sonucu elde ediyoruz:
ChatGPT-4o tarafından üretilen Python kodu.
Hem Arctic hem de ChatGPT-4o aynı görevi başarsa da yaklaşımları verimlilik ve bellek kullanımı açısından farklılık gösterir. Her iki model de os.listdir() ve open() kullanarak dosyaları verimli biçimde okur.
Bununla birlikte, ChatGPT-4o’nun sözlüklerden oluşan bir listeden DataFrame oluşturma yaklaşımı, Arctic’in listeler listesini kullanma yöntemine kıyasla biraz daha fazla bellek tüketebilir. Bunun nedeni, Pandas’ın sözlükleri işlemek için ek işlemler yapabilmesidir. Bu küçük farka rağmen, ChatGPT-4o’nun modüler kod yapısı okunabilirliği ve sürdürülebilirliği artırır.
Artık Snowflake Arctic modelinin yeteneklerini bildiğimize göre, Snowflake Arctic’e erişmeye ve yapılandırmaya odaklanalım.
Ortamın özellikleri
Arctic modellerini kullanmak kaynak yoğundur, bu nedenle en az hesaplama kaynağı kullanan Arctic aile modellerinin en küçüğü olan snowflake-arctic-embed-xs’i kullanacağız.
Aşağıda, bu eğitim için kullandığımız ortamın özelliklerini görüyoruz—özellikleri nvidia-smi komutunu çalıştırarak görüntülüyoruz:
Ardından gerekli alt kütüphaneleri içe aktarıyoruz:
import torch
from transformers import AutoTokenizer, AutoModel
from torch.nn.functional import cosine_similarityAltyapı:
Modeli ve belirteçleyiciyi yükleme
snowflake-arctic-embed-xs gömme modelini ve karşılık gelen belirteçleyicisini yükleyerek devam edelim:
model_checkpoint ="Snowflake/snowflake-arctic-embed-xs"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = AutoModel.from_pretrained(model_checkpoint, add_pooling_layer=False)Altyapı:
model_checkpoint ile belirtilen önceden eğitilmiş modeli, model çıktısının boyutunu düşürmek için kullanılan ek bir havuzlama katmanı olmadan yüklüyoruz.
Snowflake Arctic ile Belge Benzerliği Arama
Tüm gereksinimler başarıyla kurulduğuna göre, bu bölümün temel kullanım durumu, verilen bir belgeye en benzer ilk N belgeyi ve bunların kosinüs benzerliği skorlarını bulmaktır. Bunu yapmak için şu beş ana adımı izleriz:
Gömme modelini kullanarak ilk ham belgeler için gömmeler üretiriz.
Belirli bir sorgu belgesi için, aynı gömme modelini kullanarak gömmesini üretiriz.
Sorgu ve belge gömmeleri arasındaki benzerlikleri hesaplarız.
Benzerlik skorlarıyla birlikte en benzer ilk N belgeyi döndürürüz.
Snowflake Arctic kullanarak belge benzerliği araması.
Yukarıdaki adımları şu yardımcı işlevleri kullanarak uygulayabiliriz: generate_embedding() ve find_similar_documents().
generate_embedding() işlevi bir belgeyi girdi olarak alır ve gömmesini üretir. find_similar_documents() ise bir sorgu belgesi, mevcut belgelerin gömmeleri ve döndürülecek benzer belgelerin istenen sayısını alır.
Basitlik adına beş basit örnek kullanıyoruz:
documents =["This is a tutorial about Snowflake Arctic Embedding models","Arctic-embed is a state-of-the-art text embedding model.","Snowflake provides various cloud data warehousing solutions.","Embedding models are used for representing text as dense vectors.","The Arctic-embed model is based on the transformer architecture."]Altyapı:
Sonra gömmeleri üretiyoruz:
document_embeddings =[generate_embedding(doc)for doc in documents]Altyapı:
“What is the Arctic-embed model?” sorusunu sorgu belgesi olarak seçip benzer belgeleri bulalım:
query_document ="What is the Arctic-embed model?"
top_documents, top_scores =find_similar_documents(query_document, document_embeddings)Altyapı:
Son olarak, en üstteki tüm belgeler üzerinde döngü kurarak belge içeriğini ve sorgu belgesiyle benzerlik skorunu yazdırıyoruz.
İkinci belge, en yüksek kosinüs benzerliği skoruna (%%94.99) sahip olduğu için en benzer olandır.
Beş orijinal belge.
3B belge görselleştirme
Belgeleri 3B bir uzayda görselleştirdiğimizde, birbirine daha yakın olan belgeleri görebiliriz.
Orijinal gömmeler 512 boyutludur ve görselleştirilmesi imkânsızdır. En kolay yol, Temel Bileşen Analizi (PCA) kullanarak boyutları azaltmaktır. PCA hakkında daha fazla bilgi edinmek isterseniz, şu öğreticiye göz atın: Python ile Temel Bileşen Analizi (PCA).
PCA’yı kullanmadan önce, PCA’nın kullanacağı belge gömmelerini döndürmesi için find_similar_documents() işlevini değiştirmemiz gerekir.
def find_similar_documents(query_document, documents, top_n=5):
query_embedding =generate_embedding(query_document)
document_embeddings =[generate_embedding(doc)for doc in documents]
similarity_scores =[cosine_similarity(query_embedding, doc_embedding).item()for doc_embedding in document_embeddings]
sorted_indices = torch.argsort(torch.tensor(similarity_scores), descending=True)
top_documents =[documents[idx]for idx in sorted_indices[:top_n]]
top_scores =[similarity_scores[idx]for idx in sorted_indices[:top_n]]return top_documents, top_scores, document_embeddingsAltyapı:
Ayrıca görselleştirmeyi oluşturmak için gerekli birkaç modülü içe aktarırız.
from sklearn.decomposition importPCAimport matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3DAltyapı:
Şimdi 3B görselleştirmeyi şu adımlarla oluşturalım:
Gömmeleri PCA giriş biçimine uyacak şekilde yeniden şekillendirme.
top_documents, top_scores, document_embeddings =find_similar_documents(query_document, documents)
# Reshape the embeddings
reshaped_embeddings = torch.stack(document_embeddings).detach().numpy()
reshaped_embeddings = reshaped_embeddings.reshape(reshaped_embeddings.shape[0],-1)
# Apply PCA to reduce the embeddings to 3 dimensions
pca =PCA(n_components=3)
reduced_embeddings = pca.fit_transform(reshaped_embeddings)
# Create a 3D plot
fig = plt.figure(figsize=(8,6))
ax = fig.add_subplot(111, projection='3d')
# Plot the document embeddings
for i, doc inenumerate(documents):
ax.scatter(reduced_embeddings[i,0], reduced_embeddings[i,1], reduced_embeddings[i,2], marker='o', label=f"Document {i+1}")
# Plot the query document embedding
query_embedding =generate_embedding(query_document)
reshaped_query_embedding = query_embedding.detach().numpy().reshape(1,-1)
reduced_query_embedding = pca.transform(reshaped_query_embedding)
ax.scatter(reduced_query_embedding[0,0], reduced_query_embedding[0,1],
reduced_query_embedding[0,2], marker='*', s=100, color='red',
label="Query Document")
ax.set_xlabel('PC1')
ax.set_ylabel('PC2')
ax.set_zlabel('PC3')
ax.legend()
plt.title('Document Embeddings in 3D Space')
plt.show()Altyapı:
Belge benzerliğini görselleştirmek için PCA kullanımı.
İkinci belge (turuncu), sorgu belgesine (kırmızı yıldız) en yakındır. Beşinci belge (mor) ikinci en yakın belgedir; üçüncü belge (yeşil) ise en uzaktır.
Snowflake Arctic’i Streamlit ile Entegre Etme
Not defterleri, denemeler ve hızlı görselleştirme için güçlü araçlardır ve bu nedenle veri bilimcileri ile araştırmacılar arasında popülerdir. Ancak, modelleri veya uygulamaları üretim ortamlarına dağıtmaya gelince not defterleri her zaman en uygun seçenek olmayabilir. İşte burada Streamlit devreye girer.
Streamlit, veri bilimi ve makine öğrenimi projeleri için etkileşimli web uygulamaları geliştirmeyi kolaylaştıran bir Python kütüphanesidir. Geniş web geliştirme bilgisi gerektirmeden veri bilimi projelerini üretime hazır uygulamalara dönüştürmeyi kolaylaştırır.
Aşağıda, bu bölümde inşa edeceğimiz uygulamanın açılış sayfasını görüyorsunuz.
Streamlit uygulamasının açılış sayfası.
Streamlit öğretimi bu eğitimin kapsamı dışında olsa da, sıfırdan öğrenmek için şu kaynağa bakabilirsiniz: Python Eğitimi: Streamlit.
Temel entegrasyon teknikleri
Bu bölümde, belge benzerliği arama projemiz için bir web uygulaması oluşturmak üzere Streamlit’in nasıl kullanılacağını keşfedeceğiz. Bir Streamlit uygulamasını çalıştırmak için, kodun bir Python dosyasında (.py uzantılı) olması ve terminalde aşağıdaki komutun yürütülmesi gerekir:
Streamlit uygulamasını oluşturmak için kullandığımız kod biraz uzun; bu yüzden üzerinde sakin sakin gezinin. Kod bloğunun ardından ayrıca açıklayacağız.
import streamlit as st
from transformers import AutoTokenizer, AutoModel
import torch
from torch.nn.functional import cosine_similarity
from sklearn.decomposition importPCAimport matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D
model_checkpoint ="Snowflake/snowflake-arctic-embed-xs"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = AutoModel.from_pretrained(model_checkpoint, add_pooling_layer=False)
def generate_embedding(document):
inputs =tokenizer(document, padding=True, truncation=True, return_tensors='pt', max_length=512)
embedding =model(**inputs)[0][:,0]return embedding
def find_similar_documents(query_document, documents, top_n=5):
query_embedding =generate_embedding(query_document)
document_embeddings =[generate_embedding(doc)for doc in documents]
similarity_scores =[cosine_similarity(query_embedding, doc_embedding).item()for doc_embedding in document_embeddings]
sorted_indices = torch.argsort(torch.tensor(similarity_scores), descending=True)
top_documents =[documents[idx]for idx in sorted_indices[:top_n]]
top_scores =[similarity_scores[idx]for idx in sorted_indices[:top_n]]return top_documents, top_scores, document_embeddings
# Sample documents
documents =["This is a tutorial about Snowflake Arctic Embedding models","Arctic-embed is a state-of-the-art text embedding model.","Snowflake provides various cloud data warehousing solutions.","Embedding models are used for representing text as dense vectors.","The Arctic-embed model is based on the transformer architecture."]
# Streamlit app
st.title("Document Similarity Search With Snowflake Arctic")
query_document = st.text_input("Enter your query document:")
top_k = st.number_input("Enter the number of top documents to retrieve (K):", min_value=1, value=3, step=1)if st.button("Search"):
top_documents, top_scores, document_embeddings =find_similar_documents(query_document, documents, top_n=top_k)
st.subheader("Top {} Similar Documents:".format(top_k))for i,(doc, score)inenumerate(zip(top_documents, top_scores)):
st.write("{}. Document: {}".format(i+1, doc))
st.write(" Similarity Score: {:.4f}".format(score))
# Reshape the embeddings
reshaped_embeddings = torch.stack(document_embeddings).detach().numpy()
reshaped_embeddings = reshaped_embeddings.reshape(reshaped_embeddings.shape[0],-1)
# Apply PCA to reduce the embeddings to 3 dimensions
pca =PCA(n_components=3)
reduced_embeddings = pca.fit_transform(reshaped_embeddings)
# Create a 3D plot
fig = plt.figure(figsize=(8,6))
ax = fig.add_subplot(111, projection='3d')
# Plot the document embeddings
for i, doc inenumerate(documents):
ax.scatter(reduced_embeddings[i,0], reduced_embeddings[i,1], reduced_embeddings[i,2], marker='o', label=f"Document {i+1}")
# Plot the query document embedding
query_embedding =generate_embedding(query_document)
reshaped_query_embedding = query_embedding.detach().numpy().reshape(1,-1)
reduced_query_embedding = pca.transform(reshaped_query_embedding)
ax.scatter(reduced_query_embedding[0,0], reduced_query_embedding[0,1], reduced_query_embedding[0,2], marker='*', s=100, color='red', label="Query Document")
ax.set_xlabel('PC1')
ax.set_ylabel('PC2')
ax.set_zlabel('PC3')
ax.legend()
plt.title('Document Embeddings in 3D Space')
st.pyplot(fig)Altyapı:
Yukarıdaki kodu kullanarak "Document Similarity Search With Snowflake Arctic" adlı bir Streamlit uygulaması oluşturduk. Kod hakkında birkaç gözlem yapalım:
Kullanıcının st.text_input() ile bir sorgu belgesi girmesine ve st.number_input() ile alınacak en üst belgelerin sayısını (K) belirtmesine olanak tanır.
Uygulama, st.subheader() ve st.write() kullanarak en benzer K belgeyi ve benzerlik skorlarını görüntüler.
Belge gömmeleri, görselleştirme amacıyla PCA kullanılarak 3 boyuta indirgenip yeniden şekillendirilir.
Belge gömmelerini ve sorgu belgesi gömmesini görselleştirmek için Matplotlib ile bir 3B grafik oluşturulur.
3B grafik, st.pyplot(fig) kullanılarak Streamlit uygulamasında görüntülenir.
Kodun Streamlit bölümü, kullanıcıların bir sorgu belgesi girebileceği, alınacak en benzer belgelerin sayısını belirtebileceği ve sonuçları belge gömmelerinin 3B görselleştirmesiyle birlikte görebileceği etkileşimli bir kullanıcı arayüzü oluşturulmasına odaklanır.
Uygulamayı streamlit run app.py komutuyla başlatabilir ve açılış sayfasına gidebiliriz. Aynı sorgu belgesini girip Top K’yı 3 olarak ayarladığımızda aşağıdaki sonucu elde ederiz:
Streamlit kullanarak Snowflake Arctic entegrasyonu.
Gelişmiş yapılandırma ipuçları
Arctic gibi büyük dil modelleriyle çalışırken, hedef ortamımızda yapılandırmaları kapsamlı biçimde test etmek ve doğrulamak kritik önem taşır. Bu, en iyi performansı ve güvenilirliği sağlar. Aklınızda bulundurmanız gereken bazı yapılandırma ipuçları şunlardır:
Niceleme (Quantization): Model boyutunu azaltmak ve çıkarımı hızlandırmak için ağırlıkların hassasiyetini düşürün. Bu makalenin yazıldığı sırada nicelemeli denetim noktası mevcut değildir; gelecekte hem Hugging Face çıkarımı hem de vLLM için mevcut olmalıdır.
Donanım hızlandırma: GPU’ları ve karma hassasiyetli eğitim/çıkarımı kullanın.
Model damıtma (distillation): Daha küçük bir "öğrenci" modeli, daha büyük bir "öğretmen" modeli taklit edecek şekilde eğitin.
Önbellekleme ve ön işleme: Sık kullanılan gömmeleri saklayın ve verileri çevrimdışı ön işleyin.
İzleme ve günlüğe kaydetme: Optimizasyon için performansı, kaynak kullanımını ve hataları takip edin.
Ölçekleme ve yük dengeleme: Birden çok örnek dağıtın ve istekleri eşit dağıtın.
Güvenlik ve erişim kontrolü: Kimlik doğrulama, yetkilendirme ve güvenli iletişim uygulayın.
Sürekli optimizasyon: Düzenli olarak izleyin, analiz edin ve yeni tekniklerle deney yapın.
En İyi Uygulamalar ve Sorun Giderme
Snowflake Arctic’in en iyi performans ve sorunsuz çalışmasını sağlamak için en iyi uygulamaları takip etmek ve olası sorunları gidermeye hazırlıklı olmak kritik önemdedir. Bu bölümde, gerçek dünya ölçütleri ve akademik araştırmalara dayalı olarak performansı artırmaya yönelik ipuçlarını ve püf noktalarını inceleyeceğiz.
Yetkinliklerini artırmak için bazı ipuçları ve püf noktaları şunlardır:
Daha hızlı matematiksel hesaplamalar için vektörleştirilmiş yürütme motorunu kullanın (GSMBK).
Sık erişilen akademik veri kümelerini ve önceden hesaplanmış sonuçları önbelleğe alın.
Veri yüklemeyi toplu teknikler ve yerel aşamalama ile optimize edin.
Veri hareketini en aza indirmek için depolamaya daha yakın yerde hesaplama yapın.
Hesaplama yoğun görevler için paralel işlemden yararlanın (GSM8K, MMLU).
Akademik ölçütlerde performansı izleyin ve darboğazları giderin.
Akademik toplulukla işbirliği yapın ve en son araştırma bulgularını dahil edin.
İyileştirme alanlarını belirlemek için performansı sürekli test edin ve karşılaştırın.
Çıkarım performansı
Snowflake Arctic’in performansı, hem çıkarımda hem de eğitim senaryolarında öne çıkar. Çıkarım sırasında, diğer modellere kıyasla tutarlı biçimde üstün bir performans/maliyet oranı sunar. Daha fazla parametre etkinleştikçe bu verimlilik artar; yaklaşık 60 milyar etkin parametre civarında bile Mixral ve Llama 3 gibi rakipleri geride bırakarak önemli bir üstünlük sürdürür.
Eğitimde de eğilim devam eder ve Arctic bir kez daha en iyi performans/maliyet oranıyla öne çıkar. Bu verimlilik, hesaplama arttıkça ölçeklenir ve 16X hesaplamada yaklaşık %%70’e ulaşarak DBRX, Llama 3, Code Llama ve Yi gibi modelleri açık ara geride bırakır. Bu sonuçlar, Arctic’in değer önerisini vurgular: Hesaplama maliyetinin küçük bir kısmıyla yüksek kaliteli performans; bu da kaynakları gözeten işletmeler için cazip bir seçenek yapar.
Çıkarım ve eğitim için performansı optimize etmeye yönelik bazı ipuçları ve püf noktaları şunlarla sınırlı olmamak üzere şunları içerir:
Snowflake’in ölçeklenebilir mimarisinden yararlanarak Snowflake Arctic’i büyük veri kümeleri üzerinde eğitin.
Eğitim iş yüklerini paralelleştirmek ve süreyi azaltmak için Snowflake’in dağıtık hesaplamasını kullanın.
Eğitimi hızlandırmak için Snowflake’in veri önbelleklemesini kullanarak sık erişilen verileri ve ara sonuçları saklayın.
Performansı korumak ve maliyetleri azaltmak için toplu yükleme teknikleri ve yerel aşamalama ile veri yüklemeyi optimize edin.
Eğitim ilerlemesini ve performans metriklerini Snowflake’in araçları ve özel çözümlerle izleyin.
Model performansı ile eğitim maliyetlerini dengelemek için hiperparametre ayarı yapın.
Ölçeklenebilir çıkarım iş yükleri için Snowflake’in maliyet etkin hesaplama kaynaklarını kullanın.
Snowflake’in veri ambarı yeteneklerini kullanarak verimli çıkarım ardışıkları uygulayın.
Optimizasyon fırsatları için çıkarım performans metriklerini sürekli izleyin ve analiz edin.
Snowflake Arctic’in Geleceği
Snowflake Arctic’in etkileyici performansı ve maliyet etkinliği, dil modelleri için yeni bir standart belirledi. Gelecekteki geliştirmeler arasında gelişmiş doğal dil anlama, iyileştirilmiş çok görevli öğrenme ve alanlara özel uygulamalar için daha iyi destek yer alabilir. Snowflake yenilik yaptıkça, kullanıcılar daha da güçlü ve çok yönlü araçlar bekleyebilir.
Snowflake, harika bir topluluk ve kapsamlı destek kaynakları sunar. Kullanıcılar, Snowflake topluluk forumlarında bağlantı kurabilir, bilgi paylaşabilir ve birbirlerinden öğrenebilir. Ayrıntılı dokümantasyon ve öğreticiler, kullanıcıların Snowflake Arctic’in özelliklerinde gezinmesine ve bunları en üst düzeye çıkarmasına yardımcı olmak için resmî web sitesinde mevcuttur.
Sonuç
Snowflake Arctic, metin gömmeleri alanında oyunun kurallarını değiştiren bir çözümdür ve verilerinin tüm potansiyelini açığa çıkarmak isteyen kuruluşlar için güçlü ve verimli bir yaklaşım sunar. Snowflake Data Cloud ile kesintisiz entegrasyonu ve ölçeklenebilir mimarisi, veri erişim ve analiz süreçlerini sadeleştirmek isteyen kuruluşlar için ideal bir seçimdir.
Bu rehber boyunca, kurulum ve yapılandırmadan gelişmiş entegrasyon tekniklerine ve pratik uygulamalara kadar Snowflake Arctic’in temel yeteneklerini inceledik. Gelişmiş özelliklerinden ve performans optimizasyonlarından yararlanan kuruluşlar, metin gömme işlemlerinde daha iyi verimlilik ve doğruluk elde edebilir.
Bilgisini paylaşmaktan ve başkalarına katkı sunmaktan keyif alan, çok yönlü bir veri bilimci olan Zoumana, YouTube’da içerik üretiyor ve Medium’da önde gelen teknoloji yazarları arasında yer alıyor. Konuşmaktan, kod yazmaktan ve öğretmekten büyük zevk alıyor. Zoumana’nın iki yüksek lisans derecesi bulunuyor: İlki Fransa, Paris’te Makine Öğrenmesi odaklı Bilgisayar Bilimleri; ikincisi ise ABD’de Texas Tech University’den Veri Bilimi. Kariyerine Fransa’da Groupe OPEN’da Yazılım Geliştirici olarak başladı; ardından IBM’de Makine Öğrenmesi Danışmanı olarak çalıştı ve sigorta şirketleri için uçtan uca yapay zeka çözümleri geliştirdi. Paris ve Montreal merkezli ilk Sürdürülebilir YZ girişimi olan Axionable’a katıldı. Burada Veri Bilimci olarak görev yaptı ve çoğunlukla NLP kullanım örnekleri olmak üzere, Fransa, Montreal, Singapur ve İsviçre’den müşteriler için YZ ürünleri hayata geçirdi. Ayrıca zamanının %5’ini Araştırma ve Geliştirme’ye ayırdı. Hâlihazırda IFC – Dünya Bankası Grubu’nda Kıdemli Veri Bilimci olarak çalışmaktadır.
Algoritmalar, sistem tasarımı ve davranışsal senaryoları kapsayan bu temel sorularla teknik mülakat sürecine hakim olun. Uzman cevapları, kod örnekleri ve kanıtlanmış hazırlık stratejileri edinin.
Git deponuzu temiz tutmak için .gitignore’u nasıl kullanacağınızı öğrenin. Bu eğitim; temelleri, yaygın kullanım durumlarını ve başlamanıza yardımcı olacak pratik örnekleri kapsar!



 Abid Ali Awan · 14 min

 Dario Radečić · 15 min

 Adel Nehme


Snowflake Arctic, metin gömmeleri alanında yenilikçi bir gelişme olup, kurumsal veriler üzerinde yapay zekâyı benimseme sürecini basitleştirmek için tasarlanmış güçlü bir araç seti sunar.
Bu eğitimde Snowflake Arctic’e genel bir bakış sunacak, kurulum sürecinden geçecek, entegrasyon tekniklerini inceleyecek ve en iyi uygulamalar ile sorun giderme ipuçlarını paylaşacağız. Ayrıca gerçek dünya kullanım örneklerini sergileyecek, gelecekteki gelişmeleri tartışacak ve sürekli destek ve öğrenme için kaynaklar sağlayacağız.
Snowflake hakkında daha fazla bilgi edinmek isterseniz, şu Introduction to Snowflake kursuna göz atın.
Snowflake Arctic Nedir?
Peki, Snowflake Arctic tam olarak nedir? Snowflake Data Cloud içinde yapay zekânın entegrasyonunu ve dağıtımını basitleştirmek üzere tasarlanmış kapsamlı bir araç paketidir. Temelinde, verilerimizden değerli içgörüleri verimli şekilde çıkarmamızı sağlayan bir gömme modeli koleksiyonu sunar.
Buna ek olarak, SQL sorguları ve programlama kodu üretmekten karmaşık talimatları izlemeye kadar geniş bir görev yelpazesini ele alabilen çok amaçlı bir Büyük Dil Modeli (LLM) de içerir.
Arctic’in öne çıkan özelliklerinden biri, Snowflake Data Cloud ile kusursuz entegrasyonudur. Bu sıkı bağ, mevcut veri altyapımız içinde doğrudan yapay zekâ gücünden yararlanmamıza olanak tanıyarak güvenli ve akıcı bir deneyim sağlar.
Önemli olarak, Snowflake Arctic ailesindeki tüm modeller Apache 2.0 lisansı altında sunulmaktadır ve bu sayede hem akademik hem de ticari amaçlarla kullanılabilir.
Mimari ve performans
Snowflake Arctic’in üç ana bileşeni vardır:
Snowflake Arctic’in bileşenleri.
Snowflake Arctic’in mimarisi, verimli ölçeklenebilirlik ve uyarlanabilirlik sağlayan bir yenilik olan Yoğun Uzman Karışımı (MoE) hibrit dönüştürücü tasarımına dayanmaktadır. Bu yaklaşım, her biri belirli görevler için ince ayar yapılmış 128 uzman arasında dağıtılmış 480 milyar parametreden oluşan geniş bir ağdan yararlanır.
Ancak her sorgu için tüm uzmanlar etkinleştirilmez. Arctic, her girdi için yalnızca en ilgili iki uzmanın seçildiği top-2 kapılama mekanizmasını kullanır ve böylece yalnızca 17 milyar parametreyi etkinleştirir. Bu optimizasyon, kurumsal odaklı geniş bir görev yelpazesinde üst düzey performansı korurken hesaplama yükünü önemli ölçüde azaltır.
Temel özellikler
Snowflake Arctic aşağıdaki dört temel özellikle öne çıkar:
Snowflake Arctic’in dört temel özelliği.
Her şeyden önce, son derece zekidir. Arctic, SQL sorguları üretme, kod yazma ve ayrıntılı talimatları izleme gibi karmaşık görevlerde başarılıdır. Sektör ölçüt testlerinde benzer modelleri tutarlı biçimde geride bırakarak gerçek dünyadaki karmaşık senaryoları ele alma becerisini gösterir.
İkinci olarak, Arctic verimlilik için tasarlanmıştır. Benzersiz mimarisi, daha az hesaplama kaynağı tüketirken üst düzey performans sunmasına olanak tanır. Bu da önemli maliyet tasarruflarına dönüşerek her ölçekten kuruluş için cazip bir seçenek hâline getirir.
Üçüncü olarak, Snowflake Arctic açık kaynağı benimser. Apache 2.0 lisansı altında sunulur ve herkesin koduna ve model ağırlıklarına erişmesine imkân tanır.
Son olarak, Arctic kurumsal yapay zekâya odaklanır. İşletmelerin özel ihtiyaçlarını karşılamak üzere tasarlanmıştır ve veri analizi, süreç otomasyonu ve karar destek gibi görevlerde yüksek kaliteli sonuçlar üretir.
Snowflake Arctic modelleri
Çeşitli kurumsal yapay zekâ gereksinimlerini karşılamak için Snowflake, Snowflake Arctic ailesi içinde iki ana model sunmuştur:
Snowflake Arctic metin gömme modelleri
Ana modellere ek olarak Snowflake, Apache 2.0 lisansı altında bilgi erişimi görevlerine odaklanan beş metin gömme modelinden oluşan bir aile sunar. Aşağıdaki tablo, NDCG@10 ile ölçülen Massive Text Embedding Benchmark (MTEB) erişim görevinde çeşitli Snowflake Arctic modellerinin performansını göstermektedir.
Farklı Snowflake modellerinin MTEB erişim skorları. Kaynak: Hugging Face.
İlk olarak, model boyutu arttıkça performansın genel olarak iyileştiği bir eğilim görüyoruz. En büyük model olan "snowflake-arctic-embed-l", 335 milyon parametre ve 1024 gömme boyutu kullanarak 55.98 ile en yüksek NDCG@10 skoruna ulaşıyor. Bu da model ölçeğinin, metin verilerindeki karmaşık anlamsal ilişkileri yakalamada önemli bir rol oynadığını gösteriyor.
Dikkat çekici bir şekilde, gömme boyutunun 384’ten 1024’e artırılması, "snowflake-arctic-embed-l" modeli için skorları iyileştiriyor ve gömme boyutunun erişim doğruluğu üzerindeki etkisini vurguluyor. Ancak kayda değer bir istisna, "snowflake-arctic-embed-xs" modelidir. Çok daha az parametreye (22 milyon) sahip olmasına rağmen, 384 gömme boyutuna sahip daha büyük modellerle karşılaştırılabilir performans sergiler. Bu durum, belirli senaryolarda model verimliliği ve mimari optimizasyonların, salt parametre sayısının getirdiği faydaları dengeleyebileceğini düşündürür.
Snowflake Arctic: Demo
Teknik uygulamaya geçmeden önce, modeli SQL üretimi, kod yazma ve talimatları izleme gibi farklı görevlerde çalışırken görelim.
Hugging Face üzerindeki Streamlit demosundan modele bazı istekler gönderebilir, modelin parametrelerini ayarlayabilir ve yanıt alabiliriz.
Snowflake Arctic demosu.
Önce modelden bir SQL sorgusu üretmesini isteyelim:
Snowflake Arctic ile SQL üretimi örneği.
Karşılaştırma için aynı isteği ChatGPT-4o’ya gönderelim: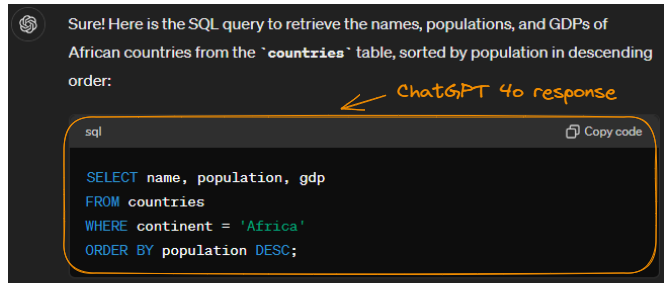
ChatGPT-4o ile SQL üretimi örneği.
Aynı sonucu (daha temiz biçimlendirmeyle) ürettiğine dikkat edin. Arctic’in iyi bir iş çıkardığı sonucuna varabiliriz.
Arctic’ten biraz Python kodu yazmasını isteyelim:
Snowflake Arctic Python kodu üretiyor.
Aynı istemi ChatGPT-4o’ya vererek aşağıdaki, yine doğru olan sonucu elde ediyoruz:
ChatGPT-4o tarafından üretilen Python kodu.
Hem Arctic hem de ChatGPT-4o aynı görevi başarsa da yaklaşımları verimlilik ve bellek kullanımı açısından farklılık gösterir. Her iki model de
os.listdir()veopen()kullanarak dosyaları verimli biçimde okur.Bununla birlikte, ChatGPT-4o’nun sözlüklerden oluşan bir listeden DataFrame oluşturma yaklaşımı, Arctic’in listeler listesini kullanma yöntemine kıyasla biraz daha fazla bellek tüketebilir. Bunun nedeni, Pandas’ın sözlükleri işlemek için ek işlemler yapabilmesidir. Bu küçük farka rağmen, ChatGPT-4o’nun modüler kod yapısı okunabilirliği ve sürdürülebilirliği artırır.
Doğru LLM’i seçme hakkında daha fazla bilgi edinmek isterseniz, şu öğreticiye göz atın: LLM Sınıflandırması: Uygulamanız için En İyi LLM Nasıl Seçilir.
Snowflake Arctic Kurulumu
Artık Snowflake Arctic modelinin yeteneklerini bildiğimize göre, Snowflake Arctic’e erişmeye ve yapılandırmaya odaklanalım.
Ortamın özellikleri
Arctic modellerini kullanmak kaynak yoğundur, bu nedenle en az hesaplama kaynağı kullanan Arctic aile modellerinin en küçüğü olan snowflake-arctic-embed-xs’i kullanacağız.
Aşağıda, bu eğitim için kullandığımız ortamın özelliklerini görüyoruz—özellikleri
nvidia-smikomutunu çalıştırarak görüntülüyoruz:Snowflake Arctic eğitimi için GPU özellikleri.
NVIDIA L4 GPU’ya ek olarak ortam, Resources bölümünde bulunabilecek aşağıdaki özelliklere sahiptir:
Hesaplama motoru arka uç özellikleri.
Kütüphanelerin kurulumu
Bu uygulamalı eğitim için iki ana kütüphane gereklidir:
torchvetransformers(aşağıdaki kodu bir not defterinden çalıştırıyoruz):Ardından gerekli alt kütüphaneleri içe aktarıyoruz:
Modeli ve belirteçleyiciyi yükleme
snowflake-arctic-embed-xs gömme modelini ve karşılık gelen belirteçleyicisini yükleyerek devam edelim:
model_checkpointile belirtilen önceden eğitilmiş modeli, model çıktısının boyutunu düşürmek için kullanılan ek bir havuzlama katmanı olmadan yüklüyoruz.Snowflake Arctic ile Belge Benzerliği Arama
Tüm gereksinimler başarıyla kurulduğuna göre, bu bölümün temel kullanım durumu, verilen bir belgeye en benzer ilk N belgeyi ve bunların kosinüs benzerliği skorlarını bulmaktır. Bunu yapmak için şu beş ana adımı izleriz:
Snowflake Arctic kullanarak belge benzerliği araması.
Yukarıdaki adımları şu yardımcı işlevleri kullanarak uygulayabiliriz:
generate_embedding()vefind_similar_documents().generate_embedding()işlevi bir belgeyi girdi olarak alır ve gömmesini üretir.find_similar_documents()ise bir sorgu belgesi, mevcut belgelerin gömmeleri ve döndürülecek benzer belgelerin istenen sayısını alır.Basitlik adına beş basit örnek kullanıyoruz:
Sonra gömmeleri üretiyoruz:
“What is the Arctic-embed model?” sorusunu sorgu belgesi olarak seçip benzer belgeleri bulalım:
Son olarak, en üstteki tüm belgeler üzerinde döngü kurarak belge içeriğini ve sorgu belgesiyle benzerlik skorunu yazdırıyoruz.
İkinci belge, en yüksek kosinüs benzerliği skoruna (%%94.99) sahip olduğu için en benzer olandır.
Beş orijinal belge.
3B belge görselleştirme
Belgeleri 3B bir uzayda görselleştirdiğimizde, birbirine daha yakın olan belgeleri görebiliriz.
Orijinal gömmeler 512 boyutludur ve görselleştirilmesi imkânsızdır. En kolay yol, Temel Bileşen Analizi (PCA) kullanarak boyutları azaltmaktır. PCA hakkında daha fazla bilgi edinmek isterseniz, şu öğreticiye göz atın: Python ile Temel Bileşen Analizi (PCA).
PCA’yı kullanmadan önce, PCA’nın kullanacağı belge gömmelerini döndürmesi için
find_similar_documents()işlevini değiştirmemiz gerekir.Ayrıca görselleştirmeyi oluşturmak için gerekli birkaç modülü içe aktarırız.
Şimdi 3B görselleştirmeyi şu adımlarla oluşturalım:
Belge benzerliğini görselleştirmek için PCA kullanımı.
İkinci belge (turuncu), sorgu belgesine (kırmızı yıldız) en yakındır. Beşinci belge (mor) ikinci en yakın belgedir; üçüncü belge (yeşil) ise en uzaktır.
Snowflake Arctic’i Streamlit ile Entegre Etme
Not defterleri, denemeler ve hızlı görselleştirme için güçlü araçlardır ve bu nedenle veri bilimcileri ile araştırmacılar arasında popülerdir. Ancak, modelleri veya uygulamaları üretim ortamlarına dağıtmaya gelince not defterleri her zaman en uygun seçenek olmayabilir. İşte burada Streamlit devreye girer.
Streamlit, veri bilimi ve makine öğrenimi projeleri için etkileşimli web uygulamaları geliştirmeyi kolaylaştıran bir Python kütüphanesidir. Geniş web geliştirme bilgisi gerektirmeden veri bilimi projelerini üretime hazır uygulamalara dönüştürmeyi kolaylaştırır.
Aşağıda, bu bölümde inşa edeceğimiz uygulamanın açılış sayfasını görüyorsunuz.
Streamlit uygulamasının açılış sayfası.
Streamlit öğretimi bu eğitimin kapsamı dışında olsa da, sıfırdan öğrenmek için şu kaynağa bakabilirsiniz: Python Eğitimi: Streamlit.
Temel entegrasyon teknikleri
Bu bölümde, belge benzerliği arama projemiz için bir web uygulaması oluşturmak üzere Streamlit’in nasıl kullanılacağını keşfedeceğiz. Bir Streamlit uygulamasını çalıştırmak için, kodun bir Python dosyasında (.py uzantılı) olması ve terminalde aşağıdaki komutun yürütülmesi gerekir:
Ancak, Streamlit’i kullanmanın ilk adımı
pipkomutuyla kurmaktır:Streamlit uygulamasını oluşturmak için kullandığımız kod biraz uzun; bu yüzden üzerinde sakin sakin gezinin. Kod bloğunun ardından ayrıca açıklayacağız.
Yukarıdaki kodu kullanarak "Document Similarity Search With Snowflake Arctic" adlı bir Streamlit uygulaması oluşturduk. Kod hakkında birkaç gözlem yapalım:
st.text_input()ile bir sorgu belgesi girmesine vest.number_input()ile alınacak en üst belgelerin sayısını (K) belirtmesine olanak tanır.st.button("Search")) tıkladığındafind_similar_documents()işlevi sorgu belgesi, belge listesi ve belirtilentop_kdeğeriyle çağrılır.st.subheader()vest.write()kullanarak en benzer K belgeyi ve benzerlik skorlarını görüntüler.st.pyplot(fig)kullanılarak Streamlit uygulamasında görüntülenir.Kodun Streamlit bölümü, kullanıcıların bir sorgu belgesi girebileceği, alınacak en benzer belgelerin sayısını belirtebileceği ve sonuçları belge gömmelerinin 3B görselleştirmesiyle birlikte görebileceği etkileşimli bir kullanıcı arayüzü oluşturulmasına odaklanır.
Makalenin tam kodu bu Jupyter Notebook’ta mevcuttur.
Uygulamayı
streamlit run app.pykomutuyla başlatabilir ve açılış sayfasına gidebiliriz. Aynı sorgu belgesini girip Top K’yı 3 olarak ayarladığımızda aşağıdaki sonucu elde ederiz:Streamlit kullanarak Snowflake Arctic entegrasyonu.
Gelişmiş yapılandırma ipuçları
Arctic gibi büyük dil modelleriyle çalışırken, hedef ortamımızda yapılandırmaları kapsamlı biçimde test etmek ve doğrulamak kritik önem taşır. Bu, en iyi performansı ve güvenilirliği sağlar. Aklınızda bulundurmanız gereken bazı yapılandırma ipuçları şunlardır:
En İyi Uygulamalar ve Sorun Giderme
Snowflake Arctic’in en iyi performans ve sorunsuz çalışmasını sağlamak için en iyi uygulamaları takip etmek ve olası sorunları gidermeye hazırlıklı olmak kritik önemdedir. Bu bölümde, gerçek dünya ölçütleri ve akademik araştırmalara dayalı olarak performansı artırmaya yönelik ipuçlarını ve püf noktalarını inceleyeceğiz.
Kaynak: Arctic Cloud.
Yetkinliklerini artırmak için bazı ipuçları ve püf noktaları şunlardır:
Çıkarım performansı
Snowflake Arctic’in performansı, hem çıkarımda hem de eğitim senaryolarında öne çıkar. Çıkarım sırasında, diğer modellere kıyasla tutarlı biçimde üstün bir performans/maliyet oranı sunar. Daha fazla parametre etkinleştikçe bu verimlilik artar; yaklaşık 60 milyar etkin parametre civarında bile Mixral ve Llama 3 gibi rakipleri geride bırakarak önemli bir üstünlük sürdürür.
Arctic çıkarım verimliliği. Kaynak: Snowflake.com.
Eğitim performansı
Eğitimde de eğilim devam eder ve Arctic bir kez daha en iyi performans/maliyet oranıyla öne çıkar. Bu verimlilik, hesaplama arttıkça ölçeklenir ve 16X hesaplamada yaklaşık %%70’e ulaşarak DBRX, Llama 3, Code Llama ve Yi gibi modelleri açık ara geride bırakır. Bu sonuçlar, Arctic’in değer önerisini vurgular: Hesaplama maliyetinin küçük bir kısmıyla yüksek kaliteli performans; bu da kaynakları gözeten işletmeler için cazip bir seçenek yapar.
Arctic eğitim verimliliği. Kaynak: Snowflake.com.
Çıkarım ve eğitim için performansı optimize etmeye yönelik bazı ipuçları ve püf noktaları şunlarla sınırlı olmamak üzere şunları içerir:
Snowflake Arctic’in Geleceği
Snowflake Arctic’in etkileyici performansı ve maliyet etkinliği, dil modelleri için yeni bir standart belirledi. Gelecekteki geliştirmeler arasında gelişmiş doğal dil anlama, iyileştirilmiş çok görevli öğrenme ve alanlara özel uygulamalar için daha iyi destek yer alabilir. Snowflake yenilik yaptıkça, kullanıcılar daha da güçlü ve çok yönlü araçlar bekleyebilir.
Snowflake, harika bir topluluk ve kapsamlı destek kaynakları sunar. Kullanıcılar, Snowflake topluluk forumlarında bağlantı kurabilir, bilgi paylaşabilir ve birbirlerinden öğrenebilir. Ayrıntılı dokümantasyon ve öğreticiler, kullanıcıların Snowflake Arctic’in özelliklerinde gezinmesine ve bunları en üst düzeye çıkarmasına yardımcı olmak için resmî web sitesinde mevcuttur.
Sonuç
Snowflake Arctic, metin gömmeleri alanında oyunun kurallarını değiştiren bir çözümdür ve verilerinin tüm potansiyelini açığa çıkarmak isteyen kuruluşlar için güçlü ve verimli bir yaklaşım sunar. Snowflake Data Cloud ile kesintisiz entegrasyonu ve ölçeklenebilir mimarisi, veri erişim ve analiz süreçlerini sadeleştirmek isteyen kuruluşlar için ideal bir seçimdir.
Bu rehber boyunca, kurulum ve yapılandırmadan gelişmiş entegrasyon tekniklerine ve pratik uygulamalara kadar Snowflake Arctic’in temel yeteneklerini inceledik. Gelişmiş özelliklerinden ve performans optimizasyonlarından yararlanan kuruluşlar, metin gömme işlemlerinde daha iyi verimlilik ve doğruluk elde edebilir.
Snowflake hakkında daha fazla bilgi edinmek isterseniz, şu kaynağa göz atın: Snowflake’e Yeni Başlayanlar için Eğitim.