
Cours
Concepts des grands modèles de langage (LLM)
2 h
109.8K
Snowflake Arctic est une avancée majeure dans le domaine des embeddings de texte, avec un ensemble d’outils puissants conçus pour faciliter l’adoption de l’IA sur des données d’entreprise.
Dans ce tutoriel, nous allons présenter Snowflake Arctic, parcourir l’installation, explorer les techniques d’intégration, puis partager des bonnes pratiques et des conseils de dépannage. Nous mettrons aussi en avant des cas d’usage concrets, aborderons les évolutions à venir et fournirons des ressources pour vous accompagner dans la durée.
Pour aller plus loin avec Snowflake, découvrez ce cours Introduction to Snowflake.
Alors, concrètement, qu’est-ce que Snowflake Arctic ? C’est une suite d’outils complète qui simplifie l’intégration et le déploiement de l’IA dans Snowflake Data Cloud. Au cœur d’Arctic, on trouve une collection de modèles d’embedding permettant d’extraire efficacement des insights de valeur à partir de vos données.
Arctic inclut également un Large Language Model (LLM) polyvalent, capable de traiter un large éventail de tâches, de la génération de requêtes SQL et de code à l’exécution d’instructions complexes.
L’un des points forts d’Arctic est son intégration fluide avec Snowflake Data Cloud. Ce couplage étroit permet de tirer parti de l’IA directement au sein de votre infrastructure de données existante, pour une expérience à la fois sécurisée et rationalisée.
Point important, tous les modèles de la famille Snowflake Arctic sont disponibles sous licence Apache 2.0, ce qui autorise leur usage académique comme commercial.
Snowflake Arctic repose sur une architecture hybride « Dense Mixture of Experts » (MoE) basée sur des transformers, une innovation clé qui favorise la montée en charge et l’adaptabilité. Cette approche s’appuie sur un vaste réseau de 480 milliards de paramètres répartis entre 128 experts spécialisés, chacun optimisé pour des tâches spécifiques.
Cependant, tous les experts ne sont pas activés à chaque requête. Arctic utilise un mécanisme de routage « top‑2 », ne sélectionnant que les deux experts les plus pertinents pour chaque entrée, soit seulement 17 milliards de paramètres activés. Cette optimisation réduit fortement la charge de calcul tout en maintenant des performances de premier plan sur un large éventail de cas d’usage orientés entreprise.
Snowflake Arctic se démarque par quatre atouts majeurs :
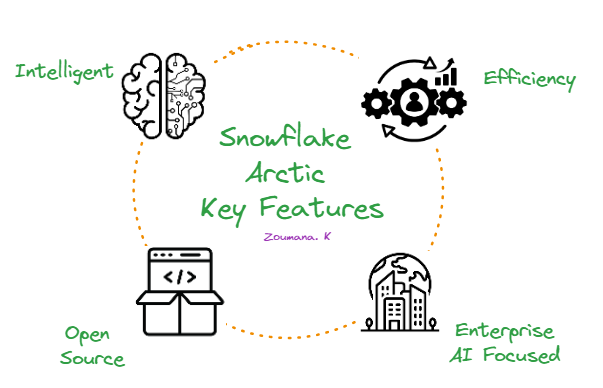
Les quatre fonctionnalités clés de Snowflake Arctic.
D’abord, il est remarquablement intelligent. Arctic excelle sur des tâches complexes comme la génération de SQL, l’écriture de code et le suivi d’instructions détaillées. Sur les benchmarks sectoriels, il surpasse régulièrement des modèles comparables, prouvant sa capacité à gérer des scénarios réels et sophistiqués.
Ensuite, Arctic est conçu pour l’efficacité. Son architecture unique lui permet d’offrir des performances de haut niveau tout en consommant moins de ressources. À la clé : des économies substantielles, attractives pour des organisations de toutes tailles.
Troisièmement, Snowflake Arctic est résolument open source. Il est disponible sous licence Apache 2.0, donnant accès au code et aux poids des modèles.
Enfin, Arctic est entièrement pensé pour l’IA d’entreprise. Il répond aux besoins spécifiques des organisations, avec des résultats de grande qualité pour l’analyse de données, l’automatisation de processus et l’aide à la décision.
Pour répondre à la diversité des besoins en IA d’entreprise, Snowflake propose deux modèles principaux au sein de la famille Arctic :
En complément des modèles principaux, Snowflake propose une famille de cinq modèles d’embedding texte sous licence Apache 2.0, tous focalisés sur les tâches de recherche d’information. Le tableau ci‑dessous illustre les performances des différents modèles Snowflake Arctic sur la tâche de recherche MTEB (Massive Text Embedding Benchmark), mesurées en NDCG@10.
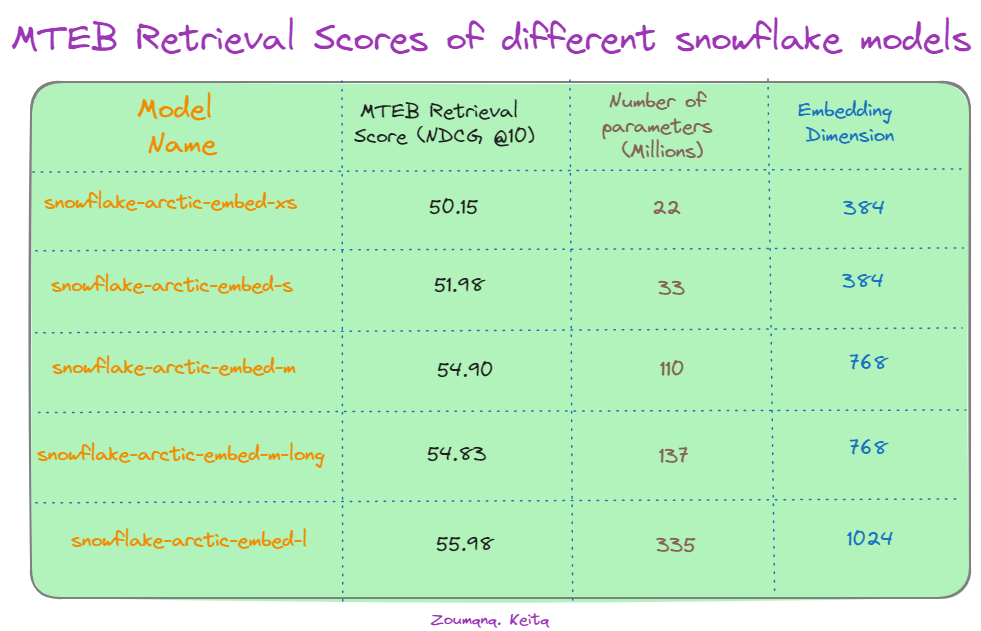
Scores MTEB (recherche) de différents modèles Snowflake. Source : Hugging Face.
On observe d’abord une tendance générale : les performances s’améliorent avec la taille du modèle. Le plus grand, « snowflake-arctic-embed-l », obtient le meilleur score NDCG@10 (55,98) avec 335 millions de paramètres et 1 024 dimensions d’embedding. Cela suggère que l’échelle du modèle joue un rôle important pour capturer des relations sémantiques fines dans les textes.
Fait intéressant, le passage de 384 à 1 024 dimensions d’embedding améliore les scores du modèle « snowflake-arctic-embed-l », soulignant l’impact de la taille d’embedding sur la précision en recherche. Exception notable : « snowflake-arctic-embed-xs ». Malgré un nombre de paramètres bien inférieur (22 millions), il rivalise avec des modèles plus grands ayant la même dimension d’embedding (384). L’efficacité du modèle et des optimisations d’architecture peuvent donc, dans certains cas, compenser un simple accroissement du nombre de paramètres.
Avant d’entrer dans l’implémentation technique, voyons le modèle à l’œuvre sur différentes tâches comme la génération SQL, le code et l’exécution d’instructions.
Depuis la démo Streamlit sur Hugging Face, vous pouvez soumettre des requêtes au modèle, ajuster ses paramètres et obtenir une réponse.
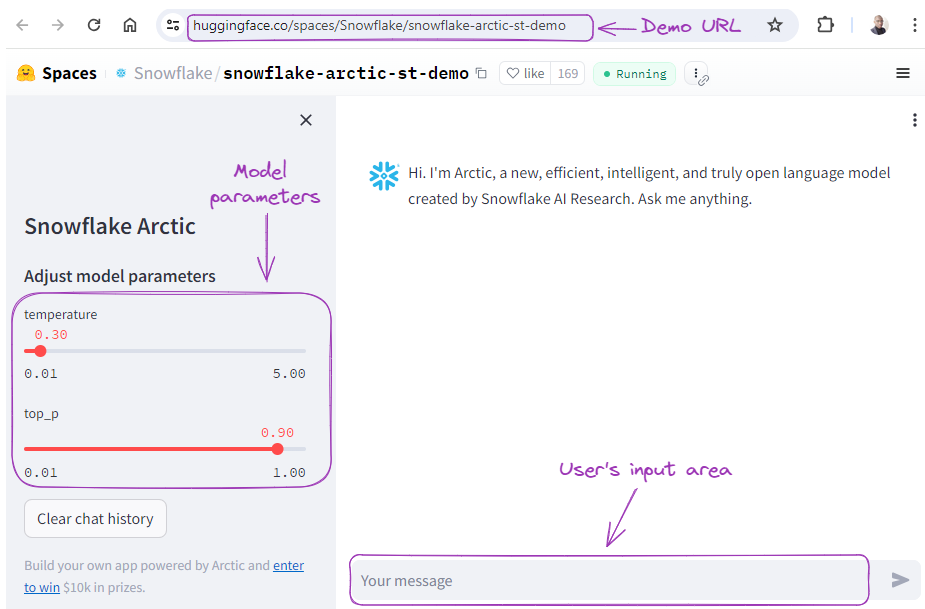
Démo Snowflake Arctic.
Commençons par demander au modèle de générer une requête SQL :
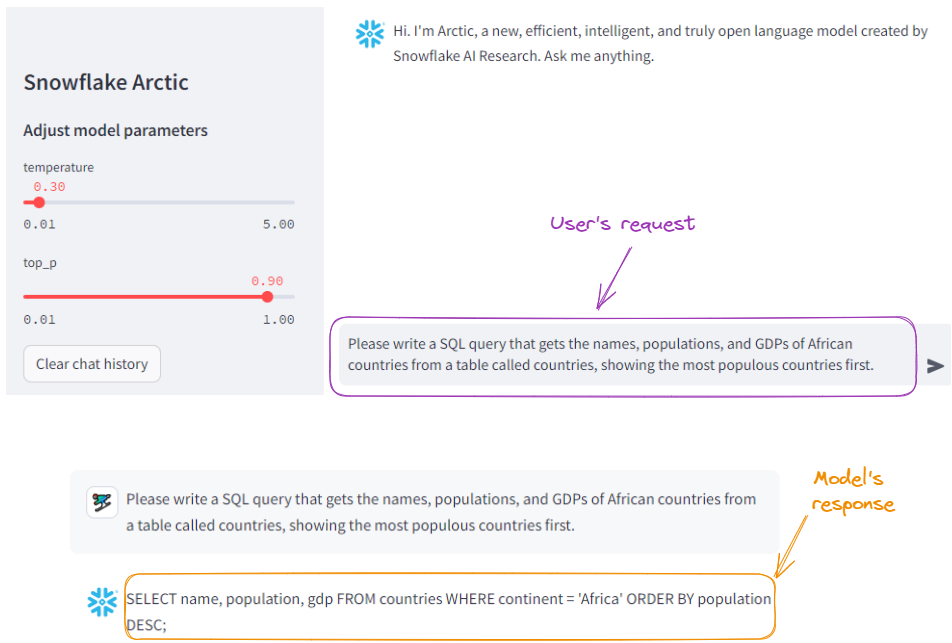
Exemple de génération SQL avec Snowflake Arctic.
Pour comparer, soumettons la même demande à ChatGPT‑4o :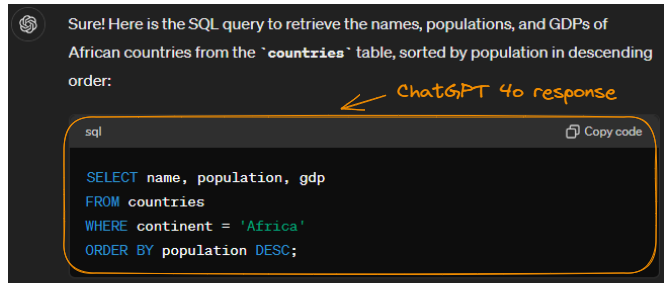
Exemple de génération SQL avec ChatGPT‑4o.
On constate que le résultat est identique (avec un formatage plus propre). Conclusion : Arctic s’en sort très bien.
Demandons maintenant à Arctic d’écrire du code Python :
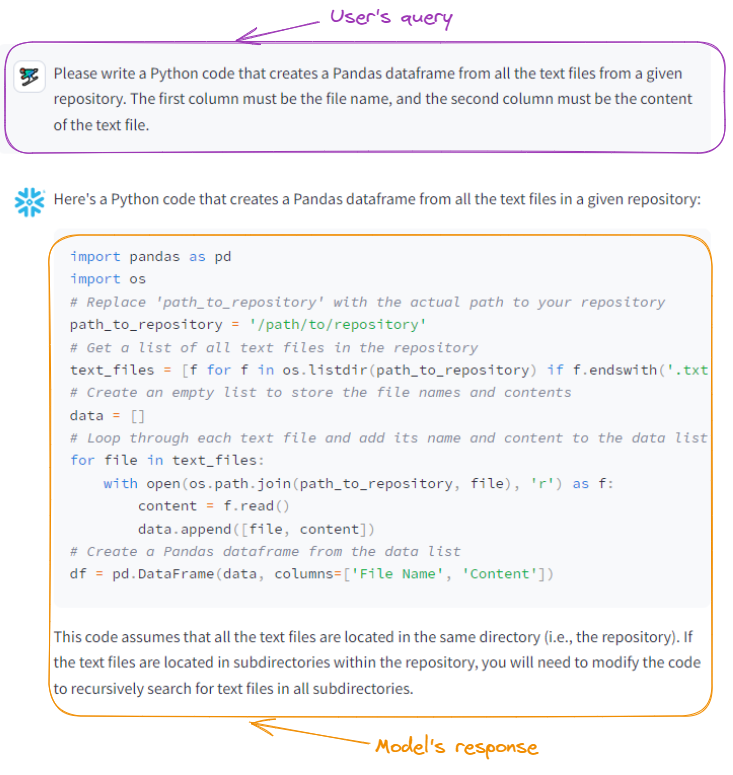
Génération de code Python avec Snowflake Arctic.
En soumettant le même prompt à ChatGPT‑4o, on obtient également un résultat correct :
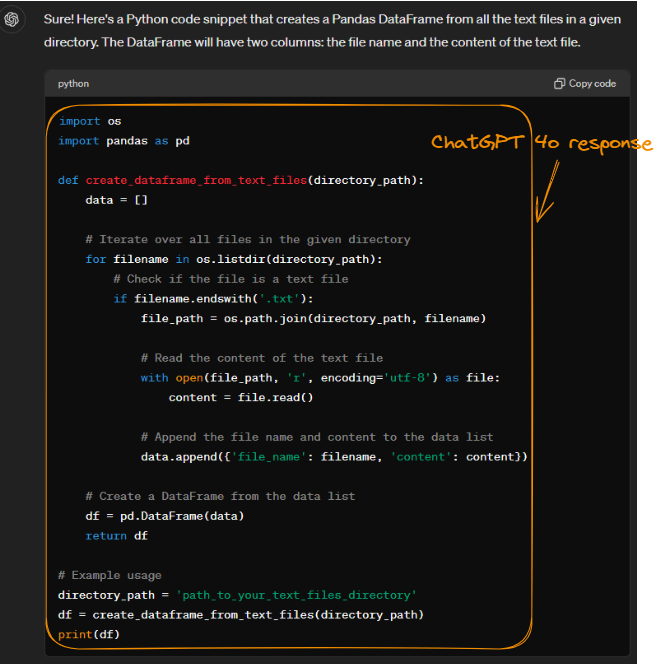
Code Python généré par ChatGPT‑4o.
Si Arctic et ChatGPT‑4o accomplissent la même tâche, leurs approches diffèrent en efficacité et en usage mémoire. Les deux modèles lisent efficacement les fichiers via os.listdir() et open().
Cependant, la création d’un DataFrame à partir d’une liste de dictionnaires par ChatGPT‑4o peut consommer légèrement plus de mémoire que l’approche d’Arctic (liste de listes), Pandas effectuant potentiellement des traitements additionnels. Malgré cette nuance, la structure modulaire du code de ChatGPT‑4o améliore la lisibilité et la maintenabilité.
Pour choisir le bon LLM, consultez ce tutoriel : LLM Classification: How to Select the Best LLM.
Maintenant que nous connaissons les capacités du modèle Snowflake Arctic, concentrons‑nous sur son accès et sa configuration.
L’usage des modèles Arctic est gourmand en ressources ; nous utiliserons donc le plus petit de la famille, snowflake‑arctic‑embed‑xs, qui requiert le moins de calcul.
Ci‑dessous, les caractéristiques de l’environnement utilisé pour ce tutoriel — affichées via la commande nvidia-smi :
!nvidia-smi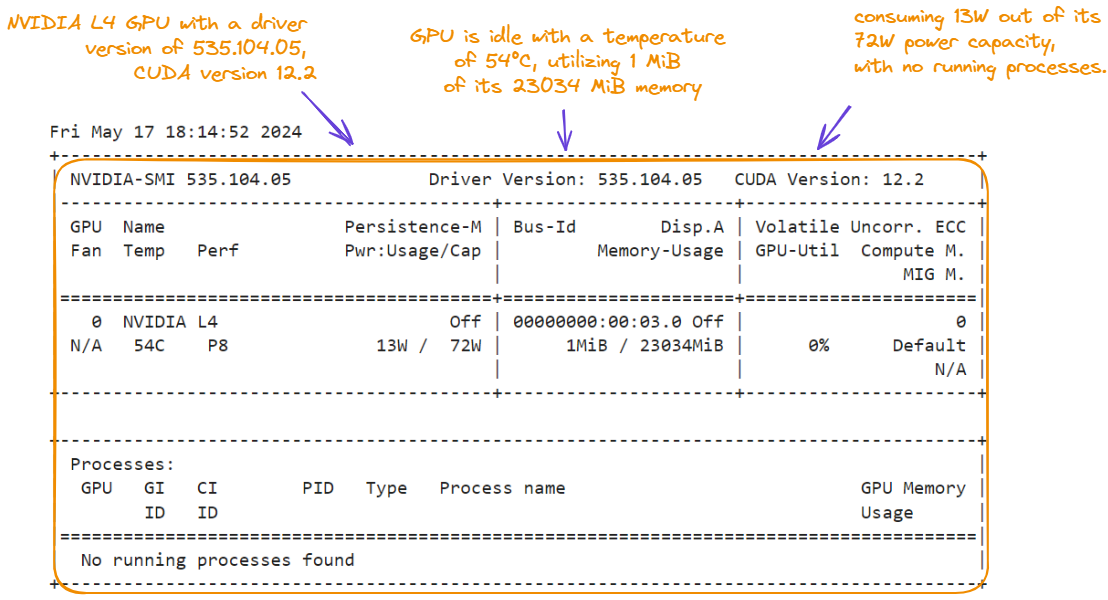
Caractéristiques GPU pour le tutoriel Snowflake Arctic.
En plus du GPU NVIDIA L4, l’environnement présente les caractéristiques suivantes, visibles dans la section Resources :
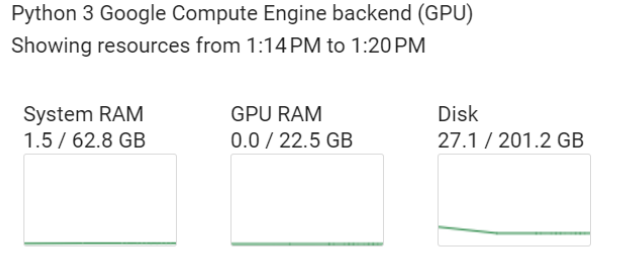
Caractéristiques du backend du moteur de calcul.
Deux bibliothèques principales sont nécessaires pour ce tutoriel pratique : torch et transformers (nous exécutons le code ci‑dessous depuis un notebook) :
%%bash
pip -qqq install transformers>=4.39.0
pip -qqq install torch
Nous importons ensuite les sous‑bibliothèques nécessaires :
import torch
from transformers import AutoTokenizer, AutoModel
from torch.nn.functional import cosine_similarityPoursuivons en chargeant le modèle d’embedding snowflake‑arctic‑embed‑xs et son tokenizer correspondant :
model_checkpoint = "Snowflake/snowflake-arctic-embed-xs"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = AutoModel.from_pretrained(model_checkpoint, add_pooling_layer=False)
Nous chargeons le modèle pré‑entraîné indiqué par model_checkpoint sans couche de pooling additionnelle, généralement utilisée pour réduire la dimension de la sortie du modèle.
Une fois l’environnement prêt, l’objectif ici est de retrouver les N documents les plus similaires à un document donné, avec leurs scores de similarité cosinus. Pour cela, nous suivons cinq étapes :
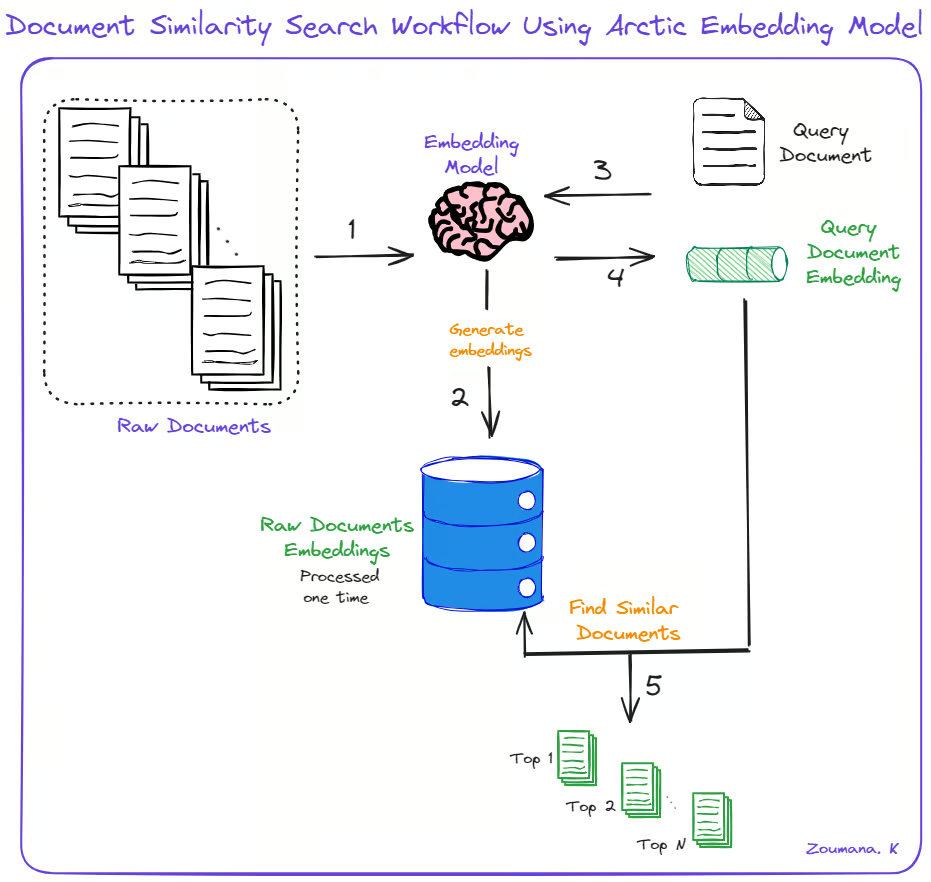
Recherche de similarité de documents avec Snowflake Arctic.
Nous pouvons implémenter ces étapes via deux fonctions utilitaires : generate_embedding() et find_similar_documents().
def generate_embedding(document):
    inputs = tokenizer(document, padding=True, truncation=True,
                       return_tensors='pt', max_length=512)

    embedding = model(**inputs)[0][:, 0]
    return embedding


def find_similar_documents(query_document, document_embeddings , top_n=5):

    query_embedding = generate_embedding(query_document)

    similarity_scores = [cosine_similarity(query_embedding,
                                           doc_embedding).item() for doc_embedding in document_embeddings]

    sorted_indices = torch.argsort(torch.tensor(similarity_scores),
                                   descending=True)

    top_documents = [documents[idx] for idx in sorted_indices[:top_n]]
    top_scores = [similarity_scores[idx] for idx in sorted_indices[:top_n]]

    return top_documents, top_scores
La fonction generate_embedding() prend un document en entrée et génère son embedding. La fonction find_similar_documents() prend un document de requête, les embeddings des documents existants et le nombre de documents similaires à retourner.
Pour simplifier, nous utilisons cinq exemples faciles :
documents = [
    "This is a tutorial about Snowflake Arctic Embedding models",
    "Arctic-embed is a state-of-the-art text embedding model.",
    "Snowflake provides various cloud data warehousing solutions.",
    "Embedding models are used for representing text as dense vectors.",
    "The Arctic-embed model is based on the transformer architecture."
]
Générons ensuite les embeddings :
document_embeddings = [generate_embedding(doc) for doc in documents]Choisissons « What is the Arctic-embed model? » comme document de requête et cherchons les documents proches :
query_document = "What is the Arctic-embed model?"
top_documents, top_scores = find_similar_documents(query_document, document_embeddings)
Enfin, parcourons les meilleurs documents pour afficher leur contenu et leur score de similarité avec la requête.
print("Query Document:")
print(query_document)
print("\nTop Similar Documents:")
for doc, score in zip(top_documents, top_scores):
    print(f"Document: {doc}")
    print(f"Similarity Score: {score:.4f}")
    print()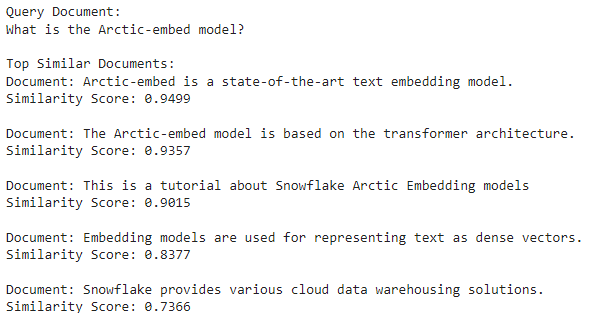
Le deuxième document est le plus similaire car il présente le score de similarité cosinus le plus élevé (94,99 %).
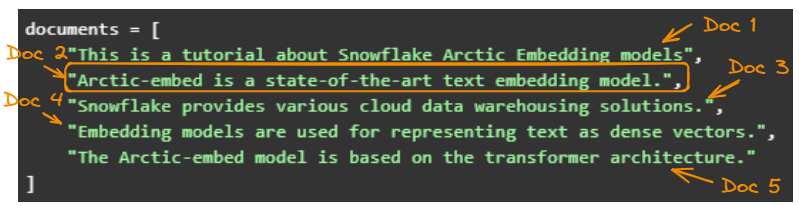
Les cinq documents d’origine.
En visualisant les documents dans un espace 3D, on distingue mieux les éléments les plus proches.
Les embeddings d’origine ont 512 dimensions, impossibles à visualiser directement. La manière la plus simple consiste à réduire la dimension par ACP (analyse en composantes principales). Pour en savoir plus, consultez ce tutoriel : Principal Component Analysis (PCA) in Python.
Avant d’utiliser l’ACP, modifions la fonction find_similar_documents() pour qu’elle retourne également les embeddings, dont l’ACP aura besoin.
def find_similar_documents(query_document, documents, top_n=5):
    query_embedding = generate_embedding(query_document)
    document_embeddings = [generate_embedding(doc) for doc in documents]

    similarity_scores = [cosine_similarity(query_embedding, doc_embedding).item() for doc_embedding in document_embeddings]
    sorted_indices = torch.argsort(torch.tensor(similarity_scores), descending=True)

    top_documents = [documents[idx] for idx in sorted_indices[:top_n]]
    top_scores = [similarity_scores[idx] for idx in sorted_indices[:top_n]]

    return top_documents, top_scores, document_embeddings
Importons également quelques modules nécessaires à la visualisation.
from sklearn.decomposition import PCA
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D
Créons maintenant la visualisation 3D en :
top_documents, top_scores, document_embeddings = find_similar_documents(query_document, documents)

# Reshape the embeddings
reshaped_embeddings = torch.stack(document_embeddings).detach().numpy()
reshaped_embeddings = reshaped_embeddings.reshape(reshaped_embeddings.shape[0], -1)

# Apply PCA to reduce the embeddings to 3 dimensions
pca = PCA(n_components=3)
reduced_embeddings = pca.fit_transform(reshaped_embeddings)

# Create a 3D plot
fig = plt.figure(figsize=(8, 6))
ax = fig.add_subplot(111, projection='3d')

# Plot the document embeddings
for i, doc in enumerate(documents):
    ax.scatter(reduced_embeddings[i, 0], reduced_embeddings[i, 1], reduced_embeddings[i, 2], marker='o', label=f"Document {i+1}")

# Plot the query document embedding
query_embedding = generate_embedding(query_document)
reshaped_query_embedding = query_embedding.detach().numpy().reshape(1, -1)
reduced_query_embedding = pca.transform(reshaped_query_embedding)
ax.scatter(reduced_query_embedding[0, 0], reduced_query_embedding[0, 1],
           reduced_query_embedding[0, 2], marker='*', s=100, color='red',
           label="Query Document")

ax.set_xlabel('PC1')
ax.set_ylabel('PC2')
ax.set_zlabel('PC3')
ax.legend()
plt.title('Document Embeddings in 3D Space')
plt.show()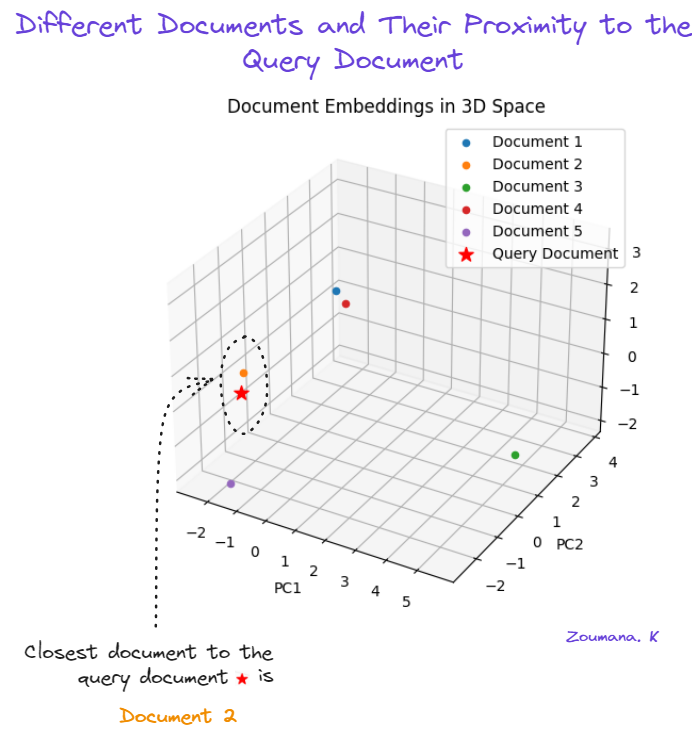
Visualiser la similarité des documents avec l’ACP.
Le deuxième document (orange) est le plus proche du document de requête (étoile rouge). Le cinquième (violet) est le second plus proche, tandis que le troisième (vert) est le plus éloigné.
Les notebooks sont redoutables pour l’expérimentation et la visualisation rapide, ce qui explique leur popularité auprès des data scientists et chercheurs. En revanche, pour déployer des modèles ou des applications en production, ce ne sont pas toujours les plus adaptés. C’est là que Streamlit intervient.
Streamlit est une bibliothèque Python qui facilite la création d’applications web interactives pour des projets de data science et de machine learning. Elle permet de transformer facilement vos projets en applications prêtes pour la production, sans expertise web poussée.
Voici la page d’accueil de ce que nous allons construire dans cette section.
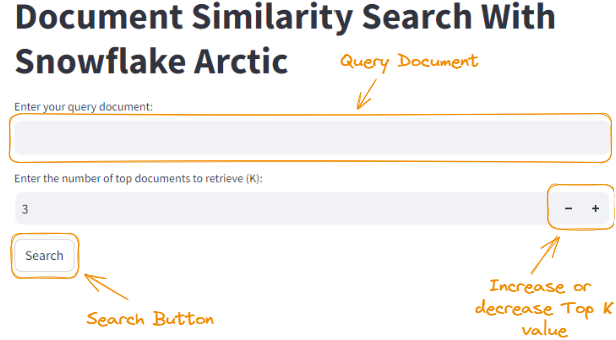
Page d’accueil de l’application Streamlit.
L’apprentissage de Streamlit dépasse le cadre de ce tutoriel, mais vous pouvez partir de zéro avec ce guide : Python Tutorial: Streamlit.
Dans cette section, nous allons voir comment créer avec Streamlit une application web pour notre projet de recherche de similarité de documents. Pour exécuter une application Streamlit, le code doit être dans un fichier Python (extension .py) et la commande suivante doit être lancée dans le terminal :
streamlit run app.pyAu préalable, il faut installer Streamlit via pip :
pip install streamlitLe code utilisé pour créer l’application est un peu long ; prenez le temps de l’examiner. Nous l’expliquons également après le bloc.
import streamlit as st
from transformers import AutoTokenizer, AutoModel
import torch
from torch.nn.functional import cosine_similarity
from sklearn.decomposition import PCA
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D


model_checkpoint = "Snowflake/snowflake-arctic-embed-xs"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = AutoModel.from_pretrained(model_checkpoint, add_pooling_layer=False)


def generate_embedding(document):
    inputs = tokenizer(document, padding=True, truncation=True, return_tensors='pt', max_length=512)
    embedding = model(**inputs)[0][:, 0]
    return embedding


def find_similar_documents(query_document, documents, top_n=5):
    query_embedding = generate_embedding(query_document)
    document_embeddings = [generate_embedding(doc) for doc in documents]


    similarity_scores = [cosine_similarity(query_embedding, doc_embedding).item() for doc_embedding in document_embeddings]
    sorted_indices = torch.argsort(torch.tensor(similarity_scores), descending=True)


    top_documents = [documents[idx] for idx in sorted_indices[:top_n]]
    top_scores = [similarity_scores[idx] for idx in sorted_indices[:top_n]]


    return top_documents, top_scores, document_embeddings


# Sample documents
documents = [
    "This is a tutorial about Snowflake Arctic Embedding models",
    "Arctic-embed is a state-of-the-art text embedding model.",
    "Snowflake provides various cloud data warehousing solutions.",
    "Embedding models are used for representing text as dense vectors.",
    "The Arctic-embed model is based on the transformer architecture."
]


# Streamlit app
st.title("Document Similarity Search With Snowflake Arctic")


query_document = st.text_input("Enter your query document:")
top_k = st.number_input("Enter the number of top documents to retrieve (K):", min_value=1, value=3, step=1)


if st.button("Search"):
    top_documents, top_scores, document_embeddings = find_similar_documents(query_document, documents, top_n=top_k)


    st.subheader("Top {} Similar Documents:".format(top_k))
    for i, (doc, score) in enumerate(zip(top_documents, top_scores)):
        st.write("{}. Document: {}".format(i+1, doc))
        st.write("   Similarity Score: {:.4f}".format(score))


    # Reshape the embeddings
    reshaped_embeddings = torch.stack(document_embeddings).detach().numpy()
    reshaped_embeddings = reshaped_embeddings.reshape(reshaped_embeddings.shape[0], -1)


    # Apply PCA to reduce the embeddings to 3 dimensions
    pca = PCA(n_components=3)
    reduced_embeddings = pca.fit_transform(reshaped_embeddings)


    # Create a 3D plot
    fig = plt.figure(figsize=(8, 6))
    ax = fig.add_subplot(111, projection='3d')


    # Plot the document embeddings
    for i, doc in enumerate(documents):
        ax.scatter(reduced_embeddings[i, 0], reduced_embeddings[i, 1], reduced_embeddings[i, 2], marker='o', label=f"Document {i+1}")


    # Plot the query document embedding
    query_embedding = generate_embedding(query_document)
    reshaped_query_embedding = query_embedding.detach().numpy().reshape(1, -1)
    reduced_query_embedding = pca.transform(reshaped_query_embedding)
    ax.scatter(reduced_query_embedding[0, 0], reduced_query_embedding[0, 1], reduced_query_embedding[0, 2], marker='*', s=100, color='red', label="Query Document")


    ax.set_xlabel('PC1')
    ax.set_ylabel('PC2')
    ax.set_zlabel('PC3')
    ax.legend()
    plt.title('Document Embeddings in 3D Space')


    st.pyplot(fig)
Avec ce code, nous avons créé une application Streamlit intitulée « Document Similarity Search With Snowflake Arctic ». Quelques remarques :
st.text_input() et de définir le nombre K de documents à récupérer via st.number_input().st.button("Search")), la fonction find_similar_documents() est appelée avec le document de requête, la liste des documents et la valeur top_k.st.subheader() et st.write().st.pyplot(fig).La partie Streamlit se concentre sur une interface interactive où l’on peut saisir une requête, choisir le nombre de documents similaires à afficher et visualiser les résultats, avec une représentation 3D des embeddings.
Le code complet de l’article est disponible dans ce Jupyter Notebook.
Lancez l’application avec la commande streamlit run app.py pour accéder à la page d’accueil. En fournissant le même document de requête et en définissant Top K à 3, on obtient le résultat suivant :
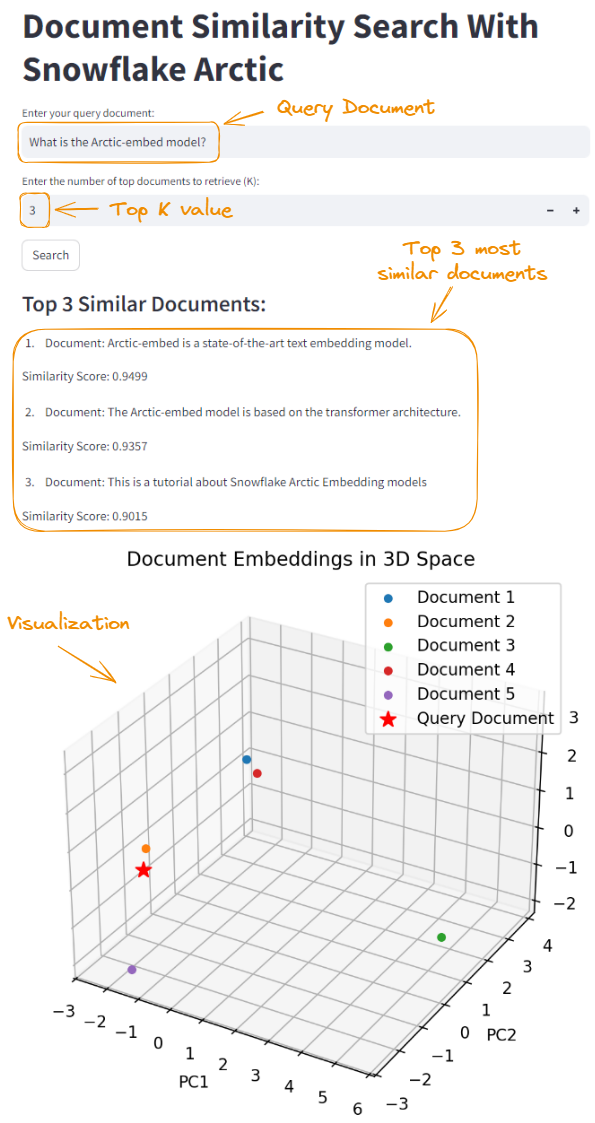
Intégration de Snowflake Arctic avec Streamlit.
Avec des LLM comme Arctic, il est essentiel de tester et valider les configurations dans votre environnement cible pour garantir performance et fiabilité. Voici quelques pistes à garder en tête :
Pour garantir des performances optimales et une utilisation fluide de Snowflake Arctic, il est crucial d’appliquer les bonnes pratiques et d’anticiper le dépannage. Dans cette section, nous partageons des conseils issus de benchmarks et de la recherche académique.
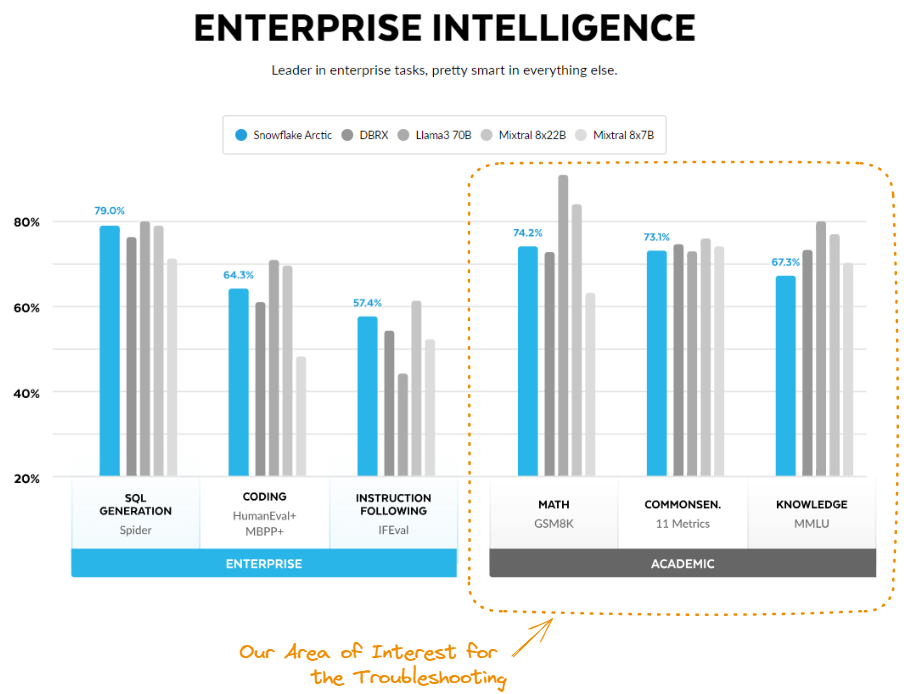
Source : Arctic Cloud.
Voici quelques pistes pour renforcer les capacités :
Snowflake Arctic se distingue en inférence comme en entraînement. Côté inférence, il offre systématiquement un excellent ratio performance/coût par rapport à d’autres modèles. Cette efficacité augmente avec le nombre de paramètres activés, conservant un avantage marqué autour de 60 milliards de paramètres actifs, devant des concurrents comme Mixtral et Llama 3.
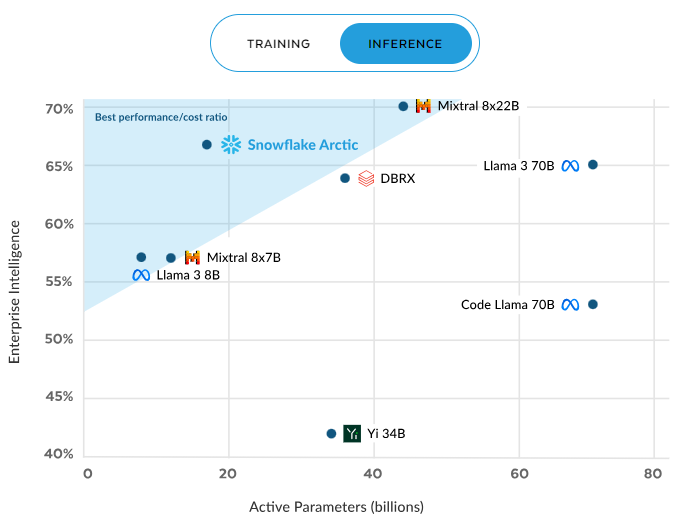
Efficacité en inférence d’Arctic. Source : Snowflake.com.
La tendance se confirme à l’entraînement, où Arctic affiche de nouveau le meilleur ratio performance/coût. Cette efficacité s’accroît avec la puissance de calcul, atteignant environ 70 % à 16× compute, largement au‑dessus de modèles comme DBRX, Llama 3, Code Llama ou Yi. En somme, Arctic offre des performances de haut niveau pour une fraction du coût, un atout de taille pour les entreprises soucieuses de leurs ressources.
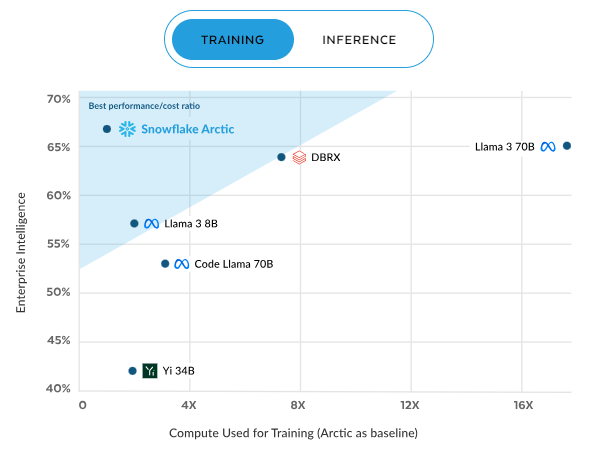
Efficacité à l’entraînement d’Arctic. Source : Snowflake.com.
Quelques conseils pour optimiser les performances en inférence et à l’entraînement (liste non exhaustive) :
Les excellentes performances et l’efficacité coût d’Arctic redéfinissent les standards des modèles de langage. Les évolutions à venir pourraient inclure une compréhension du langage renforcée, un apprentissage multi‑tâches amélioré et un meilleur support des applications métiers spécifiques. Au fil des innovations de Snowflake, attendez‑vous à des outils encore plus puissants et polyvalents.
Snowflake propose une communauté dynamique et des ressources d’accompagnement complètes. Les utilisateurs peuvent échanger et apprendre sur les forums de la communauté Snowflake. Une documentation détaillée et des tutoriels sont disponibles sur le site officiel pour vous aider à exploiter au mieux les fonctionnalités d’Arctic.
Snowflake Arctic change la donne dans le domaine des embeddings de texte, avec une solution puissante et efficace pour les entreprises qui souhaitent libérer tout le potentiel de leurs données. Grâce à son intégration fluide à Snowflake Data Cloud et à une architecture scalable, c’est un choix idéal pour rationaliser la recherche et l’analyse de données.
Dans ce guide, nous avons exploré les capacités clés de Snowflake Arctic : de sa mise en place et sa configuration à des techniques d’intégration avancées et des applications concrètes. En tirant parti de ses fonctionnalités et optimisations de performance, les entreprises gagnent en efficacité et en précision sur leurs opérations d’embedding texte.
Pour approfondir Snowflake, consultez ce Snowflake Tutorial for Beginners.
En savoir plus sur les LLM !
Cours
Cours
Cours