Tutorial su Snowflake Arctic: iniziare con l'LLM di Snowflake
Snowflake Arctic è una famiglia di modelli linguistici di livello enterprise progettati per semplificare l'integrazione e la distribuzione dell'AI all'interno dello Snowflake Data Cloud.
Snowflake Arctic è uno sviluppo innovativo nel campo delle text embeddings, che offre un potente set di strumenti pensati per semplificare l’adozione dell’AI sui dati aziendali.
In questo tutorial, forniremo una panoramica di Snowflake Arctic, affronteremo il processo di configurazione, esploreremo le tecniche di integrazione e condivideremo best practice e suggerimenti di troubleshooting. Mostreremo anche casi d’uso reali, parleremo degli sviluppi futuri e indicheremo risorse per supporto e apprendimento continuo.
Se vuoi saperne di più su Snowflake, dai un’occhiata a questo corso di Introduzione a Snowflake.
Che cos’è Snowflake Arctic?
Dunque, che cos’è esattamente Snowflake Arctic? È una suite completa di strumenti progettati per semplificare l’integrazione e la distribuzione dell’AI all’interno dello Snowflake Data Cloud. Al suo cuore, Snowflake Arctic offre una raccolta di modelli di embedding che ci permettono di estrarre in modo efficiente insight di valore dai nostri dati.
Include inoltre un Large Language Model (LLM) generico e versatile, capace di affrontare un’ampia gamma di attività, dalla generazione di query SQL e codice di programmazione al follow-up di istruzioni complesse.
Una delle caratteristiche distintive di Arctic è la sua integrazione perfetta con lo Snowflake Data Cloud. Questo legame stretto ci permette di sfruttare la potenza dell’AI direttamente all’interno dell’infrastruttura dati esistente, garantendo un’esperienza sicura e lineare.
È importante sottolineare che tutti i modelli della famiglia Snowflake Arctic sono disponibili con licenza Apache 2.0, permettendone l’uso sia per scopi accademici che commerciali.
Architettura e prestazioni
Snowflake Arctic ha tre componenti principali:
Componenti di Snowflake Arctic.
L’architettura di Snowflake Arctic si basa su un design ibrido transformer Dense Mixture of Experts (MoE), un’innovazione chiave che consente scalabilità ed adattabilità efficienti. Questo approccio sfrutta una vasta rete di 480 miliardi di parametri distribuiti su 128 esperti specializzati, ciascuno ottimizzato per compiti specifici.
Tuttavia, non tutti gli esperti vengono attivati per ogni query. Arctic impiega un meccanismo di gating top-2, selezionando solo i due esperti più rilevanti per ciascun input, attivando così appena 17 miliardi di parametri. Questa ottimizzazione riduce significativamente l’onere computazionale mantenendo prestazioni di alto livello su un’ampia gamma di task orientati all’impresa.
Caratteristiche principali
Snowflake Arctic si distingue per le seguenti quattro caratteristiche chiave:
Le quattro caratteristiche chiave di Snowflake Arctic.
Prima di tutto, è straordinariamente intelligente. Arctic eccelle in compiti complessi come generare query SQL, scrivere codice e seguire istruzioni dettagliate. Nei benchmark di settore, supera costantemente modelli simili, dimostrando la capacità di gestire scenari reali intricati.
In secondo luogo, Arctic è progettato per l’efficienza. La sua architettura unica gli consente di offrire prestazioni di alto livello consumando meno risorse computazionali. Questo si traduce in notevoli risparmi, rendendolo un’opzione interessante per organizzazioni di ogni dimensione.
In terzo luogo, Snowflake Arctic abbraccia l’open source. È disponibile con licenza Apache 2.0, garantendo a tutti l’accesso al suo codice e ai pesi del modello.
Infine, Arctic è focalizzato sull’enterprise AI. È costruito appositamente per rispondere alle esigenze specifiche delle aziende, offrendo risultati di alta qualità per attività come analisi dei dati, automazione dei processi e supporto alle decisioni.
Modelli Snowflake Arctic
Per soddisfare le diverse esigenze di AI aziendale, Snowflake ha introdotto due modelli principali all’interno della famiglia Snowflake Arctic:
Snowflake Arctic Instruct: Questa variante eccelle nel generare risposte di alta qualità a partire da prompt in linguaggio naturale.
Snowflake Arctic Base: Questa versione funge da modello linguistico fondamentale e versatile, utilizzabile in varie applicazioni senza necessità di ulteriore fine-tuning.
Modelli di text embedding Snowflake Arctic
Oltre ai modelli principali, Snowflake offre una famiglia di cinque modelli di text embedding con licenza Apache 2.0—tutti focalizzati su task di information retrieval. La tabella sotto illustra le prestazioni dei vari modelli Snowflake Arctic sul task di retrieval del Massive Text Embedding Benchmark (MTEB), misurate con NDCG@10.
Punteggi di retrieval MTEB di diversi modelli Snowflake. Fonte: Hugging Face.
Per prima cosa, notiamo una tendenza generale al miglioramento delle prestazioni all’aumentare della dimensione del modello. Il modello più grande, "snowflake-arctic-embed-l", ottiene il punteggio NDCG@10 più alto pari a 55,98, utilizzando 335 milioni di parametri e 1024 dimensioni di embedding. Questo suggerisce che la scala del modello gioca un ruolo significativo nel catturare relazioni semantiche complesse all’interno dei testi.
È interessante notare che l’aumento della dimensione dell’embedding da 384 a 1024 porta a punteggi migliori per il modello "snowflake-arctic-embed-l", evidenziando l’impatto della dimensione dell’embedding sull’accuratezza del retrieval. Tuttavia, un’eccezione degna di nota è il modello "snowflake-arctic-embed-xs". Nonostante abbia molti meno parametri (22 milioni), si comporta in modo comparabile a modelli più grandi con la stessa dimensione di embedding di 384. Ciò suggerisce che l’efficienza del modello e le ottimizzazioni architetturali possano compensare, in alcuni scenari, i benefici del semplice numero di parametri.
Snowflake Arctic: Demo
Prima di sporcarci le mani con l’implementazione tecnica, vediamo il modello in azione su diversi compiti come generazione SQL, coding e follow-up di istruzioni.
Dalla demo Streamlit su Hugging Face, possiamo fornire al modello delle richieste, regolare i parametri del modello e ottenere una risposta.
Demo di Snowflake Arctic.
Chiediamo innanzitutto al modello di generare una query SQL:
Esempio di generazione SQL con Snowflake Arctic.
Per confronto, inviamo la stessa richiesta a ChatGPT-4o:
Esempio di generazione SQL con ChatGPT-4o.
Nota che è stato generato lo stesso risultato (con una formattazione più pulita). Possiamo concludere che Arctic ha fatto un buon lavoro.
Chiediamo ora ad Arctic di scrivere del codice Python:
Snowflake Arctic genera codice Python.
Fornendo lo stesso prompt a ChatGPT-4o, otteniamo il seguente risultato, anch’esso corretto:
Codice Python generato da ChatGPT-4o.
Sebbene sia Arctic che ChatGPT-4o svolgano lo stesso compito, i loro approcci differiscono per efficienza e uso della memoria. Entrambi i modelli leggono i file in modo efficiente usando os.listdir() e open().
Tuttavia, l’approccio di ChatGPT-4o di creare un DataFrame da una lista di dizionari potrebbe consumare leggermente più memoria rispetto al metodo di Arctic che usa una lista di liste. Questo perché Pandas può eseguire elaborazioni aggiuntive per gestire i dizionari. Nonostante questa piccola differenza, la struttura modulare del codice di ChatGPT-4o migliora leggibilità e manutenibilità.
Ora che conosciamo le capacità del modello Snowflake Arctic, concentriamoci su come accedere e configurare Snowflake Arctic.
Caratteristiche dell’ambiente
L’uso dei modelli Arctic è intensivo in termini di risorse, quindi useremo il più piccolo della famiglia, snowflake-arctic-embed-xs, che richiede il minor numero di risorse computazionali.
Di seguito vediamo le caratteristiche dell’ambiente che stiamo usando per questo tutorial—le mostriamo eseguendo il comando nvidia-smi:
Caratteristiche GPU per il tutorial su Snowflake Arctic.
Oltre alla GPU NVIDIA L4, l’ambiente ha le seguenti caratteristiche, che si trovano nella sezione Resources:
62,8 GB di RAM di sistema
22,5 GB di RAM GPU
201,2 GB di disco
Caratteristiche del backend del motore di calcolo.
Installazione delle librerie
Per questo tutorial pratico servono due librerie principali: torch e transformers (eseguiamo il codice seguente da un notebook):
%%bash
pip -qqq install transformers>=4.39.0
pip -qqq install torchOfferto da
Importiamo poi le sottolibrerie necessarie:
import torch
from transformers import AutoTokenizer, AutoModel
from torch.nn.functional import cosine_similarityOfferto da
Caricare il modello e il tokenizer
Proseguiamo caricando il modello di embedding snowflake-arctic-embed-xs e il tokenizer corrispondente:
model_checkpoint ="Snowflake/snowflake-arctic-embed-xs"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = AutoModel.from_pretrained(model_checkpoint, add_pooling_layer=False)Offerto da
Carichiamo il modello pre-addestrato specificato da model_checkpoint senza un ulteriore livello di pooling, usato per ridurre la dimensionalità dell’output del modello.
Ricerca di similarità tra documenti con Snowflake Arctic
Con tutti i requisiti configurati correttamente, il caso d’uso principale di questa sezione è trovare i N documenti più simili a un dato documento, insieme ai loro punteggi di similarità coseno. Per farlo, seguiamo questi cinque passaggi principali:
Usando il modello di embedding, generiamo gli embedding per i documenti grezzi iniziali.
Per un documento di query, generiamo il suo embedding usando lo stesso modello di embedding.
Calcoliamo le similarità tra l’embedding della query e quelli dei documenti.
Restituiamo i primi N documenti più simili insieme ai loro punteggi di similarità.
Ricerca di similarità tra documenti con Snowflake Arctic.
Possiamo implementare i passaggi sopra usando queste funzioni di supporto: generate_embedding() e find_similar_documents().
La funzione generate_embedding() prende un documento in input e ne genera l’embedding. La find_similar_documents() accetta un documento di query, gli embedding dei documenti esistenti e il numero desiderato di documenti simili da restituire.
Per semplicità, usiamo cinque esempi elementari:
documents =["This is a tutorial about Snowflake Arctic Embedding models","Arctic-embed is a state-of-the-art text embedding model.","Snowflake provides various cloud data warehousing solutions.","Embedding models are used for representing text as dense vectors.","The Arctic-embed model is based on the transformer architecture."]Offerto da
Quindi generiamo gli embedding:
document_embeddings =[generate_embedding(doc)for doc in documents]Offerto da
Scegliamo “What is the Arctic-embed model?” come documento di query e troviamo i documenti simili:
query_document ="What is the Arctic-embed model?"
top_documents, top_scores =find_similar_documents(query_document, document_embeddings)Offerto da
Infine, cicliamo su tutti i documenti top per stampare il contenuto del documento e il suo punteggio di similarità con il documento di query.
print("Query Document:")print(query_document)print("\nTop Similar Documents:")for doc, score inzip(top_documents, top_scores):print(f"Document: {doc}")print(f"Similarity Score: {score:.4f}")print()Offerto da
Il secondo documento è il più simile perché ha il punteggio di similarità coseno più alto (94,99%).
I cinque documenti originali.
Visualizzazione 3D dei documenti
Quando visualizziamo i documenti in uno spazio 3D, possiamo vedere quali sono più vicini tra loro.
Gli embedding originali hanno 512 dimensioni, impossibili da visualizzare. Il modo più semplice è ridurre le dimensioni usando la Principal Component Analysis (PCA). Se vuoi saperne di più sulla PCA, dai un’occhiata a questo tutorial su Principal Component Analysis (PCA) in Python.
Prima di usare la PCA, dobbiamo modificare la funzione find_similar_documents() in modo che restituisca gli embedding dei documenti che la PCA utilizzerà.
def find_similar_documents(query_document, documents, top_n=5):
query_embedding =generate_embedding(query_document)
document_embeddings =[generate_embedding(doc)for doc in documents]
similarity_scores =[cosine_similarity(query_embedding, doc_embedding).item()for doc_embedding in document_embeddings]
sorted_indices = torch.argsort(torch.tensor(similarity_scores), descending=True)
top_documents =[documents[idx]for idx in sorted_indices[:top_n]]
top_scores =[similarity_scores[idx]for idx in sorted_indices[:top_n]]return top_documents, top_scores, document_embeddingsOfferto da
Importiamo anche alcuni moduli necessari per generare la visualizzazione.
from sklearn.decomposition importPCAimport matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3DOfferto da
Ora creiamo la visualizzazione 3D:
Ridimensioniamo gli embedding per adattarli al formato di input della PCA.
Riduciamo gli embedding a tre dimensioni.
Creiamo una visualizzazione 3D degli embedding ridotti.
top_documents, top_scores, document_embeddings =find_similar_documents(query_document, documents)
# Reshape the embeddings
reshaped_embeddings = torch.stack(document_embeddings).detach().numpy()
reshaped_embeddings = reshaped_embeddings.reshape(reshaped_embeddings.shape[0],-1)
# Apply PCA to reduce the embeddings to 3 dimensions
pca =PCA(n_components=3)
reduced_embeddings = pca.fit_transform(reshaped_embeddings)
# Create a 3D plot
fig = plt.figure(figsize=(8,6))
ax = fig.add_subplot(111, projection='3d')
# Plot the document embeddings
for i, doc inenumerate(documents):
ax.scatter(reduced_embeddings[i,0], reduced_embeddings[i,1], reduced_embeddings[i,2], marker='o', label=f"Document {i+1}")
# Plot the query document embedding
query_embedding =generate_embedding(query_document)
reshaped_query_embedding = query_embedding.detach().numpy().reshape(1,-1)
reduced_query_embedding = pca.transform(reshaped_query_embedding)
ax.scatter(reduced_query_embedding[0,0], reduced_query_embedding[0,1],
reduced_query_embedding[0,2], marker='*', s=100, color='red',
label="Query Document")
ax.set_xlabel('PC1')
ax.set_ylabel('PC2')
ax.set_zlabel('PC3')
ax.legend()
plt.title('Document Embeddings in 3D Space')
plt.show()Offerto da
Uso della PCA per visualizzare la similarità tra documenti.
Il secondo documento (arancione) è il più vicino al documento di query (stella rossa). Il quinto documento (viola) è il secondo più vicino, mentre il terzo documento (verde) è il più distante.
Integrazione di Snowflake Arctic con Streamlit
I notebook sono strumenti potenti per la sperimentazione e la visualizzazione rapida, molto apprezzati da data scientist e ricercatori. Tuttavia, potrebbero non essere la scelta più adatta quando si tratta di distribuire modelli o applicazioni in ambienti di produzione. Qui entra in gioco Streamlit.
Streamlit è una libreria Python che facilita lo sviluppo di applicazioni web interattive per progetti di data science e machine learning. Rende semplice trasformare progetti di data science in applicazioni pronte per la produzione senza una grande esperienza di sviluppo web.
Di seguito la landing page di ciò che costruiremo in questa sezione.
La landing page dell’applicazione Streamlit.
Insegnare Streamlit esula dallo scopo di questo tutorial, ma puoi impararlo da zero in questo Python Tutorial: Streamlit.
Tecniche di integrazione di base
In questa sezione vedremo come usare Streamlit per creare un’app web per il nostro progetto di ricerca di similarità tra documenti. Per eseguire un’applicazione Streamlit, il codice deve essere in un file Python (con estensione .py) ed eseguire il seguente comando nel terminale:
Il codice che abbiamo usato per costruire l’applicazione Streamlit è un po’ lungo, quindi prenditi il tempo per esaminarlo. Lo spiegheremo anche dopo il blocco di codice.
import streamlit as st
from transformers import AutoTokenizer, AutoModel
import torch
from torch.nn.functional import cosine_similarity
from sklearn.decomposition importPCAimport matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D
model_checkpoint ="Snowflake/snowflake-arctic-embed-xs"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = AutoModel.from_pretrained(model_checkpoint, add_pooling_layer=False)
def generate_embedding(document):
inputs =tokenizer(document, padding=True, truncation=True, return_tensors='pt', max_length=512)
embedding =model(**inputs)[0][:,0]return embedding
def find_similar_documents(query_document, documents, top_n=5):
query_embedding =generate_embedding(query_document)
document_embeddings =[generate_embedding(doc)for doc in documents]
similarity_scores =[cosine_similarity(query_embedding, doc_embedding).item()for doc_embedding in document_embeddings]
sorted_indices = torch.argsort(torch.tensor(similarity_scores), descending=True)
top_documents =[documents[idx]for idx in sorted_indices[:top_n]]
top_scores =[similarity_scores[idx]for idx in sorted_indices[:top_n]]return top_documents, top_scores, document_embeddings
# Sample documents
documents =["This is a tutorial about Snowflake Arctic Embedding models","Arctic-embed is a state-of-the-art text embedding model.","Snowflake provides various cloud data warehousing solutions.","Embedding models are used for representing text as dense vectors.","The Arctic-embed model is based on the transformer architecture."]
# Streamlit app
st.title("Document Similarity Search With Snowflake Arctic")
query_document = st.text_input("Enter your query document:")
top_k = st.number_input("Enter the number of top documents to retrieve (K):", min_value=1, value=3, step=1)if st.button("Search"):
top_documents, top_scores, document_embeddings =find_similar_documents(query_document, documents, top_n=top_k)
st.subheader("Top {} Similar Documents:".format(top_k))for i,(doc, score)inenumerate(zip(top_documents, top_scores)):
st.write("{}. Document: {}".format(i+1, doc))
st.write(" Similarity Score: {:.4f}".format(score))
# Reshape the embeddings
reshaped_embeddings = torch.stack(document_embeddings).detach().numpy()
reshaped_embeddings = reshaped_embeddings.reshape(reshaped_embeddings.shape[0],-1)
# Apply PCA to reduce the embeddings to 3 dimensions
pca =PCA(n_components=3)
reduced_embeddings = pca.fit_transform(reshaped_embeddings)
# Create a 3D plot
fig = plt.figure(figsize=(8,6))
ax = fig.add_subplot(111, projection='3d')
# Plot the document embeddings
for i, doc inenumerate(documents):
ax.scatter(reduced_embeddings[i,0], reduced_embeddings[i,1], reduced_embeddings[i,2], marker='o', label=f"Document {i+1}")
# Plot the query document embedding
query_embedding =generate_embedding(query_document)
reshaped_query_embedding = query_embedding.detach().numpy().reshape(1,-1)
reduced_query_embedding = pca.transform(reshaped_query_embedding)
ax.scatter(reduced_query_embedding[0,0], reduced_query_embedding[0,1], reduced_query_embedding[0,2], marker='*', s=100, color='red', label="Query Document")
ax.set_xlabel('PC1')
ax.set_ylabel('PC2')
ax.set_zlabel('PC3')
ax.legend()
plt.title('Document Embeddings in 3D Space')
st.pyplot(fig)Offerto da
Con il codice sopra, abbiamo creato un’app Streamlit chiamata "Document Similarity Search With Snowflake Arctic." Facciamo alcune osservazioni sul codice:
Consente all’utente di inserire un documento di query con st.text_input() e di specificare il numero di documenti top da recuperare (K) con st.number_input().
Quando l’utente clicca sul pulsante Search (st.button("Search")), la funzione find_similar_documents() viene chiamata con il documento di query, l’elenco dei documenti e il valore top_k specificato.
L’app mostra i K documenti più simili insieme ai rispettivi punteggi di similarità usando st.subheader() e st.write().
Gli embedding dei documenti vengono ridimensionati e ridotti a 3 dimensioni tramite PCA per la visualizzazione.
Viene creato un grafico 3D con Matplotlib per visualizzare gli embedding dei documenti e quello della query.
Il grafico 3D viene visualizzato nell’app Streamlit tramite st.pyplot(fig).
La sezione Streamlit del codice si concentra sulla creazione di un’interfaccia utente interattiva in cui l’utente può inserire un documento di query, specificare il numero di documenti simili da recuperare e visualizzare i risultati insieme a una rappresentazione 3D degli embedding.
Il codice completo dell’articolo è disponibile in questo Jupyter Notebook.
Possiamo avviare l’applicazione con il comando streamlit run app.py, che ci porterà alla landing page. Fornendo lo stesso documento di query e impostando Top K a 3, otteniamo il seguente risultato:
Integrazione di Snowflake Arctic usando Streamlit.
Suggerimenti di configurazione avanzata
Quando si lavora con large language model come Arctic, è fondamentale testare e validare accuratamente le configurazioni all’interno dell’ambiente di destinazione. Questo garantisce prestazioni e affidabilità ottimali. Ecco alcuni suggerimenti di configurazione da tenere a mente:
Quantizzazione: Riduci la precisione dei pesi per diminuire la dimensione del modello e velocizzare l’inferenza. Al momento della stesura di questo articolo, il checkpoint quantizzato non è disponibile e dovrebbe esserlo in futuro sia per l’inferenza su Hugging Face sia per vLLM.
Accelerazione hardware: Utilizza GPU e training/inference in precisione mista.
Distillazione del modello: Allena un modello "studente" più piccolo per imitare un modello "insegnante" più grande.
Caching e preprocessing: Archivia embedding usati di frequente e preelabora i dati offline.
Monitoraggio e logging: Traccia prestazioni, uso delle risorse ed errori per l’ottimizzazione.
Scalabilità e bilanciamento del carico: Distribuisci più istanze e ripartisci le richieste in modo uniforme.
Sicurezza e controllo degli accessi: Implementa autenticazione, autorizzazione e comunicazioni sicure.
Ottimizzazione continua: Monitora, analizza e sperimenta regolarmente nuove tecniche.
Best practice e troubleshooting
Per garantire prestazioni ottimali e un funzionamento fluido di Snowflake Arctic, è fondamentale seguire le best practice ed essere pronti a risolvere eventuali problemi. In questa sezione esploreremo suggerimenti e trucchi per migliorare le prestazioni basati su benchmark reali e ricerca accademica.
Ecco alcuni suggerimenti per potenziarne le capacità:
Utilizza motori di esecuzione vettorializzati per calcoli matematici più rapidi (GSMBK).
Metti in cache dataset accademici consultati di frequente e risultati precomputati.
Ottimizza il caricamento dati con tecniche bulk e staging locale.
Riduci al minimo il movimento dei dati calcolando più vicino allo storage.
Sfrutta l’elaborazione parallela per task computazionalmente intensivi (GSM8K, MMLU).
Monitora le prestazioni sui benchmark accademici e risolvi i colli di bottiglia.
Collabora con la comunità accademica e integra i risultati di ricerca più recenti.
Testa e valuta continuamente le prestazioni per individuare aree di miglioramento.
Prestazioni in inferenza
Le prestazioni di Snowflake Arctic spiccano sia in inferenza che in training. In inferenza, offre costantemente un rapporto prestazioni/costo superiore rispetto ad altri modelli. Questa efficienza migliora con l’attivazione di più parametri, mantenendo un vantaggio significativo anche attorno ai 60 miliardi di parametri attivi, superando concorrenti come Mixral e Llama 3.
Efficienza di inferenza di Arctic. Fonte: Snowflake.com.
Prestazioni in training
La tendenza continua anche nel training, dove Arctic vanta nuovamente il miglior rapporto prestazioni/costo. Questa efficienza scala con l’aumento del compute, raggiungendo circa il 70% con 16X compute, superando di gran lunga modelli come DBRX, Llama 3, Code Llama e Yi. Questi risultati sottolineano la value proposition di Arctic: prestazioni di alta qualità a una frazione del costo computazionale, rendendolo una scelta interessante per le aziende attente alle risorse.
Efficienza nel training di Arctic. Fonte: Snowflake.com.
Alcuni suggerimenti per ottimizzare le prestazioni in inferenza e training includono, a titolo esemplificativo ma non esaustivo:
Sfrutta l’architettura scalabile di Snowflake per addestrare Snowflake Arctic su dataset di grandi dimensioni.
Usa il computing distribuito di Snowflake per parallelizzare i carichi di training e ridurre i tempi.
Usa il caching dei dati di Snowflake per archiviare dati consultati di frequente e risultati intermedi, accelerando l’addestramento.
Ottimizza il caricamento dei dati con tecniche di bulk loading e staging locale per mantenere le prestazioni e ridurre i costi.
Monitora l’avanzamento del training e le metriche di performance con gli strumenti di Snowflake e soluzioni personalizzate.
Esegui il tuning degli iperparametri per bilanciare prestazioni del modello e costi di training.
Usa risorse di calcolo economiche di Snowflake per carichi di inferenza scalabili.
Implementa pipeline di inferenza efficienti sfruttando le funzionalità di data warehousing di Snowflake.
Monitora e analizza continuamente le metriche di inferenza per individuare opportunità di ottimizzazione.
Il futuro di Snowflake Arctic
Le prestazioni impressionanti e l’efficienza in termini di costi di Snowflake Arctic hanno stabilito un nuovo standard per i modelli linguistici. Gli sviluppi futuri potrebbero includere una comprensione avanzata del linguaggio naturale, un miglioramento del multi-task learning e un supporto più ampio per applicazioni specifiche di dominio. Con l’innovazione continua di Snowflake, gli utenti possono aspettarsi strumenti ancora più potenti e versatili.
Snowflake offre un’ottima community e risorse di supporto complete. Gli utenti possono connettersi, condividere conoscenze e imparare gli uni dagli altri nei forum della community di Snowflake. Documentazione dettagliata e tutorial sono disponibili sul sito ufficiale per aiutare gli utenti a orientarsi e sfruttare al massimo le funzionalità di Snowflake Arctic.
Conclusione
Snowflake Arctic è un punto di svolta nel campo delle text embeddings, offrendo una soluzione potente ed efficiente per le aziende che vogliono sbloccare tutto il potenziale dei propri dati. La sua integrazione perfetta con lo Snowflake Data Cloud e l’architettura scalabile lo rendono una scelta ideale per le organizzazioni che intendono snellire i processi di recupero e analisi dei dati.
In questa guida abbiamo esplorato le capacità principali di Snowflake Arctic, dalla configurazione di base alle tecniche di integrazione avanzate e alle applicazioni pratiche. Sfruttando le sue funzionalità avanzate e le ottimizzazioni delle prestazioni, le aziende possono ottenere maggiore efficienza e accuratezza nelle operazioni di text embedding.
Un data scientist poliedrico che ama condividere le proprie conoscenze e restituire valore agli altri, Zoumana è un content creator su YouTube e un top writer tech su Medium. Trova soddisfazione nel parlare in pubblico, programmare e insegnare. Zoumana ha due lauree magistrali: la prima in informatica con specializzazione in Machine Learning conseguita a Parigi, Francia, e la seconda in Data Science alla Texas Tech University negli Stati Uniti. Ha iniziato la sua carriera come Software Developer presso Groupe OPEN in Francia, per poi passare a IBM come Machine Learning Consultant, dove ha sviluppato soluzioni di IA end-to-end per compagnie assicurative. Successivamente, è entrato in Axionable, la prima startup di Sustainable AI con sede a Parigi e Montréal. Lì ha lavorato come Data Scientist e ha implementato prodotti di IA, principalmente casi d’uso di NLP, per clienti in Francia, Montréal, Singapore e Svizzera. Inoltre, ha dedicato il 5% del suo tempo ad attività di Ricerca e Sviluppo. Attualmente lavora come Senior Data Scientist presso IFC - World Bank Group.
Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.


 Tim Lu · 12 min

 Abid Ali Awan · 10 min

Snowflake Arctic è uno sviluppo innovativo nel campo delle text embeddings, che offre un potente set di strumenti pensati per semplificare l’adozione dell’AI sui dati aziendali.
In questo tutorial, forniremo una panoramica di Snowflake Arctic, affronteremo il processo di configurazione, esploreremo le tecniche di integrazione e condivideremo best practice e suggerimenti di troubleshooting. Mostreremo anche casi d’uso reali, parleremo degli sviluppi futuri e indicheremo risorse per supporto e apprendimento continuo.
Se vuoi saperne di più su Snowflake, dai un’occhiata a questo corso di Introduzione a Snowflake.
Che cos’è Snowflake Arctic?
Dunque, che cos’è esattamente Snowflake Arctic? È una suite completa di strumenti progettati per semplificare l’integrazione e la distribuzione dell’AI all’interno dello Snowflake Data Cloud. Al suo cuore, Snowflake Arctic offre una raccolta di modelli di embedding che ci permettono di estrarre in modo efficiente insight di valore dai nostri dati.
Include inoltre un Large Language Model (LLM) generico e versatile, capace di affrontare un’ampia gamma di attività, dalla generazione di query SQL e codice di programmazione al follow-up di istruzioni complesse.
Una delle caratteristiche distintive di Arctic è la sua integrazione perfetta con lo Snowflake Data Cloud. Questo legame stretto ci permette di sfruttare la potenza dell’AI direttamente all’interno dell’infrastruttura dati esistente, garantendo un’esperienza sicura e lineare.
È importante sottolineare che tutti i modelli della famiglia Snowflake Arctic sono disponibili con licenza Apache 2.0, permettendone l’uso sia per scopi accademici che commerciali.
Architettura e prestazioni
Snowflake Arctic ha tre componenti principali:
Componenti di Snowflake Arctic.
L’architettura di Snowflake Arctic si basa su un design ibrido transformer Dense Mixture of Experts (MoE), un’innovazione chiave che consente scalabilità ed adattabilità efficienti. Questo approccio sfrutta una vasta rete di 480 miliardi di parametri distribuiti su 128 esperti specializzati, ciascuno ottimizzato per compiti specifici.
Tuttavia, non tutti gli esperti vengono attivati per ogni query. Arctic impiega un meccanismo di gating top-2, selezionando solo i due esperti più rilevanti per ciascun input, attivando così appena 17 miliardi di parametri. Questa ottimizzazione riduce significativamente l’onere computazionale mantenendo prestazioni di alto livello su un’ampia gamma di task orientati all’impresa.
Caratteristiche principali
Snowflake Arctic si distingue per le seguenti quattro caratteristiche chiave:
Le quattro caratteristiche chiave di Snowflake Arctic.
Prima di tutto, è straordinariamente intelligente. Arctic eccelle in compiti complessi come generare query SQL, scrivere codice e seguire istruzioni dettagliate. Nei benchmark di settore, supera costantemente modelli simili, dimostrando la capacità di gestire scenari reali intricati.
In secondo luogo, Arctic è progettato per l’efficienza. La sua architettura unica gli consente di offrire prestazioni di alto livello consumando meno risorse computazionali. Questo si traduce in notevoli risparmi, rendendolo un’opzione interessante per organizzazioni di ogni dimensione.
In terzo luogo, Snowflake Arctic abbraccia l’open source. È disponibile con licenza Apache 2.0, garantendo a tutti l’accesso al suo codice e ai pesi del modello.
Infine, Arctic è focalizzato sull’enterprise AI. È costruito appositamente per rispondere alle esigenze specifiche delle aziende, offrendo risultati di alta qualità per attività come analisi dei dati, automazione dei processi e supporto alle decisioni.
Modelli Snowflake Arctic
Per soddisfare le diverse esigenze di AI aziendale, Snowflake ha introdotto due modelli principali all’interno della famiglia Snowflake Arctic:
Modelli di text embedding Snowflake Arctic
Oltre ai modelli principali, Snowflake offre una famiglia di cinque modelli di text embedding con licenza Apache 2.0—tutti focalizzati su task di information retrieval. La tabella sotto illustra le prestazioni dei vari modelli Snowflake Arctic sul task di retrieval del Massive Text Embedding Benchmark (MTEB), misurate con NDCG@10.
Punteggi di retrieval MTEB di diversi modelli Snowflake. Fonte: Hugging Face.
Per prima cosa, notiamo una tendenza generale al miglioramento delle prestazioni all’aumentare della dimensione del modello. Il modello più grande, "snowflake-arctic-embed-l", ottiene il punteggio NDCG@10 più alto pari a 55,98, utilizzando 335 milioni di parametri e 1024 dimensioni di embedding. Questo suggerisce che la scala del modello gioca un ruolo significativo nel catturare relazioni semantiche complesse all’interno dei testi.
È interessante notare che l’aumento della dimensione dell’embedding da 384 a 1024 porta a punteggi migliori per il modello "snowflake-arctic-embed-l", evidenziando l’impatto della dimensione dell’embedding sull’accuratezza del retrieval. Tuttavia, un’eccezione degna di nota è il modello "snowflake-arctic-embed-xs". Nonostante abbia molti meno parametri (22 milioni), si comporta in modo comparabile a modelli più grandi con la stessa dimensione di embedding di 384. Ciò suggerisce che l’efficienza del modello e le ottimizzazioni architetturali possano compensare, in alcuni scenari, i benefici del semplice numero di parametri.
Snowflake Arctic: Demo
Prima di sporcarci le mani con l’implementazione tecnica, vediamo il modello in azione su diversi compiti come generazione SQL, coding e follow-up di istruzioni.
Dalla demo Streamlit su Hugging Face, possiamo fornire al modello delle richieste, regolare i parametri del modello e ottenere una risposta.
Demo di Snowflake Arctic.
Chiediamo innanzitutto al modello di generare una query SQL:
Esempio di generazione SQL con Snowflake Arctic.
Per confronto, inviamo la stessa richiesta a ChatGPT-4o: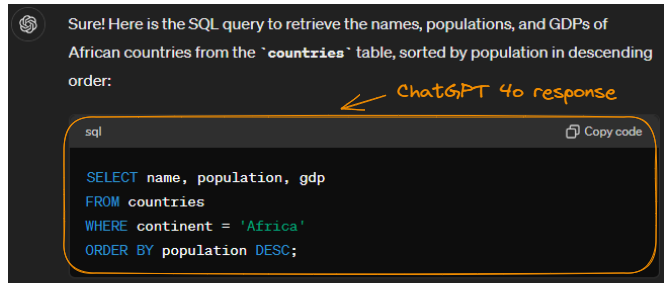
Esempio di generazione SQL con ChatGPT-4o.
Nota che è stato generato lo stesso risultato (con una formattazione più pulita). Possiamo concludere che Arctic ha fatto un buon lavoro.
Chiediamo ora ad Arctic di scrivere del codice Python:
Snowflake Arctic genera codice Python.
Fornendo lo stesso prompt a ChatGPT-4o, otteniamo il seguente risultato, anch’esso corretto:
Codice Python generato da ChatGPT-4o.
Sebbene sia Arctic che ChatGPT-4o svolgano lo stesso compito, i loro approcci differiscono per efficienza e uso della memoria. Entrambi i modelli leggono i file in modo efficiente usando
os.listdir()eopen().Tuttavia, l’approccio di ChatGPT-4o di creare un DataFrame da una lista di dizionari potrebbe consumare leggermente più memoria rispetto al metodo di Arctic che usa una lista di liste. Questo perché Pandas può eseguire elaborazioni aggiuntive per gestire i dizionari. Nonostante questa piccola differenza, la struttura modulare del codice di ChatGPT-4o migliora leggibilità e manutenibilità.
Se vuoi saperne di più sulla scelta dell’LLM giusto, dai un’occhiata a questo tutorial su Classificazione degli LLM: come selezionare il miglior LLM per la tua applicazione.
Configurazione di Snowflake Arctic
Ora che conosciamo le capacità del modello Snowflake Arctic, concentriamoci su come accedere e configurare Snowflake Arctic.
Caratteristiche dell’ambiente
L’uso dei modelli Arctic è intensivo in termini di risorse, quindi useremo il più piccolo della famiglia, snowflake-arctic-embed-xs, che richiede il minor numero di risorse computazionali.
Di seguito vediamo le caratteristiche dell’ambiente che stiamo usando per questo tutorial—le mostriamo eseguendo il comando
nvidia-smi:Caratteristiche GPU per il tutorial su Snowflake Arctic.
Oltre alla GPU NVIDIA L4, l’ambiente ha le seguenti caratteristiche, che si trovano nella sezione Resources:
Caratteristiche del backend del motore di calcolo.
Installazione delle librerie
Per questo tutorial pratico servono due librerie principali:
torchetransformers(eseguiamo il codice seguente da un notebook):Importiamo poi le sottolibrerie necessarie:
Caricare il modello e il tokenizer
Proseguiamo caricando il modello di embedding snowflake-arctic-embed-xs e il tokenizer corrispondente:
Carichiamo il modello pre-addestrato specificato da
model_checkpointsenza un ulteriore livello di pooling, usato per ridurre la dimensionalità dell’output del modello.Ricerca di similarità tra documenti con Snowflake Arctic
Con tutti i requisiti configurati correttamente, il caso d’uso principale di questa sezione è trovare i N documenti più simili a un dato documento, insieme ai loro punteggi di similarità coseno. Per farlo, seguiamo questi cinque passaggi principali:
Ricerca di similarità tra documenti con Snowflake Arctic.
Possiamo implementare i passaggi sopra usando queste funzioni di supporto:
generate_embedding()efind_similar_documents().La funzione
generate_embedding()prende un documento in input e ne genera l’embedding. Lafind_similar_documents()accetta un documento di query, gli embedding dei documenti esistenti e il numero desiderato di documenti simili da restituire.Per semplicità, usiamo cinque esempi elementari:
Quindi generiamo gli embedding:
Scegliamo “What is the Arctic-embed model?” come documento di query e troviamo i documenti simili:
Infine, cicliamo su tutti i documenti top per stampare il contenuto del documento e il suo punteggio di similarità con il documento di query.
Il secondo documento è il più simile perché ha il punteggio di similarità coseno più alto (94,99%).
I cinque documenti originali.
Visualizzazione 3D dei documenti
Quando visualizziamo i documenti in uno spazio 3D, possiamo vedere quali sono più vicini tra loro.
Gli embedding originali hanno 512 dimensioni, impossibili da visualizzare. Il modo più semplice è ridurre le dimensioni usando la Principal Component Analysis (PCA). Se vuoi saperne di più sulla PCA, dai un’occhiata a questo tutorial su Principal Component Analysis (PCA) in Python.
Prima di usare la PCA, dobbiamo modificare la funzione
find_similar_documents()in modo che restituisca gli embedding dei documenti che la PCA utilizzerà.Importiamo anche alcuni moduli necessari per generare la visualizzazione.
Ora creiamo la visualizzazione 3D:
Uso della PCA per visualizzare la similarità tra documenti.
Il secondo documento (arancione) è il più vicino al documento di query (stella rossa). Il quinto documento (viola) è il secondo più vicino, mentre il terzo documento (verde) è il più distante.
Integrazione di Snowflake Arctic con Streamlit
I notebook sono strumenti potenti per la sperimentazione e la visualizzazione rapida, molto apprezzati da data scientist e ricercatori. Tuttavia, potrebbero non essere la scelta più adatta quando si tratta di distribuire modelli o applicazioni in ambienti di produzione. Qui entra in gioco Streamlit.
Streamlit è una libreria Python che facilita lo sviluppo di applicazioni web interattive per progetti di data science e machine learning. Rende semplice trasformare progetti di data science in applicazioni pronte per la produzione senza una grande esperienza di sviluppo web.
Di seguito la landing page di ciò che costruiremo in questa sezione.
La landing page dell’applicazione Streamlit.
Insegnare Streamlit esula dallo scopo di questo tutorial, ma puoi impararlo da zero in questo Python Tutorial: Streamlit.
Tecniche di integrazione di base
In questa sezione vedremo come usare Streamlit per creare un’app web per il nostro progetto di ricerca di similarità tra documenti. Per eseguire un’applicazione Streamlit, il codice deve essere in un file Python (con estensione .py) ed eseguire il seguente comando nel terminale:
Tuttavia, il primo passo per usare Streamlit è installarlo con il comando
pip:Il codice che abbiamo usato per costruire l’applicazione Streamlit è un po’ lungo, quindi prenditi il tempo per esaminarlo. Lo spiegheremo anche dopo il blocco di codice.
Con il codice sopra, abbiamo creato un’app Streamlit chiamata "Document Similarity Search With Snowflake Arctic." Facciamo alcune osservazioni sul codice:
st.text_input()e di specificare il numero di documenti top da recuperare (K) const.number_input().st.button("Search")), la funzionefind_similar_documents()viene chiamata con il documento di query, l’elenco dei documenti e il valoretop_kspecificato.st.subheader()est.write().st.pyplot(fig).La sezione Streamlit del codice si concentra sulla creazione di un’interfaccia utente interattiva in cui l’utente può inserire un documento di query, specificare il numero di documenti simili da recuperare e visualizzare i risultati insieme a una rappresentazione 3D degli embedding.
Il codice completo dell’articolo è disponibile in questo Jupyter Notebook.
Possiamo avviare l’applicazione con il comando
streamlit run app.py, che ci porterà alla landing page. Fornendo lo stesso documento di query e impostando Top K a 3, otteniamo il seguente risultato:Integrazione di Snowflake Arctic usando Streamlit.
Suggerimenti di configurazione avanzata
Quando si lavora con large language model come Arctic, è fondamentale testare e validare accuratamente le configurazioni all’interno dell’ambiente di destinazione. Questo garantisce prestazioni e affidabilità ottimali. Ecco alcuni suggerimenti di configurazione da tenere a mente:
Best practice e troubleshooting
Per garantire prestazioni ottimali e un funzionamento fluido di Snowflake Arctic, è fondamentale seguire le best practice ed essere pronti a risolvere eventuali problemi. In questa sezione esploreremo suggerimenti e trucchi per migliorare le prestazioni basati su benchmark reali e ricerca accademica.
Fonte: Arctic Cloud.
Ecco alcuni suggerimenti per potenziarne le capacità:
Prestazioni in inferenza
Le prestazioni di Snowflake Arctic spiccano sia in inferenza che in training. In inferenza, offre costantemente un rapporto prestazioni/costo superiore rispetto ad altri modelli. Questa efficienza migliora con l’attivazione di più parametri, mantenendo un vantaggio significativo anche attorno ai 60 miliardi di parametri attivi, superando concorrenti come Mixral e Llama 3.
Efficienza di inferenza di Arctic. Fonte: Snowflake.com.
Prestazioni in training
La tendenza continua anche nel training, dove Arctic vanta nuovamente il miglior rapporto prestazioni/costo. Questa efficienza scala con l’aumento del compute, raggiungendo circa il 70% con 16X compute, superando di gran lunga modelli come DBRX, Llama 3, Code Llama e Yi. Questi risultati sottolineano la value proposition di Arctic: prestazioni di alta qualità a una frazione del costo computazionale, rendendolo una scelta interessante per le aziende attente alle risorse.
Efficienza nel training di Arctic. Fonte: Snowflake.com.
Alcuni suggerimenti per ottimizzare le prestazioni in inferenza e training includono, a titolo esemplificativo ma non esaustivo:
Il futuro di Snowflake Arctic
Le prestazioni impressionanti e l’efficienza in termini di costi di Snowflake Arctic hanno stabilito un nuovo standard per i modelli linguistici. Gli sviluppi futuri potrebbero includere una comprensione avanzata del linguaggio naturale, un miglioramento del multi-task learning e un supporto più ampio per applicazioni specifiche di dominio. Con l’innovazione continua di Snowflake, gli utenti possono aspettarsi strumenti ancora più potenti e versatili.
Snowflake offre un’ottima community e risorse di supporto complete. Gli utenti possono connettersi, condividere conoscenze e imparare gli uni dagli altri nei forum della community di Snowflake. Documentazione dettagliata e tutorial sono disponibili sul sito ufficiale per aiutare gli utenti a orientarsi e sfruttare al massimo le funzionalità di Snowflake Arctic.
Conclusione
Snowflake Arctic è un punto di svolta nel campo delle text embeddings, offrendo una soluzione potente ed efficiente per le aziende che vogliono sbloccare tutto il potenziale dei propri dati. La sua integrazione perfetta con lo Snowflake Data Cloud e l’architettura scalabile lo rendono una scelta ideale per le organizzazioni che intendono snellire i processi di recupero e analisi dei dati.
In questa guida abbiamo esplorato le capacità principali di Snowflake Arctic, dalla configurazione di base alle tecniche di integrazione avanzate e alle applicazioni pratiche. Sfruttando le sue funzionalità avanzate e le ottimizzazioni delle prestazioni, le aziende possono ottenere maggiore efficienza e accuratezza nelle operazioni di text embedding.
Se vuoi saperne di più su Snowflake, dai un’occhiata a questo Tutorial su Snowflake per principianti.