
Kursus
Konsep Large Language Models (LLM)
2 jam
112.1K
Snowflake Arctic adalah terobosan inovatif di bidang text embeddings, menawarkan serangkaian alat yang kuat untuk menyederhanakan proses adopsi AI pada data perusahaan.
Dalam tutorial ini, kami akan memberikan ikhtisar Snowflake Arctic, membahas proses penyiapan, menjelajahi teknik integrasi, serta berbagi praktik terbaik dan tips pemecahan masalah. Kami juga akan menampilkan use case dunia nyata, membahas pengembangan di masa depan, dan menyediakan sumber daya untuk dukungan serta pembelajaran berkelanjutan.
Jika Anda ingin mempelajari lebih lanjut tentang Snowflake, lihat kursus Introduction to Snowflake ini.
Jadi, apa sebenarnya Snowflake Arctic? Ini adalah rangkaian alat komprehensif yang dirancang untuk menyederhanakan integrasi dan penerapan AI di dalam Snowflake Data Cloud. Pada intinya, Snowflake Arctic menawarkan kumpulan model embedding yang memberdayakan kita untuk mengekstraksi wawasan berharga dari data secara efisien.
Selain itu, ia menyertakan Large Language Model (LLM) serbaguna untuk keperluan umum yang mampu menangani berbagai tugas, mulai dari membuat kueri SQL dan kode pemrograman hingga mengikuti instruksi yang kompleks.
Salah satu fitur menonjol Arctic adalah integrasinya yang mulus dengan Snowflake Data Cloud. Keterhubungan yang erat ini memungkinkan kita memanfaatkan kekuatan AI langsung di dalam infrastruktur data yang sudah ada, memastikan pengalaman yang aman dan efisien.
Yang penting, semua model dalam keluarga Snowflake Arctic tersedia di bawah lisensi Apache 2.0, memungkinkan kita menggunakannya untuk tujuan akademis maupun komersial.
Snowflake Arctic memiliki tiga komponen utama:
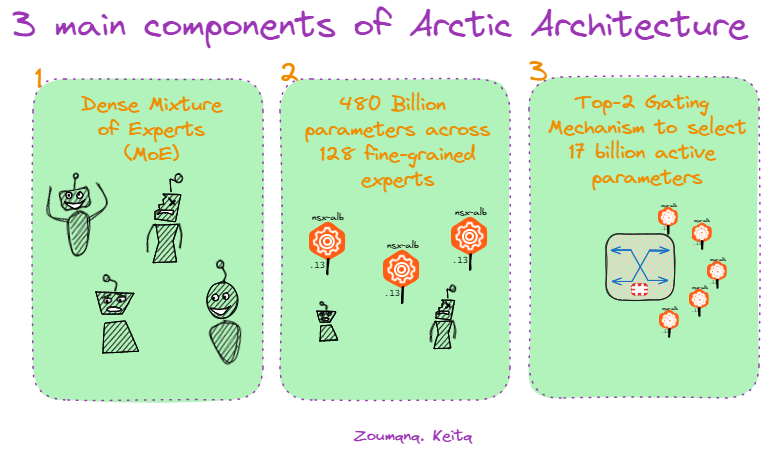
Komponen Snowflake Arctic.
Arsitektur Snowflake Arctic dibangun di atas desain transformer hibrida Dense Mixture of Experts (MoE), sebuah inovasi kunci yang memungkinkan skala dan adaptabilitas yang efisien. Pendekatan ini memanfaatkan jaringan besar berisi 480 miliar parameter yang didistribusikan di 128 expert spesialis, masing-masing dioptimalkan untuk tugas tertentu.
Namun, tidak semua expert diaktifkan untuk setiap kueri. Arctic menggunakan mekanisme top-2 gating, hanya memilih dua expert yang paling relevan untuk setiap masukan, sehingga hanya mengaktifkan 17 miliar parameter. Optimasi ini secara signifikan mengurangi beban komputasi sekaligus mempertahankan kinerja kelas atas di berbagai tugas berfokus perusahaan.
Snowflake Arctic menonjol karena empat fitur utama berikut:
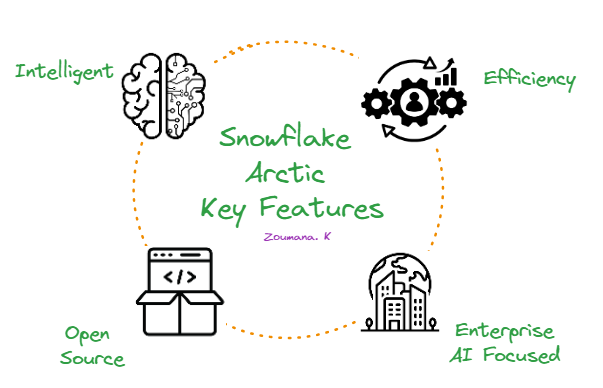
Empat fitur utama Snowflake Arctic.
Pertama dan terutama, model ini sangat cerdas. Arctic unggul dalam tugas kompleks seperti membuat kueri SQL, menulis kode, dan mengikuti instruksi terperinci. Dalam uji tolok ukur industri, ia secara konsisten melampaui model serupa, menunjukkan kemampuannya menangani skenario dunia nyata yang rumit.
Kedua, Arctic dirancang untuk efisiensi. Arsitekturnya yang unik memungkinkannya memberikan kinerja kelas atas dengan mengonsumsi lebih sedikit sumber daya komputasi. Ini berarti penghematan biaya yang signifikan, menjadikannya pilihan menarik bagi organisasi dari berbagai ukuran.
Ketiga, Snowflake Arctic mengusung prinsip open source. Model ini tersedia di bawah lisensi Apache 2.0, memberikan akses kepada semua orang terhadap kode dan bobot modelnya.
Terakhir, Arctic sangat berfokus pada AI untuk perusahaan. Model ini dibuat khusus untuk memenuhi kebutuhan bisnis, memberikan hasil berkualitas tinggi untuk tugas seperti analisis data, otomatisasi proses, dan dukungan pengambilan keputusan.
Untuk memenuhi beragam kebutuhan AI perusahaan, Snowflake memperkenalkan dua model utama dalam keluarga Snowflake Arctic:
Selain model utama, Snowflake menyediakan lima model text embedding di bawah lisensi Apache 2.0—semuanya berfokus pada tugas pengambilan informasi. Tabel di bawah mengilustrasikan kinerja berbagai model Snowflake Arctic pada tugas retrieval Massive Text Embedding Benchmark (MTEB), diukur dengan NDCG@10.
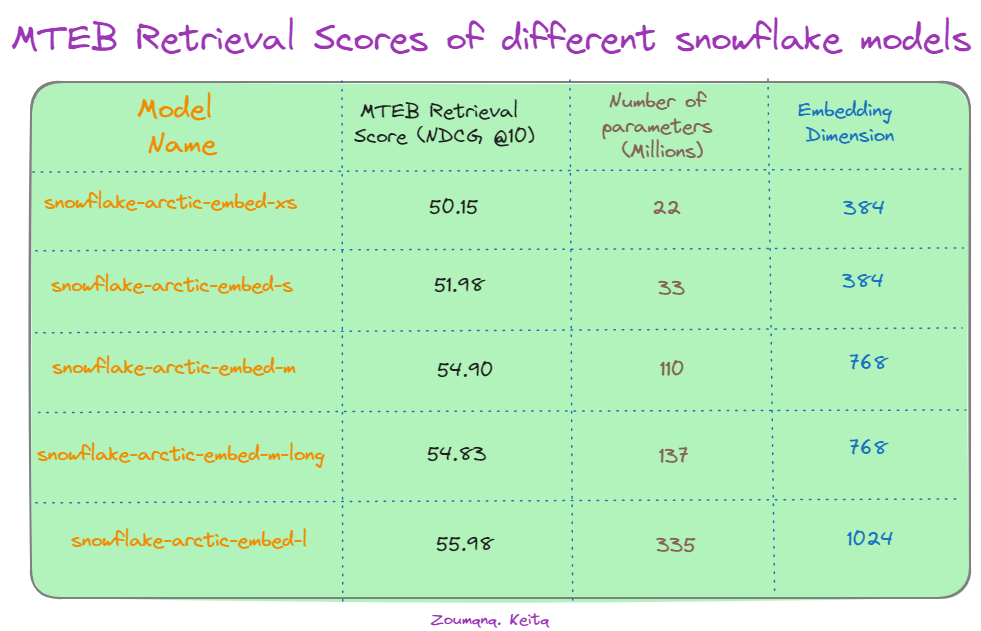
Skor retrieval MTEB dari berbagai model Snowflake. Sumber: Hugging Face.
Pertama, kita melihat tren umum peningkatan kinerja seiring bertambahnya ukuran model. Model terbesar, "snowflake-arctic-embed-l," mencapai skor NDCG@10 tertinggi sebesar 55,98, menggunakan 335 juta parameter dan 1024 dimensi embedding. Ini menunjukkan bahwa skala model berperan penting dalam menangkap hubungan semantik yang rumit dalam data teks.
Menariknya, peningkatan dimensi embedding dari 384 ke 1024 menghasilkan skor yang lebih baik untuk model "snowflake-arctic-embed-l," menyoroti dampak ukuran embedding terhadap akurasi retrieval. Namun, ada pengecualian mencolok pada model "snowflake-arctic-embed-xs." Meski memiliki parameter yang jauh lebih sedikit (22 juta), kinerjanya sebanding dengan model yang lebih besar dengan dimensi embedding yang sama, yaitu 384. Ini menunjukkan bahwa efisiensi model dan optimasi arsitektur dapat mengimbangi manfaat dari sekadar jumlah parameter dalam skenario tertentu.
Sebelum masuk ke implementasi teknis, mari kita lihat model ini beraksi melakukan berbagai tugas seperti pembuatan SQL, penulisan kode, dan mengikuti instruksi.
Dari demo Streamlit di Hugging Face, kita dapat memberikan permintaan ke model, menyesuaikan parameter model, dan mendapatkan respons.
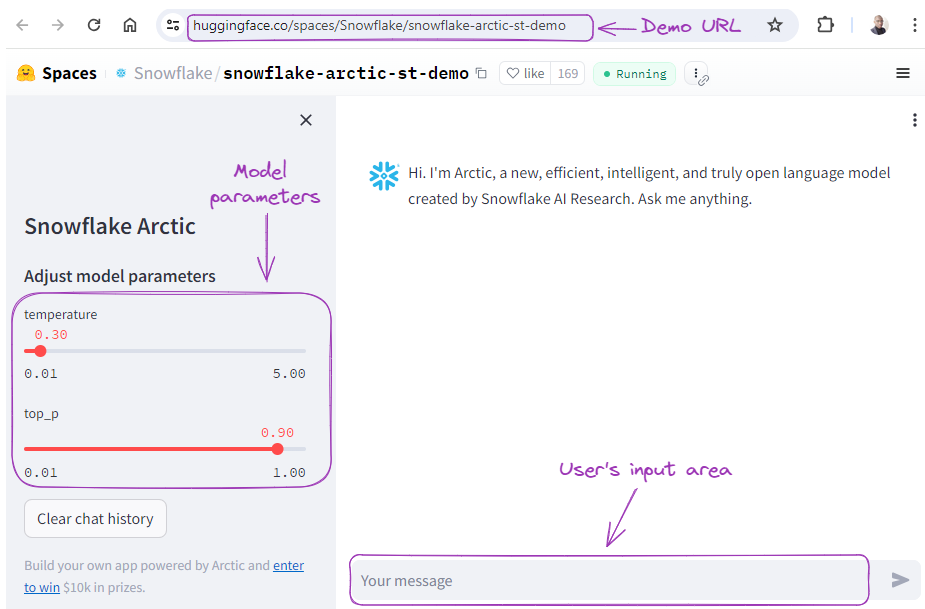
Demo Snowflake Arctic.
Mari kita minta model membuat sebuah kueri SQL terlebih dahulu:
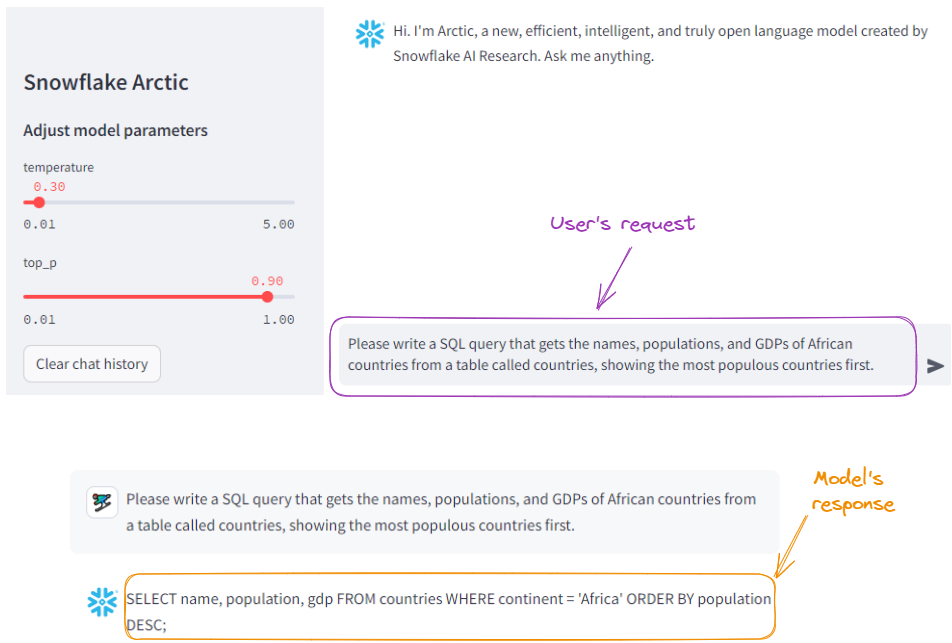
Contoh pembuatan SQL dengan Snowflake Arctic.
Untuk perbandingan, mari kirim permintaan yang sama ke ChatGPT-4o: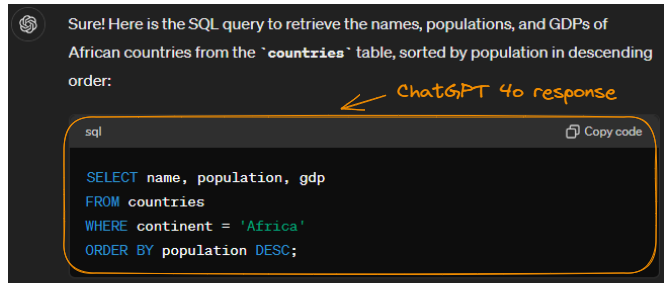
Contoh pembuatan SQL dengan ChatGPT-4o.
Perhatikan bahwa hasilnya sama (dengan pemformatan yang lebih rapi). Kita dapat menyimpulkan Arctic bekerja dengan baik.
Mari kita minta Arctic menulis kode Python:
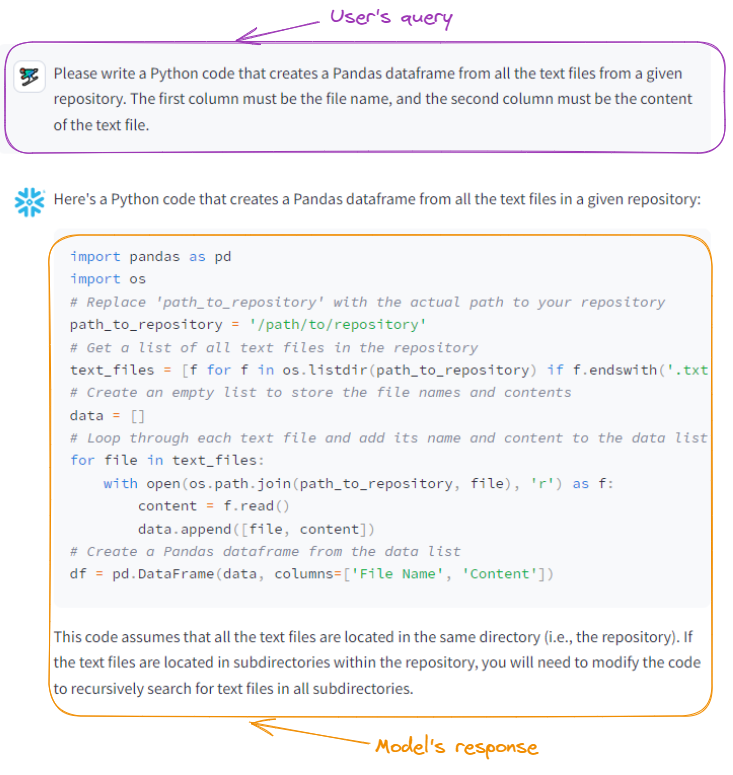
Snowflake Arctic menghasilkan kode Python.
Dengan memberikan prompt yang sama ke ChatGPT-4o, kita mendapatkan hasil berikut, yang juga akurat:
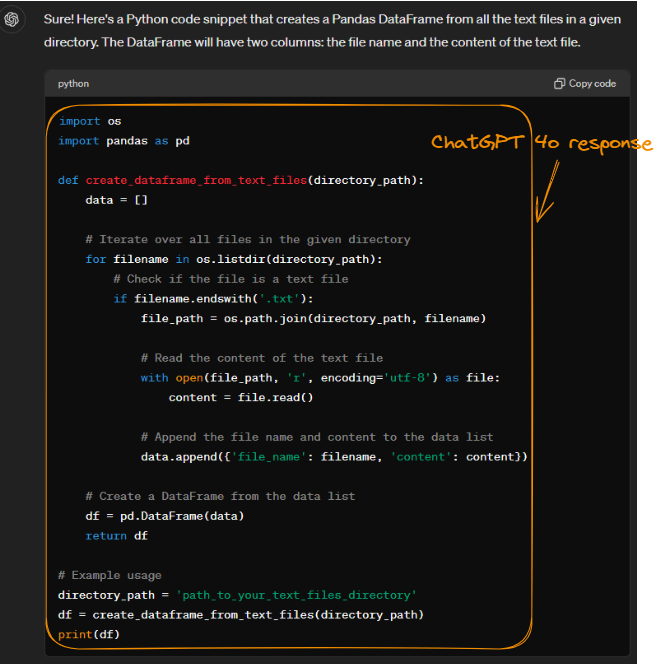
Kode Python yang dihasilkan ChatGPT-4o.
Meskipun Arctic dan ChatGPT-4o menyelesaikan tugas yang sama, pendekatan mereka berbeda dalam efisiensi dan penggunaan memori. Keduanya membaca file secara efisien menggunakan os.listdir() dan open().
Namun, pendekatan ChatGPT-4o yang membuat DataFrame dari daftar kamus mungkin sedikit lebih banyak mengonsumsi memori dibandingkan metode Arctic yang menggunakan daftar berisi daftar. Ini karena Pandas mungkin melakukan pemrosesan tambahan untuk menangani kamus. Terlepas dari perbedaan kecil ini, struktur kode modular ChatGPT-4o meningkatkan keterbacaan dan pemeliharaan.
Jika Anda ingin mempelajari lebih lanjut tentang memilih LLM yang tepat, lihat tutorial Klasifikasi LLM: Cara Memilih LLM Terbaik ini.
Sekarang setelah kita mengetahui kemampuan model Snowflake Arctic, mari fokus pada cara mengakses dan mengonfigurasinya.
Menggunakan model Arctic membutuhkan banyak sumber daya, jadi kita akan menggunakan model terkecil dalam keluarga Arctic, snowflake-arctic-embed-xs, yang menggunakan sumber daya komputasi paling sedikit.
Di bawah ini, kita melihat karakteristik lingkungan yang kita gunakan untuk tutorial ini—kita menampilkannya dengan menjalankan perintah nvidia-smi:
!nvidia-smi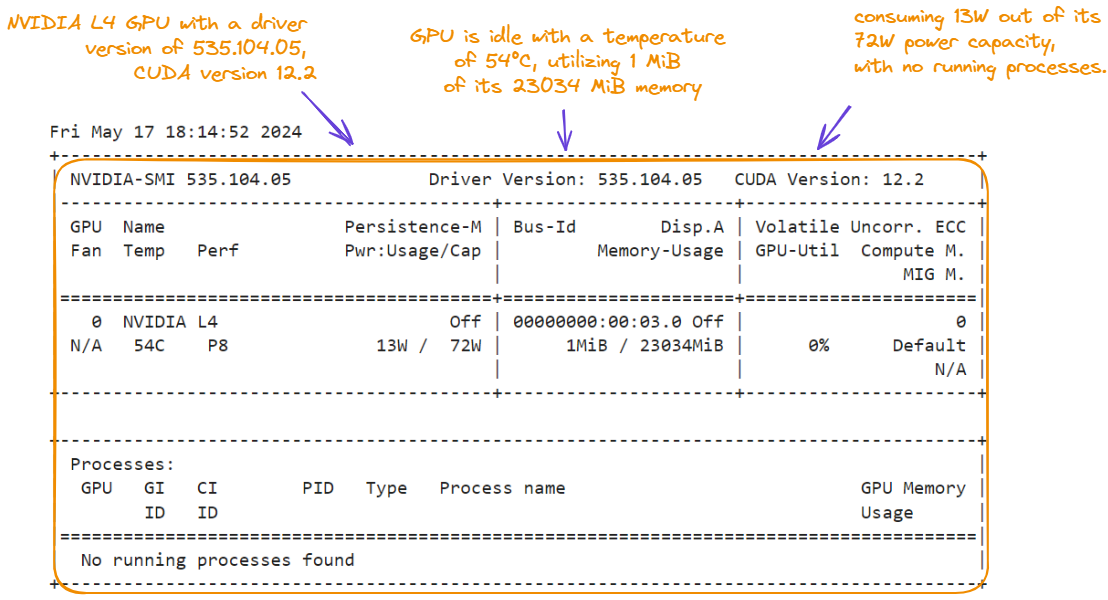
Karakteristik GPU untuk tutorial Snowflake Arctic.
Selain GPU NVIDIA L4, lingkungan ini memiliki karakteristik berikut, yang dapat Anda temukan di bagian Resources:
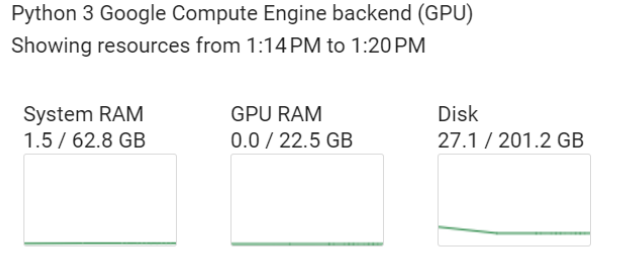
Karakteristik backend compute engine.
Dua pustaka utama diperlukan untuk tutorial praktis ini: torch dan transformers (kami menjalankan kode di bawah ini dari sebuah notebook):
%%bash
pip -qqq install transformers>=4.39.0
pip -qqq install torch
Lalu kita impor subpustaka yang diperlukan:
import torch
from transformers import AutoTokenizer, AutoModel
from torch.nn.functional import cosine_similarityMari lanjut dengan memuat model embedding snowflake-arctic-embed-xs dan tokenizer yang sesuai:
model_checkpoint = "Snowflake/snowflake-arctic-embed-xs"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = AutoModel.from_pretrained(model_checkpoint, add_pooling_layer=False)
Kita memuat model pra-latih yang ditentukan oleh model_checkpoint tanpa lapisan pooling tambahan, yang biasa digunakan untuk mengurangi dimensi keluaran model.
Setelah semua kebutuhan terpenuhi, use case inti di bagian ini adalah menemukan N dokumen yang paling mirip dengan sebuah dokumen tertentu, beserta skor kemiripannya berdasarkan cosine similarity. Untuk melakukannya, kita menempuh lima langkah utama ini:
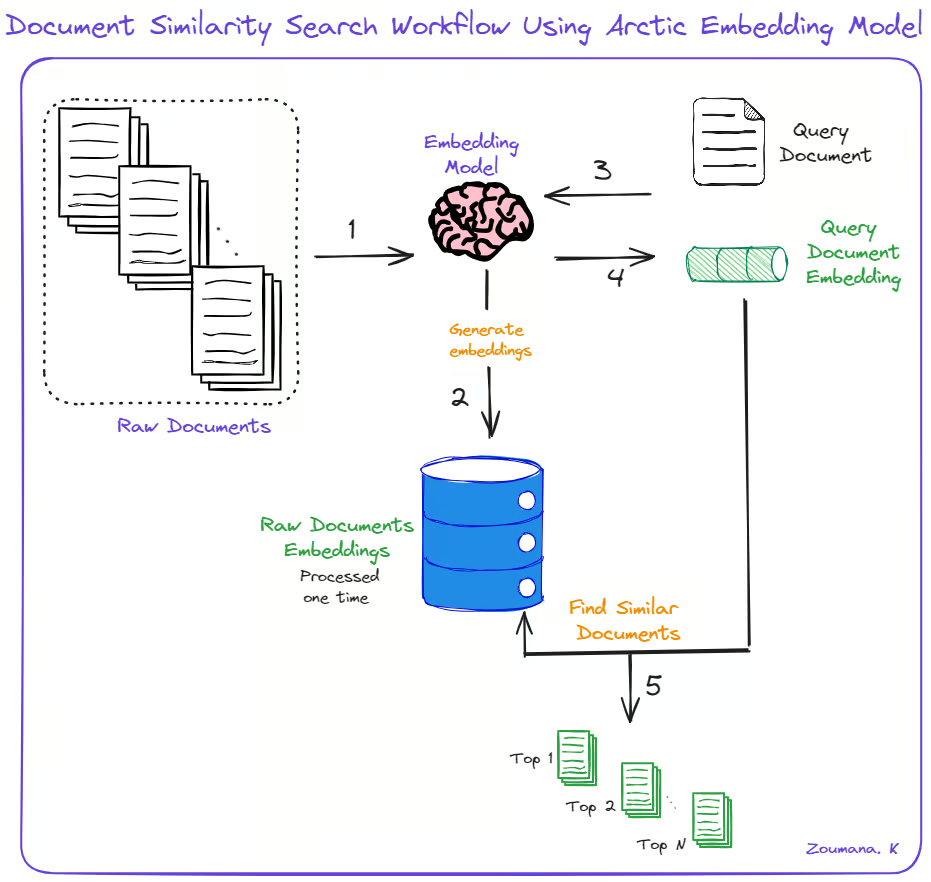
Pencarian kemiripan dokumen menggunakan Snowflake Arctic.
Kita dapat mengimplementasikan langkah-langkah di atas menggunakan fungsi pembantu berikut: generate_embedding() dan find_similar_documents().
def generate_embedding(document):
    inputs = tokenizer(document, padding=True, truncation=True,
                       return_tensors='pt', max_length=512)

    embedding = model(**inputs)[0][:, 0]
    return embedding


def find_similar_documents(query_document, document_embeddings , top_n=5):

    query_embedding = generate_embedding(query_document)

    similarity_scores = [cosine_similarity(query_embedding,
                                           doc_embedding).item() for doc_embedding in document_embeddings]

    sorted_indices = torch.argsort(torch.tensor(similarity_scores),
                                   descending=True)

    top_documents = [documents[idx] for idx in sorted_indices[:top_n]]
    top_scores = [similarity_scores[idx] for idx in sorted_indices[:top_n]]

    return top_documents, top_scores
Fungsi generate_embedding() menerima sebuah dokumen sebagai masukan dan menghasilkan embedding-nya. find_similar_documents() menerima dokumen kueri, embedding dari dokumen yang ada, dan jumlah dokumen mirip yang ingin dikembalikan.
Demi kesederhanaan, kita menggunakan lima contoh sederhana:
documents = [
    "This is a tutorial about Snowflake Arctic Embedding models",
    "Arctic-embed is a state-of-the-art text embedding model.",
    "Snowflake provides various cloud data warehousing solutions.",
    "Embedding models are used for representing text as dense vectors.",
    "The Arctic-embed model is based on the transformer architecture."
]
Selanjutnya, kita menghasilkan embedding:
document_embeddings = [generate_embedding(doc) for doc in documents]Mari pilih “What is the Arctic-embed model?” sebagai dokumen kueri dan cari dokumen yang mirip:
query_document = "What is the Arctic-embed model?"
top_documents, top_scores = find_similar_documents(query_document, document_embeddings)
Terakhir, kita melakukan loop pada semua dokumen teratas untuk mencetak isi dokumen dan skor kemiripannya dengan dokumen kueri.
print("Query Document:")
print(query_document)
print("\nTop Similar Documents:")
for doc, score in zip(top_documents, top_scores):
    print(f"Document: {doc}")
    print(f"Similarity Score: {score:.4f}")
    print()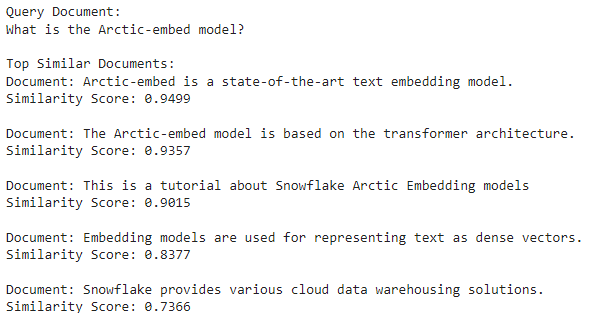
Dokumen kedua adalah yang paling mirip karena memiliki skor cosine similarity tertinggi (94,99%).
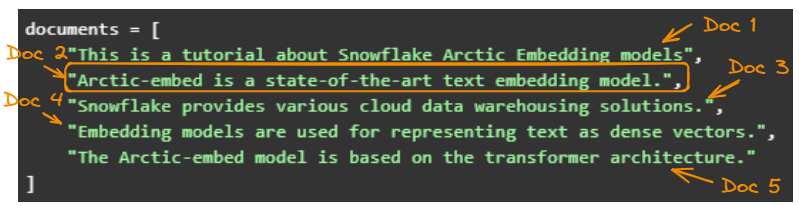
Lima dokumen asli.
Saat kita memvisualisasikan dokumen dalam ruang 3D, kita dapat melihat dokumen yang saling berdekatan.
Embedding asli memiliki 512 dimensi, yang tidak mungkin divisualisasikan. Cara termudah adalah mengurangi dimensi menggunakan Principal Component Analysis (PCA). Jika Anda ingin mempelajari lebih lanjut tentang PCA, lihat tutorial Principal Component Analysis (PCA) in Python ini.
Sebelum menggunakan PCA, kita perlu memodifikasi fungsi find_similar_documents() agar mengembalikan embedding dokumen yang akan digunakan PCA.
def find_similar_documents(query_document, documents, top_n=5):
    query_embedding = generate_embedding(query_document)
    document_embeddings = [generate_embedding(doc) for doc in documents]

    similarity_scores = [cosine_similarity(query_embedding, doc_embedding).item() for doc_embedding in document_embeddings]
    sorted_indices = torch.argsort(torch.tensor(similarity_scores), descending=True)

    top_documents = [documents[idx] for idx in sorted_indices[:top_n]]
    top_scores = [similarity_scores[idx] for idx in sorted_indices[:top_n]]

    return top_documents, top_scores, document_embeddings
Kita juga mengimpor beberapa modul yang diperlukan untuk menghasilkan visualisasi.
from sklearn.decomposition import PCA
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D
Sekarang mari kita buat visualisasi 3D dengan cara:
top_documents, top_scores, document_embeddings = find_similar_documents(query_document, documents)

# Reshape the embeddings
reshaped_embeddings = torch.stack(document_embeddings).detach().numpy()
reshaped_embeddings = reshaped_embeddings.reshape(reshaped_embeddings.shape[0], -1)

# Apply PCA to reduce the embeddings to 3 dimensions
pca = PCA(n_components=3)
reduced_embeddings = pca.fit_transform(reshaped_embeddings)

# Create a 3D plot
fig = plt.figure(figsize=(8, 6))
ax = fig.add_subplot(111, projection='3d')

# Plot the document embeddings
for i, doc in enumerate(documents):
    ax.scatter(reduced_embeddings[i, 0], reduced_embeddings[i, 1], reduced_embeddings[i, 2], marker='o', label=f"Document {i+1}")

# Plot the query document embedding
query_embedding = generate_embedding(query_document)
reshaped_query_embedding = query_embedding.detach().numpy().reshape(1, -1)
reduced_query_embedding = pca.transform(reshaped_query_embedding)
ax.scatter(reduced_query_embedding[0, 0], reduced_query_embedding[0, 1],
           reduced_query_embedding[0, 2], marker='*', s=100, color='red',
           label="Query Document")

ax.set_xlabel('PC1')
ax.set_ylabel('PC2')
ax.set_zlabel('PC3')
ax.legend()
plt.title('Document Embeddings in 3D Space')
plt.show()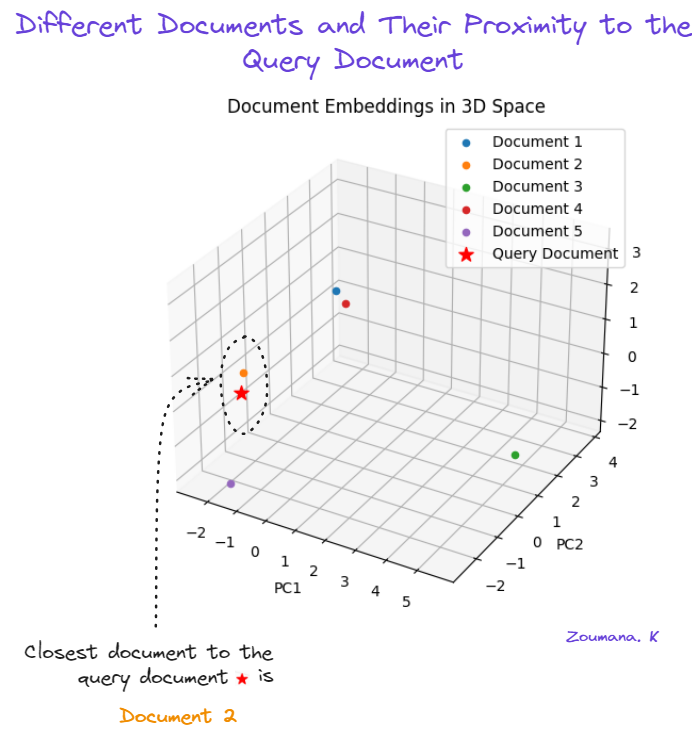
Menggunakan PCA untuk memvisualisasikan kemiripan dokumen.
Dokumen kedua (oranye) adalah yang paling dekat dengan dokumen kueri (bintang merah). Dokumen kelima (ungu) adalah yang terdekat kedua, sementara dokumen ketiga (hijau) adalah yang paling jauh.
Notebook adalah alat yang kuat untuk eksperimen dan visualisasi cepat, sehingga populer di kalangan data scientist dan peneliti. Namun, notebook mungkin bukan pilihan paling tepat saat menerapkan model atau aplikasi di lingkungan produksi. Di sinilah Streamlit berperan.
Streamlit adalah pustaka Python yang memudahkan pengembangan aplikasi web interaktif untuk proyek data science dan machine learning. Alat ini memudahkan transformasi proyek data science menjadi aplikasi siap produksi tanpa perlu pengetahuan pengembangan web yang ekstensif.
Di bawah ini adalah halaman landing dari aplikasi yang akan kita bangun di bagian ini.
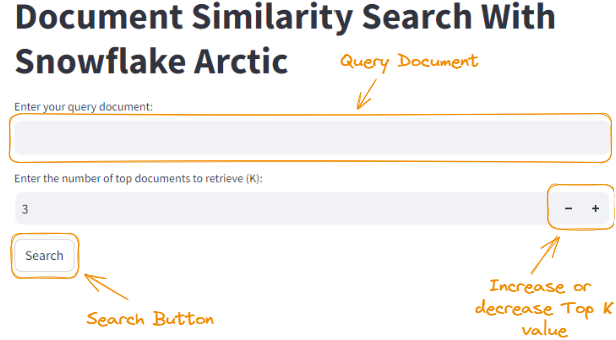
Halaman landing aplikasi Streamlit.
Mengajarkan Streamlit berada di luar cakupan tutorial ini, tetapi Anda dapat mempelajarinya dari awal melalui Python Tutorial: Streamlit ini.
Di bagian ini, kita akan mengeksplorasi cara menggunakan Streamlit untuk membuat aplikasi web bagi proyek pencarian kemiripan dokumen kita. Untuk menjalankan aplikasi Streamlit, kodenya perlu berada dalam file Python (berekstensi .py) dan jalankan perintah berikut di terminal:
streamlit run app.pyNamun, langkah pertama menggunakan Streamlit adalah menginstalnya dengan perintah pip:
pip install streamlitKode yang kita gunakan untuk membangun aplikasi Streamlit ini cukup panjang, jadi luangkan waktu untuk menelitinya. Kami juga akan menjelaskannya setelah blok kode.
import streamlit as st
from transformers import AutoTokenizer, AutoModel
import torch
from torch.nn.functional import cosine_similarity
from sklearn.decomposition import PCA
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D


model_checkpoint = "Snowflake/snowflake-arctic-embed-xs"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = AutoModel.from_pretrained(model_checkpoint, add_pooling_layer=False)


def generate_embedding(document):
    inputs = tokenizer(document, padding=True, truncation=True, return_tensors='pt', max_length=512)
    embedding = model(**inputs)[0][:, 0]
    return embedding


def find_similar_documents(query_document, documents, top_n=5):
    query_embedding = generate_embedding(query_document)
    document_embeddings = [generate_embedding(doc) for doc in documents]


    similarity_scores = [cosine_similarity(query_embedding, doc_embedding).item() for doc_embedding in document_embeddings]
    sorted_indices = torch.argsort(torch.tensor(similarity_scores), descending=True)


    top_documents = [documents[idx] for idx in sorted_indices[:top_n]]
    top_scores = [similarity_scores[idx] for idx in sorted_indices[:top_n]]


    return top_documents, top_scores, document_embeddings


# Sample documents
documents = [
    "This is a tutorial about Snowflake Arctic Embedding models",
    "Arctic-embed is a state-of-the-art text embedding model.",
    "Snowflake provides various cloud data warehousing solutions.",
    "Embedding models are used for representing text as dense vectors.",
    "The Arctic-embed model is based on the transformer architecture."
]


# Streamlit app
st.title("Document Similarity Search With Snowflake Arctic")


query_document = st.text_input("Enter your query document:")
top_k = st.number_input("Enter the number of top documents to retrieve (K):", min_value=1, value=3, step=1)


if st.button("Search"):
    top_documents, top_scores, document_embeddings = find_similar_documents(query_document, documents, top_n=top_k)


    st.subheader("Top {} Similar Documents:".format(top_k))
    for i, (doc, score) in enumerate(zip(top_documents, top_scores)):
        st.write("{}. Document: {}".format(i+1, doc))
        st.write("   Similarity Score: {:.4f}".format(score))


    # Reshape the embeddings
    reshaped_embeddings = torch.stack(document_embeddings).detach().numpy()
    reshaped_embeddings = reshaped_embeddings.reshape(reshaped_embeddings.shape[0], -1)


    # Apply PCA to reduce the embeddings to 3 dimensions
    pca = PCA(n_components=3)
    reduced_embeddings = pca.fit_transform(reshaped_embeddings)


    # Create a 3D plot
    fig = plt.figure(figsize=(8, 6))
    ax = fig.add_subplot(111, projection='3d')


    # Plot the document embeddings
    for i, doc in enumerate(documents):
        ax.scatter(reduced_embeddings[i, 0], reduced_embeddings[i, 1], reduced_embeddings[i, 2], marker='o', label=f"Document {i+1}")


    # Plot the query document embedding
    query_embedding = generate_embedding(query_document)
    reshaped_query_embedding = query_embedding.detach().numpy().reshape(1, -1)
    reduced_query_embedding = pca.transform(reshaped_query_embedding)
    ax.scatter(reduced_query_embedding[0, 0], reduced_query_embedding[0, 1], reduced_query_embedding[0, 2], marker='*', s=100, color='red', label="Query Document")


    ax.set_xlabel('PC1')
    ax.set_ylabel('PC2')
    ax.set_zlabel('PC3')
    ax.legend()
    plt.title('Document Embeddings in 3D Space')


    st.pyplot(fig)
Dengan kode di atas, kita membuat aplikasi Streamlit bernama "Document Similarity Search With Snowflake Arctic." Mari buat beberapa pengamatan tentang kodenya:
st.text_input() dan menentukan jumlah dokumen teratas yang akan diambil (K) menggunakan st.number_input().st.button("Search")), fungsi find_similar_documents() dipanggil dengan dokumen kueri, daftar dokumen, dan nilai top_k yang ditentukan.st.subheader() dan st.write().st.pyplot(fig).Bagian Streamlit dari kode berfokus pada pembuatan antarmuka pengguna interaktif tempat pengguna dapat memasukkan dokumen kueri, menentukan jumlah dokumen paling mirip yang akan diambil, dan melihat hasilnya beserta visualisasi 3D dari embedding dokumen.
Kode lengkap artikel ini tersedia dalam Jupyter Notebook ini.
Kita dapat memulai aplikasi dengan perintah streamlit run app.py, yang akan membawa kita ke halaman landing. Dengan memberikan dokumen kueri yang sama dan mengatur Top K ke 3, kita mendapatkan hasil berikut:
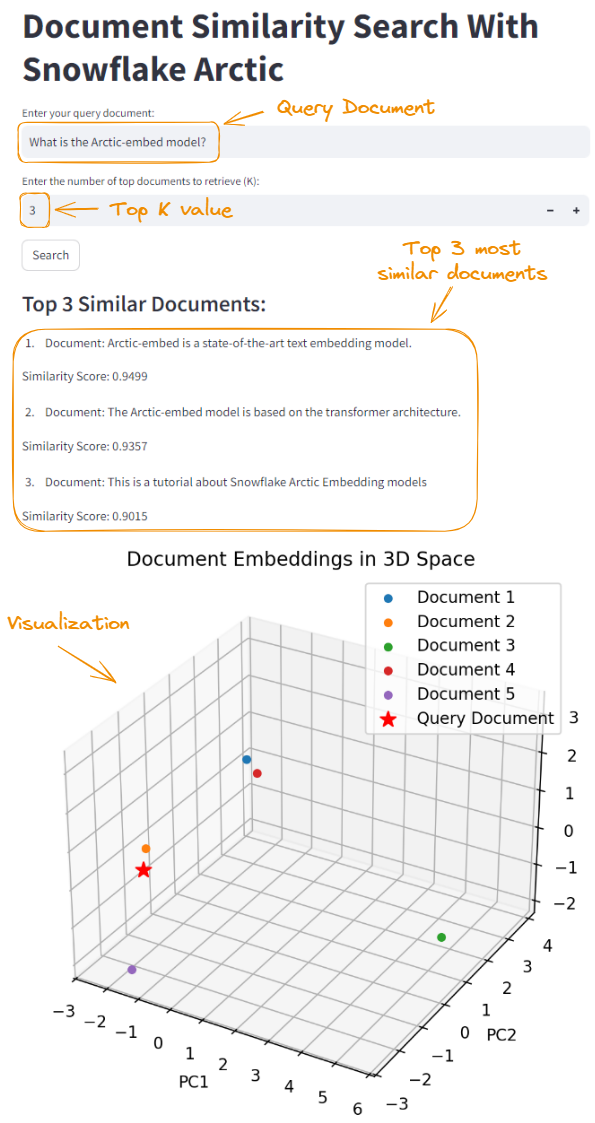
Integrasi Snowflake Arctic menggunakan Streamlit.
Saat bekerja dengan large language model seperti Arctic, sangat penting untuk menguji dan memvalidasi konfigurasi secara menyeluruh di lingkungan target. Ini memastikan kinerja dan keandalan yang optimal. Berikut beberapa tips konfigurasi yang perlu diingat:
Untuk memastikan kinerja optimal dan operasi yang lancar dari Snowflake Arctic, penting untuk mengikuti praktik terbaik dan siap memecahkan masalah apa pun yang mungkin muncul. Di bagian ini, kami akan mengeksplorasi kiat dan trik untuk meningkatkan kinerja berdasarkan tolok ukur dunia nyata dan riset akademik.
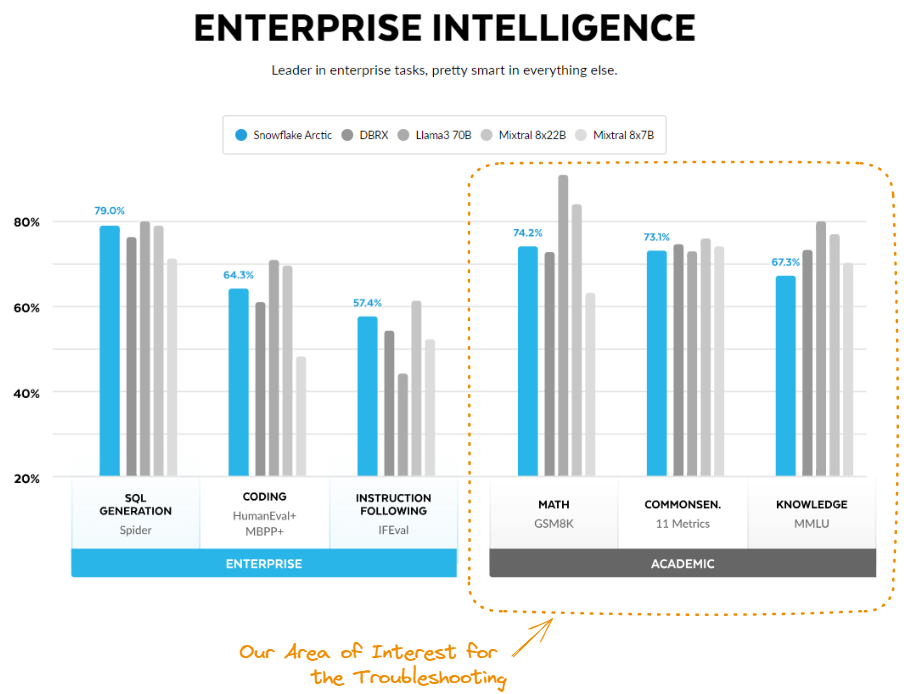
Sumber: Arctic Cloud.
Berikut beberapa kiat dan trik untuk meningkatkan kemampuannya:
Kinerja Snowflake Arctic menonjol baik dalam skenario inferensi maupun pelatihan. Selama inferensi, model ini secara konsisten memberikan rasio kinerja/biaya yang superior dibandingkan model lain. Efisiensi ini meningkat seiring lebih banyak parameter diaktifkan, mempertahankan keunggulan signifikan bahkan di sekitar 60 miliar parameter aktif, melampaui pesaing seperti Mixral dan Llama 3.
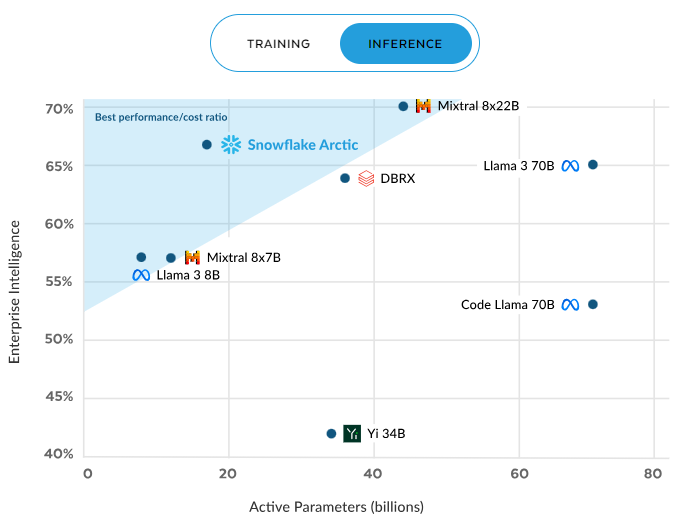
Efisiensi inferensi Arctic. Sumber: Snowflake.com.
Tren ini berlanjut pada pelatihan, di mana Arctic kembali menawarkan rasio kinerja/biaya terbaik. Efisiensi ini meningkat seiring tambahan komputasi, mencapai sekitar 70% pada komputasi 16X, jauh melampaui model seperti DBRX, Llama 3, Code Llama, dan Yi. Hasil ini menegaskan proposisi nilai Arctic: kinerja berkualitas tinggi dengan sebagian kecil biaya komputasi, menjadikannya pilihan menarik bagi perusahaan yang memperhatikan sumber daya.
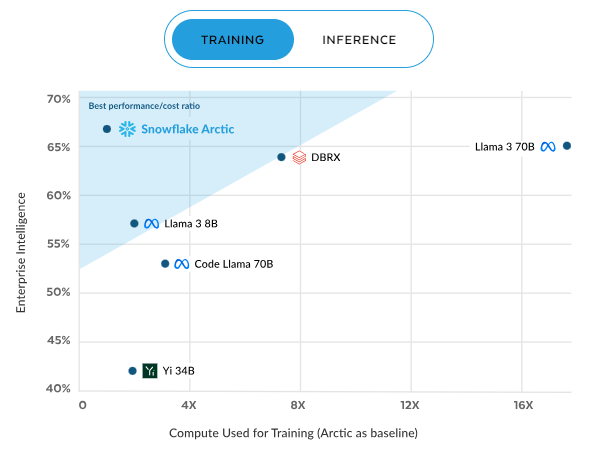
Efisiensi pelatihan Arctic. Sumber: Snowflake.com.
Beberapa kiat dan trik untuk mengoptimalkan kinerja inferensi dan pelatihan meliputi, namun tidak terbatas pada:
Kinerja impresif dan efisiensi biaya Snowflake Arctic telah menetapkan standar baru untuk model bahasa. Pengembangan di masa depan dapat mencakup pemahaman bahasa alami yang lebih maju, peningkatan pembelajaran multi-tugas, dan dukungan yang lebih baik untuk aplikasi khusus domain. Seiring Snowflake terus berinovasi, pengguna dapat mengharapkan alat yang lebih kuat dan serbaguna.
Snowflake menawarkan komunitas yang hebat dan sumber daya dukungan yang komprehensif. Pengguna dapat terhubung, berbagi pengetahuan, dan saling belajar di forum komunitas Snowflake. Dokumentasi dan tutorial terperinci tersedia di situs web resmi untuk membantu pengguna menavigasi dan memaksimalkan fitur Snowflake Arctic.
Snowflake Arctic adalah pengubah permainan di bidang text embeddings, menawarkan solusi yang kuat dan efisien bagi perusahaan yang ingin membuka potensi penuh data mereka. Integrasinya yang mulus dengan Snowflake Data Cloud dan arsitektur yang dapat diskalakan menjadikannya pilihan ideal bagi organisasi yang ingin merampingkan proses pengambilan dan analisis data.
Sepanjang panduan ini, kami telah mengeksplorasi kemampuan inti Snowflake Arctic, mulai dari penyiapan dan konfigurasinya hingga teknik integrasi lanjutan dan penerapan praktis. Dengan memanfaatkan fitur canggih dan optimasi kinerjanya, perusahaan dapat mencapai efisiensi dan akurasi yang lebih baik dalam operasi text embedding mereka.
Jika Anda ingin mempelajari lebih lanjut tentang Snowflake, lihat Snowflake Tutorial for Beginners ini.
Pelajari lebih lanjut tentang LLM!
Kursus
Kursus
Kursus
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt




