
Cursus
Concepten van Large Language Models (LLMs)
2 uur
112K
Snowflake Arctic is een innovatieve ontwikkeling op het gebied van tekst-embeddings, met een krachtige set tools die zijn ontworpen om het gebruik van AI op enterprise-data te vereenvoudigen.
In deze tutorial geven we een overzicht van Snowflake Arctic, doorlopen we het installatieproces, verkennen we integratietechnieken en delen we best practices en tips voor probleemoplossing. We laten ook praktijkvoorbeelden zien, bespreken toekomstige ontwikkelingen en bieden bronnen voor doorlopende ondersteuning en verdere learning.
Wil je meer leren over Snowflake? Bekijk dan deze cursus Introduction to Snowflake.
Dus, wat is Snowflake Arctic precies? Het is een uitgebreide suite aan tools die is ontworpen om de integratie en uitrol van AI binnen de Snowflake Data Cloud te vereenvoudigen. De kern van Snowflake Arctic is een verzameling embeddingmodellen die ons in staat stellen om efficiënt waardevolle inzichten uit onze data te halen.
Daarnaast bevat het een veelzijdig Large Language Model (LLM) voor algemeen gebruik, dat een breed scala aan taken aankan, van het genereren van SQL-queries en programmeercode tot het opvolgen van complexe instructies.
Een van de opvallende kenmerken van Arctic is de naadloze integratie met de Snowflake Data Cloud. Deze nauwe koppeling stelt ons in staat om de kracht van AI direct binnen onze bestaande datainfrastructuur te benutten, wat zorgt voor een veilige en gestroomlijnde ervaring.
Belangrijk is dat alle modellen binnen de Snowflake Arctic-familie beschikbaar zijn onder een Apache 2.0-licentie, waardoor we ze zowel voor academische als commerciële doeleinden kunnen gebruiken.
Snowflake Arctic heeft drie hoofdcomponenten:
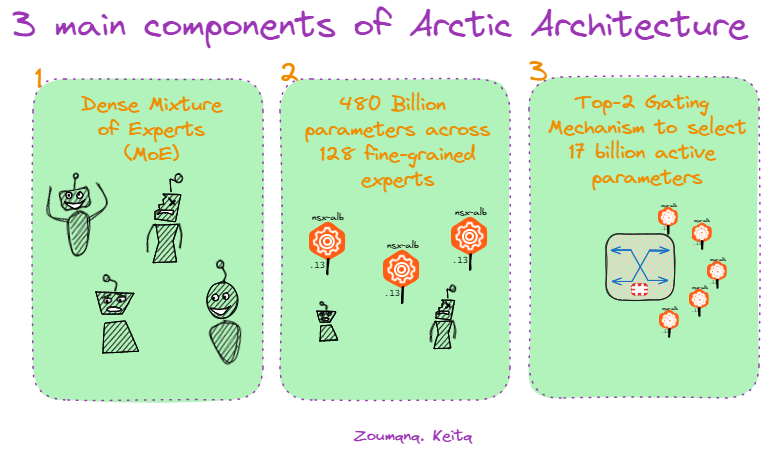
Componenten van Snowflake Arctic.
De architectuur van Snowflake Arctic is gebaseerd op een Dense Mixture of Experts (MoE) hybride transformerdetail, een belangrijke innovatie die efficiënte schaalbaarheid en aanpasbaarheid mogelijk maakt. Deze aanpak maakt gebruik van een uitgestrekt netwerk van 480 miljard parameters, verdeeld over 128 gespecialiseerde experts die elk zijn afgestemd op specifieke taken.
Niet alle experts worden echter bij elke query geactiveerd. Arctic gebruikt een top-2-gatingmechanisme waarbij alleen de twee meest relevante experts voor elke input worden gekozen, waardoor slechts 17 miljard parameters worden geactiveerd. Deze optimalisatie vermindert de rekenlast aanzienlijk, terwijl topniveau-prestaties behouden blijven voor een breed scala aan enterprisegerichte taken.
Snowflake Arctic valt op door de volgende vier kernfeatures:
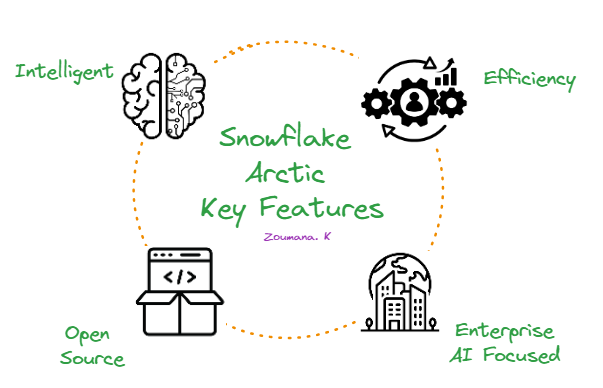
De vier kernfeatures van Snowflake Arctic.
Allereerst is het opmerkelijk intelligent. Arctic blinkt uit in complexe taken zoals het genereren van SQL-queries, het schrijven van code en het volgen van gedetailleerde instructies. In industriële benchmarktests presteert het consequent beter dan vergelijkbare modellen, wat zijn vermogen aantoont om complexe, realistische scenario's aan te kunnen.
Ten tweede is Arctic ontworpen voor efficiëntie. Dankzij de unieke architectuur levert het topprestaties met minder rekenbronnen. Dat vertaalt zich in aanzienlijke kostenbesparingen, waardoor het een aantrekkelijke optie is voor organisaties van elke omvang.
Ten derde omarmt Snowflake Arctic open source. Het is beschikbaar onder een Apache 2.0-licentie, waardoor iedereen toegang heeft tot de code en de modelgewichten.
Tot slot is Arctic volledig gefocust op enterprise-AI. Het is doelgericht gebouwd om te voldoen aan de specifieke behoeften van bedrijven en levert hoogwaardige resultaten voor taken als data-analyse, procesautomatisering en besluitvorming.
Om aan uiteenlopende enterprise-AI-behoeften te voldoen, heeft Snowflake twee primaire modellen binnen de Snowflake Arctic-familie geïntroduceerd:
Naast de hoofdmodellen biedt Snowflake een familie van vijf tekst-embeddingmodellen onder de Apache 2.0-licentie—allemaal gericht op informatieophaaldtaken. De onderstaande tabel illustreert de prestaties van verschillende Snowflake Arctic-modellen op de Massive Text Embedding Benchmark (MTEB) retrieval-taak, gemeten met NDCG@10.
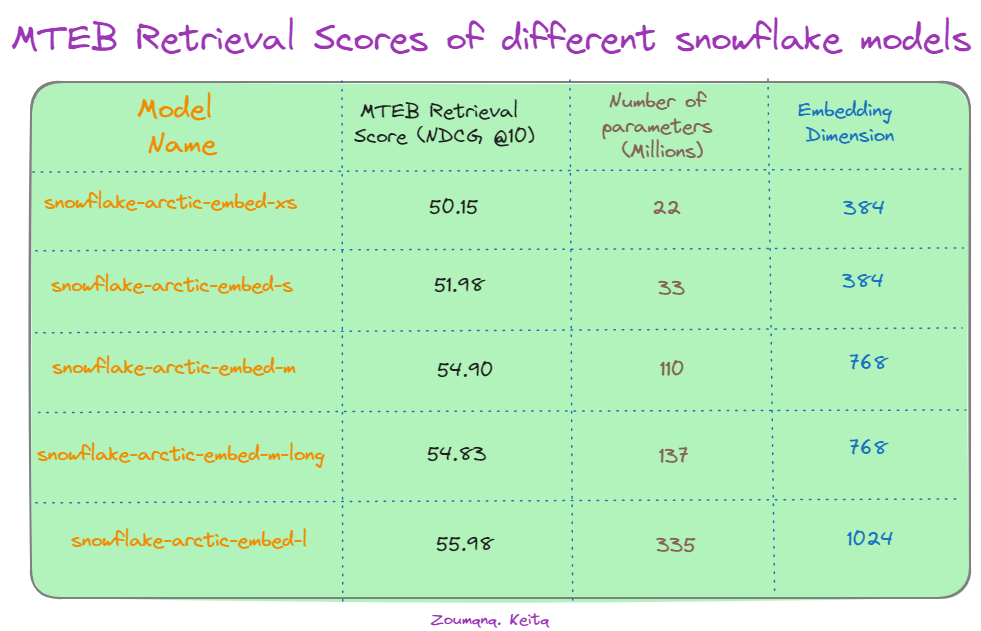
MTEB-retrievalscores van verschillende Snowflake-modellen. Bron: Hugging Face.
We zien om te beginnen een algemene trend van betere prestaties naarmate het model groter is. Het grootste model, "snowflake-arctic-embed-l", behaalt de hoogste NDCG@10-score van 55,98, met 335 miljoen parameters en 1024 embeddingdimensies. Dit suggereert dat schaal een belangrijke rol speelt bij het vastleggen van complexe semantische relaties in tekstdata.
Opvallend is dat het verhogen van de embeddingdimensie van 384 naar 1024 leidt tot betere scores voor het model "snowflake-arctic-embed-l", wat de impact van embeddinggrootte op retrievalnauwkeurigheid onderstreept. Een opmerkelijke uitzondering is echter het model "snowflake-arctic-embed-xs". Ondanks het aanzienlijk lagere aantal parameters (22 miljoen) presteert het vergelijkbaar met grotere modellen met dezelfde embeddingdimensie van 384. Dit wijst erop dat modelefficiëntie en architectuuroptimalisaties in bepaalde scenario's de voordelen van puur meer parameters kunnen compenseren.
Voordat we met de technische implementatie aan de slag gaan, bekijken we het model in actie bij verschillende taken zoals SQL-generatie, coderen en het opvolgen van instructies.
In de Streamlit-demo op Hugging Face kunnen we het model verzoeken geven, de parameters aanpassen en een antwoord krijgen.
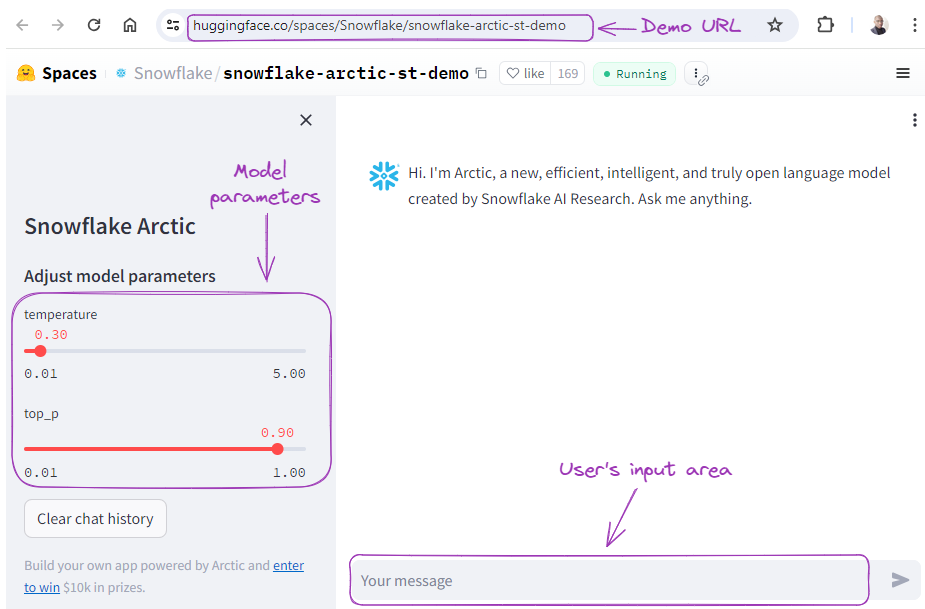
Snowflake Arctic-demo.
Laten we het model eerst vragen een SQL-query te genereren:
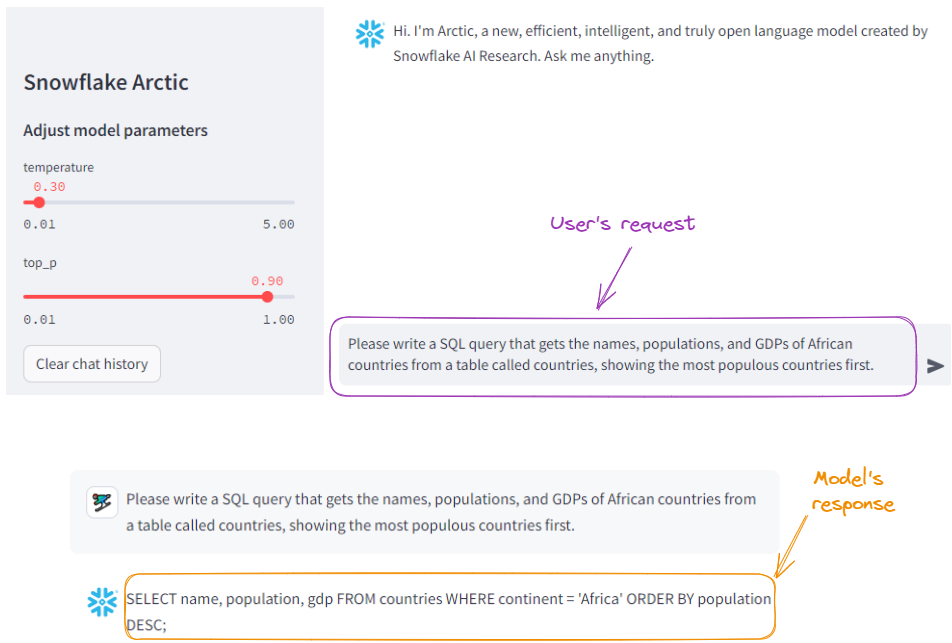
Voorbeeld van SQL-generatie met Snowflake Arctic.
Ter vergelijking dienen we dezelfde aanvraag in bij ChatGPT-4o: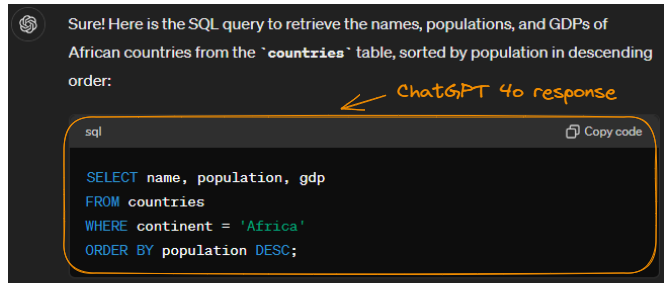
Voorbeeld van SQL-generatie met ChatGPT-4o.
Let op: het genereerde hetzelfde resultaat (met nettere opmaak). We kunnen concluderen dat Arctic het goed heeft gedaan.
Laten we Arctic vragen wat Python-code te schrijven:
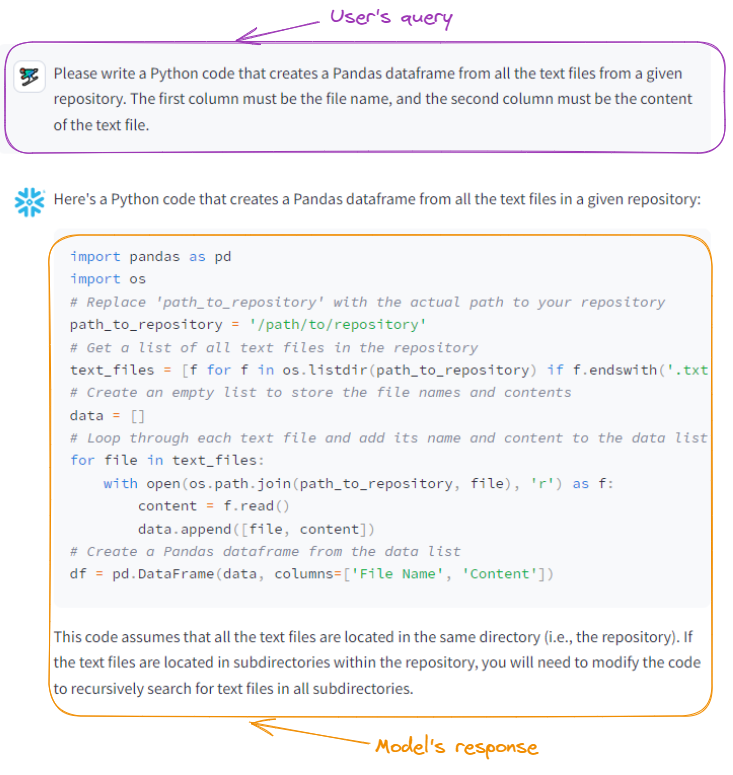
Snowflake Arctic genereert Python-code.
Door dezelfde prompt aan ChatGPT-4o te geven, krijgen we het volgende resultaat, dat ook correct is:
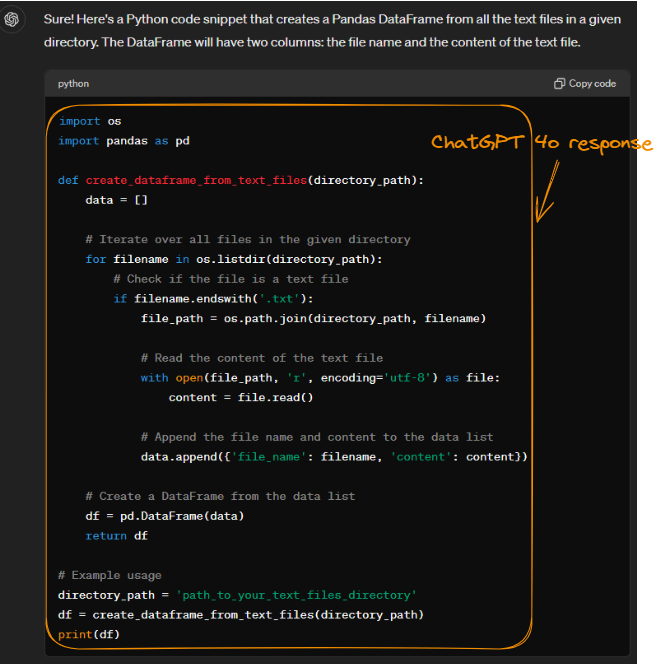
Python-code gegenereerd door ChatGPT-4o.
Hoewel zowel Arctic als ChatGPT-4o dezelfde taak uitvoeren, verschillen hun aanpakken in efficiëntie en geheugengebruik. Beide modellen lezen bestanden efficiënt in met os.listdir() en open().
De aanpak van ChatGPT-4o om een DataFrame te maken uit een lijst met dictionaries kan echter iets meer geheugen verbruiken dan de methode van Arctic met een lijst van lijsten. Dit komt doordat Pandas mogelijk extra verwerking uitvoert om dictionaries af te handelen. Ondanks dit kleine verschil zorgt de modulaire codestructuur van ChatGPT-4o voor betere leesbaarheid en onderhoudbaarheid.
Wil je meer leren over het kiezen van de juiste LLM? Bekijk dan deze tutorial: LLM Classification: How to Select the Best LLM.
Nu we weten waartoe het Snowflake Arctic-model in staat is, richten we ons op het benaderen en configureren van Snowflake Arctic.
Het gebruik van Arctic-modellen vergt veel resources, dus we gebruiken het kleinste model uit de Arctic-familie, snowflake-arctic-embed-xs, dat de minste rekenbronnen nodig heeft.
Hieronder zie je de kenmerken van de omgeving die we in deze tutorial gebruiken—deze tonen we door het commando nvidia-smi uit te voeren:
!nvidia-smi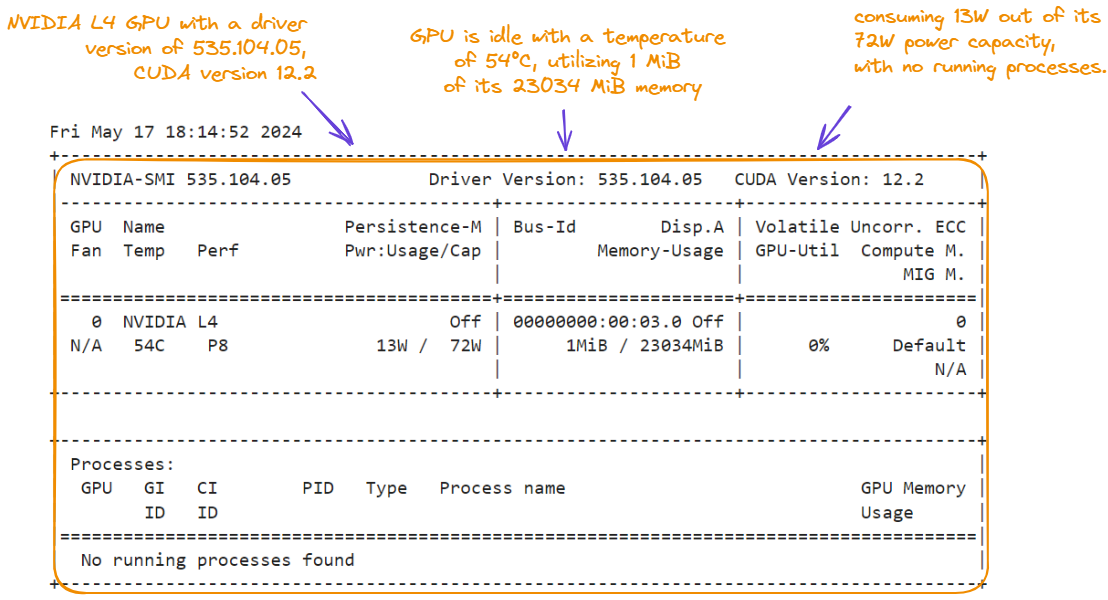
GPU-kenmerken voor de Snowflake Arctic-tutorial.
Naast de NVIDIA L4-GPU heeft de omgeving de volgende kenmerken, die je kunt vinden in de sectie Resources:
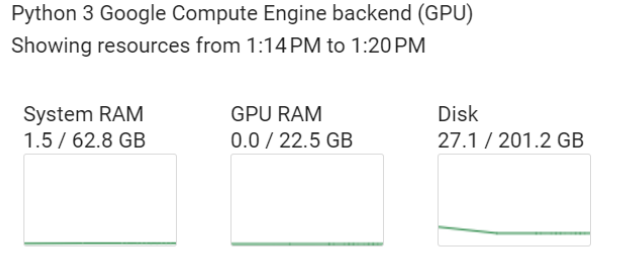
Kenmerken van de compute-engine-backend.
Voor deze hands-on tutorial zijn twee belangrijke libraries nodig: torch en transformers (we draaien onderstaande code vanuit een notebook):
%%bash
pip -qqq install transformers>=4.39.0
pip -qqq install torch
Vervolgens importeren we de benodigde sublibraries:
import torch
from transformers import AutoTokenizer, AutoModel
from torch.nn.functional import cosine_similarityLaten we doorgaan met het laden van het embeddingmodel snowflake-arctic-embed-xs en de bijbehorende tokenizer:
model_checkpoint = "Snowflake/snowflake-arctic-embed-xs"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = AutoModel.from_pretrained(model_checkpoint, add_pooling_layer=False)
We laden het voorgetrainde model dat is gespecificeerd door model_checkpoint zonder een extra poolinglaag, die doorgaans wordt gebruikt om de dimensionaliteit van de modeloutput te reduceren.
Nu alles is ingericht, is de kernusecase in deze sectie om de top N meest vergelijkbare documenten te vinden bij een gegeven document, samen met hun cosinus-similariteitsscores. Dat doen we in vijf hoofdtappen:
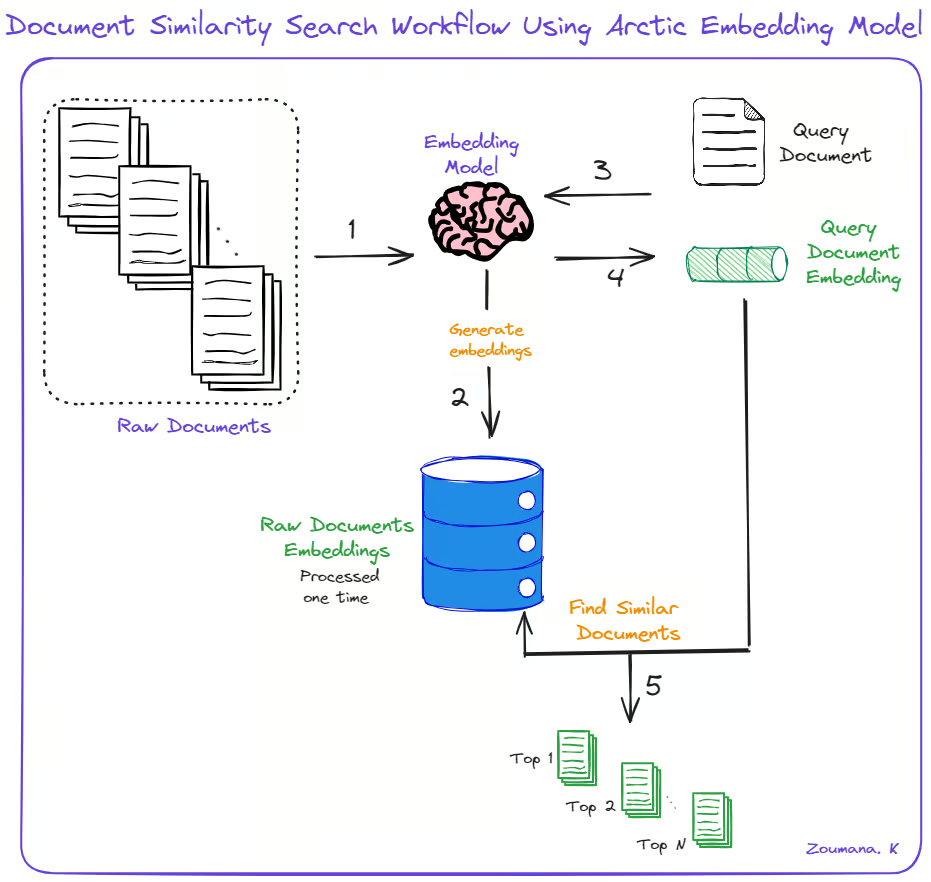
Zoeken naar documentsimilariteit met Snowflake Arctic.
We kunnen de bovenstaande stappen implementeren met de volgende helperfuncties: generate_embedding() en find_similar_documents().
def generate_embedding(document):
    inputs = tokenizer(document, padding=True, truncation=True,
                       return_tensors='pt', max_length=512)

    embedding = model(**inputs)[0][:, 0]
    return embedding


def find_similar_documents(query_document, document_embeddings , top_n=5):

    query_embedding = generate_embedding(query_document)

    similarity_scores = [cosine_similarity(query_embedding,
                                           doc_embedding).item() for doc_embedding in document_embeddings]

    sorted_indices = torch.argsort(torch.tensor(similarity_scores),
                                   descending=True)

    top_documents = [documents[idx] for idx in sorted_indices[:top_n]]
    top_scores = [similarity_scores[idx] for idx in sorted_indices[:top_n]]

    return top_documents, top_scores
De functie generate_embedding() neemt een document als input en genereert de embedding. find_similar_documents() neemt een querydocument, de embeddings van de bestaande documenten en het gewenste aantal terug te geven vergelijkbare documenten.
Voor de eenvoud gebruiken we vijf simpele voorbeelden:
documents = [
    "This is a tutorial about Snowflake Arctic Embedding models",
    "Arctic-embed is a state-of-the-art text embedding model.",
    "Snowflake provides various cloud data warehousing solutions.",
    "Embedding models are used for representing text as dense vectors.",
    "The Arctic-embed model is based on the transformer architecture."
]
Vervolgens genereren we de embeddings:
document_embeddings = [generate_embedding(doc) for doc in documents]Laten we “What is the Arctic-embed model?” als ons querydocument kiezen en vergelijkbare documenten vinden:
query_document = "What is the Arctic-embed model?"
top_documents, top_scores = find_similar_documents(query_document, document_embeddings)
Tot slot lopen we alle topdocumenten langs om de documentinhoud en de similariteitsscore met het querydocument te printen.
print("Query Document:")
print(query_document)
print("\nTop Similar Documents:")
for doc, score in zip(top_documents, top_scores):
    print(f"Document: {doc}")
    print(f"Similarity Score: {score:.4f}")
    print()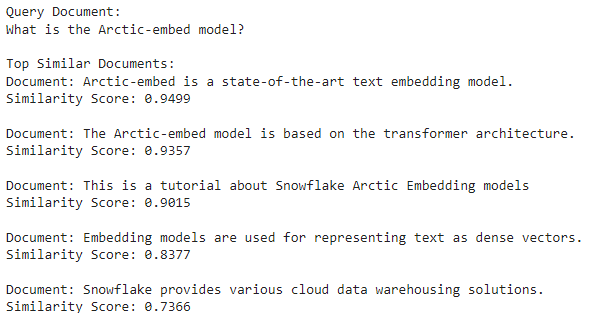
Het tweede document is het meest vergelijkbaar omdat het de hoogste cosinus-similariteitsscore heeft (94,99%).
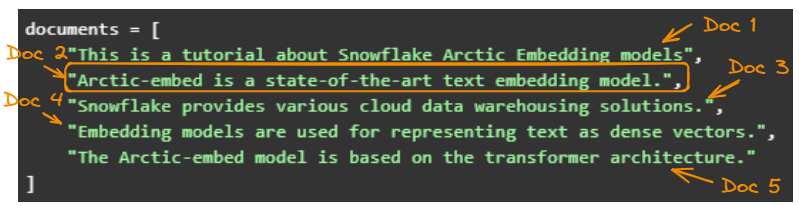
De vijf originele documenten.
Als we de documenten in een 3D-ruimte visualiseren, zien we welke documenten dichter bij elkaar liggen.
De originele embeddings hebben 512 dimensies, wat onmogelijk te visualiseren is. De eenvoudigste manier is om de dimensionaliteit te reduceren met Principal Component Analysis (PCA). Wil je meer leren over PCA? Bekijk dan deze tutorial: Principal Component Analysis (PCA) in Python.
Voordat we PCA gebruiken, moeten we de functie find_similar_documents() aanpassen zodat deze de document-embeddings teruggeeft die PCA zal gebruiken.
def find_similar_documents(query_document, documents, top_n=5):
    query_embedding = generate_embedding(query_document)
    document_embeddings = [generate_embedding(doc) for doc in documents]

    similarity_scores = [cosine_similarity(query_embedding, doc_embedding).item() for doc_embedding in document_embeddings]
    sorted_indices = torch.argsort(torch.tensor(similarity_scores), descending=True)

    top_documents = [documents[idx] for idx in sorted_indices[:top_n]]
    top_scores = [similarity_scores[idx] for idx in sorted_indices[:top_n]]

    return top_documents, top_scores, document_embeddings
We importeren ook een paar modules die nodig zijn om de visualisatie te maken.
from sklearn.decomposition import PCA
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D
Laten we nu de 3D-visualisatie maken door:
top_documents, top_scores, document_embeddings = find_similar_documents(query_document, documents)

# Reshape the embeddings
reshaped_embeddings = torch.stack(document_embeddings).detach().numpy()
reshaped_embeddings = reshaped_embeddings.reshape(reshaped_embeddings.shape[0], -1)

# Apply PCA to reduce the embeddings to 3 dimensions
pca = PCA(n_components=3)
reduced_embeddings = pca.fit_transform(reshaped_embeddings)

# Create a 3D plot
fig = plt.figure(figsize=(8, 6))
ax = fig.add_subplot(111, projection='3d')

# Plot the document embeddings
for i, doc in enumerate(documents):
    ax.scatter(reduced_embeddings[i, 0], reduced_embeddings[i, 1], reduced_embeddings[i, 2], marker='o', label=f"Document {i+1}")

# Plot the query document embedding
query_embedding = generate_embedding(query_document)
reshaped_query_embedding = query_embedding.detach().numpy().reshape(1, -1)
reduced_query_embedding = pca.transform(reshaped_query_embedding)
ax.scatter(reduced_query_embedding[0, 0], reduced_query_embedding[0, 1],
           reduced_query_embedding[0, 2], marker='*', s=100, color='red',
           label="Query Document")

ax.set_xlabel('PC1')
ax.set_ylabel('PC2')
ax.set_zlabel('PC3')
ax.legend()
plt.title('Document Embeddings in 3D Space')
plt.show()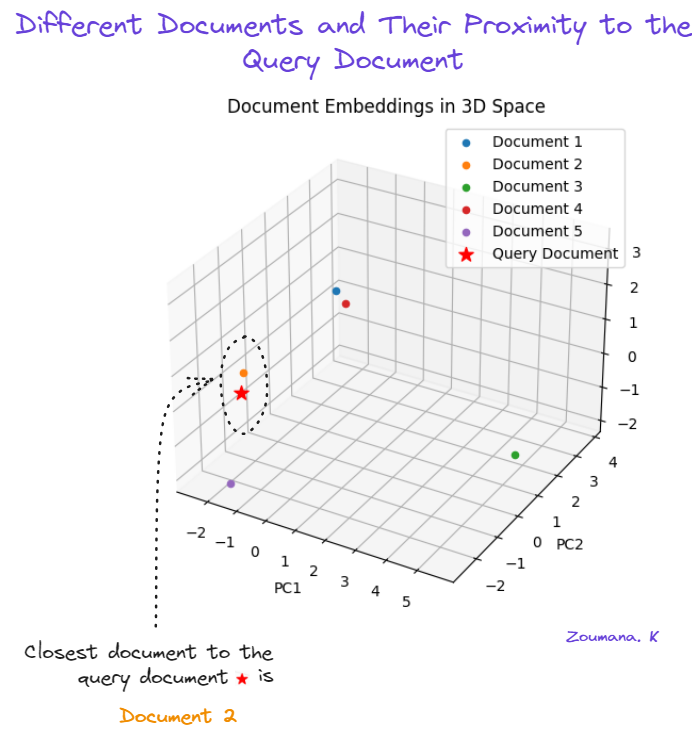
PCA gebruiken om documentsimilariteit te visualiseren.
Het tweede document (oranje) ligt het dichtst bij het querydocument (rode ster). Het vijfde document (paars) is het op één na dichtstbijzijnde, terwijl het derde document (groen) het verst weg ligt.
Notebooks zijn krachtige tools voor experimenteren en snelle visualisatie, en daardoor populair bij data scientists en onderzoekers. Voor productie-omgevingen zijn notebooks echter niet altijd de meest geschikte keuze voor het uitrollen van modellen of applicaties. Daar komt Streamlit om de hoek kijken.
Streamlit is een Python-library die het ontwikkelen van interactieve webapplicaties voor data science- en machinelearningprojecten vereenvoudigt. Het maakt het makkelijk om data science-projecten om te zetten naar productieklare applicaties zonder uitgebreide webdevelopmentkennis.
Hieronder zie je de landingspagina van wat we in deze sectie gaan bouwen.
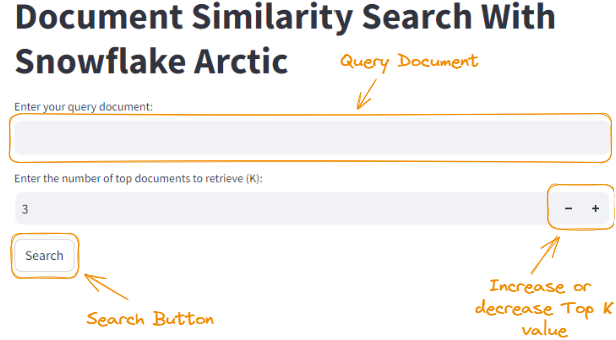
De landingspagina van de Streamlit-applicatie.
Streamlit uitleggen valt buiten de scope van deze tutorial, maar je kunt het vanaf nul leren in deze Python Tutorial: Streamlit.
In deze sectie verkennen we hoe je Streamlit gebruikt om een webapplicatie te maken voor ons documentsimilariteitsproject. Om een Streamlit-app te draaien, moet de code in een Python-bestand staan (met de extensie .py) en voer je het volgende commando in de terminal uit:
streamlit run app.pyDe eerste stap om Streamlit te gebruiken is het installeren met het pip-commando:
pip install streamlitDe code die we gebruikten om de Streamlit-app te bouwen is wat lang, dus neem de tijd om die door te nemen. We leggen het ook uit na het codeblok.
import streamlit as st
from transformers import AutoTokenizer, AutoModel
import torch
from torch.nn.functional import cosine_similarity
from sklearn.decomposition import PCA
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D


model_checkpoint = "Snowflake/snowflake-arctic-embed-xs"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = AutoModel.from_pretrained(model_checkpoint, add_pooling_layer=False)


def generate_embedding(document):
    inputs = tokenizer(document, padding=True, truncation=True, return_tensors='pt', max_length=512)
    embedding = model(**inputs)[0][:, 0]
    return embedding


def find_similar_documents(query_document, documents, top_n=5):
    query_embedding = generate_embedding(query_document)
    document_embeddings = [generate_embedding(doc) for doc in documents]


    similarity_scores = [cosine_similarity(query_embedding, doc_embedding).item() for doc_embedding in document_embeddings]
    sorted_indices = torch.argsort(torch.tensor(similarity_scores), descending=True)


    top_documents = [documents[idx] for idx in sorted_indices[:top_n]]
    top_scores = [similarity_scores[idx] for idx in sorted_indices[:top_n]]


    return top_documents, top_scores, document_embeddings


# Sample documents
documents = [
    "This is a tutorial about Snowflake Arctic Embedding models",
    "Arctic-embed is a state-of-the-art text embedding model.",
    "Snowflake provides various cloud data warehousing solutions.",
    "Embedding models are used for representing text as dense vectors.",
    "The Arctic-embed model is based on the transformer architecture."
]


# Streamlit app
st.title("Document Similarity Search With Snowflake Arctic")


query_document = st.text_input("Enter your query document:")
top_k = st.number_input("Enter the number of top documents to retrieve (K):", min_value=1, value=3, step=1)


if st.button("Search"):
    top_documents, top_scores, document_embeddings = find_similar_documents(query_document, documents, top_n=top_k)


    st.subheader("Top {} Similar Documents:".format(top_k))
    for i, (doc, score) in enumerate(zip(top_documents, top_scores)):
        st.write("{}. Document: {}".format(i+1, doc))
        st.write("   Similarity Score: {:.4f}".format(score))


    # Reshape the embeddings
    reshaped_embeddings = torch.stack(document_embeddings).detach().numpy()
    reshaped_embeddings = reshaped_embeddings.reshape(reshaped_embeddings.shape[0], -1)


    # Apply PCA to reduce the embeddings to 3 dimensions
    pca = PCA(n_components=3)
    reduced_embeddings = pca.fit_transform(reshaped_embeddings)


    # Create a 3D plot
    fig = plt.figure(figsize=(8, 6))
    ax = fig.add_subplot(111, projection='3d')


    # Plot the document embeddings
    for i, doc in enumerate(documents):
        ax.scatter(reduced_embeddings[i, 0], reduced_embeddings[i, 1], reduced_embeddings[i, 2], marker='o', label=f"Document {i+1}")


    # Plot the query document embedding
    query_embedding = generate_embedding(query_document)
    reshaped_query_embedding = query_embedding.detach().numpy().reshape(1, -1)
    reduced_query_embedding = pca.transform(reshaped_query_embedding)
    ax.scatter(reduced_query_embedding[0, 0], reduced_query_embedding[0, 1], reduced_query_embedding[0, 2], marker='*', s=100, color='red', label="Query Document")


    ax.set_xlabel('PC1')
    ax.set_ylabel('PC2')
    ax.set_zlabel('PC3')
    ax.legend()
    plt.title('Document Embeddings in 3D Space')


    st.pyplot(fig)
Met de bovenstaande code hebben we een Streamlit-app gemaakt met de naam "Document Similarity Search With Snowflake Arctic." Een paar observaties over de code:
st.text_input() en het aantal terug te halen topdocumenten (K) opgeven met st.number_input().st.button("Search")), wordt de functie find_similar_documents() aangeroepen met het querydocument, de lijst met documenten en de opgegeven waarde top_k.st.subheader() en st.write().st.pyplot(fig).Het Streamlit-gedeelte van de code richt zich op het creëren van een interactieve gebruikersinterface waarin gebruikers een querydocument kunnen invoeren, het aantal topvergelijkbare documenten kunnen opgeven en de resultaten kunnen bekijken, samen met een 3D-visualisatie van de document-embeddings.
De volledige code van het artikel is beschikbaar in deze Jupyter Notebook.
We kunnen de applicatie starten met het commando streamlit run app.py, waarmee we op de landingspagina terechtkomen. Door hetzelfde querydocument in te voeren en Top K op 3 te zetten, krijgen we het volgende resultaat:
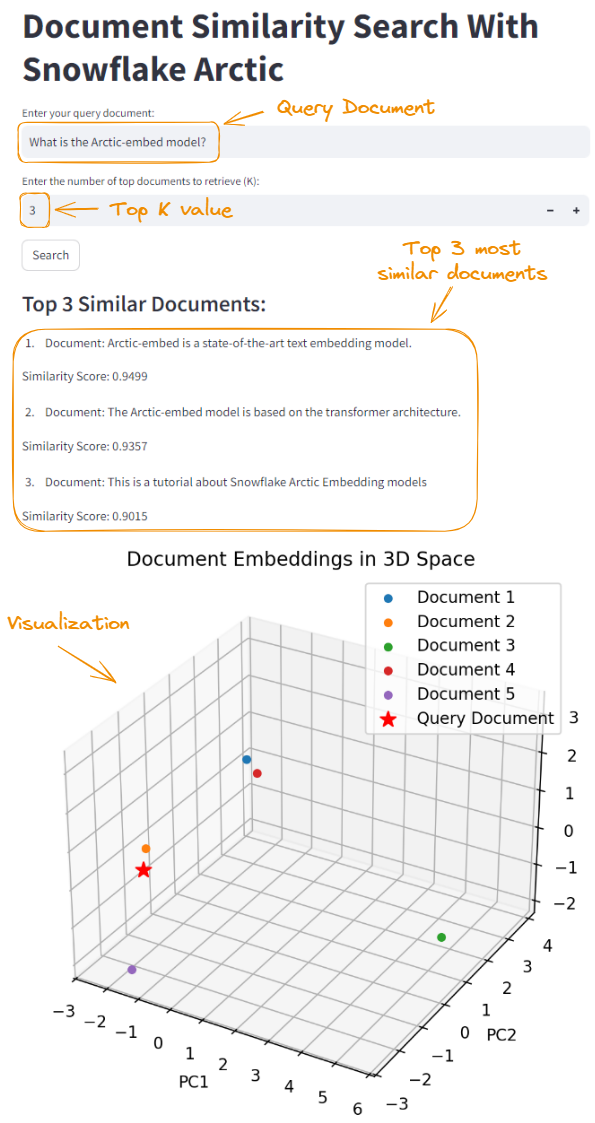
Snowflake Arctic-integratie met Streamlit.
Bij het werken met grote taalmodellen zoals Arctic is het cruciaal om configuraties grondig te testen en te valideren binnen onze doelsituatie. Zo waarborg je optimale prestaties en betrouwbaarheid. Enkele configuratietips om in gedachten te houden:
Om optimale prestaties en een soepele werking van Snowflake Arctic te garanderen, is het belangrijk om best practices te volgen en voorbereid te zijn op eventuele problemen. In deze sectie verkennen we tips en tricks om prestaties te verbeteren, gebaseerd op praktijkbenchmarks en academisch onderzoek.
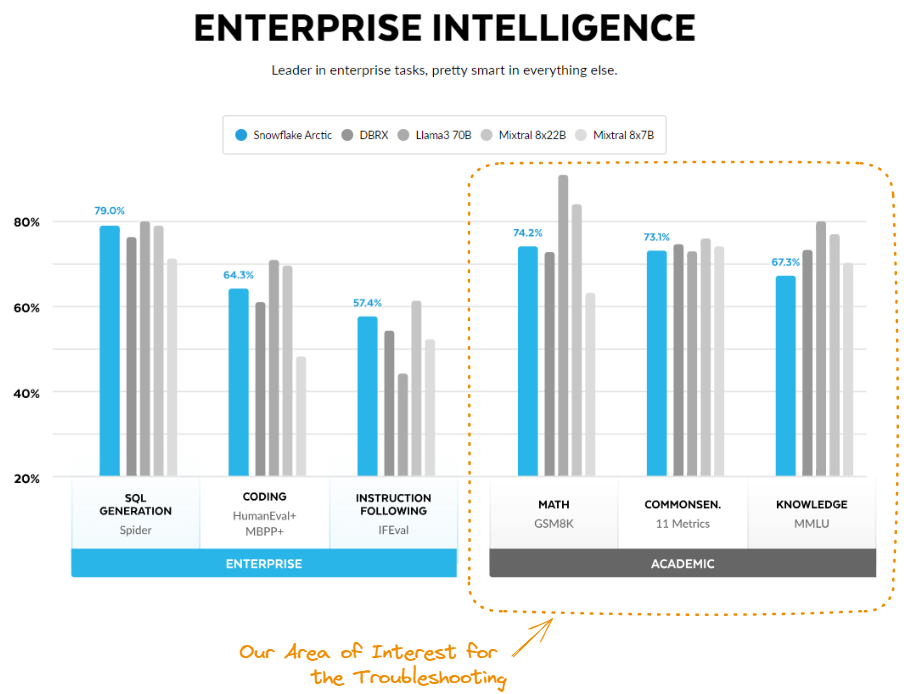
Bron: Arctic Cloud.
Hier zijn enkele tips en tricks om de mogelijkheden te vergroten:
De prestaties van Snowflake Arctic vallen op bij zowel inference als training. Tijdens inference levert het consistent een superieure verhouding prestatie/kosten in vergelijking met andere modellen. Deze efficiëntie verbetert naarmate meer parameters worden geactiveerd en behoudt een aanzienlijk voordeel zelfs rond 60 miljard actieve parameters, waarbij concurrenten zoals Mixral en Llama 3 worden overtroffen.
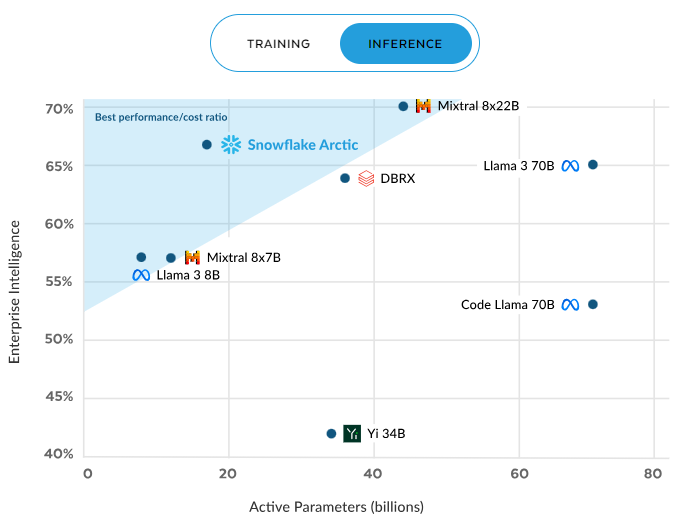
Arctic-inference-efficiëntie. Bron: Snowflake.com.
Die trend zet zich voort bij training, waar Arctic opnieuw de beste verhouding prestatie/kosten behaalt. Deze efficiëntie schaalt mee met meer rekenkracht en bereikt ongeveer 70% bij 16X compute, ver boven modellen als DBRX, Llama 3, Code Llama en Yi. Deze resultaten onderstrepen de waardepropositie van Arctic: hoge kwaliteit tegen een fractie van de rekenkosten, wat het een aantrekkelijke keuze maakt voor kostenbewuste ondernemingen.
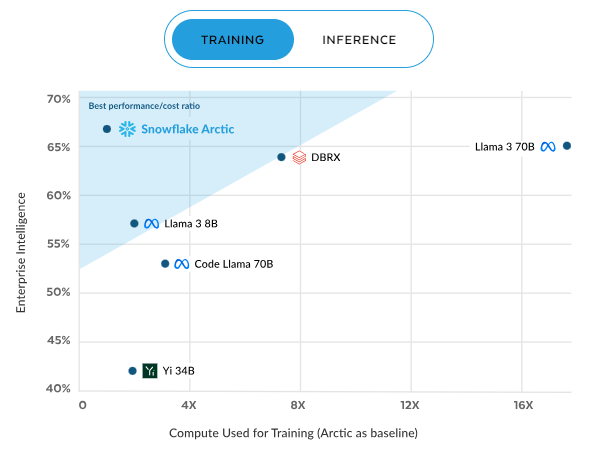
Arctic-trainings-efficiëntie. Bron: Snowflake.com.
Enkele tips en tricks om de prestaties voor inference en training te optimaliseren zijn onder andere:
De indrukwekkende prestaties en kostenefficiëntie van Snowflake Arctic zetten een nieuwe standaard voor taalmodellen. Toekomstige ontwikkelingen kunnen geavanceerde natuurlijke taalbegrip, verbeterde multitask-learning en betere ondersteuning voor domeinspecifieke toepassingen omvatten. Naarmate Snowflake innoveert, kunnen gebruikers nog krachtigere en veelzijdigere tools verwachten.
Snowflake biedt een geweldige community en uitgebreide ondersteuningsbronnen. Gebruikers kunnen contact leggen, kennis delen en van elkaar leren op de communityforums van Snowflake. Gedetailleerde documentatie en tutorials zijn beschikbaar op de officiële website om gebruikers te helpen de features van Snowflake Arctic te benutten.
Snowflake Arctic is een gamechanger op het gebied van tekst-embeddings en biedt een krachtige en efficiënte oplossing voor bedrijven die het volledige potentieel van hun data willen ontsluiten. De naadloze integratie met de Snowflake Data Cloud en schaalbare architectuur maken het een ideale keuze voor organisaties die hun dataretrieval- en analyseprocessen willen stroomlijnen.
In deze gids hebben we de kernmogelijkheden van Snowflake Arctic verkend, van installatie en configuratie tot geavanceerde integratietechnieken en praktische toepassingen. Door de geavanceerde features en prestatie-optimalisaties te benutten, kunnen bedrijven meer efficiëntie en nauwkeurigheid bereiken in hun tekst-embeddingoperaties.
Wil je meer leren over Snowflake? Bekijk dan deze Snowflake Tutorial for Beginners.
Leer meer over LLM's!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

