Kurs
Konzepte großer Sprachmodelle (LLMs)
2 Std.
109.8K
Snowflake Arctic ist eine innovative Entwicklung im Bereich von Text-Embeddings und bietet ein leistungsstarkes Set an Tools, das die Einführung von KI auf Unternehmensdaten deutlich vereinfacht.
In diesem Tutorial geben wir dir einen Überblick über Snowflake Arctic, führen dich durch das Setup, zeigen Integrationsansätze und teilen Best Practices sowie Tipps zur Fehlerbehebung. Außerdem stellen wir Praxisbeispiele vor, blicken auf künftige Entwicklungen und verlinken Ressourcen für kontinuierliche Unterstützung und Lernen.
Wenn du mehr über Snowflake lernen willst, schau dir diesen Kurs an: Introduction to Snowflake.
Was genau ist Snowflake Arctic? Es handelt sich um eine umfassende Tool-Suite, die die Integration und Bereitstellung von KI innerhalb der Snowflake Data Cloud vereinfacht. Im Kern stellt Snowflake Arctic eine Sammlung von Embedding-Modellen bereit, mit denen wir effizient wertvolle Erkenntnisse aus unseren Daten gewinnen können.
Zusätzlich enthält es ein vielseitiges Large Language Model (LLM) für allgemeine Zwecke, das ein breites Aufgabenspektrum abdeckt – von der Generierung von SQL-Abfragen und Programmcode bis hin zum Befolgen komplexer Anweisungen.
Ein herausragendes Merkmal von Arctic ist die nahtlose Integration in die Snowflake Data Cloud. Diese enge Verzahnung ermöglicht es uns, die Leistungsfähigkeit von KI direkt in unserer bestehenden Dateninfrastruktur zu nutzen – sicher und ohne Reibungsverluste.
Wichtig: Alle Modelle der Snowflake-Arctic-Familie sind unter der Apache-2.0-Lizenz verfügbar und können sowohl akademisch als auch kommerziell genutzt werden.
Snowflake Arctic besteht aus drei Hauptkomponenten:
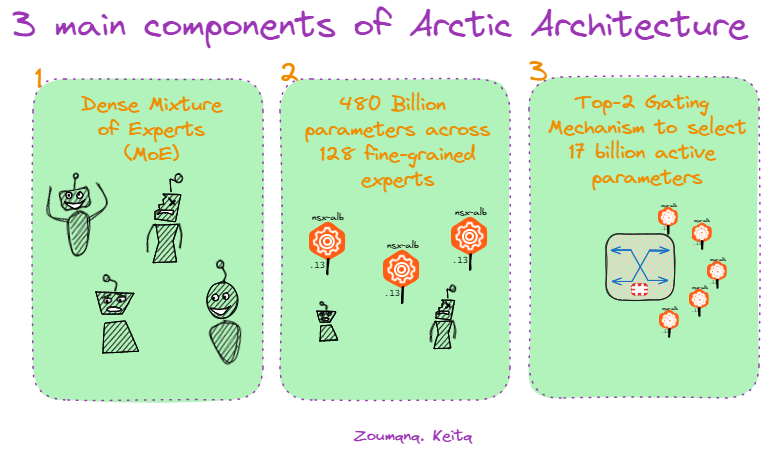
Komponenten von Snowflake Arctic.
Die Architektur von Snowflake Arctic basiert auf einem hybriden Transformer-Design mit Dense Mixture of Experts (MoE) – eine Schlüsselinnovation, die effiziente Skalierung und Anpassungsfähigkeit ermöglicht. Dieser Ansatz nutzt ein großes Netzwerk aus 480 Milliarden Parametern, verteilt auf 128 spezialisierte Experts, die jeweils für bestimmte Aufgaben feinabgestimmt sind.
Allerdings werden nicht bei jeder Abfrage alle Experts aktiviert. Arctic verwendet ein Top-2-Gating und wählt für jeden Input nur die zwei relevantesten Experts aus – so werden effektiv lediglich 17 Milliarden Parameter aktiviert. Diese Optimierung reduziert den Rechenaufwand deutlich, während die Spitzenleistung für eine breite Palette unternehmensrelevanter Aufgaben erhalten bleibt.
Snowflake Arctic überzeugt insbesondere durch vier zentrale Stärken:
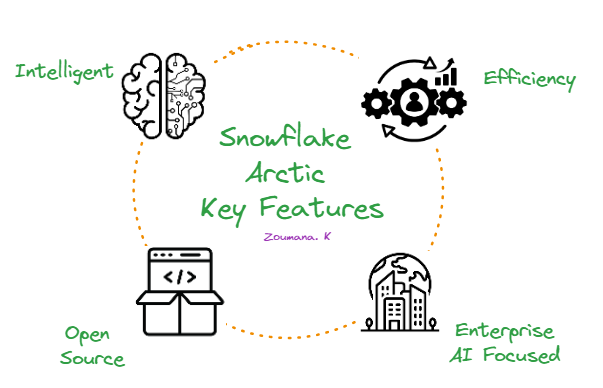
Die vier zentralen Stärken von Snowflake Arctic.
Erstens ist es ausgesprochen leistungsfähig. Arctic meistert komplexe Aufgaben wie das Generieren von SQL-Abfragen, das Schreiben von Code und das Befolgen detaillierter Anweisungen. In Branchenbenchmarks liegt es regelmäßig vor vergleichbaren Modellen und zeigt, dass es auch anspruchsvolle, praxisnahe Szenarien souverän bewältigt.
Zweitens ist Arctic auf Effizienz ausgelegt. Durch die besondere Architektur liefert es Top-Performance bei geringerem Ressourcenverbrauch. Das senkt die Kosten spürbar – attraktiv für Unternehmen jeder Größe.
Drittens setzt Snowflake Arctic auf Open Source. Es steht unter der Apache-2.0-Lizenz zur Verfügung – inklusive Code und Model Weights.
Viertens ist Arctic konsequent auf Enterprise-KI ausgerichtet. Es adressiert die speziellen Anforderungen von Unternehmen und liefert hochwertige Ergebnisse für Aufgaben wie Datenanalyse, Prozessautomatisierung und Entscheidungsunterstützung.
Um unterschiedliche Anforderungen an Enterprise-KI abzudecken, bietet Snowflake zwei Hauptvarianten innerhalb der Arctic-Familie:
Ergänzend zu den Hauptmodellen stellt Snowflake eine Familie von fünf Text-Embedding-Modellen unter Apache 2.0 bereit – alle auf Information-Retrieval ausgelegt. Die folgende Tabelle zeigt die Performance verschiedener Snowflake-Arctic-Modelle bei der Massive Text Embedding Benchmark (MTEB) Retrieval-Aufgabe, gemessen mit NDCG@10.
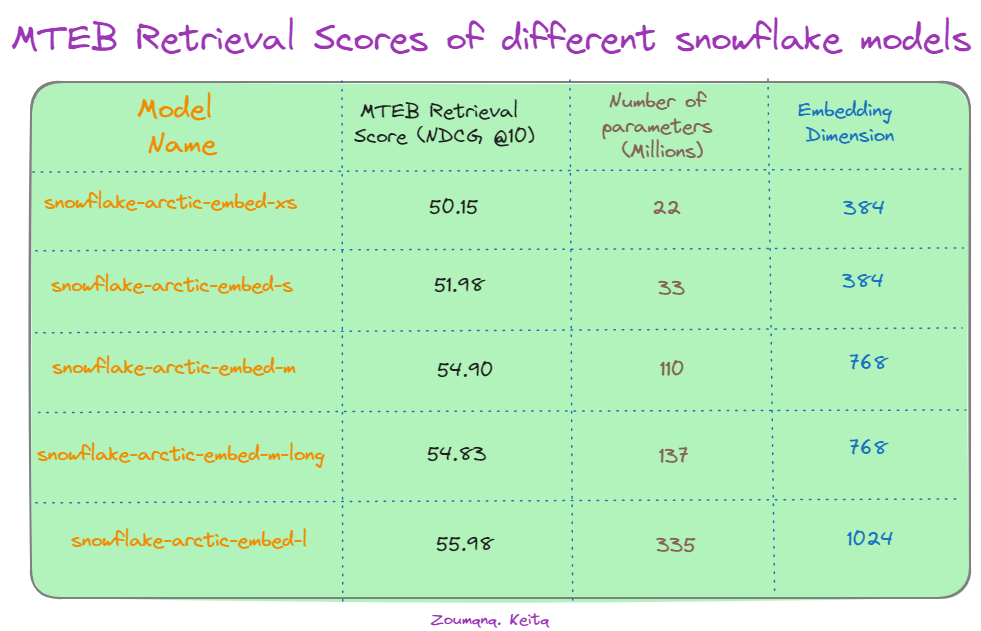
MTEB-Retrieval-Scores verschiedener Snowflake-Modelle. Quelle: Hugging Face.
Zunächst fällt ein allgemeiner Trend auf: Größere Modelle erzielen bessere Ergebnisse. Das größte Modell, „snowflake-arctic-embed-l“, erreicht mit 335 Millionen Parametern und 1024 Embedding-Dimensionen den höchsten NDCG@10-Wert von 55,98. Das deutet darauf hin, dass der Modellumfang eine wichtige Rolle beim Erfassen feiner semantischer Beziehungen in Textdaten spielt.
Interessant ist zudem: Das Erhöhen der Embedding-Dimension von 384 auf 1024 verbessert die Werte beim Modell „snowflake-arctic-embed-l“ – die Embedding-Größe wirkt sich also spürbar auf die Retrieval-Genauigkeit aus. Eine bemerkenswerte Ausnahme ist „snowflake-arctic-embed-xs“: Trotz deutlich weniger Parametern (22 Millionen) erreicht es mit derselben Embedding-Dimension von 384 eine vergleichbare Leistung wie größere Modelle. Das legt nahe, dass Effizienz und architektonische Optimierungen in manchen Szenarien den reinen Parameterumfang ausgleichen können.
Bevor wir in die technische Umsetzung einsteigen, werfen wir einen Blick auf das Modell in Aktion – bei Aufgaben wie SQL-Generierung, Coding und dem Befolgen von Anweisungen.
In der Streamlit-Demo auf Hugging Face kannst du dem Modell Prompts geben, Parameter einstellen und die Antwort ausgeben lassen.
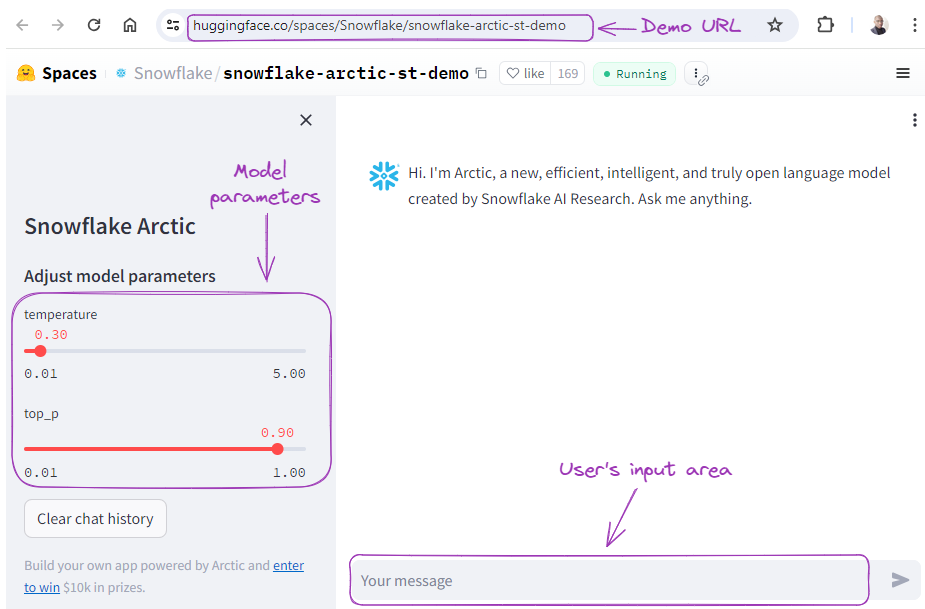
Snowflake-Arctic-Demo.
Fragen wir das Modell zunächst nach einer SQL-Abfrage:
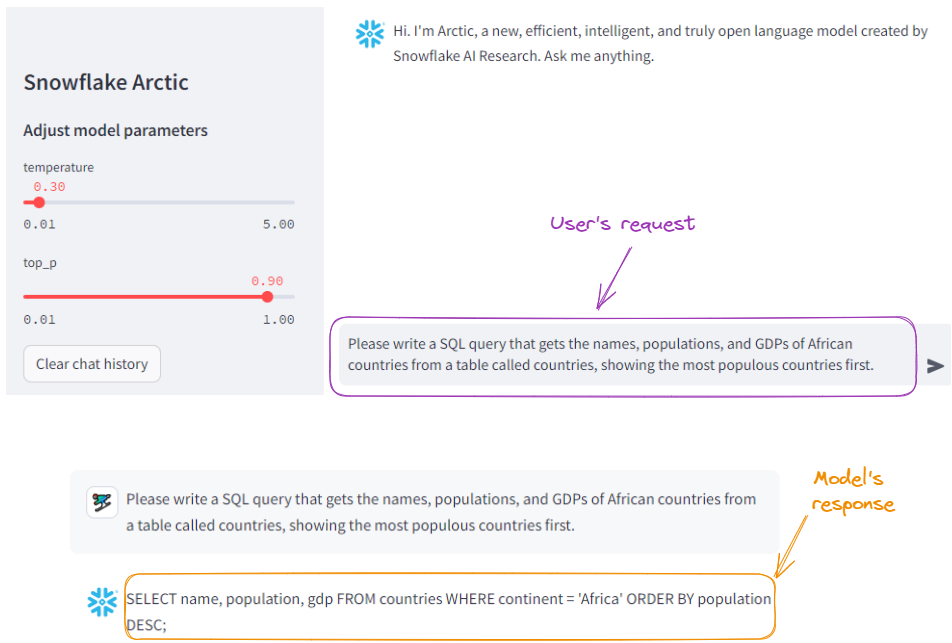
Beispiel für SQL-Generierung mit Snowflake Arctic.
Zum Vergleich schicken wir die gleiche Anfrage an ChatGPT-4o: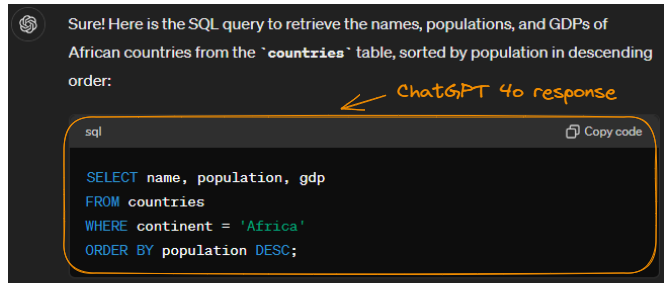
Beispiel für SQL-Generierung mit ChatGPT-4o.
Beachte: Das Ergebnis ist identisch (mit saubererem Format). Fazit: Arctic hat hier einen guten Job gemacht.
Bitten wir Arctic nun, etwas Python-Code zu schreiben:
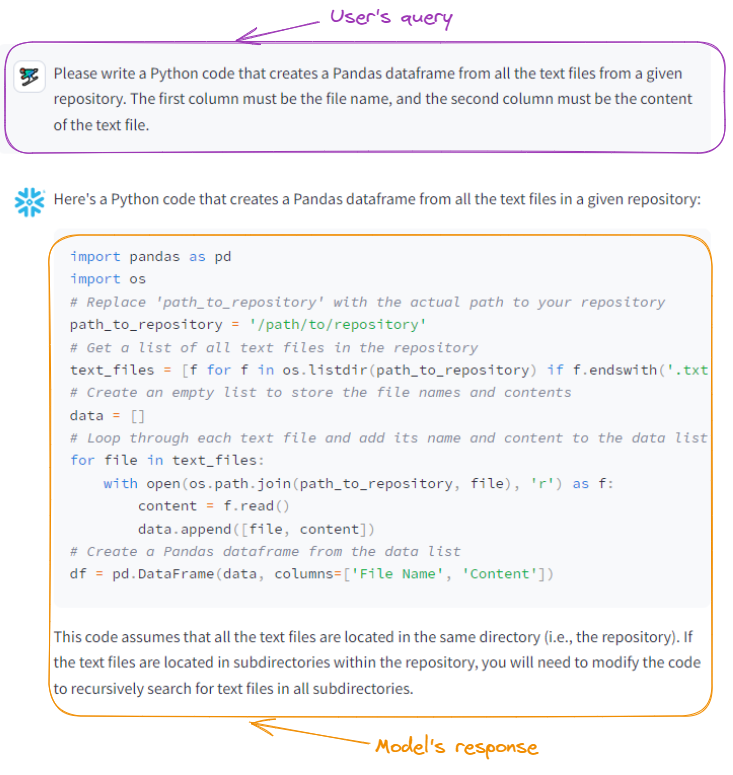
Snowflake Arctic generiert Python-Code.
Mit demselben Prompt an ChatGPT-4o erhalten wir folgendes – ebenfalls korrektes – Ergebnis:
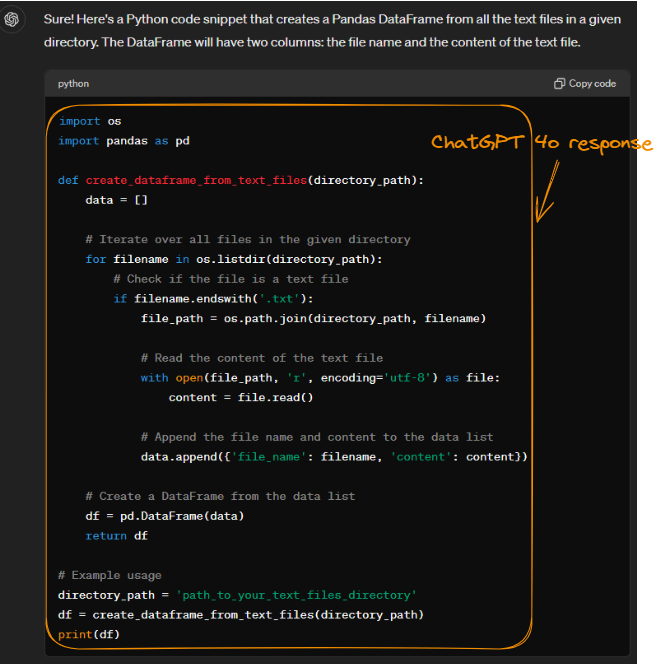
Von ChatGPT-4o generierter Python-Code.
Beide, Arctic und ChatGPT-4o, lösen die Aufgabe, gehen dabei aber unterschiedlich effizient mit Speicher um. Beide Modelle lesen Dateien effizient mit os.listdir() und open().
Allerdings kann der Ansatz von ChatGPT-4o, aus einer Liste von Dictionaries ein DataFrame zu erstellen, etwas mehr Speicher benötigen als Arctics Liste-von-Listen-Variante – Pandas führt bei Dictionaries unter Umständen zusätzliche Verarbeitungsschritte aus. Trotz dieses kleinen Unterschieds erhöht die modulare Struktur des ChatGPT-4o-Codes die Lesbarkeit und Wartbarkeit.
Wenn du mehr darüber erfahren willst, wie du das passende LLM auswählst, sieh dir dieses Tutorial an: LLM Classification: How to Select the Best LLM.
Nachdem wir die Fähigkeiten des Snowflake-Arctic-Modells gesehen haben, konzentrieren wir uns nun auf Zugriff und Konfiguration.
Die Nutzung von Arctic-Modellen ist ressourcenintensiv. Daher verwenden wir das kleinste Modell der Arctic-Familie, snowflake-arctic-embed-xs, das am wenigsten Rechenressourcen benötigt.
Unten siehst du die Eigenschaften der Umgebung, die wir in diesem Tutorial verwenden – angezeigt über den Befehl nvidia-smi:
!nvidia-smi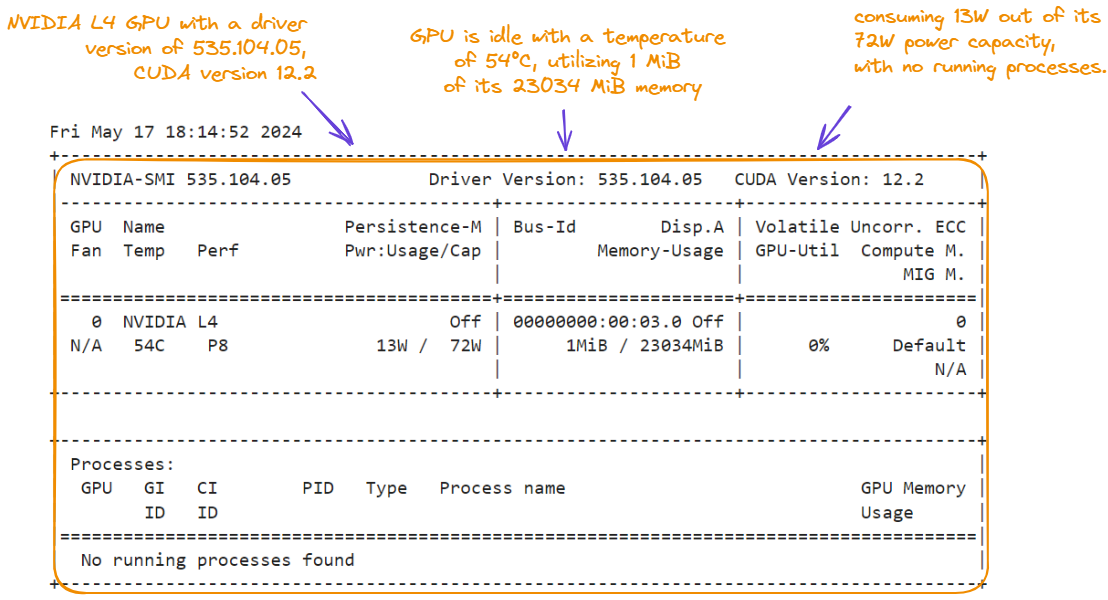
GPU-Eigenschaften für das Snowflake-Arctic-Tutorial.
Zusätzlich zur NVIDIA L4 GPU hat die Umgebung folgende Eigenschaften, die du im Bereich Resources findest:
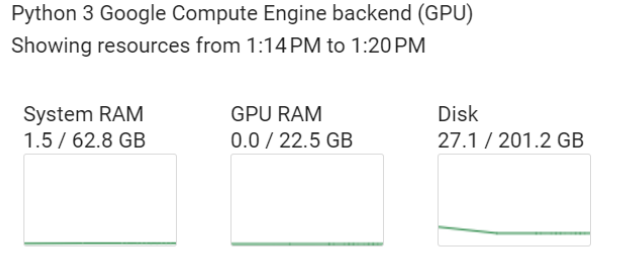
Merkmale des Compute-Engine-Backends.
Für dieses Hands-on-Tutorial brauchst du zwei zentrale Bibliotheken: torch und transformers (wir führen den Code im Notebook aus):
%%bash
pip -qqq install transformers>=4.39.0
pip -qqq install torch
Anschließend importieren wir die benötigten Sublibraries:
import torch
from transformers import AutoTokenizer, AutoModel
from torch.nn.functional import cosine_similarityAls Nächstes laden wir das Embedding-Modell snowflake-arctic-embed-xs samt passendem Tokenizer:
model_checkpoint = "Snowflake/snowflake-arctic-embed-xs"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = AutoModel.from_pretrained(model_checkpoint, add_pooling_layer=False)
Wir laden das vortrainierte Modell aus model_checkpoint ohne zusätzliche Pooling-Schicht, die normalerweise zur Reduzierung der Ausgabedimensionen dient.
Nachdem alles eingerichtet ist, lautet die Kernaufgabe in diesem Abschnitt: Finde zu einem gegebenen Dokument die N ähnlichsten Dokumente samt Kosinus‑Ähnlichkeitswerten. Dafür gehen wir in fünf Schritten vor:
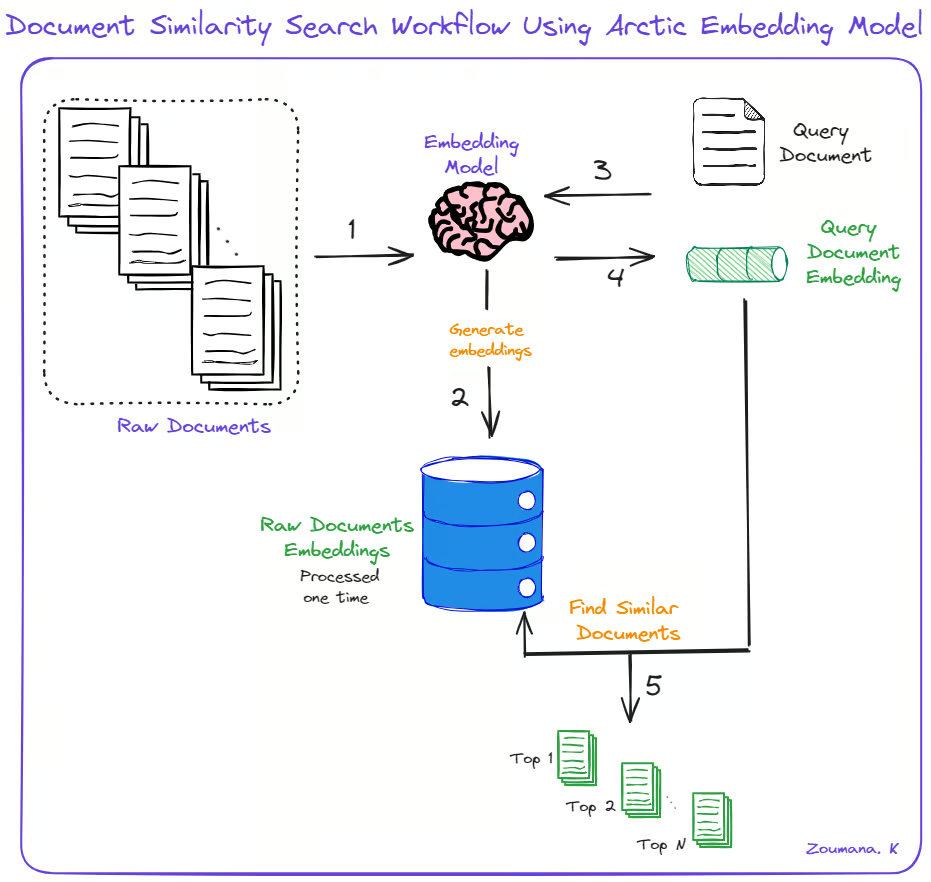
Dokumenten-Ähnlichkeitssuche mit Snowflake Arctic.
Die obigen Schritte setzen wir mit folgenden Helper-Funktionen um: generate_embedding() und find_similar_documents().
def generate_embedding(document):
    inputs = tokenizer(document, padding=True, truncation=True,
                       return_tensors='pt', max_length=512)

    embedding = model(**inputs)[0][:, 0]
    return embedding


def find_similar_documents(query_document, document_embeddings , top_n=5):

    query_embedding = generate_embedding(query_document)

    similarity_scores = [cosine_similarity(query_embedding,
                                           doc_embedding).item() for doc_embedding in document_embeddings]

    sorted_indices = torch.argsort(torch.tensor(similarity_scores),
                                   descending=True)

    top_documents = [documents[idx] for idx in sorted_indices[:top_n]]
    top_scores = [similarity_scores[idx] for idx in sorted_indices[:top_n]]

    return top_documents, top_scores
Die Funktion generate_embedding() nimmt ein Dokument entgegen und erzeugt dessen Embedding. find_similar_documents() erhält ein Query-Dokument, die Embeddings der vorhandenen Dokumente und die gewünschte Anzahl zurückzugebender ähnlicher Dokumente.
Der Einfachheit halber nutzen wir fünf kurze Beispiele:
documents = [
    "This is a tutorial about Snowflake Arctic Embedding models",
    "Arctic-embed is a state-of-the-art text embedding model.",
    "Snowflake provides various cloud data warehousing solutions.",
    "Embedding models are used for representing text as dense vectors.",
    "The Arctic-embed model is based on the transformer architecture."
]
Als Nächstes erzeugen wir die Embeddings:
document_embeddings = [generate_embedding(doc) for doc in documents]Wir wählen „What is the Arctic-embed model?“ als Query-Dokument und suchen ähnliche Dokumente:
query_document = "What is the Arctic-embed model?"
top_documents, top_scores = find_similar_documents(query_document, document_embeddings)
Zum Schluss iterieren wir über die Top-Dokumente und geben Inhalte sowie Ähnlichkeitswerte aus.
print("Query Document:")
print(query_document)
print("\nTop Similar Documents:")
for doc, score in zip(top_documents, top_scores):
    print(f"Document: {doc}")
    print(f"Similarity Score: {score:.4f}")
    print()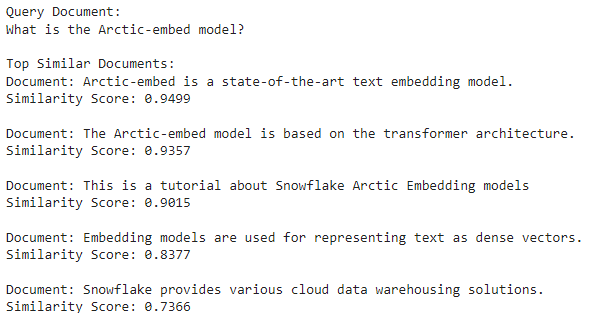
Das zweite Dokument ist am ähnlichsten, da es den höchsten Kosinus‑Ähnlichkeitswert (94,99 %) hat.
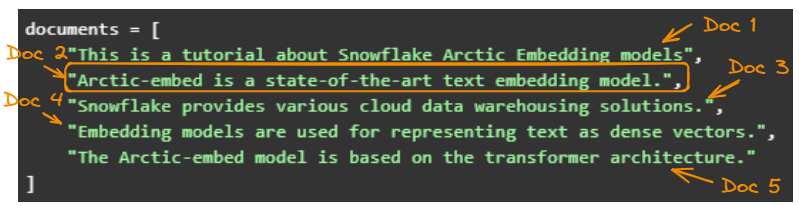
Die fünf Originaldokumente.
In einer 3D-Darstellung siehst du schnell, welche Dokumente nah beieinanderliegen.
Die ursprünglichen Embeddings haben 512 Dimensionen – nicht visualisierbar. Am einfachsten reduzierst du die Dimensionen mit Principal Component Analysis (PCA). Wenn du mehr zu PCA wissen willst, sieh dir dieses Tutorial an: Principal Component Analysis (PCA) in Python.
Bevor wir PCA nutzen, passen wir find_similar_documents() so an, dass die Funktion auch die Dokument-Embeddings für die PCA zurückgibt.
def find_similar_documents(query_document, documents, top_n=5):
    query_embedding = generate_embedding(query_document)
    document_embeddings = [generate_embedding(doc) for doc in documents]

    similarity_scores = [cosine_similarity(query_embedding, doc_embedding).item() for doc_embedding in document_embeddings]
    sorted_indices = torch.argsort(torch.tensor(similarity_scores), descending=True)

    top_documents = [documents[idx] for idx in sorted_indices[:top_n]]
    top_scores = [similarity_scores[idx] for idx in sorted_indices[:top_n]]

    return top_documents, top_scores, document_embeddings
Außerdem importieren wir ein paar Module, die wir für die Visualisierung benötigen.
from sklearn.decomposition import PCA
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D
Jetzt erstellen wir die 3D-Visualisierung, indem wir:
top_documents, top_scores, document_embeddings = find_similar_documents(query_document, documents)

# Reshape the embeddings
reshaped_embeddings = torch.stack(document_embeddings).detach().numpy()
reshaped_embeddings = reshaped_embeddings.reshape(reshaped_embeddings.shape[0], -1)

# Apply PCA to reduce the embeddings to 3 dimensions
pca = PCA(n_components=3)
reduced_embeddings = pca.fit_transform(reshaped_embeddings)

# Create a 3D plot
fig = plt.figure(figsize=(8, 6))
ax = fig.add_subplot(111, projection='3d')

# Plot the document embeddings
for i, doc in enumerate(documents):
    ax.scatter(reduced_embeddings[i, 0], reduced_embeddings[i, 1], reduced_embeddings[i, 2], marker='o', label=f"Document {i+1}")

# Plot the query document embedding
query_embedding = generate_embedding(query_document)
reshaped_query_embedding = query_embedding.detach().numpy().reshape(1, -1)
reduced_query_embedding = pca.transform(reshaped_query_embedding)
ax.scatter(reduced_query_embedding[0, 0], reduced_query_embedding[0, 1],
           reduced_query_embedding[0, 2], marker='*', s=100, color='red',
           label="Query Document")

ax.set_xlabel('PC1')
ax.set_ylabel('PC2')
ax.set_zlabel('PC3')
ax.legend()
plt.title('Document Embeddings in 3D Space')
plt.show()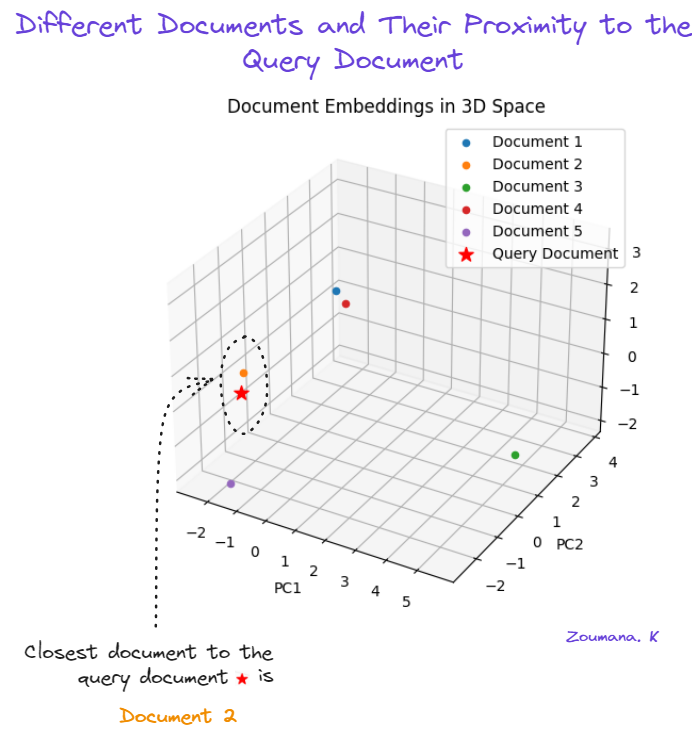
Dokumentenähnlichkeit mit PCA visualisieren.
Das zweite Dokument (orange) liegt am nächsten beim Query-Dokument (roter Stern). Das fünfte Dokument (lila) ist das zweitnächste, während das dritte (grün) am weitesten entfernt ist.
Notebooks sind großartig für Experimente und schnelle Visualisierungen und deshalb bei Data Scientists beliebt. Für die produktive Bereitstellung von Modellen oder Anwendungen sind sie jedoch nicht immer ideal. Hier kommt Streamlit ins Spiel.
Streamlit ist eine Python-Bibliothek für interaktive Web-Apps in Data-Science- und Machine-Learning-Projekten. Damit verwandelst du Data-Science-Arbeiten ohne tiefes Webdev-Know-how in produktionsreife Anwendungen.
Unten siehst du die Landingpage dessen, was wir in diesem Abschnitt bauen.
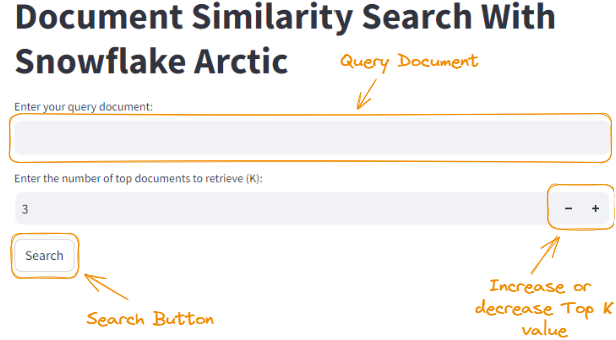
Die Landingpage der Streamlit-Anwendung.
Das Erlernen von Streamlit sprengt den Rahmen dieses Tutorials. Du kannst aber hier von Grund auf einsteigen: Python Tutorial: Streamlit.
In diesem Abschnitt bauen wir mit Streamlit eine Web-App für unsere Dokumenten‑Ähnlichkeitssuche. Um eine Streamlit-App zu starten, muss der Code in einer Python-Datei (.py) liegen und per Terminalbefehl ausgeführt werden:
streamlit run app.pyZuerst installierst du Streamlit mit pip:
pip install streamlitDer Code für die Streamlit-App ist etwas länger – nimm dir Zeit dafür. Im Anschluss erklären wir die wichtigsten Punkte.
import streamlit as st
from transformers import AutoTokenizer, AutoModel
import torch
from torch.nn.functional import cosine_similarity
from sklearn.decomposition import PCA
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D


model_checkpoint = "Snowflake/snowflake-arctic-embed-xs"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = AutoModel.from_pretrained(model_checkpoint, add_pooling_layer=False)


def generate_embedding(document):
    inputs = tokenizer(document, padding=True, truncation=True, return_tensors='pt', max_length=512)
    embedding = model(**inputs)[0][:, 0]
    return embedding


def find_similar_documents(query_document, documents, top_n=5):
    query_embedding = generate_embedding(query_document)
    document_embeddings = [generate_embedding(doc) for doc in documents]


    similarity_scores = [cosine_similarity(query_embedding, doc_embedding).item() for doc_embedding in document_embeddings]
    sorted_indices = torch.argsort(torch.tensor(similarity_scores), descending=True)


    top_documents = [documents[idx] for idx in sorted_indices[:top_n]]
    top_scores = [similarity_scores[idx] for idx in sorted_indices[:top_n]]


    return top_documents, top_scores, document_embeddings


# Sample documents
documents = [
    "This is a tutorial about Snowflake Arctic Embedding models",
    "Arctic-embed is a state-of-the-art text embedding model.",
    "Snowflake provides various cloud data warehousing solutions.",
    "Embedding models are used for representing text as dense vectors.",
    "The Arctic-embed model is based on the transformer architecture."
]


# Streamlit app
st.title("Document Similarity Search With Snowflake Arctic")


query_document = st.text_input("Enter your query document:")
top_k = st.number_input("Enter the number of top documents to retrieve (K):", min_value=1, value=3, step=1)


if st.button("Search"):
    top_documents, top_scores, document_embeddings = find_similar_documents(query_document, documents, top_n=top_k)


    st.subheader("Top {} Similar Documents:".format(top_k))
    for i, (doc, score) in enumerate(zip(top_documents, top_scores)):
        st.write("{}. Document: {}".format(i+1, doc))
        st.write("   Similarity Score: {:.4f}".format(score))


    # Reshape the embeddings
    reshaped_embeddings = torch.stack(document_embeddings).detach().numpy()
    reshaped_embeddings = reshaped_embeddings.reshape(reshaped_embeddings.shape[0], -1)


    # Apply PCA to reduce the embeddings to 3 dimensions
    pca = PCA(n_components=3)
    reduced_embeddings = pca.fit_transform(reshaped_embeddings)


    # Create a 3D plot
    fig = plt.figure(figsize=(8, 6))
    ax = fig.add_subplot(111, projection='3d')


    # Plot the document embeddings
    for i, doc in enumerate(documents):
        ax.scatter(reduced_embeddings[i, 0], reduced_embeddings[i, 1], reduced_embeddings[i, 2], marker='o', label=f"Document {i+1}")


    # Plot the query document embedding
    query_embedding = generate_embedding(query_document)
    reshaped_query_embedding = query_embedding.detach().numpy().reshape(1, -1)
    reduced_query_embedding = pca.transform(reshaped_query_embedding)
    ax.scatter(reduced_query_embedding[0, 0], reduced_query_embedding[0, 1], reduced_query_embedding[0, 2], marker='*', s=100, color='red', label="Query Document")


    ax.set_xlabel('PC1')
    ax.set_ylabel('PC2')
    ax.set_zlabel('PC3')
    ax.legend()
    plt.title('Document Embeddings in 3D Space')


    st.pyplot(fig)
Mit dem obigen Code haben wir eine Streamlit-App namens „Document Similarity Search With Snowflake Arctic“ erstellt. Ein paar Beobachtungen zum Code:
st.text_input() ein und wählen die Anzahl der Top-Dokumente (K) über st.number_input().st.button("Search")) wird find_similar_documents() mit Query, Dokumentliste und top_k aufgerufen.st.subheader() und st.write() an.st.pyplot(fig) in Streamlit angezeigt.Der Streamlit-Teil des Codes konzentriert sich auf eine interaktive UI, in der du ein Query-Dokument eingibst, die Anzahl ähnlicher Dokumente festlegst und die Ergebnisse inklusive 3D-Visualisierung der Embeddings siehst.
Den vollständigen Code findest du in diesem Jupyter Notebook.
Die Anwendung startest du mit streamlit run app.py und landest auf der Startseite. Mit demselben Query-Dokument und Top K = 3 erhältst du folgendes Ergebnis:
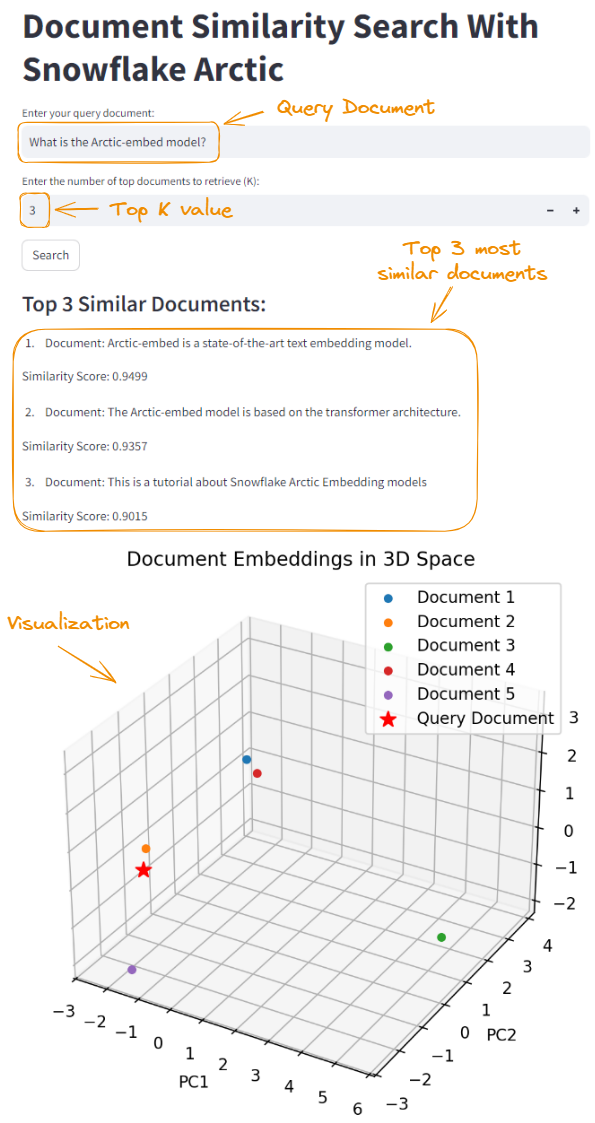
Snowflake-Arctic-Integration mit Streamlit.
Bei großen Sprachmodellen wie Arctic ist es entscheidend, Konfigurationen in der Zielumgebung gründlich zu testen und zu validieren – für optimale Performance und Zuverlässigkeit. Beachte insbesondere:
Damit Snowflake Arctic reibungslos und performant läuft, solltest du Best Practices befolgen und auf mögliche Probleme vorbereitet sein. In diesem Abschnitt teilen wir Tipps und Tricks zur Performance-Steigerung auf Basis von Praxisbenchmarks und Forschung.
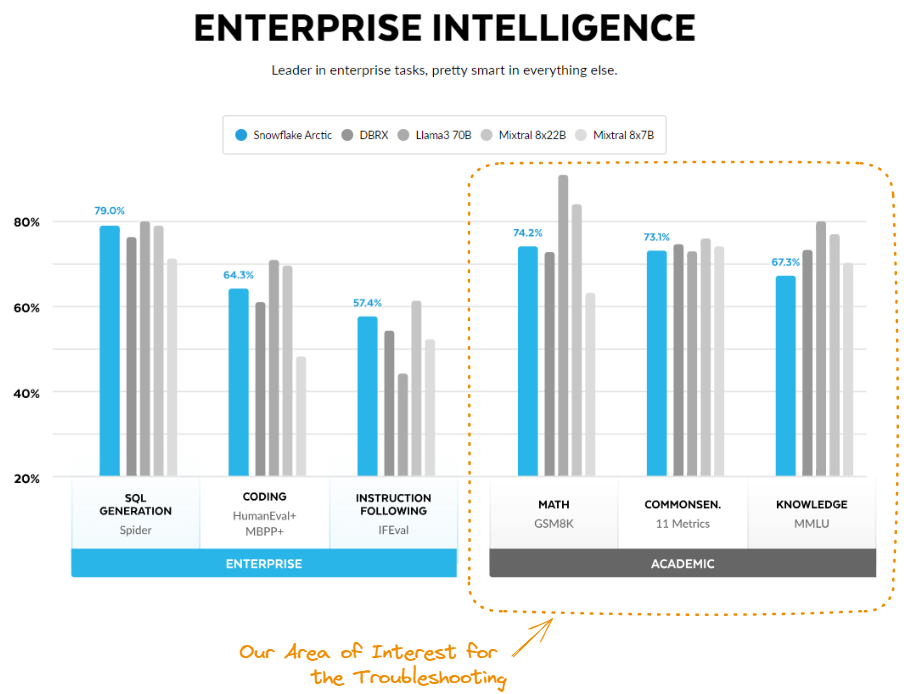
Quelle: Arctic Cloud.
Hier einige Hebel für mehr Leistung:
Arctic überzeugt sowohl bei Inferenz als auch Training. In der Inferenz liefert es durchgängig ein überlegenes Verhältnis aus Leistung und Kosten. Dieser Vorteil bleibt auch bestehen, wenn mehr Parameter aktiviert werden – selbst bei rund 60 Milliarden aktiven Parametern schlägt es Wettbewerber wie Mixral und Llama 3.
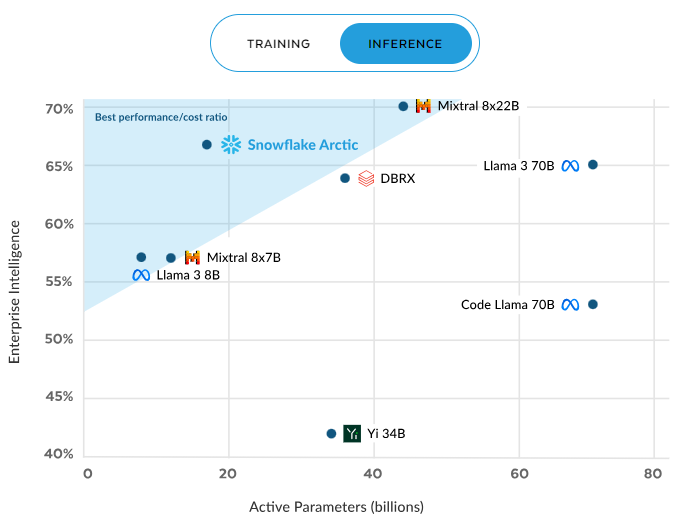
Arctic-Inferenzeffizienz. Quelle: Snowflake.com.
Der Trend setzt sich im Training fort: Auch hier bietet Arctic das beste Verhältnis aus Leistung und Kosten. Mit steigender Rechenleistung skaliert die Effizienz auf etwa 70 % bei 16-facher Compute – deutlich vor Modellen wie DBRX, Llama 3, Code Llama und Yi. Das unterstreicht Arctics Wertversprechen: hohe Qualität bei deutlich geringeren Rechenkosten – ideal für kostenbewusste Unternehmen.
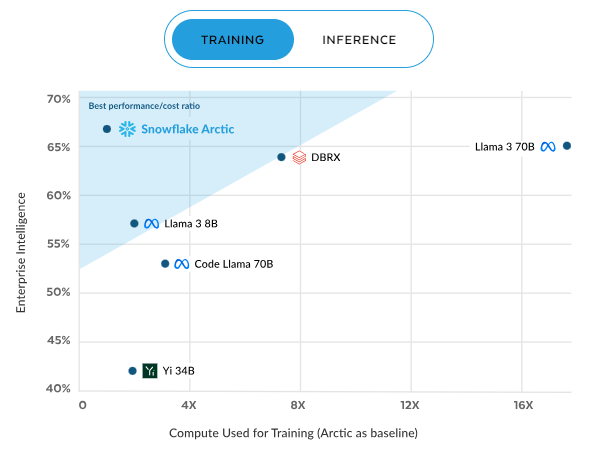
Arctic-Trainingseffizienz. Quelle: Snowflake.com.
Einige Ansätze zur Optimierung von Inferenz und Training sind unter anderem:
Die starke Performance und Kosteneffizienz von Snowflake Arctic setzt neue Maßstäbe für Sprachmodelle. Künftige Entwicklungen könnten bessere Sprachverständnisfähigkeiten, optimiertes Multitask-Lernen und einen erweiterten Support für domänenspezifische Anwendungen umfassen. Mit weiteren Innovationen von Snowflake dürfen Nutzende auf noch leistungsfähigere und vielseitigere Tools hoffen.
Snowflake bietet eine aktive Community und umfassende Support-Ressourcen. Auf den Community-Foren können sich Nutzende austauschen und voneinander lernen. Detaillierte Dokus und Tutorials findest du auf der offiziellen Website, um Snowflake Arctic optimal zu nutzen.
Snowflake Arctic ist ein Gamechanger im Bereich Text-Embeddings und bietet eine leistungsstarke, effiziente Lösung für Unternehmen, die das volle Potenzial ihrer Daten ausschöpfen wollen. Dank der nahtlosen Integration in die Snowflake Data Cloud und der skalierbaren Architektur ist es ideal, um Datenrecherche und -analyse zu beschleunigen.
In diesem Leitfaden haben wir die Kernfunktionen von Snowflake Arctic beleuchtet – vom Setup und der Konfiguration über fortgeschrittene Integrationsansätze bis hin zu praktischen Anwendungen. Wer die erweiterten Features und Performance-Optimierungen nutzt, steigert Effizienz und Genauigkeit in Text-Embedding-Workflows.
Wenn du mehr über Snowflake lernen möchtest, schau dir dieses Snowflake Tutorial for Beginners an.
Erfahre mehr über LLMs!
Kurs
Kurs
Kurs
Blog
Nisha Arya Ahmed
15 Min.
Blog
Tutorial
Matt Crabtree
5 Min.
Tutorial
Sejal Jaiswal
9 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Stephen Gruppetta
12 Min.