Snowflake Arctic là một bước tiến đổi mới trong lĩnh vực nhúng văn bản, cung cấp bộ công cụ mạnh mẽ giúp đơn giản hóa quy trình áp dụng AI trên dữ liệu doanh nghiệp.
Trong hướng dẫn này, chúng tôi sẽ giới thiệu tổng quan về Snowflake Arctic, đi qua quy trình thiết lập, khám phá các kỹ thuật tích hợp, và chia sẻ thực hành tốt nhất cùng mẹo xử lý sự cố. Chúng tôi cũng sẽ trình bày các trường hợp sử dụng trong thực tế, thảo luận về các phát triển trong tương lai, và cung cấp tài nguyên để hỗ trợ và học tập liên tục.
Vậy, chính xác Snowflake Arctic là gì? Đây là một bộ công cụ toàn diện được thiết kế để đơn giản hóa việc tích hợp và triển khai AI trong Snowflake Data Cloud. Cốt lõi của Snowflake Arctic là tập hợp các mô hình nhúng giúp chúng ta trích xuất thông tin giá trị từ dữ liệu một cách hiệu quả.
Ngoài ra, bộ này còn bao gồm một Mô hình Ngôn ngữ Lớn (LLM) đa dụng có khả năng xử lý nhiều tác vụ, từ tạo truy vấn SQL và mã lập trình đến tuân theo các chỉ dẫn phức tạp.
Một trong những điểm nổi bật của Arctic là tích hợp liền mạch với Snowflake Data Cloud. Sự gắn kết chặt chẽ này cho phép chúng ta tận dụng sức mạnh AI trực tiếp trong hạ tầng dữ liệu hiện có, đảm bảo trải nghiệm an toàn và tinh gọn.
Đáng chú ý, tất cả các mô hình trong họ Snowflake Arctic đều được phát hành theo giấy phép Apache 2.0, cho phép sử dụng cho cả mục đích học thuật và thương mại.
Kiến trúc và hiệu năng
Snowflake Arctic có ba thành phần chính:
Các thành phần của Snowflake Arctic.
Kiến trúc của Snowflake Arctic được xây dựng trên thiết kế transformer lai Dense Mixture of Experts (MoE), một đổi mới then chốt cho phép mở rộng hiệu quả và thích ứng linh hoạt. Cách tiếp cận này tận dụng mạng lưới khổng lồ 480 tỷ tham số phân bổ trên 128 chuyên gia chuyên biệt, mỗi chuyên gia được tinh chỉnh cho các tác vụ cụ thể.
Tuy nhiên, không phải chuyên gia nào cũng được kích hoạt cho mọi truy vấn. Arctic sử dụng cơ chế cổng top-2, chỉ chọn hai chuyên gia phù hợp nhất cho mỗi đầu vào, nhờ đó chỉ kích hoạt khoảng 17 tỷ tham số. Tối ưu hóa này giúp giảm đáng kể chi phí tính toán trong khi vẫn duy trì hiệu năng hàng đầu trên nhiều tác vụ tập trung cho doanh nghiệp.
Tính năng chính
Snowflake Arctic nổi bật nhờ bốn tính năng chính sau:
Bốn tính năng chính của Snowflake Arctic.
Trước hết, nó cực kỳ thông minh. Arctic vượt trội ở các tác vụ phức tạp như tạo truy vấn SQL, viết mã, và làm theo hướng dẫn chi tiết. Trong các bài kiểm định chuẩn ngành, nó liên tục vượt qua các mô hình tương tự, cho thấy khả năng xử lý những kịch bản thực tế phức tạp.
Thứ hai, Arctic được thiết kế cho hiệu quả. Kiến trúc độc đáo cho phép cung cấp hiệu năng hàng đầu trong khi tiêu thụ ít tài nguyên tính toán hơn. Điều này chuyển hóa thành tiết kiệm chi phí đáng kể, khiến nó trở thành lựa chọn hấp dẫn cho mọi quy mô tổ chức.
Thứ ba, Snowflake Arctic theo đuổi mã nguồn mở. Nó được phát hành theo giấy phép Apache 2.0, trao quyền truy cập vào mã nguồn và trọng số mô hình cho tất cả mọi người.
Cuối cùng, Arctic tập trung mạnh vào AI cho doanh nghiệp. Nó được xây dựng có chủ đích để đáp ứng nhu cầu cụ thể của doanh nghiệp, mang lại kết quả chất lượng cao cho các tác vụ như phân tích dữ liệu, tự động hóa quy trình, và hỗ trợ ra quyết định.
Các mô hình Snowflake Arctic
Để đáp ứng nhu cầu AI đa dạng trong doanh nghiệp, Snowflake đã giới thiệu hai mô hình chính trong họ Snowflake Arctic:
Snowflake Arctic Instruct: Biến thể này xuất sắc trong việc tạo phản hồi chất lượng cao từ các lời nhắc ngôn ngữ tự nhiên.
Snowflake Arctic Base: Phiên bản này là mô hình ngôn ngữ nền tảng linh hoạt có thể dùng trong nhiều ứng dụng mà không cần tinh chỉnh thêm.
Các mô hình nhúng văn bản Snowflake Arctic
Bên cạnh các mô hình chính, Snowflake cung cấp một họ gồm năm mô hình nhúng văn bản theo giấy phép Apache 2.0—tất cả đều tập trung vào các tác vụ truy xuất thông tin. Bảng dưới minh họa hiệu năng của các mô hình Snowflake Arctic trên bài toán truy xuất của Massive Text Embedding Benchmark (MTEB), đo bằng NDCG@10.
Điểm truy xuất MTEB của các mô hình Snowflake khác nhau. Nguồn: Hugging Face.
Trước hết, có thể thấy xu hướng chung là hiệu năng được cải thiện khi kích thước mô hình tăng. Mô hình lớn nhất, "snowflake-arctic-embed-l," đạt điểm NDCG@10 cao nhất là 55,98, sử dụng 335 triệu tham số và 1024 chiều nhúng. Điều này gợi ý rằng quy mô mô hình đóng vai trò quan trọng trong việc nắm bắt các quan hệ ngữ nghĩa tinh vi trong dữ liệu văn bản.
Điều đáng chú ý là việc tăng số chiều nhúng từ 384 lên 1024 giúp cải thiện điểm số cho mô hình "snowflake-arctic-embed-l," nhấn mạnh tác động của kích thước nhúng tới độ chính xác truy xuất. Tuy nhiên, có một ngoại lệ đáng lưu ý là mô hình "snowflake-arctic-embed-xs". Dù có số tham số ít hơn đáng kể (22 triệu), nó cho hiệu năng tương đương các mô hình lớn hơn có cùng số chiều nhúng 384. Điều này cho thấy hiệu quả mô hình và tối ưu kiến trúc có thể bù đắp lợi ích của số lượng tham số đơn thuần trong một số tình huống.
Snowflake Arctic: Bản demo
Trước khi bắt tay vào phần triển khai kỹ thuật, hãy xem mô hình hoạt động với các tác vụ khác nhau như tạo SQL, viết mã, và làm theo hướng dẫn.
Trước tiên, hãy yêu cầu mô hình tạo một truy vấn SQL:
Ví dụ tạo SQL với Snowflake Arctic.
Để so sánh, hãy gửi cùng yêu cầu đó cho ChatGPT-4o:
Ví dụ tạo SQL với ChatGPT-4o.
Lưu ý rằng kết quả tạo ra là như nhau (với định dạng gọn gàng hơn). Có thể kết luận Arctic đã làm tốt.
Hãy yêu cầu Arctic viết một đoạn mã Python:
Snowflake Arctic tạo mã Python.
Khi cung cấp cùng một prompt cho ChatGPT-4o, chúng ta nhận được kết quả sau, cũng chính xác:
Mã Python do ChatGPT-4o tạo.
Mặc dù cả Arctic và ChatGPT-4o đều hoàn thành cùng tác vụ, cách tiếp cận của chúng khác nhau về hiệu quả và mức sử dụng bộ nhớ. Cả hai mô hình đều đọc tệp hiệu quả bằng os.listdir() và open().
Tuy nhiên, cách tiếp cận của ChatGPT-4o là tạo DataFrame từ danh sách các dictionary có thể tiêu tốn nhiều bộ nhớ hơn một chút so với phương pháp dùng danh sách các danh sách của Arctic. Nguyên nhân là Pandas có thể thực hiện xử lý bổ sung để làm việc với dictionary. Dù khác biệt nhỏ này tồn tại, cấu trúc mã theo mô-đun của ChatGPT-4o giúp tăng khả năng đọc và bảo trì.
Giờ khi đã biết khả năng của mô hình Snowflake Arctic, hãy tập trung vào truy cập và cấu hình Snowflake Arctic.
Đặc tính môi trường
Sử dụng các mô hình Arctic tiêu tốn tài nguyên, vì vậy chúng ta sẽ dùng mô hình nhỏ nhất trong họ Arctic, snowflake-arctic-embed-xs, vốn dùng ít tài nguyên tính toán nhất.
Bên dưới là các đặc tính của môi trường dùng cho hướng dẫn này—chúng ta hiển thị đặc tính bằng cách chạy lệnh nvidia-smi:
Sau đó, chúng ta import các thư viện con cần thiết:
import torch
from transformers import AutoTokenizer, AutoModel
from torch.nn.functional import cosine_similarityĐược hỗ trợ bởi
Tải mô hình và tokenizer
Tiếp tục, hãy tải mô hình nhúng snowflake-arctic-embed-xs và tokenizer tương ứng:
model_checkpoint ="Snowflake/snowflake-arctic-embed-xs"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = AutoModel.from_pretrained(model_checkpoint, add_pooling_layer=False)Được hỗ trợ bởi
Chúng ta tải mô hình tiền huấn luyện được chỉ định bởi model_checkpoint mà không thêm lớp pooling bổ sung, vốn dùng để giảm chiều đầu ra của mô hình.
Tìm kiếm tương đồng tài liệu với Snowflake Arctic
Sau khi thiết lập xong các yêu cầu, trường hợp sử dụng cốt lõi của phần này là tìm N tài liệu giống nhất với một tài liệu cho trước, kèm theo điểm tương đồng cosine của chúng. Để làm điều này, chúng ta thực hiện năm bước chính:
Sử dụng mô hình nhúng để tạo vector nhúng cho các tài liệu thô ban đầu.
Với một tài liệu truy vấn, tạo vector nhúng của nó bằng cùng mô hình nhúng.
Tính toán độ tương đồng giữa nhúng truy vấn và nhúng tài liệu.
Trả về N tài liệu giống nhất kèm theo điểm tương đồng của chúng.
Tìm kiếm tương đồng tài liệu bằng Snowflake Arctic.
Chúng ta có thể triển khai các bước trên bằng những hàm trợ giúp sau: generate_embedding() và find_similar_documents().
Hàm generate_embedding() nhận một tài liệu làm đầu vào và tạo vector nhúng của nó. Hàm find_similar_documents() nhận tài liệu truy vấn, nhúng của các tài liệu hiện có, và số lượng tài liệu tương tự muốn trả về.
Để đơn giản, chúng ta dùng năm ví dụ ngắn:
documents =["This is a tutorial about Snowflake Arctic Embedding models","Arctic-embed is a state-of-the-art text embedding model.","Snowflake provides various cloud data warehousing solutions.","Embedding models are used for representing text as dense vectors.","The Arctic-embed model is based on the transformer architecture."]Được hỗ trợ bởi
Tiếp theo, chúng ta tạo nhúng:
document_embeddings =[generate_embedding(doc)for doc in documents]Được hỗ trợ bởi
Hãy chọn “What is the Arctic-embed model?” làm tài liệu truy vấn và tìm các tài liệu tương tự:
query_document ="What is the Arctic-embed model?"
top_documents, top_scores =find_similar_documents(query_document, document_embeddings)Được hỗ trợ bởi
Cuối cùng, chúng ta lặp qua tất cả tài liệu top để in nội dung và điểm tương đồng với tài liệu truy vấn.
print("Query Document:")print(query_document)print("\nTop Similar Documents:")for doc, score inzip(top_documents, top_scores):print(f"Document: {doc}")print(f"Similarity Score: {score:.4f}")print()Được hỗ trợ bởi
Tài liệu thứ hai là tương tự nhất vì có điểm tương đồng cosine cao nhất (94,99%).
Năm tài liệu gốc.
Trực quan hóa tài liệu 3D
Khi trực quan hóa các tài liệu trong không gian 3D, chúng ta có thể thấy các tài liệu gần nhau.
Các vector nhúng gốc có 512 chiều, điều này không thể trực quan hóa trực tiếp. Cách dễ nhất là giảm chiều bằng Phân tích Thành phần Chính (PCA). Nếu bạn muốn tìm hiểu thêm về PCA, hãy xem hướng dẫn Phân tích Thành phần Chính (PCA) trong Python.
Trước khi dùng PCA, chúng ta cần sửa hàm find_similar_documents() để hàm trả về cả nhúng tài liệu mà PCA sẽ sử dụng.
def find_similar_documents(query_document, documents, top_n=5):
query_embedding =generate_embedding(query_document)
document_embeddings =[generate_embedding(doc)for doc in documents]
similarity_scores =[cosine_similarity(query_embedding, doc_embedding).item()for doc_embedding in document_embeddings]
sorted_indices = torch.argsort(torch.tensor(similarity_scores), descending=True)
top_documents =[documents[idx]for idx in sorted_indices[:top_n]]
top_scores =[similarity_scores[idx]for idx in sorted_indices[:top_n]]return top_documents, top_scores, document_embeddingsĐược hỗ trợ bởi
Chúng ta cũng import một vài mô-đun cần thiết để tạo trực quan.
from sklearn.decomposition importPCAimport matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3DĐược hỗ trợ bởi
Giờ hãy tạo trực quan 3D bằng cách:
Định hình lại các nhúng để phù hợp định dạng đầu vào của PCA.
Giảm nhúng xuống ba chiều.
Tạo trực quan 3D cho các nhúng đã giảm chiều.
top_documents, top_scores, document_embeddings =find_similar_documents(query_document, documents)
# Reshape the embeddings
reshaped_embeddings = torch.stack(document_embeddings).detach().numpy()
reshaped_embeddings = reshaped_embeddings.reshape(reshaped_embeddings.shape[0],-1)
# Apply PCA to reduce the embeddings to 3 dimensions
pca =PCA(n_components=3)
reduced_embeddings = pca.fit_transform(reshaped_embeddings)
# Create a 3D plot
fig = plt.figure(figsize=(8,6))
ax = fig.add_subplot(111, projection='3d')
# Plot the document embeddings
for i, doc inenumerate(documents):
ax.scatter(reduced_embeddings[i,0], reduced_embeddings[i,1], reduced_embeddings[i,2], marker='o', label=f"Document {i+1}")
# Plot the query document embedding
query_embedding =generate_embedding(query_document)
reshaped_query_embedding = query_embedding.detach().numpy().reshape(1,-1)
reduced_query_embedding = pca.transform(reshaped_query_embedding)
ax.scatter(reduced_query_embedding[0,0], reduced_query_embedding[0,1],
reduced_query_embedding[0,2], marker='*', s=100, color='red',
label="Query Document")
ax.set_xlabel('PC1')
ax.set_ylabel('PC2')
ax.set_zlabel('PC3')
ax.legend()
plt.title('Document Embeddings in 3D Space')
plt.show()Được hỗ trợ bởi
Dùng PCA để trực quan hóa độ tương đồng tài liệu.
Tài liệu thứ hai (màu cam) gần nhất với tài liệu truy vấn (ngôi sao đỏ). Tài liệu thứ năm (màu tím) là gần thứ hai, trong khi tài liệu thứ ba (màu xanh lá) là xa nhất.
Tích hợp Snowflake Arctic với Streamlit
Notebook là công cụ mạnh để thử nghiệm và trực quan hóa nhanh, nên rất phổ biến với nhà khoa học dữ liệu và nhà nghiên cứu. Tuy nhiên, notebook có thể không phù hợp nhất khi triển khai mô hình hoặc ứng dụng trong môi trường sản xuất. Đây là lúc Streamlit phát huy tác dụng.
Streamlit là một thư viện Python giúp phát triển ứng dụng web tương tác cho các dự án khoa học dữ liệu và máy học. Nó giúp chuyển dự án khoa học dữ liệu thành ứng dụng sẵn sàng cho sản xuất mà không cần kiến thức phát triển web sâu rộng.
Bên dưới là trang đích của ứng dụng chúng ta sẽ xây dựng trong phần này.
Trang đích của ứng dụng Streamlit.
Việc giảng dạy Streamlit nằm ngoài phạm vi của hướng dẫn này, nhưng bạn có thể học từ đầu qua Hướng dẫn Python: Streamlit.
Kỹ thuật tích hợp cơ bản
Trong phần này, chúng ta sẽ khám phá cách dùng Streamlit để tạo ứng dụng web cho dự án tìm kiếm tương đồng tài liệu. Để chạy một ứng dụng Streamlit, mã cần nằm trong tệp Python (đuôi .py) và thực thi lệnh sau trong terminal:
Mã chúng ta dùng để xây dựng ứng dụng Streamlit khá dài nên hãy dành thời gian xem kỹ. Chúng tôi cũng sẽ giải thích sau khối mã.
import streamlit as st
from transformers import AutoTokenizer, AutoModel
import torch
from torch.nn.functional import cosine_similarity
from sklearn.decomposition importPCAimport matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D
model_checkpoint ="Snowflake/snowflake-arctic-embed-xs"
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = AutoModel.from_pretrained(model_checkpoint, add_pooling_layer=False)
def generate_embedding(document):
inputs =tokenizer(document, padding=True, truncation=True, return_tensors='pt', max_length=512)
embedding =model(**inputs)[0][:,0]return embedding
def find_similar_documents(query_document, documents, top_n=5):
query_embedding =generate_embedding(query_document)
document_embeddings =[generate_embedding(doc)for doc in documents]
similarity_scores =[cosine_similarity(query_embedding, doc_embedding).item()for doc_embedding in document_embeddings]
sorted_indices = torch.argsort(torch.tensor(similarity_scores), descending=True)
top_documents =[documents[idx]for idx in sorted_indices[:top_n]]
top_scores =[similarity_scores[idx]for idx in sorted_indices[:top_n]]return top_documents, top_scores, document_embeddings
# Sample documents
documents =["This is a tutorial about Snowflake Arctic Embedding models","Arctic-embed is a state-of-the-art text embedding model.","Snowflake provides various cloud data warehousing solutions.","Embedding models are used for representing text as dense vectors.","The Arctic-embed model is based on the transformer architecture."]
# Streamlit app
st.title("Document Similarity Search With Snowflake Arctic")
query_document = st.text_input("Enter your query document:")
top_k = st.number_input("Enter the number of top documents to retrieve (K):", min_value=1, value=3, step=1)if st.button("Search"):
top_documents, top_scores, document_embeddings =find_similar_documents(query_document, documents, top_n=top_k)
st.subheader("Top {} Similar Documents:".format(top_k))for i,(doc, score)inenumerate(zip(top_documents, top_scores)):
st.write("{}. Document: {}".format(i+1, doc))
st.write(" Similarity Score: {:.4f}".format(score))
# Reshape the embeddings
reshaped_embeddings = torch.stack(document_embeddings).detach().numpy()
reshaped_embeddings = reshaped_embeddings.reshape(reshaped_embeddings.shape[0],-1)
# Apply PCA to reduce the embeddings to 3 dimensions
pca =PCA(n_components=3)
reduced_embeddings = pca.fit_transform(reshaped_embeddings)
# Create a 3D plot
fig = plt.figure(figsize=(8,6))
ax = fig.add_subplot(111, projection='3d')
# Plot the document embeddings
for i, doc inenumerate(documents):
ax.scatter(reduced_embeddings[i,0], reduced_embeddings[i,1], reduced_embeddings[i,2], marker='o', label=f"Document {i+1}")
# Plot the query document embedding
query_embedding =generate_embedding(query_document)
reshaped_query_embedding = query_embedding.detach().numpy().reshape(1,-1)
reduced_query_embedding = pca.transform(reshaped_query_embedding)
ax.scatter(reduced_query_embedding[0,0], reduced_query_embedding[0,1], reduced_query_embedding[0,2], marker='*', s=100, color='red', label="Query Document")
ax.set_xlabel('PC1')
ax.set_ylabel('PC2')
ax.set_zlabel('PC3')
ax.legend()
plt.title('Document Embeddings in 3D Space')
st.pyplot(fig)Được hỗ trợ bởi
Dùng đoạn mã trên, chúng ta đã tạo một ứng dụng Streamlit tên "Document Similarity Search With Snowflake Arctic." Hãy đưa ra vài nhận xét về mã:
Ứng dụng cho phép người dùng nhập tài liệu truy vấn bằng st.text_input() và chỉ định số lượng tài liệu top cần truy xuất (K) bằng st.number_input().
Khi người dùng nhấn nút Search (st.button("Search")), hàm find_similar_documents() được gọi với tài liệu truy vấn, danh sách tài liệu, và giá trị top_k đã chỉ định.
Ứng dụng hiển thị K tài liệu tương tự nhất cùng điểm số tương đồng bằng st.subheader() và st.write().
Các nhúng tài liệu được định hình lại và giảm xuống 3 chiều bằng PCA để trực quan hóa.
Một biểu đồ 3D được tạo bằng Matplotlib để trực quan hóa nhúng tài liệu và nhúng tài liệu truy vấn.
Biểu đồ 3D được hiển thị trong ứng dụng Streamlit bằng st.pyplot(fig).
Phần Streamlit trong mã tập trung vào việc tạo giao diện người dùng tương tác, nơi người dùng có thể nhập tài liệu truy vấn, chỉ định số lượng tài liệu tương tự cần lấy, và xem kết quả cùng trực quan 3D của các vector nhúng tài liệu.
Chúng ta có thể khởi chạy ứng dụng bằng lệnh streamlit run app.py, lệnh này sẽ dẫn đến trang đích. Khi cung cấp cùng tài liệu truy vấn và đặt Top K là 3, chúng ta nhận kết quả sau:
Tích hợp Snowflake Arctic bằng Streamlit.
Mẹo cấu hình nâng cao
Khi làm việc với các mô hình ngôn ngữ lớn như Arctic, điều quan trọng là kiểm thử và xác thực kỹ cấu hình trong môi trường mục tiêu. Điều này đảm bảo hiệu năng tối ưu và tính tin cậy. Dưới đây là vài mẹo cấu hình cần ghi nhớ:
Lượng tử hóa (Quantization): Giảm độ chính xác của trọng số để thu nhỏ kích thước mô hình và tăng tốc suy luận. Tại thời điểm viết bài, checkpoint đã lượng tử hóa chưa có sẵn và dự kiến sẽ có trong tương lai cho cả suy luận trên Hugging Face và vLLM.
Tăng tốc phần cứng: Tận dụng GPU và huấn luyện/suy luận hỗn hợp độ chính xác.
Chưng cất mô hình: Huấn luyện mô hình "học sinh" nhỏ hơn để bắt chước mô hình "giáo viên" lớn.
Bộ nhớ đệm và tiền xử lý: Lưu trữ các nhúng dùng thường xuyên và tiền xử lý dữ liệu ngoại tuyến.
Giám sát và ghi log: Theo dõi hiệu năng, sử dụng tài nguyên, và lỗi để tối ưu.
Mở rộng và cân bằng tải: Triển khai nhiều phiên bản và phân phối yêu cầu đồng đều.
Bảo mật và kiểm soát truy cập: Thực hiện xác thực, phân quyền, và truyền thông an toàn.
Tối ưu liên tục: Thường xuyên giám sát, phân tích, và thử nghiệm kỹ thuật mới.
Thực hành tốt nhất và xử lý sự cố
Để đảm bảo hiệu năng tối ưu và vận hành trơn tru của Snowflake Arctic, điều quan trọng là tuân theo thực hành tốt nhất và sẵn sàng xử lý mọi vấn đề có thể xảy ra. Trong phần này, chúng ta sẽ khám phá các mẹo và thủ thuật nâng cao hiệu năng dựa trên điểm chuẩn thực tế và nghiên cứu học thuật.
Dưới đây là một số mẹo và thủ thuật để tăng cường khả năng của nó:
Tận dụng engine thực thi vector hóa cho các phép tính nhanh hơn (GSMBK).
Cache các bộ dữ liệu học thuật truy cập thường xuyên và kết quả tính sẵn.
Tối ưu tải dữ liệu bằng kỹ thuật nạp khối và staging cục bộ.
Giảm di chuyển dữ liệu bằng cách tính toán gần nơi lưu trữ.
Tận dụng xử lý song song cho các tác vụ đòi hỏi tính toán cao (GSM8K, MMLU).
Giám sát hiệu năng trên các điểm chuẩn học thuật và xử lý nút thắt cổ chai.
Hợp tác với cộng đồng học thuật và tích hợp phát hiện nghiên cứu mới nhất.
Liên tục kiểm thử và đo chuẩn hiệu năng để xác định khu vực cần cải thiện.
Hiệu năng suy luận
Hiệu năng của Snowflake Arctic nổi bật cả trong kịch bản suy luận và huấn luyện. Trong suy luận, nó liên tục mang lại tỷ lệ hiệu năng/chi phí vượt trội so với các mô hình khác. Sự hiệu quả này tăng lên khi nhiều tham số được kích hoạt, và vẫn duy trì lợi thế đáng kể ngay cả khoảng 60 tỷ tham số hoạt động, vượt trội so với các đối thủ như Mixral và Llama 3.
Xu hướng này tiếp tục ở giai đoạn huấn luyện, nơi Arctic một lần nữa có tỷ lệ hiệu năng/chi phí tốt nhất. Hiệu quả này mở rộng theo tài nguyên tính toán, đạt khoảng 70% ở mức compute 16X, vượt xa các mô hình như DBRX, Llama 3, Code Llama, và Yi. Những kết quả này nhấn mạnh đề xuất giá trị của Arctic: hiệu năng chất lượng cao với chi phí tính toán chỉ bằng một phần, trở thành lựa chọn hấp dẫn cho các doanh nghiệp coi trọng tài nguyên.
Hiệu quả huấn luyện của Arctic. Nguồn: Snowflake.com.
Một số mẹo và thủ thuật để tối ưu hiệu năng cho suy luận và huấn luyện bao gồm nhưng không giới hạn ở:
Tận dụng kiến trúc có khả năng mở rộng của Snowflake để huấn luyện Snowflake Arctic trên tập dữ liệu lớn.
Dùng tính toán phân tán của Snowflake để song song hóa khối lượng huấn luyện và rút ngắn thời gian.
Dùng cơ chế cache dữ liệu của Snowflake để lưu trữ dữ liệu truy cập thường xuyên và kết quả trung gian, tăng tốc huấn luyện.
Tối ưu tải dữ liệu bằng kỹ thuật nạp khối và staging cục bộ để duy trì hiệu năng và giảm chi phí.
Giám sát tiến trình huấn luyện và chỉ số hiệu năng bằng công cụ của Snowflake và giải pháp tùy chỉnh.
Điều chỉnh siêu tham số để cân bằng giữa hiệu năng mô hình và chi phí huấn luyện.
Dùng tài nguyên tính toán tiết kiệm chi phí của Snowflake cho khối lượng suy luận có khả năng mở rộng.
Triển khai pipeline suy luận hiệu quả bằng năng lực kho dữ liệu của Snowflake.
Liên tục giám sát và phân tích chỉ số hiệu năng suy luận để tìm cơ hội tối ưu.
Tương lai của Snowflake Arctic
Hiệu năng ấn tượng và hiệu quả chi phí của Snowflake Arctic đã đặt ra tiêu chuẩn mới cho các mô hình ngôn ngữ. Phát triển trong tương lai có thể bao gồm khả năng hiểu ngôn ngữ tự nhiên nâng cao, cải thiện học đa nhiệm, và hỗ trợ tốt hơn cho ứng dụng theo miền. Khi Snowflake tiếp tục đổi mới, người dùng có thể kỳ vọng các công cụ ngày càng mạnh mẽ và đa dụng hơn.
Snowflake cung cấp cộng đồng tuyệt vời và tài nguyên hỗ trợ toàn diện. Người dùng có thể kết nối, chia sẻ kiến thức, và học hỏi lẫn nhau trên diễn đàn cộng đồng Snowflake. Tài liệu chi tiết và hướng dẫn có sẵn trên trang web chính thức để giúp người dùng điều hướng và tận dụng tối đa các tính năng của Snowflake Arctic.
Kết luận
Snowflake Arctic là một bước ngoặt trong lĩnh vực nhúng văn bản, cung cấp giải pháp mạnh mẽ và hiệu quả cho các doanh nghiệp muốn khai mở toàn bộ tiềm năng dữ liệu. Sự tích hợp liền mạch với Snowflake Data Cloud và kiến trúc có khả năng mở rộng khiến nó trở thành lựa chọn lý tưởng cho các tổ chức muốn tinh gọn quy trình truy xuất và phân tích dữ liệu.
Xuyên suốt hướng dẫn, chúng ta đã khám phá các năng lực cốt lõi của Snowflake Arctic, bao gồm từ thiết lập và cấu hình đến kỹ thuật tích hợp nâng cao và ứng dụng thực tiễn. Bằng cách tận dụng các tính năng nâng cao và tối ưu hiệu năng của nó, doanh nghiệp có thể đạt hiệu quả và độ chính xác cao hơn trong các hoạt động nhúng văn bản.
Nhà khoa học dữ liệu đa tài, yêu thích chia sẻ kiến thức và đóng góp cho cộng đồng, Zoumana là người sáng tạo nội dung trên YouTube và là cây bút công nghệ hàng đầu trên Medium. Anh yêu thích thuyết trình, lập trình và giảng dạy. Zoumana có hai bằng thạc sĩ: một về khoa học máy tính chuyên sâu Học máy tại Paris, Pháp, và một về Khoa học dữ liệu tại Texas Tech University, Hoa Kỳ. Anh bắt đầu sự nghiệp với vai trò Nhà phát triển phần mềm tại Groupe OPEN ở Pháp, sau đó chuyển sang IBM làm Tư vấn Học máy, nơi anh phát triển các giải pháp AI đầu-cuối cho các công ty bảo hiểm. Zoumana gia nhập Axionable, startup Trí tuệ nhân tạo Bền vững đầu tiên có trụ sở tại Paris và Montreal. Tại đây, anh làm Nhà khoa học dữ liệu và triển khai các sản phẩm AI, chủ yếu là các bài toán NLP, cho khách hàng tại Pháp, Montreal, Singapore và Thụy Sĩ. Ngoài ra, 5% thời gian của anh được dành cho Nghiên cứu và Phát triển. Hiện tại, anh làm việc với vai trò Nhà khoa học dữ liệu cao cấp tại IFC - Nhóm Ngân hàng Thế giới.
Khám phá toàn bộ tiềm năng của LLM với khóa học khái niệm của chúng tôi, bao gồm các ứng dụng LLM, phương pháp đào tạo, cân nhắc đạo đức và nghiên cứu mới nhất.


 Matt Crabtree · 10 min
Snowflake Arctic là một bước tiến đổi mới trong lĩnh vực nhúng văn bản, cung cấp bộ công cụ mạnh mẽ giúp đơn giản hóa quy trình áp dụng AI trên dữ liệu doanh nghiệp.
Trong hướng dẫn này, chúng tôi sẽ giới thiệu tổng quan về Snowflake Arctic, đi qua quy trình thiết lập, khám phá các kỹ thuật tích hợp, và chia sẻ thực hành tốt nhất cùng mẹo xử lý sự cố. Chúng tôi cũng sẽ trình bày các trường hợp sử dụng trong thực tế, thảo luận về các phát triển trong tương lai, và cung cấp tài nguyên để hỗ trợ và học tập liên tục.
Nếu bạn muốn tìm hiểu thêm về Snowflake, hãy xem khóa học Giới thiệu về Snowflake này.
Snowflake Arctic là gì?
Vậy, chính xác Snowflake Arctic là gì? Đây là một bộ công cụ toàn diện được thiết kế để đơn giản hóa việc tích hợp và triển khai AI trong Snowflake Data Cloud. Cốt lõi của Snowflake Arctic là tập hợp các mô hình nhúng giúp chúng ta trích xuất thông tin giá trị từ dữ liệu một cách hiệu quả.
Ngoài ra, bộ này còn bao gồm một Mô hình Ngôn ngữ Lớn (LLM) đa dụng có khả năng xử lý nhiều tác vụ, từ tạo truy vấn SQL và mã lập trình đến tuân theo các chỉ dẫn phức tạp.
Một trong những điểm nổi bật của Arctic là tích hợp liền mạch với Snowflake Data Cloud. Sự gắn kết chặt chẽ này cho phép chúng ta tận dụng sức mạnh AI trực tiếp trong hạ tầng dữ liệu hiện có, đảm bảo trải nghiệm an toàn và tinh gọn.
Đáng chú ý, tất cả các mô hình trong họ Snowflake Arctic đều được phát hành theo giấy phép Apache 2.0, cho phép sử dụng cho cả mục đích học thuật và thương mại.
Kiến trúc và hiệu năng
Snowflake Arctic có ba thành phần chính:
Các thành phần của Snowflake Arctic.
Kiến trúc của Snowflake Arctic được xây dựng trên thiết kế transformer lai Dense Mixture of Experts (MoE), một đổi mới then chốt cho phép mở rộng hiệu quả và thích ứng linh hoạt. Cách tiếp cận này tận dụng mạng lưới khổng lồ 480 tỷ tham số phân bổ trên 128 chuyên gia chuyên biệt, mỗi chuyên gia được tinh chỉnh cho các tác vụ cụ thể.
Tuy nhiên, không phải chuyên gia nào cũng được kích hoạt cho mọi truy vấn. Arctic sử dụng cơ chế cổng top-2, chỉ chọn hai chuyên gia phù hợp nhất cho mỗi đầu vào, nhờ đó chỉ kích hoạt khoảng 17 tỷ tham số. Tối ưu hóa này giúp giảm đáng kể chi phí tính toán trong khi vẫn duy trì hiệu năng hàng đầu trên nhiều tác vụ tập trung cho doanh nghiệp.
Tính năng chính
Snowflake Arctic nổi bật nhờ bốn tính năng chính sau:
Bốn tính năng chính của Snowflake Arctic.
Trước hết, nó cực kỳ thông minh. Arctic vượt trội ở các tác vụ phức tạp như tạo truy vấn SQL, viết mã, và làm theo hướng dẫn chi tiết. Trong các bài kiểm định chuẩn ngành, nó liên tục vượt qua các mô hình tương tự, cho thấy khả năng xử lý những kịch bản thực tế phức tạp.
Thứ hai, Arctic được thiết kế cho hiệu quả. Kiến trúc độc đáo cho phép cung cấp hiệu năng hàng đầu trong khi tiêu thụ ít tài nguyên tính toán hơn. Điều này chuyển hóa thành tiết kiệm chi phí đáng kể, khiến nó trở thành lựa chọn hấp dẫn cho mọi quy mô tổ chức.
Thứ ba, Snowflake Arctic theo đuổi mã nguồn mở. Nó được phát hành theo giấy phép Apache 2.0, trao quyền truy cập vào mã nguồn và trọng số mô hình cho tất cả mọi người.
Cuối cùng, Arctic tập trung mạnh vào AI cho doanh nghiệp. Nó được xây dựng có chủ đích để đáp ứng nhu cầu cụ thể của doanh nghiệp, mang lại kết quả chất lượng cao cho các tác vụ như phân tích dữ liệu, tự động hóa quy trình, và hỗ trợ ra quyết định.
Các mô hình Snowflake Arctic
Để đáp ứng nhu cầu AI đa dạng trong doanh nghiệp, Snowflake đã giới thiệu hai mô hình chính trong họ Snowflake Arctic:
Các mô hình nhúng văn bản Snowflake Arctic
Bên cạnh các mô hình chính, Snowflake cung cấp một họ gồm năm mô hình nhúng văn bản theo giấy phép Apache 2.0—tất cả đều tập trung vào các tác vụ truy xuất thông tin. Bảng dưới minh họa hiệu năng của các mô hình Snowflake Arctic trên bài toán truy xuất của Massive Text Embedding Benchmark (MTEB), đo bằng NDCG@10.
Điểm truy xuất MTEB của các mô hình Snowflake khác nhau. Nguồn: Hugging Face.
Trước hết, có thể thấy xu hướng chung là hiệu năng được cải thiện khi kích thước mô hình tăng. Mô hình lớn nhất, "snowflake-arctic-embed-l," đạt điểm NDCG@10 cao nhất là 55,98, sử dụng 335 triệu tham số và 1024 chiều nhúng. Điều này gợi ý rằng quy mô mô hình đóng vai trò quan trọng trong việc nắm bắt các quan hệ ngữ nghĩa tinh vi trong dữ liệu văn bản.
Điều đáng chú ý là việc tăng số chiều nhúng từ 384 lên 1024 giúp cải thiện điểm số cho mô hình "snowflake-arctic-embed-l," nhấn mạnh tác động của kích thước nhúng tới độ chính xác truy xuất. Tuy nhiên, có một ngoại lệ đáng lưu ý là mô hình "snowflake-arctic-embed-xs". Dù có số tham số ít hơn đáng kể (22 triệu), nó cho hiệu năng tương đương các mô hình lớn hơn có cùng số chiều nhúng 384. Điều này cho thấy hiệu quả mô hình và tối ưu kiến trúc có thể bù đắp lợi ích của số lượng tham số đơn thuần trong một số tình huống.
Snowflake Arctic: Bản demo
Trước khi bắt tay vào phần triển khai kỹ thuật, hãy xem mô hình hoạt động với các tác vụ khác nhau như tạo SQL, viết mã, và làm theo hướng dẫn.
Từ bản demo Streamlit trên Hugging Face, chúng ta có thể gửi một số yêu cầu cho mô hình, điều chỉnh tham số và nhận phản hồi.
Bản demo Snowflake Arctic.
Trước tiên, hãy yêu cầu mô hình tạo một truy vấn SQL:
Ví dụ tạo SQL với Snowflake Arctic.
Để so sánh, hãy gửi cùng yêu cầu đó cho ChatGPT-4o: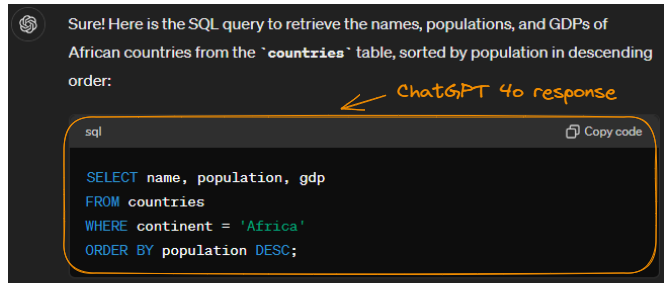
Ví dụ tạo SQL với ChatGPT-4o.
Lưu ý rằng kết quả tạo ra là như nhau (với định dạng gọn gàng hơn). Có thể kết luận Arctic đã làm tốt.
Hãy yêu cầu Arctic viết một đoạn mã Python:
Snowflake Arctic tạo mã Python.
Khi cung cấp cùng một prompt cho ChatGPT-4o, chúng ta nhận được kết quả sau, cũng chính xác:
Mã Python do ChatGPT-4o tạo.
Mặc dù cả Arctic và ChatGPT-4o đều hoàn thành cùng tác vụ, cách tiếp cận của chúng khác nhau về hiệu quả và mức sử dụng bộ nhớ. Cả hai mô hình đều đọc tệp hiệu quả bằng
os.listdir()vàopen().Tuy nhiên, cách tiếp cận của ChatGPT-4o là tạo DataFrame từ danh sách các dictionary có thể tiêu tốn nhiều bộ nhớ hơn một chút so với phương pháp dùng danh sách các danh sách của Arctic. Nguyên nhân là Pandas có thể thực hiện xử lý bổ sung để làm việc với dictionary. Dù khác biệt nhỏ này tồn tại, cấu trúc mã theo mô-đun của ChatGPT-4o giúp tăng khả năng đọc và bảo trì.
Nếu bạn muốn tìm hiểu thêm về cách chọn LLM phù hợp, hãy xem hướng dẫn Phân loại LLM: Cách chọn LLM tốt nhất.
Thiết lập Snowflake Arctic
Giờ khi đã biết khả năng của mô hình Snowflake Arctic, hãy tập trung vào truy cập và cấu hình Snowflake Arctic.
Đặc tính môi trường
Sử dụng các mô hình Arctic tiêu tốn tài nguyên, vì vậy chúng ta sẽ dùng mô hình nhỏ nhất trong họ Arctic, snowflake-arctic-embed-xs, vốn dùng ít tài nguyên tính toán nhất.
Bên dưới là các đặc tính của môi trường dùng cho hướng dẫn này—chúng ta hiển thị đặc tính bằng cách chạy lệnh
nvidia-smi:Đặc tính GPU cho hướng dẫn Snowflake Arctic.
Ngoài GPU NVIDIA L4, môi trường còn có các đặc tính sau, có thể tìm trong phần Resources:
Đặc tính backend của compute engine.
Cài đặt thư viện
Hai thư viện chính cần thiết cho phần thực hành này là
torchvàtransformers(chúng ta chạy mã dưới đây từ notebook):Sau đó, chúng ta import các thư viện con cần thiết:
Tải mô hình và tokenizer
Tiếp tục, hãy tải mô hình nhúng snowflake-arctic-embed-xs và tokenizer tương ứng:
Chúng ta tải mô hình tiền huấn luyện được chỉ định bởi
model_checkpointmà không thêm lớp pooling bổ sung, vốn dùng để giảm chiều đầu ra của mô hình.Tìm kiếm tương đồng tài liệu với Snowflake Arctic
Sau khi thiết lập xong các yêu cầu, trường hợp sử dụng cốt lõi của phần này là tìm N tài liệu giống nhất với một tài liệu cho trước, kèm theo điểm tương đồng cosine của chúng. Để làm điều này, chúng ta thực hiện năm bước chính:
Tìm kiếm tương đồng tài liệu bằng Snowflake Arctic.
Chúng ta có thể triển khai các bước trên bằng những hàm trợ giúp sau:
generate_embedding()vàfind_similar_documents().Hàm
generate_embedding()nhận một tài liệu làm đầu vào và tạo vector nhúng của nó. Hàmfind_similar_documents()nhận tài liệu truy vấn, nhúng của các tài liệu hiện có, và số lượng tài liệu tương tự muốn trả về.Để đơn giản, chúng ta dùng năm ví dụ ngắn:
Tiếp theo, chúng ta tạo nhúng:
Hãy chọn “What is the Arctic-embed model?” làm tài liệu truy vấn và tìm các tài liệu tương tự:
Cuối cùng, chúng ta lặp qua tất cả tài liệu top để in nội dung và điểm tương đồng với tài liệu truy vấn.
Tài liệu thứ hai là tương tự nhất vì có điểm tương đồng cosine cao nhất (94,99%).
Năm tài liệu gốc.
Trực quan hóa tài liệu 3D
Khi trực quan hóa các tài liệu trong không gian 3D, chúng ta có thể thấy các tài liệu gần nhau.
Các vector nhúng gốc có 512 chiều, điều này không thể trực quan hóa trực tiếp. Cách dễ nhất là giảm chiều bằng Phân tích Thành phần Chính (PCA). Nếu bạn muốn tìm hiểu thêm về PCA, hãy xem hướng dẫn Phân tích Thành phần Chính (PCA) trong Python.
Trước khi dùng PCA, chúng ta cần sửa hàm
find_similar_documents()để hàm trả về cả nhúng tài liệu mà PCA sẽ sử dụng.Chúng ta cũng import một vài mô-đun cần thiết để tạo trực quan.
Giờ hãy tạo trực quan 3D bằng cách:
Dùng PCA để trực quan hóa độ tương đồng tài liệu.
Tài liệu thứ hai (màu cam) gần nhất với tài liệu truy vấn (ngôi sao đỏ). Tài liệu thứ năm (màu tím) là gần thứ hai, trong khi tài liệu thứ ba (màu xanh lá) là xa nhất.
Tích hợp Snowflake Arctic với Streamlit
Notebook là công cụ mạnh để thử nghiệm và trực quan hóa nhanh, nên rất phổ biến với nhà khoa học dữ liệu và nhà nghiên cứu. Tuy nhiên, notebook có thể không phù hợp nhất khi triển khai mô hình hoặc ứng dụng trong môi trường sản xuất. Đây là lúc Streamlit phát huy tác dụng.
Streamlit là một thư viện Python giúp phát triển ứng dụng web tương tác cho các dự án khoa học dữ liệu và máy học. Nó giúp chuyển dự án khoa học dữ liệu thành ứng dụng sẵn sàng cho sản xuất mà không cần kiến thức phát triển web sâu rộng.
Bên dưới là trang đích của ứng dụng chúng ta sẽ xây dựng trong phần này.
Trang đích của ứng dụng Streamlit.
Việc giảng dạy Streamlit nằm ngoài phạm vi của hướng dẫn này, nhưng bạn có thể học từ đầu qua Hướng dẫn Python: Streamlit.
Kỹ thuật tích hợp cơ bản
Trong phần này, chúng ta sẽ khám phá cách dùng Streamlit để tạo ứng dụng web cho dự án tìm kiếm tương đồng tài liệu. Để chạy một ứng dụng Streamlit, mã cần nằm trong tệp Python (đuôi .py) và thực thi lệnh sau trong terminal:
Tuy nhiên, bước đầu tiên để dùng Streamlit là cài đặt nó bằng lệnh
pip:Mã chúng ta dùng để xây dựng ứng dụng Streamlit khá dài nên hãy dành thời gian xem kỹ. Chúng tôi cũng sẽ giải thích sau khối mã.
Dùng đoạn mã trên, chúng ta đã tạo một ứng dụng Streamlit tên "Document Similarity Search With Snowflake Arctic." Hãy đưa ra vài nhận xét về mã:
st.text_input()và chỉ định số lượng tài liệu top cần truy xuất (K) bằngst.number_input().st.button("Search")), hàmfind_similar_documents()được gọi với tài liệu truy vấn, danh sách tài liệu, và giá trịtop_kđã chỉ định.st.subheader()vàst.write().st.pyplot(fig).Phần Streamlit trong mã tập trung vào việc tạo giao diện người dùng tương tác, nơi người dùng có thể nhập tài liệu truy vấn, chỉ định số lượng tài liệu tương tự cần lấy, và xem kết quả cùng trực quan 3D của các vector nhúng tài liệu.
Toàn bộ mã của bài viết có trong Jupyter Notebook này.
Chúng ta có thể khởi chạy ứng dụng bằng lệnh
streamlit run app.py, lệnh này sẽ dẫn đến trang đích. Khi cung cấp cùng tài liệu truy vấn và đặt Top K là 3, chúng ta nhận kết quả sau:Tích hợp Snowflake Arctic bằng Streamlit.
Mẹo cấu hình nâng cao
Khi làm việc với các mô hình ngôn ngữ lớn như Arctic, điều quan trọng là kiểm thử và xác thực kỹ cấu hình trong môi trường mục tiêu. Điều này đảm bảo hiệu năng tối ưu và tính tin cậy. Dưới đây là vài mẹo cấu hình cần ghi nhớ:
Thực hành tốt nhất và xử lý sự cố
Để đảm bảo hiệu năng tối ưu và vận hành trơn tru của Snowflake Arctic, điều quan trọng là tuân theo thực hành tốt nhất và sẵn sàng xử lý mọi vấn đề có thể xảy ra. Trong phần này, chúng ta sẽ khám phá các mẹo và thủ thuật nâng cao hiệu năng dựa trên điểm chuẩn thực tế và nghiên cứu học thuật.
Nguồn: Arctic Cloud.
Dưới đây là một số mẹo và thủ thuật để tăng cường khả năng của nó:
Hiệu năng suy luận
Hiệu năng của Snowflake Arctic nổi bật cả trong kịch bản suy luận và huấn luyện. Trong suy luận, nó liên tục mang lại tỷ lệ hiệu năng/chi phí vượt trội so với các mô hình khác. Sự hiệu quả này tăng lên khi nhiều tham số được kích hoạt, và vẫn duy trì lợi thế đáng kể ngay cả khoảng 60 tỷ tham số hoạt động, vượt trội so với các đối thủ như Mixral và Llama 3.
Hiệu quả suy luận của Arctic. Nguồn: Snowflake.com.
Hiệu năng huấn luyện
Xu hướng này tiếp tục ở giai đoạn huấn luyện, nơi Arctic một lần nữa có tỷ lệ hiệu năng/chi phí tốt nhất. Hiệu quả này mở rộng theo tài nguyên tính toán, đạt khoảng 70% ở mức compute 16X, vượt xa các mô hình như DBRX, Llama 3, Code Llama, và Yi. Những kết quả này nhấn mạnh đề xuất giá trị của Arctic: hiệu năng chất lượng cao với chi phí tính toán chỉ bằng một phần, trở thành lựa chọn hấp dẫn cho các doanh nghiệp coi trọng tài nguyên.
Hiệu quả huấn luyện của Arctic. Nguồn: Snowflake.com.
Một số mẹo và thủ thuật để tối ưu hiệu năng cho suy luận và huấn luyện bao gồm nhưng không giới hạn ở:
Tương lai của Snowflake Arctic
Hiệu năng ấn tượng và hiệu quả chi phí của Snowflake Arctic đã đặt ra tiêu chuẩn mới cho các mô hình ngôn ngữ. Phát triển trong tương lai có thể bao gồm khả năng hiểu ngôn ngữ tự nhiên nâng cao, cải thiện học đa nhiệm, và hỗ trợ tốt hơn cho ứng dụng theo miền. Khi Snowflake tiếp tục đổi mới, người dùng có thể kỳ vọng các công cụ ngày càng mạnh mẽ và đa dụng hơn.
Snowflake cung cấp cộng đồng tuyệt vời và tài nguyên hỗ trợ toàn diện. Người dùng có thể kết nối, chia sẻ kiến thức, và học hỏi lẫn nhau trên diễn đàn cộng đồng Snowflake. Tài liệu chi tiết và hướng dẫn có sẵn trên trang web chính thức để giúp người dùng điều hướng và tận dụng tối đa các tính năng của Snowflake Arctic.
Kết luận
Snowflake Arctic là một bước ngoặt trong lĩnh vực nhúng văn bản, cung cấp giải pháp mạnh mẽ và hiệu quả cho các doanh nghiệp muốn khai mở toàn bộ tiềm năng dữ liệu. Sự tích hợp liền mạch với Snowflake Data Cloud và kiến trúc có khả năng mở rộng khiến nó trở thành lựa chọn lý tưởng cho các tổ chức muốn tinh gọn quy trình truy xuất và phân tích dữ liệu.
Xuyên suốt hướng dẫn, chúng ta đã khám phá các năng lực cốt lõi của Snowflake Arctic, bao gồm từ thiết lập và cấu hình đến kỹ thuật tích hợp nâng cao và ứng dụng thực tiễn. Bằng cách tận dụng các tính năng nâng cao và tối ưu hiệu năng của nó, doanh nghiệp có thể đạt hiệu quả và độ chính xác cao hơn trong các hoạt động nhúng văn bản.
Nếu bạn muốn tìm hiểu thêm về Snowflake, hãy xem Hướng dẫn Snowflake cho người mới bắt đầu này.