Kurs
Machine Learning'i Anlamak
2 sa
311.4K
Makine öğreniminde mutlaka Aşırı Öğrenme (Overfitting) terimiyle karşılaşmışsınızdır. Aşırı öğrenme, bir makine öğrenimi modelinin eğitim verisini fazlasıyla iyi modellediği, ancak test verisi üzerinde iyi performans gösteremediği bir olgudur. Test verisi üzerinde yeterince iyi performans göstermek, makine öğreniminde bir tür nihai ölçüt olarak kabul edilir.
Aşırı öğrenmeyi önlemeye yardımcı olan epey teknik vardır. Düzenlileştirme (Regularization) bunlardan biridir. Bu yazı tamamen buna ayrılmıştır. Bu yazıda, düzenlileştirmeyi daha az matematikle, daha çok sezgiyle açıklamaya çalışacağım. Diğer eğitim yazılarımdan farklı olarak herhangi bir vaka çalışmasını kapsamayacak. Herhangi bir vaka çalışmasına dalmadan önce, düzenlileştirmenin önemini ve küçük inceliklerini anlamanızı isterim. Çünkü düzenlileştirme biraz çetrefillidir ama bir Veri Bilimci olarak bilinmesi çok önemli bir tekniktir.
Bu yazının akışı şu şekildedir:
Aşırı öğrenmeyi açıklamadan önce, makine öğreniminde genellemeden biraz bahsedelim.
Genelleme, bir makine öğrenimi modelinin öğrendiği kavramların, modelin öğrenme sırasında görmediği belirli örneklere (kısaca test kümesine) ne kadar iyi uygulanabildiğini ifade eder.
İyi bir makine öğrenimi modelinin hedefi, eğitim verisinden problem alanındaki herhangi bir veriye iyi genelleme yapmaktır. Bu, modelin gelecekte daha önce hiç görmediği veriler üzerinde tahmin yapabilmesini sağlar.
Giriş bölümünden alıntı yapacağım: “Aşırı öğrenme, bir makine öğrenimi modelinin eğitim verisini fazlasıyla iyi modellediği, ancak test verisi üzerinde iyi performans gösteremediği bir olgudur."
Aşırı öğrenme, bir model eğitim verisindeki ayrıntıları ve gürültüyü o denli öğrenir ki, modelin görülmemiş verilerdeki performansını olumsuz etkiler. Bu, eğitim verisindeki gürültü veya rastgele dalgalanmaların model tarafından kavramlar olarak yakalanıp öğrenildiği anlamına gelir. Sorun şu ki, bu kavramlar yeni verilere uygulanamaz ve modelin genelleme yeteneğini olumsuz etkiler.
Aşırı öğrenme, hedef fonksiyonu öğrenilirken daha fazla esnekliğe sahip parametrik olmayan ve doğrusal olmayan modellerde daha olasıdır. Bu nedenle, birçok parametrik olmayan makine öğrenimi algoritması, modelin ne kadar ayrıntı öğrendiğini sınırlamak ve kısıtlamak için parametreler veya teknikler içerir.
Örneğin, karar ağaçları çok esnek, parametrik olmayan bir makine öğrenimi algoritmasıdır ve eğitim verisini aşırı öğrenmeye açıktır. Bu sorun, öğrenme sonrasında ağacı budayarak, yakaladığı bazı ayrıntıları kaldırmak suretiyle ele alınabilir. Öte yandan, Eksik Öğrenme (Underfitting), ne eğitim verisini modelleyebilen ne de yeni veriye genelleyebilen bir modeli ifade eder.
Makine Öğrenimi bağlamı olmadan “Düzenlileştirme” sözcüğünü duyduğunuzda, bir şeyi düzene koyma ya da düzenli hâle getirme sürecini anlarsınız. Peki sorun şu: O “şey” tam olarak nedir? Makine Öğrenimi söz konusu olduğunda, öğrenme algoritmalarından veya modellerden bahsedersiniz; peki algoritmaların veya modellerin içinde ne vardır? Parametre kümesi. Kısacası, makine öğreniminde düzenlileştirme; katsayı tahminlerini sıfıra doğru kısıtlayan, düzenleyen veya küçülten parametrelerin düzenlenmesi sürecidir. Başka bir deyişle, bu teknik daha karmaşık veya fazla esnek bir model öğrenmeyi caydırır ve Aşırı Öğrenme riskini önlemeye yardımcı olur.
Şimdi, düzenlileştirmenin Aşırı Öğrenmeyi önlemede nasıl yardımcı olduğunu anlamaya yavaş yavaş yaklaşıyorsunuz. Hemen konuya girelim.
Düzenlileştirmenin aslında parametrelerimizi düzenlemek olduğunu öğrendikten sonra şu soruyu sorabilirsiniz: Parametreleri düzenlemek Aşırı Öğrenmeyi neden önlemeye yardımcı olur? Aşağıdaki grafiği ele alalım:
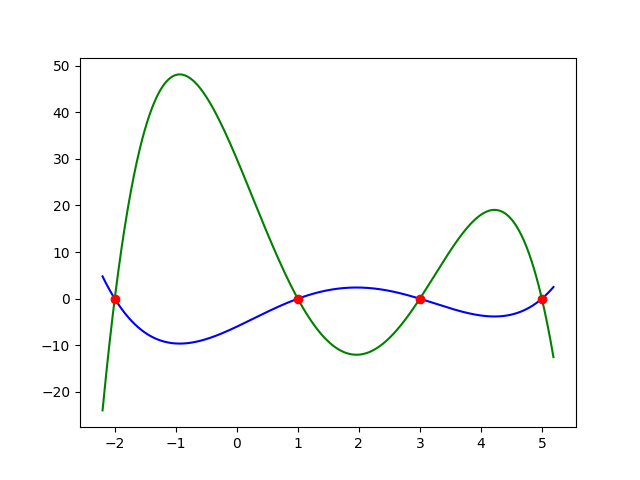
Grafikte görüldüğü gibi, biri yeşil diğeri mavi eğriyle gösterilen iki fonksiyon vardır. Her iki eğri de kırmızı noktaları o kadar iyi uyar ki, ikisinin de sıfır kayıp ürettiğini varsayabilirsiniz. Aşırı Öğrenme sezgisinden, yeşil eğrinin aşırı öğrenen olduğunu tahmin etmiş olabilirsiniz. Evet, tamamen haklısınız! Peki hiç düşündünüz mü, neden yeşil eğri (veya ona benzer herhangi bir eğri) veriyi aşırı öğreniyor?
Bunu biraz daha matematiksel bir şekilde anlamak için, yukarıdaki grafiği çizmekte kullanılan iki fonksiyonu varsayalım:
Yeşil eğri:
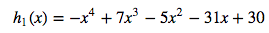
Kırmızı eğri:
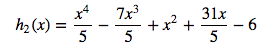
Her bir fonksiyonun denklemine bakarsanız, yeşil eğrinin daha büyük katsayılara sahip olduğunu ve bunun Aşırı Öğrenmenin başlıca nedeni olduğunu görürsünüz. Daha önce belirtildiği gibi, Aşırı Öğrenme; modelinizin veri setini o kadar iyi uyarlaması ki, gösterdiğimiz veriyi gerçekten öğrenmek yerine adeta ezberlemesi olarak yorumlanabilir. Sezgisel olarak, büyük katsayılara sahip olmak veriyi ezberlemeye bir kanıt olarak görülebilir. Örneğin, eğitim veri setinizde bazı gürültüler varsa ve verinin büyüklüğü diğerlerinden çok farklıysa, bu gürültüler modelimizin daha yüksek derece katsayılarına daha fazla ağırlık vermesine neden olur ve sonuçta eğitim verimizi aşırı öğrenen bir model elde ederiz!
Veri Bilimi problemlerinde, özellik sayısı arttıkça bir makine öğrenimi modeli verinizi iyi uyarlayabilir. Ancak her şeyin bir bedeli vardır. Çok fazla özellik eklerseniz, Aşırı Öğrenme ile cezalandırılırsınız. Bazılarınız, bu kadar çok özellik eklemek Aşırı Öğrenmeye yol açıyorsa, o hâlde kabul edilebilir bir model elde ettiğimizde özellik eklemeyi neden durdurmuyoruz diye düşünebilir. Ama şöyle düşünün: Müşteriniz veya yöneticiniz %95 doğruluğa sahip bir model istiyor, ancak bunu birkaç özellik daha eklemeden başaramıyorsunuz ve bu da verinin aşırı öğrenilmesiyle sonuçlanıyor. Bir sonraki adımda ne yapacaksınız?
Ya da başka bir açıdan bakın: Elinizde her birinde birçok özellik bulunan büyük bir veri seti var. Hangi özellikleri atacağınızı bilmiyorsunuz ve dahası, her özelliğin oldukça bilgi verici olduğu ortaya çıkabilir; bu da bazı özellikleri çıkarmanın algoritmanın performansını muhtemelen bozacağı anlamına gelir. Sırada ne yapmayı planlıyorsunuz?
Yanıt: düzenlileştirme.
Dolayısıyla, Aşırı Öğrenmeyi önlemek için bazı özellikleri atmak her zaman iyi bir fikir değildir. Ve yukarıdaki örnekte gördüğünüz gibi, bazı daha az bilgi verici özellikleri kaldırıp kaldıramayacağınızı bilmek için ek analiz gerekir. Bu nedenle, başlangıçta ilk modelinizi kurarken tüm özellikleri kullanmanız iyi bir uygulamadır. Ve Düzenlileştirme çözüm olarak ortaya çıkar. Bunu daha şeffaf kılmak için önce MSE maliyet fonksiyonuna (MSE: Ortalama Kare Hata) bir göz atalım:
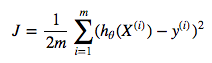
burada,
Lojistik Regresyon gibi modellerde, öğrenmenin amacı bu MSE fonksiyonunu en aza indirmektir. Bu, MSE değerini düşürmek uğruna parametrelerinizin her şekilde güncellenebileceği anlamına gelir. Ve yukarıda belirtildiği gibi, parametreleriniz büyüdükçe modelinizin veriyi aşırı öğrenme olasılığı artar. O hâlde soru şu: Yalnızca maliyet fonksiyonunu en aza indirmekle kalmayıp parametrelerin çok büyümesini de engelleyemez misiniz? Yanıt: ENGELLEYEBİLİRSİNİZ; aşağıdaki gibi bir düzenlileştirme terimi ekleyerek:
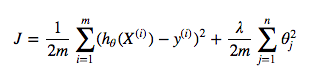
burada,
Düzenlileştirme terimini ekledikten sonra yeni maliyet fonksiyonunuza bakın. Düzenlileştirme terimi, büyük parametreleri cezalandırır. Açıkça görüldüğü gibi, maliyet fonksiyonunu en aza indirmek, sağ taraftaki iki terimi de düşürmeyi içerir: MSE terimi ve düzenlileştirme terimi. Dolayısıyla, herhangi bir parametre önemli ölçüde büyüyecek şekilde güncellendiğinde, düzenlileştirme terimi nedeniyle maliyet fonksiyonunun değeri artacak ve bunun sonucu olarak parametre cezalandırılarak daha küçük bir değere güncellenecektir.
Bu yazıyı burada noktalayacağım. Yazının çok uzun olmadığını, ancak sizin için tekrar gözden geçirip pekiştirmenize yetecek kadar içerik barındırdığını düşünüyorum. Bu yazıyla oluşturduğunuz sezgi konusunda kendinizi güvende hissettiğinizde, sıradaki adımlar şunlar olacaktır:
Makine Öğrenimi hakkında daha fazla bilgi edinmek isterseniz, şu DataCamp kurslarına göz atın:
Makine Öğrenimi kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



