कोर्स
Understanding Machine Learning
2 घंटा
311.6K
मशीन लर्निंग में, आपने ओवरफिटिंग शब्द ज़रूर सुना होगा। ओवरफिटिंग वह स्थिति है जहाँ कोई मशीन लर्निंग मॉडल प्रशिक्षण डेटा पर बहुत अच्छा फिट हो जाता है, लेकिन परीक्षण डेटा पर अच्छा प्रदर्शन नहीं कर पाता। मशीन लर्निंग में परीक्षण डेटा पर पर्याप्त अच्छा प्रदर्शन करना एक तरह से अंतिम कसौटी माना जाता है।
ओवरफिटिंग को रोकने में मदद करने वाली कई तकनीकें हैं। रेग्युलराइजेशन ऐसी ही एक तकनीक है। और यह पोस्ट पूरी तरह उसी के लिए समर्पित है। इस पोस्ट में, मैं कम गणित और अधिक सहज समझ के साथ रेग्युलराइजेशन समझाने की कोशिश करूँगा। मेरी अन्य ट्यूटोरियल्स के विपरीत, यह किसी केस स्टडी को कवर नहीं करेगी। किसी केस स्टडी में जाने से पहले, मैं चाहता हूँ कि आप रेग्युलराइजेशन के महत्व और उसकी बारीकियों को समझें। क्योंकि रेग्युलराइजेशन पेचीदा है, पर एक डेटा साइंटिस्ट के रूप में जानने के लिए बहुत महत्वपूर्ण तकनीक है।
यह पोस्ट निम्नानुसार व्यवस्थित है:
ओवरफिटिंग समझाने से पहले, मशीन लर्निंग में जनरलाइज़ेशन पर थोड़ी बात करते हैं।
जनरलाइज़ेशन का मतलब है कि सीखते समय मॉडल ने जिन अवधारणाओं को सीखा, वे उन विशेष उदाहरणों पर कितनी अच्छी तरह लागू होती हैं जिन्हें मॉडल ने पहले नहीं देखा है (संक्षेप में, टेस्ट सेट)।
एक अच्छे मशीन लर्निंग मॉडल का लक्ष्य प्रशिक्षण डेटा से समस्या-क्षेत्र के किसी भी डेटा पर अच्छी तरह जनरलाइज़ करना होता है। यह आपको भविष्य में ऐसे डेटा पर भविष्यवाणी करने देता है जिसे मॉडल ने पहले कभी नहीं देखा।
मैं परिचय खंड से उद्धृत करूँगा: “ओवरफिटिंग वह स्थिति है जहाँ कोई मशीन लर्निंग मॉडल प्रशिक्षण डेटा पर बहुत अच्छा फिट हो जाता है, लेकिन परीक्षण डेटा पर अच्छा प्रदर्शन नहीं कर पाता।”
ओवरफिटिंग तब होता है जब कोई मॉडल प्रशिक्षण डेटा के विवरण और शोर को इस हद तक सीख लेता है कि यह अनदेखे डेटा पर मॉडल के प्रदर्शन को नकारात्मक रूप से प्रभावित करता है। इसका मतलब है कि प्रशिक्षण डेटा में मौजूद शोर या यादृच्छिक उतार-चढ़ाव को मॉडल अवधारणा की तरह पकड़ लेता है और सीख लेता है। समस्या यह है कि ये अवधारणाएँ नए डेटा पर लागू नहीं होतीं और मॉडल की जनरलाइज़ करने की क्षमता को नुकसान पहुँचाती हैं।
ओवरफिटिंग की संभावना गैर-पैरामीट्रिक और नॉनलाइनियर मॉडलों में अधिक होती है, जिनमें लक्ष्य फ़ंक्शन सीखते समय अधिक लचीलापन होता है। इसी कारण, कई गैर-पैरामीट्रिक मशीन लर्निंग एल्गोरिदम में ऐसे पैरामीटर या तकनीकें भी होती हैं जो यह सीमित करती हैं कि मॉडल कितनी बारीकी तक सीख सकता है।
उदाहरण के लिए, डिसीजन ट्री एक गैर-पैरामीट्रिक मशीन लर्निंग एल्गोरिदम है जो बहुत लचीला है और प्रशिक्षण डेटा पर ओवरफिटिंग के लिए संवेदनशील होता है। इस समस्या का समाधान ट्री को सीखने के बाद प्रूनिंग करके किया जा सकता है ताकि उसने जो अतिरिक्त विवरण पकड़ लिया है, उसे हटाया जा सके। दूसरी ओर, अंडरफिटिंग उस मॉडल को संदर्भित करता है जो न तो प्रशिक्षण डेटा को मॉडल कर पाता है और न ही नए डेटा पर जनरलाइज़ कर पाता है।
जब आप मशीन लर्निंग से अलग सिर्फ रेग्युलराइजेशन शब्द सुनते हैं, तो आप समझते हैं कि रेग्युलराइजेशन किसी चीज़ को नियमित या नियंत्रित करने की प्रक्रिया है। सवाल है: वह “चीज़” क्या है। मशीन लर्निंग के संदर्भ में, हम लर्निंग एल्गोरिदम या मॉडलों की बात करते हैं—और एल्गोरिदम या मॉडलों के भीतर क्या होता है? वह है पैरामीटर्स का सेट। संक्षेप में, मशीन लर्निंग में रेग्युलराइजेशन पैरामीटर्स को नियमित करने की प्रक्रिया है, जो गुणांक (coefficient) के आकलनों को शून्य की ओर सीमित, नियंत्रित या छोटा करती है। दूसरे शब्दों में, यह तकनीक अधिक जटिल या अत्यधिक लचीला मॉडल सीखने से हतोत्साहित करती है, जिससे ओवरफिटिंग के जोखिम से बचाव होता है।
अब, आप धीरे-धीरे समझ रहे हैं कि रेग्युलराइजेशन वास्तव में ओवरफिटिंग को रोकने में कैसे मदद करता है? आइए सीधे उसी पर आते हैं।
जब आपको पता चल गया कि रेग्युलराइजेशन दरअसल हमारे पैरामीटर्स को नियमित करना है, तब आप सोच सकते हैं: पैरामीटर्स को नियमित करना ओवरफिटिंग को रोकने में कैसे मदद करता है? आइए नीचे दिए गए ग्राफ़ पर विचार करते हैं:
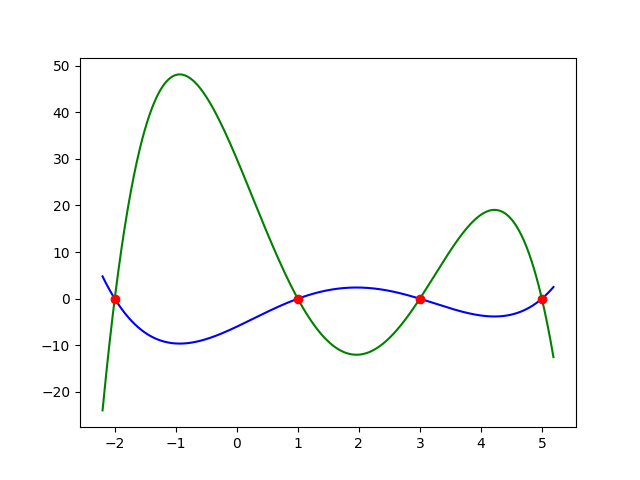
जैसा कि आप ग्राफ़ में देख सकते हैं, इसमें दो फ़ंक्शन हैं जो क्रमशः हरे और नीले कर्व से दर्शाए गए हैं। दोनों कर्व उन लाल बिंदुओं को इतनी अच्छी तरह फिट करते हैं कि आप मान सकते हैं कि दोनों का लॉस शून्य है। ओवरफिटिंग की सहज समझ से, आप शायद अनुमान लगा चुके होंगे कि हरा कर्व ओवरफिट कर रहा है। जी हाँ, आप बिल्कुल सही हैं! लेकिन क्या आपने कभी सोचा है कि हरा कर्व (या उसके समान कोई भी कर्व) डेटा को ओवरफिट क्यों करता है?
इसे थोड़ा अधिक गणितीय ढंग से समझने के लिए, मान लेते हैं कि ऊपर ग्राफ़ बनाने में जिन दो फ़ंक्शनों का उपयोग हुआ है, वे हैं:
हरा कर्व:
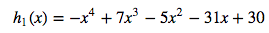
लाल कर्व:
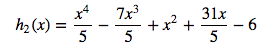
यदि आप प्रत्येक फ़ंक्शन के समीकरण को देखें, तो पाएँगे कि हरे कर्व में बड़े गुणांक हैं, और यही ओवरफिटिंग का प्राथमिक कारण है। जैसा कि पहले बताया गया, ओवरफिटिंग का अर्थ यह भी लगाया जा सकता है कि आपका मॉडल डेटासेट को इतना अच्छा फिट कर रहा है कि वह वास्तव में सीखने के बजाय हमने जो डेटा दिखाया है, उसे याद कर रहा है। सहज रूप से, बड़े गुणांक होना डेटा को याद करने का संकेत माना जा सकता है। उदाहरण के लिए, आपके प्रशिक्षण डेटासेट में कुछ शोर (noises) हैं, जहाँ डेटा का परिमाण बाकी से काफी अलग है—ये शोर हमारे मॉडल को उच्च घात के गुणांकों पर अधिक भार देने के लिए प्रेरित करेंगे, और नतीजा होगा एक ऐसा मॉडल जो हमारे प्रशिक्षण डेटा पर ओवरफिट कर रहा है!
डेटा साइंस की समस्याओं में अक्सर, फीचर्स की संख्या बढ़ने के साथ, कोई मशीन लर्निंग मॉडल आपके डेटा को अच्छी तरह फिट कर सकता है। लेकिन हर चीज़ की एक कमी होती है। यदि आप बहुत अधिक फीचर्स जोड़ते हैं, तो हमें ओवरफिटिंग का दंड मिलता है। आपमें से कुछ सोच सकते हैं, अगर बहुत सारे फीचर्स जोड़ने से ओवरफिटिंग होती है, तो जब एक स्वीकार्य मॉडल मिल जाए, तब और फीचर्स जोड़ना बंद क्यों न कर दें? पर इस तरह सोचिए। यदि आपका ग्राहक या बॉस 95% एक्यूरेसी वाला मॉडल चाहता है, पर आप कुछ और फीचर्स जोड़ने के बिना उस परिणाम तक नहीं पहुँच पा रहे—और वे जोड़ने से डेटा ओवरफिट हो जाता है—तो अगला कदम आप क्या उठाएँगे?
या इसे दूसरे तरीके से सोचिए। आप एक ऐसी समस्या का सामना कर रहे हैं जहाँ आपके पास एक बड़ा डेटासेट है और हर रिकॉर्ड में कई फीचर्स हैं। आपको नहीं पता कि किन फीचर्स को हटाया जाए, और बदतर यह कि यदि हर फीचर काफ़ी सूचनाप्रद निकले—जिसका अर्थ है कि कुछ फीचर्स हटाने से एल्गोरिदम का प्रदर्शन बिगड़ सकता है। तब आप क्या करेंगे?
जवाब है—रेग्युलराइजेशन।
अतः ओवरफिटिंग को रोकने के लिए फीचर्स हटाना हमेशा अच्छा विचार नहीं होता। और जैसा कि आपने ऊपर के उदाहरण में देखा, कम सूचनाप्रद फीचर्स हटाए जा सकते हैं या नहीं—यह जानने के लिए अतिरिक्त विश्लेषण चाहिए। इसलिए, शुरुआत में अपना पहला मॉडल बनाते समय सभी फीचर्स का उपयोग करना अच्छा अभ्यास है। और रेग्युलराइजेशन समाधान के रूप में सामने आता है। इसे और स्पष्ट करने के लिए, पहले MSE कॉस्ट फ़ंक्शन (MSE: Mean Squared Error) पर नज़र डालते हैं:
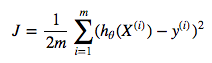
जहाँ,
लॉजिस्टिक रिग्रेशन जैसे मॉडलों में, सीखने का उद्देश्य इस MSE फ़ंक्शन को न्यूनतम करना है। इसका अर्थ है कि आपके पैरामीटर्स किसी भी तरह अपडेट हो सकते हैं, बस MSE का मान घटना चाहिए। और जैसा कि ऊपर उल्लेख किया, आपके पैरामीटर्स जितने बड़े होंगे, आपके मॉडल के डेटा को ओवरफिट करने की संभावना उतनी ही अधिक होगी। तो सवाल है: क्या आप न केवल कॉस्ट फ़ंक्शन को घटा सकते हैं, बल्कि पैरामीटर्स को बहुत बड़ा होने से भी रोक सकते हैं? जवाब है: हाँ, आप कर सकते हैं—नीचे दिए गए अनुसार रेग्युलराइजेशन टर्म जोड़कर:
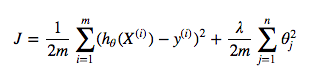
जहाँ,
रेग्युलराइजेशन टर्म जोड़ने के बाद अपने नए कॉस्ट फ़ंक्शन पर नज़र डालें। रेग्युलराइजेशन टर्म बड़े पैरामीटर्स को दंडित करता है। स्पष्ट है, कॉस्ट फ़ंक्शन को न्यूनतम करने में दाईं ओर के दोनों पदों—MSE टर्म और रेग्युलराइजेशन टर्म—को घटाना शामिल है। इसलिए जब भी कोई पैरामीटर अपडेट होकर काफी बड़ा होता है, तो रेग्युलराइजेशन टर्म के कारण कॉस्ट फ़ंक्शन का मान बढ़ जाएगा, और नतीजतन उसे दंडित किया जाएगा और छोटे मान की ओर अपडेट किया जाएगा।
मैं यहीं इस पोस्ट को समाप्त करूँगा। मुझे लगता है कि पोस्ट बहुत लंबी नहीं है, पर आपके लिए दोहराने और खुद से अभ्यास करने के लिए पर्याप्त है। जब आप इस पोस्ट से बनी सहज समझ पर आत्मविश्वास महसूस करें, तो अगले कदम ये होंगे:
यदि आप मशीन लर्निंग के बारे में और सीखना चाहते हैं, तो ये DataCamp कोर्स देखें:
मशीन लर्निंग कोर्स
कोर्स
कोर्स
कोर्स