Corso
Capire il Machine Learning
2 ore
310.9K
Nel machine learning, ti sarà capitato di incontrare il termine overfitting. L’overfitting è un fenomeno in cui un modello di machine learning modella troppo bene i dati di training ma non riesce a ottenere buone prestazioni sui dati di test. Ottenere risultati sufficientemente buoni sui dati di test è considerato una sorta di ultimatum nel machine learning.
Esistono diverse tecniche che aiutano a prevenire l’overfitting. La regolarizzazione è una di queste. E questo post è interamente dedicato a lei. In questo articolo cercherò di spiegare la regolarizzazione con poca matematica e più intuizione. A differenza degli altri miei tutorial, non includerà un caso di studio. Prima di affrontare un caso pratico, vorrei che capissi l’importanza e alcune sottigliezze della regolarizzazione. Perché la regolarizzazione è insidiosa ma una tecnica molto importante da conoscere per chi fa Data Science.
Questo post è strutturato come segue:
Prima di spiegare l’overfitting, parliamo un attimo della generalizzazione nel machine learning.
La generalizzazione si riferisce a quanto bene i concetti appresi da un modello di machine learning si applicano a esempi specifici non visti dal modello durante l’apprendimento (in breve, il set di test).
L’obiettivo di un buon modello di machine learning è generalizzare bene dai dati di training a qualsiasi dato del dominio del problema. Questo ti permette di fare previsioni in futuro su dati che il modello non ha mai visto.
Riporto quanto detto nell’introduzione: “L’overfitting è un fenomeno in cui un modello di machine learning modella troppo bene i dati di training ma non riesce a ottenere buone prestazioni sui dati di test.”
L’overfitting si verifica quando un modello apprende i dettagli e il rumore nei dati di training al punto da influenzare negativamente le prestazioni del modello su dati non visti. Ciò significa che il rumore o le fluttuazioni casuali nei dati di training vengono catturati e appresi come concetti dal modello. Il problema è che questi concetti non si applicano a nuovi dati e danneggiano la capacità del modello di generalizzare.
L’overfitting è più probabile con modelli non parametrici e non lineari che hanno maggiore flessibilità nell’apprendere una funzione obiettivo. Per questo motivo, molti algoritmi di machine learning non parametrici includono anche parametri o tecniche per limitare e vincolare il livello di dettaglio che il modello apprende.
Ad esempio, gli alberi decisionali sono un algoritmo di machine learning non parametrico molto flessibile e soggetto a overfitting sui dati di training. Questo problema può essere affrontato potando l’albero dopo l’apprendimento per rimuovere parte dei dettagli acquisiti. D’altra parte, il underfitting si riferisce a un modello che non riesce né a modellare i dati di training né a generalizzare su nuovi dati.
Quando senti la parola regolarizzazione senza altro legato al Machine Learning, capisci che la regolarizzazione è il processo di rendere qualcosa “regolare” o il processo con cui qualcosa viene regolarizzato. Il punto è: che cos’è esattamente questo “qualcosa”? Nel Machine Learning si parla di algoritmi o modelli di apprendimento, e cosa c’è effettivamente dentro gli algoritmi o i modelli? C’è l’insieme dei parametri. In breve, la regolarizzazione nel machine learning è il processo di regolarizzare i parametri che vincola, regolarizza o riduce le stime dei coefficienti verso zero. In altre parole, questa tecnica scoraggia l’apprendimento di un modello più complesso o flessibile, evitando il rischio di overfitting.
Ora ti stai avvicinando a capire come la regolarizzazione aiuti effettivamente a prevenire l’overfitting. Andiamo dritti al punto.
Dopo aver capito che la regolarizzazione serve a regolarizzare i parametri, potresti chiederti: perché regolarizzare i parametri aiuta a prevenire l’overfitting? Consideriamo il grafico qui sotto:
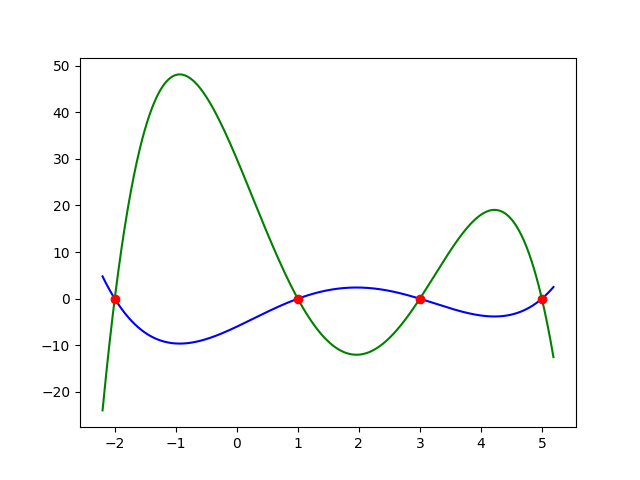
Come puoi vedere nel grafico, ci sono due funzioni rappresentate rispettivamente da una curva verde e una blu. Entrambe le curve si adattano così bene a quei punti rossi che si può considerare che entrambe comportino perdita pari a zero. Per intuizione sull’overfitting, potresti aver indovinato che la curva verde è quella che overfitta. Sì, è proprio così! Ma ti sei mai chiesto perché la curva verde (o qualsiasi curva simile) stia overfittando i dati?
Per capirlo in modo un po’ più matematico, supponiamo le due funzioni usate per tracciare il grafico sopra:
La curva verde:
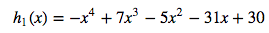
La curva rossa:
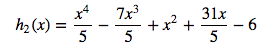
Se guardi l’equazione di ciascuna funzione, noterai che la curva verde ha coefficienti più grandi, ed è questa la causa principale dell’overfitting. Come detto prima, l’overfitting può essere interpretato come un modello che si adatta talmente bene al dataset da sembrare che stia memorizzando i dati mostrati invece di imparare davvero da essi. Intuitivamente, avere coefficienti grandi può essere visto come un indizio di memorizzazione dei dati. Per esempio, se nel dataset di training ci sono rumori, in cui l’ampiezza dei dati è molto diversa dal resto, quei rumori porteranno il modello ad attribuire più peso ai coefficienti di grado superiore, e il risultato sarà un modello che overfitta i dati di training!
Spesso, nei problemi di Data Science, con l’aumentare del numero di feature un modello di machine learning può adattarsi bene ai tuoi dati. Ma ogni cosa ha un rovescio della medaglia. Se aggiungi troppe feature, verrai “punito” con l’overfitting. Alcuni potrebbero pensare: se aggiungere molte feature causa overfitting, perché non smettere semplicemente di aggiungerne quando otteniamo un modello accettabile? Ma pensa anche così: se il tuo cliente o il tuo capo vuole un modello con il 95% di accuratezza, e non riesci a raggiungere quel risultato senza aggiungere altre feature, cosa che porta a overfitting, qual è il passo successivo?
Oppure consideralo da un’altra prospettiva. Ti trovi di fronte a un problema con un ampio dataset, ognuno con molte feature. Non sai quali feature eliminare, e peggio ancora, potrebbe risultare che ogni feature sia abbastanza informativa, il che significa che eliminarne alcune potrebbe compromettere le prestazioni dell’algoritmo. Cosa pensi di fare dopo?
La risposta è: regolarizzazione.
Non è quindi sempre una buona idea eliminare alcune feature per prevenire l’overfitting. E come hai visto nell’esempio sopra, serve un’analisi ulteriore per capire se puoi rimuovere alcune feature meno informative. È quindi una buona pratica usare tutte le feature per costruire il primo modello all’inizio. E la regolarizzazione è la soluzione. Per renderlo più chiaro, diamo prima un’occhiata alla funzione di costo MSE (MSE: Mean Squared Error):
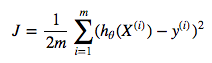
dove,
In modelli come la logistic regression, l’obiettivo dell’apprendimento è minimizzare questa funzione MSE. Significa che i tuoi parametri possono essere aggiornati in qualunque modo, purché riducano il valore dell’MSE. E, come accennato sopra, più grandi diventano i parametri, maggiore è la probabilità che il modello overfitti i dati. Quindi la domanda è: puoi non solo minimizzare la funzione di costo ma anche limitare i parametri affinché non diventino troppo grandi? La risposta è: SÌ, puoi, aggiungendo il termine di regolarizzazione come sotto:
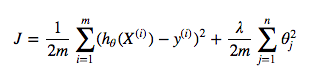
dove,
Osserva la nuova funzione di costo dopo aver aggiunto il termine di regolarizzazione. Il termine di regolarizzazione penalizza i parametri grandi. È chiaro che minimizzare la funzione di costo consiste nel ridurre entrambi i termini a destra: il termine MSE e il termine di regolarizzazione. Quindi, ogni volta che un parametro viene aggiornato diventando significativamente grande, aumenterà il valore della funzione di costo tramite il termine di regolarizzazione e, di conseguenza, verrà penalizzato e aggiornato a un valore più piccolo.
Mi fermo qui. Credo che il post non sia lungo, ma ci sia abbastanza materiale per ripassare e rielaborare da solo. Quando ti sentirai sicuro dell’intuizione costruita con questo articolo, i prossimi passi saranno:
Se vuoi saperne di più sul Machine Learning, dai un’occhiata a questi corsi DataCamp:
Corsi di Machine Learning
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



