{count, plural, one {Khóa học} other {Khóa học}}
Tìm hiểu Machine Learning
{hours} giờ
311.9K
Trong machine learning, hẳn bạn đã gặp thuật ngữ Overfitting. Overfitting (quá khớp) là hiện tượng một mô hình machine learning mô hình hóa dữ liệu huấn luyện quá tốt nhưng lại hoạt động kém trên dữ liệu kiểm tra. Việc đạt kết quả đủ tốt trên dữ liệu kiểm tra được xem là một yêu cầu tối hậu trong machine learning.
Có khá nhiều kỹ thuật giúp ngăn chặn quá khớp. Regularization là một trong số đó. Và bài viết này dành trọn cho chủ đề này. Trong bài, tôi sẽ cố gắng giải thích Regularization ít toán hơn nhưng nhiều trực giác hơn. Khác với các hướng dẫn khác của tôi, bài này sẽ không bao gồm nghiên cứu tình huống nào. Trước khi đi vào bất kỳ nghiên cứu tình huống nào, tôi muốn bạn hiểu tầm quan trọng và những tinh tế nhỏ của Regularization. Bởi Regularization có phần khó nhưng là kỹ thuật rất quan trọng cần biết với một Nhà khoa học dữ liệu.
Bài viết được cấu trúc như sau:
Trước khi giải thích quá khớp, hãy nói một chút về khái quát hóa trong machine learning.
Khái quát hóa đề cập đến mức độ mà các khái niệm do mô hình machine learning học được áp dụng cho các ví dụ cụ thể mà mô hình chưa thấy khi học (nói ngắn gọn là tập kiểm tra).
Mục tiêu của một mô hình machine learning tốt là khái quát hóa tốt từ dữ liệu huấn luyện sang mọi dữ liệu thuộc miền bài toán. Điều này cho phép bạn đưa ra dự đoán trong tương lai trên dữ liệu mà mô hình chưa từng thấy.
Tôi xin trích từ phần mở đầu: “Overfitting là hiện tượng một mô hình machine learning mô hình hóa dữ liệu huấn luyện quá tốt nhưng lại hoạt động kém trên dữ liệu kiểm tra.”
Quá khớp xảy ra khi một mô hình học cả chi tiết và nhiễu trong dữ liệu huấn luyện đến mức làm suy giảm hiệu năng của mô hình trên dữ liệu chưa thấy. Điều này có nghĩa là nhiễu hoặc dao động ngẫu nhiên trong dữ liệu huấn luyện bị mô hình “nhặt” lên và học như những khái niệm. Vấn đề là các khái niệm này không áp dụng cho dữ liệu mới và làm giảm khả năng khái quát hóa của mô hình.
Quá khớp dễ xảy ra hơn với các mô hình phi tham số và phi tuyến vốn linh hoạt hơn khi học hàm mục tiêu. Vì vậy, nhiều thuật toán machine learning phi tham số cũng bao gồm các tham số hoặc kỹ thuật để giới hạn và ràng buộc mức độ chi tiết mà mô hình học.
Ví dụ, cây quyết định là một thuật toán machine learning phi tham số rất linh hoạt và dễ bị quá khớp dữ liệu huấn luyện. Vấn đề này có thể được xử lý bằng cách cắt tỉa cây sau khi học để loại bỏ một số chi tiết đã “nhặt” lên. Ngược lại, Underfitting (thiếu khớp) đề cập đến một mô hình không thể mô hình hóa dữ liệu huấn luyện cũng như không thể khái quát hóa sang dữ liệu mới.
Khi bạn nghe từ Regularization mà không gắn với Machine Learning, bạn có thể hiểu đó là quá trình “chuẩn hóa” hay làm cho thứ gì đó trở nên “đều đặn”. Vấn đề là: chính xác “thứ gì đó” là gì. Trong Machine Learning, bạn nói về các thuật toán hay mô hình học, và bên trong chúng là gì? Đó là tập tham số. Nói ngắn gọn, Regularization trong machine learning là quá trình chuẩn hóa các tham số nhằm ràng buộc, điều chuẩn, hoặc kéo các ước lượng hệ số tiến về gần 0. Nói cách khác, kỹ thuật này làm nản lòng việc học một mô hình quá phức tạp hoặc quá linh hoạt, từ đó tránh rủi ro Overfitting.
Giờ bạn đang dần hiểu Regularization thực sự giúp ngăn Overfitting như thế nào? Hãy đi thẳng vào vấn đề.
Sau khi biết Regularization thực chất là điều chuẩn các tham số, bạn có thể thắc mắc: Vì sao điều chuẩn tham số lại giúp ngăn Overfitting? Hãy xem xét đồ thị dưới đây:
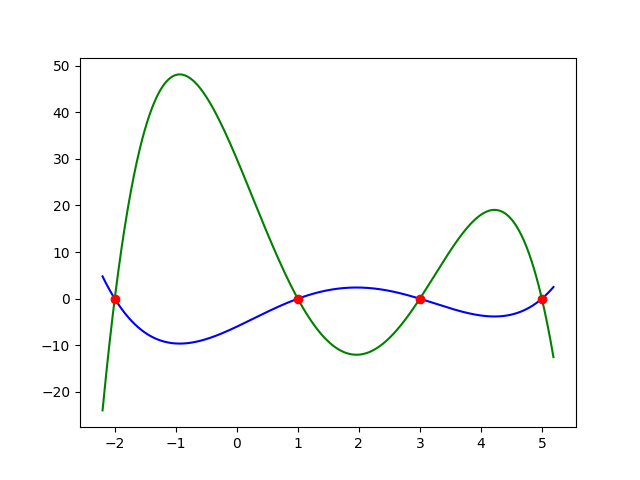
Như bạn thấy trên đồ thị, có hai hàm tương ứng với đường cong màu xanh lá và màu xanh dương. Cả hai đường đều khớp với các điểm đỏ rất tốt đến mức bạn có thể xem như chúng cùng có sai số bằng 0. Từ trực giác về Overfitting, bạn có thể đoán đường xanh lá là đường quá khớp. Vâng, bạn hoàn toàn đúng! Nhưng bạn đã bao giờ tự hỏi vì sao đường xanh lá (hoặc bất kỳ đường tương tự) lại quá khớp dữ liệu?
Để hiểu theo cách toán học hơn một chút, giả sử hai hàm được dùng để vẽ đồ thị trên:
Đường màu xanh lá:
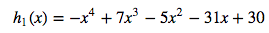
Đường màu đỏ:
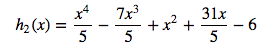
Nếu bạn nhìn vào phương trình của mỗi hàm, bạn sẽ thấy đường xanh lá có các hệ số lớn hơn, và đó là nguyên nhân chính của Overfitting. Như đã nói, Overfitting có thể được hiểu là mô hình khớp với tập dữ liệu quá tốt đến mức dường như ghi nhớ dữ liệu chúng ta đưa vào hơn là thực sự học từ nó. Một cách trực giác, việc có các hệ số lớn có thể xem như dấu hiệu của việc ghi nhớ dữ liệu. Ví dụ, bạn có một số nhiễu trong tập huấn luyện, nơi độ lớn của dữ liệu khác xa so với phần còn lại; những nhiễu này sẽ khiến mô hình đặt trọng số lớn hơn vào các hệ số bậc cao, và kết quả là bạn nhận được một mô hình quá khớp dữ liệu huấn luyện!
Trong các bài toán Khoa học dữ liệu, khi số lượng đặc trưng tăng lên, một mô hình machine learning có thể khớp dữ liệu của bạn tốt hơn. Nhưng mọi thứ đều có mặt trái. Nếu bạn thêm quá nhiều đặc trưng, bạn sẽ bị “trừng phạt” bởi Overfitting. Một số bạn có thể nghĩ, nếu thêm quá nhiều đặc trưng gây Overfitting, vậy sao không dừng thêm khi đã có mô hình chấp nhận được? Nhưng hãy nghĩ theo cách này. Nếu khách hàng hoặc sếp của bạn muốn một mô hình học đạt độ chính xác 95%, nhưng bạn không thể đạt được nếu không thêm một vài đặc trưng nữa, điều này lại dẫn đến quá khớp dữ liệu. Bạn sẽ làm gì tiếp theo?
Hoặc nghĩ theo một cách khác. Bạn đang đối mặt với một vấn đề mà bạn có một tập dữ liệu lớn, mỗi mẫu chứa nhiều đặc trưng. Bạn không biết nên bỏ đặc trưng nào, và tệ hơn nếu hóa ra mọi đặc trưng đều khá giàu thông tin, nghĩa là việc loại bỏ một số đặc trưng có thể làm hỏng hiệu năng thuật toán. Kế hoạch tiếp theo của bạn là gì?
Câu trả lời là regularization.
Vì vậy, không phải lúc nào việc loại bỏ một số đặc trưng cũng là ý tưởng hay để ngăn Overfitting. Và như bạn thấy trong ví dụ trên, cần phân tích thêm để biết liệu bạn có thể loại bỏ một số đặc trưng kém thông tin hay không. Vì thế, một thực hành tốt là dùng tất cả đặc trưng để xây dựng mô hình đầu tiên. Và Regularization xuất hiện như một giải pháp. Để rõ ràng hơn, trước hết hãy xem hàm chi phí MSE (MSE: Mean Squared Error - sai số bình phương trung bình):
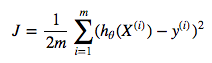
trong đó,
Trong các mô hình như Hồi quy Logistic, mục tiêu học là tối thiểu hóa hàm MSE này. Điều đó có nghĩa là các tham số của bạn có thể được cập nhật theo bất kỳ cách nào, miễn là làm giảm giá trị MSE. Và như đã đề cập, tham số càng lớn thì khả năng mô hình của bạn quá khớp dữ liệu càng cao. Vậy câu hỏi là: bạn có thể vừa tối thiểu hóa hàm chi phí vừa ràng buộc các tham số không trở nên quá lớn không? Câu trả lời là: CÓ THỂ, bằng cách thêm thành phần regularization như dưới đây:
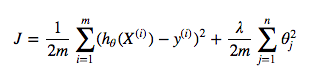
trong đó,
Hãy xem hàm chi phí mới sau khi thêm thành phần regularization. Thành phần regularization sẽ phạt các tham số lớn. Rõ ràng, tối thiểu hóa hàm chi phí bao gồm việc giảm cả hai vế bên phải: vế MSE và vế regularization. Vì vậy, mỗi khi một tham số được cập nhật trở nên quá lớn, nó sẽ làm tăng giá trị của hàm chi phí qua thành phần regularization, và do đó, nó sẽ bị phạt và được cập nhật về giá trị nhỏ hơn.
Tôi sẽ kết thúc bài viết tại đây. Tôi tin rằng bài viết không quá dài, nhưng đủ để bạn ôn lại và tự thực hành. Khi bạn thấy tự tin với trực giác đã xây dựng qua bài này, các bước tiếp theo sẽ là:
Nếu bạn muốn học thêm về Machine Learning, hãy xem các khóa học của DataCamp sau:
Khóa học Machine Learning
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {blog} other {blog}}
Matt Crabtree
10 phút
