Kursus
Memahami Machine Learning
2 jam
311.4K
Dalam machine learning, Anda mungkin pernah menemui istilah Overfitting. Overfitting adalah fenomena ketika sebuah model machine learning memodelkan data pelatihan dengan sangat baik tetapi gagal berkinerja baik pada data pengujian. Berkinerja cukup baik pada data pengujian dianggap sebagai semacam ultimatum dalam machine learning.
Ada cukup banyak teknik yang membantu mencegah overfitting. Regularisasi adalah salah satunya. Dan tulisan ini sepenuhnya membahas hal tersebut. Di sini, saya akan mencoba menjelaskan Regularisasi dengan sedikit matematika namun lebih banyak intuisi. Tidak seperti tutorial saya yang lain, tulisan ini tidak akan membahas studi kasus. Sebelum masuk ke studi kasus apa pun, saya ingin Anda memahami pentingnya dan seluk-beluk Regularisasi. Karena Regularisasi itu rumit tetapi sangat penting untuk dipahami sebagai Data Scientist.
Tulisan ini disusun sebagai berikut:
Sebelum menjelaskan overfitting, mari membahas sedikit tentang generalisasi dalam machine learning.
Generalisasi mengacu pada seberapa baik konsep yang dipelajari oleh model machine learning berlaku untuk contoh spesifik yang tidak terlihat oleh model saat proses belajar (singkatnya: himpunan pengujian).
Tujuan model machine learning yang baik adalah melakukan generalisasi dengan baik dari data pelatihan ke data apa pun dalam domain masalah. Ini memungkinkan Anda membuat prediksi di masa depan pada data yang belum pernah dilihat model.
Saya akan mengutip dari bagian pengantar: “Overfitting adalah fenomena ketika sebuah model machine learning memodelkan data pelatihan dengan sangat baik tetapi gagal berkinerja baik pada data pengujian."
Overfitting terjadi ketika sebuah model mempelajari detail dan noise dalam data pelatihan hingga tingkat yang berdampak negatif pada kinerja model terhadap data yang belum pernah dilihat. Artinya, noise atau fluktuasi acak dalam data pelatihan ditangkap dan dipelajari sebagai konsep oleh model. Masalahnya, konsep-konsep ini tidak berlaku untuk data baru dan berdampak negatif pada kemampuan model untuk melakukan generalisasi.
Overfitting lebih mungkin terjadi pada model nonparametrik dan non-linear yang lebih fleksibel saat mempelajari fungsi target. Karena itu, banyak algoritma machine learning nonparametrik juga menyertakan parameter atau teknik untuk membatasi dan mengekang seberapa banyak detail yang dipelajari model.
Sebagai contoh, decision tree adalah algoritma machine learning nonparametrik yang sangat fleksibel dan rentan terhadap overfitting pada data pelatihan. Masalah ini dapat diatasi dengan memangkas pohon setelah belajar untuk menghapus sebagian detail yang tertangkap. Di sisi lain, Underfitting mengacu pada model yang tidak mampu memodelkan data pelatihan maupun melakukan generalisasi ke data baru.
Saat Anda mendengar kata Regularisasi tanpa konteks lain terkait Machine Learning, Anda mungkin memahami bahwa Regularisasi adalah proses menertibkan sesuatu atau proses ketika sesuatu dibuat menjadi teratur. Masalahnya: apa tepatnya “sesuatu” itu. Dalam Machine Learning, kita berbicara tentang algoritma atau model pembelajaran, dan apa yang sebenarnya ada di dalam algoritma atau model? Yaitu sekumpulan parameter. Singkatnya, Regularisasi dalam machine learning adalah proses menertibkan parameter yang membatasi, menertibkan, atau mengecilkan taksiran koefisien menuju nol. Dengan kata lain, teknik ini mencegah pembelajaran model yang terlalu kompleks atau fleksibel, sehingga menghindari risiko Overfitting.
Sekarang, Anda mulai memahami bagaimana Regularisasi sebenarnya membantu mencegah Overfitting? Mari langsung ke intinya.
Setelah mengetahui bahwa Regularisasi bertujuan menertibkan parameter, Anda mungkin bertanya: Mengapa menertibkan parameter membantu mencegah Overfitting? Mari pertimbangkan grafik di bawah ini:
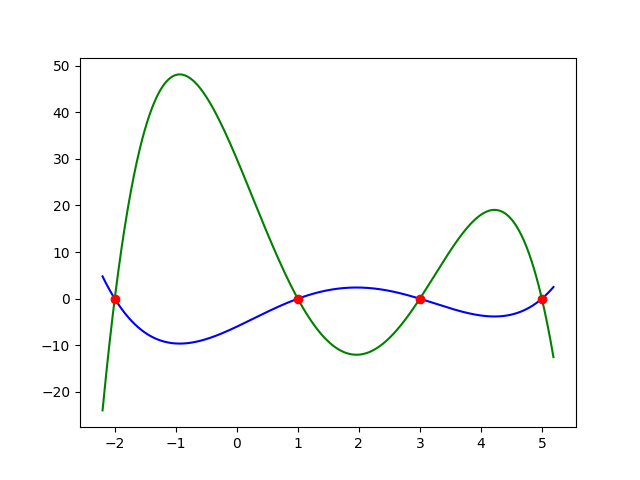
Seperti yang terlihat pada grafik, ada dua fungsi yang diwakili oleh kurva hijau dan kurva biru. Keduanya memuat titik-titik merah dengan sangat baik hingga dapat dianggap sama-sama menghasilkan loss nol. Dari intuisi tentang Overfitting, Anda mungkin menebak kurva hijau adalah yang melakukan overfit. Ya, benar sekali! Tetapi pernahkah Anda bertanya mengapa kurva hijau (atau kurva lain yang serupa) melakukan overfitting terhadap data?
Untuk memahaminya sedikit lebih matematis, mari asumsikan dua fungsi yang digunakan untuk menggambar grafik di atas:
Kurva hijau:
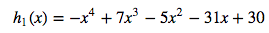
Kurva merah:
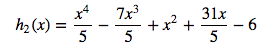
Jika Anda melihat bentuk persamaan masing-masing, Anda akan mendapati bahwa kurva hijau memiliki koefisien yang lebih besar, dan itulah penyebab utama Overfitting. Seperti disebutkan sebelumnya, Overfitting dapat diartikan bahwa model Anda memuat dataset dengan sangat baik sampai tampak menghafal data yang ditunjukkan alih-alih benar-benar belajar darinya. Secara intuitif, koefisien yang besar dapat dianggap sebagai bukti menghafal data. Misalnya, ada noise pada dataset pelatihan, di mana magnitudo data jauh berbeda dari yang lain; noise tersebut akan menyebabkan model kita memberi bobot lebih besar pada koefisien berderajat lebih tinggi, dan hasilnya adalah model yang melakukan overfit pada data pelatihan!
Sering kali dalam masalah Data Science, dengan bertambahnya jumlah fitur, sebuah model machine learning dapat memuat data Anda dengan baik. Namun, semuanya punya kelemahan. Jika Anda menambahkan terlalu banyak fitur, kita akan dihukum dengan Overfitting. Sebagian dari Anda mungkin berpikir, jika menambahkan terlalu banyak fitur menyebabkan Overfitting, mengapa kita tidak berhenti menambah fitur ketika model sudah cukup baik? Tetapi pikirkan begini. Jika pelanggan atau atasan Anda menginginkan model dengan akurasi 95%, namun Anda tidak dapat mencapainya tanpa menambahkan beberapa fitur lagi yang berujung pada overfitting data, apa langkah Anda berikutnya?
Atau pikirkan dengan cara lain. Anda menghadapi masalah dengan dataset besar, dan masing-masing berisi banyak fitur. Anda tidak tahu fitur mana yang harus dihapus, dan lebih buruk lagi jika ternyata setiap fitur cukup informatif, yang berarti menghapus beberapa fitur kemungkinan akan merusak kinerja algoritma. Apa rencana Anda berikutnya?
Jawabannya adalah regularisasi.
Karena itu, tidak selalu merupakan ide yang baik untuk menghapus beberapa fitur guna mencegah Overfitting. Dan seperti yang Anda lihat pada contoh di atas, diperlukan analisis lebih lanjut untuk mengetahui apakah Anda dapat menghapus beberapa fitur yang kurang informatif. Jadi, praktik yang baik adalah menggunakan semua fitur untuk membangun model pertama Anda di awal. Dan Regularisasi hadir sebagai solusinya. Agar lebih jelas, mari terlebih dahulu melihat fungsi biaya MSE (MSE: Mean Squared Error):
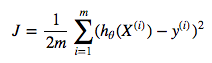
di mana,
Pada model seperti Regresi Logistik, tujuan pembelajaran adalah meminimalkan fungsi MSE ini. Artinya parameter Anda dapat diperbarui dengan cara apa pun, asalkan menurunkan nilai MSE. Dan seperti disebutkan di atas, semakin besar parameter Anda, semakin tinggi peluang model Anda melakukan overfit terhadap data. Jadi pertanyaannya: dapatkah Anda tidak hanya meminimalkan fungsi biaya tetapi juga membatasi parameter agar tidak menjadi terlalu besar? Jawabannya: BISA, dengan menambahkan term regularisasi seperti di bawah ini:
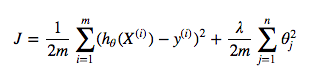
di mana,
Perhatikan fungsi biaya baru Anda setelah menambahkan term regularisasi. Term regularisasi memberi penalti pada parameter yang besar. Jelas, meminimalkan fungsi biaya terdiri dari mengurangi kedua suku di sebelah kanan: suku MSE dan suku regularisasi. Jadi setiap kali suatu parameter diperbarui hingga menjadi sangat besar, nilai fungsi biaya akan meningkat karena term regularisasi, dan akibatnya parameter tersebut akan dipenalti dan diperbarui menjadi lebih kecil.
Saya akhiri tulisan ini sampai di sini. Saya percaya tulisan ini tidak terlalu panjang, tetapi cukup bagi Anda untuk meninjau dan memantapkan pemahaman sendiri. Ketika Anda merasa yakin dengan intuisi yang dibangun dari tulisan ini, langkah selanjutnya adalah:
Jika Anda ingin belajar lebih lanjut tentang Machine Learning, lihat kursus DataCamp berikut:
Kursus Machine Learning
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



