
Last chance! 50% off DataCamp Premium
Sale ends in
In machine learning ben je vast de term overfitting tegengekomen. Overfitting is een verschijnsel waarbij een machine learning-model de trainingsdata té goed modelleert, maar slecht presteert op de testdata. Voldoende goed presteren op testdata wordt in machine learning gezien als een soort ultimatum.
Er zijn behoorlijk wat technieken die helpen om overfitting te voorkomen. Regularisatie is zo’n techniek. En deze post is daar helemaal aan gewijd. In deze post probeer ik regularisatie uit te leggen met minder wiskunde en meer intuïtie. In tegenstelling tot mijn andere tutorials komt er geen casestudy aan bod. Voordat we in een casestudy duiken, wil ik dat je het belang en de kleine finesses van regularisatie begrijpt. Want regularisatie is tricky, maar een heel belangrijke techniek om te kennen als data scientist.
Deze post is als volgt opgebouwd:
Voordat we overfitting uitleggen, praten we eerst even over generalisatie in machine learning.
Generalisatie verwijst naar hoe goed de concepten die een machine learning-model heeft geleerd, toepasbaar zijn op concrete voorbeelden die het model tijdens het leren niet heeft gezien (kortweg de testset).
Het doel van een goed machine learning-model is om goed te generaliseren van de trainingsdata naar alle data binnen het probleemdomein. Zo kun je in de toekomst voorspellingen doen op data die het model nog nooit heeft gezien.
Ik citeer uit de inleiding: “Overfitting is een verschijnsel waarbij een machine learning-model de trainingsdata té goed modelleert, maar slecht presteert op de testdata."
Overfitting treedt op wanneer een model de details en de ruis in de trainingsdata zó leert dat dit de prestaties op onzichtbare data negatief beïnvloedt. Dit betekent dat de ruis of willekeurige fluctuaties in de trainingsdata worden opgepikt en door het model als concepten worden geleerd. Het probleem is dat deze concepten niet gelden voor nieuwe data en de generalisatie van het model schaden.
Overfitting komt vaker voor bij niet-parametrische en niet-lineaire modellen die meer flexibiliteit hebben bij het leren van een doelfunctie. Daarom bevatten veel niet-parametrische machine learning-algoritmen ook parameters of technieken om te beperken hoeveel detail het model leert.
Zo zijn beslissingsbomen een niet-parametrisch machine learning-algoritme dat zeer flexibel is en gevoelig voor overfitting op trainingsdata. Dit probleem kan worden aangepakt door een boom na het leren te snoeien om zo een deel van de opgepikte details te verwijderen. Aan de andere kant verwijst underfitting naar een model dat noch de trainingsdata kan modelleren, noch kan generaliseren naar nieuwe data.
Als je het woord regularisatie hoort zonder verdere context over machine learning, begrijp je dat regularisatie het proces is waarbij iets wordt gereguleerd of gelijkmatiger gemaakt. De vraag is: wat is dat “iets”? In machine learning heb je het over leeralgoritmen of modellen, en wat zit er eigenlijk in die algoritmen of modellen? Dat is de set parameters. Kort gezegd: regularisatie in machine learning is het proces waarbij je de parameters reguleert die de coëfficiëntschattingen beperken, regulariseren of richting nul laten krimpen. Met andere woorden, deze techniek ontmoedigt het leren van een complexer of flexibeler model en verkleint zo het risico op overfitting.
Nu begin je langzaam te begrijpen hoe regularisatie helpt om overfitting te voorkomen. Laten we daar meteen naartoe gaan.
Nu je weet dat regularisatie neerkomt op het reguleren van onze parameters, vraag je je misschien af: waarom helpt het regulariseren van parameters om overfitting te voorkomen? Laten we naar de onderstaande grafiek kijken:
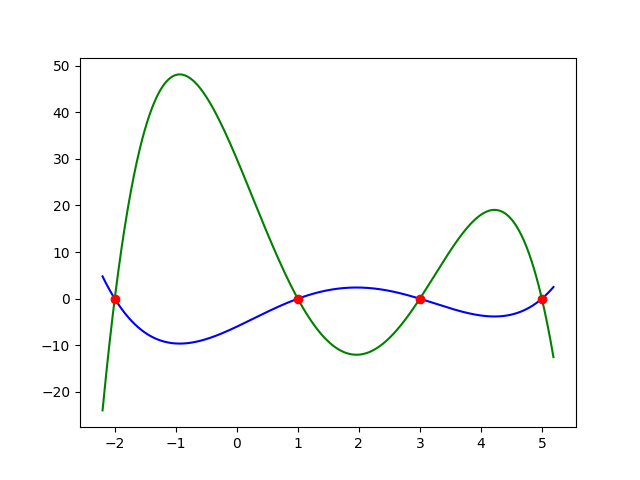
Zoals je in de grafiek ziet, zijn er twee functies weergegeven met respectievelijk een groene en een blauwe curve. Beide curves passen zo goed op die rode punten dat je kunt aannemen dat ze allebei nul verlies hebben. Vanuit de intuïtie over overfitting heb je misschien geraden dat de groene curve degene is die overfit. Klopt helemaal! Maar heb je je ooit afgevraagd waarom de groene curve (of een vergelijkbare curve) de data overfit?
Om dat wat wiskundiger te begrijpen, nemen we de twee functies aan die gebruikt zijn om de bovenstaande grafiek te tekenen:
De groene curve:
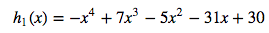
De rode curve:
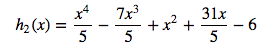
Kijk je naar de vergelijkingen van elke functie, dan zie je dat de groene curve grotere coëfficiënten heeft, en dat is de primaire oorzaak van overfitting. Zoals eerder vermeld kun je overfitting interpreteren als: je model past zó goed op de dataset dat het de data lijkt te memoriseren in plaats van er werkelijk van te leren. Intuïtief kun je grote coëfficiënten zien als een teken van het memoriseren van de data. Stel dat er ruis in je trainingsdataset zit, waarbij de grootte van sommige data sterk afwijkt van de rest; die ruis zorgt ervoor dat je model meer gewicht toekent aan coëfficiënten van hogere orde, en het resultaat is een model dat je trainingsdata overfit!
In data science-problemen kan een machine learning-model met een toenemend aantal features je data vaak goed fitten. Maar alles heeft een keerzijde. Als je te veel features toevoegt, word je gestraft met overfitting. Sommigen denken misschien: als zoveel features toevoegen overfitting veroorzaakt, waarom stoppen we dan niet gewoon met features toevoegen zodra we een acceptabel model hebben? Maar bekijk het eens zo. Als je klant of je baas een geleerd model met 95% nauwkeurigheid wil, maar je dat resultaat niet haalt zonder extra features toe te voegen, wat leidt tot overfitting—wat doe je dan?
Of denk er op een andere manier over. Je hebt een probleem waarbij je een grote dataset krijgt, en elk record bevat veel features. Je weet niet welke features je moet laten vallen, en het is nog lastiger als blijkt dat elke feature redelijk informatief is, wat betekent dat het laten vallen van sommige features de prestaties van het algoritme waarschijnlijk schaadt. Wat is dan je plan?
Het antwoord is: regularisatie.
Het is dus niet altijd een goed idee om features te verwijderen om overfitting te voorkomen. En zoals je in het bovenstaande voorbeeld zag, is er meer analyse nodig om te bepalen of je minder informatieve features kunt schrappen. Het is daarom een goede gewoonte om in het begin alle features te gebruiken om je eerste model te bouwen. En regularisatie biedt een oplossing. Om het transparanter te maken, kijken we eerst naar de MSE-kostenfunctie (MSE: Mean Squared Error):
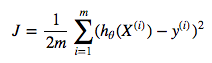
waarbij,
In modellen zoals logistische regressie is het doel van het leren om deze MSE-functie te minimaliseren. Dat betekent dat je parameters op elke manier kunnen worden bijgewerkt, zolang de MSE maar daalt. En zoals hierboven vermeld: hoe groter je parameters worden, hoe groter de kans dat je model de data overfit. Dus de vraag is: kun je niet alleen de kostenfunctie minimaliseren, maar ook voorkomen dat de parameters te groot worden? Het antwoord is: DAT KAN, door de regularisatieterm toe te voegen zoals hieronder:
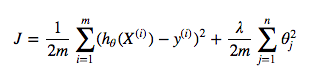
waarbij,
Kijk naar je nieuwe kostenfunctie na het toevoegen van de regularisatieterm. De regularisatieterm bestraft grote parameters. Het minimaliseren van de kostenfunctie bestaat duidelijk uit het verlagen van beide termen rechts: de MSE-term en de regularisatieterm. Telkens wanneer een parameter wordt bijgewerkt en aanzienlijk groot wordt, verhoogt dat de waarde van de kostenfunctie via de regularisatieterm; als gevolg daarvan wordt die parameter bestraft en bijgewerkt naar een kleinere waarde.
Ik rond deze post hier af. Ik denk niet dat de post erg lang is, maar er staat genoeg in om zelf te herhalen en uit te werken. Als je je zeker voelt over de intuïtie die je met deze post hebt opgebouwd, zijn de volgende stappen:
Wil je meer leren over machine learning? Bekijk dan deze DataCamp-cursussen:
Cursussen Machine Learning
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

