学习路径
深度学习 在 Python 中
18 小时
TRIBE v2(TRImodal Brain Encoder)是一个深度学习模型,用于将自然化刺激映射到预测的 fMRI 脑响应。给定一段视频、一个音频文件或一段文本,模型会在 fsaverage5 皮层表面的 20,484 个顶点上以 1 Hz 输出预测的 BOLD 信号,即每秒进行一次预测。
预测针对的是平均受试者(而非某个特定个体的大脑),即 TRIBE v2 从四个自然化数据集中的 720 名参与者所学习到的典型群体平均响应。该模型在 Human Connectome Project 7T 数据集上的零样本预测优于单一受试者的 fMRI 记录,而该数据集是训练集中信号质量最高的。
|
属性 |
详情 |
|
输出空间 |
fsaverage5 表面上的 20,484 个皮层顶点,以及约 70,000 个体素(皮层 + 皮层下)的全脑预测 |
|
时间分辨率 |
1 Hz(与 fMRI 的 TR 频率匹配) |
|
输入模态 |
视频(V-JEPA2-Giant)、音频(Wav2Vec-BERT 2.0)、文本(LLaMA 3.2-3B) |
|
编码器参数量 |
~10 亿个在 Transformer 集成层中可学习的参数 |
|
训练数据 |
横跨 720 名受试者、4 个数据集的 1,115 小时 fMRI |
|
泛化能力 |
对新受试者、新任务和新语言的零样本泛化 |
|
许可证 |
CC-BY-NC 4.0(研究用途,非商业) |
该模型改编自论文 A foundation model of vision, audition, and language for in-silico neuroscience,展示了 TRIBE v2 无需在推理时使用任何 fMRI 数据,也能恢复与面孔相关的梭状回面孔区(FFA)、与场景相关的海马旁地点区(PPA)、处理复杂句法的布罗卡区,以及与语音相关的左侧化语言网络。
TRIBE v2 在每次推理调用中按顺序运行三个阶段:
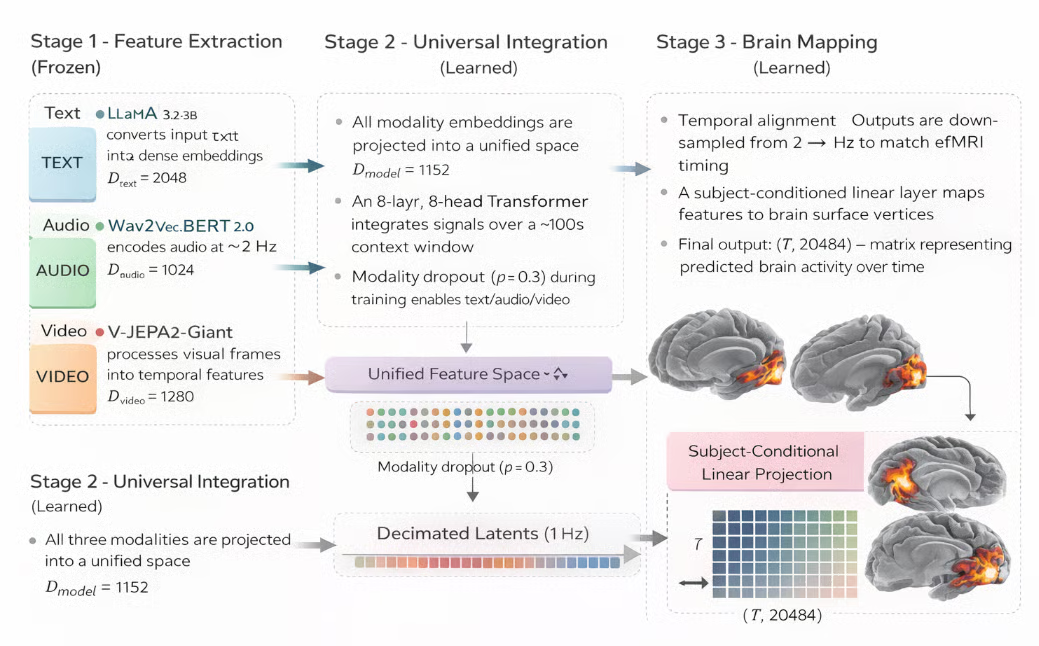
示意图:TRIBE v2 脑活动预测模型(由 AI 生成)
首先,三个独立的预训练编码器分别将各自的输入模态处理为密集且时间对齐的嵌入。这些编码器在训练期间不更新(冻结),因此 TRIBE v2 直接继承其表征。各模态特征提取的部分指标如下:
文本:LLaMA 3.2-3B 将输入文本转换为密集嵌入(D = 2048)
音频:Wav2Vec-BERT 2.0 以约 2 Hz 对音频信号编码(D = 1024)
视频:V-JEPA2-Giant 将视觉帧处理为时序特征(D = 1280)
三路嵌入流被融合为一个共享表征,并由跨时间注意的 Transformer 处理。这是 TRIBE v2 可学习权重所在之处,也是捕捉跨模态交互的地方,具体如下:
共享表征:所有模态嵌入被投影到统一空间(D_model = 1152)
Transformer 融合:一个 8 层、8 头的 Transformer 在约 100 秒的长上下文窗口内整合信号
模态灵活性:模态 dropout(p = 0.3)使得可以用任意子集(文本/音频/视频)进行推理
融合后的潜在表征被投影到皮层表面,生成最终的 fMRI 预测。该阶段将抽象的模型特征转换为空间和时间上分辨的脑活动估计。
由于三个特征提取器在训练中被冻结,TRIBE v2 仅学习投影层和整合其输出的 Transformer 权重。这个设计选择很重要,因为这意味着模型对分布外刺激具有鲁棒性:它继承了三个大规模预训练模型的泛化能力,而不是仅在 fMRI 数据上端到端训练。
注意:一个关键训练技巧是模态 dropout。训练时,每个模态以 0.3 的概率独立置零。这迫使模型能够从任意模态子集做出有意义的预测。因此,在推理时,您只传入音频或只传入文本,仍能得到有用的皮层预测。
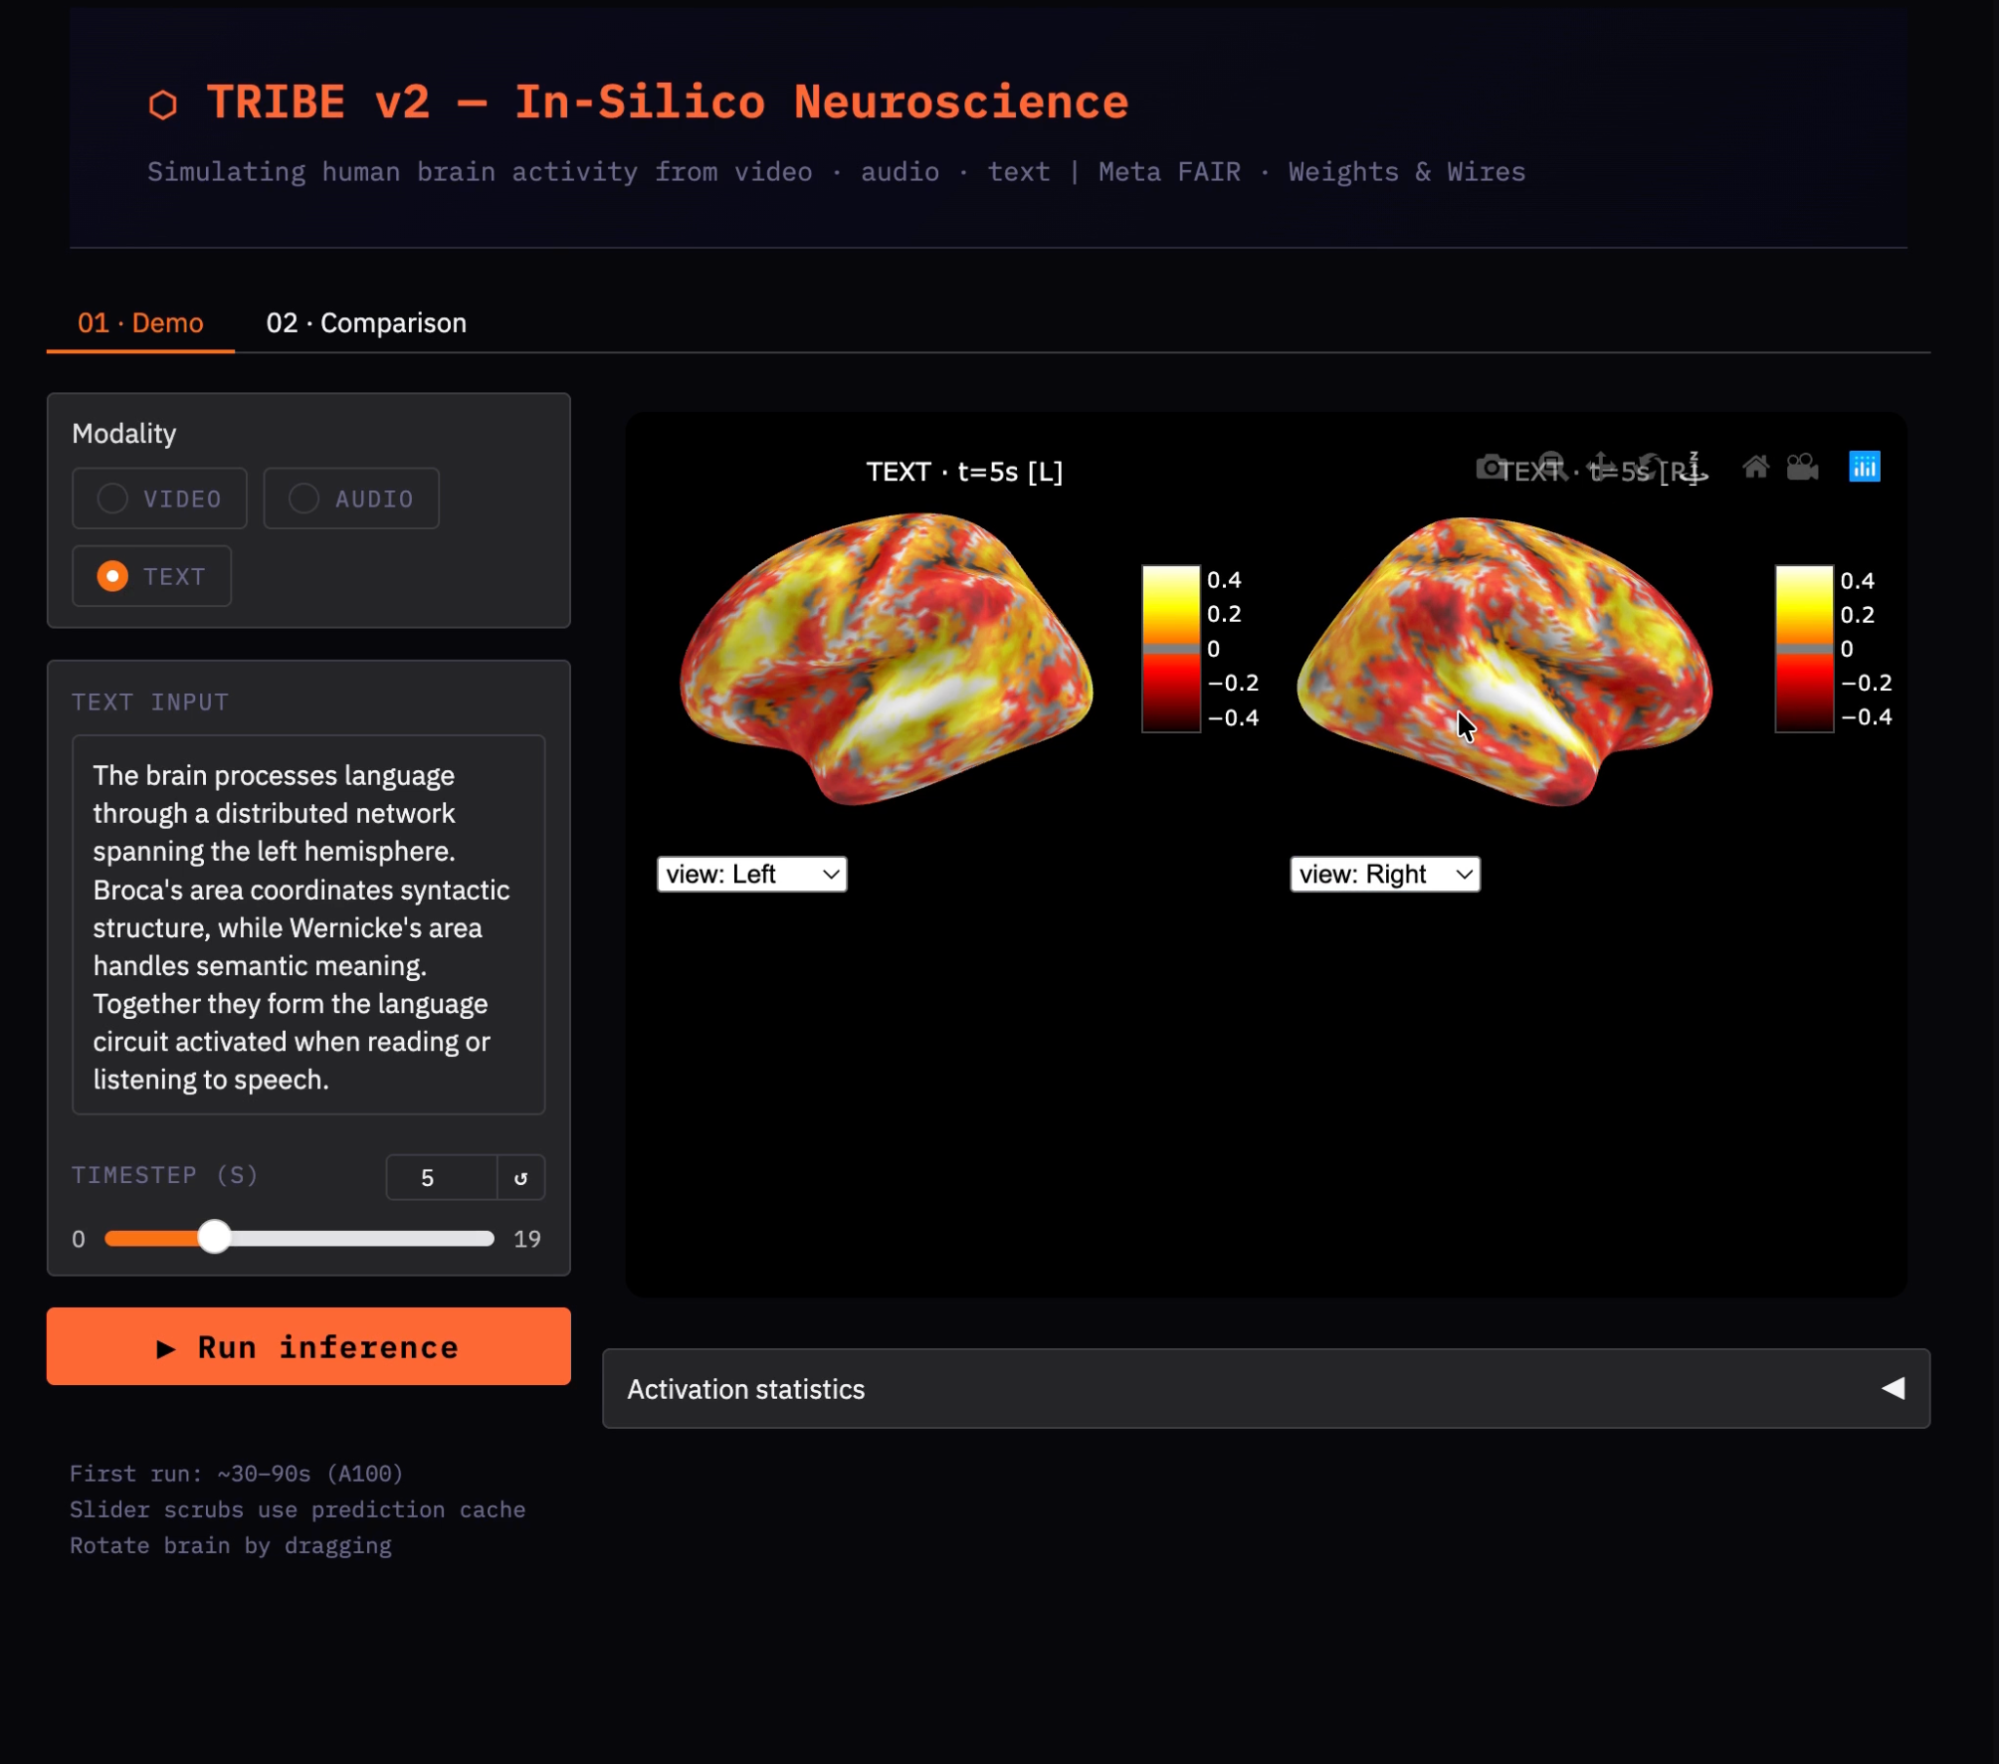
在本部分中,我们将构建一个分步工作流,对文本、音频或视频输入运行 TRIBE v2 推理,并将预测的皮层活动可视化为交互式 3D 脑热力图。我们还将运行一个比较实验,复现实验论文中的体内计算范式。最后,我们将开发一个任何人都可在线体验的 Gradio 应用。
开始之前,请配置您的 Colab 运行时。您也可以使用任何拥有高内存的稳定 A100 GPU 的服务。
TRIBE v2 会同时加载三个冻结的编码器:LLaMA 3.2-3B(约 7 GB)、V-JEPA2-Giant(约 14 GB)和 Wav2Vec-BERT 2.0(约 1 GB),以及 TRIBE 的 Transformer 权重。总显存占用约为 28–32 GB。
注意:当 model.predict() 加载 LLaMA 时,T4(16 GB)会发生内存不足。为获得更好表现,请使用 A100(40 GB)或启用 High RAM 的 A100(80 GB)。
在安装任何东西前,先运行以下命令验证您的 GPU:
import subprocess, sys
result = subprocess.run(
    ['nvidia-smi', '--query-gpu=name,memory.total',
     '--format=csv,noheader,nounits'],
    capture_output=True, text=True)
print(result.stdout.strip())
import torch
assert torch.cuda.is_available(), "No GPU detected"
props = torch.cuda.get_device_properties(0)
assert props.total_memory > 30e9, (
    f"Need ≥40 GB VRAM. Got {props.total_memory/1e9:.0f} GB. Switch to A100.")
print(f"GPU: {props.name} — {props.total_memory/1e9:.0f} GB")
subprocess.run() 调用以 --query-gpu 标志调用 nvidia-smi,提取 GPU 名称和总显存。两个 assert 充当早期退出;第一个确认 CUDA 可用,第二个验证总显存超过 30 GB。此处“明确失败”优于在 model.predict() 中运行 10 分钟后以含糊的 CUDA 内存不足错误“悄然失败”。
如果您不在 Google Colab 上运行,可跳过此步。Colab 默认提供 NumPy 2.x,这是您将遇到的第一个问题。TRIBE v2 的若干内部依赖,尤其是 neuralset,是针对 NumPy <2.1 编译的,而后者移除了 numpy._core.umath 中的 _center 符号。尝试 import tribev2 时会报如下错:
ImportError
cannot import name '_center' from 'numpy._core.umath'
(/usr/local/lib/python3.12/dist-packages/numpy/_core/umath.py)
修复方法是在安装 tribev2 或其依赖之前将 NumPy 固定到 <2.1,然后重启运行时。直接运行下方单元,即可卸载当前 NumPy 并替换为 2.1 以下的版本。
import subprocess, sys
print("Pinning NumPy to <2.1 (required for neuralset compatibility)...")
subprocess.run([sys.executable, '-m', 'pip', 'uninstall', '-y', 'numpy'])
subprocess.run([sys.executable, '-m', 'pip', 'install', '-q',
                'numpy>=1.26.4,<2.1.0'])
当环境与依赖固定后,我们即可继续安装 TRIBE v2。
在全新重启内核并加载了固定版本的 NumPy 后,我们可以安全地从 GitHub 安装 tribev2 包,并配合安装可视化与 UI 库。
import numpy as np
from packaging.version import Version
assert Version(np.__version__) < Version('2.1.0'), (
    f"NumPy is {np.__version__}. Run Step 2a and restart first.")
print(f"NumPy {np.__version__} Checked")
# Install tribev2 from GitHub
!pip install -q 'tribev2[plotting] @ git+https://github.com/facebookresearch/tribev2.git'
!pip install -q 'gradio>=4.19.0' 'nilearn>=0.10.3' 'plotly>=5.18.0'
tribev2[plotting] 额外安装了 pyvista(3D 可视化库)和 nilearn(神经影像库),以及核心包。直接从 GitHub URL 安装可确保无需本地克隆即可获取最新提交。
单独安装 nilearn 与 gradio 是因为它们的版本约束更灵活,且从 tribev2 的依赖图中独立解析更有利。
文本编码器使用 LLaMA 3.2-3B,这是 HuggingFace 上的受限模型。下载权重前,您需要明确接受 Meta 的许可证。只需操作一次:
设置好 HF 令牌后,运行以下代码登录您的账户:
import os
# Load token from Colab Secrets
try:
    from google.colab import userdata
    os.environ['HF_TOKEN'] = userdata.get('HF_TOKEN')
    print("HF_TOKEN loaded from Colab Secrets")
except Exception:
    from huggingface_hub import login
    login()
首选路径使用 google.colab.userdata.get(),从 Colab 的加密 Secrets 存储读取,无法在共享笔记本链接中被意外泄露。
回退路径调用 huggingface_hub.login(),交互式提示并在输入时遮蔽令牌。两种方式都会将令牌写入 os.environ['HF_TOKEN'],HuggingFace Hub 库在下载受限模型权重时会自动读取它。
固定 NumPy、配置好认证并缓存 LLaMA 后,我们可以从 HuggingFace 加载 TRIBE v2 编码器检查点。首次运行会下载约 1 GB,此后从缓存读取仅需数秒。
from pathlib import Path
from tribev2.demo_utils import TribeModel
import torch
CACHE_DIR = Path('/content/tribe_cache')
CACHE_DIR.mkdir(exist_ok=True)
print('Loading TRIBE v2 (first run downloads ~1 GB)...')
model = TribeModel.from_pretrained(
    'facebook/tribev2',
    cache_folder=str(CACHE_DIR)
)
print('Model loaded')
if torch.cuda.is_available():
    used  = torch.cuda.memory_allocated() / 1e9
    total = torch.cuda.get_device_properties(0).total_memory / 1e9
    print(f'VRAM after load: {used:.1f} / {total:.1f} GB')
TribeModel.from_pretrained() 会从 HuggingFace 的 facebook/tribev2 下载 TRIBE 编码器检查点并保存到 cache_folder。该检查点包含 Transformer 集成权重和 subject block,但不包含三个特征提取器。后者将在 model.predict() 首次使用各自模态时单独拉取。
仅加载 TRIBE 编码器后,约分配 2–4 GB 显存;其余 24–28 GB 会在 model.predict() 首次加载 V-JEPA2-Giant 和 LLaMA 3.2-3B 时消耗。
加载 TRIBE 模型后,首次对文本输入调用 model.predict() 会触发延迟下载 LLaMA 3.2-3B 权重(约 6 GB)。HuggingFace Hub 默认超时为 10 秒,会在推理中途出现如下错误:
ReadTimeout
The read operation timed out
Computing word embeddings:  0%|  | 0/9 [00:10<?, ?it/s]
为修复此问题,提高超时环境变量,然后用 snapshot_download 预下载 LLaMA,以便获得可见的进度并在中断时自动续传,而不是在 predict() 内部静默失败。
import os
os.environ['HF_HUB_DOWNLOAD_TIMEOUT'] = '300'
os.environ['HF_HUB_HTTP_TIMEOUT']     = '300'
from huggingface_hub import snapshot_download
print("Pre-downloading LLaMA 3.2-3B (~6 GB)...")
print("Runs once — subsequent calls load from cache.\n")
snapshot_download(
    repo_id        = "meta-llama/Llama-3.2-3B",
    cache_dir      = "/content/tribe_cache/llama",
    ignore_patterns= ["*.bin"],
)
print("\n LLaMA 3.2-3B cached")
snapshot_download() 使用 HuggingFace 的分段请求协议将整个仓库下载到本地缓存,连接中断时可自动续传。ignore_patterns=["*.bin"] 会跳过旧的 PyTorch 二进制格式,仅下载 safetensors 文件,总下载量约减少 40%。
在运行真实推理前,我们先设置可视化层。这些辅助函数将原始的 (T, 20484) 预测数组转换为使用 nilearn 的交互式 3D 脑热力图。
TRIBE v2 返回形状为 (T, 20484) 的 NumPy 数组,其中 T 为输入时长(秒)。前 10,242 个顶点为左半球,其余 10,242 个为右半球。
我们使用 nilearn.plotting.view_surf 将每个半球渲染为交互式 WebGL 表面。膨胀网格暴露原本被脑回折叠遮蔽的沟回几何,沟深图在热力图下提供解剖学参照。
fsaverage5 网格是 TRIBE v2 使用的标准 FreeSurfer 皮层模板作为输出空间。我们在此下载一次,后续所有可视化调用都可直接引用,无需再次走网络。
import numpy as np
from nilearn import datasets as nl_datasets
from nilearn.plotting import view_surf
from IPython.display import display, HTML
N_PER_HEMI = 10242   # fsaverage5: 10242 vertices per hemisphere
print('Fetching fsaverage5 mesh...')
fsavg = nl_datasets.fetch_surf_fsaverage(mesh='fsaverage5')
print('Mesh ready')
print('Keys:', [k for k in fsavg.keys() if k != 'description'])
fetch_surf_fsaverage(mesh='fsaverage5') 会从 nilearn 的 CDN 下载 FreeSurfer 的 fsaverage5 模板并缓存,同时返回一个含有 infl_left、infl_right、sulc_left 与 sulc_right 等键的 Bunch(字典)对象。
此子步骤定义了本教程所有可视化依赖的三个核心函数。split_hemis() 用于拆分顶点数组,render_hemi() 构建单个半球的交互式 WebGL 表面,show_brain() 将两者组合为左右并排布局。
def split_hemis(v):
    n = v.shape[0]
    if n == 2 * N_PER_HEMI:
        return v[:N_PER_HEMI], v[N_PER_HEMI:]
    return v[:n//2], v[n//2:]
def render_hemi(pred_vec, hemi='left', title=''):
    lh, rh = split_hemis(pred_vec)
    data = lh if hemi == 'left' else rh
    vmax = max(float(np.percentile(np.abs(data), 99)), 1e-6)
    return view_surf(
        surf_mesh = fsavg[f'infl_{hemi}'],
        surf_map  = data,
        bg_map    = fsavg[f'sulc_{hemi}'],
        hemi      = hemi,
        threshold = '20%',
        cmap      = 'hot',
        black_bg  = True,
        vmax      = vmax,
        bg_on_data= True,
        colorbar  = True,
        title     = title,
    )
def show_brain(pred_vec, title='', t=None):
    sfx = f' — t={t}s' if t is not None else ''
    lv  = render_hemi(pred_vec, 'left',  f'{title} [Left]{sfx}')
    rv  = render_hemi(pred_vec, 'right', f'{title} [Right]{sfx}')
    html = (
        '<div style="display:flex;gap:10px;background:#000;'
        'border-radius:10px;">'
        f'<div style="flex:1">{lv.get_iframe(width="100%",height="460px")}</div>'
        f'<div style="flex:1">{rv.get_iframe(width="100%",height="460px")}</div>'
        '</div>'
    )
    display(HTML(html))
我们来详细理解这些辅助函数的作用:
split_hemis() 函数在索引 10,242 处切分预测向量,这是 FreeSurfer 约定的 fsaverage5 网格的标准分割点。左半球占据索引 0–10241,右半球占据 10242–20483。底部的回退分支用于处理模型返回非标准顶点数的边界情况。
在 render_hemi() 中,vmax 取绝对激活值的 99 百分位而非真实最大值,避免单个极端顶点将整个颜色映射压缩在狭窄范围内,从而使空间模式可见。
view_surf() 返回包含 2.4 MB 自包含 WebGL HTML 的 SurfaceView 对象。get_iframe() 将其包装进给定尺寸的 <iframe>。因此,当我们用两个并排的 iframe 调用 display(HTML(...)) 时,就得到左右半球分屏布局。
模型加载与可视化助手就绪后,我们可以运行第一次真实推理。
TRIBE v2 的推理分两步。首先,model.get_events_dataframe() 从输入中抽取时间对齐的事件:文本的词时序、音频的 Wav2Vec 2 Hz 嵌入,或视频帧的 V-JEPA2 2 Hz 嵌入。
随后将得到的事件 DataFrame 传给 model.predict(),运行 Transformer 与 subject block,生成最终的皮层预测。
import tempfile, os
SAMPLE_TEXT = '''
The brain processes language through a distributed network in the left hemisphere.
Broca's area coordinates syntactic structure, while Wernicke's area handles semantics.
Together they form the language circuit activated when reading or hearing speech.
'''
tmp = tempfile.NamedTemporaryFile(delete=False, suffix='.txt', mode='w')
try:
    tmp.write(SAMPLE_TEXT.strip())
    tmp.flush()
    os.fsync(tmp.fileno())
    tmp.close()
    events = model.get_events_dataframe(text_path=tmp.name)
finally:
    if os.path.exists(tmp.name):
        os.unlink(tmp.name)
print(f'Events: {events.shape}')
print(events[['type', 'start', 'duration']].head(8))
print('\nRunning model.predict()...')
preds, segments = model.predict(events=events)
preds = np.asarray(preds)
print(f'Prediction shape: {preds.shape}')
print(f'  T = {preds.shape[0]}s   (1 Hz fMRI frequency)')
print(f'  V = {preds.shape[1]} vertices  (fsaverage5 cortical surface)')
按 tmp.write()、tmp.flush()、os.fsync(tmp.fileno())、tmp.close() 的写入顺序是修复一个隐蔽错误的关键。如果您在 with 代码块中调用 get_events_dataframe() 而文件尚未关闭,Python 的内部写缓存可能尚未同步到操作系统,tribev2 会读到一个空文件并抛出 ValueError。os.fsync() 确保在 tribev2 打开路径前,操作系统页缓存已刷新到磁盘。
model.predict() 返回一个 (preds, segments) 的元组。preds 数组形状为 (T, 20484),即每秒一个皮层预测,覆盖所有 20,484 个 fsaverage5 顶点。用 np.asarray() 包装,确保其为纯 NumPy 数组,而不受模型内部返回类型影响。一旦拿到 preds,即可在任意时间步进行可视化:
T = preds.shape[0]
print(f'Timesteps: 0 to {T-1}')
T_SHOW = min(5, T - 1)
show_brain(preds[T_SHOW], title='Language stimulus', t=T_SHOW)
我们默认取 t=5,因为 BOLD(血氧水平依赖)信号具有血流动力学延迟,血管对神经活动的响应在刺激开始后约 5–6 秒达到峰值。在 t=0 可视化会显示接近零的激活,与刺激内容无关,因为血管反应尚未建立。min(5, T-1) 用于当输入产生少于 6 个时间步时避免索引错误。
单张激活图能告诉您哪些区域被激活,但无法揭示刺激之间的差异来源。本步骤将两种输入分别通过模型,并计算对比图(A − B),以分离语言内容与视觉/空间内容之间的区域特异差异。
为避免为每个条件重复“写入 -> 刷新 -> 关闭 -> 推理”的模式,我们将其封装为 text_to_preds() 函数。这样可确保对任一条件都不会意外遗漏关键的文件刷新步骤。
TEXT_A = '''
She spoke slowly and clearly, her voice filling the quiet room.
Every sentence carried meaning, and each word was chosen with care.
Language connects us, the professor said, bridging minds across time.
'''
TEXT_B = '''
The canyon walls rose steeply, layers of red and orange sandstone.
A hawk circled overhead, its wings barely moving in the thermal current.
Shadows shifted as the sun tracked its arc across the open desert sky.
'''
def text_to_preds(text):
    tmp = tempfile.NamedTemporaryFile(
        delete=False, suffix='.txt', mode='w', encoding='utf-8')
    try:
        tmp.write(text.strip())
        tmp.flush()
        os.fsync(tmp.fileno())
        tmp.close()
        evts = model.get_events_dataframe(text_path=tmp.name)
        p, _ = model.predict(events=evts)
        return np.asarray(p)
    finally:
        if os.path.exists(tmp.name):
            os.unlink(tmp.name)
print('Condition A: language content...')
preds_a = text_to_preds(TEXT_A)
print('Condition B: visual/spatial content...')
preds_b = text_to_preds(TEXT_B)
我们选择了两段语义内容差异明显的文本,预期发现是:语言内容更多激活左半球颞叶皮层,而视觉/空间内容更多招募枕叶与顶叶后部皮层。
text_to_preds() 将完整流水线封装为单一可复用函数,采用与步骤 8 相同的安全模式,确保在 tribev2 读取前,临时文件已完全刷新。encoding='utf-8' 明确指定可避免平台相关的编码问题。
在获得两个条件的预测后,我们分别可视化各自的结果,并逐顶点相减以生成对比图。
T_shared = min(preds_a.shape[0], preds_b.shape[0])
t_show   = min(5, T_shared - 1)
print('\n[A] Language content:')
show_brain(preds_a[t_show], title='Condition A: Language', t=t_show)
print('\n[B] Visual/spatial content:')
show_brain(preds_b[t_show], title='Condition B: Visual', t=t_show)
print('\n[A − B] Contrast: Language > Visual')
show_brain(preds_a[t_show] - preds_b[t_show], title='Contrast A − B', t=t_show)
对比图 preds_a[t_show] - preds_b[t_show] 是逐顶点直接相减:正值表示条件 A 激活更强的区域,负值表示条件 B 更强。
由于两个条件共享相同的文本处理通路,原始图会整体相似。对比图可突出语言与视觉内容的领域特异差异。
脑热力图展示的是单一时间点的空间模式。本步骤加入时间视角:例如,整个时间序列上两条件的整体激活如何比较?何时差异最显著?
import matplotlib.pyplot as plt
diff_norms = [
    np.linalg.norm(preds_a[i] - preds_b[i])
    for i in range(T_shared)
]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 3.5))
ax1.plot(np.abs(preds_a).mean(axis=1)[:T_shared],
         color='#e74c3c', linewidth=2, label='A: Language')
ax1.plot(np.abs(preds_b).mean(axis=1)[:T_shared],
         color='#3498db', linewidth=2, label='B: Visual')
ax1.set_title('Mean cortical activation over time')
ax1.set_xlabel('Time (s)'); ax1.legend(); ax1.grid(True, alpha=0.3)
ax2.plot(diff_norms, color='#f39c12', linewidth=2)
ax2.fill_between(range(T_shared), diff_norms, alpha=0.2, color='#f39c12')
ax2.set_title('||A − B|| difference over time')
ax2.set_xlabel('Time (s)'); ax2.grid(True, alpha=0.3)
plt.tight_layout(); plt.show()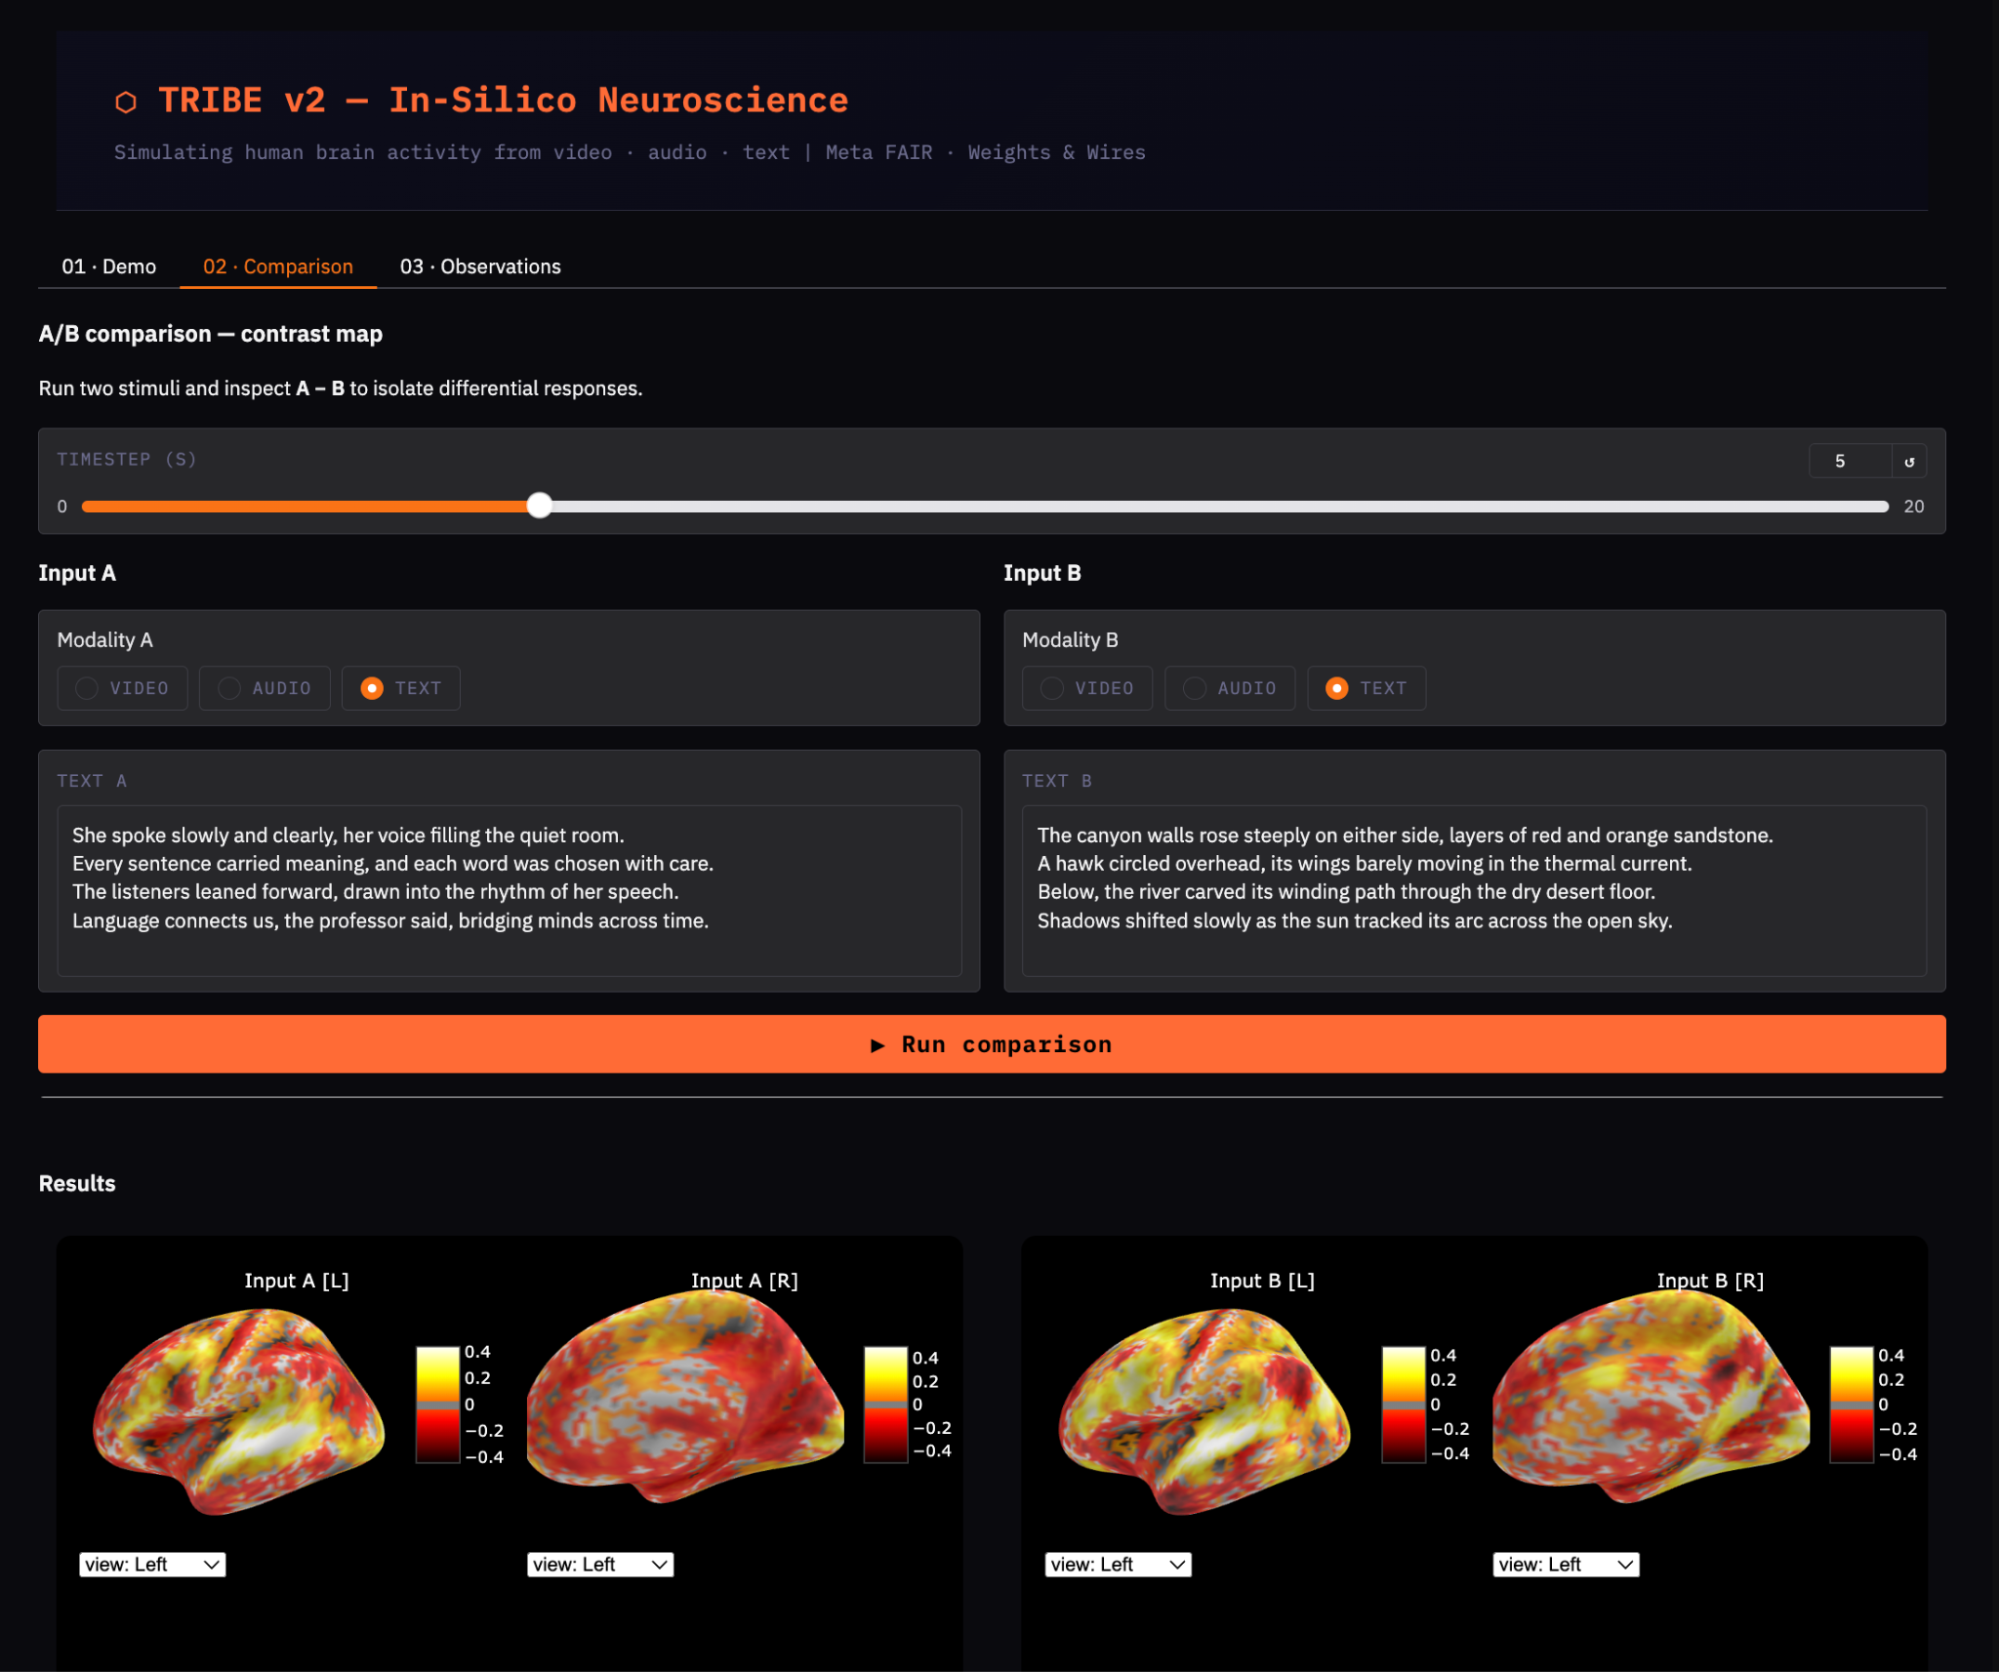
左图绘制 np.abs(preds).mean(axis=1),即每秒对 20,484 个顶点取绝对值后求均值,反映各条件对皮层的总体激活强度与峰值时刻。取绝对值很重要,因为预测的 BOLD 值可能为负(去激活),我们希望看到幅度而非带符号均值。
右图绘制每个时间步的差向量 L2 范数 np.linalg.norm(preds_a[i] - preds_b[i])。该曲线在 t=5–7s 左右出现峰值与血流动力学延迟一致:两个条件都需要时间让 BOLD 响应建立后才会出现分化。fill_between() 的填充使差异的起始与峰值更清晰。
最后一步将推理与可视化逻辑封装到一个 Gradio 应用中,提供简洁 UI、时间步滑块和 A/B 对比标签页。
import gradio as gr
_pred_cache = {}
def _infer(mod, vid, aud, txt):
    """Run inference and cache the result. Subsequent calls return cached array."""
    key = (mod, vid, aud, hash(txt or ''))
    if key not in _pred_cache:
        if mod == 'video':
            evts = model.get_events_dataframe(video_path=vid)
        elif mod == 'audio':
            evts = model.get_events_dataframe(audio_path=aud)
        else:
            tmp = tempfile.NamedTemporaryFile(delete=False, suffix='.txt', mode='w')
            tmp.write((txt or '').strip()); tmp.flush()
            os.fsync(tmp.fileno()); tmp.close()
            evts = model.get_events_dataframe(text_path=tmp.name)
            os.unlink(tmp.name)
        p, _ = model.predict(events=evts)
        _pred_cache[key] = np.asarray(p)
    return _pred_cache[key]
demo.launch(
    share      = True,
    debug      = False,
    server_name= "0.0.0.0",
)
Gradio UI 与推理管线的结合方式如下:
_infer() 函数作为中心推理层,处理三种模态(视频、音频、文本)的输入准备、model.predict() 调用并返回预测的脑活动。
使用基于模态、输入路径与文本哈希组成的键的预测缓存,避免相同输入重复推理。
缓存机制至关重要,因为诸如滑块等 UI 组件会频繁触发回调。没有缓存,每次交互都会重新运行推理(耗时可达 ~60 秒);而有了缓存,首次运行后可即时返回结果。
界面提供两个标签页:单输入模式带时间步滑块以探索随时间的脑活动;对比模式可运行两次输入并将其差异可视化为对比热力图。
最后,demo.launch() 配置了 share=True 以生成公开 URL,server_name="0.0.0.0" 允许外部访问,便于应用部署。
在不同输入(视频、音频与文本)上运行演示后,会出现一些一致模式,有助于解释 TRIBE v2 的输出。部分洞见如下:
模型并不声称 100% 准确,同时也存在自身的陷阱:
TRIBE v2 是强大的研究工具,但存在重要限制,会影响我们对其输出的解读。在据此做出任何科学或临床结论前,理解这些限制至关重要。
在本教程中,我们在 Google Colab A100 上构建了一个可运行的 TRIBE v2 流水线:从解决两个具体问题(NumPy 2.x 版本冲突与 HuggingFace 下载超时),到运行真实的皮层预测,再到将其可视化为交互式 3D 脑热力图,并运行复现实验论文体内计算范式的比较实验。
本教程最重要的四点工程经验是:
将 NumPy 固定到 <2.1,并在安装 tribev2 前重启运行时
设置 HF_HUB_DOWNLOAD_TIMEOUT=300,并在调用 model.predict() 前用 snapshot_download 预下载 LLaMA
在将临时文件路径传给模型前,始终按 写入 → flush() → fsync() → close() 的顺序操作
将预测缓存到字典中,避免因 UI 滑块交互而重复运行推理。
接下来有两个自然的扩展。其一是更丰富的刺激:时长 30–60 秒的真实电影片段或播客片段,较短文本段落会呈现更清晰的时间动力学与空间模式。
其二是个体化微调:给定某一特定受试者约 1 小时的 fMRI 数据,论文结果显示,可在一个 epoch 内微调 TRIBE v2 的 subject block,从而将个体化预测性能较群体平均模型提升 2–4 倍。
完整的笔记本可在 TRIBE v2 的 GitHub 仓库中获得。强烈建议通读论文,尤其是第 2.5 节(体内计算视觉实验)与第 2.8 节(多模态集成洞见),可了解此类工具对神经科学研究的潜力。
深度学习课程
学习路径
课程
课程