Lộ trình
Học sâu trong Python
18 giờ
TRIBE v2 (TRImodal Brain Encoder) là một mô hình deep learning ánh xạ các kích thích tự nhiên vào phản ứng fMRI dự đoán của não. Với một đoạn video, tệp âm thanh hoặc một khối văn bản, mô hình xuất ra tín hiệu BOLD dự đoán cho từng trong số 20.484 đỉnh trên bề mặt vỏ não fsaverage5 ở tần số 1 Hz, tức là một dự đoán mỗi giây.
Các dự đoán là cho đối tượng trung bình (không phải não của cá nhân cụ thể), tức đáp ứng trung bình theo nhóm mà TRIBE v2 học được từ 720 người tham gia trên bốn bộ dữ liệu tự nhiên. Dự đoán zero-shot của mô hình vượt trội so với bản ghi fMRI đơn đối tượng trên bộ Human Connectome Project 7T, vốn có chất lượng tín hiệu cao nhất trong tập huấn luyện.
|
Thuộc tính |
Chi tiết |
|
Không gian đầu ra |
20.484 đỉnh vỏ não trên bề mặt fsaverage5 và dự đoán toàn não trên khoảng 70.000 voxel (vỏ não + dưới vỏ) |
|
Độ phân giải thời gian |
1 Hz (khớp với tần số TR của fMRI) |
|
Các phương thức đầu vào |
Video (V-JEPA2-Giant), Âm thanh (Wav2Vec-BERT 2.0), Văn bản (LLaMA 3.2-3B) |
|
Tham số encoder |
~1B tham số có thể học ở lớp tích hợp transformer |
|
Dữ liệu huấn luyện |
1.115 giờ fMRI của 720 đối tượng trên 4 bộ dữ liệu |
|
Khả năng khái quát hóa |
Zero-shot cho đối tượng, nhiệm vụ và ngôn ngữ mới |
|
Giấy phép |
CC-BY-NC 4.0 (nghiên cứu, phi thương mại) |
Mô hình được điều chỉnh từ bài báo A foundation model of vision, audition, and language for in-silico neuroscience, cho thấy TRIBE v2 khôi phục vùng fusiform face area cho khuôn mặt, parahippocampal place area cho cảnh vật, vùng Broca cho cú pháp phức tạp, và mạng ngôn ngữ thiên trái cho lời nói mà không cần dữ liệu fMRI tại thời điểm suy luận.
TRIBE v2 có ba giai đoạn chạy nối tiếp cho mỗi lần suy luận:
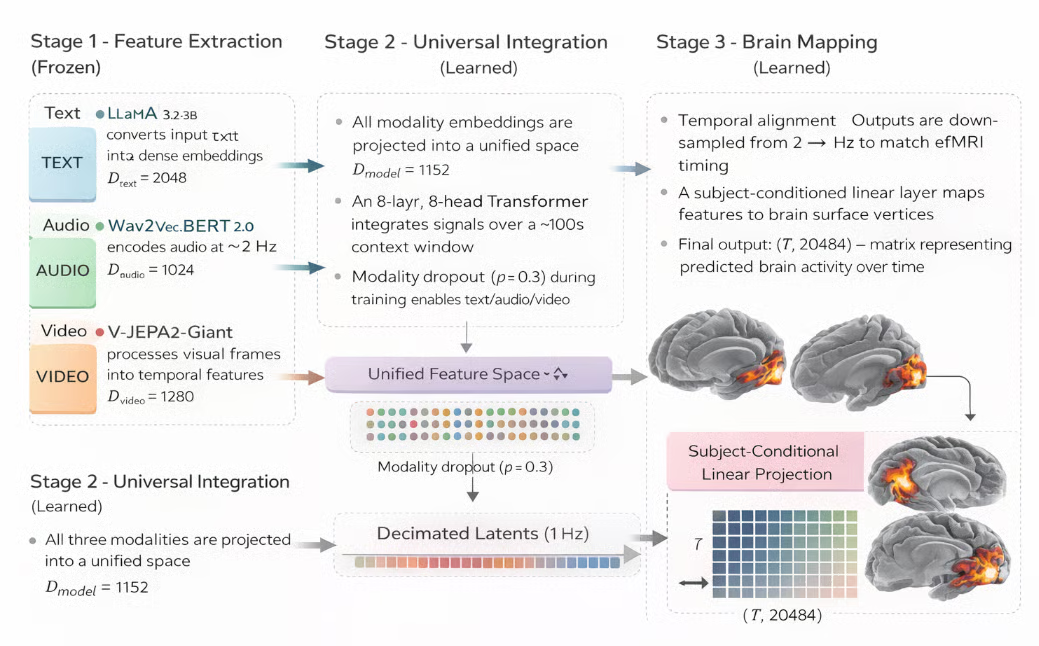
Hình: Mô hình dự đoán hoạt động não TRIBE v2 (Tạo bằng AI)
Đầu tiên, ba encoder đã được tiền huấn luyện xử lý độc lập từng phương thức đầu vào thành các embedding dày, căn chỉnh theo thời gian. Không encoder nào trong số này được cập nhật trong huấn luyện (đóng băng), vì vậy TRIBE v2 kế thừa biểu diễn của chúng nguyên trạng. Một vài chỉ số cho trích xuất đặc trưng theo từng phương thức:
Văn bản: LLaMA 3.2-3B chuyển văn bản đầu vào thành embedding dày (D = 2048)
Âm thanh: Wav2Vec-BERT 2.0 mã hóa tín hiệu âm thanh ở ~2 Hz (D = 1024)
Video: V-JEPA2-Giant xử lý khung hình thành đặc trưng theo thời gian (D = 1280)
Ba luồng embedding được hợp nhất thành một biểu diễn chung và xử lý bởi Transformer chú ý theo thời gian. Đây là nơi chứa trọng số đã học của TRIBE v2 và là nơi ghi nhận tương tác liên phương thức như sau:
Biểu diễn chung: Tất cả embedding phương thức được chiếu vào không gian thống nhất (D_model = 1152)
Hợp nhất bằng Transformer: Transformer 8 lớp, 8 đầu tích hợp tín hiệu qua cửa sổ ngữ cảnh dài (~100s)
Linh hoạt phương thức: Modality dropout (p = 0.3) cho phép suy luận với bất kỳ tập con nào (văn bản/âm thanh/video)
Biểu diễn tiềm ẩn đã hợp nhất được chiếu lên bề mặt vỏ não để tạo ra dự đoán fMRI cuối cùng. Giai đoạn này chuyển các đặc trưng trừu tượng của mô hình thành ước lượng hoạt động não có phân giải theo không gian và thời gian.
Vì ba bộ trích xuất đặc trưng được đóng băng trong huấn luyện, TRIBE v2 chỉ học các lớp chiếu và trọng số transformer tích hợp đầu ra của chúng. Quyết định thiết kế này quan trọng vì nó giúp mô hình vững vàng với kích thích ngoài phân phối, do kế thừa khả năng khái quát của ba mô hình tiền huấn luyện quy mô lớn thay vì huấn luyện end-to-end chỉ trên dữ liệu fMRI.
Lưu ý: Mẹo huấn luyện then chốt là dropout theo phương thức. Trong huấn luyện, mỗi phương thức bị đặt về 0 độc lập với xác suất 0,3. Điều này buộc mô hình phải đưa ra dự đoán có ý nghĩa từ bất kỳ tập con phương thức nào. Vì vậy khi suy luận, bạn có thể chỉ đưa âm thanh hoặc chỉ văn bản và vẫn nhận được dự đoán vỏ não hữu ích.
Trong phần này, chúng ta sẽ xây dựng quy trình tuần tự chạy suy luận TRIBE v2 trên đầu vào văn bản, âm thanh hoặc video và trực quan hóa hoạt động vỏ não dự đoán dưới dạng bản đồ nhiệt não 3D tương tác. Chúng ta cũng sẽ chạy một thí nghiệm so sánh tái lập mô hình in-silico từ bài báo gốc. Cuối cùng, chúng ta sẽ phát triển một ứng dụng Gradio để bất kỳ ai cũng có thể khám phá demo trực tiếp.
Trước khi bắt đầu, hãy cấu hình runtime Colab của bạn. Lưu ý bạn cũng có thể dùng dịch vụ khác với GPU A100 ổn định và RAM cao.
TRIBE v2 nạp đồng thời ba encoder đóng băng, gồm LLaMA 3.2-3B (~7 GB), V-JEPA2-Giant (~14 GB), và Wav2Vec-BERT 2.0 (~1 GB), cùng với trọng số transformer của TRIBE. Tổng dung lượng VRAM là 28–32 GB.
Lưu ý: T4 (16 GB) sẽ thiếu bộ nhớ khi model.predict() nạp LLaMA. Hãy dùng A100 (40 GB) hoặc A100 với High RAM (80 GB) để có hiệu năng tốt hơn.
Xác nhận GPU của bạn trước khi cài đặt bất kỳ thứ gì bằng cách chạy:
import subprocess, sys
result = subprocess.run(
    ['nvidia-smi', '--query-gpu=name,memory.total',
     '--format=csv,noheader,nounits'],
    capture_output=True, text=True)
print(result.stdout.strip())
import torch
assert torch.cuda.is_available(), "No GPU detected"
props = torch.cuda.get_device_properties(0)
assert props.total_memory > 30e9, (
    f"Need ≥40 GB VRAM. Got {props.total_memory/1e9:.0f} GB. Switch to A100.")
print(f"GPU: {props.name} — {props.total_memory/1e9:.0f} GB")
Lệnh subprocess.run() gọi nvidia-smi với cờ --query-gpu để lấy tên GPU và tổng VRAM. Hai câu lệnh assert đóng vai trò dừng sớm; câu đầu xác nhận CUDA khả dụng, câu sau kiểm tra tổng VRAM vượt 30 GB. Thất bại ồn ào ở đây tốt hơn là lỗi hết bộ nhớ CUDA khó hiểu bên trong model.predict() sau 10 phút.
Bỏ qua bước này nếu bạn không chạy trên Google Colab. Đây là lỗi đầu tiên bạn sẽ gặp vì Colab cài sẵn NumPy 2.x theo mặc định. Một số phụ thuộc nội bộ của TRIBE v2, cụ thể là neuralset, được biên dịch với NumPy <2.1, vốn đã loại bỏ ký hiệu _center khỏi numpy._core.umath. Kết quả là lỗi này khi bạn thử import tribev2:
ImportError
cannot import name '_center' from 'numpy._core.umath'
(/usr/local/lib/python3.12/dist-packages/numpy/_core/umath.py)
Cách khắc phục là cố định NumPy <2.1 trước khi cài tribev2 hoặc bất kỳ phụ thuộc nào của nó, rồi khởi động lại runtime. Chỉ cần chạy ô sau, sẽ gỡ cài NumPy hiện tại và thay bằng phiên bản dưới 2.1.
import subprocess, sys
print("Pinning NumPy to <2.1 (required for neuralset compatibility)...")
subprocess.run([sys.executable, '-m', 'pip', 'uninstall', '-y', 'numpy'])
subprocess.run([sys.executable, '-m', 'pip', 'install', '-q',
                'numpy>=1.26.4,<2.1.0'])
Khi môi trường và phụ thuộc đã ổn định, chúng ta có thể tiếp tục cài đặt TRIBE v2.
Sau khi khởi động lại kernel và nạp NumPy đã cố định, ta có thể cài gói tribev2 từ GitHub cùng các thư viện trực quan hóa và UI một cách an toàn.
import numpy as np
from packaging.version import Version
assert Version(np.__version__) < Version('2.1.0'), (
    f"NumPy is {np.__version__}. Run Step 2a and restart first.")
print(f"NumPy {np.__version__} Checked")
# Install tribev2 from GitHub
!pip install -q 'tribev2[plotting] @ git+https://github.com/facebookresearch/tribev2.git'
!pip install -q 'gradio>=4.19.0' 'nilearn>=0.10.3' 'plotly>=5.18.0'
tribev2[plotting] sẽ cài pyvista (thư viện Python cho trực quan hóa 3D) và nilearn (thư viện Python cho ảnh thần kinh) cùng với gói lõi. Cài trực tiếp từ URL GitHub đảm bảo bạn nhận commit mới nhất mà không cần clone kho về máy.
Các gói nilearn và gradio được cài riêng vì ràng buộc phiên bản linh hoạt hơn và có lợi khi giải quyết độc lập với đồ thị phụ thuộc của tribev2.
Encoder văn bản dùng LLaMA 3.2-3B, là mô hình bị giới hạn trên HuggingFace. Bạn cần chấp nhận giấy phép của Meta trước khi có thể tải trọng số. Thực hiện một lần:
Khi đã đặt HF token, chạy đoạn mã sau để đăng nhập tài khoản:
import os
# Load token from Colab Secrets
try:
    from google.colab import userdata
    os.environ['HF_TOKEN'] = userdata.get('HF_TOKEN')
    print("HF_TOKEN loaded from Colab Secrets")
except Exception:
    from huggingface_hub import login
    login()
Ưu tiên dùng google.colab.userdata.get(), đọc từ kho Secrets mã hóa của Colab, không thể vô tình lộ ra khi chia sẻ notebook.
Phương án dự phòng gọi huggingface_hub.login(), nhắc nhập tương tác và che token khi gõ. Cả hai cách đều ghi token vào os.environ['HF_TOKEN'], và thư viện HuggingFace Hub sẽ tự động sử dụng khi tải trọng số mô hình bị giới hạn.
Khi đã cố định NumPy, cấu hình xác thực và cache LLaMA, ta có thể nạp checkpoint encoder TRIBE v2 từ HuggingFace. Lần đầu tải khoảng 1 GB và các lần sau chỉ mất vài giây từ cache.
from pathlib import Path
from tribev2.demo_utils import TribeModel
import torch
CACHE_DIR = Path('/content/tribe_cache')
CACHE_DIR.mkdir(exist_ok=True)
print('Loading TRIBE v2 (first run downloads ~1 GB)...')
model = TribeModel.from_pretrained(
    'facebook/tribev2',
    cache_folder=str(CACHE_DIR)
)
print('Model loaded')
if torch.cuda.is_available():
    used  = torch.cuda.memory_allocated() / 1e9
    total = torch.cuda.get_device_properties(0).total_memory / 1e9
    print(f'VRAM after load: {used:.1f} / {total:.1f} GB')
TribeModel.from_pretrained() tải checkpoint encoder TRIBE từ facebook/tribev2 trên HuggingFace và lưu vào cache_folder. Checkpoint này chứa trọng số tích hợp transformer và khối chủ thể, nhưng không gồm ba bộ trích xuất đặc trưng. Chúng sẽ được tải riêng khi model.predict() lần đầu dùng mỗi phương thức.
Sau khi chỉ nạp encoder TRIBE, khoảng 2–4 GB VRAM được cấp phát; phần còn lại 24–28 GB sẽ tiêu thụ khi model.predict() lần đầu nạp V-JEPA2-Giant và LLaMA 3.2-3B.
Sau khi tải mô hình TRIBE, lần đầu gọi model.predict() với văn bản sẽ kích hoạt việc tải lười trọng số LLaMA 3.2-3B (~6 GB). Mặc định timeout của HuggingFace Hub là 10 giây, gây lỗi giữa chừng:
ReadTimeout
The read operation timed out
Computing word embeddings:  0%|  | 0/9 [00:10<?, ?it/s]
Khắc phục bằng cách tăng biến môi trường timeout, rồi tải trước LLaMA rõ ràng bằng snapshot_download để có tiến độ hiển thị và tự động tiếp tục nếu gián đoạn, thay vì lỗi âm thầm bên trong predict().
import os
os.environ['HF_HUB_DOWNLOAD_TIMEOUT'] = '300'
os.environ['HF_HUB_HTTP_TIMEOUT']     = '300'
from huggingface_hub import snapshot_download
print("Pre-downloading LLaMA 3.2-3B (~6 GB)...")
print("Runs once — subsequent calls load from cache.\n")
snapshot_download(
    repo_id        = "meta-llama/Llama-3.2-3B",
    cache_dir      = "/content/tribe_cache/llama",
    ignore_patterns= ["*.bin"],
)
print("\n LLaMA 3.2-3B cached")
snapshot_download() tải toàn bộ kho về cache cục bộ bằng giao thức range-request của HuggingFace, nghĩa là sẽ tự nối lại nếu rớt kết nối giữa chừng. Tham số ignore_patterns=["*.bin"] bỏ qua định dạng nhị phân PyTorch cũ và chỉ tải tệp safetensors, giúp giảm khoảng 40% dung lượng tải.
Trước khi chạy suy luận thực, ta thiết lập lớp trực quan hóa. Các hàm trợ giúp này chuyển mảng dự đoán thô (T, 20484) thành bản đồ nhiệt não 3D tương tác bằng nilearn.
TRIBE v2 trả về dự đoán là mảng NumPy có dạng (T, 20484), trong đó T là số giây của đầu vào. 10.242 đỉnh đầu thuộc bán cầu trái, số còn lại thuộc bán cầu phải.
Chúng ta dùng nilearn.plotting.view_surf để vẽ mỗi bán cầu dưới dạng bề mặt WebGL tương tác. Lưới inflated phơi bày hình học rãnh não vốn bị che trong các nếp gấp, và bản đồ độ sâu rãnh cho tham chiếu giải phẫu dưới lớp bản đồ nhiệt.
Lưới fsaverage5 là mẫu vỏ não FreeSurfer tiêu chuẩn mà TRIBE v2 dùng làm không gian đầu ra. Chúng ta tải một lần tại đây để các lần trực quan hóa sau có thể tham chiếu mà không cần tải lại qua mạng.
import numpy as np
from nilearn import datasets as nl_datasets
from nilearn.plotting import view_surf
from IPython.display import display, HTML
N_PER_HEMI = 10242   # fsaverage5: 10242 vertices per hemisphere
print('Fetching fsaverage5 mesh...')
fsavg = nl_datasets.fetch_surf_fsaverage(mesh='fsaverage5')
print('Mesh ready')
print('Keys:', [k for k in fsavg.keys() if k != 'description'])
Hàm fetch_surf_fsaverage(mesh='fsaverage5') tải mẫu FreeSurfer fsaverage5 từ CDN của nilearn và lưu cache. Nó trả về một đối tượng Bunch (từ điển) với các khóa như infl_left, infl_right, sulc_left và sulc_right.
Tiểu bước này định nghĩa ba hàm cốt lõi mà toàn bộ trực quan hóa trong hướng dẫn phụ thuộc vào. Hàm split_hemis() chia mảng đỉnh, render_hemi() dựng bề mặt WebGL tương tác cho một bán cầu, và show_brain() ghép hai bán cầu cạnh nhau.
def split_hemis(v):
    n = v.shape[0]
    if n == 2 * N_PER_HEMI:
        return v[:N_PER_HEMI], v[N_PER_HEMI:]
    return v[:n//2], v[n//2:]
def render_hemi(pred_vec, hemi='left', title=''):
    lh, rh = split_hemis(pred_vec)
    data = lh if hemi == 'left' else rh
    vmax = max(float(np.percentile(np.abs(data), 99)), 1e-6)
    return view_surf(
        surf_mesh = fsavg[f'infl_{hemi}'],
        surf_map  = data,
        bg_map    = fsavg[f'sulc_{hemi}'],
        hemi      = hemi,
        threshold = '20%',
        cmap      = 'hot',
        black_bg  = True,
        vmax      = vmax,
        bg_on_data= True,
        colorbar  = True,
        title     = title,
    )
def show_brain(pred_vec, title='', t=None):
    sfx = f' — t={t}s' if t is not None else ''
    lv  = render_hemi(pred_vec, 'left',  f'{title} [Left]{sfx}')
    rv  = render_hemi(pred_vec, 'right', f'{title} [Right]{sfx}')
    html = (
        '<div style="display:flex;gap:10px;background:#000;'
        'border-radius:10px;">'
        f'<div style="flex:1">{lv.get_iframe(width="100%",height="460px")}</div>'
        f'<div style="flex:1">{rv.get_iframe(width="100%",height="460px")}</div>'
        '</div>'
    )
    display(HTML(html))
Hãy hiểu chi tiết chức năng của từng hàm trợ giúp:
Hàm split_hemis() cắt vector dự đoán tại chỉ số 10.242, là điểm tách chuẩn cho lưới fsaverage5 theo quy ước của FreeSurfer. Bán cầu trái chiếm chỉ số 0–10241 và bán cầu phải 10242–20483. Nhánh dự phòng dưới cùng xử lý trường hợp số lượng đỉnh không chuẩn.
Bên trong render_hemi(), vmax được tính là bách phân vị 99 của trị tuyệt đối thay vì giá trị lớn nhất thực. Điều này ngăn một đỉnh cực trị làm sập dải màu, giúp mẫu không gian nhìn rõ hơn.
Hàm view_surf() trả về đối tượng SurfaceView chứa 2,4 MB HTML WebGL tự chứa. Lời gọi get_iframe() bọc nó trong thẻ <iframe> theo kích thước cho trước. Vì vậy khi gọi display(HTML(...)) với hai iframe cạnh nhau, nó tạo bố cục tách trái/phải.
Khi mô hình đã nạp và các trợ giúp trực quan hóa sẵn sàng, ta có thể chạy suy luận đầu tiên.
Suy luận của TRIBE v2 gồm hai bước. Trước hết, model.get_events_dataframe() trích xuất các sự kiện căn chỉnh thời gian từ đầu vào, cùng thời điểm từ cho văn bản, embedding Wav2Vec ở 2 Hz cho âm thanh, hoặc embedding V-JEPA2 ở 2 Hz từ khung hình video.
DataFrame sự kiện kết quả được truyền vào model.predict(), nơi chạy transformer và khối chủ thể để tạo ra dự đoán vỏ não cuối cùng.
import tempfile, os
SAMPLE_TEXT = '''
The brain processes language through a distributed network in the left hemisphere.
Broca's area coordinates syntactic structure, while Wernicke's area handles semantics.
Together they form the language circuit activated when reading or hearing speech.
'''
tmp = tempfile.NamedTemporaryFile(delete=False, suffix='.txt', mode='w')
try:
    tmp.write(SAMPLE_TEXT.strip())
    tmp.flush()
    os.fsync(tmp.fileno())
    tmp.close()
    events = model.get_events_dataframe(text_path=tmp.name)
finally:
    if os.path.exists(tmp.name):
        os.unlink(tmp.name)
print(f'Events: {events.shape}')
print(events[['type', 'start', 'duration']].head(8))
print('\nRunning model.predict()...')
preds, segments = model.predict(events=events)
preds = np.asarray(preds)
print(f'Prediction shape: {preds.shape}')
print(f'  T = {preds.shape[0]}s   (1 Hz fMRI frequency)')
print(f'  V = {preds.shape[1]} vertices  (fsaverage5 cortical surface)')
Trình tự ghi tmp.write(), tmp.flush(), os.fsync(tmp.fileno()), tmp.close() là bản vá quan trọng cho lỗi tinh vi. Nếu bạn gọi get_events_dataframe() bên trong khối with trước khi đóng tệp, bộ đệm ghi nội bộ của Python có thể chưa đồng bộ xuống hệ điều hành, và tribev2 sẽ đọc tệp rỗng và báo ValueError. Lời gọi os.fsync() đảm bảo bộ nhớ đệm trang của OS được ghi ra đĩa trước khi tribev2 mở đường dẫn.
Hàm model.predict() trả về bộ (preds, segments). Mảng preds có dạng (T, 20484), một dự đoán vỏ não mỗi giây đầu vào trên tất cả 20.484 đỉnh fsaverage5. Bọc trong np.asarray() đảm bảo nó là mảng NumPy thuần bất kể kiểu nội bộ. Khi đã có preds, bạn có thể trực quan hóa đáp ứng vỏ não ở bất kỳ thời điểm nào:
T = preds.shape[0]
print(f'Timesteps: 0 to {T-1}')
T_SHOW = min(5, T - 1)
show_brain(preds[T_SHOW], title='Language stimulus', t=T_SHOW)
Mặc định t=5 vì tín hiệu BOLD (Blood-Oxygen-Level-Dependent) có độ trễ huyết động, và đáp ứng mạch máu với hoạt động thần kinh đạt đỉnh khoảng 5–6 giây sau khi kích thích bắt đầu. Trực quan hóa tại t=0 cho kích hoạt gần như bằng 0 bất kể nội dung kích thích, vì đáp ứng mạch máu của não chưa tích lũy. Phần bảo vệ min(5, T-1) ngăn lỗi chỉ mục khi đầu vào tạo ít hơn 6 bước thời gian.
Một bản đồ kích hoạt đơn cho biết vùng nào hoạt động, nhưng không cho biết điều gì làm một kích thích khác với kích thích khác. Bước này chạy hai đầu vào qua mô hình và tính bản đồ tương phản (A − B) để cô lập khác biệt theo vùng giữa nội dung ngôn ngữ và nội dung thị giác/không gian.
Thay vì lặp lại mẫu write -> flush -> close -> infer cho từng điều kiện, ta gói vào một hàm text_to_preds(). Điều này đảm bảo các bước ghi-đồng-bộ tệp quan trọng không bị bỏ sót cho bất kỳ điều kiện nào.
TEXT_A = '''
She spoke slowly and clearly, her voice filling the quiet room.
Every sentence carried meaning, and each word was chosen with care.
Language connects us, the professor said, bridging minds across time.
'''
TEXT_B = '''
The canyon walls rose steeply, layers of red and orange sandstone.
A hawk circled overhead, its wings barely moving in the thermal current.
Shadows shifted as the sun tracked its arc across the open desert sky.
'''
def text_to_preds(text):
    tmp = tempfile.NamedTemporaryFile(
        delete=False, suffix='.txt', mode='w', encoding='utf-8')
    try:
        tmp.write(text.strip())
        tmp.flush()
        os.fsync(tmp.fileno())
        tmp.close()
        evts = model.get_events_dataframe(text_path=tmp.name)
        p, _ = model.predict(events=evts)
        return np.asarray(p)
    finally:
        if os.path.exists(tmp.name):
            os.unlink(tmp.name)
print('Condition A: language content...')
preds_a = text_to_preds(TEXT_A)
print('Condition B: visual/spatial content...')
preds_b = text_to_preds(TEXT_B)
Chúng ta dùng hai đoạn văn bản có nội dung ngữ nghĩa khác biệt, với kỳ vọng nội dung ngôn ngữ kích hoạt vỏ thái dương bán cầu trái mạnh hơn, trong khi nội dung thị giác/không gian huy động vỏ chẩm và vỏ đỉnh sau mạnh hơn.
Hàm text_to_preds() đóng gói toàn bộ pipeline vào một hàm tái sử dụng, áp dụng mẫu an toàn từ Bước 8 để tệp tạm luôn được ghi hoàn toàn trước khi tribev2 đọc. Tham số encoding='utf-8' được nêu rõ để tránh vấn đề mã hóa phụ thuộc nền tảng.
Khi cả hai điều kiện đã được dự đoán, ta trực quan hóa từng điều kiện riêng lẻ rồi trừ đỉnh-theo-đỉnh để tạo bản đồ tương phản.
T_shared = min(preds_a.shape[0], preds_b.shape[0])
t_show   = min(5, T_shared - 1)
print('\n[A] Language content:')
show_brain(preds_a[t_show], title='Condition A: Language', t=t_show)
print('\n[B] Visual/spatial content:')
show_brain(preds_b[t_show], title='Condition B: Visual', t=t_show)
print('\n[A − B] Contrast: Language > Visual')
show_brain(preds_a[t_show] - preds_b[t_show], title='Contrast A − B', t=t_show)
Bản đồ tương phản preds_a[t_show] - preds_b[t_show] là phép trừ từng đỉnh trực tiếp, trong đó giá trị dương chỉ vùng điều kiện A kích hoạt mạnh hơn, và âm chỉ vùng điều kiện B mạnh hơn.
Vì cả hai điều kiện dùng chung đường xử lý văn bản, các bản đồ thô sẽ nhìn chung tương tự. Bản đồ tương phản nêu bật khác biệt theo lĩnh vực giữa nội dung ngôn ngữ và thị giác.
Các bản đồ nhiệt não cho thấy mẫu không gian tại một thời điểm. Bước này bổ sung góc nhìn thời gian: tổng thể kích hoạt so giữa các điều kiện ra sao theo từng giây, và khi nào hai điều kiện phân kỳ mạnh nhất?
import matplotlib.pyplot as plt
diff_norms = [
    np.linalg.norm(preds_a[i] - preds_b[i])
    for i in range(T_shared)
]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 3.5))
ax1.plot(np.abs(preds_a).mean(axis=1)[:T_shared],
         color='#e74c3c', linewidth=2, label='A: Language')
ax1.plot(np.abs(preds_b).mean(axis=1)[:T_shared],
         color='#3498db', linewidth=2, label='B: Visual')
ax1.set_title('Mean cortical activation over time')
ax1.set_xlabel('Time (s)'); ax1.legend(); ax1.grid(True, alpha=0.3)
ax2.plot(diff_norms, color='#f39c12', linewidth=2)
ax2.fill_between(range(T_shared), diff_norms, alpha=0.2, color='#f39c12')
ax2.set_title('||A − B|| difference over time')
ax2.set_xlabel('Time (s)'); ax2.grid(True, alpha=0.3)
plt.tight_layout(); plt.show()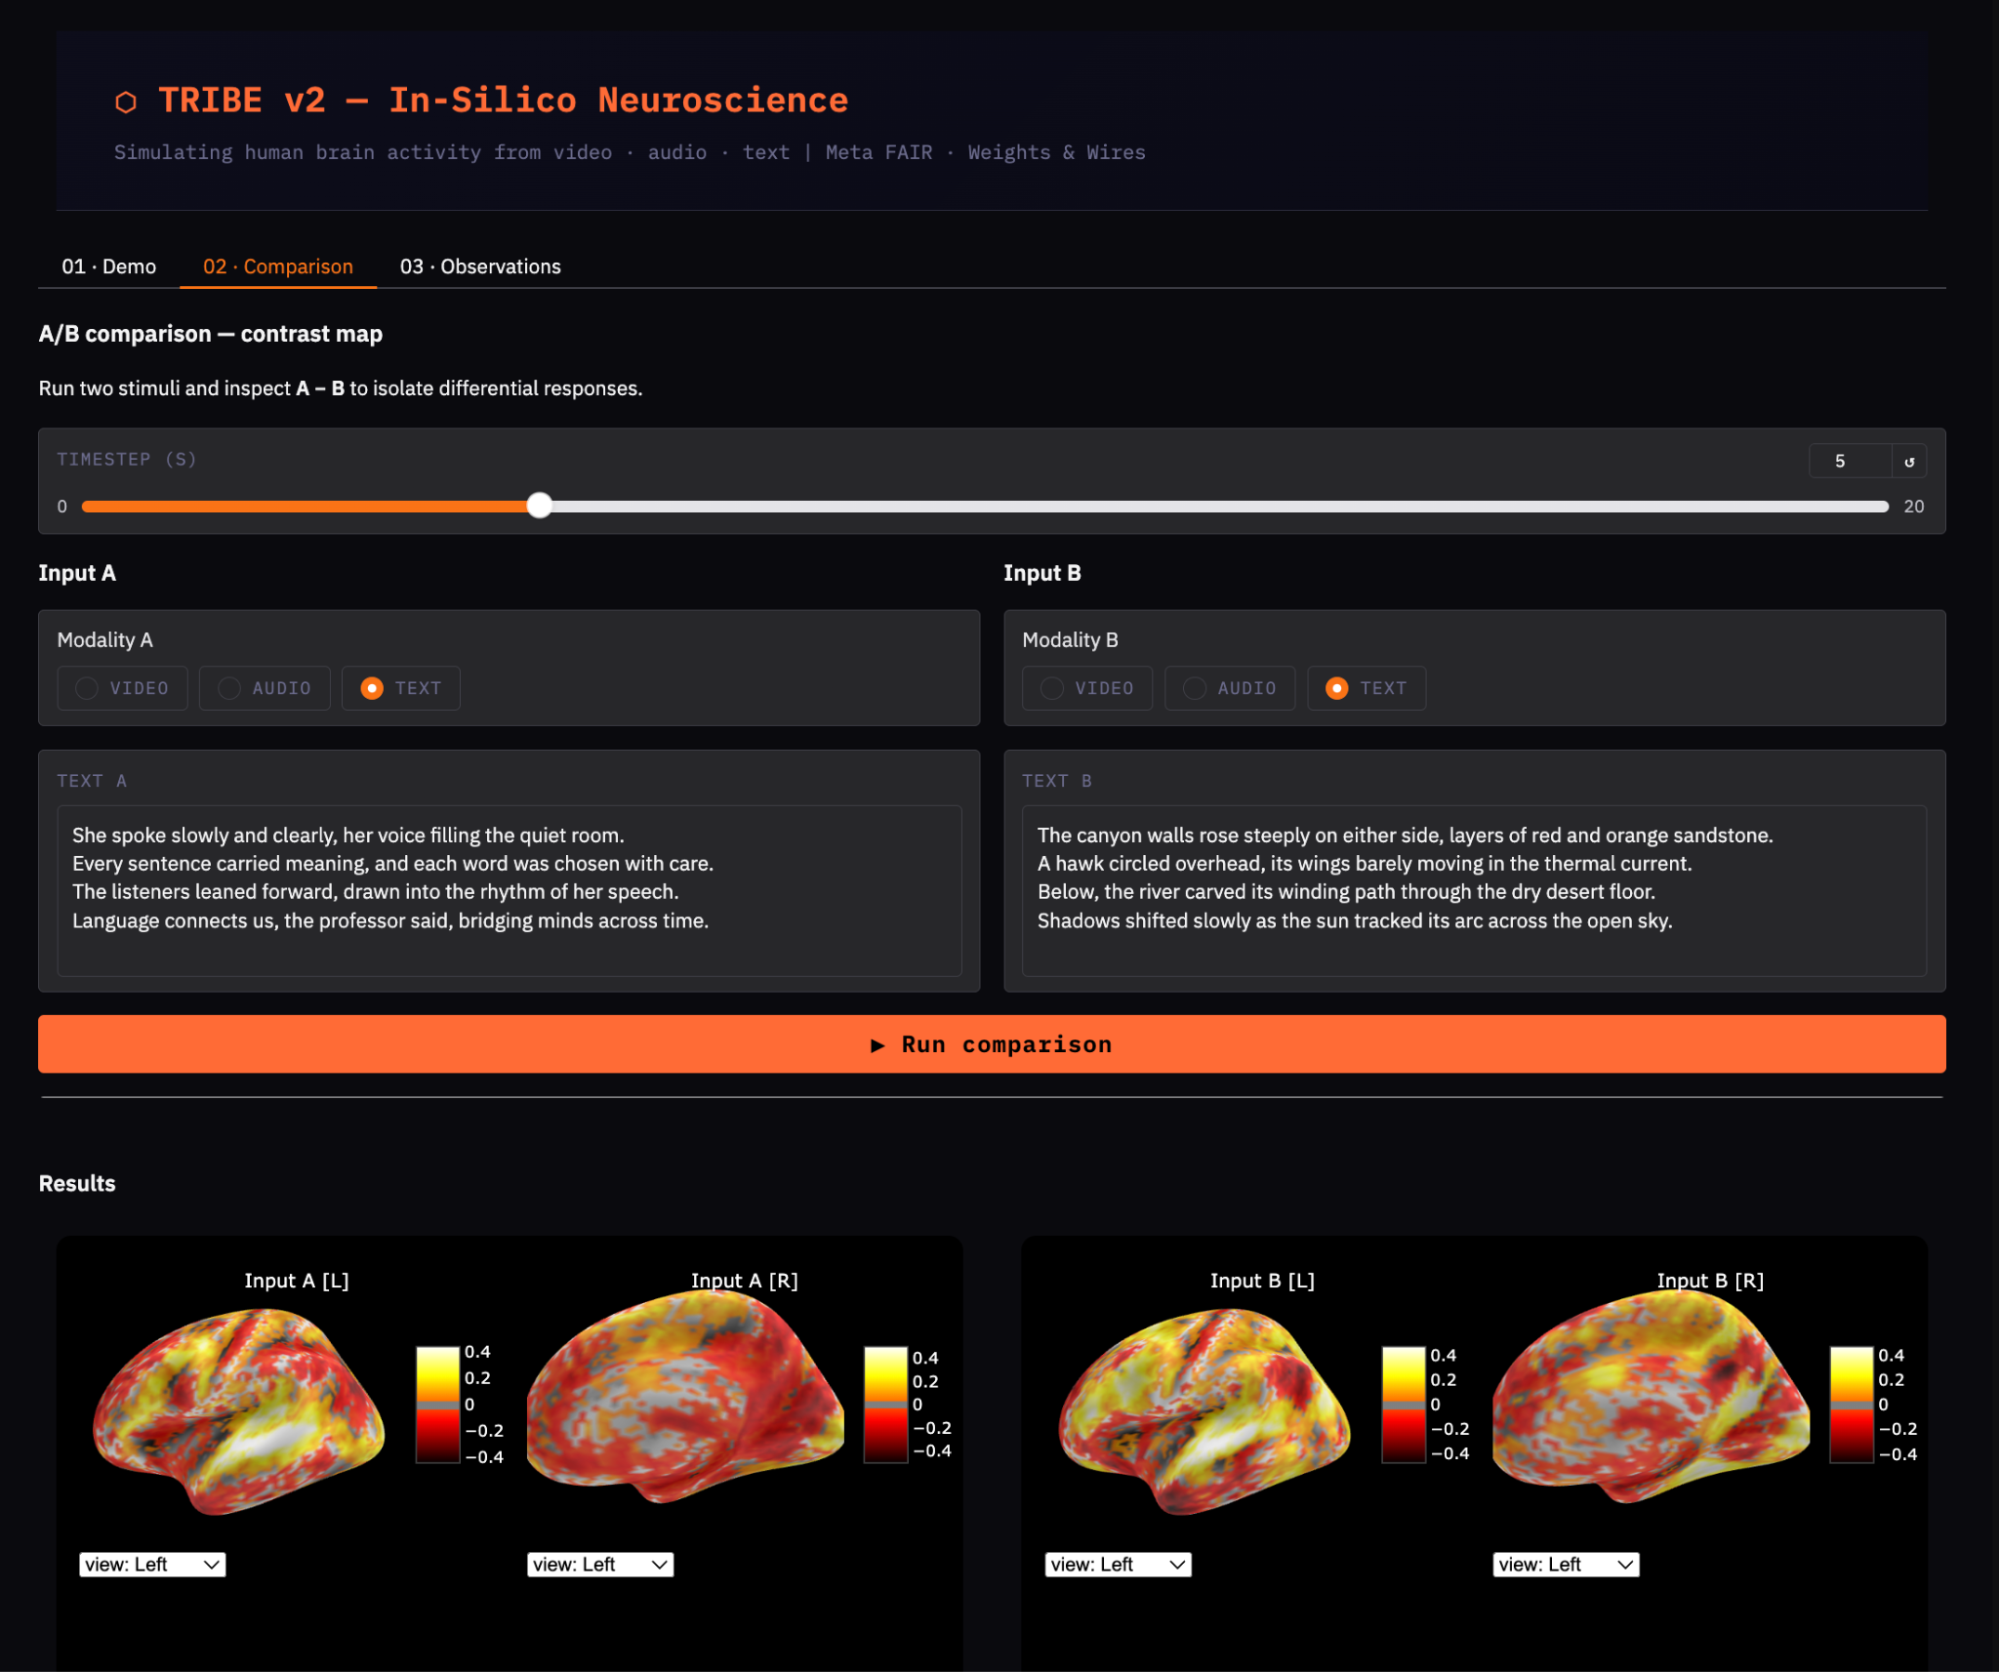
Biểu đồ trái theo dõi np.abs(preds).mean(axis=1), tức giá trị kích hoạt tuyệt đối trung bình gộp trên 20.484 đỉnh tại mỗi giây. Điều này cho thấy mức độ mỗi điều kiện huy động vỏ não và khi nào đáp ứng đạt đỉnh. Lấy trị tuyệt đối là quan trọng vì giá trị BOLD dự đoán có thể âm (khử hoạt), và ta quan tâm độ lớn thay vì trung bình có dấu.
Biểu đồ phải theo dõi chuẩn L2 của vector khác biệt tại mỗi bước thời gian, np.linalg.norm(preds_a[i] - preds_b[i]). Đỉnh quanh t=5–7s phù hợp độ trễ huyết động: cả hai điều kiện cần thời gian để đáp ứng BOLD xây dựng trước khi phân kỳ. Vùng tô fill_between() giúp rõ ràng thời điểm khởi phát và đỉnh phân kỳ.
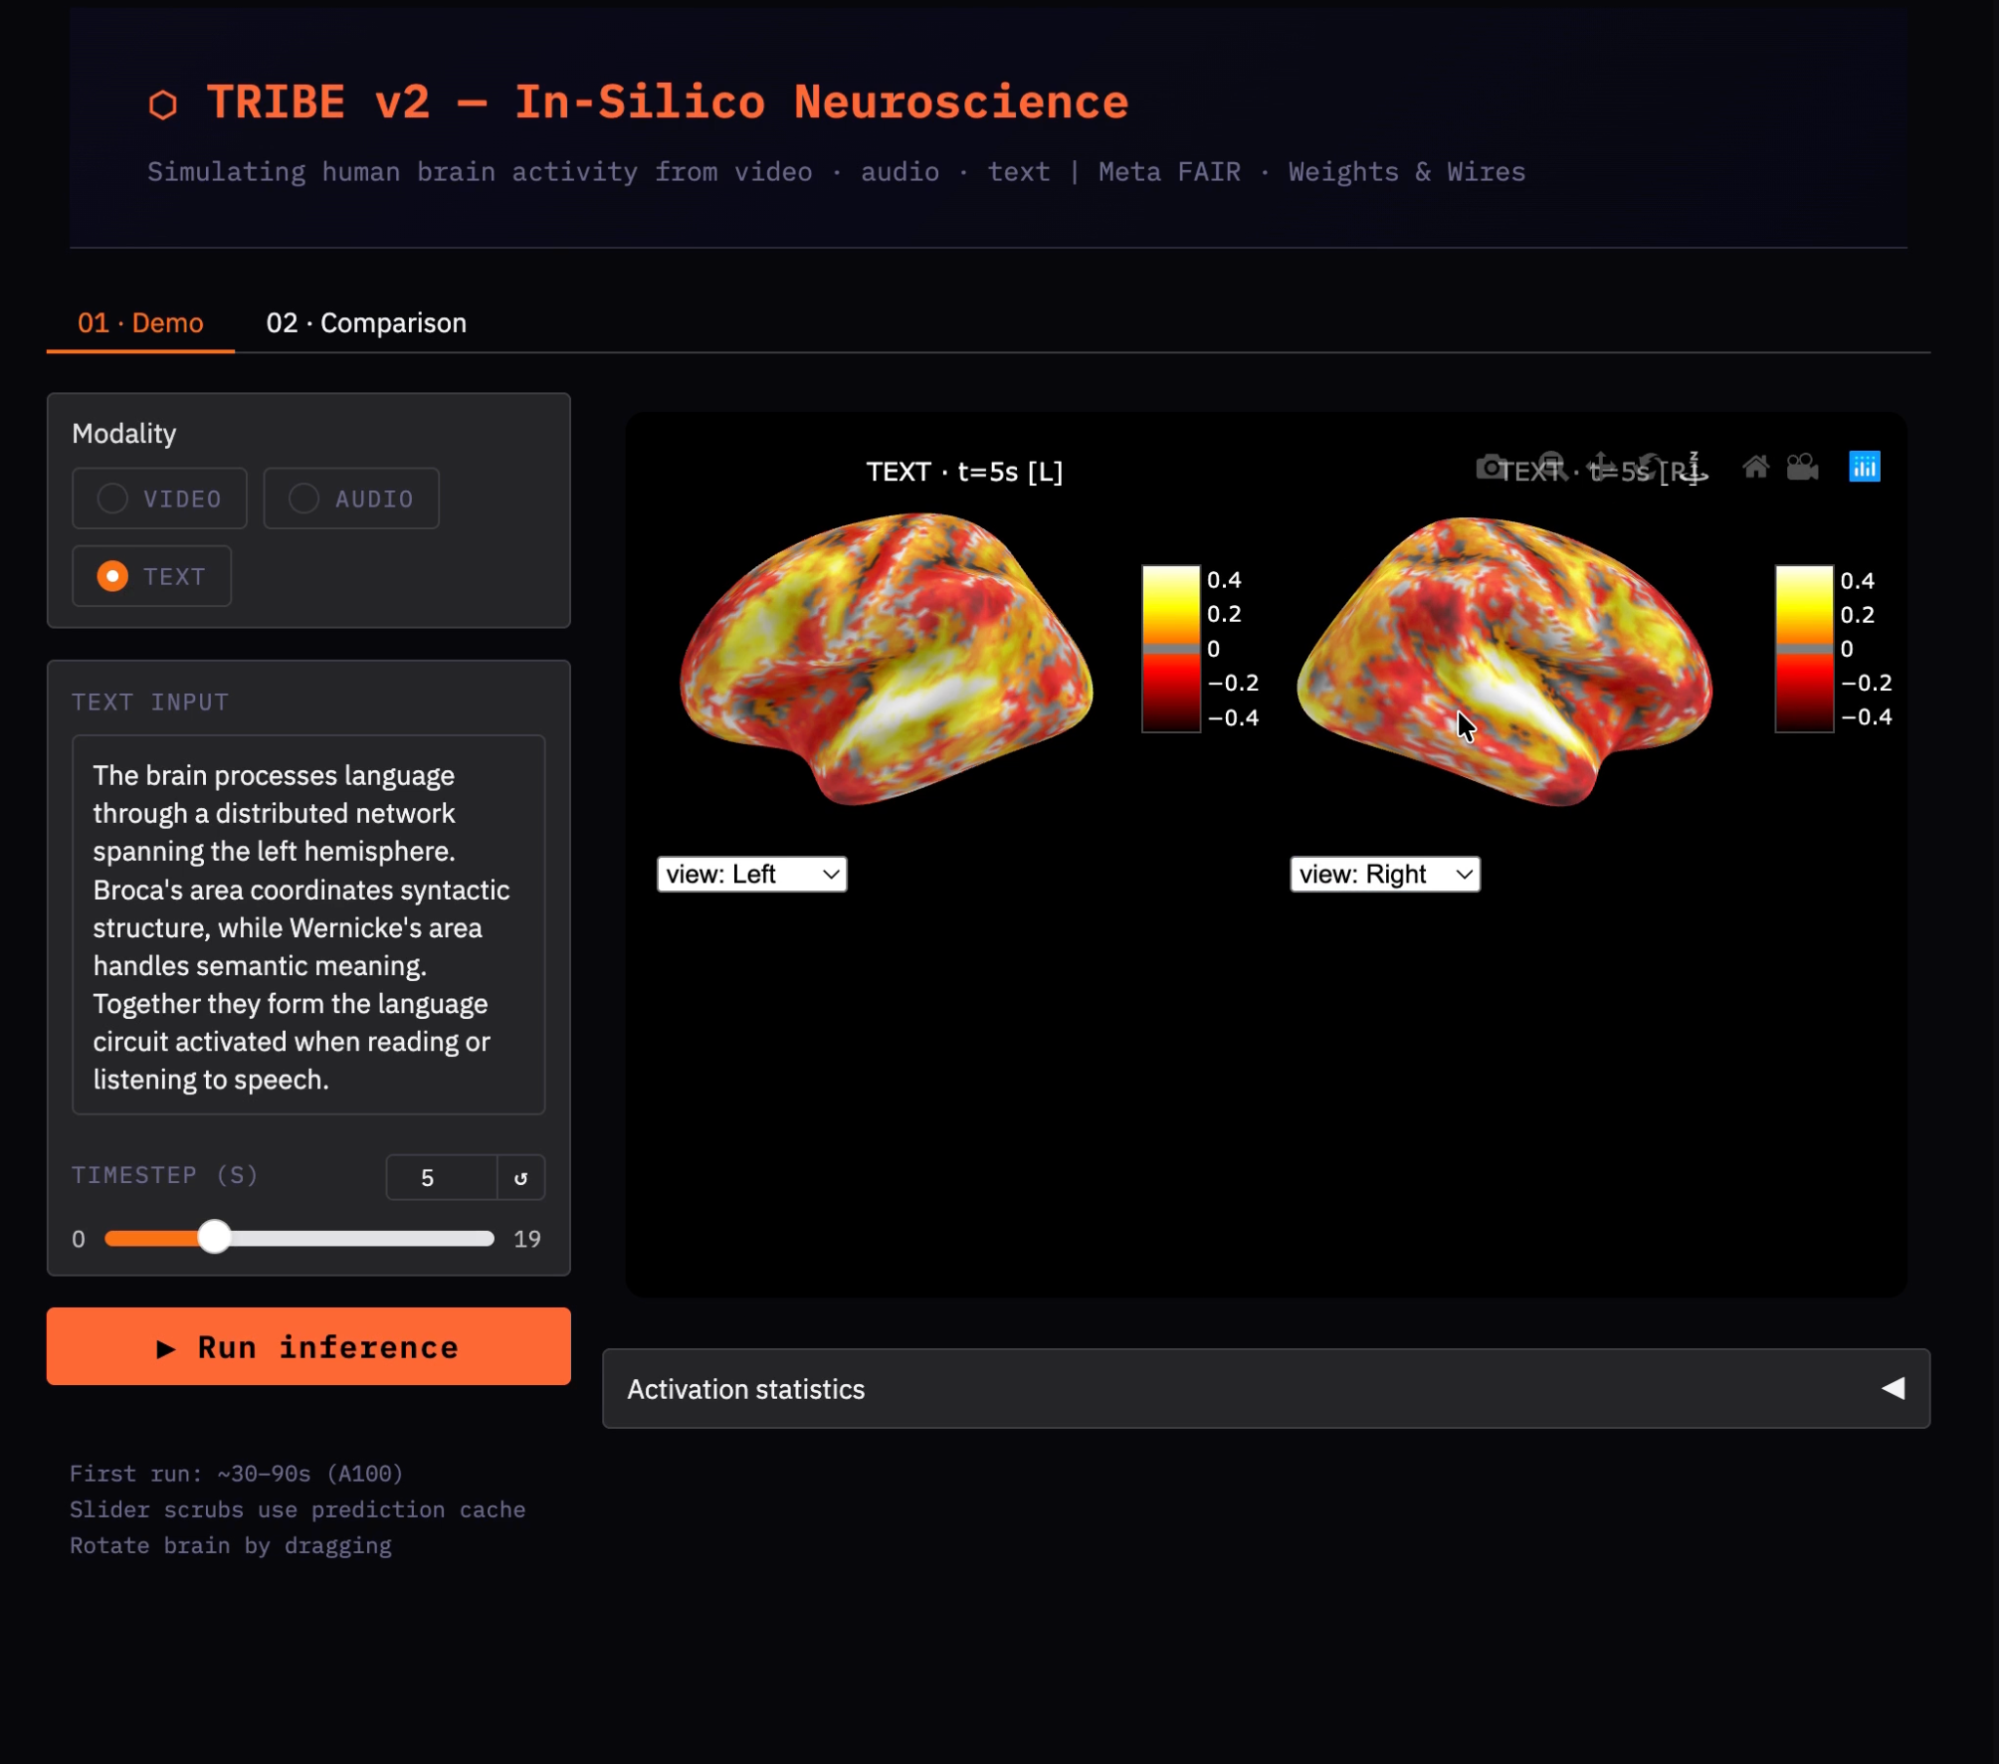
Bước cuối bọc logic suy luận và trực quan hóa vào ứng dụng Gradio với UI gọn gàng, thanh trượt thời điểm và thẻ so sánh A/B.
import gradio as gr
_pred_cache = {}
def _infer(mod, vid, aud, txt):
    """Run inference and cache the result. Subsequent calls return cached array."""
    key = (mod, vid, aud, hash(txt or ''))
    if key not in _pred_cache:
        if mod == 'video':
            evts = model.get_events_dataframe(video_path=vid)
        elif mod == 'audio':
            evts = model.get_events_dataframe(audio_path=aud)
        else:
            tmp = tempfile.NamedTemporaryFile(delete=False, suffix='.txt', mode='w')
            tmp.write((txt or '').strip()); tmp.flush()
            os.fsync(tmp.fileno()); tmp.close()
            evts = model.get_events_dataframe(text_path=tmp.name)
            os.unlink(tmp.name)
        p, _ = model.predict(events=evts)
        _pred_cache[key] = np.asarray(p)
    return _pred_cache[key]
demo.launch(
    share      = True,
    debug      = False,
    server_name= "0.0.0.0",
)
Cách UI Gradio và pipeline suy luận kết hợp với nhau như sau:
Hàm _infer() đóng vai trò lớp suy luận trung tâm, xử lý cả ba phương thức (video, âm thanh, văn bản) bằng cách chuẩn bị đầu vào, gọi model.predict() và trả về hoạt động não dự đoán.
Bộ nhớ đệm dự đoán lưu kết quả dựa trên khóa gồm phương thức, đường dẫn đầu vào và băm của văn bản. Điều này đảm bảo đầu vào giống hệt không kích hoạt suy luận lại.
Bộ đệm là thiết yếu vì các thành phần UI như thanh trượt gọi callback thường xuyên. Không có cache, mỗi tương tác sẽ chạy lại suy luận (mất tới ~60 giây), còn có cache thì trả kết quả tức thì sau lần đầu.
Giao diện có hai thẻ: chế độ một đầu vào với thanh trượt thời điểm để khám phá hoạt động theo thời gian, và chế độ so sánh chạy hai đầu vào và trực quan hóa chênh lệch dưới dạng bản đồ nhiệt tương phản.
Cuối cùng, demo.launch() được cấu hình share=True để tạo URL công khai và server_name="0.0.0.0" cho phép truy cập bên ngoài, giúp ứng dụng dễ triển khai.
Sau khi chạy demo trên nhiều đầu vào (video, âm thanh, văn bản), một vài mẫu nhất quán xuất hiện, giúp diễn giải đầu ra của TRIBE v2. Một số nhận định:
Mô hình không tuyên bố chính xác 100% và cũng có những hạn chế riêng:
TRIBE v2 là công cụ nghiên cứu mạnh mẽ, nhưng có những ràng buộc quan trọng ảnh hưởng cách diễn giải đầu ra. Hiểu các giới hạn này là điều thiết yếu trước khi rút ra kết luận khoa học hay lâm sàng từ dự đoán.
Trong hướng dẫn này, chúng ta đã xây dựng pipeline TRIBE v2 hoạt động trên Google Colab A100: từ giải quyết hai lỗi cụ thể (xung đột phiên bản NumPy 2.x và timeout tải xuống HuggingFace) đến chạy dự đoán vỏ não thực, trực quan hóa chúng thành bản đồ nhiệt não 3D tương tác và chạy thí nghiệm so sánh tái lập mô hình in-silico của bài báo.
Bốn bài học kỹ thuật quan trọng nhất từ hướng dẫn này:
Cố định NumPy <2.1 và khởi động lại runtime trước khi cài tribev2
Đặt HF_HUB_DOWNLOAD_TIMEOUT=300 và tải trước LLaMA với snapshot_download trước khi gọi model.predict()
Luôn ghi → flush() → fsync() → close() tệp tạm trước khi truyền đường dẫn cho mô hình
Lưu cache dự đoán trong từ điển, để tương tác thanh trượt UI không chạy lại suy luận.
Từ đây, có hai hướng mở rộng tự nhiên. Thứ nhất là kích thích phong phú hơn: đoạn phim hay podcast dài 30–60 giây cho động học thời gian và mẫu không gian rõ ràng hơn nhiều so với đoạn văn ngắn.
Thứ hai là fine-tune cá nhân: với ~1 giờ fMRI của một đối tượng cụ thể, khối chủ thể của TRIBE v2 có thể fine-tune trong một epoch để tạo dự đoán cá nhân hóa vượt mô hình trung bình nhóm 2–4 lần theo kết quả bài báo.
Toàn bộ notebook có trên kho GitHub TRIBE v2. Bài báo rất đáng đọc đầy đủ, đặc biệt Mục 2.5 (thí nghiệm thị giác in-silico) và Mục 2.8 (nhận định tích hợp đa phương thức), cho thấy loại công cụ này mở ra điều gì cho nghiên cứu thần kinh học.
Khóa học Deep Learning
Lộ trình
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
