Cursus
Apprentissage profond en Python
18 h
TRIBE v2 (TRImodal Brain Encoder) est un modèle d’apprentissage profond qui associe des stimuli naturalistes à des réponses cérébrales IRMf prédites. À partir d’un extrait vidéo, d’un fichier audio ou d’un bloc de texte, le modèle produit un signal BOLD prédit pour chacun des 20 484 sommets de la surface corticale fsaverage5 à 1 Hz, soit une prédiction par seconde.
Les prédictions correspondent à un sujet moyen (pas à un cerveau individuel), c’est-à-dire à la réponse canonique moyenne de groupe apprise par TRIBE v2 à partir de 720 participants sur quatre jeux de données naturalistes. Les prédictions zero-shot du modèle surpassent les enregistrements IRMf mono-sujet du jeu de données 7T du Human Connectome Project, qui présente la meilleure qualité de signal de l’ensemble d’entraînement.
|
Propriété |
Détail |
|
Espace de sortie |
20 484 sommets corticaux sur la surface fsaverage5 et prédictions à l’échelle du cerveau pour environ 70 000 voxels (cortex + sous-cortex) |
|
Résolution temporelle |
1 Hz (correspond à la fréquence TR de l’IRMf) |
|
Modalités d’entrée |
Vidéo (V-JEPA2-Giant), Audio (Wav2Vec-BERT 2.0), Texte (LLaMA 3.2-3B) |
|
Paramètres de l’encodeur |
~1 milliard de paramètres apprenables dans la couche d’intégration par Transformer |
|
Données d’entraînement |
1 115 heures d’IRMf sur 720 sujets et 4 jeux de données |
|
Généralisation |
Zero-shot vers de nouveaux sujets, tâches et langues |
|
Licence |
CC-BY-NC 4.0 (usage de recherche, non commercial) |
Le modèle est adapté de l’article A foundation model of vision, audition, and language for in-silico neuroscience, qui montre que TRIBE v2 retrouve l’aire fusiforme des visages pour les visages, l’aire parahippocampique des lieux pour les scènes, l’aire de Broca pour la syntaxe complexe et le réseau linguistique latéralisé à gauche pour la parole, sans aucune donnée IRMf au moment de l’inférence.
TRIBE v2 comporte trois étapes exécutées en séquence à chaque appel d’inférence :
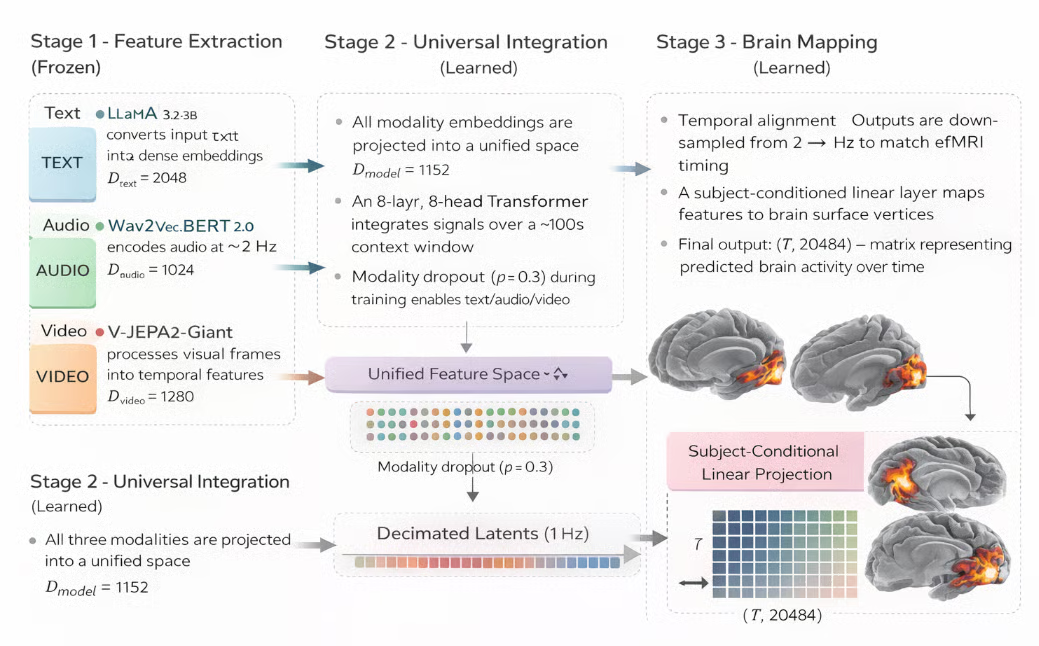
Figure : modèle de prédiction de l’activité cérébrale TRIBE v2 (généré par IA)
Trois encodeurs préentraînés distincts traitent indépendamment chaque modalité d’entrée en embeddings denses et alignés temporellement. Aucun de ces encodeurs n’est mis à jour pendant l’entraînement (ils sont gelés), TRIBE v2 hérite donc de leurs représentations telles quelles. Voici quelques métriques d’extraction de caractéristiques pour chaque modalité :
Texte : LLaMA 3.2-3B convertit le texte d’entrée en embeddings denses (D = 2048)
Audio : Wav2Vec-BERT 2.0 code les signaux audio à ~2 Hz (D = 1024)
Vidéo : V-JEPA2-Giant transforme les images en caractéristiques temporelles (D = 1280)
Les trois flux d’embeddings sont fusionnés en une représentation partagée unique et traités par un Transformer qui prête attention au temps. C’est ici que résident les poids appris de TRIBE v2 et où les interactions inter-modales sont capturées comme suit :
Représentation partagée : toutes les embeddings de modalités sont projetées dans un espace unifié (D_model = 1152)
Fusion par Transformer : un Transformer à 8 couches et 8 têtes intègre les signaux sur une longue fenêtre de contexte (~100 s)
Flexibilité des modalités : le dropout de modalité (p = 0.3) permet l’inférence avec n’importe quel sous-ensemble (texte/audio/vidéo)
La représentation latente fusionnée est projetée sur la surface corticale pour produire la prédiction IRMf finale. Cette étape convertit les caractéristiques abstraites du modèle en estimations d’activité cérébrale résolues spatialement et temporellement.
Comme les trois extracteurs de caractéristiques sont gelés pendant l’entraînement, TRIBE v2 n’apprend que les couches de projection et les poids du Transformer qui intègrent leurs sorties. Ce choix de conception est important : le modèle est robuste aux stimuli hors distribution, car il hérite de la généralisation de trois grands modèles préentraînés, plutôt que d’être entraîné de bout en bout uniquement sur des données IRMf.
Remarque : une astuce d’entraînement clé est le dropout par modalité. Pendant l’entraînement, chaque modalité est annulée indépendamment avec une probabilité de 0,3. Cela force le modèle à produire des prédictions pertinentes à partir de n’importe quel sous-ensemble de modalités. Ainsi, à l’inférence, vous pouvez ne transmettre que de l’audio ou que du texte et obtenir malgré tout une prédiction corticale utile.
Dans cette section, nous allons construire un flux de travail pas à pas pour exécuter l’inférence TRIBE v2 sur des entrées texte, audio ou vidéo et visualiser l’activité corticale prédite en carte thermique 3D interactive. Nous mènerons aussi une expérience de comparaison qui reproduit le paradigme in silico de l’article d’origine. Enfin, nous créerons une application Gradio pour explorer la démo en direct.
Avant de commencer, configurez votre environnement Colab. Vous pouvez également utiliser tout autre service disposant d’un GPU A100 stable avec une grande quantité de RAM.
TRIBE v2 charge simultanément trois encodeurs gelés, dont LLaMA 3.2-3B (~7 Go), V-JEPA2-Giant (~14 Go) et Wav2Vec-BERT 2.0 (~1 Go), ainsi que les poids du Transformer TRIBE. L’empreinte totale en VRAM est de 28–32 Go.
Remarque : un T4 (16 Go) manquera de mémoire lorsque model.predict() chargera LLaMA. Utilisez l’A100 (40 Go) ou l’A100 avec Haute RAM (80 Go) pour de meilleures performances.
Vérifiez votre GPU avant d’installer quoi que ce soit en exécutant ce qui suit :
import subprocess, sys
result = subprocess.run(
    ['nvidia-smi', '--query-gpu=name,memory.total',
     '--format=csv,noheader,nounits'],
    capture_output=True, text=True)
print(result.stdout.strip())
import torch
assert torch.cuda.is_available(), "No GPU detected"
props = torch.cuda.get_device_properties(0)
assert props.total_memory > 30e9, (
    f"Need ≥40 GB VRAM. Got {props.total_memory/1e9:.0f} GB. Switch to A100.")
print(f"GPU: {props.name} — {props.total_memory/1e9:.0f} GB")
L’appel subprocess.run() invoque nvidia-smi avec l’option --query-gpu pour extraire le nom du GPU et la VRAM totale. Les deux assertions servent d’arrêts précoces : la première confirme la disponibilité de CUDA, la seconde vérifie que la VRAM totale dépasse 30 Go. Échouer bruyamment ici est préférable à un échec silencieux dans model.predict() 10 minutes plus tard avec une erreur CUDA de mémoire insuffisante.
Passez cette étape si vous n’utilisez pas Google Colab. C’est le premier bug que vous rencontrerez, car Colab est livré avec NumPy 2.x par défaut. Plusieurs dépendances internes de TRIBE v2, notamment neuralset, ont été compilées contre NumPy <2.1, qui a supprimé le symbole _center de numpy._core.umath. Le résultat est l’erreur suivante lorsque vous tentez import tribev2 :
ImportError
cannot import name '_center' from 'numpy._core.umath'
(/usr/local/lib/python3.12/dist-packages/numpy/_core/umath.py)
La correction consiste à épingler NumPy à une version <2.1 avant d’installer tribev2 ou l’une de ses dépendances, puis à redémarrer l’environnement d’exécution. Exécutez simplement la cellule suivante, qui désinstalle la version actuelle de NumPy et la remplace par une version inférieure à 2.1.
import subprocess, sys
print("Pinning NumPy to <2.1 (required for neuralset compatibility)...")
subprocess.run([sys.executable, '-m', 'pip', 'uninstall', '-y', 'numpy'])
subprocess.run([sys.executable, '-m', 'pip', 'install', '-q',
                'numpy>=1.26.4,<2.1.0'])
Une fois l’environnement et les dépendances figés, nous pouvons passer à l’installation de TRIBE v2.
Avec le noyau fraîchement redémarré et NumPy épinglé, nous pouvons installer en toute sécurité le package tribev2 depuis GitHub, ainsi que les bibliothèques de visualisation et d’interface.
import numpy as np
from packaging.version import Version
assert Version(np.__version__) < Version('2.1.0'), (
    f"NumPy is {np.__version__}. Run Step 2a and restart first.")
print(f"NumPy {np.__version__} Checked")
# Install tribev2 from GitHub
!pip install -q 'tribev2[plotting] @ git+https://github.com/facebookresearch/tribev2.git'
!pip install -q 'gradio>=4.19.0' 'nilearn>=0.10.3' 'plotly>=5.18.0'
L’extra tribev2[plotting] installe pyvista, une bibliothèque Python pour la visualisation 3D, et nilearn, une bibliothèque Python pour la neuroimagerie, en plus du package principal. L’installation directement depuis l’URL GitHub garantit d’obtenir le dernier commit sans avoir à cloner le dépôt en local.
Les packages nilearn et gradio sont installés séparément car leurs contraintes de version sont plus souples et gagnent à être résolues indépendamment du graphe de dépendances de tribev2.
L’encodeur texte utilise LLaMA 3.2-3B, un modèle restreint sur HuggingFace. Vous devez accepter explicitement la licence de Meta avant que les poids puissent être téléchargés. À faire une fois :
Une fois votre jeton HF défini, exécutez le code suivant pour vous connecter à votre compte :
import os
# Load token from Colab Secrets
try:
    from google.colab import userdata
    os.environ['HF_TOKEN'] = userdata.get('HF_TOKEN')
    print("HF_TOKEN loaded from Colab Secrets")
except Exception:
    from huggingface_hub import login
    login()
La voie privilégiée utilise google.colab.userdata.get(), qui lit depuis le coffre-fort chifré des Secrets de Colab, impossible à exposer par inadvertance dans un notebook partagé.
La solution de repli appelle huggingface_hub.login(), qui invite à saisir le jeton de manière interactive et le masque à la frappe. Les deux méthodes écrivent le jeton dans os.environ['HF_TOKEN'], où la bibliothèque HuggingFace Hub le détectera automatiquement pour télécharger les poids des modèles restreints.
Avec NumPy épinglé, l’authentification configurée et LLaMA en cache, nous pouvons charger le point de contrôle de l’encodeur TRIBE v2 depuis HuggingFace. Environ 1 Go est téléchargé lors de la première exécution, puis quelques secondes suffisent grâce au cache par la suite.
from pathlib import Path
from tribev2.demo_utils import TribeModel
import torch
CACHE_DIR = Path('/content/tribe_cache')
CACHE_DIR.mkdir(exist_ok=True)
print('Loading TRIBE v2 (first run downloads ~1 GB)...')
model = TribeModel.from_pretrained(
    'facebook/tribev2',
    cache_folder=str(CACHE_DIR)
)
print('Model loaded')
if torch.cuda.is_available():
    used  = torch.cuda.memory_allocated() / 1e9
    total = torch.cuda.get_device_properties(0).total_memory / 1e9
    print(f'VRAM after load: {used:.1f} / {total:.1f} GB')
TribeModel.from_pretrained() télécharge le point de contrôle de l’encodeur TRIBE depuis facebook/tribev2 sur HuggingFace et l’enregistre dans cache_folder. Ce point de contrôle contient les poids d’intégration du Transformer et le bloc sujet, mais pas les trois extracteurs de caractéristiques. Ceux-ci sont chargés séparément lors du premier appel à model.predict() pour chaque modalité.
Après chargement du seul encodeur TRIBE, environ 2–4 Go de VRAM sont alloués, tandis que les 24–28 Go restants seront consommés lorsque model.predict() chargera V-JEPA2-Giant et LLaMA 3.2-3B à la première utilisation.
Après le chargement du modèle TRIBE, l’appel de model.predict() sur une entrée texte déclenche pour la première fois le téléchargement différé des poids de LLaMA 3.2-3B (~6 Go). Le délai d’expiration par défaut de HuggingFace Hub est de 10 secondes, ce qui génère cette erreur en cours d’inférence :
ReadTimeout
The read operation timed out
Computing word embeddings:  0%|  | 0/9 [00:10<?, ?it/s]
Pour corriger cela, augmentez les variables d’environnement de timeout, puis pré-téléchargez LLaMA explicitement avec snapshot_download afin d’obtenir une progression visible et une reprise automatique en cas d’interruption, plutôt qu’un échec silencieux enfoui dans predict().
import os
os.environ['HF_HUB_DOWNLOAD_TIMEOUT'] = '300'
os.environ['HF_HUB_HTTP_TIMEOUT']     = '300'
from huggingface_hub import snapshot_download
print("Pre-downloading LLaMA 3.2-3B (~6 GB)...")
print("Runs once — subsequent calls load from cache.\n")
snapshot_download(
    repo_id        = "meta-llama/Llama-3.2-3B",
    cache_dir      = "/content/tribe_cache/llama",
    ignore_patterns= ["*.bin"],
)
print("\n LLaMA 3.2-3B cached")
snapshot_download() télécharge un dépôt entier vers le cache local via le protocole de requêtes par plages de HuggingFace, ce qui permet une reprise automatique si la connexion se coupe en cours de fichier. L’argument ignore_patterns=["*.bin"] ignore l’ancien format binaire PyTorch et ne télécharge que les fichiers safetensors, réduisant la taille totale d’environ 40 %.
Avant de lancer l’inférence réelle, configurons la couche de visualisation. Ces fonctions utilitaires convertissent le tableau de prédictions brut (T, 20484) en cartes thermiques cérébrales 3D interactives à l’aide de nilearn.
TRIBE v2 renvoie des prédictions sous forme d’un tableau NumPy de forme (T, 20484), où T est le nombre de secondes de l’entrée. Les 10 242 premiers sommets appartiennent à l’hémisphère gauche et les 10 242 restants à l’hémisphère droit.
Nous utilisons nilearn.plotting.view_surf pour afficher chaque hémisphère sous forme de surface WebGL interactive. Le maillage « gonflé » expose la géométrie des sillons autrement cachée dans les plis, et la carte de profondeur sulcale sert de repère anatomique sous la carte thermique.
Le maillage fsaverage5 est le gabarit cortical standard de FreeSurfer utilisé par TRIBE v2 comme espace de sortie. Nous le téléchargeons ici une fois pour toutes afin que les appels de visualisation suivants puissent s’y référer sans retéléchargement.
import numpy as np
from nilearn import datasets as nl_datasets
from nilearn.plotting import view_surf
from IPython.display import display, HTML
N_PER_HEMI = 10242   # fsaverage5: 10242 vertices per hemisphere
print('Fetching fsaverage5 mesh...')
fsavg = nl_datasets.fetch_surf_fsaverage(mesh='fsaverage5')
print('Mesh ready')
print('Keys:', [k for k in fsavg.keys() if k != 'description'])
La fonction fetch_surf_fsaverage(mesh='fsaverage5') télécharge le gabarit fsaverage5 de FreeSurfer depuis le CDN de nilearn et le met en cache. Elle renvoie aussi un objet Bunch (dictionnaire) avec des clés telles que infl_left, infl_right, sulc_left et sulc_right.
Cette sous-étape définit les trois fonctions centrales sur lesquelles repose toute la visualisation du tutoriel. split_hemis() partitionne le vecteur de sommets, render_hemi() construit la surface WebGL interactive pour un hémisphère, et show_brain() assemble les deux côte à côte.
def split_hemis(v):
    n = v.shape[0]
    if n == 2 * N_PER_HEMI:
        return v[:N_PER_HEMI], v[N_PER_HEMI:]
    return v[:n//2], v[n//2:]
def render_hemi(pred_vec, hemi='left', title=''):
    lh, rh = split_hemis(pred_vec)
    data = lh if hemi == 'left' else rh
    vmax = max(float(np.percentile(np.abs(data), 99)), 1e-6)
    return view_surf(
        surf_mesh = fsavg[f'infl_{hemi}'],
        surf_map  = data,
        bg_map    = fsavg[f'sulc_{hemi}'],
        hemi      = hemi,
        threshold = '20%',
        cmap      = 'hot',
        black_bg  = True,
        vmax      = vmax,
        bg_on_data= True,
        colorbar  = True,
        title     = title,
    )
def show_brain(pred_vec, title='', t=None):
    sfx = f' — t={t}s' if t is not None else ''
    lv  = render_hemi(pred_vec, 'left',  f'{title} [Left]{sfx}')
    rv  = render_hemi(pred_vec, 'right', f'{title} [Right]{sfx}')
    html = (
        '<div style="display:flex;gap:10px;background:#000;'
        'border-radius:10px;">'
        f'<div style="flex:1">{lv.get_iframe(width="100%",height="460px")}</div>'
        f'<div style="flex:1">{rv.get_iframe(width="100%",height="460px")}</div>'
        '</div>'
    )
    display(HTML(html))
Voici le rôle de chaque fonction utilitaire :
La fonction split_hemis() tranche le vecteur de prédiction à l’index 10 242, le point de séparation standard du maillage fsaverage5 selon la convention FreeSurfer. L’hémisphère gauche occupe les indices 0–10241 et le droit 10242–20483. La branche de repli gère les cas où le modèle renvoie un nombre de sommets non standard.
Dans render_hemi(), vmax est calculé comme le 99e percentile des valeurs absolues d’activation, plutôt que le maximum réel. Cela évite qu’un seul sommet extrême écrase toute l’échelle de couleurs, et rend le motif spatial lisible.
La fonction view_surf() renvoie un objet SurfaceView contenant 2,4 Mo de HTML WebGL autonome. L’appel get_iframe() l’encapsule dans une balise <iframe> aux dimensions souhaitées. Ainsi, display(HTML(...)) avec deux iframes côte à côte produit la vue séparée gauche/droite.
Le modèle étant chargé et les assistants de visualisation prêts, nous pouvons lancer une première inférence réelle.
L’inférence de TRIBE v2 se fait en deux temps. D’abord, model.get_events_dataframe() extrait des événements alignés dans le temps à partir de l’entrée, avec la temporalité des mots pour le texte, des embeddings Wav2Vec à 2 Hz pour l’audio, ou des embeddings V-JEPA2 à 2 Hz pour les images vidéo.
Le DataFrame d’événements résultant est ensuite passé à model.predict(), qui exécute le Transformer et le bloc sujet pour produire les prédictions corticales finales.
import tempfile, os
SAMPLE_TEXT = '''
The brain processes language through a distributed network in the left hemisphere.
Broca's area coordinates syntactic structure, while Wernicke's area handles semantics.
Together they form the language circuit activated when reading or hearing speech.
'''
tmp = tempfile.NamedTemporaryFile(delete=False, suffix='.txt', mode='w')
try:
    tmp.write(SAMPLE_TEXT.strip())
    tmp.flush()
    os.fsync(tmp.fileno())
    tmp.close()
    events = model.get_events_dataframe(text_path=tmp.name)
finally:
    if os.path.exists(tmp.name):
        os.unlink(tmp.name)
print(f'Events: {events.shape}')
print(events[['type', 'start', 'duration']].head(8))
print('\nRunning model.predict()...')
preds, segments = model.predict(events=events)
preds = np.asarray(preds)
print(f'Prediction shape: {preds.shape}')
print(f'  T = {preds.shape[0]}s   (1 Hz fMRI frequency)')
print(f'  V = {preds.shape[1]} vertices  (fsaverage5 cortical surface)')
La séquence d’écriture tmp.write(), tmp.flush(), os.fsync(tmp.fileno()), tmp.close() corrige un bug subtil. Si vous appelez get_events_dataframe() dans un bloc with avant la fermeture du fichier, le tampon d’écriture interne de Python peut ne pas être encore synchronisé avec l’OS, et tribev2 lira un fichier vide et lèvera une ValueError. L’appel à os.fsync() garantit que le cache de pages de l’OS est vidé sur le disque avant que tribev2 n’ouvre le chemin.
model.predict() renvoie un tuple (preds, segments). Le tableau preds a la forme (T, 20484), soit une prédiction corticale par seconde d’entrée sur les 20 484 sommets fsaverage5. L’envelopper avec np.asarray() garantit un tableau NumPy standard, quel que soit le type interne renvoyé. Une fois preds obtenu, vous pouvez visualiser la réponse corticale à n’importe quel instant :
T = preds.shape[0]
print(f'Timesteps: 0 to {T-1}')
T_SHOW = min(5, T - 1)
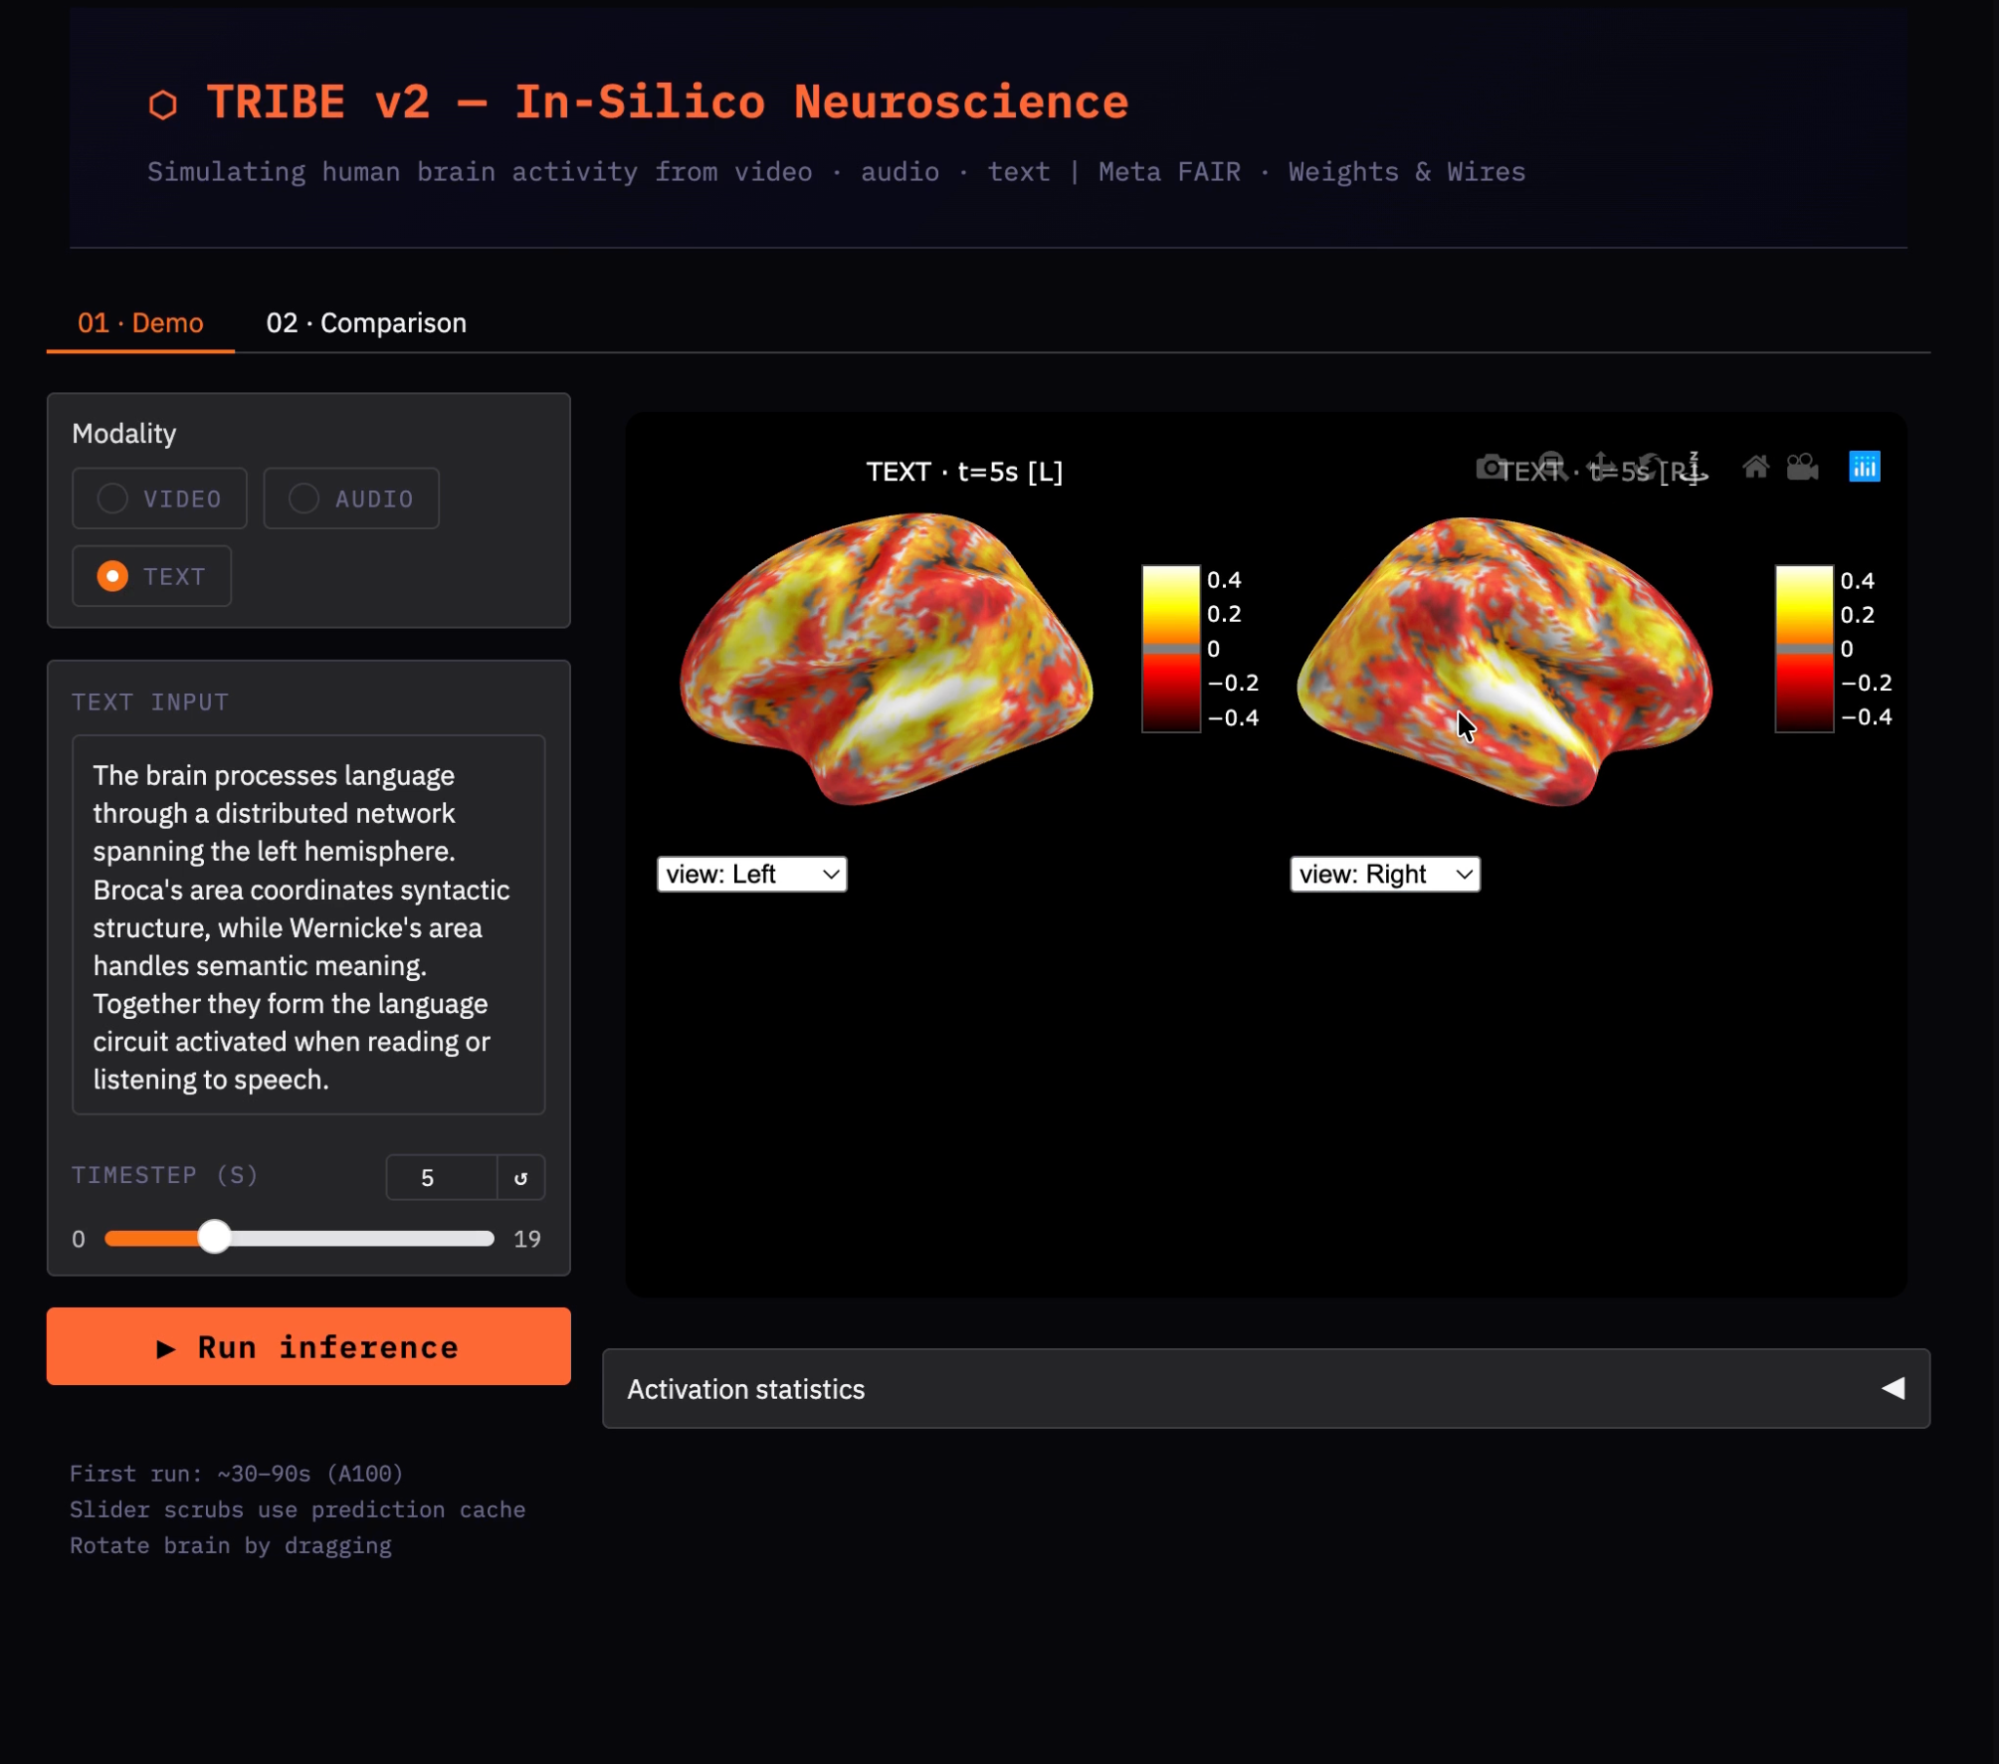
show_brain(preds[T_SHOW], title='Language stimulus', t=T_SHOW)
Nous proposons par défaut t=5 car le signal BOLD (Blood-Oxygen-Level-Dependent) présente un délai hémodynamique : la réponse vasculaire à l’activité neuronale atteint son pic environ 5–6 secondes après le début du stimulus. Visualiser à t=0 montre une activation quasi nulle, quelle que soit la nature du stimulus, la réponse vasculaire ne s’étant pas encore construite. La garde min(5, T-1) évite une erreur d’index si l’entrée produit moins de 6 pas de temps.
Une seule carte d’activation montre quelles zones s’activent, mais pas ce qui distingue un stimulus d’un autre. Cette étape fait passer deux entrées dans le modèle et calcule une carte de contraste (A − B) pour isoler les différences régionales entre le contenu linguistique et le contenu visuel/spatial.
Plutôt que de répéter le schéma écrire → flush → close → inférer pour chaque condition, nous l’encapsulons dans une fonction text_to_preds() unique. Cela garantit que les étapes critiques de vidage de fichier ne seront jamais oubliées pour l’une ou l’autre condition.
TEXT_A = '''
She spoke slowly and clearly, her voice filling the quiet room.
Every sentence carried meaning, and each word was chosen with care.
Language connects us, the professor said, bridging minds across time.
'''
TEXT_B = '''
The canyon walls rose steeply, layers of red and orange sandstone.
A hawk circled overhead, its wings barely moving in the thermal current.
Shadows shifted as the sun tracked its arc across the open desert sky.
'''
def text_to_preds(text):
    tmp = tempfile.NamedTemporaryFile(
        delete=False, suffix='.txt', mode='w', encoding='utf-8')
    try:
        tmp.write(text.strip())
        tmp.flush()
        os.fsync(tmp.fileno())
        tmp.close()
        evts = model.get_events_dataframe(text_path=tmp.name)
        p, _ = model.predict(events=evts)
        return np.asarray(p)
    finally:
        if os.path.exists(tmp.name):
            os.unlink(tmp.name)
print('Condition A: language content...')
preds_a = text_to_preds(TEXT_A)
print('Condition B: visual/spatial content...')
preds_b = text_to_preds(TEXT_B)
Nous utilisons deux passages de texte au contenu sémantique distinct ; on s’attend à ce que le contenu linguistique sollicite davantage le cortex temporal de l’hémisphère gauche, tandis que le contenu visuel/spatial recrute davantage le cortex occipital et pariétal postérieur.
La fonction text_to_preds() encapsule le pipeline complet dans une fonction réutilisable, en appliquant le même schéma sûr de l’étape 8 pour garantir que le fichier temporaire est toujours entièrement vidé avant que tribev2 ne le lise. L’argument encoding='utf-8' est explicite pour éviter les problèmes d’encodage dépendants de la plateforme.
Maintenant que les deux conditions sont prédites, visualisons chacune séparément puis soustrayons-les sommet par sommet pour produire la carte de contraste.
T_shared = min(preds_a.shape[0], preds_b.shape[0])
t_show   = min(5, T_shared - 1)
print('\n[A] Language content:')
show_brain(preds_a[t_show], title='Condition A: Language', t=t_show)
print('\n[B] Visual/spatial content:')
show_brain(preds_b[t_show], title='Condition B: Visual', t=t_show)
print('\n[A − B] Contrast: Language > Visual')
show_brain(preds_a[t_show] - preds_b[t_show], title='Contrast A − B', t=t_show)
La carte de contraste preds_a[t_show] - preds_b[t_show] est une soustraction directe sommet à sommet : les valeurs positives indiquent les régions où la condition A s’active davantage, les négatives où la condition B s’active davantage.
Comme les deux conditions partagent la même voie de traitement du texte, les cartes brutes se ressemblent globalement. Cette carte de contraste met en évidence les différences spécifiques au domaine entre contenu linguistique et contenu visuel.
Les cartes thermiques cérébrales montrent des motifs spatiaux à un instant donné. Cette étape ajoute une perspective temporelle : comment l’activation globale se compare-t-elle entre les conditions au fil du temps, et quand divergent-elles le plus fortement ?
import matplotlib.pyplot as plt
diff_norms = [
    np.linalg.norm(preds_a[i] - preds_b[i])
    for i in range(T_shared)
]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 3.5))
ax1.plot(np.abs(preds_a).mean(axis=1)[:T_shared],
         color='#e74c3c', linewidth=2, label='A: Language')
ax1.plot(np.abs(preds_b).mean(axis=1)[:T_shared],
         color='#3498db', linewidth=2, label='B: Visual')
ax1.set_title('Mean cortical activation over time')
ax1.set_xlabel('Time (s)'); ax1.legend(); ax1.grid(True, alpha=0.3)
ax2.plot(diff_norms, color='#f39c12', linewidth=2)
ax2.fill_between(range(T_shared), diff_norms, alpha=0.2, color='#f39c12')
ax2.set_title('||A − B|| difference over time')
ax2.set_xlabel('Time (s)'); ax2.grid(True, alpha=0.3)
plt.tight_layout(); plt.show()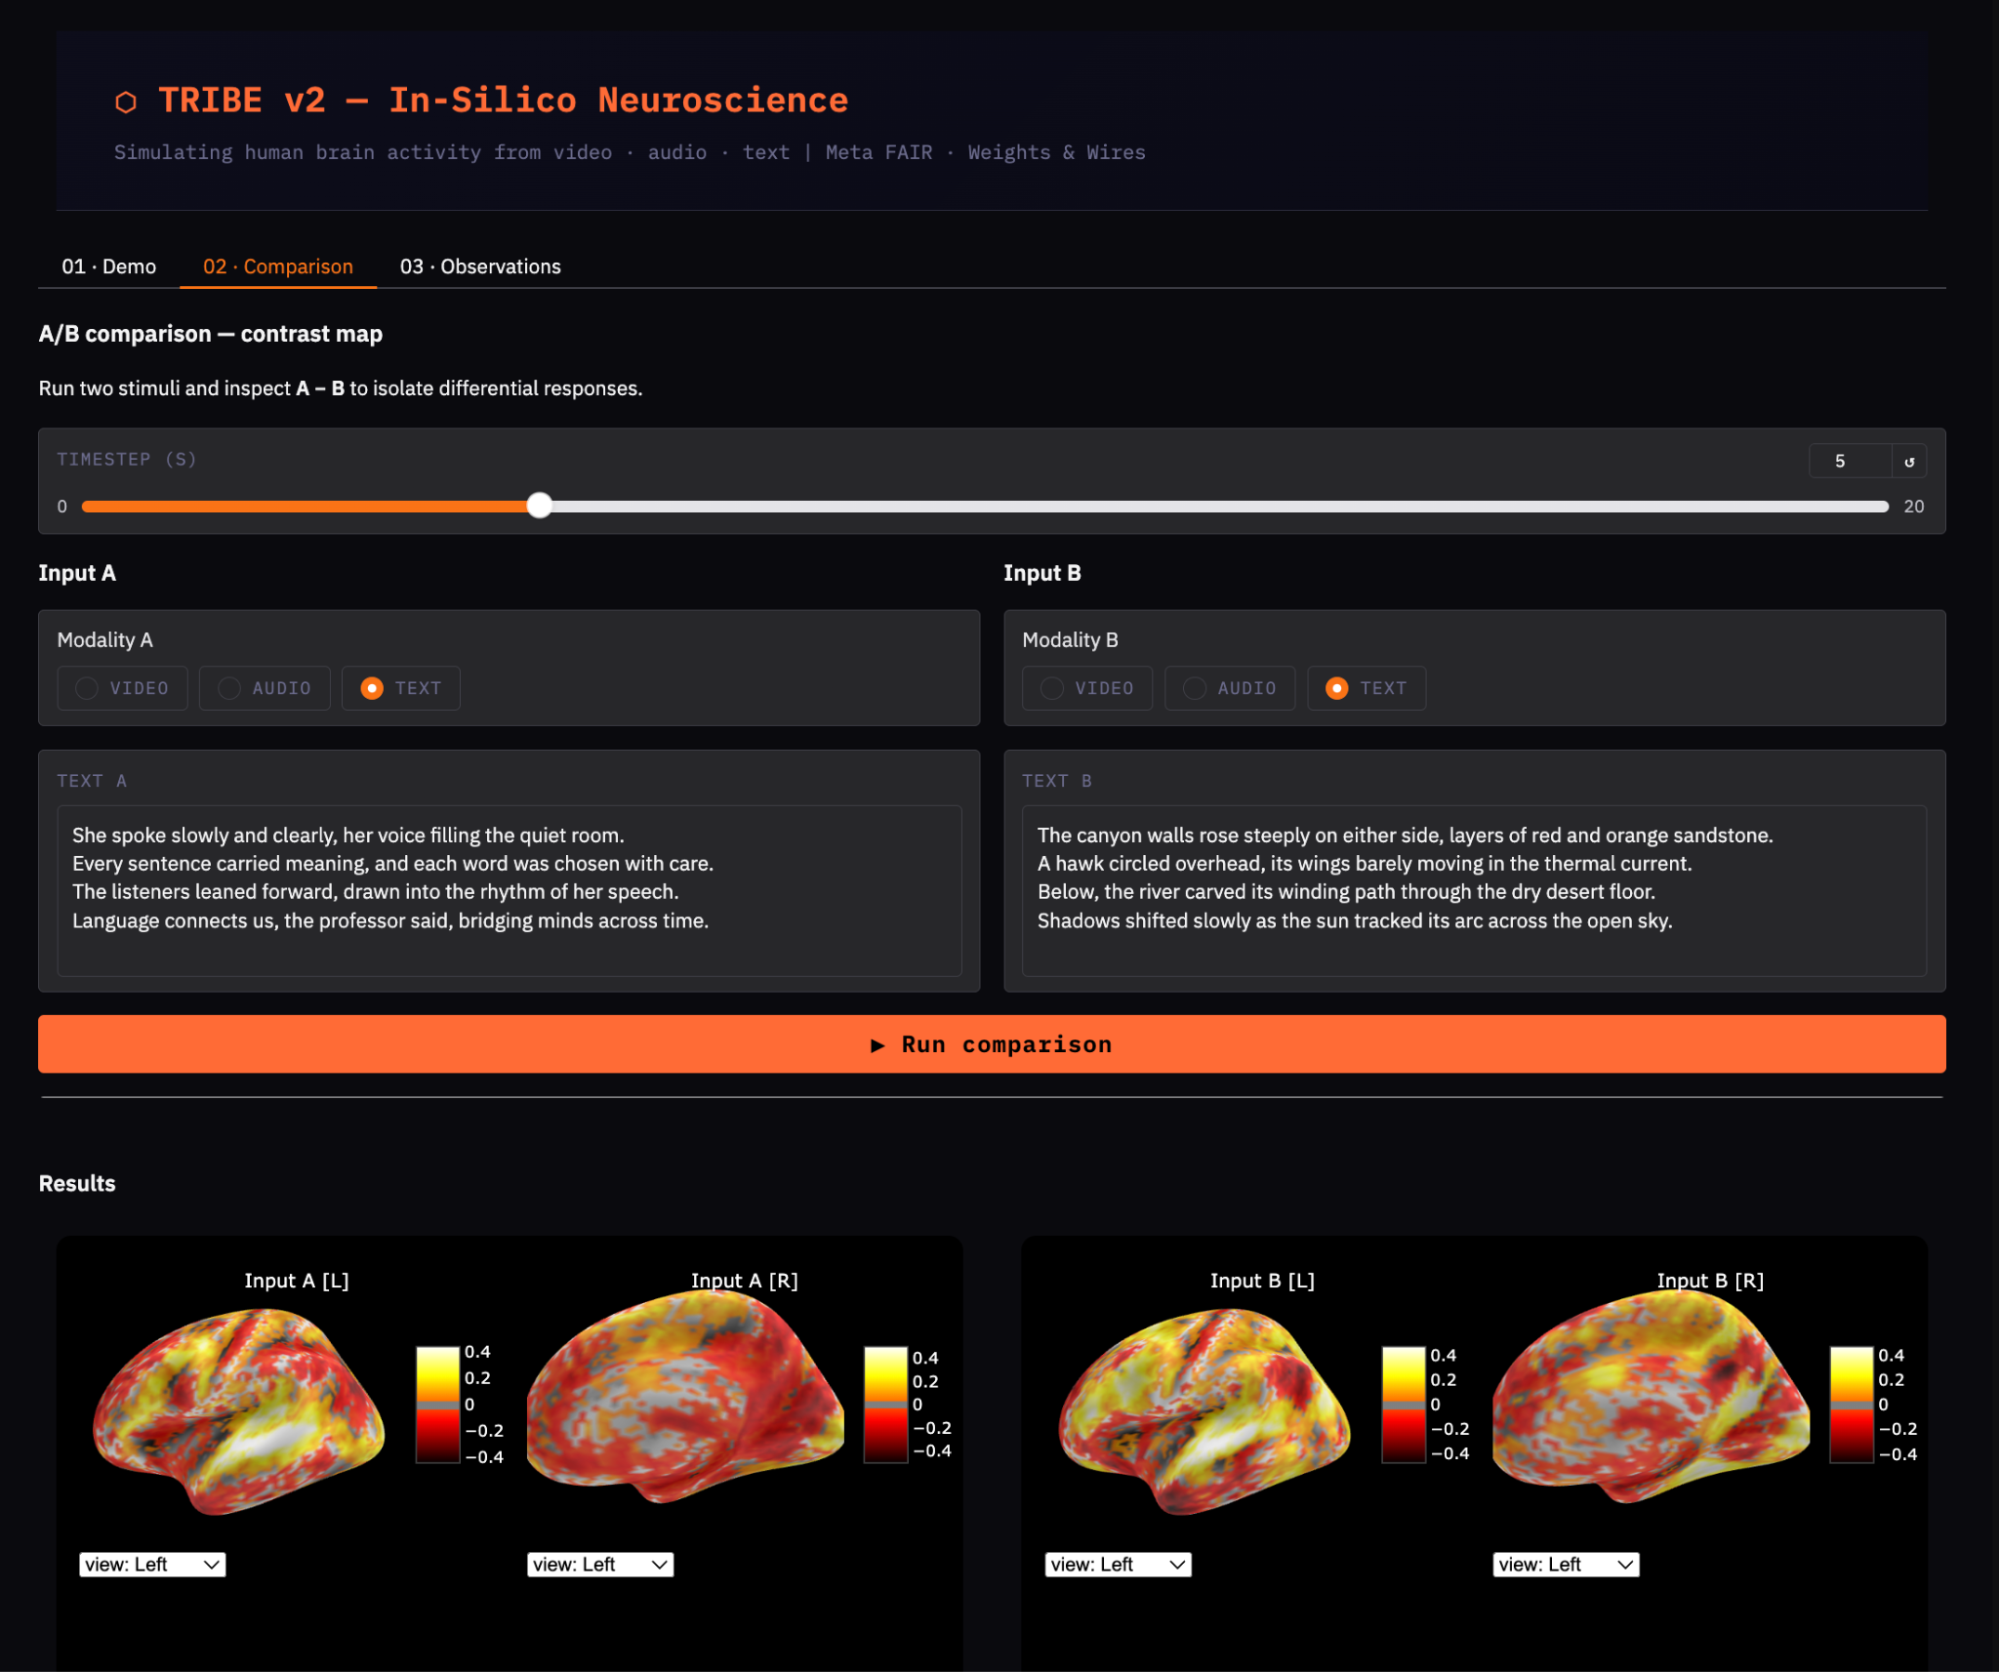
Le graphique de gauche trace np.abs(preds).mean(axis=1), c’est-à-dire l’activation absolue moyenne, agrégée sur les 20 484 sommets à chaque seconde. Il montre l’intensité d’engagement du cortex pour chaque condition et le moment du pic de réponse. La valeur absolue est importante car les valeurs BOLD prédites peuvent être négatives (désactivation) ; on s’intéresse à la magnitude, pas à la moyenne signée.
Le graphique de droite trace la norme L2 du vecteur différence à chaque pas de temps, np.linalg.norm(preds_a[i] - preds_b[i]). Un pic autour de t=5–7 s est cohérent avec le délai hémodynamique : les deux conditions ont besoin de temps pour que la réponse BOLD se construise avant de diverger. Le remplissage fill_between() met visuellement en évidence le début et le pic de divergence.
Cette dernière étape encapsule la logique d’inférence et de visualisation dans une application Gradio avec une interface soignée, un curseur temporel et un onglet de comparaison A/B.
import gradio as gr
_pred_cache = {}
def _infer(mod, vid, aud, txt):
    """Run inference and cache the result. Subsequent calls return cached array."""
    key = (mod, vid, aud, hash(txt or ''))
    if key not in _pred_cache:
        if mod == 'video':
            evts = model.get_events_dataframe(video_path=vid)
        elif mod == 'audio':
            evts = model.get_events_dataframe(audio_path=aud)
        else:
            tmp = tempfile.NamedTemporaryFile(delete=False, suffix='.txt', mode='w')
            tmp.write((txt or '').strip()); tmp.flush()
            os.fsync(tmp.fileno()); tmp.close()
            evts = model.get_events_dataframe(text_path=tmp.name)
            os.unlink(tmp.name)
        p, _ = model.predict(events=evts)
        _pred_cache[key] = np.asarray(p)
    return _pred_cache[key]
demo.launch(
    share      = True,
    debug      = False,
    server_name= "0.0.0.0",
)
Voici comment l’interface Gradio et le pipeline d’inférence s’articulent :
La fonction _infer() joue le rôle de couche d’inférence centrale, prenant en charge les trois modalités (vidéo, audio, texte) en préparant les entrées, en appelant model.predict() et en renvoyant l’activité cérébrale prédite.
Un cache de prédictions stocke les résultats à partir d’une clé composée de la modalité, des chemins d’entrée et d’un hash du texte. Cela évite de relancer l’inférence pour des entrées identiques.
Ce mécanisme de cache est crucial car des composants d’UI comme les curseurs déclenchent souvent des callbacks. Sans cache, chaque interaction relancerait l’inférence (jusqu’à ~60 secondes), alors qu’avec cache, les résultats sont renvoyés instantanément après la première exécution.
L’interface propose deux onglets : un mode entrée unique avec curseur temporel pour explorer l’activité au fil du temps, et un mode comparaison qui exécute deux entrées et visualise leur différence sous forme de carte thermique de contraste.
Enfin, demo.launch() est configuré avec share=True pour générer une URL publique et server_name="0.0.0.0" pour permettre l’accès externe, ce qui facilite le déploiement de l’application.
Après avoir exécuté la démo sur différentes entrées (vidéo, audio et texte), quelques tendances récurrentes aident à interpréter les sorties de TRIBE v2. Voici quelques enseignements :
Le modèle ne prétend pas être exact à 100 % et présente ses propres limites :
TRIBE v2 est un outil de recherche puissant, mais il présente des contraintes importantes qui influencent l’interprétation de ses sorties. Les comprendre est essentiel avant toute conclusion scientifique ou clinique.
Dans ce tutoriel, nous avons construit un pipeline TRIBE v2 fonctionnel sur Google Colab A100 : de la résolution de deux bugs concrets (le conflit de version NumPy 2.x et le délai d’expiration de téléchargement HuggingFace) jusqu’à l’exécution de prédictions corticales réelles, leur visualisation en cartes thermiques 3D interactives et une expérience de comparaison reproduisant le paradigme in silico de l’article.
Les quatre enseignements d’ingénierie les plus importants de ce tutoriel sont :
Épinglez NumPy à <2.1 et redémarrez l’environnement avant d’installer tribev2
Définissez HF_HUB_DOWNLOAD_TIMEOUT=300 et pré-téléchargez LLaMA avec snapshot_download avant d’appeler model.predict()
Écrivez toujours → flush() → fsync() → close() les fichiers temporaires avant de transmettre leur chemin au modèle
Mettez en cache les prédictions dans un dictionnaire pour que les interactions du curseur d’UI ne relancent jamais l’inférence.
À partir d’ici, deux prolongements naturels se dégagent. Le premier concerne des stimuli plus riches : de vrais extraits de films ou de podcasts de 30–60 secondes produisent des dynamiques temporelles et des motifs spatiaux bien plus nets que de courts passages de texte.
Le second est l’affinage individuel : avec ~1 heure d’IRMf d’un sujet spécifique, le bloc sujet de TRIBE v2 peut être affiné en une époque pour produire des prédictions personnalisées qui surpassent le modèle moyen de groupe par un facteur de 2 à 4 selon l’article.
Le notebook complet est disponible sur le dépôt GitHub de TRIBE v2. L’article mérite d’être lu en entier, en particulier la section 2.5 (expériences de vision in silico) et la section 2.8 (enseignements sur l’intégration multimodale), qui illustrent le potentiel de ce type d’outillage pour la recherche en neurosciences.
Cours de deep learning
Cursus
Cours
Cours
blog
Kurtis Pykes
9 min
blog
blog
Nathaniel Taylor-Leach
8 min
Tutoriel
Tutoriel
Josef Waples
8 min
Tutoriel
Sejal Jaiswal
24 min




