Lernpfad
Deep Learning in Python
18 Std.
TRIBE v2 (TRImodal Brain Encoder) ist ein Deep-Learning-Modell, das natürliche Reize auf vorhergesagte fMRT-Gehirnantworten abbildet. Aus einem Videoclip, einer Audiodatei oder einem Textblock gibt das Modell ein vorhergesagtes BOLD-Signal für jeden der 20.484 Vertices auf der fsaverage5-kortikalen Oberfläche mit 1 Hz aus, also eine Vorhersage pro Sekunde.
Die Vorhersagen gelten für das durchschnittliche Subjekt (nicht für das Gehirn einer spezifischen Person), genauer: die kanonische Gruppenmittelwert-Antwort, die TRIBE v2 aus 720 Teilnehmenden über vier naturalistische Datensätze gelernt hat. Die Zero-shot-Vorhersagen des Modells übertreffen Einzelsubjekt-fMRT-Aufnahmen im Human Connectome Project 7T-Datensatz, der die höchste Signalqualität im Training aufweist.
|
Eigenschaft |
Details |
|
Ausgaberaum |
20.484 kortikale Vertices auf der fsaverage5-Oberfläche und Ganzhirnvorhersagen über ungefähr 70.000 Voxel (Kortex + Subkortex) |
|
Zeitliche Auflösung |
1 Hz (entspricht der fMRT-TR-Frequenz) |
|
Eingabemodalitäten |
Video (V-JEPA2-Giant), Audio (Wav2Vec-BERT 2.0), Text (LLaMA 3.2-3B) |
|
Encoder-Parameter |
~1B lernbare Parameter in der Transformer-Integrationsschicht |
|
Trainingsdaten |
1.115 Stunden fMRT von 720 Probanden über 4 Datensätze |
|
Generalisierung |
Zero-shot auf neue Subjekte, Aufgaben und Sprachen |
|
Lizenz |
CC-BY-NC 4.0 (Forschung, nicht kommerziell) |
Das Modell basiert auf dem Paper A foundation model of vision, audition, and language for in-silico neuroscience. Es zeigt, dass TRIBE v2 die Fusiform Face Area für Gesichter, die Parahippocampal Place Area für Szenen, Brocas Areal für komplexe Syntax und das linksseitig lokalisierte Sprachnetzwerk für Sprache wiederfindet – ganz ohne fMRT-Daten zur Inferenzzeit.
TRIBE v2 durchläuft bei jedem Inferenzaufruf drei aufeinanderfolgende Stufen:
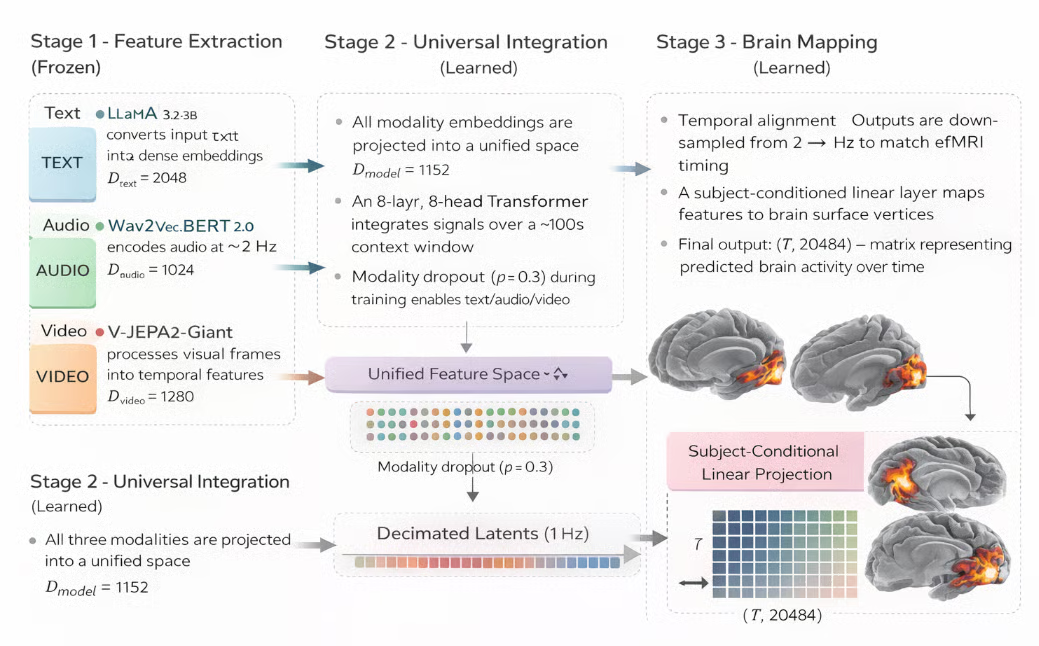
Abbildung: TRIBE v2 Modell zur Vorhersage von Gehirnaktivität (Mit KI generiert)
Zunächst verarbeiten drei separat vortrainierte Encoder jede Eingabemodalität unabhängig zu dichten, zeitlich ausgerichteten Embeddings. Keiner dieser Encoder wird im Training aktualisiert (eingefroren), daher übernimmt TRIBE v2 ihre Repräsentationen unverändert. Einige Kennzahlen zur Feature-Extraktion je Modalität:
Text: LLaMA 3.2-3B konvertiert Eingabetext in dichte Embeddings (D = 2048)
Audio: Wav2Vec-BERT 2.0 codiert Audiosignale mit ~2 Hz (D = 1024)
Video: V-JEPA2-Giant verarbeitet Bildfolgen zu zeitlichen Merkmalen (D = 1280)
Die drei Embedding-Ströme werden zu einer gemeinsamen Repräsentation fusioniert und von einem Transformer über die Zeit verarbeitet. Hier liegen die gelernten Gewichte von TRIBE v2 und hier werden Cross-Modal-Interaktionen wie folgt erfasst:
Geteilte Repräsentation: Alle Modalitäts-Embeddings werden in einen einheitlichen Raum projiziert (D_model = 1152)
Transformer-Fusion: Ein 8-lagiger, 8-köpfiger Transformer integriert Signale über ein langes Kontextfenster (~100 s)
Modalitäts-Flexibilität: Modality Dropout (p = 0,3) ermöglicht Inferenz mit beliebigen Teilmengen (Text/Audio/Video)
Die fusionierte latente Repräsentation wird auf die kortikale Oberfläche projiziert, um die finale fMRT-Vorhersage zu erzeugen. Diese Stufe übersetzt abstrakte Modellmerkmale in räumlich und zeitlich aufgelöste Schätzungen der Gehirnaktivität.
Da die drei Feature-Extractoren im Training eingefroren sind, lernt TRIBE v2 nur die Projektionsschichten und Transformer-Gewichte, die deren Ausgaben integrieren. Das ist wichtig, weil das Modell dadurch robuster gegenüber Out-of-Distribution-Reizen ist: Es erbt die Generalisierung dreier großskaliger, vortrainierter Modelle statt End-to-End nur auf fMRT-Daten zu trainieren.
Hinweis: Ein zentrales Trainingstrick ist Modalitäts-Dropout. Während des Trainings wird jede Modalität mit Wahrscheinlichkeit 0,3 unabhängig genullt. Das zwingt das Modell, aus jeder Teilmenge sinnvolle Vorhersagen zu machen. Zur Inferenzzeit kannst du also nur Audio oder nur Text übergeben und erhältst dennoch eine brauchbare kortikale Vorhersage.
In diesem Abschnitt erstellen wir einen Schritt-für-Schritt-Workflow, der TRIBE v2 auf Text-, Audio- oder Videoeingaben ausführt und die vorhergesagte kortikale Aktivität als interaktive 3D-Gehirn-Heatmap visualisiert. Außerdem führen wir ein Vergleichsexperiment durch, das das In-silico-Paradigma aus dem Originalpaper repliziert. Abschließend entwickeln wir eine Gradio-App, mit der jede Person die Demo live erkunden kann.
Bevor du beginnst, konfiguriere deine Colab-Runtime. Du kannst auch jeden anderen Dienst mit stabiler A100-GPU und viel RAM verwenden.
TRIBE v2 lädt gleichzeitig drei eingefrorene Encoder, darunter LLaMA 3.2-3B (~7 GB), V-JEPA2-Giant (~14 GB) und Wav2Vec-BERT 2.0 (~1 GB), zusammen mit den TRIBE-Transformer-Gewichten. Der gesamte VRAM-Bedarf liegt bei 28–32 GB.
Hinweis: Eine T4 (16 GB) läuft beim Laden von LLaMA in model.predict() in einen Speichermangel. Nutze die A100 (40 GB) oder A100 mit High RAM (80 GB) für bessere Performance.
Überprüfe deine GPU, bevor du etwas installierst, mit folgendem Code:
import subprocess, sys
result = subprocess.run(
    ['nvidia-smi', '--query-gpu=name,memory.total',
     '--format=csv,noheader,nounits'],
    capture_output=True, text=True)
print(result.stdout.strip())
import torch
assert torch.cuda.is_available(), "No GPU detected"
props = torch.cuda.get_device_properties(0)
assert props.total_memory > 30e9, (
    f"Need ≥40 GB VRAM. Got {props.total_memory/1e9:.0f} GB. Switch to A100.")
print(f"GPU: {props.name} — {props.total_memory/1e9:.0f} GB")
Der Aufruf subprocess.run() startet nvidia-smi mit dem Flag --query-gpu, um GPU-Name und gesamten VRAM auszulesen. Die beiden Assert-Statements dienen als frühe Abbrüche: Das erste bestätigt CUDA-Verfügbarkeit, das zweite verifiziert, dass der VRAM 30 GB übersteigt. Ein lautes Scheitern hier ist besser als ein späterer, kryptischer CUDA-Out-of-Memory-Fehler in model.predict() nach 10 Minuten.
Überspringe diesen Schritt, wenn du nicht auf Google Colab arbeitest. Dies ist der erste Bug, auf den du stößt, da Colab standardmäßig mit NumPy 2.x ausgeliefert wird. Mehrere interne Abhängigkeiten von TRIBE v2, insbesondere neuralset, wurden gegen NumPy <2.1 kompiliert, wodurch das Symbol _center aus numpy._core.umath entfernt wurde. Das führt zu folgendem Fehler beim import tribev2:
ImportError
cannot import name '_center' from 'numpy._core.umath'
(/usr/local/lib/python3.12/dist-packages/numpy/_core/umath.py)
Die Lösung ist, NumPy vor der Installation von tribev2 oder dessen Abhängigkeiten auf <2.1 zu pinnen und dann die Runtime neu zu starten. Führe einfach diese Zelle aus. Sie deinstalliert das aktuelle NumPy und ersetzt es durch eine Version unter 2.1.
import subprocess, sys
print("Pinning NumPy to <2.1 (required for neuralset compatibility)...")
subprocess.run([sys.executable, '-m', 'pip', 'uninstall', '-y', 'numpy'])
subprocess.run([sys.executable, '-m', 'pip', 'install', '-q',
                'numpy>=1.26.4,<2.1.0'])
Sobald Umgebung und Abhängigkeiten stehen, können wir TRIBE v2 installieren.
Mit frisch neu gestartetem Kernel und gepinntem NumPy installieren wir nun sicher das tribev2-Paket von GitHub sowie Visualisierungs- und UI-Bibliotheken.
import numpy as np
from packaging.version import Version
assert Version(np.__version__) < Version('2.1.0'), (
    f"NumPy is {np.__version__}. Run Step 2a and restart first.")
print(f"NumPy {np.__version__} Checked")
# Install tribev2 from GitHub
!pip install -q 'tribev2[plotting] @ git+https://github.com/facebookresearch/tribev2.git'
!pip install -q 'gradio>=4.19.0' 'nilearn>=0.10.3' 'plotly>=5.18.0'
Das Extra tribev2[plotting] installiert pyvista für 3D-Visualisierung und nilearn für Neuroimaging zusätzlich zum Kernpaket. Die direkte Installation aus der GitHub-URL stellt sicher, dass du den neuesten Commit bekommst, ohne das Repository lokal zu klonen.
Die Pakete nilearn und gradio werden separat installiert, da ihre Versionsconstraints flexibler sind und unabhängig vom tribev2-Abhängigkeitsgraphen besser aufgelöst werden.
Der Text-Encoder nutzt LLaMA 3.2-3B, ein gated Modell auf HuggingFace. Du musst Metas Lizenz explizit akzeptieren, bevor die Gewichte heruntergeladen werden können. Einmalig durchführen:
Sobald dein HF-Token gesetzt ist, melde dich mit folgendem Code an:
import os
# Load token from Colab Secrets
try:
    from google.colab import userdata
    os.environ['HF_TOKEN'] = userdata.get('HF_TOKEN')
    print("HF_TOKEN loaded from Colab Secrets")
except Exception:
    from huggingface_hub import login
    login()
Der bevorzugte Pfad nutzt google.colab.userdata.get() und liest aus Colabs verschlüsseltem Secrets-Store, der in geteilten Notebooks nicht versehentlich offengelegt werden kann.
Der Fallback ruft huggingface_hub.login() auf, fragt interaktiv nach dem Token und maskiert die Eingabe. Beide Wege schreiben das Token nach os.environ['HF_TOKEN'], wo die HuggingFace-Hub-Bibliothek es beim Download der gated Modellgewichte automatisch findet.
Mit gepinntem NumPy, eingerichteter Authentifizierung und zwischengespeichertem LLaMA laden wir nun den TRIBE v2 Encoder-Checkpoint von HuggingFace. Beim ersten Lauf werden ca. 1 GB heruntergeladen, spätere Läufe kommen aus dem Cache.
from pathlib import Path
from tribev2.demo_utils import TribeModel
import torch
CACHE_DIR = Path('/content/tribe_cache')
CACHE_DIR.mkdir(exist_ok=True)
print('Loading TRIBE v2 (first run downloads ~1 GB)...')
model = TribeModel.from_pretrained(
    'facebook/tribev2',
    cache_folder=str(CACHE_DIR)
)
print('Model loaded')
if torch.cuda.is_available():
    used  = torch.cuda.memory_allocated() / 1e9
    total = torch.cuda.get_device_properties(0).total_memory / 1e9
    print(f'VRAM after load: {used:.1f} / {total:.1f} GB')
TribeModel.from_pretrained() lädt den TRIBE-Encoder-Checkpoint von facebook/tribev2 auf HuggingFace und speichert ihn in cache_folder. Dieser Checkpoint enthält die Transformer-Integrationsgewichte und den Subject-Block, nicht jedoch die drei Feature-Extractoren. Diese werden separat gezogen, wenn model.predict() eine Modalität erstmals nutzt.
Nach dem Laden nur des TRIBE-Encoders sind ungefähr 2–4 GB VRAM belegt, die übrigen 24–28 GB werden verbraucht, sobald model.predict() V-JEPA2-Giant und LLaMA 3.2-3B beim ersten Gebrauch lädt.
Nach dem Laden des TRIBE-Modells löst der erste Aufruf von model.predict() mit Texteingabe den Lazy-Download der LLaMA 3.2-3B-Gewichte (~6 GB) aus. Das Standard-Timeout des HuggingFace Hubs beträgt 10 Sekunden und führt zu folgendem Fehler mitten in der Inferenz:
ReadTimeout
The read operation timed out
Computing word embeddings:  0%|  | 0/9 [00:10<?, ?it/s]
Setze dafür höhere Timeout-Umgebungsvariablen und lade LLaMA anschließend explizit mit snapshot_download vorab herunter. So siehst du Fortschritt, hast automatisches Resume bei Unterbrechung und vermeidest stille Fehler in predict().
import os
os.environ['HF_HUB_DOWNLOAD_TIMEOUT'] = '300'
os.environ['HF_HUB_HTTP_TIMEOUT']     = '300'
from huggingface_hub import snapshot_download
print("Pre-downloading LLaMA 3.2-3B (~6 GB)...")
print("Runs once — subsequent calls load from cache.\n")
snapshot_download(
    repo_id        = "meta-llama/Llama-3.2-3B",
    cache_dir      = "/content/tribe_cache/llama",
    ignore_patterns= ["*.bin"],
)
print("\n LLaMA 3.2-3B cached")
snapshot_download() lädt ein gesamtes Repository in den lokalen Cache per Range-Request-Protokoll, wodurch Downloads bei Verbindungsabbruch automatisch fortgesetzt werden. Mit ignore_patterns=["*.bin"] werden ältere PyTorch-Binärdateien übersprungen und nur Safetensors geladen – das reduziert die Gesamtgröße um rund 40 %.
Bevor wir echte Inferenz laufen lassen, richten wir die Visualisierungsebene ein. Diese Helferfunktionen konvertieren das rohe (T, 20484)-Vorhersagearray in interaktive 3D-Gehirn-Heatmaps mit nilearn.
TRIBE v2 liefert Vorhersagen als NumPy-Array der Form (T, 20484), wobei T die Anzahl Sekunden der Eingabe ist. Die ersten 10.242 Vertices gehören zur linken Hemisphäre, die restlichen 10.242 zur rechten.
Wir nutzen nilearn.plotting.view_surf, um jede Hemisphäre als interaktive WebGL-Oberfläche zu rendern. Das „inflated“ Mesh legt Sulci frei, die in den Falten verborgen wären, und die Sulcal-Tiefenkarte dient als anatomische Referenz unter der Heatmap.
Das fsaverage5-Mesh ist das Standard-FreeSurfer-Kortikaltemplate, das TRIBE v2 als Ausgaberaum nutzt. Wir laden es hier einmal herunter, damit spätere Visualisierungsaufrufe ohne erneute Netzwerkanfrage darauf zugreifen können.
import numpy as np
from nilearn import datasets as nl_datasets
from nilearn.plotting import view_surf
from IPython.display import display, HTML
N_PER_HEMI = 10242   # fsaverage5: 10242 vertices per hemisphere
print('Fetching fsaverage5 mesh...')
fsavg = nl_datasets.fetch_surf_fsaverage(mesh='fsaverage5')
print('Mesh ready')
print('Keys:', [k for k in fsavg.keys() if k != 'description'])
Der Aufruf fetch_surf_fsaverage(mesh='fsaverage5') lädt das FreeSurfer-Template fsaverage5 vom CDN von nilearn und cached es. Er liefert ein Bunch-Objekt (Dictionary) mit Schlüsseln wie infl_left, infl_right, sulc_left und sulc_right.
Dieser Teil definiert drei Kernfunktionen, auf denen die gesamte Visualisierung im Tutorial basiert. split_hemis() teilt den Vertex-Vektor, render_hemi() baut die interaktive WebGL-Ansicht für eine Hemisphäre und show_brain() setzt beides nebeneinander zusammen.
def split_hemis(v):
    n = v.shape[0]
    if n == 2 * N_PER_HEMI:
        return v[:N_PER_HEMI], v[N_PER_HEMI:]
    return v[:n//2], v[n//2:]
def render_hemi(pred_vec, hemi='left', title=''):
    lh, rh = split_hemis(pred_vec)
    data = lh if hemi == 'left' else rh
    vmax = max(float(np.percentile(np.abs(data), 99)), 1e-6)
    return view_surf(
        surf_mesh = fsavg[f'infl_{hemi}'],
        surf_map  = data,
        bg_map    = fsavg[f'sulc_{hemi}'],
        hemi      = hemi,
        threshold = '20%',
        cmap      = 'hot',
        black_bg  = True,
        vmax      = vmax,
        bg_on_data= True,
        colorbar  = True,
        title     = title,
    )
def show_brain(pred_vec, title='', t=None):
    sfx = f' — t={t}s' if t is not None else ''
    lv  = render_hemi(pred_vec, 'left',  f'{title} [Left]{sfx}')
    rv  = render_hemi(pred_vec, 'right', f'{title} [Right]{sfx}')
    html = (
        '<div style="display:flex;gap:10px;background:#000;'
        'border-radius:10px;">'
        f'<div style="flex:1">{lv.get_iframe(width="100%",height="460px")}</div>'
        f'<div style="flex:1">{rv.get_iframe(width="100%",height="460px")}</div>'
        '</div>'
    )
    display(HTML(html))
Das leisten die Helfer im Detail:
split_hemis() schneidet den Vorhersagevektor bei Index 10.242 – dem Standardtrennpunkt des fsaverage5-Mesh nach FreeSurfer-Konvention. Die linke Hemisphäre belegt Indizes 0–10241, die rechte 10242–20483. Der Fallback unten behandelt Sonderfälle mit abweichender Vertexzahl.
In render_hemi() wird vmax als 99. Perzentil der absoluten Aktivierungen statt als echtes Maximum berechnet. So verhindert man, dass ein Extremwert die gesamte Farbskala zusammendrückt, und macht das räumliche Muster sichtbar.
view_surf() liefert ein SurfaceView-Objekt mit 2,4 MB selbstenthaltener WebGL-HTML. get_iframe() kapselt dies in einem <iframe> mit vorgegebener Größe. display(HTML(...)) mit zwei Iframes nebeneinander erzeugt das Split-Layout links/rechts.
Mit geladenem Modell und Visualisierungshilfen können wir die erste echte Inferenz ausführen.
Die Inferenz von TRIBE v2 erfolgt in zwei Schritten. Zuerst extrahiert model.get_events_dataframe() zeitlich ausgerichtete Events aus der Eingabe – inklusive Wortzeiten aus Text, Wav2Vec-Embeddings mit 2 Hz aus Audio oder V-JEPA2-Embeddings mit 2 Hz aus Videoframes.
Das resultierende Events-DataFrame wird dann an model.predict() übergeben, das den Transformer und den Subject-Block ausführt, um die endgültigen kortikalen Vorhersagen zu erzeugen.
import tempfile, os
SAMPLE_TEXT = '''
The brain processes language through a distributed network in the left hemisphere.
Broca's area coordinates syntactic structure, while Wernicke's area handles semantics.
Together they form the language circuit activated when reading or hearing speech.
'''
tmp = tempfile.NamedTemporaryFile(delete=False, suffix='.txt', mode='w')
try:
    tmp.write(SAMPLE_TEXT.strip())
    tmp.flush()
    os.fsync(tmp.fileno())
    tmp.close()
    events = model.get_events_dataframe(text_path=tmp.name)
finally:
    if os.path.exists(tmp.name):
        os.unlink(tmp.name)
print(f'Events: {events.shape}')
print(events[['type', 'start', 'duration']].head(8))
print('\nRunning model.predict()...')
preds, segments = model.predict(events=events)
preds = np.asarray(preds)
print(f'Prediction shape: {preds.shape}')
print(f'  T = {preds.shape[0]}s   (1 Hz fMRI frequency)')
print(f'  V = {preds.shape[1]} vertices  (fsaverage5 cortical surface)')
Die Sequenz tmp.write(), tmp.flush(), os.fsync(tmp.fileno()), tmp.close() behebt einen subtilen Fehler: Wenn du get_events_dataframe() in einem with-Block aufrufst, bevor die Datei geschlossen ist, könnte Pythons interner Schreibpuffer noch nicht mit dem OS synchronisiert sein – tribev2 liest dann eine leere Datei und wirft ValueError. os.fsync() stellt sicher, dass der OS-Seiten-Cache vor dem Öffnen durch tribev2 auf die Platte geschrieben ist.
model.predict() gibt ein Tupel (preds, segments) zurück. preds hat die Form (T, 20484), also eine kortikale Vorhersage pro Sekunde Eingabe über alle 20.484 fsaverage5-Vertices. np.asarray() stellt sicher, dass es sich unabhängig vom internen Typ um ein NumPy-Array handelt. Mit preds kannst du die kortikale Antwort zu jedem Zeitpunkt visualisieren:
T = preds.shape[0]
print(f'Timesteps: 0 to {T-1}')
T_SHOW = min(5, T - 1)
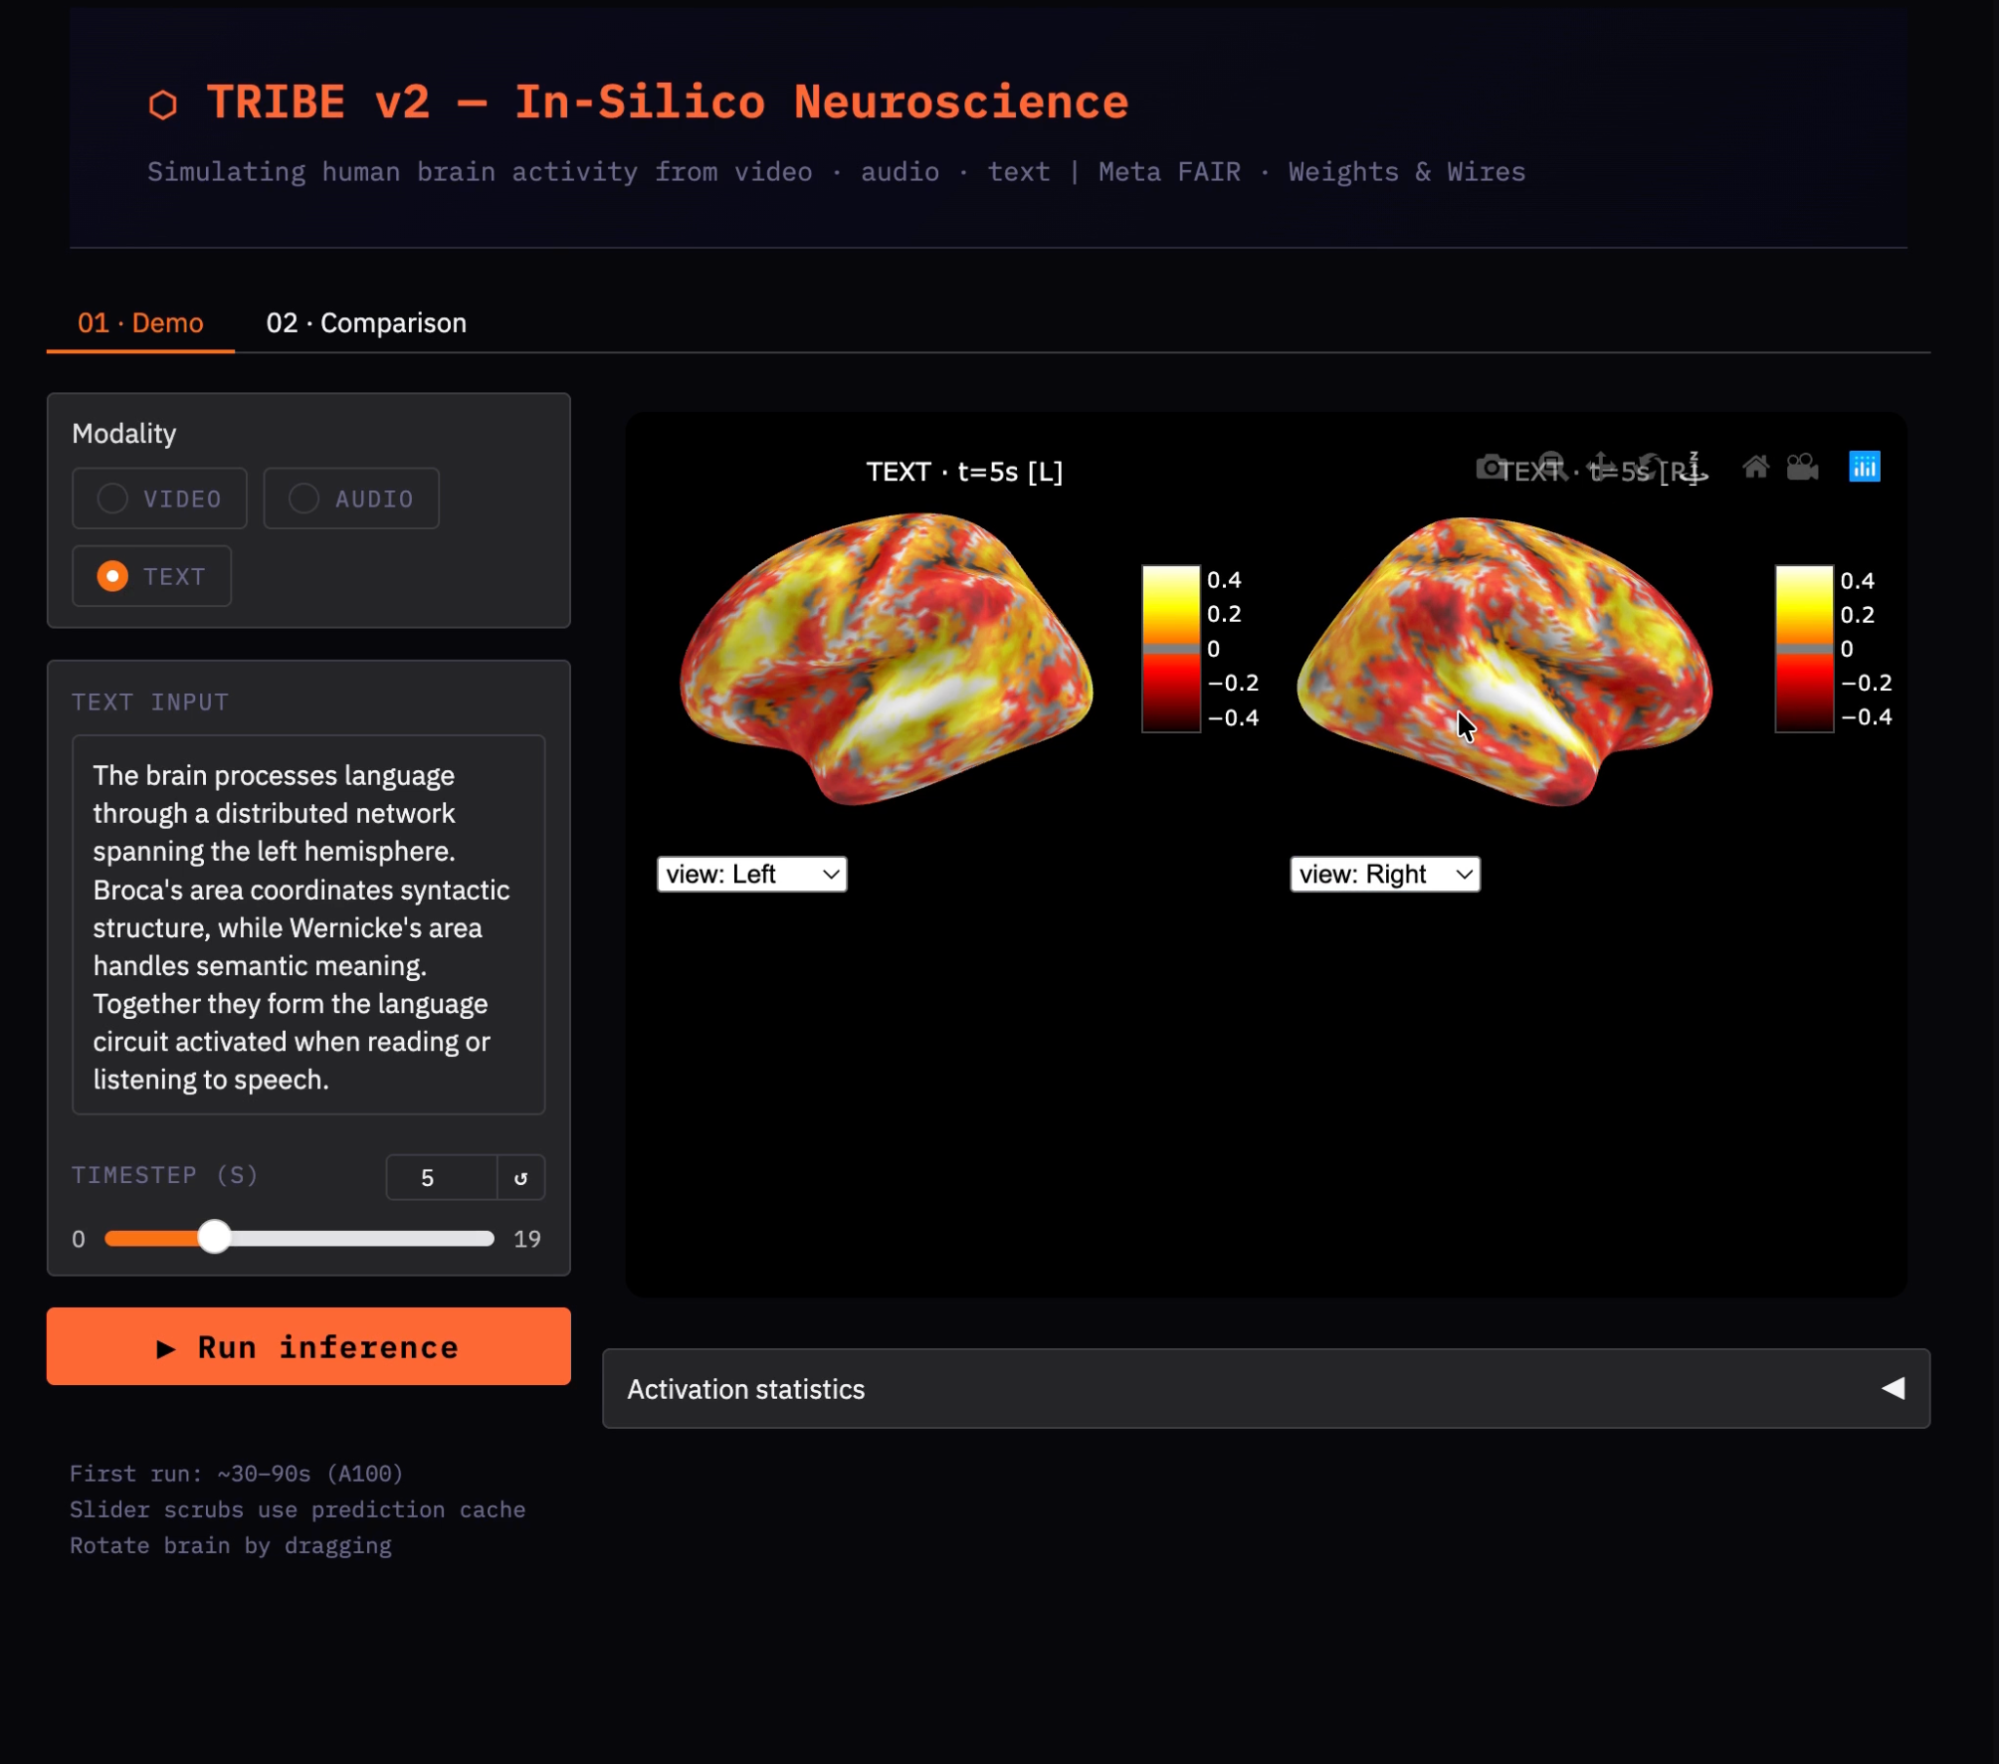
show_brain(preds[T_SHOW], title='Language stimulus', t=T_SHOW)
Standardmäßig nutzen wir t=5, weil das BOLD-Signal (Blood-Oxygen-Level-Dependent) eine hämodynamische Verzögerung hat und die vaskuläre Antwort etwa 5–6 Sekunden nach Reizbeginn ihren Peak erreicht. Bei t=0 ist die Aktivierung nahezu null – unabhängig vom Reizinhalt. Die Schutzklausel min(5, T-1) verhindert Indexfehler bei weniger als 6 Zeitschritten.
Eine einzelne Aktivierungskarte zeigt, welche Areale aktiv sind, aber nicht, wodurch sich Reize unterscheiden. In diesem Schritt schicken wir zwei Eingaben durch das Modell und berechnen eine Kontrastkarte (A − B), um regionsspezifische Unterschiede zwischen Sprach- und visuell/räumlichem Inhalt zu isolieren.
Anstatt das Muster Schreiben -> Flush -> Close -> Inferenz für jede Bedingung zu wiederholen, kapseln wir es in text_to_preds(). So gehen die kritischen Flush-Schritte nie verloren.
TEXT_A = '''
She spoke slowly and clearly, her voice filling the quiet room.
Every sentence carried meaning, and each word was chosen with care.
Language connects us, the professor said, bridging minds across time.
'''
TEXT_B = '''
The canyon walls rose steeply, layers of red and orange sandstone.
A hawk circled overhead, its wings barely moving in the thermal current.
Shadows shifted as the sun tracked its arc across the open desert sky.
'''
def text_to_preds(text):
    tmp = tempfile.NamedTemporaryFile(
        delete=False, suffix='.txt', mode='w', encoding='utf-8')
    try:
        tmp.write(text.strip())
        tmp.flush()
        os.fsync(tmp.fileno())
        tmp.close()
        evts = model.get_events_dataframe(text_path=tmp.name)
        p, _ = model.predict(events=evts)
        return np.asarray(p)
    finally:
        if os.path.exists(tmp.name):
            os.unlink(tmp.name)
print('Condition A: language content...')
preds_a = text_to_preds(TEXT_A)
print('Condition B: visual/spatial content...')
preds_b = text_to_preds(TEXT_B)
Wir nutzen zwei Textpassagen mit unterschiedlicher Semantik. Erwartungsgemäß treibt Sprachinhalt die linke Temporalkortex-Seite stärker, während visuell/räumlicher Inhalt den Okzipital- und posterioren Parietalkortex stärker rekrutiert.
Die Funktion text_to_preds() kapselt die gesamte Pipeline und verwendet das sichere Muster aus Schritt 8, damit die temporäre Datei immer vollständig geflusht ist, bevor tribev2 sie liest. encoding='utf-8' ist explizit gesetzt, um plattformspezifische Kodierungsprobleme zu vermeiden.
Nachdem beide Bedingungen vorhergesagt sind, visualisieren wir jede einzeln und subtrahieren sie anschließend Vertex für Vertex, um die Kontrastkarte zu erzeugen.
T_shared = min(preds_a.shape[0], preds_b.shape[0])
t_show   = min(5, T_shared - 1)
print('\n[A] Language content:')
show_brain(preds_a[t_show], title='Condition A: Language', t=t_show)
print('\n[B] Visual/spatial content:')
show_brain(preds_b[t_show], title='Condition B: Visual', t=t_show)
print('\n[A − B] Contrast: Language > Visual')
show_brain(preds_a[t_show] - preds_b[t_show], title='Contrast A − B', t=t_show)
Die Kontrastkarte preds_a[t_show] - preds_b[t_show] ist eine direkte Vertex-weise Subtraktion: Positive Werte markieren Regionen, in denen Bedingung A stärker ist, negative, in denen Bedingung B stärker ist.
Da beide Bedingungen denselben Textverarbeitungsweg teilen, ähneln sich die Rohkarten insgesamt. Der Kontrast hebt die domänenspezifischen Unterschiede zwischen Sprache und visuellen Inhalten hervor.
Die Gehirn-Heatmaps zeigen räumliche Muster zu einem Zeitpunkt. Hier fügen wir die Zeitperspektive hinzu: Wie unterscheidet sich die Gesamtaktivierung über alle Zeitschritte, und wann divergieren die Bedingungen am stärksten?
import matplotlib.pyplot as plt
diff_norms = [
    np.linalg.norm(preds_a[i] - preds_b[i])
    for i in range(T_shared)
]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 3.5))
ax1.plot(np.abs(preds_a).mean(axis=1)[:T_shared],
         color='#e74c3c', linewidth=2, label='A: Language')
ax1.plot(np.abs(preds_b).mean(axis=1)[:T_shared],
         color='#3498db', linewidth=2, label='B: Visual')
ax1.set_title('Mean cortical activation over time')
ax1.set_xlabel('Time (s)'); ax1.legend(); ax1.grid(True, alpha=0.3)
ax2.plot(diff_norms, color='#f39c12', linewidth=2)
ax2.fill_between(range(T_shared), diff_norms, alpha=0.2, color='#f39c12')
ax2.set_title('||A − B|| difference over time')
ax2.set_xlabel('Time (s)'); ax2.grid(True, alpha=0.3)
plt.tight_layout(); plt.show()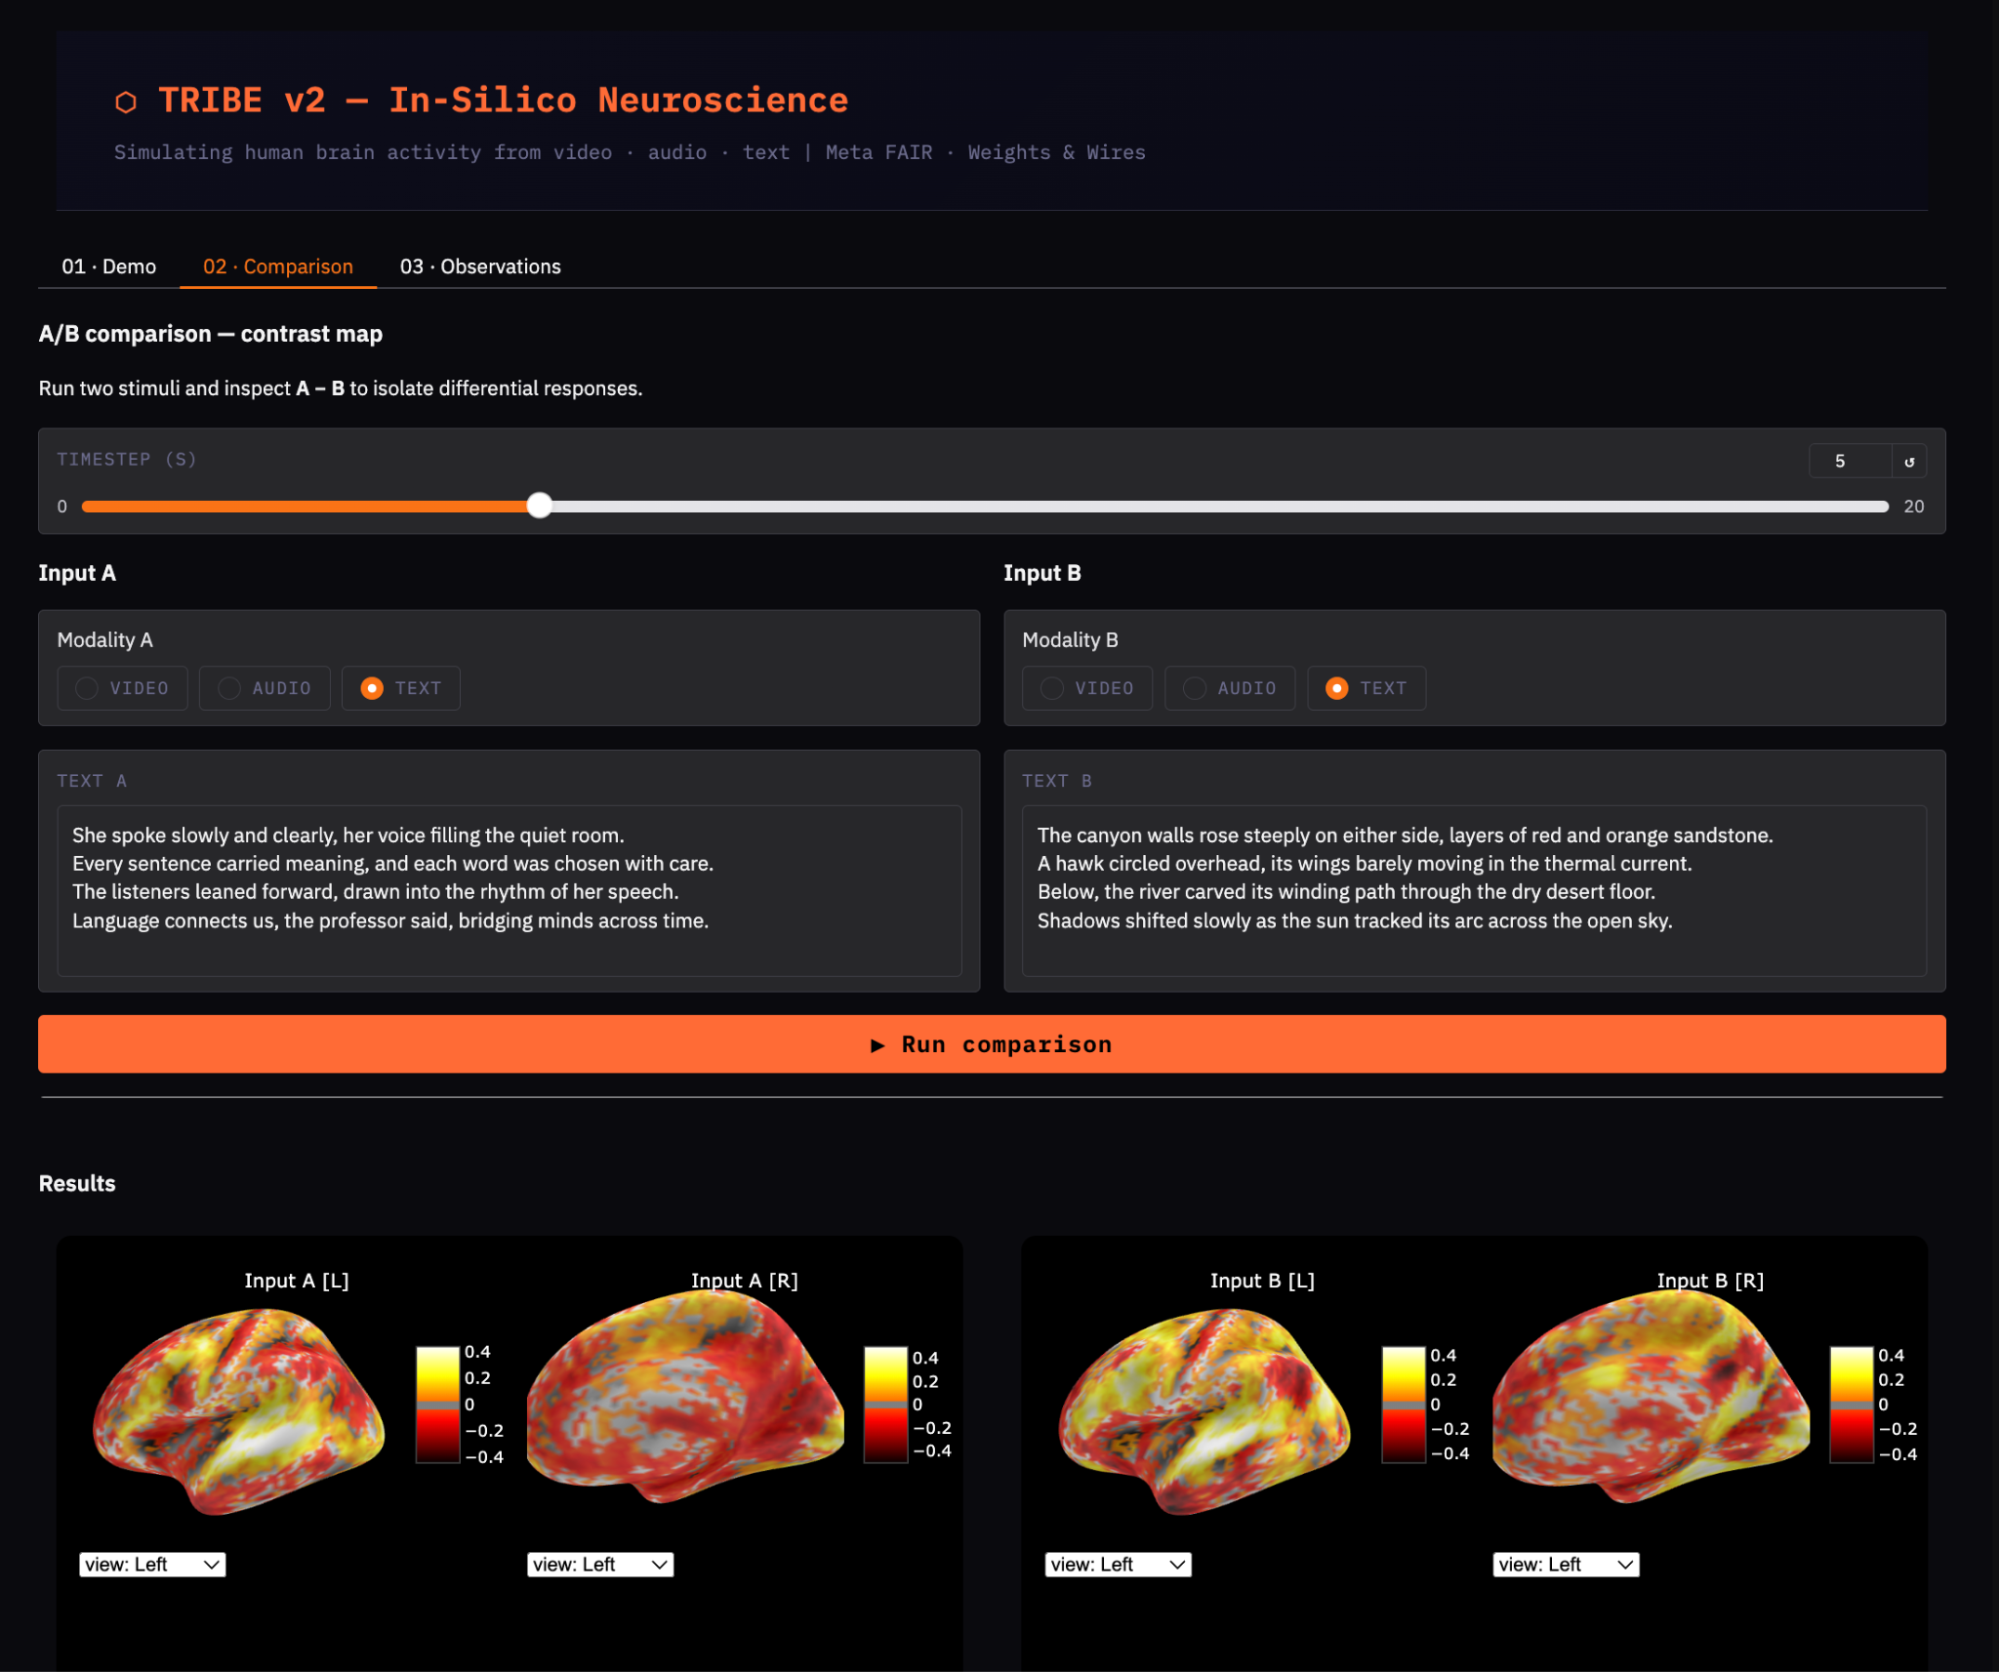
Der linke Plot zeigt np.abs(preds).mean(axis=1), also die mittlere absolute Aktivierung über alle 20.484 Vertices je Sekunde. So siehst du, wie stark jede Bedingung den Kortex aktiviert und wann die Antwort ihren Höhepunkt erreicht. Der Betrag ist wichtig, weil vorhergesagte BOLD-Werte negativ sein können (Deaktivierung) – wir wollen die Stärke, nicht den Vorzeichenmittelwert.
Der rechte Plot zeigt die L2-Norm des Differenzvektors je Zeitschritt, np.linalg.norm(preds_a[i] - preds_b[i]). Ein Peak um t=5–7 s passt zur hämodynamischen Verzögerung: Beide Bedingungen brauchen Zeit, bis die BOLD-Antwort aufgebaut ist und divergieren. fill_between() macht Onset und Peak der Divergenz visuell klarer.
Zum Abschluss verpacken wir Inferenz und Visualisierung in eine Gradio-App mit aufgeräumter UI, Zeitregler und A/B-Vergleichs-Tab.
import gradio as gr
_pred_cache = {}
def _infer(mod, vid, aud, txt):
    """Run inference and cache the result. Subsequent calls return cached array."""
    key = (mod, vid, aud, hash(txt or ''))
    if key not in _pred_cache:
        if mod == 'video':
            evts = model.get_events_dataframe(video_path=vid)
        elif mod == 'audio':
            evts = model.get_events_dataframe(audio_path=aud)
        else:
            tmp = tempfile.NamedTemporaryFile(delete=False, suffix='.txt', mode='w')
            tmp.write((txt or '').strip()); tmp.flush()
            os.fsync(tmp.fileno()); tmp.close()
            evts = model.get_events_dataframe(text_path=tmp.name)
            os.unlink(tmp.name)
        p, _ = model.predict(events=evts)
        _pred_cache[key] = np.asarray(p)
    return _pred_cache[key]
demo.launch(
    share      = True,
    debug      = False,
    server_name= "0.0.0.0",
)
So greifen Gradio-UI und Inferenz-Pipeline ineinander:
_infer() ist die zentrale Inferenzschicht für alle drei Modalitäten (Video, Audio, Text): Inputs vorbereiten, model.predict() aufrufen, vorhergesagte Gehirnaktivität zurückgeben.
Ein Prediction-Cache speichert Ergebnisse anhand eines Schlüssels aus Modalität, Pfaden und einem Hash des Texts. Identische Eingaben lösen so keine erneute Inferenz aus.
Das Caching ist entscheidend, weil UI-Elemente wie Slider häufig Callbacks triggern. Ohne Cache würde jede Interaktion die Inferenz neu starten (~60 Sekunden), mit Cache kommen Ergebnisse nach dem ersten Lauf sofort.
Die Oberfläche bietet zwei Tabs: einen Single-Input-Modus mit Zeitregler zur Erkundung der Aktivität über die Zeit und einen Vergleichsmodus, der zwei Eingaben ausführt und ihren Unterschied als Kontrast-Heatmap visualisiert.
Zum Schluss startet demo.launch() mit share=True eine öffentliche URL und mit server_name="0.0.0.0" externen Zugriff – ideal zum schnellen Teilen.
Nach der Demo mit verschiedenen Eingaben (Video, Audio, Text) zeigen sich konsistente Muster, die helfen, die Ausgaben von TRIBE v2 zu interpretieren. Einige Erkenntnisse:
Das Modell ist nicht unfehlbar und bringt typische Stolpersteine mit:
TRIBE v2 ist ein leistungsfähiges Forschungstool, hat aber wichtige Grenzen, die beeinflussen, wie Ausgaben zu interpretieren sind. Diese zu kennen, ist entscheidend, bevor du wissenschaftliche oder klinische Schlüsse ziehst.
In diesem Tutorial haben wir eine funktionierende TRIBE v2 Pipeline in Google Colab A100 aufgebaut: vom Beheben zweier konkreter Bugs (NumPy-2.x-Konflikt und HuggingFace-Download-Timeout) über echte kortikale Vorhersagen bis zur Visualisierung als interaktive 3D-Gehirn-Heatmaps und einem Vergleichsexperiment, das das In-silico-Paradigma des Papers repliziert.
Die vier wichtigsten Engineering-Learnings sind:
NumPy auf <2.1 pinnen und die Runtime neu starten, bevor du tribev2 installierst
HF_HUB_DOWNLOAD_TIMEOUT=300 setzen und LLaMA mit snapshot_download vorab ziehen, bevor model.predict() läuft
Temporäre Dateien immer Schreiben → flush() → fsync() → close(), bevor du den Pfad ans Modell übergibst
Vorhersagen im Dictionary cachen, damit UI-Slider keine erneute Inferenz auslösen.
Von hier aus bieten sich zwei naheliegende Erweiterungen an. Erstens reichhaltigere Reize: Echte Filmszenen oder Podcast-Ausschnitte über 30–60 Sekunden zeigen deutlich klarere zeitliche Dynamik und räumliche Muster als kurze Textpassagen.
Zweitens individuelles Fine-Tuning: Laut Paper kann der Subject-Block von TRIBE v2 mit ~1 Stunde fMRT-Daten einer Person in einer Epoche feinjustiert werden und liefert dann 2–4x bessere personalisierte Vorhersagen als das Gruppenmittel.
Das vollständige Notebook findest du im TRIBE v2 GitHub-Repository. Das Paper lohnt sich besonders in Abschnitt 2.5 (In-silico-Visionsexperimente) und Abschnitt 2.8 (Erkenntnisse zur multimodalen Integration) – es zeigt, was diese Tools für die neurowissenschaftliche Forschung möglich machen.
Deep-Learning-Kurse
Lernpfad
Kurs
Kurs
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Blog
Nathaniel Taylor-Leach
4 Min.
Blog
Nathaniel Taylor-Leach
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Sejal Jaiswal
24 Min.