Programa
Aprendizagem profunda Em Python
18 h
TRIBE v2 (TRImodal Brain Encoder) é um modelo de deep learning que mapeia estímulos naturalísticos para respostas cerebrais de fMRI previstas. Dado um clipe de vídeo, um arquivo de áudio ou um bloco de texto, o modelo gera um sinal BOLD previsto para cada um dos 20.484 vértices na superfície cortical fsaverage5 a 1 Hz, ou seja, uma previsão por segundo.
As previsões representam um sujeito médio (não o cérebro de uma pessoa específica), correspondendo à resposta canônica de grupo que o TRIBE v2 aprendeu a partir de 720 participantes em quatro datasets naturalísticos. As previsões zero-shot do modelo superam gravações de fMRI de sujeito único no dataset 7T do Human Connectome Project, que tem a maior qualidade de sinal no conjunto de treino.
|
Propriedade |
Detalhe |
|
Espaço de saída |
20.484 vértices corticais na superfície fsaverage5 e previsões de todo o cérebro em ~70.000 voxels (córtex + subcórtex) |
|
Resolução temporal |
1 Hz (compatível com a frequência TR do fMRI) |
|
Modalidades de entrada |
Vídeo (V-JEPA2-Giant), áudio (Wav2Vec-BERT 2.0), texto (LLaMA 3.2-3B) |
|
Parâmetros do codificador |
~1B de parâmetros treináveis na camada de integração do transformer |
|
Dados de treino |
1.115 horas de fMRI de 720 sujeitos em 4 datasets |
|
Generalização |
Zero-shot para novos sujeitos, tarefas e idiomas |
|
Licença |
CC-BY-NC 4.0 (uso em pesquisa, não comercial) |
O modelo é adaptado do artigo A foundation model of vision, audition, and language for in-silico neuroscience, que demonstra que o TRIBE v2 recupera a área fusiforme de faces para rostos, a área para-hipocampal de lugares para cenas, a área de Broca para sintaxe complexa e a rede de linguagem lateralizada à esquerda para fala — tudo isso sem usar dados de fMRI no momento da inferência.
O TRIBE v2 tem três estágios executados em sequência a cada chamada de inferência:
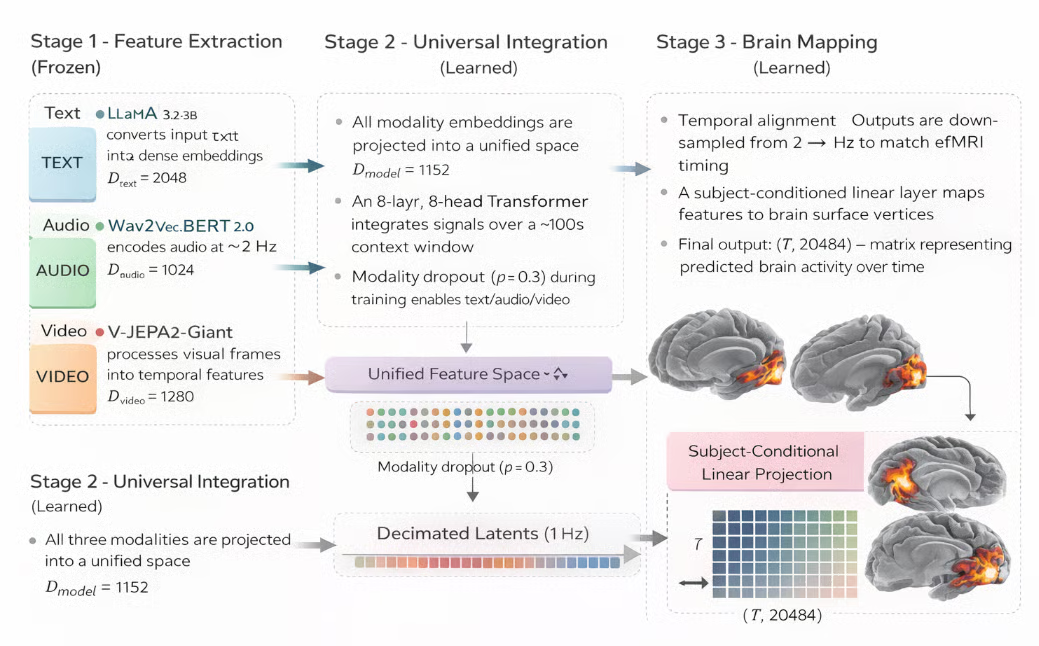
Figura: modelo de previsão de atividade cerebral TRIBE v2 (gerado com IA)
Primeiro, três codificadores pré-treinados e separados processam cada modalidade de entrada de forma independente, gerando embeddings densos e alinhados no tempo. Nenhum desses codificadores é atualizado durante o treino (congelados), então o TRIBE v2 herda essas representações como estão. Métricas de extração por modalidade:
Texto: LLaMA 3.2-3B converte o texto em embeddings densos (D = 2048)
Áudio: Wav2Vec-BERT 2.0 codifica sinais de áudio em ~2 Hz (D = 1024)
Vídeo: V-JEPA2-Giant processa frames visuais em features temporais (D = 1280)
Os três fluxos de embeddings são fundidos em uma representação compartilhada única e processados por um Transformer que faz atenção ao longo do tempo. Aqui residem os pesos aprendidos do TRIBE v2 e onde interações entre modalidades são capturadas:
Representação compartilhada: Todos os embeddings são projetados em um espaço unificado (D_model = 1152)
Fusão via Transformer: Um Transformer de 8 camadas e 8 cabeças integra sinais em uma janela de contexto longa (~100s)
Flexibilidade de modalidade: Dropout de modalidade (p = 0,3) permite inferência com qualquer subconjunto (texto/áudio/vídeo)
A representação latente fundida é projetada na superfície cortical para produzir a previsão final de fMRI. Este estágio converte features abstratas do modelo em estimativas de atividade cerebral com resolução espacial e temporal.
Como três extratores de features ficam congelados durante o treino, o TRIBE v2 aprende apenas as camadas de projeção e os pesos do transformer que integram suas saídas. Essa decisão de design é importante porque torna o modelo robusto a estímulos fora da distribuição, já que ele herda a capacidade de generalização de três modelos de grande escala pré-treinados em vez de ser treinado de ponta a ponta só com dados de fMRI.
Observação: um truque de treino essencial é o dropout por modalidade. Durante o treino, cada modalidade é zerada independentemente com probabilidade 0,3. Isso força o modelo a fazer previsões úteis a partir de qualquer subconjunto de modalidades. Assim, na inferência, você pode passar só áudio ou só texto e ainda assim obter uma previsão cortical útil.
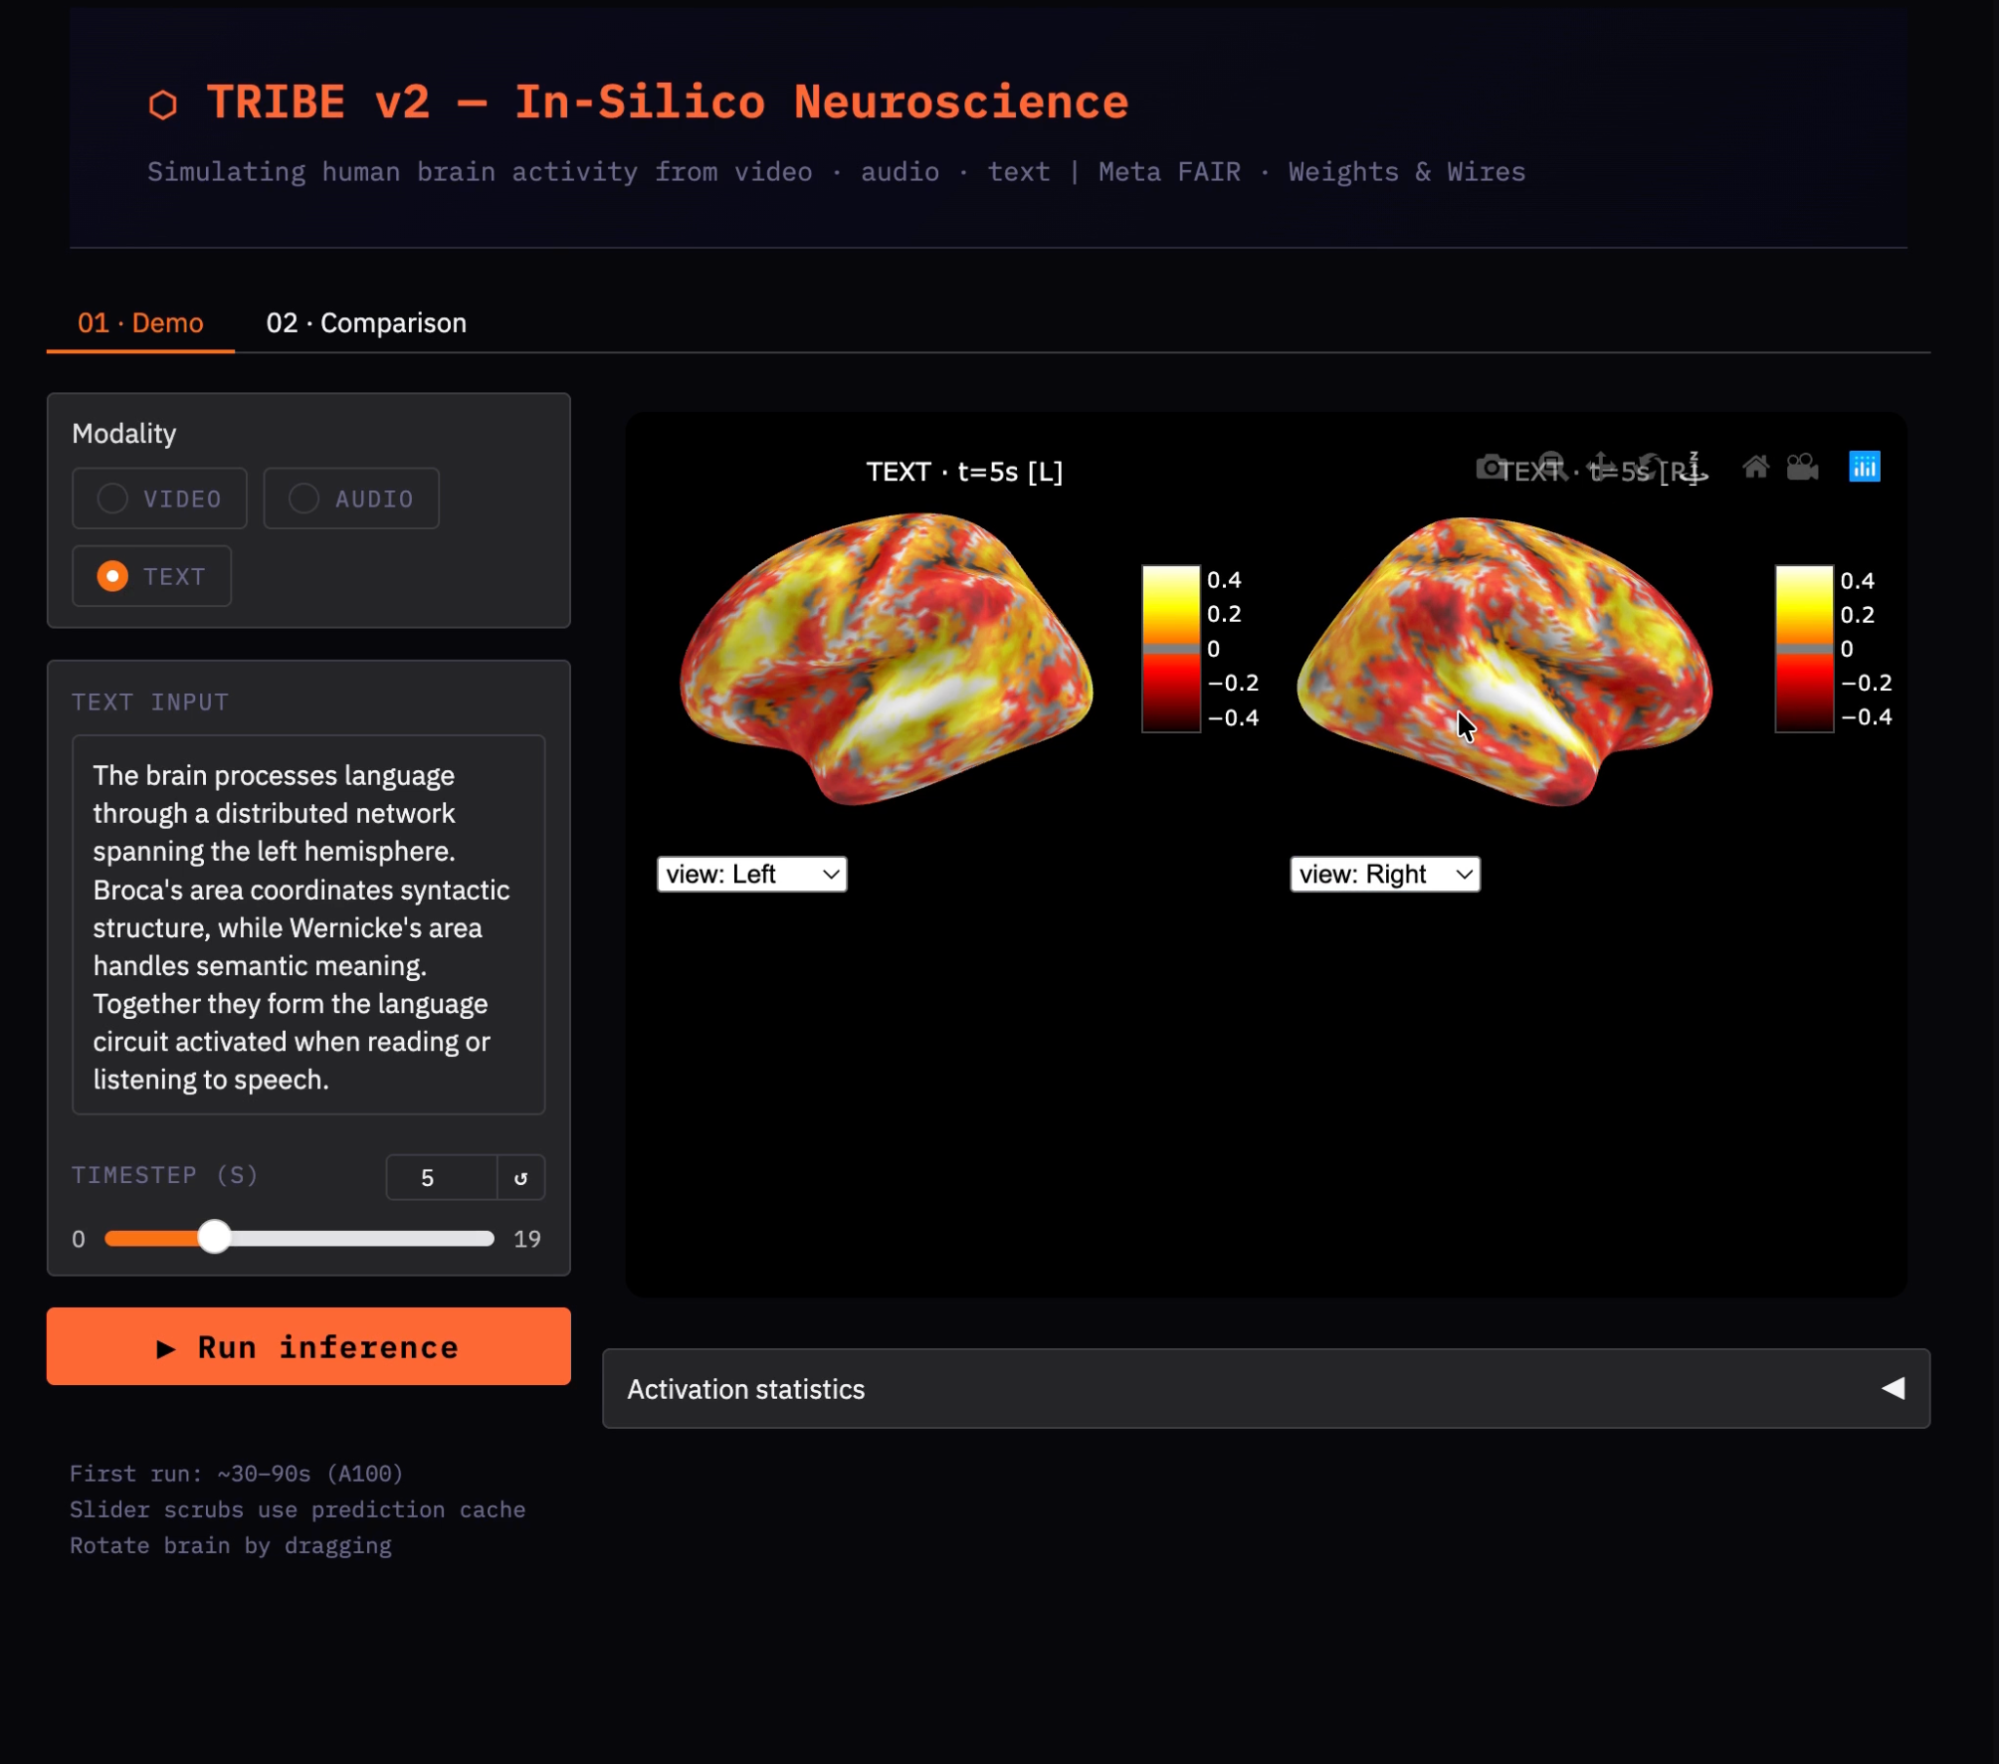
Nesta seção, vamos criar um fluxo passo a passo que roda a inferência do TRIBE v2 em entradas de texto, áudio ou vídeo e visualiza a atividade cortical prevista como um mapa de calor 3D interativo do cérebro. Também vamos executar um experimento de comparação que replica o paradigma in silico do paper original. Por fim, vamos desenvolver um app em Gradio para qualquer pessoa explorar o demo ao vivo.
Antes de começar, configure o runtime do Colab. Você também pode usar qualquer outro serviço com uma GPU A100 estável e RAM alta.
O TRIBE v2 carrega três codificadores congelados simultaneamente, incluindo LLaMA 3.2-3B (~7 GB), V-JEPA2-Giant (~14 GB) e Wav2Vec-BERT 2.0 (~1 GB), além dos pesos do transformer do TRIBE. O uso total de VRAM fica entre 28 e 32 GB.
Observação: uma T4 (16 GB) ficará sem memória quando model.predict() carregar o LLaMA. Use a A100 (40 GB) ou A100 com High RAM (80 GB) para melhor desempenho.
Verifique sua GPU antes de instalar qualquer coisa executando o seguinte:
import subprocess, sys
result = subprocess.run(
    ['nvidia-smi', '--query-gpu=name,memory.total',
     '--format=csv,noheader,nounits'],
    capture_output=True, text=True)
print(result.stdout.strip())
import torch
assert torch.cuda.is_available(), "No GPU detected"
props = torch.cuda.get_device_properties(0)
assert props.total_memory > 30e9, (
    f"Need ≥40 GB VRAM. Got {props.total_memory/1e9:.0f} GB. Switch to A100.")
print(f"GPU: {props.name} — {props.total_memory/1e9:.0f} GB")
A chamada subprocess.run() invoca nvidia-smi com a flag --query-gpu para extrair o nome da GPU e a VRAM total. Os dois asserts atuam como saídas antecipadas; o primeiro confirma que o CUDA está disponível, e o segundo verifica que a VRAM total excede 30 GB. É melhor falhar aqui de forma explícita do que falhar 10 minutos depois dentro de model.predict() com um erro críptico de falta de memória do CUDA.
Ignore este passo se você não estiver rodando no Google Colab. Este é o primeiro bug que você vai encontrar, pois o Colab traz NumPy 2.x por padrão. Várias dependências internas do TRIBE v2, especificamente neuralset, foram compiladas contra NumPy <2.1, que removeu o símbolo _center de numpy._core.umath. O resultado é este erro ao tentar import tribev2:
ImportError
cannot import name '_center' from 'numpy._core.umath'
(/usr/local/lib/python3.12/dist-packages/numpy/_core/umath.py)
A correção é fixar o NumPy em <2.1 antes de instalar o tribev2 ou qualquer dependência dele e, em seguida, reiniciar o runtime. Basta rodar a célula abaixo, que desinstala o NumPy atual e o substitui por uma versão abaixo de 2.1.
import subprocess, sys
print("Pinning NumPy to <2.1 (required for neuralset compatibility)...")
subprocess.run([sys.executable, '-m', 'pip', 'uninstall', '-y', 'numpy'])
subprocess.run([sys.executable, '-m', 'pip', 'install', '-q',
                'numpy>=1.26.4,<2.1.0'])
Com o ambiente e as dependências finalizados, podemos prosseguir com a instalação do TRIBE v2.
Com o kernel recém-reiniciado e o NumPy fixado carregado, podemos instalar com segurança o pacote tribev2 a partir do GitHub, junto com as bibliotecas de visualização e UI.
import numpy as np
from packaging.version import Version
assert Version(np.__version__) < Version('2.1.0'), (
    f"NumPy is {np.__version__}. Run Step 2a and restart first.")
print(f"NumPy {np.__version__} Checked")
# Install tribev2 from GitHub
!pip install -q 'tribev2[plotting] @ git+https://github.com/facebookresearch/tribev2.git'
!pip install -q 'gradio>=4.19.0' 'nilearn>=0.10.3' 'plotly>=5.18.0'
O extra tribev2[plotting] instala o pyvista, biblioteca Python para visualização 3D, e o nilearn, biblioteca Python para neuroimagem, junto com o pacote principal. Instalar direto da URL do GitHub garante que você obtenha o commit mais recente sem precisar clonar o repositório localmente.
Os pacotes nilearn e gradio são instalados separadamente porque suas restrições de versão são mais flexíveis e se beneficiam de resolução independente do grafo de dependências do tribev2.
O codificador de texto usa LLaMA 3.2-3B, que é um modelo com acesso controlado no HuggingFace. Você precisa aceitar explicitamente a licença da Meta antes de baixar os pesos. Faça isso uma vez:
Quando seu token HF estiver configurado, rode o código abaixo para fazer login na sua conta:
import os
# Load token from Colab Secrets
try:
    from google.colab import userdata
    os.environ['HF_TOKEN'] = userdata.get('HF_TOKEN')
    print("HF_TOKEN loaded from Colab Secrets")
except Exception:
    from huggingface_hub import login
    login()
O caminho preferencial usa google.colab.userdata.get(), que lê do repositório criptografado de Segredos do Colab, evitando exposição acidental em um link de notebook compartilhado.
O fallback chama huggingface_hub.login(), que solicita interativamente e mascara o token conforme você digita. Ambos escrevem o token em os.environ['HF_TOKEN'], de onde a biblioteca HuggingFace Hub vai capturá-lo automaticamente ao baixar pesos de modelos com acesso controlado.
Com o NumPy fixado, a autenticação configurada e o LLaMA em cache, podemos carregar o checkpoint do codificador TRIBE v2 do HuggingFace. Isso baixa aproximadamente 1 GB na primeira execução e leva alguns segundos a partir do cache nas execuções seguintes.
from pathlib import Path
from tribev2.demo_utils import TribeModel
import torch
CACHE_DIR = Path('/content/tribe_cache')
CACHE_DIR.mkdir(exist_ok=True)
print('Loading TRIBE v2 (first run downloads ~1 GB)...')
model = TribeModel.from_pretrained(
    'facebook/tribev2',
    cache_folder=str(CACHE_DIR)
)
print('Model loaded')
if torch.cuda.is_available():
    used  = torch.cuda.memory_allocated() / 1e9
    total = torch.cuda.get_device_properties(0).total_memory / 1e9
    print(f'VRAM after load: {used:.1f} / {total:.1f} GB')
TribeModel.from_pretrained() baixa o checkpoint do codificador TRIBE de facebook/tribev2 no HuggingFace e o salva em cache_folder. Esse checkpoint contém os pesos de integração do transformer e o bloco de sujeito, mas não os três extratores de features. Eles são baixados separadamente quando model.predict() usa cada modalidade pela primeira vez.
Depois de carregar apenas o codificador TRIBE, cerca de 2–4 GB de VRAM são alocados, enquanto os 24–28 GB restantes serão consumidos quando model.predict() carregar V-JEPA2-Giant e LLaMA 3.2-3B no primeiro uso.
Após o carregamento do modelo TRIBE, chamar model.predict() com entrada de texto pela primeira vez dispara um download lazy dos pesos do LLaMA 3.2-3B (~6 GB). O timeout padrão do HuggingFace Hub é 10 segundos, gerando este erro no meio da inferência:
ReadTimeout
The read operation timed out
Computing word embeddings:  0%|  | 0/9 [00:10<?, ?it/s]
Para corrigir, aumente as variáveis de ambiente de timeout e faça o pré-download explícito do LLaMA com snapshot_download, assim você vê o progresso e tem retomada automática em caso de interrupção, em vez de uma falha silenciosa dentro de predict().
import os
os.environ['HF_HUB_DOWNLOAD_TIMEOUT'] = '300'
os.environ['HF_HUB_HTTP_TIMEOUT']     = '300'
from huggingface_hub import snapshot_download
print("Pre-downloading LLaMA 3.2-3B (~6 GB)...")
print("Runs once — subsequent calls load from cache.\n")
snapshot_download(
    repo_id        = "meta-llama/Llama-3.2-3B",
    cache_dir      = "/content/tribe_cache/llama",
    ignore_patterns= ["*.bin"],
)
print("\n LLaMA 3.2-3B cached")
snapshot_download() baixa um repositório inteiro para o cache local usando o protocolo de requisições parciais do HuggingFace, retomando automaticamente se a conexão cair no meio do arquivo. O argumento ignore_patterns=["*.bin"] ignora o formato binário antigo do PyTorch e baixa apenas os arquivos safetensors, reduzindo o tamanho total em cerca de 40%.
Antes de rodar a inferência real, vamos configurar a camada de visualização. Essas funções auxiliares convertem o array bruto (T, 20484) em mapas de calor 3D interativos usando nilearn.
O TRIBE v2 retorna previsões como um array NumPy no formato (T, 20484), onde T é o número de segundos da entrada. Os primeiros 10.242 vértices são do hemisfério esquerdo e os 10.242 restantes do hemisfério direito.
Usamos nilearn.plotting.view_surf para renderizar cada hemisfério como uma superfície WebGL interativa. A malha inflada expõe a geometria dos sulcos que ficaria oculta nas dobras, e o mapa de profundidade sulcal fornece referência anatômica sob o mapa de calor.
A malha fsaverage5 é o template cortical padrão do FreeSurfer que o TRIBE v2 usa como espaço de saída. Baixamos uma vez aqui para que as chamadas de visualização seguintes a referenciem sem novo download.
import numpy as np
from nilearn import datasets as nl_datasets
from nilearn.plotting import view_surf
from IPython.display import display, HTML
N_PER_HEMI = 10242   # fsaverage5: 10242 vertices per hemisphere
print('Fetching fsaverage5 mesh...')
fsavg = nl_datasets.fetch_surf_fsaverage(mesh='fsaverage5')
print('Mesh ready')
print('Keys:', [k for k in fsavg.keys() if k != 'description'])
O fetch_surf_fsaverage(mesh='fsaverage5') baixa o template fsaverage5 do FreeSurfer a partir do CDN do nilearn e o armazena em cache. Ele retorna um objeto Bunch (dicionário) com chaves como infl_left, infl_right, sulc_left e sulc_right.
Esta subetapa define três funções centrais de que toda a visualização depende. split_hemis() faz a partição do vetor de vértices, render_hemi() constrói a superfície WebGL interativa para um hemisfério e show_brain() monta ambas lado a lado.
def split_hemis(v):
    n = v.shape[0]
    if n == 2 * N_PER_HEMI:
        return v[:N_PER_HEMI], v[N_PER_HEMI:]
    return v[:n//2], v[n//2:]
def render_hemi(pred_vec, hemi='left', title=''):
    lh, rh = split_hemis(pred_vec)
    data = lh if hemi == 'left' else rh
    vmax = max(float(np.percentile(np.abs(data), 99)), 1e-6)
    return view_surf(
        surf_mesh = fsavg[f'infl_{hemi}'],
        surf_map  = data,
        bg_map    = fsavg[f'sulc_{hemi}'],
        hemi      = hemi,
        threshold = '20%',
        cmap      = 'hot',
        black_bg  = True,
        vmax      = vmax,
        bg_on_data= True,
        colorbar  = True,
        title     = title,
    )
def show_brain(pred_vec, title='', t=None):
    sfx = f' — t={t}s' if t is not None else ''
    lv  = render_hemi(pred_vec, 'left',  f'{title} [Left]{sfx}')
    rv  = render_hemi(pred_vec, 'right', f'{title} [Right]{sfx}')
    html = (
        '<div style="display:flex;gap:10px;background:#000;'
        'border-radius:10px;">'
        f'<div style="flex:1">{lv.get_iframe(width="100%",height="460px")}</div>'
        f'<div style="flex:1">{rv.get_iframe(width="100%",height="460px")}</div>'
        '</div>'
    )
    display(HTML(html))
Vamos entender o papel de cada helper em detalhe:
A função split_hemis() fatia o vetor de previsão no índice 10.242, que é o ponto de divisão padrão da malha fsaverage5 na convenção do FreeSurfer. O hemisfério esquerdo ocupa os índices 0–10241 e o direito 10242–20483. O branch de fallback lida com casos em que o modelo retorna uma contagem de vértices não padrão.
Dentro de render_hemi(), o vmax é calculado como o percentil 99 dos valores absolutos de ativação, e não o máximo real. Isso evita que um único vértice extremo comprima todo o mapa de cores em uma faixa estreita, preservando o padrão espacial visível.
A função view_surf() retorna um objeto SurfaceView contendo 2,4 MB de HTML WebGL autocontido. A chamada get_iframe() o empacota em uma tag <iframe> no tamanho especificado. Assim, ao chamar display(HTML(...)) com dois iframes lado a lado, obtemos o layout dividido esquerda/direita.
Com o modelo carregado e os helpers prontos, podemos rodar nossa primeira inferência real.
A inferência do TRIBE v2 ocorre em duas etapas. Primeiro, model.get_events_dataframe() extrai eventos alinhados no tempo a partir da entrada, junto com timings de palavras de texto, embeddings do Wav2Vec a 2 Hz no áudio ou embeddings do V-JEPA2 a 2 Hz nos frames de vídeo.
O DataFrame de eventos resultante é então passado a model.predict(), que roda o transformer e o bloco de sujeito para gerar as previsões corticais finais.
import tempfile, os
SAMPLE_TEXT = '''
The brain processes language through a distributed network in the left hemisphere.
Broca's area coordinates syntactic structure, while Wernicke's area handles semantics.
Together they form the language circuit activated when reading or hearing speech.
'''
tmp = tempfile.NamedTemporaryFile(delete=False, suffix='.txt', mode='w')
try:
    tmp.write(SAMPLE_TEXT.strip())
    tmp.flush()
    os.fsync(tmp.fileno())
    tmp.close()
    events = model.get_events_dataframe(text_path=tmp.name)
finally:
    if os.path.exists(tmp.name):
        os.unlink(tmp.name)
print(f'Events: {events.shape}')
print(events[['type', 'start', 'duration']].head(8))
print('\nRunning model.predict()...')
preds, segments = model.predict(events=events)
preds = np.asarray(preds)
print(f'Prediction shape: {preds.shape}')
print(f'  T = {preds.shape[0]}s   (1 Hz fMRI frequency)')
print(f'  V = {preds.shape[1]} vertices  (fsaverage5 cortical surface)')
A sequência tmp.write(), tmp.flush(), os.fsync(tmp.fileno()), tmp.close() é a correção crítica para um bug sutil. Se você chamar get_events_dataframe() dentro de um bloco with antes de o arquivo ser fechado, o buffer interno de escrita do Python pode ainda não ter sido sincronizado com o SO, e o tribev2 vai ler um arquivo vazio e levantar ValueError. A chamada os.fsync() garante que o cache de página do SO seja descarregado em disco antes de o tribev2 abrir o caminho.
A função model.predict() retorna uma tupla (preds, segments). O array preds tem formato (T, 20484), uma previsão cortical por segundo de entrada nos 20.484 vértices do fsaverage5. Envolvê-lo com np.asarray() garante que seja um array NumPy puro, independentemente do tipo interno retornado pelo modelo. Com preds em mãos, você pode visualizar a resposta cortical em qualquer instante:
T = preds.shape[0]
print(f'Timesteps: 0 to {T-1}')
T_SHOW = min(5, T - 1)
show_brain(preds[T_SHOW], title='Language stimulus', t=T_SHOW)
O padrão é t=5 porque o sinal BOLD (Blood-Oxygen-Level-Dependent) tem um atraso hemodinâmico, e a resposta vascular à atividade neural atinge o pico cerca de 5–6 segundos após o início do estímulo. Visualizar em t=0 mostra ativação quase zero, independentemente do conteúdo, já que a resposta vascular ainda não se formou. O guard min(5, T-1) evita erro de índice quando a entrada gera menos de 6 timesteps.
Um único mapa de ativação mostra quais áreas estão ativas, mas não explica o que diferencia um estímulo de outro. Este passo roda duas entradas no modelo e calcula um mapa de contraste (A − B) para isolar as diferenças específicas de região entre conteúdo linguístico e conteúdo visual/espacial.
Em vez de repetir o padrão escrever -> flush -> close -> inferir para cada condição, vamos encapsular tudo na função text_to_preds(). Isso garante que as etapas críticas de flush de arquivo nunca sejam omitidas em nenhuma condição.
TEXT_A = '''
She spoke slowly and clearly, her voice filling the quiet room.
Every sentence carried meaning, and each word was chosen with care.
Language connects us, the professor said, bridging minds across time.
'''
TEXT_B = '''
The canyon walls rose steeply, layers of red and orange sandstone.
A hawk circled overhead, its wings barely moving in the thermal current.
Shadows shifted as the sun tracked its arc across the open desert sky.
'''
def text_to_preds(text):
    tmp = tempfile.NamedTemporaryFile(
        delete=False, suffix='.txt', mode='w', encoding='utf-8')
    try:
        tmp.write(text.strip())
        tmp.flush()
        os.fsync(tmp.fileno())
        tmp.close()
        evts = model.get_events_dataframe(text_path=tmp.name)
        p, _ = model.predict(events=evts)
        return np.asarray(p)
    finally:
        if os.path.exists(tmp.name):
            os.unlink(tmp.name)
print('Condition A: language content...')
preds_a = text_to_preds(TEXT_A)
print('Condition B: visual/spatial content...')
preds_b = text_to_preds(TEXT_B)
Usamos duas passagens de texto com conteúdo semântico distinto, com a expectativa de que conteúdo linguístico ative mais o córtex temporal do hemisfério esquerdo, enquanto conteúdo visual/espacial recrute mais o córtex occipital e parietal posterior.
A função text_to_preds() encapsula o pipeline completo em uma função reutilizável, aplicando o mesmo padrão seguro do Passo 8 para que o arquivo temporário esteja sempre totalmente sincronizado antes de o tribev2 lê-lo. O argumento encoding='utf-8' é explícito para evitar problemas de codificação dependentes da plataforma.
Com as duas condições previstas, vamos visualizar cada uma individualmente e depois subtraí-las vértice a vértice para produzir o mapa de contraste.
T_shared = min(preds_a.shape[0], preds_b.shape[0])
t_show   = min(5, T_shared - 1)
print('\n[A] Language content:')
show_brain(preds_a[t_show], title='Condition A: Language', t=t_show)
print('\n[B] Visual/spatial content:')
show_brain(preds_b[t_show], title='Condition B: Visual', t=t_show)
print('\n[A − B] Contrast: Language > Visual')
show_brain(preds_a[t_show] - preds_b[t_show], title='Contrast A − B', t=t_show)
O mapa de contraste preds_a[t_show] - preds_b[t_show] é uma subtração direta vértice a vértice em que valores positivos indicam regiões onde a condição A ativa mais e valores negativos indicam regiões onde a condição B ativa mais.
Como ambas as condições compartilham a via de processamento de texto, os mapas brutos parecerão amplamente semelhantes. Este contraste destaca diferenças específicas de domínio entre linguagem e conteúdo visual.
Os mapas do cérebro mostram padrões espaciais em um único instante. Aqui adicionamos uma perspectiva temporal: como a ativação geral se compara entre condições ao longo do tempo? Quando as duas condições divergem mais fortemente?
import matplotlib.pyplot as plt
diff_norms = [
    np.linalg.norm(preds_a[i] - preds_b[i])
    for i in range(T_shared)
]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 3.5))
ax1.plot(np.abs(preds_a).mean(axis=1)[:T_shared],
         color='#e74c3c', linewidth=2, label='A: Language')
ax1.plot(np.abs(preds_b).mean(axis=1)[:T_shared],
         color='#3498db', linewidth=2, label='B: Visual')
ax1.set_title('Mean cortical activation over time')
ax1.set_xlabel('Time (s)'); ax1.legend(); ax1.grid(True, alpha=0.3)
ax2.plot(diff_norms, color='#f39c12', linewidth=2)
ax2.fill_between(range(T_shared), diff_norms, alpha=0.2, color='#f39c12')
ax2.set_title('||A − B|| difference over time')
ax2.set_xlabel('Time (s)'); ax2.grid(True, alpha=0.3)
plt.tight_layout(); plt.show()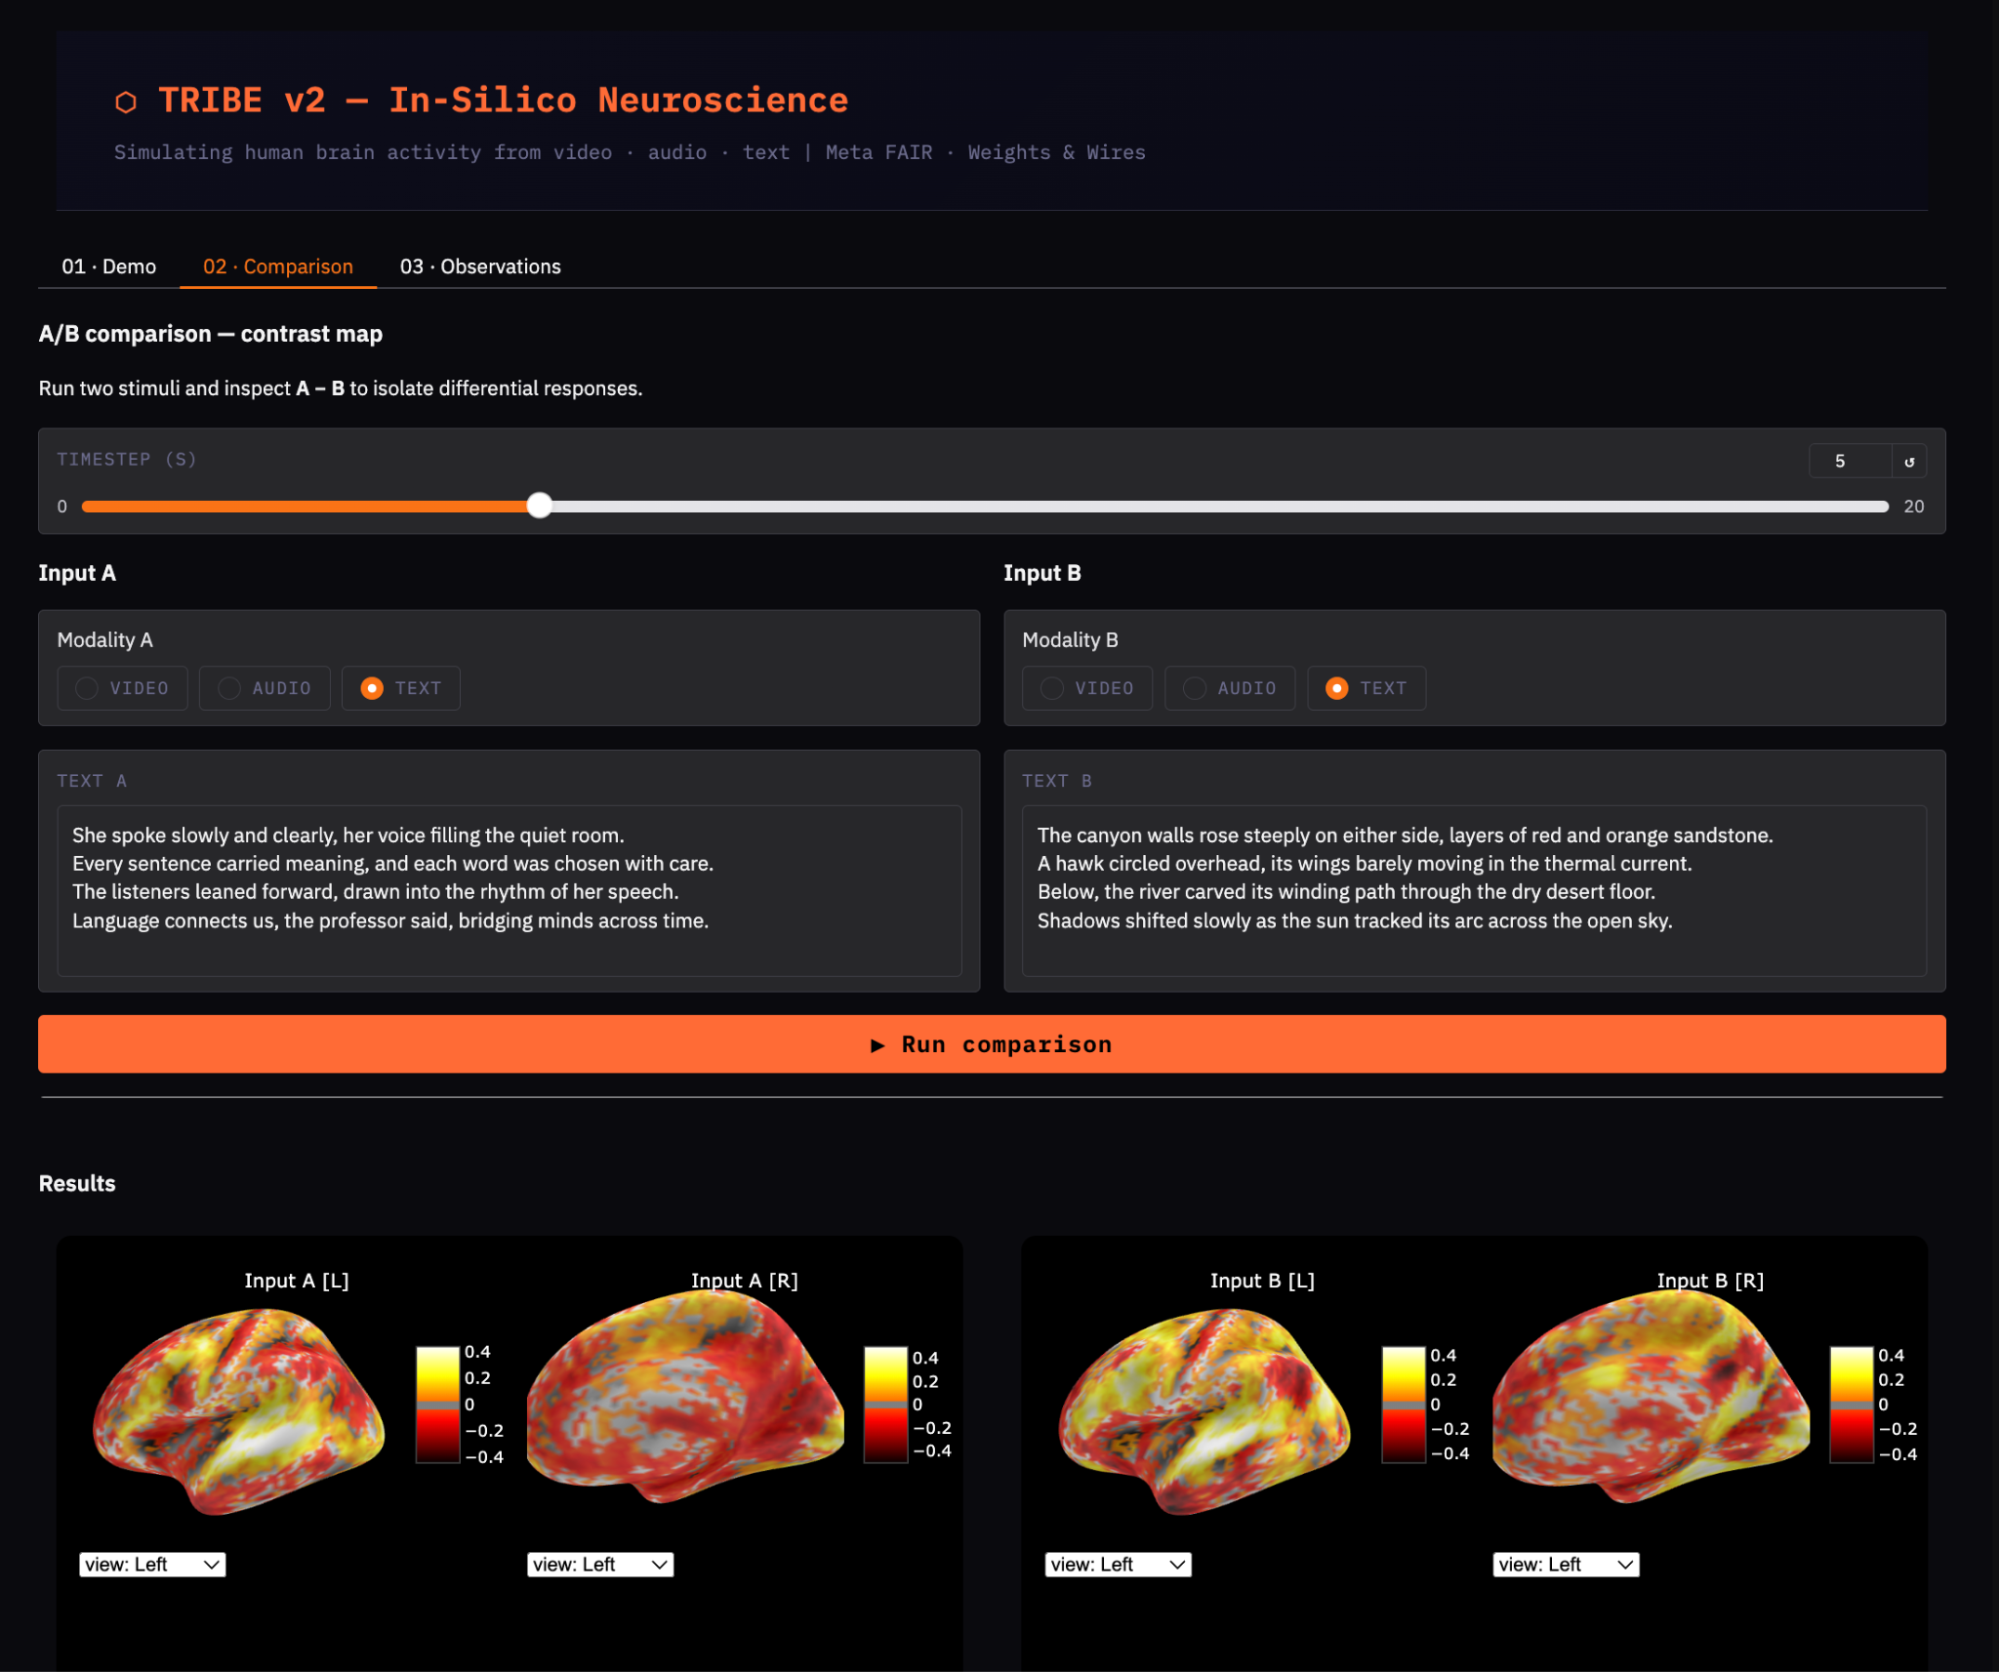
O gráfico da esquerda acompanha np.abs(preds).mean(axis=1), a ativação absoluta média colapsada nos 20.484 vértices a cada segundo. Isso mostra o quão fortemente cada condição engaja o córtex e quando a resposta atinge o pico. Tomar o valor absoluto é importante porque valores BOLD previstos podem ser negativos (desativação) e queremos a magnitude, não a média assinada.
O gráfico da direita acompanha a norma L2 do vetor diferença a cada timestep, np.linalg.norm(preds_a[i] - preds_b[i]). Um pico nessa curva por volta de t=5–7s é consistente com o atraso hemodinâmico: ambas as condições precisam de tempo para a resposta BOLD se construir antes de divergir. O sombreamento com fill_between() torna claro o início e o pico da divergência.
Este passo final empacota a lógica de inferência e visualização em um app Gradio com uma UI limpa, controle deslizante de timestep e uma aba de comparação A/B.
import gradio as gr
_pred_cache = {}
def _infer(mod, vid, aud, txt):
    """Run inference and cache the result. Subsequent calls return cached array."""
    key = (mod, vid, aud, hash(txt or ''))
    if key not in _pred_cache:
        if mod == 'video':
            evts = model.get_events_dataframe(video_path=vid)
        elif mod == 'audio':
            evts = model.get_events_dataframe(audio_path=aud)
        else:
            tmp = tempfile.NamedTemporaryFile(delete=False, suffix='.txt', mode='w')
            tmp.write((txt or '').strip()); tmp.flush()
            os.fsync(tmp.fileno()); tmp.close()
            evts = model.get_events_dataframe(text_path=tmp.name)
            os.unlink(tmp.name)
        p, _ = model.predict(events=evts)
        _pred_cache[key] = np.asarray(p)
    return _pred_cache[key]
demo.launch(
    share      = True,
    debug      = False,
    server_name= "0.0.0.0",
)
Veja como a UI do Gradio e o pipeline de inferência se conectam:
A função _infer() atua como a camada central de inferência, lidando com as três modalidades (vídeo, áudio e texto) ao preparar entradas, chamar model.predict() e retornar a atividade cerebral prevista.
Um cache de previsões armazena resultados com base em uma chave composta pela modalidade, caminhos de entrada e um hash do texto. Isso evita que entradas idênticas disparem novas inferências.
O cache é crítico porque componentes de UI como sliders disparam callbacks com frequência. Sem cache, cada interação reexecutaria a inferência (levando até ~60 segundos); com cache, os resultados retornam instantaneamente após a primeira execução.
A interface oferece duas abas: uma de entrada única com slider de timestep para explorar a atividade ao longo do tempo e outra de comparação que roda duas entradas e visualiza a diferença como um mapa de calor de contraste.
Por fim, demo.launch() é configurado com share=True para gerar uma URL pública e server_name="0.0.0.0" para permitir acesso externo, facilitando a implantação do app.
Após rodar o demo com diferentes entradas (vídeo, áudio e texto), alguns padrões consistentes ajudam a interpretar as saídas do TRIBE v2. Alguns insights:
O modelo não promete 100% de acurácia e tem suas próprias armadilhas:
O TRIBE v2 é uma ferramenta poderosa de pesquisa, mas tem limitações importantes que afetam como suas saídas devem ser interpretadas. Entender essas restrições é essencial antes de tirar conclusões científicas ou clínicas.
Neste tutorial, montamos um pipeline funcional do TRIBE v2 no Google Colab A100: resolvemos dois bugs concretos (o conflito de versão do NumPy 2.x e o timeout de download do HuggingFace), rodamos previsões corticais reais, visualizamos os resultados como mapas de calor 3D interativos e executamos um experimento de comparação que replica o paradigma in silico do paper.
As quatro lições de engenharia mais importantes deste tutorial são:
Fixar o NumPy em <2.1 e reiniciar o runtime antes de instalar o tribev2
Definir HF_HUB_DOWNLOAD_TIMEOUT=300 e fazer pré-download do LLaMA com snapshot_download antes de chamar model.predict()
Sempre escrever → flush() → fsync() → close() os arquivos temporários antes de passar o caminho para o modelo
Fazer cache das previsões em um dicionário para que interações do slider na UI não reexecutem a inferência.
A partir daqui, duas extensões naturais se destacam. A primeira são estímulos mais ricos: clipes de filmes reais ou trechos de podcasts com 30–60 segundos produzem dinâmicas temporais e padrões espaciais muito mais claros do que passagens curtas de texto.
A segunda é o fine-tuning individual: com ~1 hora de fMRI de um sujeito específico, o bloco de sujeito do TRIBE v2 pode ser ajustado em uma época para gerar previsões personalizadas que superam o modelo médio de grupo em 2–4x, segundo o paper.
O notebook completo está disponível no repositório do TRIBE v2 no GitHub. Vale a pena ler o paper na íntegra, especialmente a Seção 2.5 (experimentos de visão in silico) e a Seção 2.8 (insights de integração multimodal), que mostram o potencial desse tipo de ferramenta para pesquisa em neurociência.
Cursos de deep learning
Programa
Curso
Curso
blog
Dr Ana Rojo-Echeburúa
9 min
blog
blog
Abid Ali Awan
9 min
Tutorial
Zoumana Keita
8 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Aashi Dutt
14 min